数据结构——二叉搜索树 (Binary Search Tree)
目录
1.二叉搜索的概念
为什么要有二叉搜索树?在学习二叉树时,如果要查找某一个元素时,需要对二叉树的一个节点挨着一个节点进行遍历访问,直到访问到为止或者把整棵树都遍历结束发现没有这个查找值为止,这样的效率就会非常的慢,所以数据结构就引入了二叉搜索树。
二叉搜索树( BST )又称为二叉排序树,它或者是一棵空树,或者是满足以下性质的二叉树:
- 若它的左子树不为空,则左子树的所有节点的值都小于根节点的值
- 若它的右子树不为空,则右子树的所有节点的值都大于根节点的值
- 它的左右子树也要满足二叉搜索树,并且通常二叉搜索树不能有重复值
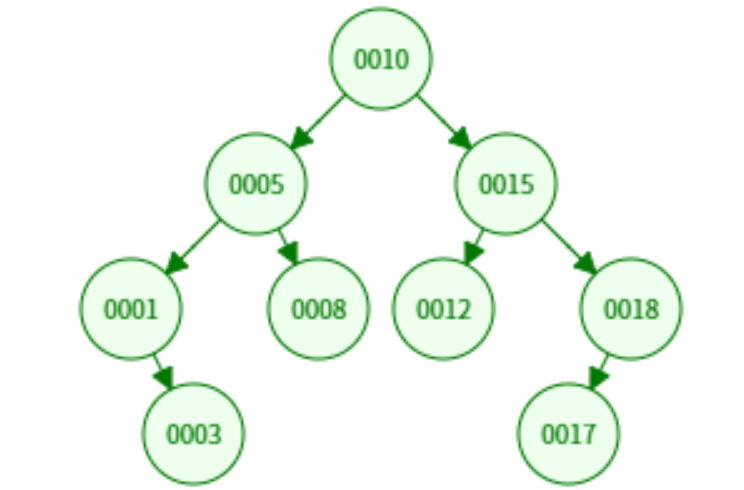
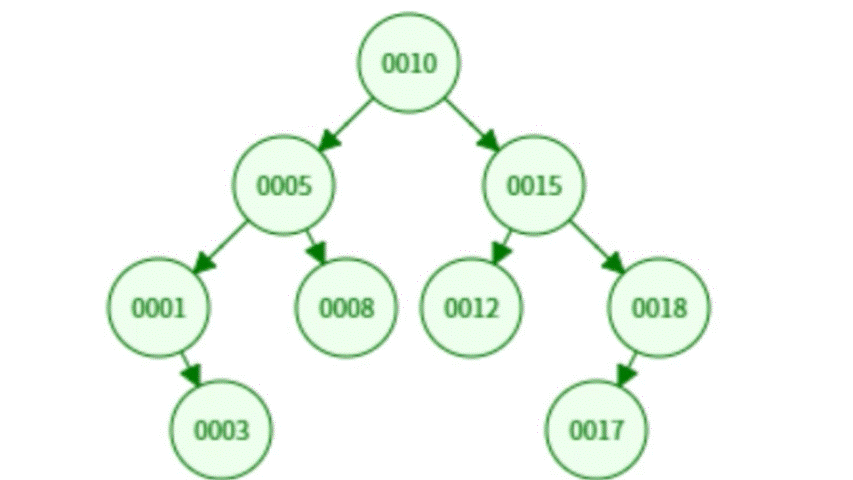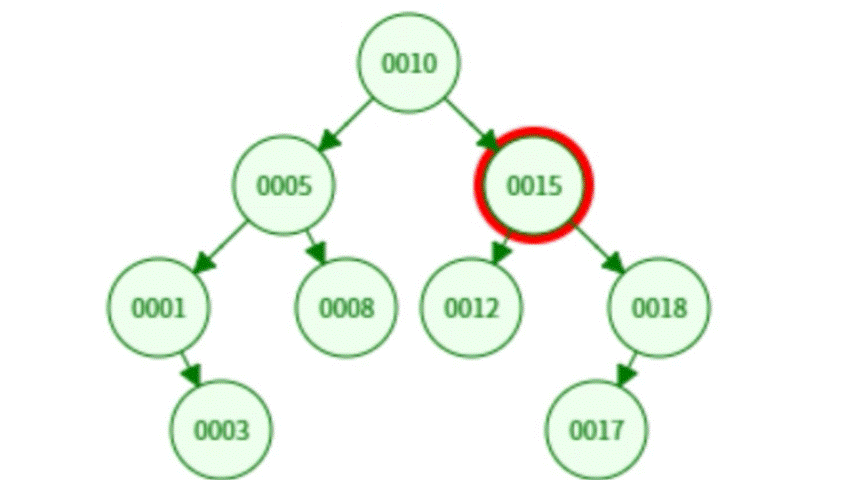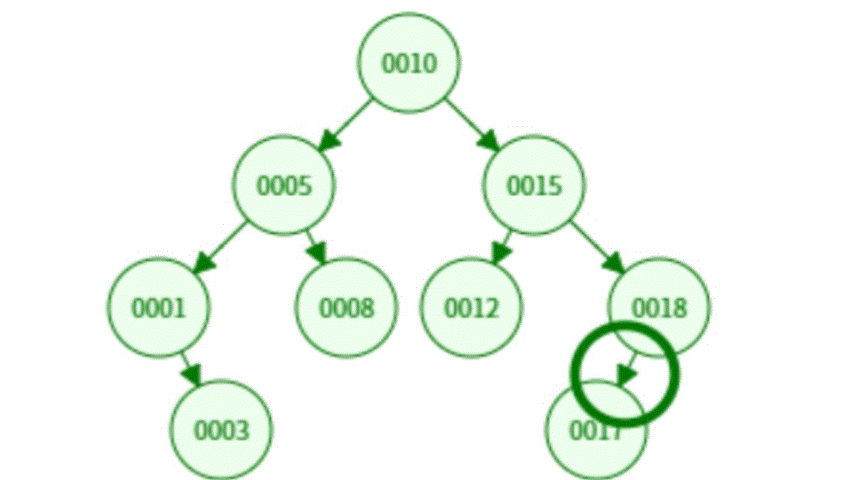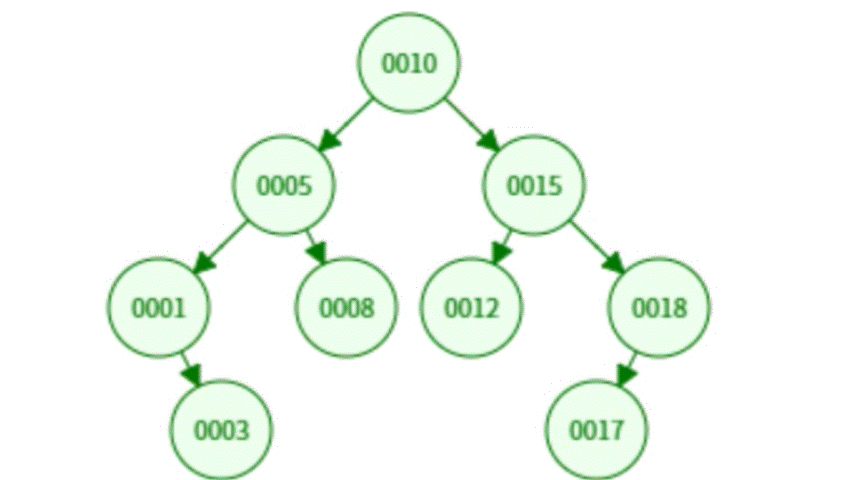
比如上面的一棵二叉树就是二叉搜索树。
可以看到:二叉搜索树的根节点的值都大于左节点的值,并且小于右节点的值。所以,如果对二叉搜索树进行中序遍历,那么得到的结果就是一组升序的数据。
2.二叉搜索树的操作
2.1 查找 search
情况1:若根节点为空,即二叉搜索树为空,查找不到,直接返回 null ;
情况2:若根节点不为空,已经知道二叉搜索树的左节点值 < 根节点值 < 右节点值,所以当要查找某一个值时,只需要判断要查找的值和根节点的值大小,
- 如果根节点的值等于查找的值,返回 该根节点 ,
- 如果根节点的值 < 查找的值,在右子树查找,
- 如果根节点的值 > 查找的值,在左子树查找,
- 最后走到叶子节点还是找不到,说明这棵二叉搜索树没有要查找的值,返回 null。
以查找值为 17 的节点为例:根节点值 10 < 查找值 17,在右子树查找;根节点值15 < 查找值 17,在右子树查找;根节点值 18 > 查找值 17,在左子树查找;节点值 17 = 查找值 17,找到返回。
public class BinarySearchTree {
    public static class TreeNode {
        public int val;//节点值
        public TreeNode left;//左子树
        public TreeNode right;//右子树

        public TreeNode(int val) {
            this.val = val;
        }
    }
    public TreeNode root;//根节点
    //查找元素
    public TreeNode search(int key) {
        if (root == null) {
            //根节点为空,直接返回
            return null;
        }
        TreeNode cur = root;
        while (cur != null) {
            if (cur.val < key) {
                //根节点值小于查找值
                cur = cur.right;
            } else if (cur.val > key) {
                //根节点值大于查找值
                cur = cur.left;
            } else {
                //根节点值等于查找值
                return cur;
            }
        }
        return null;//找不到
    }
时间复杂度分析:平均O(log N),最坏情况:退化成单分支的树时,O(N)
2.2 插入 insert
情况1:若根节点为空,即二叉搜索树为空,直接插入,root = node
情况2:若根节点不为空,根据性质二叉搜索树的左节点值 < 根节点值 < 右节点值,从根节点开始判断:
- 如果根节点的值等于插入的值,直接返回,BST中通常不能有重复值 ,
- 如果根节点的值 < 插入的值,在右子树查找合适点,
- 如果根节点的值 > 插入的值,在左子树查找合适点,
以插入值为 13 的节点为例:根节点值 10 < 插入值 13,在右子树查找;根节点值15 > 插入值 13,在左子树查找;根节点值 12 < 插入值 13,在右子树查找;此时根节点已为空,在值为 12 的节点的右子树插入 值为 13 的节点。
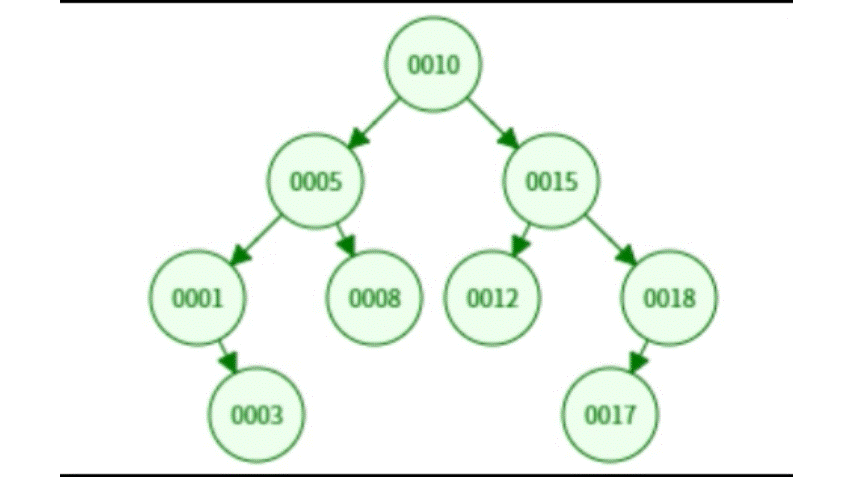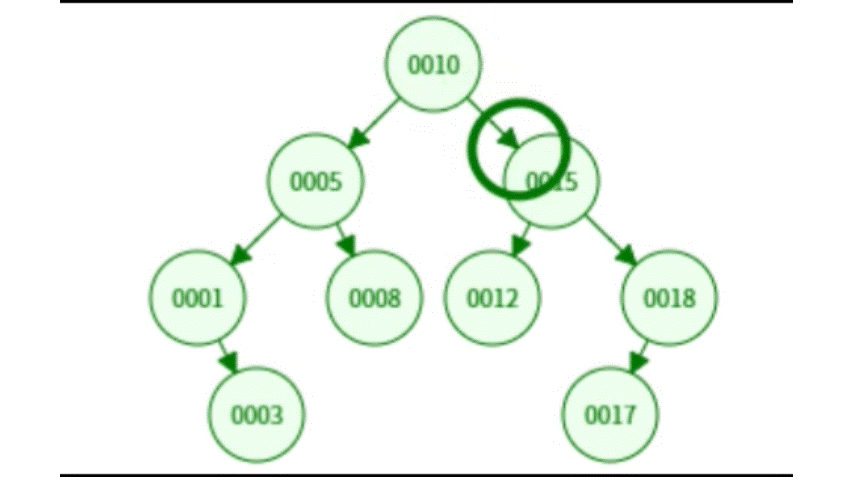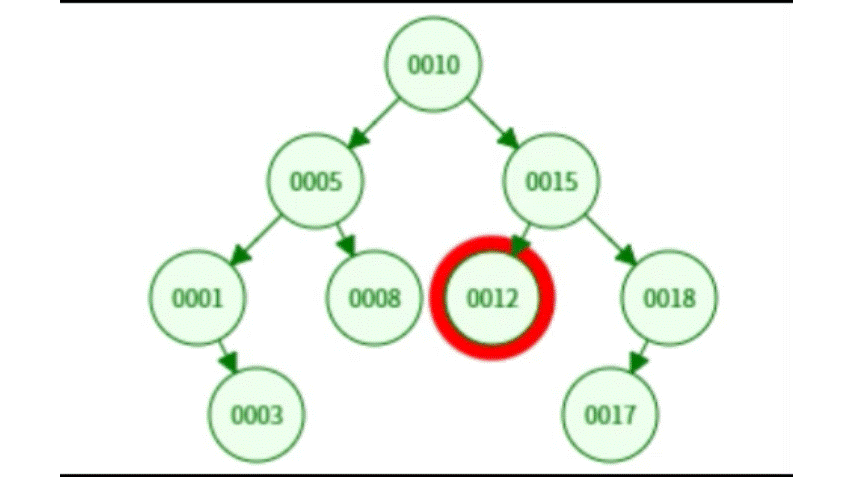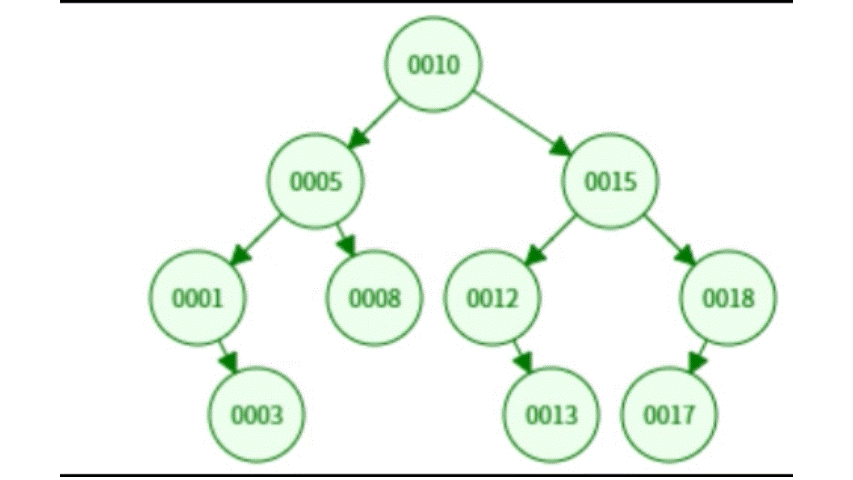
    //插入元素
    public void insert(int key) {
        TreeNode node = new TreeNode(key);
        if (root == null) {
            //根节点为空,直接插入
            root = node;
            return;
        }
        TreeNode cur = root;//用来遍历,直到找到空树位置
        TreeNode parent = null;//记录cur的上一个位置,当cur为空时,说明插入的节点在这个节点的左边或者右边
        while (cur != null) {
            if (cur.val < key) {
                parent = cur;
                cur = cur.right;
            } else if (cur.val > key) {
                parent = cur;
                cur = cur.left;
            } else {
                return;//不能插入相同的元素
            }
        }
        if (parent.val < key) {
            parent.right = node;//插入的节点值大,在右边插入
        } else {
            parent.left = node;
        }
    }
时间复杂度分析:平均O(log N),最坏情况:退化成单分支的树时,O(N)
2.3 删除 remove
二叉搜索的查找和插入都相对简单,但是删除节点时就比较麻烦,具体可以看以下情况。
设待删除节点为空 cur ,待删除节点的双亲节点是 parent。
删除操作首先要找到需要删除的节点,在此基础上,分为三种大情况:
情况1:待删除节点的左子树为空,即 cur.left == null,则:
- cur 是根节点,即 cur == root,只需把根节点更新为 cur 的右节点,即 root = cur.right
- cur 不是根节点,当 cur 是parent 的左子树时,则 parent.left = cur.right
- cur 不是根节点,当 cur 是parent 的右子树时,则 parent.right = cur.right
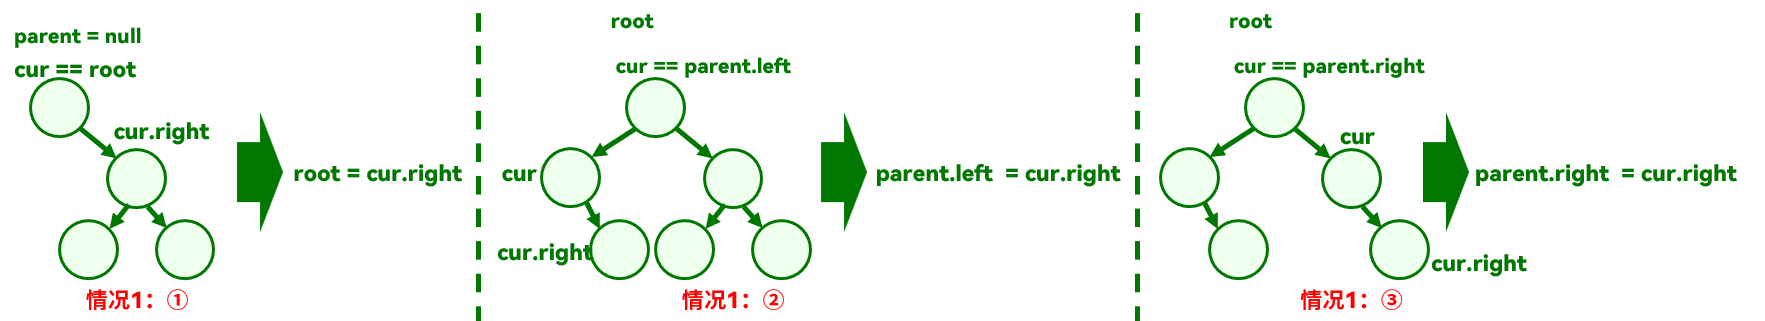
情况2:待删除节点的右子树为空,即 cur.right == null,则:
- cur 是根节点,即 cur == root,只需把根节点更新为 cur 的左节点,即 root = cur.left
- cur 不是根节点,当 cur 是parent 的左子树时,则 parent.left = cur.left
- cur 不是根节点,当 cur 是parent 的右子树时,则 parent.right = cur.left
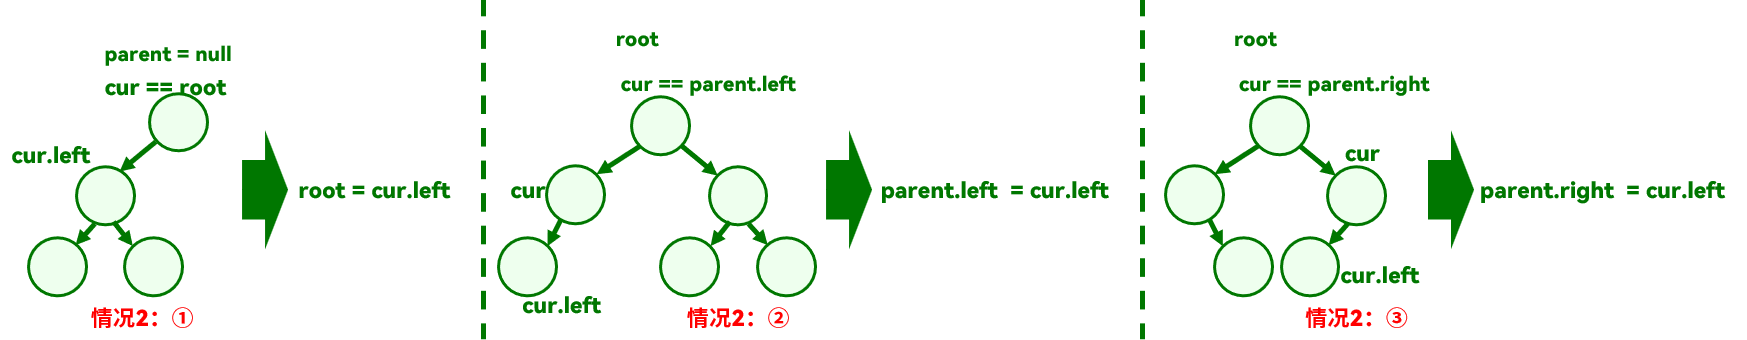
情况3:待删除节点的左右子树都不为空,即 cur.left != null && cur.right != null,则先找到需要删除的节点,然后再找到一个节点来替换该节点,否则就没有要删除的节点。如果有删除的节点,有两种删除方式:
- 在待删除节点的左子树中找到最大节点替换该待删除节点:左子树的最大值节点是该树的最右节点
- 在待删除节点的右子树中找到最小节点替换该待删除节点:右子树的最小值节点是该树的最左节点
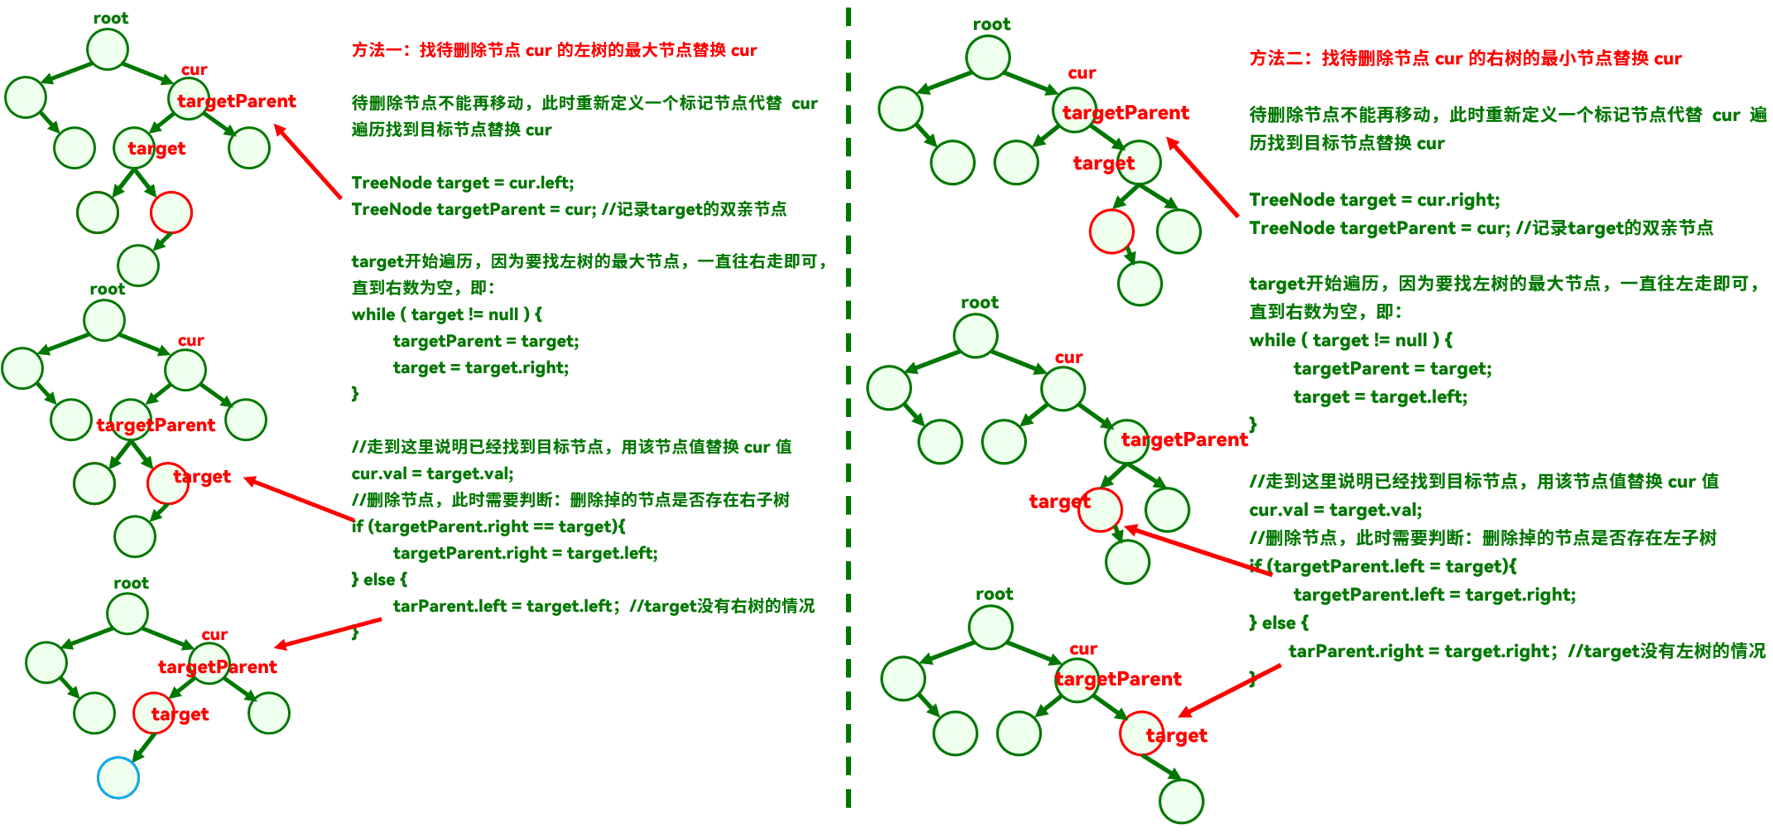
    //删除节点
    public void remove(int key) {
        if (root == null) {
            return;
        }
        TreeNode parent = null;
        TreeNode cur = root;
        while (cur != null) {
            if (cur.val < key) {
                parent = cur;
                cur = cur.right;
            } else if (cur.val > key) {
                parent = cur;
                cur = cur.left;
            } else {
                removeNode(parent , cur);
                return;
            }
        }
    }

    private void removeNode(TreeNode parent , TreeNode cur) {
        //情况1:cur的左边为空
        if (cur.left == null) {
            if (cur == root) {//cur本身就在根节点
                root = cur.right;
            } else if (cur == parent.left) {//cur在parent的左边
                parent.left = cur.right;
            } else {//cur在parent的右边
                parent.right = cur.right;
            }
        }
        //情况2:cur的右边为空
        else if (cur.right == null) {
            if (cur == root) {//cur本身就在根节点
                root = cur.left;
            } else if (cur == parent.left) {//cur在parent的左边
                parent.left = cur.left;
            } else {//cur在parent的右边
                parent.right = cur.left;
            }
        }
        /*
          情况3:
          cur的左右都不为空
          这里有两种解法:一是找到 cur 右数的最小值替换 cur(找左树的右节点),
                       二是找到 cur 左树的最大值替换 cur(找右书的左节点)
          这里以找cur左树的最大值为例
         */
        else {
            TreeNode targetParent = cur;
            TreeNode target = cur.left;
            while (target.right != null) {
                targetParent = target;
                target = target.right;
            }
            //走到这里,说明target已经到了最后的右树节点
            cur.val = target.val;//把当前的target值赋给cur节点的值,完成替换
            //删除节点
            if (targetParent.right == target) {
                targetParent.right = target.left;
            } else {
                targetParent.left = target.left;
            }
        }
    }
时间复杂度分析:平均O(log N),最坏情况:退化成单分支的树时,O(N)
3.二叉搜索树总结
二叉搜索的三大核心操作:查找、插入、删除,它们的时间复杂度在最好的情况是完全二叉树时:O(logN),平均时间复杂度也可以认为是这样,因为在使用时不会可以的让二叉树的每一层只有两三个节点,而在最坏情况下,二叉树退化成一个单分支的树,类似于链表,此时时间复杂度是O(N)。
所以,如果二叉搜索树退化成单分支树,二叉搜索的查找性能优势也就失去了,如何解决这个问题?
为了解决这个问题,引入了平衡二叉搜索树(AVL),其特点是严格平衡,任何节点的左右子树高度差都不超过1,其操作是通过旋转来实现平衡,而当旋转次数过多时,又引入了红黑树,其特点是近似平衡,确保从根到叶子节点的最长路劲不会超过最短路劲的两倍,其操作是通过变色和旋转来实现平衡等。在这里点到为止,想要学习AVL、红黑树等,就需要学习 Map 和 Set,这些都会在后面学习到。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 31
 0
- 0


 已为社区贡献1条内容

所有评论(0)