《零基础学机器学习》学习笔记(一)
·
书名《零基础学机器学习》
作者黄佳 人民邮电出版社 出版
1 引子
1.1 机器学习的家族谱
1.1.1 从数据中发现规律
机器学习:通过已知数据集,选择最优模型描述特征(自变量x1,x2,...,xnx_1, x_2, ..., x_nx1,x2,...,xn)与标签(因变量yyy)的关系。
- 训练阶段:使用1000组钻石数据(含特征与价格)训练模型。
- 测试阶段:将模型应用于新钻石数据(无价格),预测其价格。
- 目标:最小化预测误差,直至找到最优模型。
1.1.2 机器学习的类别
按数据标签分类:
- 监督学习:依赖标签数据(如钻石价格)。
- 无监督学习:仅使用特征(如客户聚类)。
- 半监督学习:结合少量标签与大量无标签数据。
1.1.3 深度学习:神经网络的崛起
深度学习通过人工神经网络(ANN)自动提取特征,无需手工设计(如传统方法需预定义“数字8有两个圈”)。
- 优势:直接处理非结构化数据(如图片32×32像素矩阵→数字“8”)。
- 应用:同步完成特征提取与分类(如猫狗识别)。
1.1.4 强化学习:从奖惩中学习
强化学习:智能体在封闭环境中通过试错最大化累积奖励(如AlphaGo围棋)。
- 与监督学习差异:
- 监督学习:数据标签明确对错(如“猫/狗”分类)。
- 强化学习:仅获奖励信号(如“输/赢”),需自主探索策略平衡(探索新动作 vs 利用已知经验)。
1.1.5 两大核心任务:回归与分类
| 任务类型 | 标签特点 | 示例 | 常用算法 |
|---|---|---|---|
| 回归 | 连续值 | 房价预测、气温预报 | 线性回归、神经网络 |
| 分类 | 离散类别 | 邮件垃圾检测、猫狗识别 | 逻辑回归、决策树、神经网络 |
扩展:
- 多标签分类:单样本关联多个标签(如照片自动标注多人名)。
- 推荐系统:用户-商品多维关联(如“用户A可能喜欢商品X、Y、Z”)。
1.1.6 其他应用场景
- 聚类:无监督发现数据内在结构(如用户分群)。
- 降维:压缩高维数据(如PCA可视化)。
- 生成模型:创建新数据(如GAN生成图像)。
1.2 基本机器学习术语
表1-1 机器学习基本术语一览
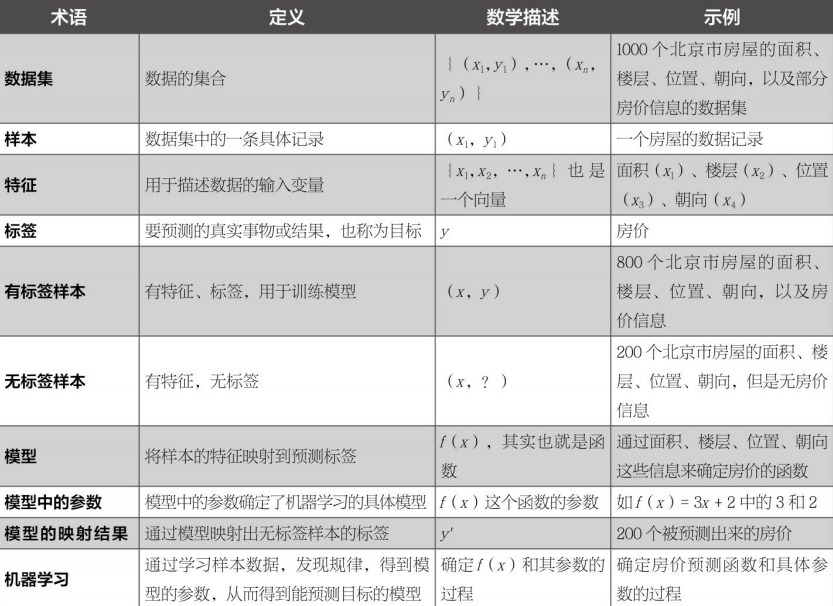
1.2.1 特征(Feature)
- 定义:模型的输入变量,用于描述样本的属性。
- 维度:指特征的数量(≠样本数)。
- 低维:可仅 1 维,如“面积→房价”。
- 高维:100 px×100 px RGB 图像共 30 000 维(100×100×3)。
- 数据结构:
单个样本的特征记为向量 x=(x₁, x₂, …, xₙ),n 即特征维度。
为避免与“张量阶数”混淆,后文用“阶”表示数组维度:
1D 向量、2D 矩阵、3D 张量等。
1.2.2 标签(Label)
- 定义:模型待输出的目标变量,记为 y。
- 类型:
- 真实标签 y:训练集中与样本同时给出。
- 预测标签 y′(y-hat):模型输出,用于与 y 比较以评估效果。
- 特殊情况:无监督学习不存在标签。
1.2.3 模型(Model)
- 定义:将特征映射到预测标签的函数 y′=f(x; θ)。
- 组成:
- 算法类型:先选定函数形式,如线性回归、神经网络。
- 参数 θ:通过训练数据学习得到,例如线性回归 f(x)=3x+2 中的 3 与 2。
- 训练目标:找到使损失函数最小的参数 θ。
1.3 Python 与机器学习框架
表1-3 八大量级库分类总览
| 类别 | 库名 | 核心作用 |
|---|---|---|
| 数据结构 | Pandas、NumPy | 提供表格/数组对象,支撑数值计算 |
| 可视化 | Matplotlib、Seaborn | 绘制静态、统计级图表 |
| 算法实现 | Scikit-learn、TensorFlow、Keras、PyTorch | 传统 ML 与深度学习建模 |
1.3.1 Pandas
import pandas as pd
- 定位:基于 NumPy 的高层次数据分析库。
- 核心数据结构
Series:1D 带索引数组。DataFrame:2D 表结构,行索引 + 列名,可直接喂入模型。Panel(已弃用):3D 容器,建议改用xarray。
- 典型流程:
read_csv→DataFrame→ 清洗 → 模型输入。
1.3.2 NumPy
- 定位:Python 科学计算底层库。
- 核心对象:
ndarrayn 维数组,支持向量化运算与广播机制。 - 性能:底层 C 实现,无缝调用 CPU/GPU 并行指令,加速 ML 训练。
1.3.3 Matplotlib
import matplotlib.pyplot as plt
- 定位:Python 2D 绘图基础库,提供类似 MATLAB 的 API。
- 用途:折线、直方、散点等基础图;可嵌入 GUI 或导出 PDF/SVG。
1.3.4 Seaborn
import seaborn as sns
- 定位:Matplotlib 的高级封装,专注统计可视化。
- 优势:一键绘制热力图、 pairplot、 violinplot,默认配色友好。
1.3.5 Scikit-learn
from sklearn.linear_model import LinearRegression
model = LinearRegression()
- 定位:统一接口的传统机器学习库。
- 功能链:预处理 → 特征选择 → 模型训练 → 交叉验证 → 指标评估。
- 算法覆盖:分类、回归、聚类、降维、模型选择等近 50 种算法。
1.3.6 TensorFlow
import tensorflow as tf
- 定位:Google 开源的深度学习符号式框架。
- 特点:
- 静态计算图(TF2 默认 eager)。
- 跨平台:CPU/GPU/TPU、移动端、WebAssembly。
- 适用:大规模部署与生产环境,但底层 API 学习曲线陡峭。
1.3.7 Keras
import tensorflow.keras as keras
- 定位:高级深度学习接口,现已集成至 TensorFlow 2。
- 优势:模块化、Pythonic、几分钟内搭建原型;后端可切换 TensorFlow/CNTK/Theano。
1.3.8 PyTorch
import torch
- 定位:Facebook 推出的动态图深度学习框架。
- 特点:
- 命令式编程,调试直观。
- 全部算法源码为 Python,易读易改。
- 生态:
torchvision、torchtext、Lightning等配套库完善,研究社区活跃。
选型建议
| 场景 | 推荐框架 |
|---|---|
| 快速传统 ML 原型 | Scikit-learn |
| 小规模深度学习实验 | Keras 或 PyTorch |
| 工业级大模型部署 | TensorFlow 或 PyTorch + TorchScript |
1.4 机器学习项目实战架构
1.4.1 环节1:问题定义
| 输出 | 模板 |
|---|---|
| 任务类型 | 分类 / 回归 / 聚类 / 强化 |
| 评价指标 | Accuracy、F1、RMSE、Return… |
| 资源约束 | 数据量、计算时限、延迟要求 |
例:MNIST
- 任务:10 类手写数字分类
- 指标:Top-1 Accuracy
- 约束:≤ 25 ms 单张推理延迟
1.4.2 环节2:数据工程(总结)
| 子步骤 | 关键动作 | 工具/API |
|---|---|---|
| 获取 | 开源、爬虫、私有库 | Kaggle、tensorflow_datasets |
| 向量化 | 图像→张量、文本→Token | tf.image、Tokenizer |
| 清洗 | 缺失、异常、重复 | pandas.dropna、scipy.stats |
| 缩放 | 标准化 μ=0,σ=1 或归一化 [0,1] | StandardScaler、MinMaxScaler |
| 特征工程 | 领域特征、降维、组合 | PCA、GBDT+LR、AutoEncoder |
| 划分 | 训练 / 验证 / 测试 或 K 折 | sklearn.model_selection.* |
MNIST 代码片段(精简)
from tensorflow.keras.datasets import mnist
(x_train, y_train), (x_test, y_test) = mnist.load_data()
x_train = x_train.astype("float32")/255          # 归一化 [0,1]
x_train = np.expand_dims(x_train, -1)            # (N,28,28,1)
y_train = tf.keras.utils.to_categorical(y_train, 10)
1.4.3 环节3:基线模型选择
| 算法族 | 适用场景 | 起点 |
|---|---|---|
| 线性 | 可解释强、特征少 | LogisticRegression |
| 树/集成 | 表格数据、非线性 | RandomForest、LightGBM |
| 神经网络 | 图像、语音、文本 | CNN、Transformer |
MNIST CNN 基线(Keras 函数式)
inputs = tf.keras.Input(shape=(28,28,1))
x = tf.keras.layers.Conv2D(32,3,activation='relu')(inputs)
x = tf.keras.layers.MaxPool2D()(x)
x = tf.keras.layers.Flatten()(x)
x = tf.keras.layers.Dense(128,activation='relu')(x)
outputs = tf.keras.layers.Dense(10,activation='softmax')(x)
model = tf.keras.Model(inputs,outputs)
model.compile(optimizer='adam',
              loss='categorical_crossentropy',
              metrics=['accuracy'])
1.4.4 环节4:训练 & 超参数初调
| 概念 | 一句话说明 |
|---|---|
| 内参 | 训练过程自动更新(权重、偏置) |
| 超参 | 需人工预设或搜索(学习率、Epoch、Batch、网络深度) |
MNIST 快速训练
model.fit(x_train, y_train,
          validation_split=0.2,
          epochs=5,
          batch_size=128,
          verbose=2)
输出示例
val_accuracy: 0.9842(5 Epoch,无需调参已达标)
1.4.5 环节5:评估、优化、上线
-
三集合原则
训练集 ←→ 验证集 ←→ 测试集(仅最终一次)
防止 Overfitting & Information Leak -
K 折交叉验证(小数据场景)
sklearn.model_selection.StratifiedKFold(n_splits=5) -
正则 & 增强 & 调参
- 正则:Dropout、L2、EarlyStopping
- 增强:
ImageDataGenerator(rotation_range=8) - 调参:Optuna、Keras-Tuner、BayesianOptimization
-
误差分析
绘制混淆矩阵 → 查看易混类别 → 针对性加数据或改模型
MNIST 最终评估
test_loss, test_acc = model.evaluate(x_test, y_test, verbose=0)
print(f"Test accuracy: {test_acc:.4f}")   # 0.9838
- 结果可视化
pred = model.predict(x_test[:1])
print("pred label:", pred.argmax())   # 7
plt.imshow(x_test[0].reshape(28,28), cmap='gray')
1.4.6 常见陷阱速查表
| 现象 | 可能原因 | 快速诊断 |
|---|---|---|
| 训练准确率高,验证低 | 过拟合 | 增数据、加 Dropout、降模型复杂度 |
| 训练&验证均低 | 欠拟合 | 增模型容量、减正则、调大学习率 |
| 验证与测试差距大 | 信息泄露 | 重分数据,确保测试集全程不可见 |
| 性能震荡 | 学习率过大 | 用余弦退火或 ReduceLROnPlateau |

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 20
 0
- 0


 已为社区贡献2条内容

所有评论(0)