登录社区云,与社区用户共同成长
邀请您加入社区
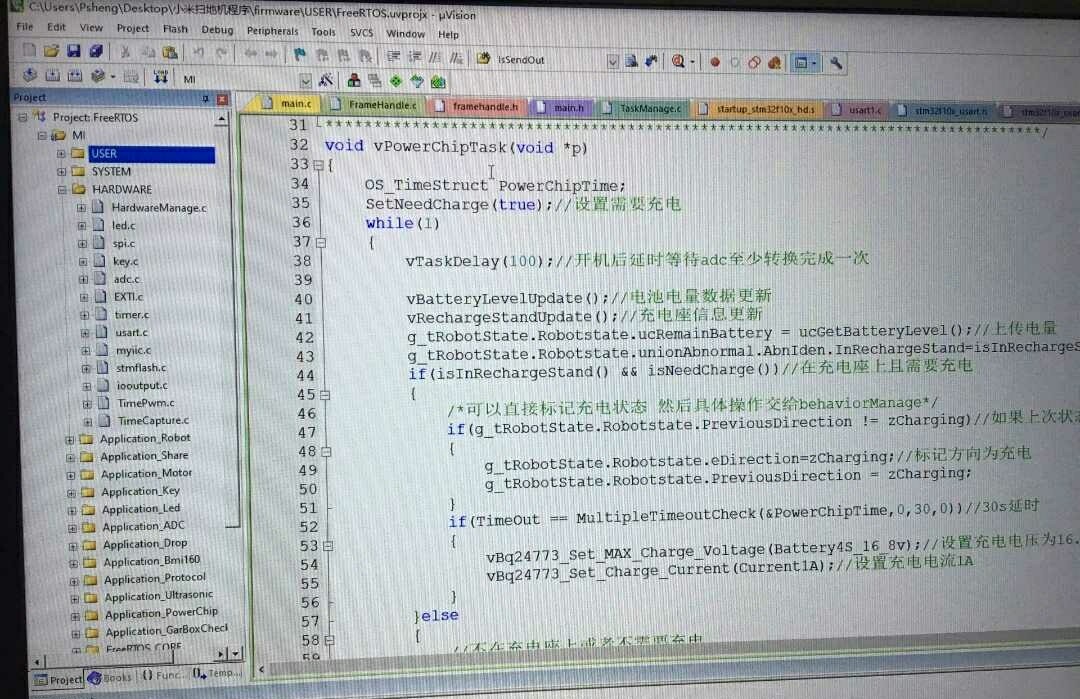
小米扫地机器人固件展现了典型的嵌入式实时系统设计范式:以 FreeRTOS 为调度核心,构建模块化、层次化的软件架构;通过严谨的异常检测与安全控制策略保障设备物理安全;利用高效的 IAP 机制支持远程升级;并设计轻量可靠的通信协议实现内外部数据交互。整个系统在性能、资源占用与功能完整性之间取得了良好平衡,为其稳定、智能的清扫体验提供了坚实的软件基础。
SparkML机器学习
易于使用:提供了丰富的 API,支持 Scala、Java、Python 和 R 等多种编程语言。高度可扩展:可以处理海量数据,适用于大规模机器学习任务。丰富的算法库:支持分类、回归、聚类、降维、协同过滤等常用算法。本文详细介绍了 Spark MLlib 的功能及其应用,结合实例演示了分类、回归、聚类、降维、协同过滤等常用机器学习任务的实现过程。通过这些实例,我们可以看到 Spark MLlib
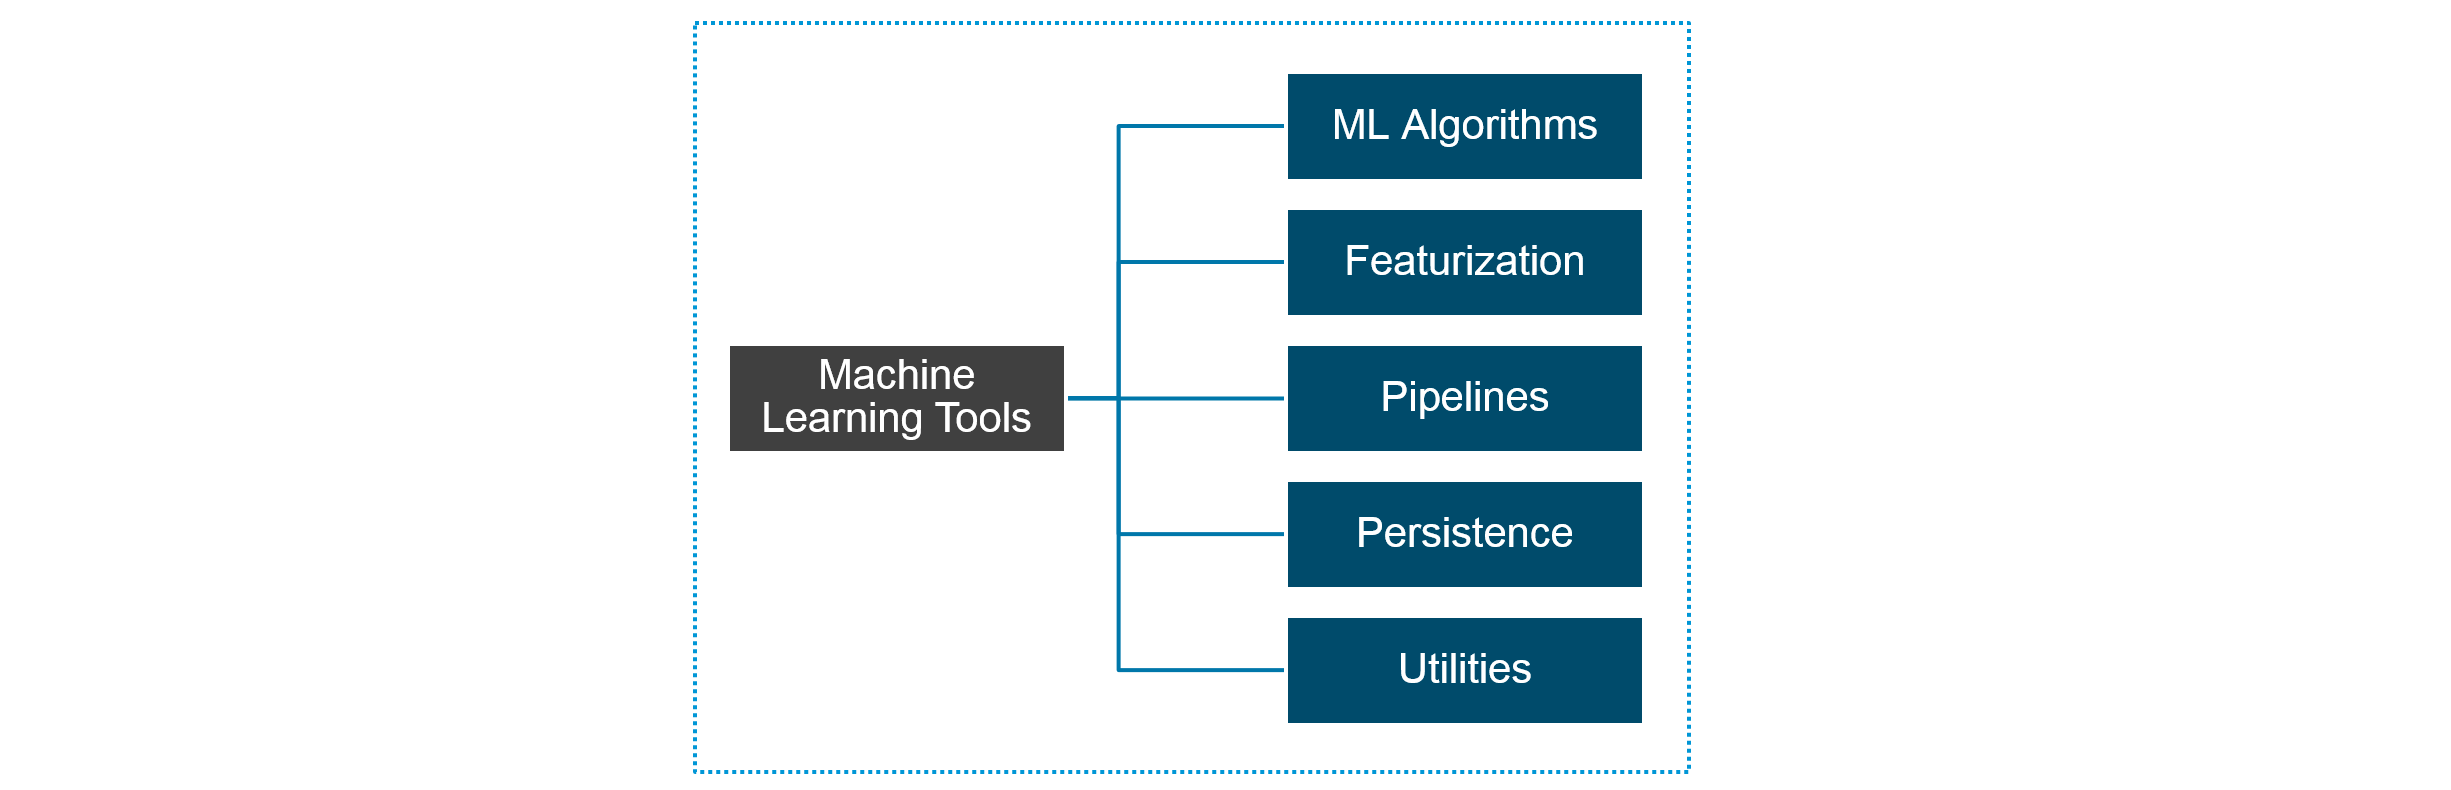
Spark MLlib提供了一套完整的机器学习流程支持,包括数据准备、特征工程、模型训练、评估和部署。核心是Pipeline API,将多个转换器和估计器串联成工作流。数据准备阶段通过DataFrame进行数据清洗和特征提取;特征工程阶段使用各种转换器进行特征编码、归一化和合成;模型训练支持分类、回归、聚类等算法;模型评估提供多种评估器;最后可将训练好的模型保存并部署用于预测。整个流程强调Data
大数据毕业设计hadoop+pyspark图书推荐系统 豆瓣图书数据分析可视化大屏 豆瓣图书爬虫 知识图谱 图书大数据 机器学习 计算机毕业设计 深度学习 人工智能 图书价格预测 图书评论情感分析
1.背景介绍Spark MLlib和Mllib是Apache Spark生态系统中的两个重要组件,它们分别负责机器学习和数据分析。Spark MLlib是一个用于大规模机器学习的库,它提供了许多常用的机器学习算法和工具,如梯度下降、随机梯度下降、支持向量机、决策树等。Mllib则是一个更广泛的机器学习库,它提供了许多其他的机器学习算法和工具,如聚类、主成分分析、线性回归等。在本文中,我们将...
随着数据量的爆炸式增长,如何有效地利用机器学习技术从海量数据中挖掘价值,成为了业界关注的焦点。传统单机机器学习方法在面对TB甚至PB级别的数据时,往往显得力不从心。本篇文章将深入探讨将机器学习应用于大规模数据集所面临的挑战,介绍主流的大数据处理框架(特别是 Apache Spark 及其 MLlib 库),解析分布式训练的核心策略,并展望云平台如何为大数据机器学习提供强大的支持。