GLOW:一种面向通用具身智能的生成式学习框架
26年9月来自诺因智能博客的文章“GLOW: A Generative Learning Framework for General-Purpose Embodied Intelligence”。
GLOW 最值得关注的是“物理经验如何转化为可复用的机器人能力”这一系统设计;但博客提供的证据,还不足以确认其核心算法优势和泛化边界。 应区分三件事:作者提出的框架、展示出来的系统能力,以及实验真正证明了什么。
1.方法要点与模型框架
其系统架构图如下:
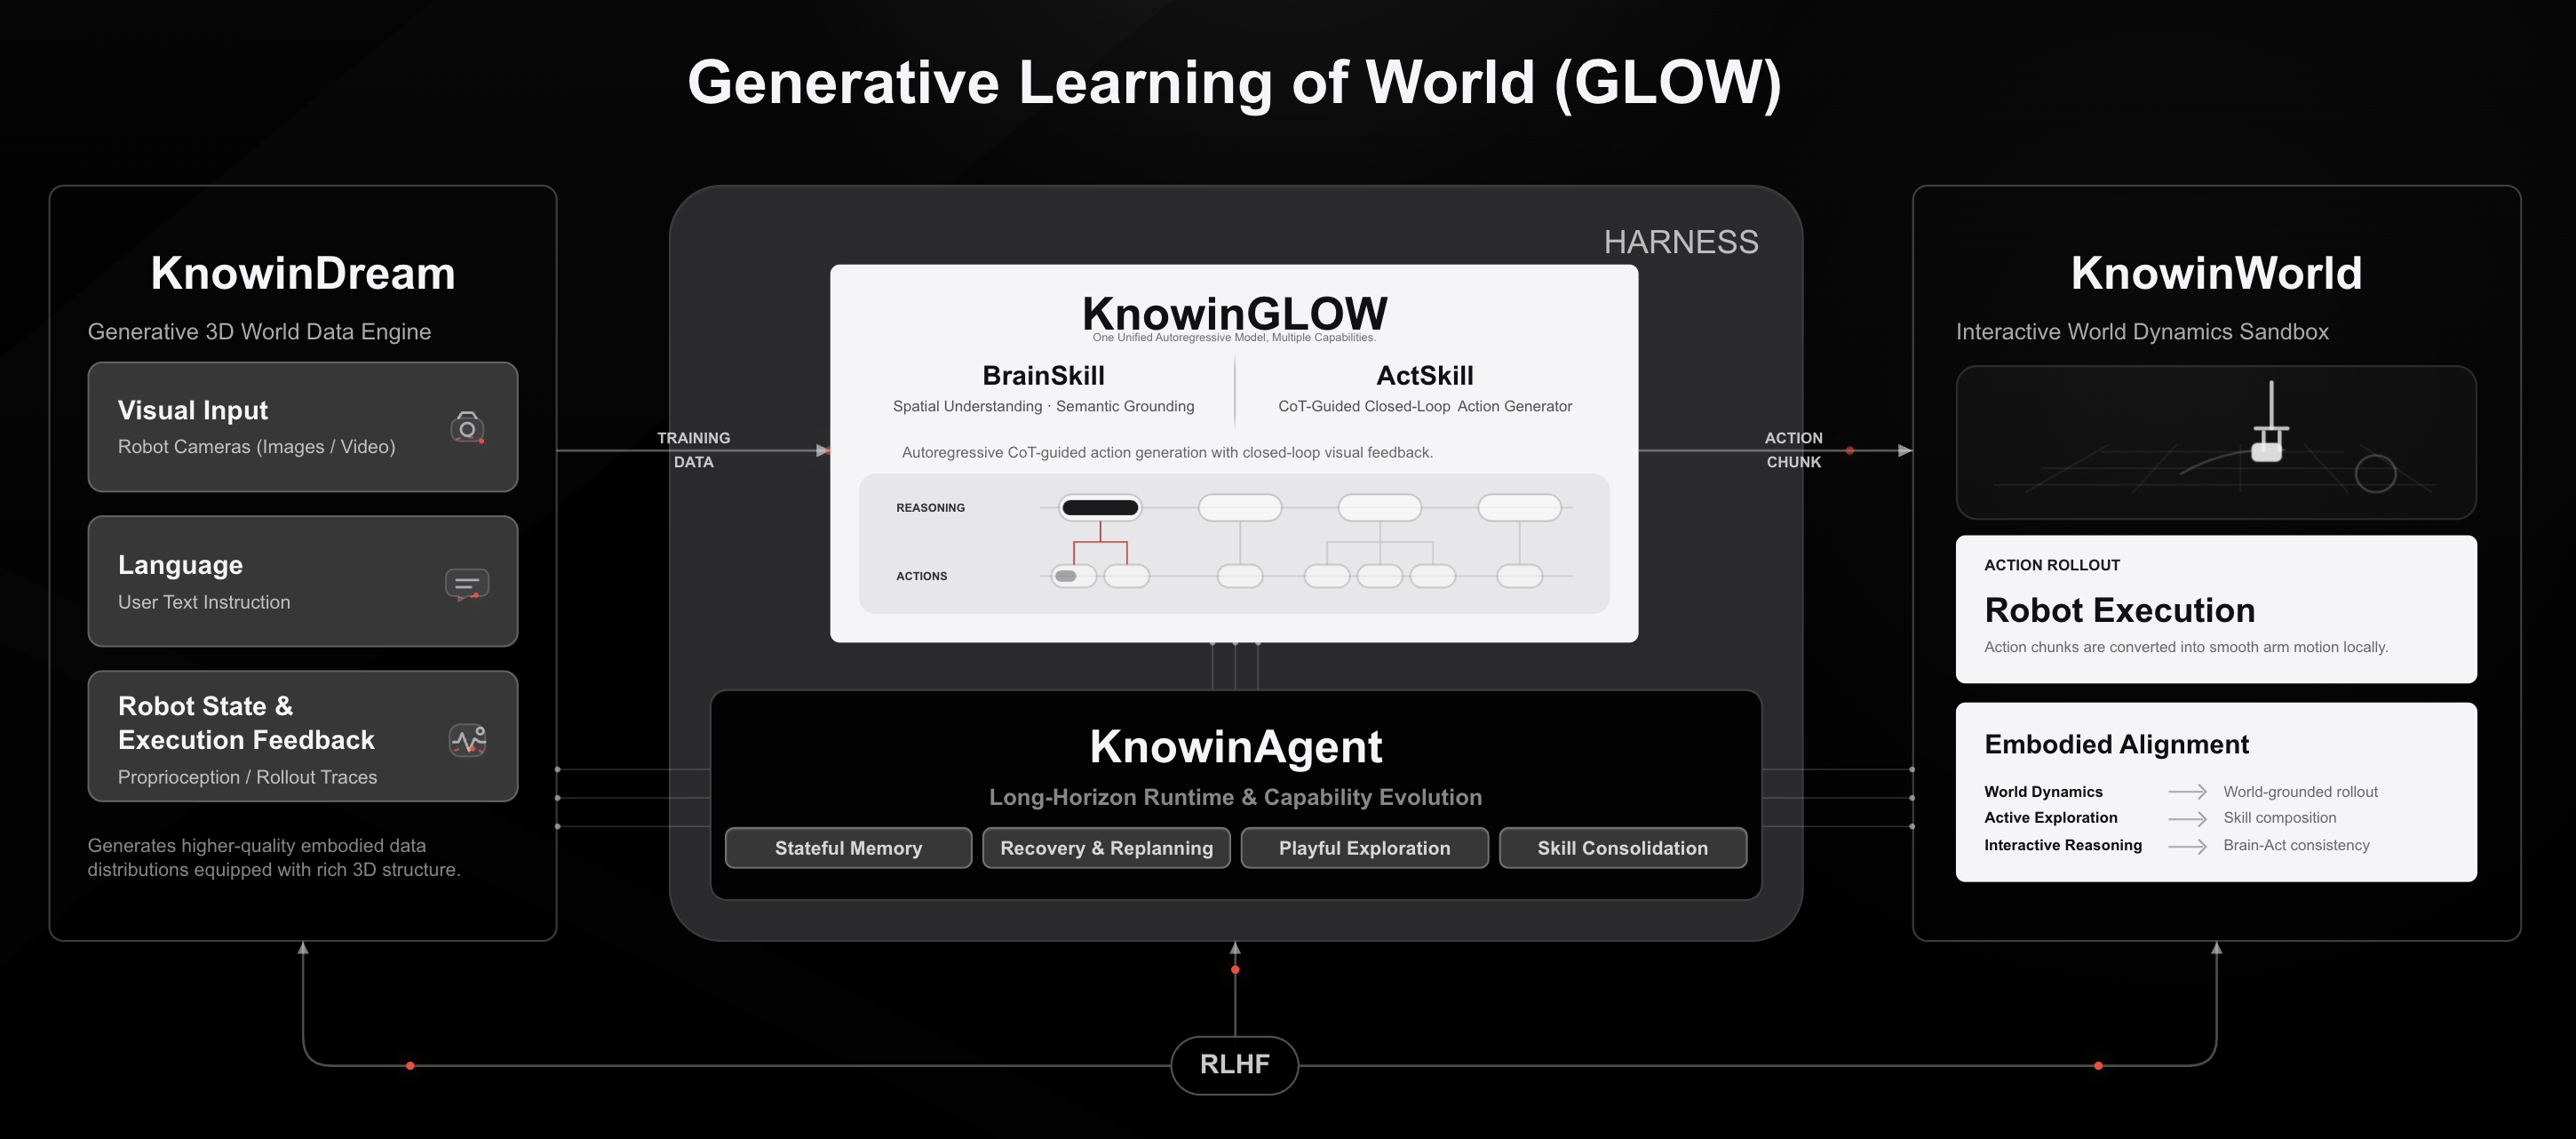
GLOW(Generative Learning of World)包含四个主要模块:
| 模块 | 原文描述的作用 |
|---|---|
| KnowinDream | 生成家庭场景及物理交互经验 |
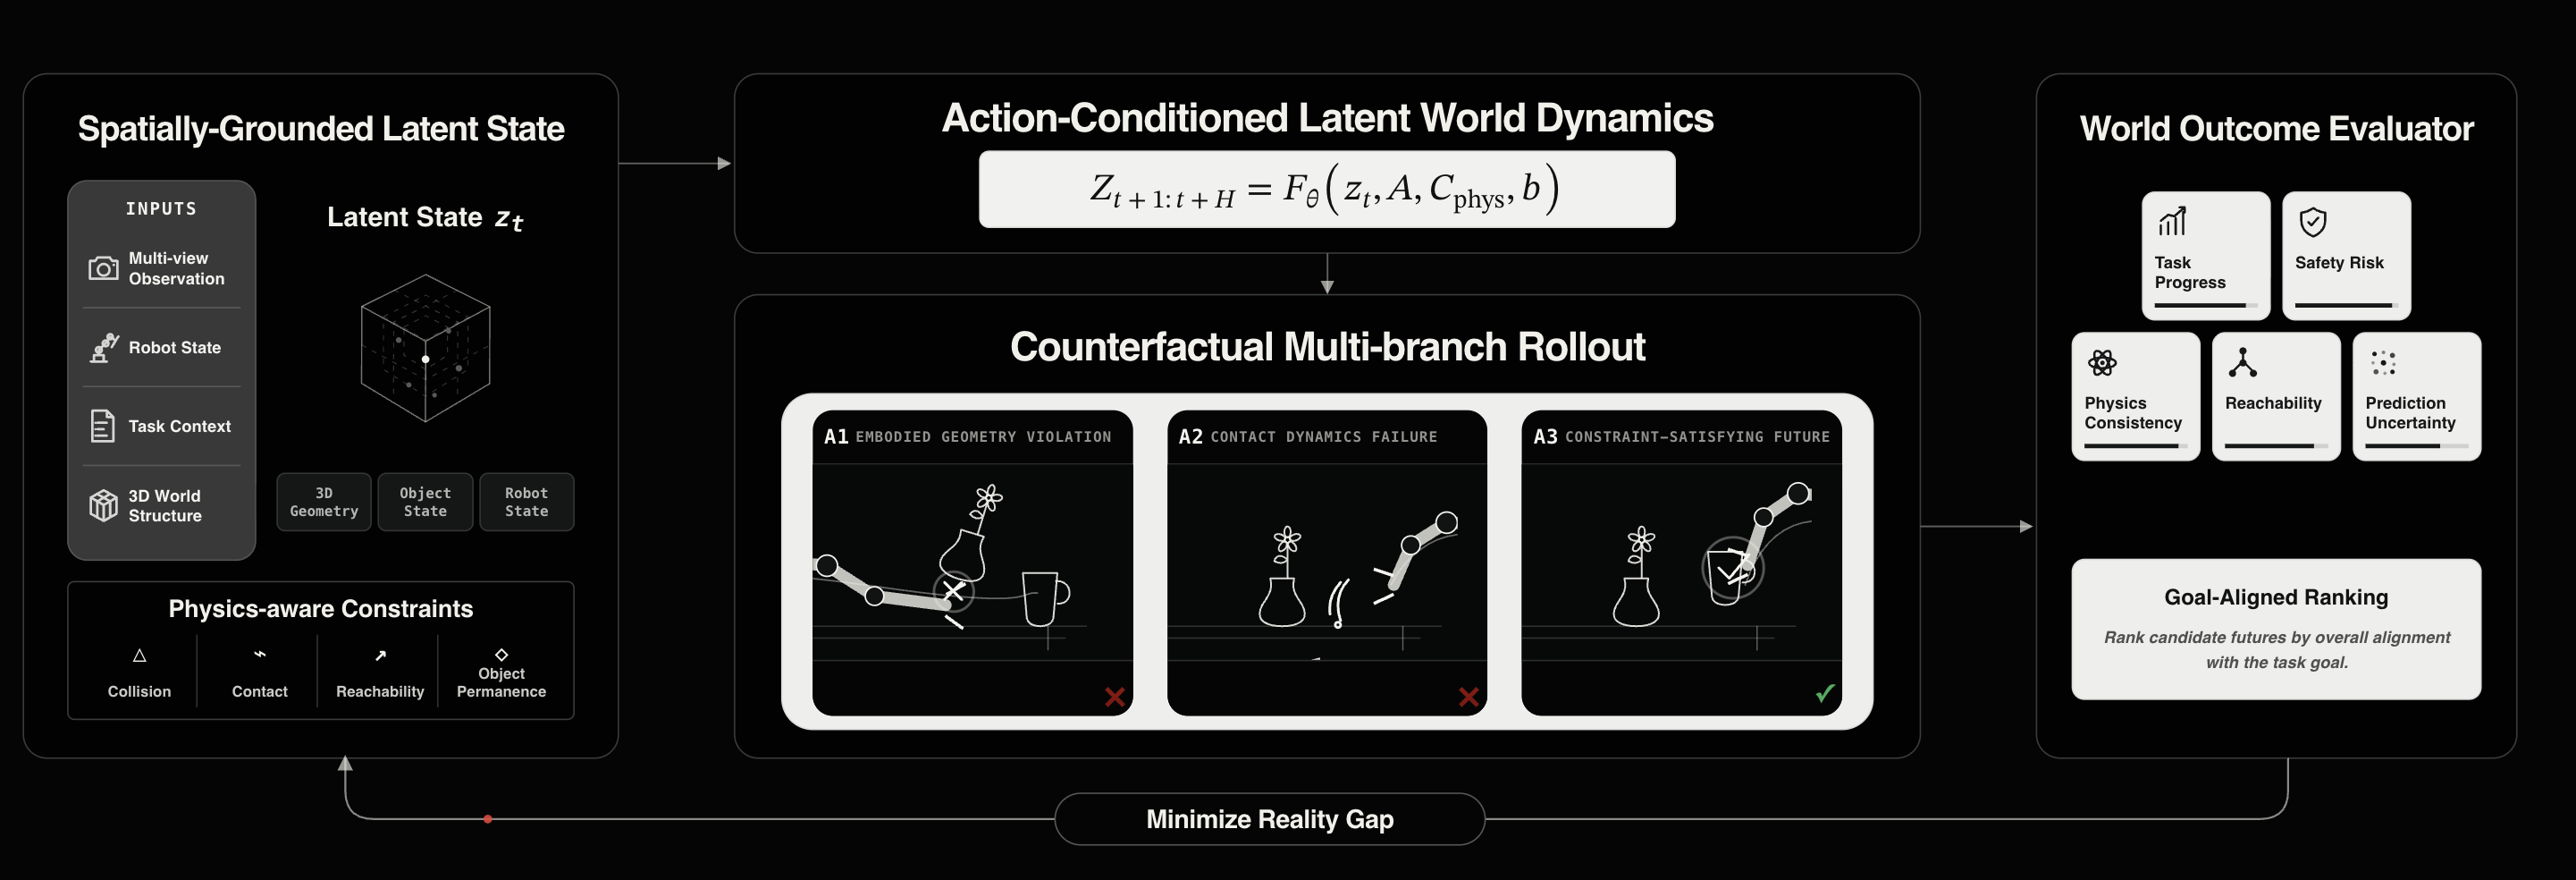
| KnowinWorld | 根据候选动作预测后果、比较未来分支 |
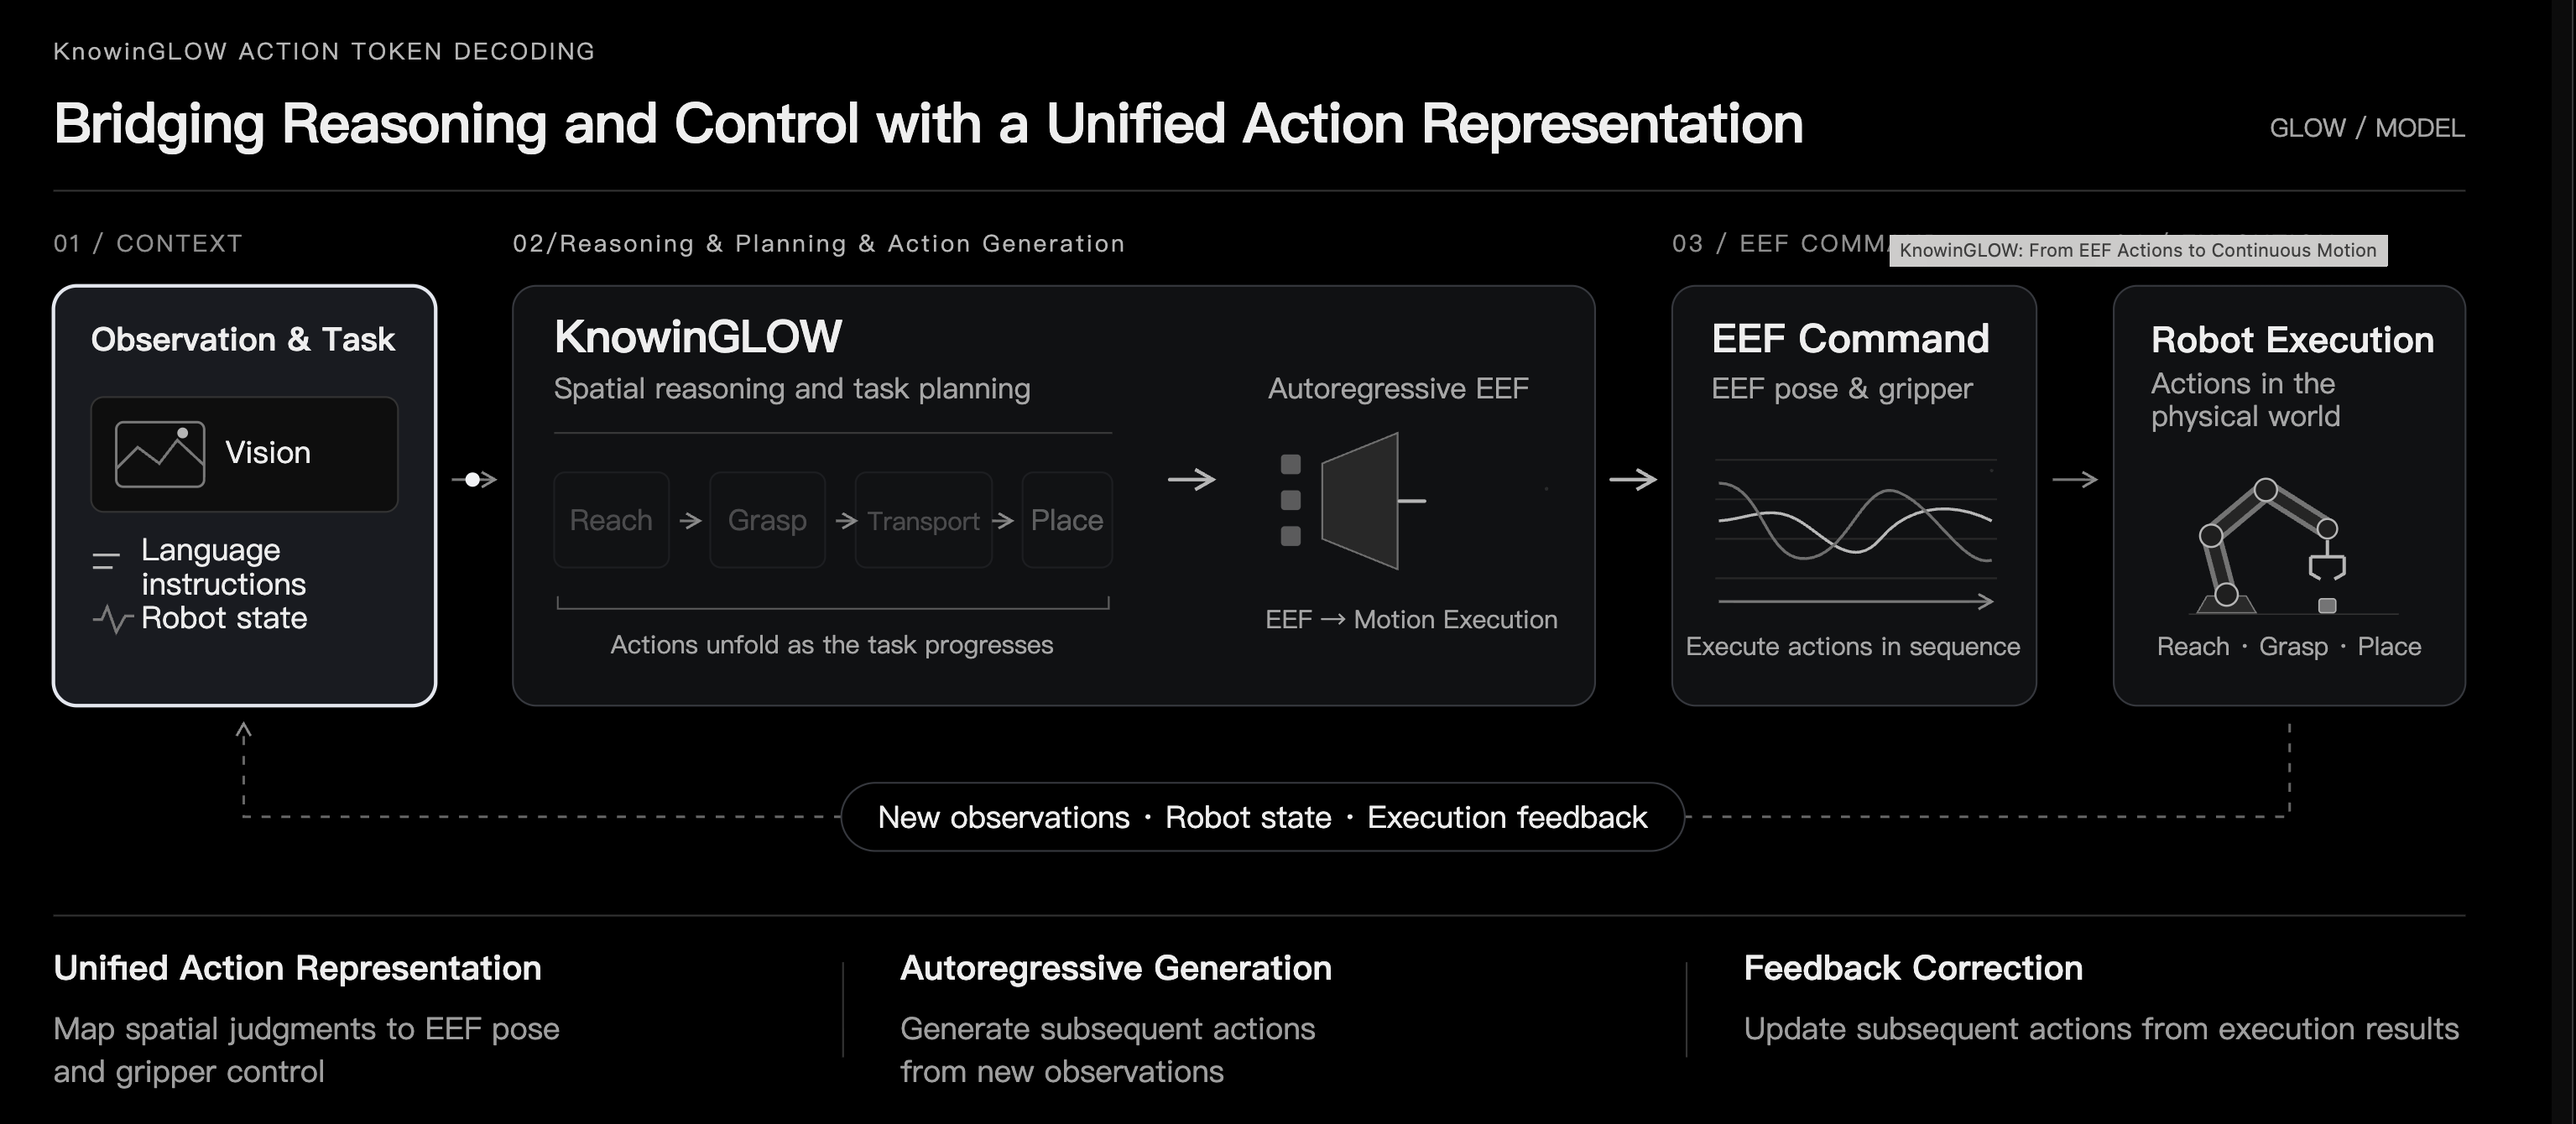
| KnowinGLOW | 统一的多模态自回归模型,生成理解、规划及末端执行器动作 |
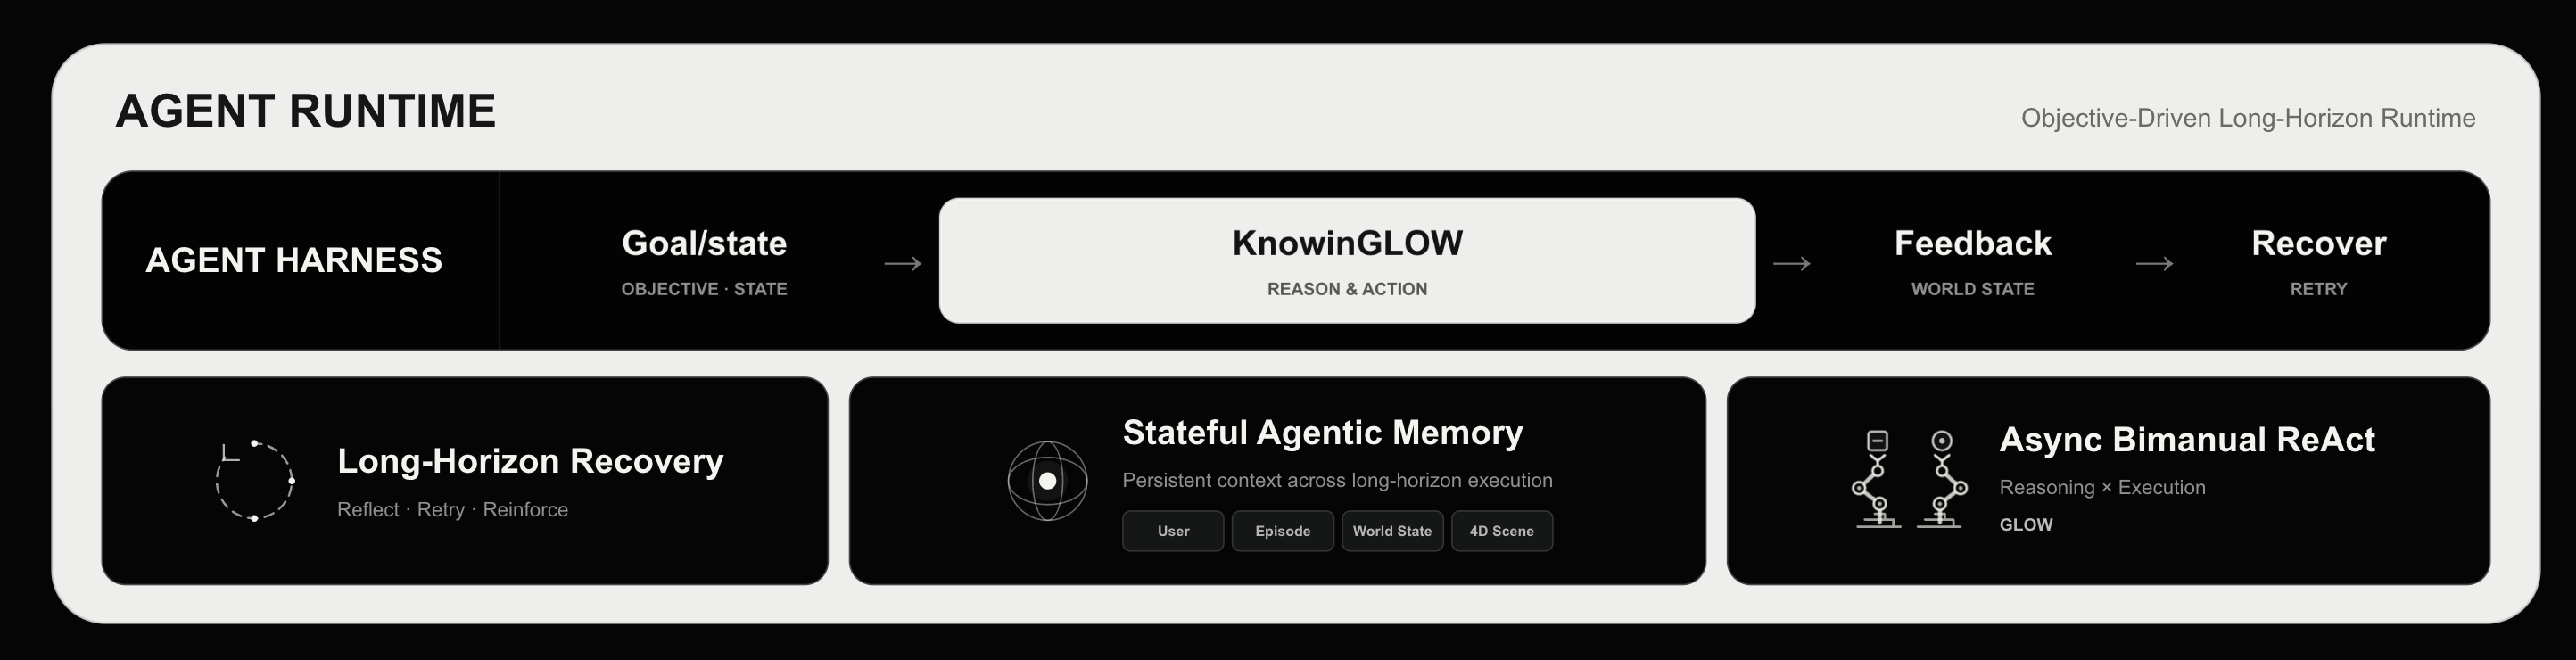
| KnowinAgent / Harness | 管理工具、记忆、执行反馈与重规划 |
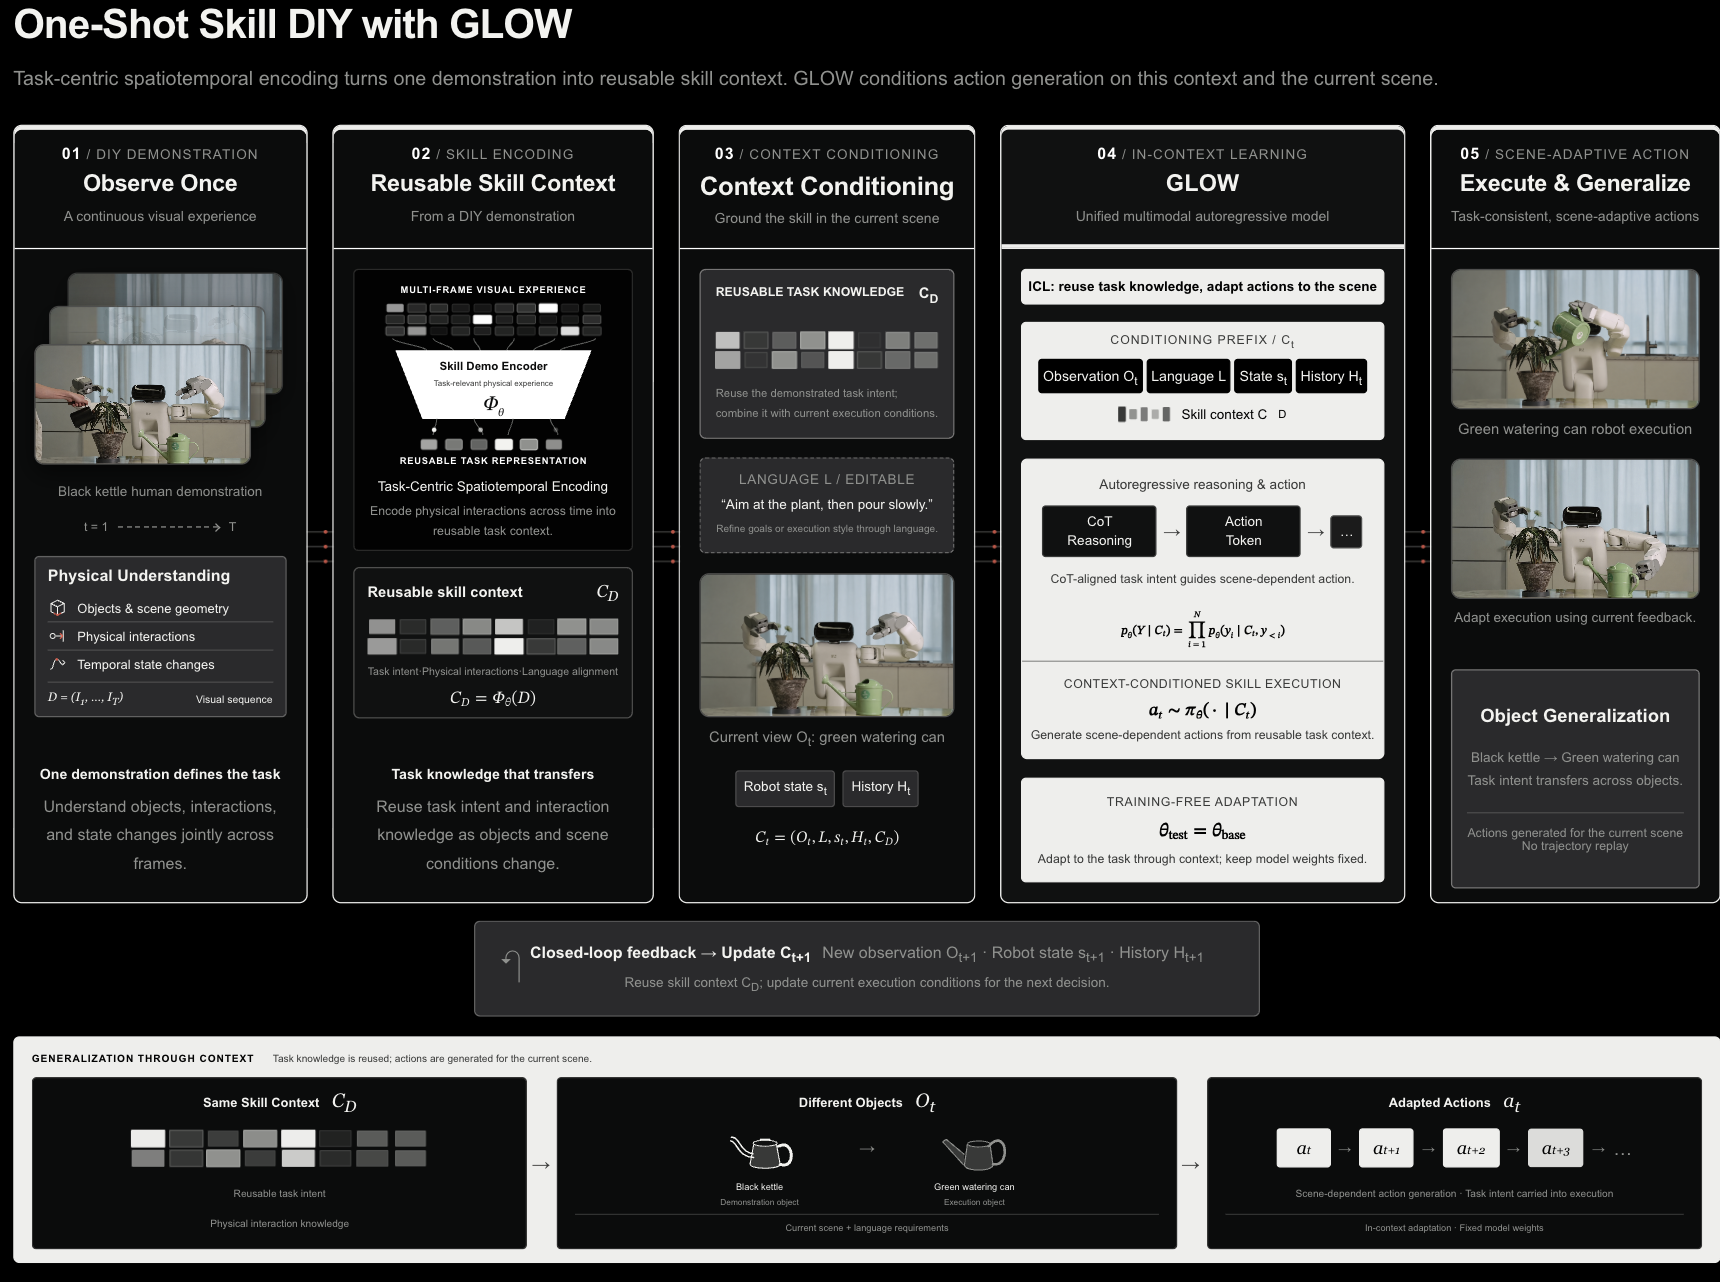
训练侧通过 Experience Compiler 将交互经验组织成多种监督;执行侧将示范编码为技能上下文,结合现场观测生成动作,单次示教期间不更新模型权重。
从功能上,这一设计理解为如下框架:
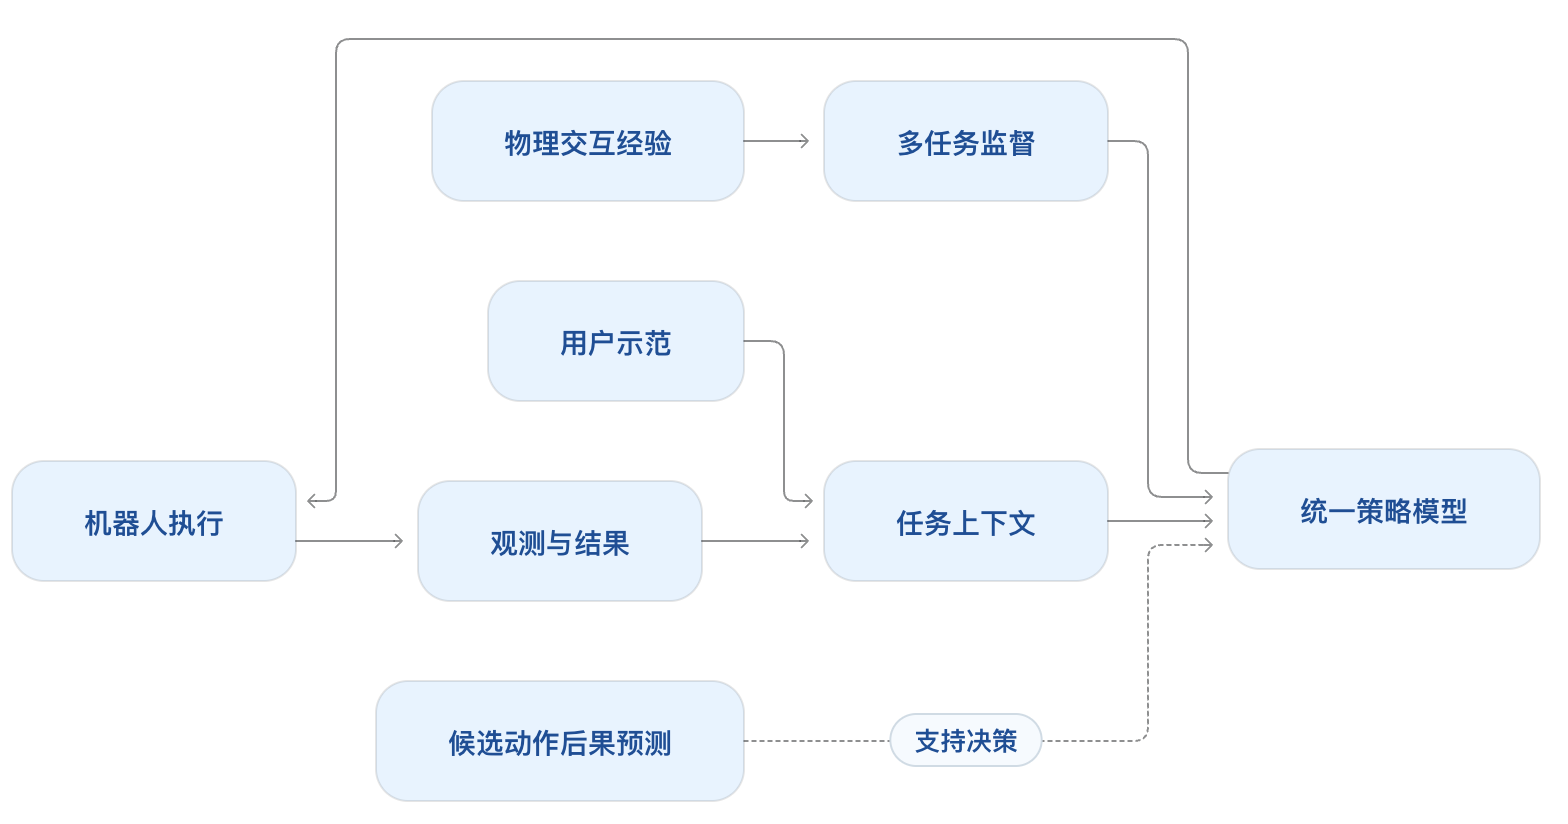
KnowinDream的主要三个引擎是:
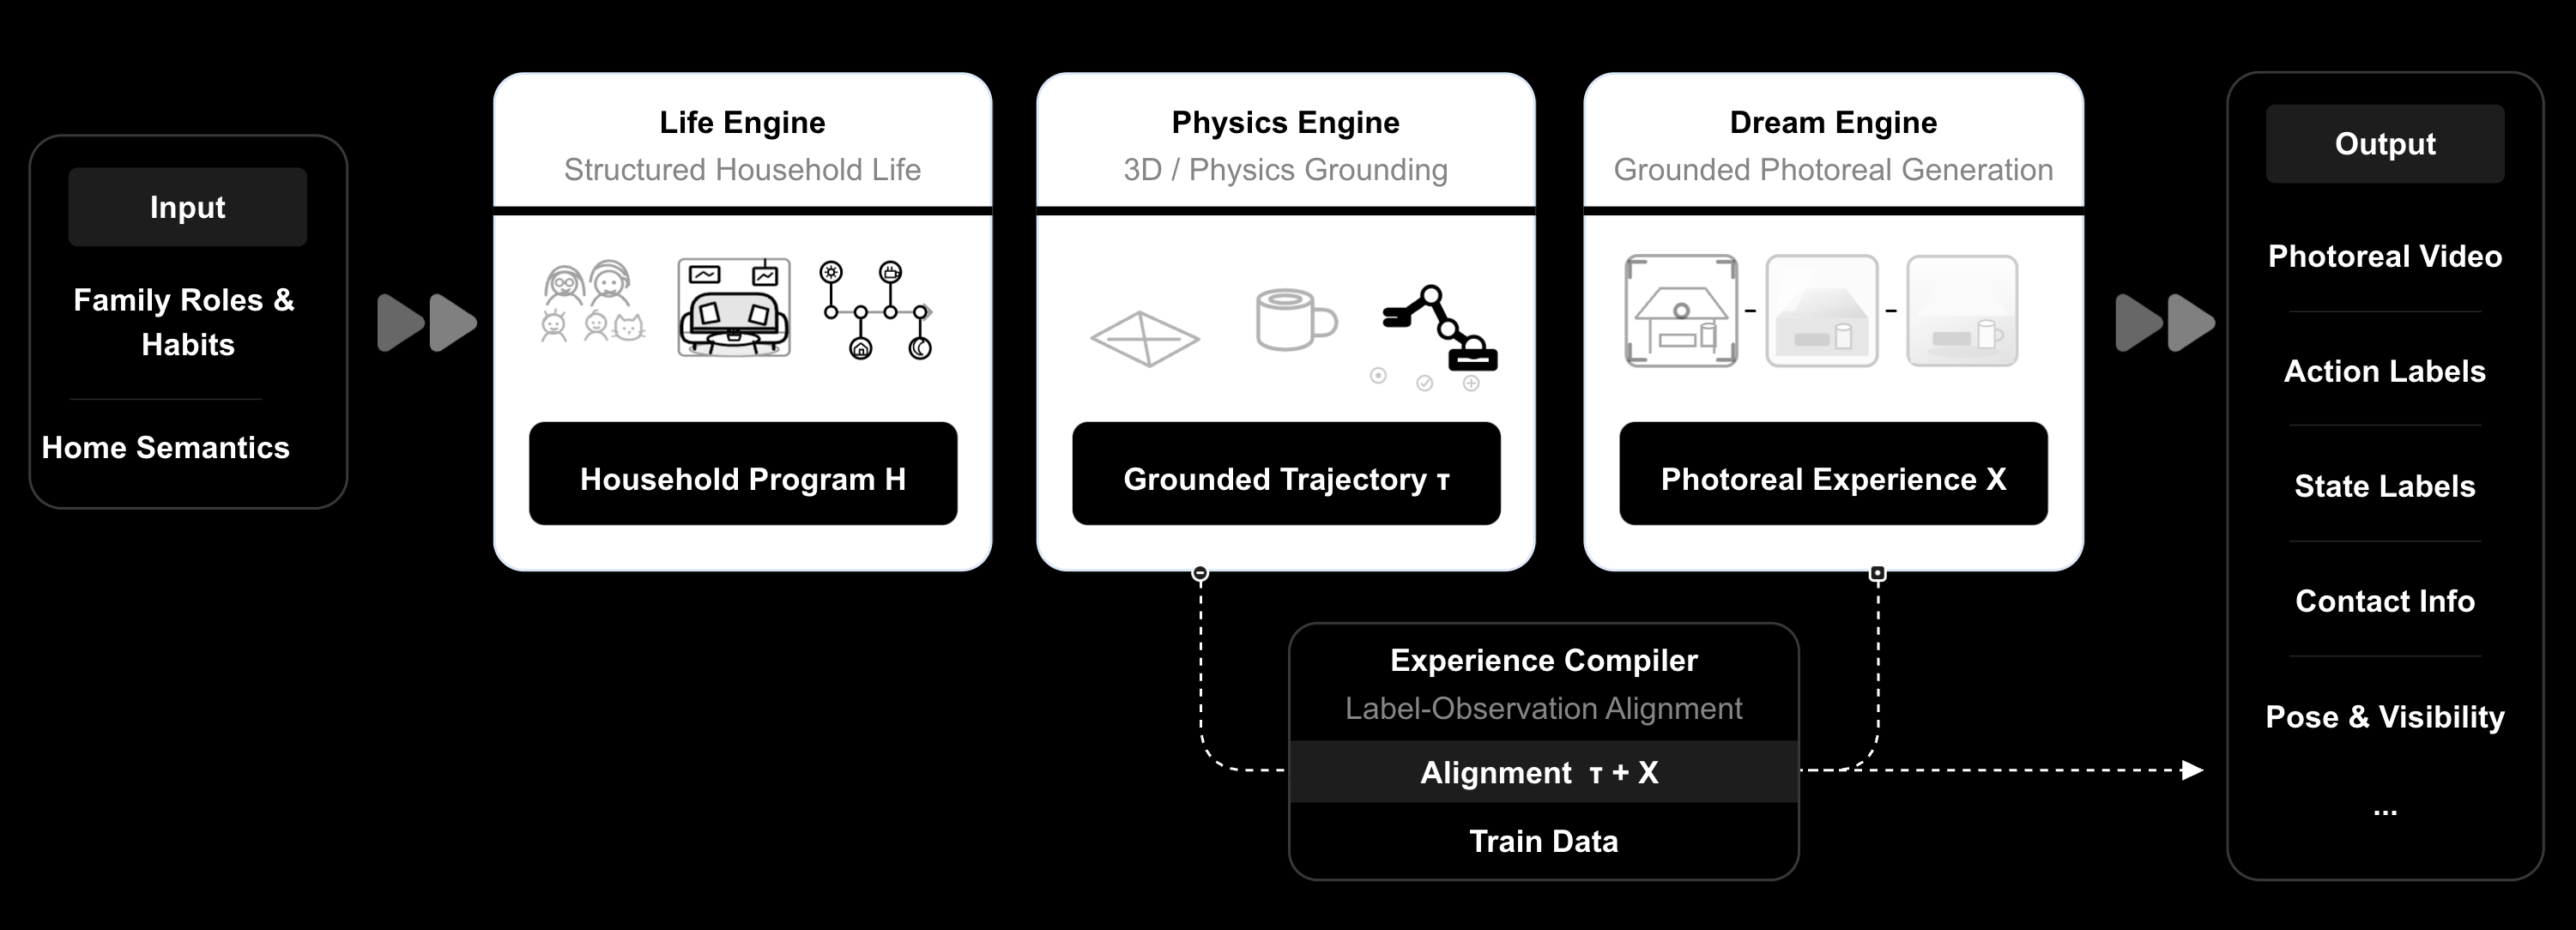
KnowinWorld的框架如下所示:
KnowinGLOW的框架如下所示:
还有其构建的一个智能体驾驭KnowinAgent,如图所示:
最后是使用GLOW的机器人上下文学习框架,如图所示:
这里有两个值得把握的区别:
- 训练阶段学能力,部署阶段用示范指定任务。 “看一次就会”可能意味着把已有能力组合成新流程,也可能意味着学会新的动作规律,两者的难度和证据要求完全不同。
- 统一模型不等于整个系统没有模块。 评估时仍应区分策略本身、几何工具、运动控制器与任务管理机制各自的贡献。
附上其提到的参考文献:
[1]Google DeepMind. Gemini Robotics 1.5: Pushing the Frontier of Generalist Robots with Advanced Embodied Reasoning, Thinking, and Motion Transfer. 2025. [Technical Report]
[2]Physical Intelligence. π₀.₅: A VLA with Open-World Generalization. 2025. [Technical Report]
[3]Figure AI. Helix 2.5: Zero-Shot 30-Home Generalization. 2026. [Technical Report]
[4]NVIDIA. GR00T N1: An Open Foundation Model for Generalist Humanoid Robots. 2025. [Technical Report]
[5]ByteDance Seed Robotics. GR-3 Technical Report. 2025. [Technical Report]
[6]Skild AI. Introducing S1: In-Context Learning for Robotics. 2026. [Technical Report]
[7]Physical Intelligence. π₀.₇: A Steerable Model with Emergent Capabilities. 2026. [Technical Report]
[8]Generalist AI. GEN-1.5: Embodied Foundation Models are One-Shot Learners. 2026. [Technical Report]
2.可能的贡献在哪里?
有三个值得验证的贡献假设。
第一,让同一份交互经验同时约束感知、预测与行动。
机器人可能“能描述物体在哪里,却不知道怎样抓”;也可能“能模仿抓取,却无法判断为什么失败”。如果不同训练目标共享一致的交互记录,就有机会减少这些能力之间的脱节。真正重要的指标是:加入理解或预测监督后,动作成功率是否提高,而不只是问答成绩提高。
第二,用动作后果的差异学习选择,而不仅学习模仿。
成功示范告诉模型“这样做可以”,同一起点下的不同动作结果则有机会告诉模型“为什么选这个动作”。但生成多个未来本身不能证明模型掌握因果关系;需要测试它能否预测未见过的干预结果。
第三,将示教变成可复用的任务接口。
这对产品很有价值:用户可以展示难以用语言完整表达的操作。但研究上的关键问题是,示范究竟提供了额外的运动信息,还是仅帮助识别任务名称。
这些方向并非 GLOW 独有。GR00T N1 已采用真实、合成及人类视频数据,并结合视觉语言模块与动作模块;Skild S1 也明确研究视频示范驱动的上下文学习。因此,GLOW 的创新性需要落在具体的数据组织、训练机制和可验证增益上。
3.实验应该怎样解读?
作者报告 RoboDojo 成功率为 62.2%、LIBERO-Pro 为 86.7%。后者在文中单策略组居首,但低于表内最强混合策略系统的 97.3%;原文还说明,部分演示触发成功判定时物体仍在夹爪中。
可以解读为:这些结果支持继续研究这条路线,但不能直接推出“通用机器人能力已经成立”。
尤其需要防止三个推论跨越:
- 系统分数高 → 基础模型更强: 若工具、观测信息或重试预算不同,差距可能来自系统配置。
- 仿真成功 → 真实环境可靠: 接触误差、传感器噪声和物体属性变化,可能改变失败模式。
- 一次示范完成任务 → 学会全新技能: 也可能是在调用预训练已掌握的动作,再重新排列步骤。
4.主要问题与技术风险
| 问题 | 为什么重要 | 怎样验证 |
|---|---|---|
| 性能来源难分解 | 数据、模型、工具和反馈都可能提升结果 | 固定其他条件,逐项消融 |
| 世界模型可能产生乐观预测 | 策略可能选择预测中成功、现实中失败的动作 | 比较预测与真实后果,尤其检查接触阶段 |
| 示范可能被当成任务标签 | 系统可能忽略示范中的关键操作差异 | 相同场景、不同示范,要求执行不同规则 |
| 合成经验覆盖不足 | 视觉多样性不等于物理多样性 | 改变摩擦、质量、柔性、关节阻力等属性 |
| 自回归生成的控制成本 | 推理等待可能使观测过时 | 测量端到端延迟、有效控制频率和动态任务表现 |
| 长任务的错误累积 | 单步可靠不代表整条任务链可靠 | 测量完整任务成功率及自动恢复率 |
其中最关心世界模型的不确定性。假设模型对两条路线都预测成功,其中一条涉及陌生接触,另一条虽然慢却更熟悉,系统应如何选择?若只按预测的任务进度排序,就可能偏好不可靠分支。需要让预测置信度真正影响动作选择,而不只是输出一个附加分数。
另一个重点是记忆中的事实是否仍然有效。机器人记住“杯子在桌上”并不够,还应知道这是何时看到的、之后是否发生过遮挡或人为移动。这会直接影响它是否需要重新观察。
5.未来最值得做的下一步
按以下优先级推进。
优先级一:建立能够解释结果的消融实验。
在相同数据量、算力、工具和执行预算下,比较:
- 基础策略;
- 加入合成交互经验;
- 加入动作后果预测;
- 加入示范上下文;
- 加入记忆与恢复机制。
还要将世界模型的训练数据贡献与在线规划贡献拆开。前者有效,并不意味着部署时运行世界模型也划算。
优先级二:严格验证单次示教。
将测试分为四层:新物体、新空间配置、已知技能的新组合、全新动作原语。加入无示范、错误示范、打乱顺序的示范,以及仅提供文字描述等对照。
最有说服力的案例是:现场物体和语言指令相同,只有示范中的规则不同,机器人就能稳定执行不同操作。 这样更容易证明它确实在利用示范信息。
优先级三:让世界模型指导“先看清楚,再行动”。
将移动相机、试探抓取、轻微推拉也作为候选动作;除了衡量任务进展,还衡量它们能减少多少不确定性。这能把预测能力转化为主动感知和更稳健的接触决策。
优先级四:建立真实环境中的可靠性评测。
不仅统计成功率,还统计:
- 无人工干预的完整任务完成率;
- 含推理等待的实际耗时;
- 放手后的稳定性;
- 失败恢复率和恢复成本;
- 新家庭、新物体、新机器人上的性能下降。
最优先做的是:“严格的新技能单次示教测试+模块消融”。 它能同时回答最关键的两个问题:GLOW 到底从示范中学到了什么,以及成功究竟来自哪里。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献462条内容

所有评论(0)