代码评审门禁中的 AI 角色定位:建议者而非裁决者的最佳边界
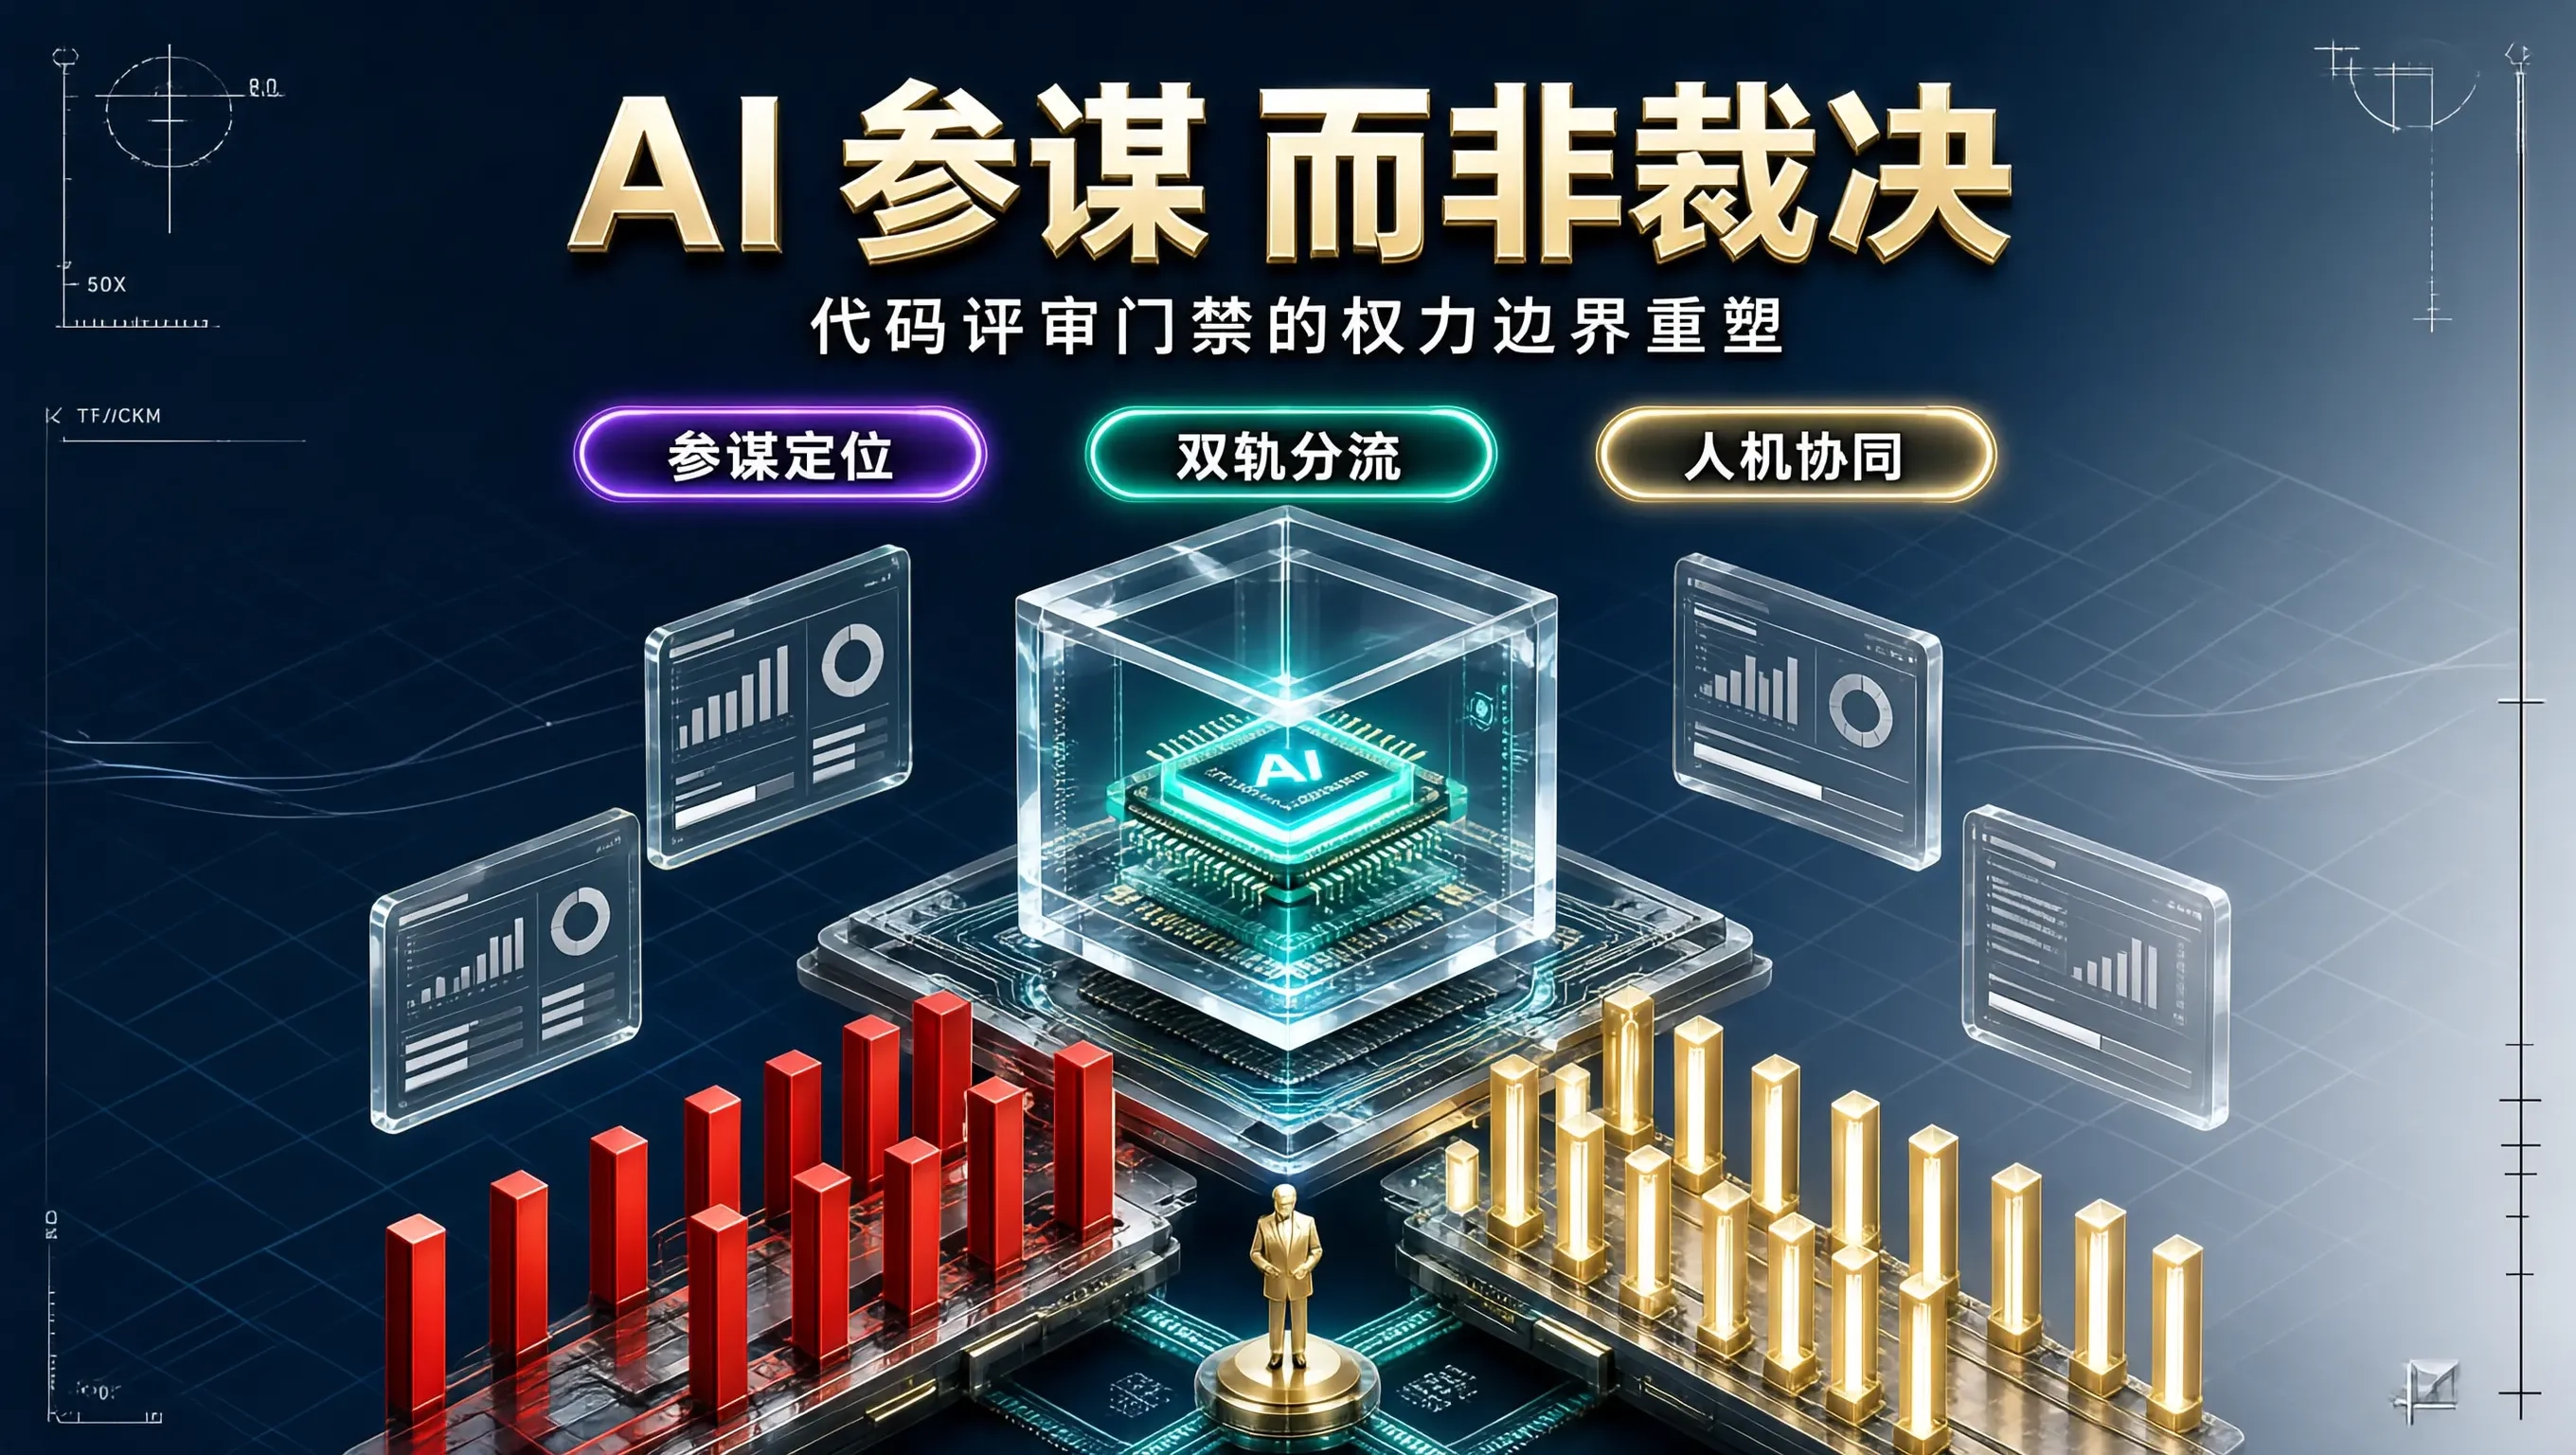
在推动研发效能智能化的进程中,引入“AI 自动化代码评审机器人(AI Code Review Bot)”往往被很多技术管理者视作提升大仓代码质量的杀手锏。
然而,在不少激进推进的团队中,这场变革很快演变成了一场严重的协作危机:管理层为了追求所谓的“零缺陷上线”,直接在持续集成流水线中赋予了 AI 评审机器人一票否决权(Block Merge Permission)。只要 AI 在评审报告中给出了“需改进”的判定,PR 便被系统强制锁定,严禁合入主干。
随之而来的,是一线工程师铺天盖地的怨声载道:
- 针对一个简单的临时运营活动页面,AI 喋喋不休地要求开发者“遵循 DDD 严格六边形架构拆解成 5 个包”;
- 针对一个在特定场景下经过精密压测的无锁局部变量,AI 机械地判定为“潜藏并发竞态”并粗暴阻断;
- 开发者为了让代码能够顺利合入,被迫花费数个小时在评论区撰写各种讨好模型的长篇大论,甚至为了迎合 AI 的死板规则把原本简洁的代码改得臃肿不堪。
这种将 AI 奉为“最高法官”的懒政设计,不仅严重破坏了工程师的心理安全感,更是将高效的代码评审异化为了一场令人筋疲力尽的“人机对抗赛”。
如何定义 AI 在代码评审流水线中的真实角色?我们在经历了大促备战的反复试错后,总结出了一条核心军规:AI 必须是敏锐的“全能参谋与建议者(Advisor)”,而绝不能越俎代庖成为握有生杀大权的“终审裁决者(Arbiter)”。
为什么 AI 永远无法成为终审法官?
大模型在阅读单次 PR 代码时,存在三个天然无法克服的物理与认知边界:
- 宏观业务上下文的不可见性(Business Blindspot):
一段代码之所以写成某种看似“不规范”的妥协形态,背后往往隐藏着复杂的商业权衡:可能是为了配合某个明天就要全网发布的营销活动做的临时硬编码、可能是为了规避某个外部老旧银行系统的陈年 Bug 做的特殊兼容。这些隐藏在工程师脑海中的隐性常识,AI 无论上下文窗口多大,都无法在冷冰冰的 Git Diff 中自行推导。 - 缺乏对“后果与责任”的终极承担力(Lack of Accountability):
如果在评审时,AI 强烈建议工程师将一个同步事务重构为复杂的异步事件驱动,工程师照做后在双 11 零点发生了严重的资金对账混乱,谁来对故障负责?是给建议的模型,还是签字批准的人类架构师?权力和责任必须对等。没有兜底责任的主体,绝对不应被赋予排他性的裁决权。 - 主观工程审美的无休止发散:
在变量命名、目录组织、函数长短等非功能性领域,软件工程本身就存在大量的流派与偏好。让一个基于概率分布训练出来的统计模型去裁决“这个命名是否足够优雅”,必然会引发无数没有标准答案的哲学口水战。
权力的重塑:硬性阻断红线与软性建议边界
一个健康的智能评审体系,必须在“机器确定性规则”与“人类领域裁决”之间划出一条黑白分明的楚河汉界:
                      [Pull Request 发起]
                               │
                               ▼
        ┌─────────────────────────────────────────────┐
        │       AI 智能评审流水线触发双轨分析          │
        └─────────────────────────────────────────────┘
                               │
            ┌──────────────────┴──────────────────┐
            ▼                                     ▼
   【硬性阻断红线 (Hard Gates)】          【软性审查建议 (Soft Suggestions)】
   - 凭证与生产秘钥硬编码                - 领域聚合根抽象合理性建议
   - 确定性 SQL 注入与未鉴权接口          - 圈复杂度与深度嵌套重构提示
   - 破坏性向下兼容 (Breaking Changes)   - 异常处理颗粒度优化建议
   - 变异测试击杀率未达标                - 命名规范与潜在代码坏味道
            │                                     │
            ▼                                     ▼
    [CI 立即红色阻断]                   [生成结构化建议卡片 (带置信度)]
   (必须修复后方可流转)                           │
                                                  ▼
                                      【Code Owners 资深架构师】
                                      (一键点击采纳 / 驳回并填写原因)
1. 允许机器直接行使阻断权的“硬性红线”
在这类具有确定性客观标准、触及企业生存底线的领域,流水线直接配置自动化硬拦截,人类没有特批权:
- 安全红线:检测到云厂商 AK/SK、内部数据库明文密码、未鉴权的公开路由;
- 契约破坏:公开暴露的 Protobuf 或 RPC 字段存在被删除或类型不兼容变更;
- 质量防线:全套单元测试存在失败用例,或变异测试击杀率低于团队底线阈值(如 85%)。
2. 严禁机器随意阻断的“软性建议领域”
在涉及架构设计、代码组织与性能权衡的广阔空间里,AI 的任务是把问题用最体贴的方式标注出来,将决断权完好无损地交还给人类:
- 在评论区以“疑问与提醒”的温和口吻发帖,而非命令式的指责;
- 明确标注该建议的置信度等级(High / Medium / Low),低置信度的提示默认折叠,防止打扰阅读;
- 每一条建议必须附带“为什么这么建议的工程依据”以及“推荐的代码重构 Snippet”,方便人类工程师评估。
生产级落地范例:人机协同评审卡片
在团队的代码管理平台上,我们定制了标准化的高信噪比评审评论模板:
> 🤖 **Corp AI Code Reviewer 预审摘要** (置信度: 85%)

#### 💡 潜在优化建议:
在 `internal/settlement/calculator.go:78` 中,函数 `CalculateMultiTierDiscount` 认知复杂度达到 18(建议阈值 ≤ 15),存在 4 层深度嵌套循环与判断。

- **潜在风险**: 在双 11 高并发流量下,该嵌套分支可能降低 CPU 指令分支预测效率,且增加后续维护心智负担。
- **重构启发**: 建议提取满减计算子逻辑为独立的策略无状态函数。

```go
// 推荐重构示范:
func resolveTierStrategy(tier int) DiscountStrategy { ... }
[一键采纳并自动生成 Commit] | [忽略此建议 (无需填写理由)]
### 实践成效

从“一票否决”退回至“专业参谋”的定位调整后,团队效能生态迎来了不可思议的良性反弹:

1. **PR 评审阻抗彻底消除**:工程师对 AI Review 的抵触情绪全面化解,由于没有被无理挂起的恐惧,研发人员开始主动在评论区参考 AI 提出的边界条件与重构思路,**有效建议的真实采纳率反而从 28% 飙升至 74%**。
2. **架构师聚焦高维思考**:人类 Reviewer 不再需要在语法格式、空指针检查这些琐碎细节上耗费脑力,这些前置工作已被 AI 过滤得干干净净。架构师能够把 100% 的精力投入在业务领域的本质矛盾与长远演化架构上。
3. **构建人机互信的技术文化**:AI 扮演的是默默守护在你身旁的副驾驶,它在发现盲区时轻轻拉一下你的衣袖,而手握方向盘的人类,始终保持着对技术与业务决策的绝对掌控和骄傲。

清晰的边界感,才是任何长久协作最坚固的基石。在代码评审这场关乎工程品质的严肃对话中,让机器回归参谋,让人类坚守把关,软件工程的进化才能真正走在理性与温度兼备的大道上。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献10条内容

所有评论(0)