是什么阻碍机器人领域的递归自我改进?——来自 1-2-3 轮自主技能发现的启示
26年9月来自新加坡国立J Wang的论文“What Stops Recursive Self-Improvement in Robotics? Lessons from 1-2-3 Rounds of Agentic Skill Discovery”。
这篇论文最有价值的结论是:机器人能够自主发现并补上局部能力,但“技能库持续变化”不等于“机器人持续变强”。 它揭示了技能发现走向递归自我改进时,容易断裂的几个环节:失败归因、能力表达、技能组合和改进验收。
先明确本文中“RSI”和“技能发现”的含义。这里的 RSI(递归自我改进)主要体现为:智能体观察机器人失败,修改机器人软件,测试后将修改纳入下一轮。基础大模型本身没有在这个循环中训练或改写权重。“技能发现”则指发现缺失能力、编写可执行技能、引入外部模型及扩展已有技能。因此,它研究的是机器人软件系统如何积累能力,以及这种积累为什么停滞。
方法的核心,是让失败驱动技能库演化。 系统在 RoboCasa 仿真中控制 PandaOmron 移动操作机器人,主任务约有 15 个步骤:识别冰箱最上层、必要时清理已有物品,再把芥末和蛋黄酱搬上去。任务同时涉及主动观察、关系理解、移动、抓取和放置。
其框架可拆成以下几层(正文 §2、图 2所示):
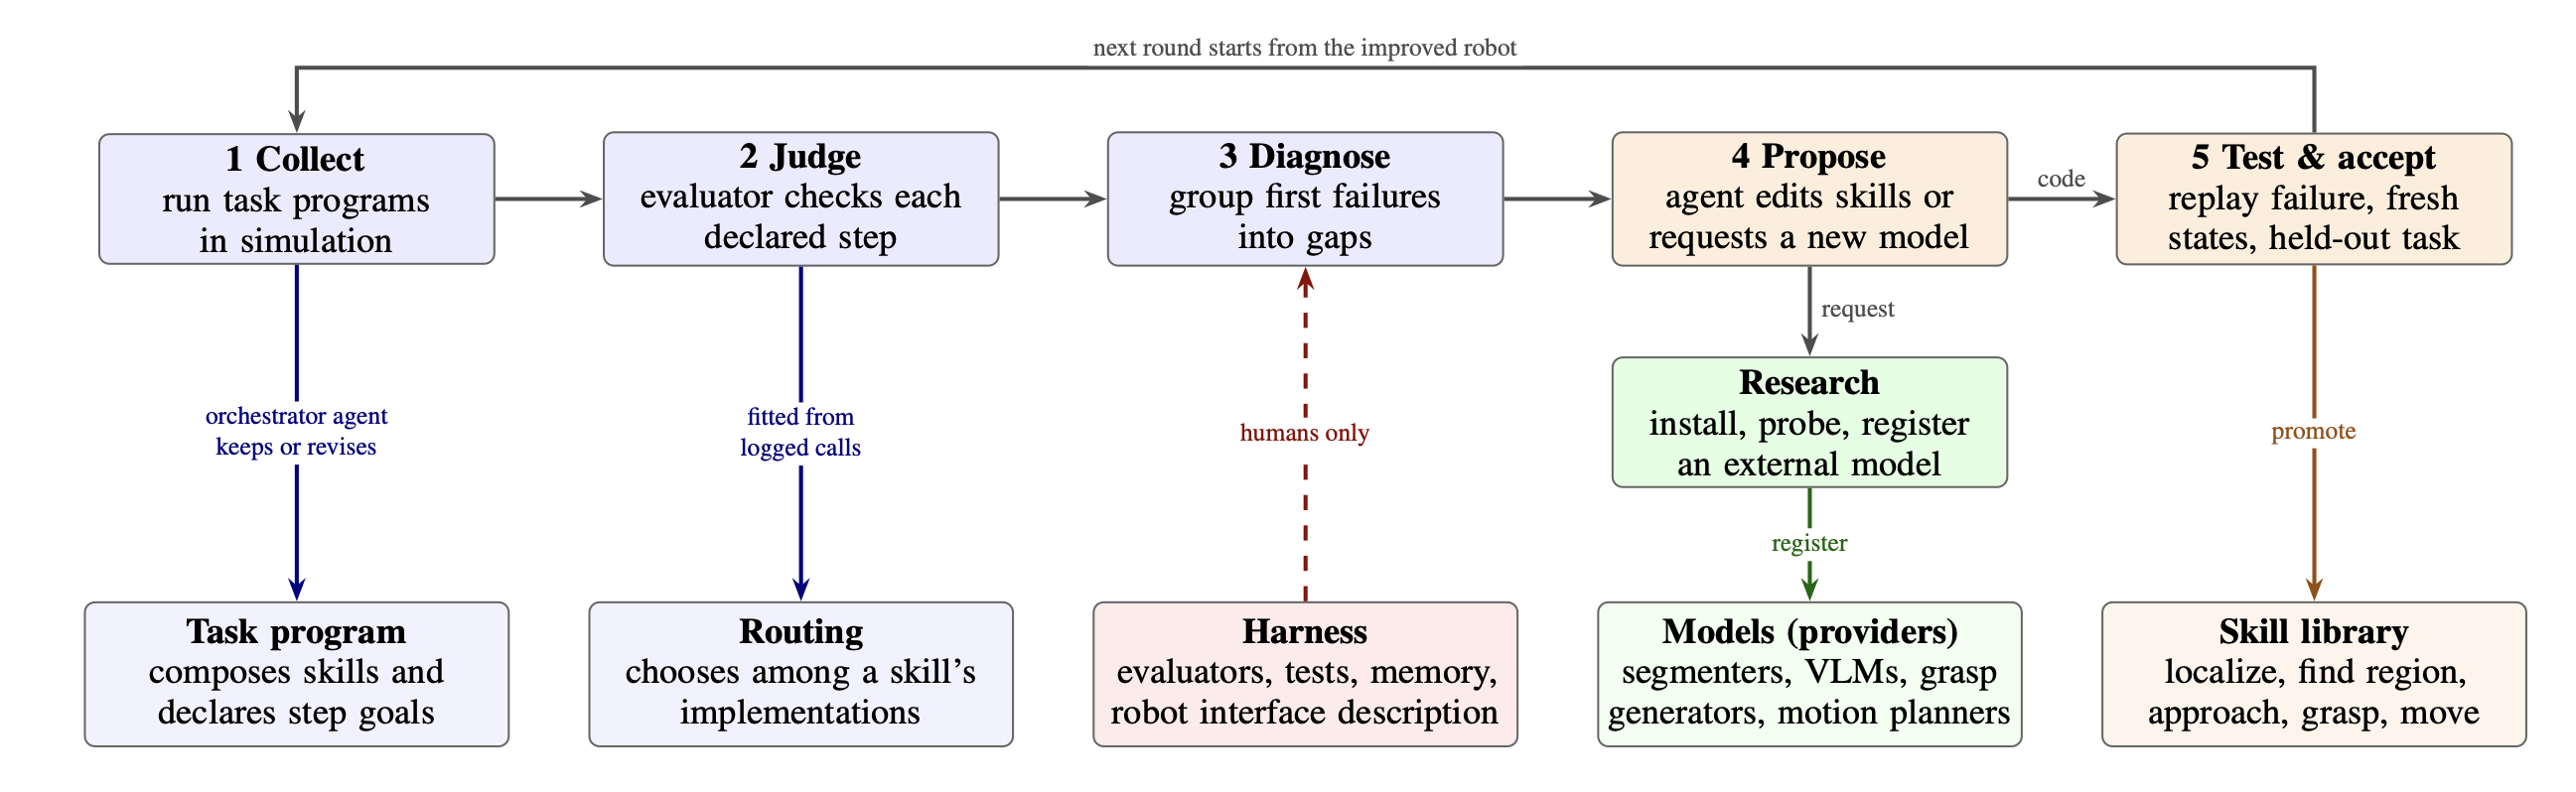
| 层次 | 职责 | 如何改变 |
|---|---|---|
| 任务程序 | 将指令拆成技能调用,并声明每步应达成的结果 | 编排智能体生成、保留和修订程序 |
| 技能库 | 实现物体定位、区域定位、接近、抓取、运动等能力;具有类型化输入输出 | 改进智能体根据失败修改代码 |
| 路由 | 为同一技能选择不同实现 | 每轮根据调用日志重新拟合 |
| 外部能力提供者(provider) | 提供分割、深度、抓取生成、运动规划等能力 | 研究智能体检索、安装、封装和测试 |
| 评估与验收 | 判断步骤是否成功,比较新旧实现,检查泛化和回归 | 实验中由人类维护 |
| 记忆与反馈 | 保存失败、修改、研究请求和测试结果 | 为后续提案提供依据,但其机制也由人类维护 |
三个智能体分别负责“编排任务”“修改技能”“引入模型”。其中,改进智能体能看到相机关键帧、执行轨迹、评估诊断和历史修改;但机器人执行时,感知依赖技能调用的模型,并不直接获得改进智能体自身的视觉理解能力。
每轮的基本流程是:
执行任务 → 评估每个步骤 → 聚合失败形成能力缺口 → 修改技能或申请新模型 → 测试 → 接受修改并进入下一轮。
验收包括原始失败状态回放、新场景中新旧实现的配对比较、留出任务测试;后期还加入了封存失败样本和关联技能测试。需要注意,这些测试机制是在运行过程中逐渐修补完善的,不能把最终版本的严格程度套用于全部 123 轮。
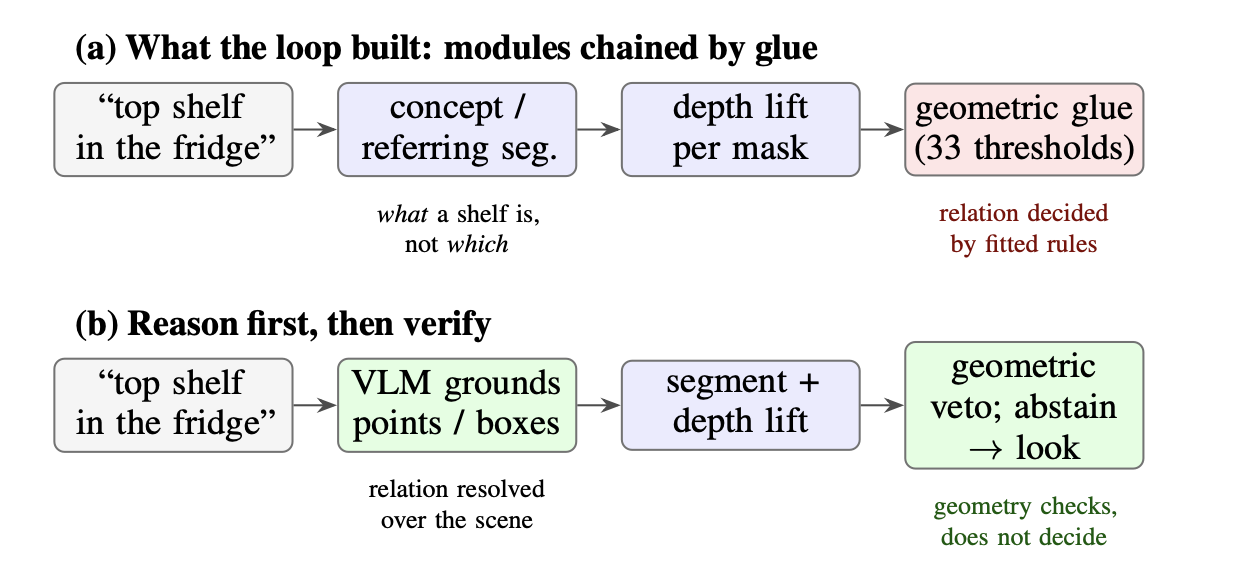
如图 4 所示关系存在于何处。(a) 在采用概念级和指称表达式分割器的系统中,没有专门的模块来表征“上方”或“下方”;该关系是通过人工编写的“胶水”代码(glue code)来实现的。(b) 视觉-语言模型基于整幅图像来判定该关系;几何信息和主动观察行为仅用于验证或否定模型的判定结果。
一个有说服力的技能发现案例是主动搜索:目标物体最初不在视野内,系统却把可见的相似物体当作目标。人类修正评估器,使其准确报告“目标不可见”后,智能体提出主动选取观察视角的需求,引入规划能力,发现并推动修复起始位置被误标为障碍的问题,最终将其包装成可执行搜索技能。这个案例说明,正确的失败信息可以触发从“修补识别结果”到“增加观察行为”的能力扩展。
实验结果支持“局部能力获得”,但没有支持“端到端能力持续累积”。 附录表 5–7 给出比摘要更清楚的统计口径:
| 指标 | 结果 | 应如何理解 |
|---|---|---|
| 改进轮数、提案次数 | 123 轮、847 次提案 | 搜索活动持续发生 |
| 被接受的技能库改动 | 57 次,其中 51 次涉及感知 | 约 89% 的改动集中在任务前段 |
| 外部能力注册 | 86 次注册,涉及 20 个不同 provider 标识 | 不是发现了 86 个独立新模型 |
| 实际部署调用 | 20 个 provider 中有 8 个被后续任务调用 | 注册与接入执行之间存在明显断层 |
| 冰箱任务 | 0/486 次完成执行成功 | 主任务始终未完成 |
| 柜子任务 | 0/256 | 辅助任务也未完成 |
| 水槽任务 | 14/230,其中 9 次存在失败的中间步骤 | 最终状态成功未必意味着可靠完成操作过程 |
| 人工维护 | 113 次评估与运行框架修复 | 自动写技能仍依赖大量人工维护 |
此外,57 次改动并不等于 57 项新技能。附录说明,首次接受的改动在第 10 轮建立了“区域定位”技能家族,其余主要修复或扩展已有技能。
论文对停滞提出了三个重要解释。
1. 关系语义没有被模型可靠表达,智能体便把它变成越来越复杂的几何规则。
“找到架子”和“找到冰箱内部最上层架子”是不同能力。在本实验中,SAM 3 能找到架子,Florence-2 对关系表达的分割却可能覆盖多个架子。加入深度后,系统得到更多几何信息,但仍缺少可靠的关系判定。
智能体因此不断补充阈值、遮挡规则和边界判断。区域技能最终达到 3,056 行、33 个阈值,还组合了另一个具有 48 个阈值的定位器。针对两个记录状态的 27 次尝试,始终只能救回其中一个。
作者将其称为 semantic displacement,可理解为“将缺失的语义能力转移到程序规则中”。这提供了一个有用的诊断信号:当代码不断增长、收益却局限于个别状态时,应检查能力表示是否选错,而不只是继续修补参数。
不过,论文支持的是这套模型组合在这些场景下失败,尚不能证明模块化感知普遍无法处理关系。
2.长技能链既压低任务成功率,也使后段技能得不到学习机会。
设第 j 步在前面各步成功的条件下,其成功概率为 p_j,则:
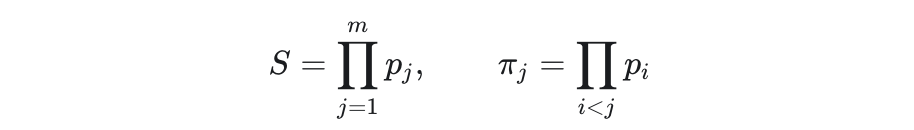
其中 S 是任务成功率,pi_j 是执行到第 j 步的概率。由于 p_j 是条件概率,这里不要求步骤相互独立。
如果一次修改只提高第 j 步的可靠性,而其他条件概率不变,那么:
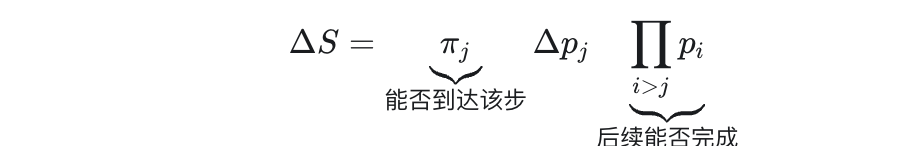
同时,n次完整任务尝试中,平均只有约 n pi_j 次真正测试到这个技能。因此,后段改进既难以影响最终成绩,也难以得到足够证据来验证。
实验中,冰箱任务 57% 在第一步失败,只有 2.7% 能通过前四步。第 118 轮的抓取修改在新状态及留出任务上出现可复现的局部收益,但随后的 60 次任务执行仍全部失败。
作者称之为 frontier lock:改进集中在最早的失败处,后面的能力长期缺少训练与测试。这是全文对长程机器人学习最有启发性的分析之一。
3. 评估、记忆和接入机制决定了系统实际在优化什么。
论文给出了几类具体故障:
-
- 评估替代了真实能力。 系统用半径 0.85 米的球体近似机械臂可达空间,智能体学会把底盘停在球面附近,通过评估后仍抓不到物体。
- 机器人能力描述有误。 躯干升降自由度没有被正确告知智能体,底盘速度描述也明显偏离实测。
- 验收缺乏足够分辨力。 两个样本要求至少 60% 修复率,会直接拒绝救回一个样本的方案;另一方面,22 次接受发生在新场景比较中“零胜、零负”的情况下。
- 差异不稳定。 36 组重新运行的新旧差异中,16 组未复现。
- 记忆把“没试过”写成了“失败”。 88 个包含研究请求的提案被当成代码处理,导致有价值的需求被错误压制。
- 有模型却没有调用路径。 后期注册的关系定位模型并未被部署技能使用。
这些现象说明,技能发现需要同时回答三个问题:系统是否知道缺什么、是否能获得它、获得后是否真正用上并产生收益。
论文的贡献主要在诊断框架和失败证据。 具体有四点:
- 提供了长期运行中“改动很多、任务不进步”的完整案例,揭示只统计代码修改或模型注册会高估进展。
- 提出三个检查维度:失败能否被正确表达(representability)、有效修复能否在允许修改的范围内实现(expressibility)、测试能否可靠区分改进(resolvability)。
- 将长任务的可靠性问题进一步解释为数据覆盖和改进选择问题:后段技能不仅容易失效,而且难以获得学习机会。
- 指出 RSI 的递归范围不应只覆盖执行代码;评估器、记忆、任务链和模型接入机制同样会成为瓶颈。
同时,论文的解释力度强于它的因果证据,以下几点值得保留判断。
首先,它只有一次长期运行,使用一个仿真器、一个厨房布局和少量任务,没有独立重复、等预算基线或消融。模型、提示、评估规则和外部能力又沿时间线共同变化。因此,“这些机制确实出过问题”有充分记录;“智能体通常不是瓶颈”“更强智能体不会有帮助”则没有被严格证明。
其次,文中的 VLM 替代方案只在 4 个记录视角上获得正确定位,属于可行性检查。后期 VLM 又没有进入真实执行路径,所以论文没有证明换上 VLM 后任务就会成功。
再次,系统对任务程序修改的限制本身可能制造瓶颈。若需要先升高躯干、换视角再定位,却要求智能体优先在单个技能内部修复,失败自然会被反复归入错误层次。这既是发现,也意味着结果受到架构选择影响。
最后,仿真评估可以使用真实状态,现实机器人很难直接拥有同等可靠的判断依据。本文尚未解决真实世界中的自主复位、接触状态判断和低成本验证问题。另外,成功路径不必严格等同于预先编写的程序;水槽中的偶然掉落之所以不能作为可靠进步,关键在于不可控、不可复现,而非仅仅偏离预定步骤。
下一步最值得做的是把这些机制解释变成可对照、可证伪的实验。
| 优先方向 | 具体工作 | 关键验证指标 |
|---|---|---|
| 先打通关系理解与执行 | 冻结其他组件,对比现有定位、VLM 定位、VLM 加主动观察;要求新模型在合适状态下实际被调用 | 未见布局上的定位率、错误自信率、调用率、任务推进深度 |
| 让后段技能获得证据 | 从物理可实现的中间状态测试抓取、搬运和放置,再回到完整任务验证 | 每步到达率、条件成功率、有效比较样本量、完整任务收益 |
| 允许学习任务链 | 为技能声明前置条件、效果和失败类型;允许插入观察、重新定位和恢复步骤 | 恢复成功率、步骤衔接可靠性、端到端成功率 |
| 改善失败归因 | 测试失败步骤从其起始状态是否本来就可能成功,并追溯使其不可行的上游决策 | 归因准确率、错误修复次数、单位预算的有效改进 |
| 让框架也能被改进 | 对评估器、记忆和测试规则的修改进行独立审查与历史回放;区分未测试、基础设施失败和实测失败 | 验收误判率、后续退化率、人工干预量 |
其中,建议先开展“关系定位 × 后段状态覆盖”实验:冻结同一初始技能库和智能体预算,分别开启或关闭关系定位改进、从中间状态开始的技能测试,形成四组,再用多个独立运行和未见布局评估。
这个实验能区分:系统究竟主要被感知卡住,被后段证据不足卡住,还是必须同时解除两者才能产生累积收益。如果只提高局部技能分数,完整任务仍无改善,就应继续检查任务链和技能接口。
更长期的方向,是把技能从一段代码扩展为带有适用条件、效果、置信度、恢复策略和验证记录的能力单元,并允许智能体在“改代码、换模型、采集数据训练策略、修改任务链”之间选择。评价时应同时报告任务成功率、跨场景迁移、遗忘或退化,以及计算与人工成本,才能判断是否形成真正可持续的自我改进。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献458条内容

所有评论(0)