具身智能 VLA 面试基础加强版:Python 与 PyTorch 高频考点
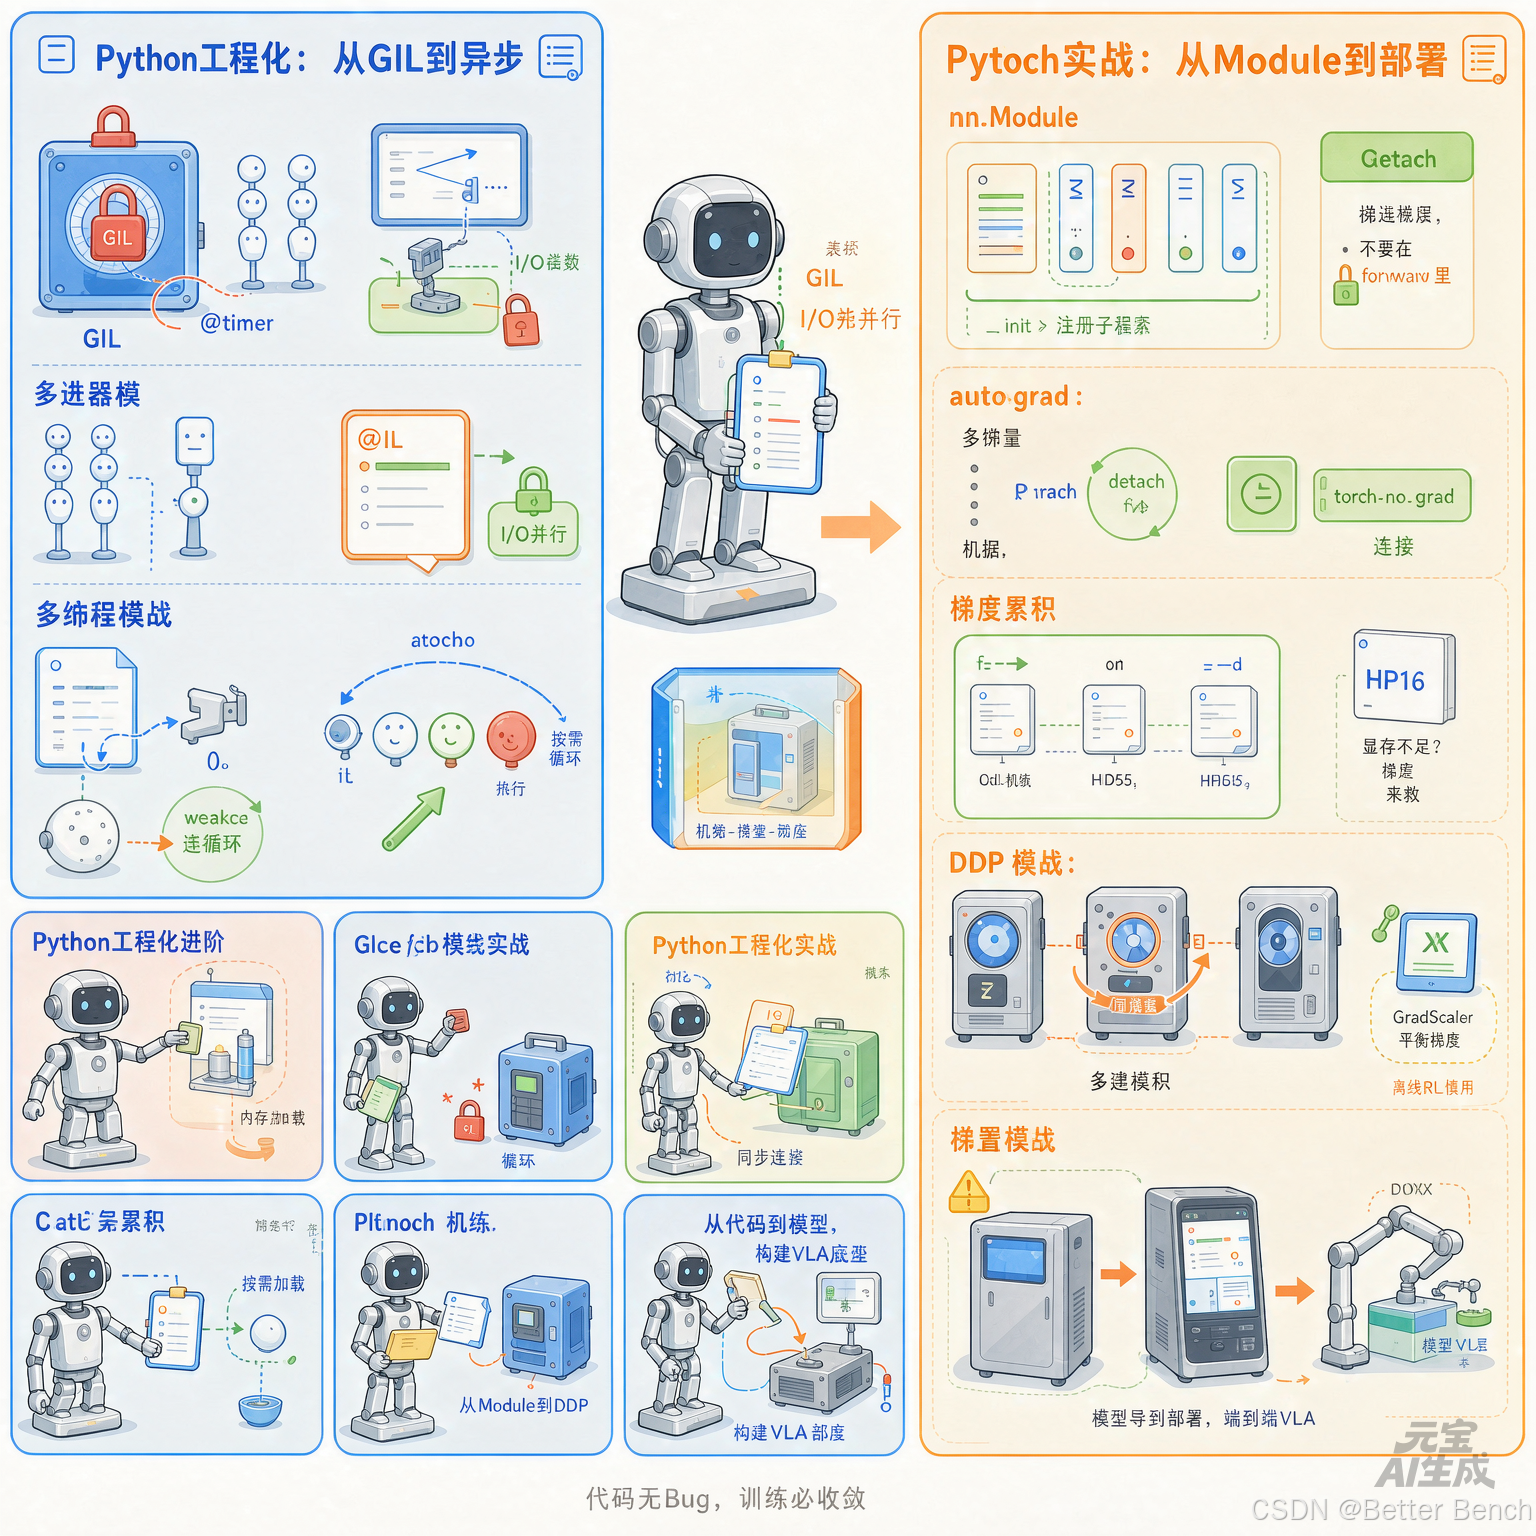
第一部分:Python 工程化进阶
1. GIL(全局解释器锁)的原理是什么?它对 CPU 密集型和 I/O 密集型任务有何不同影响?
GIL 是 CPython 解释器的互斥锁,同一时刻只允许一个线程执行 Python 字节码。对于 CPU 密集型任务,比如图像预处理或模型推理,多线程无法利用多核并行,反而因线程切换带来开销。对于 I/O 密集型任务,比如相机数据采集、串口通信或网络请求,线程在等待 I/O 时会释放 GIL,因此多线程能有效提升吞吐量。
2. 在机器人开发中,如何绕过 GIL 实现真正的并行计算?
有三种主流方案。多进程(multiprocessing)让每个进程有独立的 GIL 和内存空间,适合 CPU 密集任务,但进程间通信开销较大。C/C++ 扩展将计算密集型代码用 C++ 编写,通过 pybind11 暴露接口,在 C++ 中释放 GIL。异步 I/O(asyncio)适用于高并发 I/O 场景,如同时控制多个传感器。
3. multiprocessing 中 spawn、fork、forkserver 三种启动方式的区别?在 ROS 环境中推荐哪种?
fork 复制父进程内存,启动快,但可能继承不必要的资源如文件锁或 CUDA 上下文,导致死锁,在 Linux 上默认。spawn 启动全新的 Python 解释器,只继承必要的资源,更安全但启动慢,在 macOS 和 Windows 上默认。forkserver 启动一个服务器进程,fork 该服务器以获得干净状态。在 ROS 或涉及 CUDA 的环境中,推荐使用 spawn,避免 fork 导致的 CUDA 上下文冲突或 ROS 节点初始化问题。
4. 多进程间通信有哪些方式?在机器人数据流中如何选择?
Queue 是线程/进程安全的,适合传递序列化对象,但有序列化开销。Pipe 是双向通道,速度比 Queue 快,但只支持两个端点。SharedMemory 共享内存,零拷贝,适合传递大型数组如图像,但需要手动同步。multiprocessing.Manager 支持共享字典、列表等,但性能较低。相机图像流常用 SharedMemory 加 Lock,控制指令常用 Queue。
其中进程是操作系统资源分配的基本单位,而线程是 CPU 调度和执行的基本单位。 简单来说,进程好比一个正在运营的工厂(拥有独立的厂房和资源),而线程则是工厂里面的工人(共享厂房内的资源,协同完成生产任务)。一个进程可以包含多个线程,每个进程至少有一个主线程。
5. 多线程在机器人采集相机数据时为何有效?需要注意什么?
相机读取是 I/O 密集型,多线程可以在等待帧数据时释放 GIL,让其他线程运行。需注意 OpenCV 的 cv2.VideoCapture 内部可能使用了线程,需设置 cv2.CAP_PROP_BUFFERSIZE 控制缓冲。避免在多个线程中同时操作同一个 VideoCapture 实例,应单线程采集,多线程处理。
6. asyncio 事件循环在机器人异步控制中有哪些应用?
asyncio 适用于单线程并发处理多个 I/O 任务,如同时向多个电机发送指令、异步接收传感器数据。在 ROS2 中,rclpy 原生支持 asyncio,可以用 async/await 编写非阻塞节点,简化并发逻辑。
7. 装饰器的底层原理是什么?什么是闭包?
装饰器本质是一个高阶函数,接收一个函数作为参数,返回一个新的函数。闭包是指内部函数引用了外部函数的变量,并且外部函数返回内部函数。装饰器利用闭包保存被装饰函数的引用,并在调用前后插入逻辑。
8. 为什么在装饰器中必须使用 functools.wraps?
functools.wraps 会将原函数的元信息如 name、doc、annotations 复制到装饰后的函数上。否则,装饰后的函数名会变成装饰器内部函数的名字,导致调试困难、日志混乱,且某些依赖反射的框架可能出错。
9. 如何实现一个带参数的装饰器?
带参数的装饰器是一个返回装饰器的函数。例如实现一个重试装饰器:
def retry(max_retries=3, delay=1):
    def decorator(func):
        @wraps(func)
        def wrapper(*args, **kwargs):
            for i in range(max_retries):
                try:
                    return func(*args, **kwargs)
                except Exception as e:
                    if i == max_retries - 1: raise
                    time.sleep(delay)
        return wrapper
    return decorator
10. 类装饰器是什么?在算法工厂模式中有什么应用?
类装饰器是实现了 call 方法的类,它可以像函数装饰器一样使用。在算法工厂中,常用类装饰器注册算法:
class AlgorithmRegistry:
    def __init__(self): self._algs = {}
    def register(self, name):
        def decorator(cls): self._algs[name] = cls; return cls
        return decorator
    def get(self, name): return self._algs[name]

registry = AlgorithmRegistry()

@registry.register("ppo")
class PPO: pass
这样可以通过字符串动态获取算法类。
整个逻辑就是:通过装饰器语法,在定义类的时候自动把类和名字注册到一个全局的注册表中。以后如果想用字符串 “ppo” 来获取对应的类,只需要调用 registry.get(“ppo”) 就可以了。这种模式在需要动态加载算法、模型或者插件的时候非常有用,可以避免用大量的 if-elif 语句来判断名字,也让新增算法变得更简单,只要定义类的时候加上装饰器就行。
11. 迭代器协议包含哪两个方法?生成器是如何实现这两个方法的?
迭代器协议包含 iter(返回迭代器自身)和 next(返回下一个值,无值时抛出 StopIteration)。生成器函数(含 yield)在调用时返回一个生成器对象,该对象自动实现了这两个方法,yield 语句暂停并保存状态,next() 恢复执行。
生成器是 Python 里一种非常实用的工具,它本质上是一个特殊的迭代器。当你写一个函数,里面用了 yield 关键字,这个函数就不再是普通函数,而是一个生成器函数。调用这个函数时,它不会马上运行里面的代码,而是返回一个生成器对象。这个对象自己就实现了迭代器协议要求的两个方法,也就是 iter 和 next。
iter 方法只需要返回迭代器自身,生成器对象天然就满足这一点,所以你可以直接把它用在 for 循环里。next 方法负责返回下一个值,生成器内部会记住上次执行到哪个 yield,每次调用 next() 时,它就从暂停的地方继续往下走,直到遇到下一个 yield,把 yield 后面的值作为结果返回,然后再次暂停。如果函数运行到头了,或者遇到 return,生成器就会抛出 StopIteration 异常,表示没有更多值了。
这种机制的好处是,生成器可以一边循环一边计算,不用一次性把所有结果都存在内存里。比如你要读取一个巨大的机器人数据集,用生成器可以每次只取一条数据,处理完再取下一条,内存占用始终很低。yield 语句在这里就像是一个暂停键,它把值交出去,但保留了函数内部的所有状态,包括局部变量、指令指针,下次唤醒时一切如初。
12. yield from 的作用是什么?在嵌套生成器中有何优势?
yield from 用于委托给子生成器,它会自动处理子生成器的迭代,并转发 send() 和 throw() 值。在嵌套数据流中,如从多个 HDF5 文件中逐帧读取,yield from 可以扁平化嵌套循环,简化代码。
13. 生成器在读取大型机器人数据集(如 HDF5)时如何节省内存?
HDF5 文件可能包含数百 GB 的轨迹数据。使用生成器可以逐条或逐批读取,而不是一次性加载到内存。例如:
def read_hdf5_generator(path):
    with h5py.File(path, 'r') as f:
        for i in range(len(f['actions'])):
            yield f['states'][i], f['actions'][i]
训练时,DataLoader 可以逐个取出批次,内存占用恒定。
14. itertools 模块中有哪些常用函数?在机器人动作组合中有何应用?
itertools.product 用于笛卡尔积,遍历所有关节角度组合。itertools.cycle 循环迭代,重复播放一段演示轨迹。itertools.chain 链接多个迭代器,合并多个数据源。itertools.islice 切片,跳过文件头或只取部分数据。在网格搜索超参数或生成动作候选时非常有用。
15. Python 的内存管理机制是怎样的?
Python 采用引用计数为主,标记-清除和分代收集为辅的机制。引用计数指每个对象维护一个计数,为 0 时立即回收。标记-清除解决循环引用问题,如列表互相引用。分代收集将对象分为三代,新对象在 0 代,存活越久晋升到更高代,减少扫描频率。
16. 什么是循环引用?如何用 weakref 解决?
循环引用指两个或多个对象互相引用,导致引用计数永远不为 0。例如,机械臂对象引用控制器,控制器又引用机械臂。使用 weakref 模块可以创建弱引用,不增加引用计数,从而打破循环,让对象能被正常回收。
17. 如何调试 Python 内存泄漏?
使用 gc 模块,gc.collect() 强制回收,gc.get_objects() 查看所有对象,gc.get_referrers() 查看引用者。使用 tracemalloc 跟踪内存分配,对比快照找出增长最快的类型。第三方工具如 objgraph 可视化对象引用图,memory_profiler 逐行分析内存使用。
18. *args 和 **kwargs 的解包操作在配置传递中如何应用?
在函数调用时,*list 将列表解包为位置参数,**dict 将字典解包为关键字参数。在配置传递中,常将配置文件加载为字典,然后 **config 传递给函数,避免逐个参数书写。例如:train(**yaml.load(config_file))。
19. 上下文管理器 enter 和 exit 的作用?contextlib 如何简化定义?
enter 在进入 with 块时调用,返回资源对象;exit 在退出时调用,处理清理如关闭文件、释放锁。contextlib.contextmanager 装饰器允许用生成器快速定义上下文管理器:
@contextmanager
def lock_scope(lock):
    lock.acquire()
    try: yield
    finally: lock.release()
20. 深拷贝与浅拷贝的区别?在修改机器人状态字典时有什么陷阱?
浅拷贝(copy.copy)只复制对象本身,不复制内部嵌套对象,嵌套对象仍指向原引用;深拷贝(copy.deepcopy)递归复制所有对象。在机器人状态中,若包含列表或字典如关节角度数组,浅拷贝修改内部元素会影响原对象,导致状态污染,必须使用深拷贝。
21. 异常处理中 try/except/else/finally 的执行顺序是怎样的?在训练循环中如何最佳实践?
try 执行可能出错的代码;若无异常,执行 else;无论是否异常,最后执行 finally。在训练循环中,try 包裹单步训练,except 捕获梯度爆炸或数据异常并记录日志,else 更新进度条,finally 确保资源释放如关闭文件、保存 checkpoint。
22. 如何自定义异常类?在框架设计中为何需要?
继承 Exception 类或子类,通常保持简单,仅提供错误信息。在框架中,自定义异常可以区分不同错误类型,如 DataCorruptionError、RobotConnectionError,让调用者能精确捕获并处理,而不是笼统地捕获 Exception。
23. 类型注解(typing 模块)在大型项目中有什么价值?Protocol 如何用于鸭子类型?
类型注解提升代码可读性,支持 IDE 自动补全和静态检查工具提前发现错误。在机器人框架中,Protocol 定义接口,如 Robot 协议要求有 get_state 和 send_command 方法,任何满足该接口的类都可被视为 Robot,实现鸭子类型,无需强制继承。
typing 模块里的 Protocol 就是为了解决这个问题而生的。它让你能定义一个接口协议,比如声明一个 Robot 协议,里面规定必须有 get_state 和 send_command 方法。然后你给函数参数标注为这个协议类型。这时候,静态检查工具就会去检查:所有传给这个函数的对象,不管它实际是哪个类,只要它真的实现了这两个方法,就认为它符合协议,类型检查通过。如果缺了方法,工具就会报错。这就把鸭子类型从运行时的隐式约定提升到了编写代码时的静态检查,既保留了灵活性,又增加了安全性。
24. dataclasses 模块在配置管理中如何简化代码?
@dataclass 自动生成 init、repr、eq 等方法。在配置管理中,可以定义:
@dataclass
class TrainConfig:
    lr: float = 1e-4
    batch_size: int = 32
    device: str = 'cuda'
避免手写大量样板代码,且支持类型提示和默认值。
25. collections 模块中的 defaultdict、Counter、deque、namedtuple 在机器人中有哪些妙用?
defaultdict 统计每个关节的动作频率,无需初始化。Counter 统计不同抓取结果的出现次数。deque 实现固定长度的动作历史缓冲区(maxlen=100),用于状态拼接。namedtuple 定义轻量级数据结构,如 State(joint_angles, velocity, timestamp),提高可读性。
26. functools.lru_cache 在机器人状态查询中如何应用?
lru_cache 缓存函数调用结果,适合计算成本高且频繁调用的纯函数。例如,逆运动学求解(IK)中,相同末端位姿的 IK 结果可以缓存,避免重复计算,大幅提升效率。
27. Python 序列化有哪些方式?在机器人数据中为何常用 pickle 之外的格式?
pickle 可序列化任意 Python 对象,但不安全(可执行恶意代码),且跨语言/版本兼容性差。机器人数据常用 json(人类可读,跨语言)、yaml(支持复杂结构)、msgpack(二进制,高效)、protobuf(强类型,高效,适合大规模数据存储和通信如 ROS 消息)。
28. 虚拟环境与依赖管理工具 venv、conda、poetry 的区别?
venv 是 Python 标准库,轻量,仅管理 Python 包,不管理 Python 版本。conda 跨语言,可管理 Python 版本和系统库如 CUDA,适合科学计算。poetry 是现代 Python 包管理,支持依赖版本锁定(poetry.lock),发布包到 PyPI,适合项目开发。算法研究用 conda,工程部署用 poetry 或 venv。
29. 如何用 pybind11 将 C++ 运动规划库封装给 Python 调用?
pybind11 是一个轻量级头文件库,通过 PYBIND11_MODULE 宏定义 Python 模块,将 C++ 类、函数、枚举暴露给 Python。例如,将 OMPL 的规划算法封装后,Python 端可以像调用普通函数一样调用,同时释放 GIL 以允许并行。
30. 如何定位 Python 代码中的性能瓶颈?cProfile 和 line_profiler 怎么用?
cProfile 是内置模块,统计每个函数的调用次数和耗时,命令为 python -m cProfile -s cumulative script.py。line_profiler 逐行分析函数耗时,需装饰 @profile,然后 kernprof -l -v script.py。memory_profiler 逐行分析内存使用。在机器人训练中,先用 cProfile 找到慢的函数,再用 line_profiler 定位具体行。
第二部分:PyTorch 深度学习实战(30问)
1. nn.Module 的生命周期是怎样的?子模块是如何注册的?
nn.Module 在 init 中定义子模块如 nn.Linear,这些子模块会被自动注册到 _modules 字典中。注册后,参数(parameters())和缓冲区(buffers())会被递归收集,方便统一管理如 to(device)、state_dict()。在 forward 中定义层会导致每次调用重新初始化,参数无法被注册。
2. register_buffer 和 register_parameter 的区别与使用场景?
register_parameter 注册可学习参数如自定义权重,会被包含在 parameters() 中,参与反向传播。register_buffer 注册不可学习的张量如 BatchNorm 的 running_mean、位置编码表,会被包含在 buffers() 中,随模型保存/加载,但不参与梯度更新。在 VLA 中,固定视觉编码器的特征统计量常用 register_buffer。
3. 为什么 forward 中不能定义网络层?动态图机制如何支持调试?
forward 每次调用都会执行,若在其中定义层,会反复创建新层,参数无法固定,且计算图节点混乱。动态图(define-by-run)允许每次前向传播构建新的计算图,因此可以随时 print 中间张量形状、使用 pdb 断点调试,甚至根据输入条件改变控制流如 if 语句,这是 PyTorch 相比静态图框架的最大优势。
4. 自动求导机制中 requires_grad、grad_fn、backward() 是如何协作的?
requires_grad=True 的张量会追踪操作,grad_fn 指向创建该张量的函数如 AddBackward。调用 backward() 时,从根节点反向遍历计算图,根据链式法则计算梯度,并累积到各张量的 .grad 属性中。默认累加梯度,需手动 zero_grad()。
requires_grad 是标记哪些张量需要关心影响,grad_fn 是记录每一步怎么反推,backward() 是启动整个反推过程,把算出来的影响存到 .grad 里,而 zero_grad() 是每次开始前擦干净黑板。这样,整个自动求导就像一场有组织的接力赛,每个人只管自己那一棒,最后所有影响都算得清清楚楚。
5. detach()、torch.no_grad()、torch.inference_mode() 的区别与适用场景?
detach() 从计算图中分离张量,返回的新张量 requires_grad=False,用于需要值但不希望梯度回传的场景如 Target Q 网络更新。torch.no_grad() 是上下文管理器,关闭所有梯度追踪,节省显存和计算,用于模型评估、推理。torch.inference_mode() 是 PyTorch 1.9+ 引入,比 no_grad 更激进,完全禁用视图跟踪,速度更快,仅用于纯推理。注意 inference_mode 下不能调用 backward,否则报错。
6. 如何实现梯度累积(Gradient Accumulation)?在显存不足时有何作用?
梯度累积通过多次前向传播累积梯度,再统一更新参数,模拟大 batch size。实现如下:
for i, (x, y) in enumerate(dataloader):
    loss = model(x, y)
    loss = loss / accumulation_steps
    loss.backward()
    if (i + 1) % accumulation_steps == 0:
        optimizer.step()
        optimizer.zero_grad()
作用是在 GPU 显存有限时,通过时间换空间,达到与大 batch 相同的梯度效果。
7. 梯度消失和梯度爆炸的原因是什么?有哪些对策?
深层网络中,梯度通过链式法则连乘,若导数小于 1 则消失,大于 1 则爆炸;RNN 中尤为明显。对策包括梯度裁剪(torch.nn.utils.clip_grad_norm_ 或 clip_grad_value_)、使用 ReLU 缓解消失避免 Sigmoid/Tanh 深层堆叠、权重初始化(Xavier/Glorot 或 Kaiming)、批归一化(BatchNorm/LayerNorm)、残差连接(ResNet)。
严格来说,如果网络层数很多,只有精确的 1 才是绝对安全的。导数都死死地卡在 1 附近,稍微飘一点,经过几十上百层的放大或缩小,就出事了。
那现实中怎么做到呢?其实那些对策,本质上都是在帮网络“把系数往 1 附近拽”。比如使用ReLU激活函数、权重初始化(Xavier/Kaiming)、批归一化(BatchNorm)、残差连接(ResNet)。
8. 张量创建与内存布局:from_numpy 的共享内存陷阱是什么?
torch.from_numpy(ndarray) 创建的张量与 NumPy 数组共享内存,修改一个会影响另一个。若在训练中对张量做 in-place 修改,可能导致 NumPy 数据意外改变,引发难以调试的错误。建议使用 torch.tensor(ndarray) 复制一份。
9. 为什么 PyTorch 中尽量避免使用 in-place 操作(如 add*、zero*)?
in-place 操作会覆盖张量值,破坏计算图的历史,导致 backward 时无法找到原始值而报错(RuntimeError: one of the variables needed for gradient computation has been modified in-place)。除非确定不需要梯度(如 relu_ 在推理时),否则应避免。
10. 广播机制(Broadcasting)在损失计算中的应用与常见错误?
广播允许不同形状张量进行逐元素操作,规则是从尾部维度开始对齐,大小为 1 的维度可扩展。例如,预测 (B, 1) 与标签 (B,) 可自动广播。常见错误是维度不匹配导致意外广播,如 (3,) 与 (4,) 会报错,但 (1,3) 与 (4,1) 会广播成 (4,3),需仔细检查 unsqueeze 和 view。
11. view、reshape、flatten 的区别?contiguous 问题如何解决?
view 要求张量在内存中连续,否则报错,返回视图(共享内存)。reshape 若连续则同 view,否则返回拷贝,更灵活。flatten 展平指定维度,返回拷贝或视图。若 transpose 或 permute 后内存不连续,需先 contiguous() 再 view。
12. cat、stack、split、chunk 在多模态数据拼接中如何使用?
cat 沿已有维度拼接,要求其他维度相同,用于拼接图像批次和状态批次。stack 在新维度上堆叠,要求所有张量形状相同,用于将多个动作序列堆叠成 (T, B, D)。split 按大小或块数拆分,用于将一个大 batch 分成小 batch。chunk 将张量均匀分成指定块数。
13. CrossEntropyLoss、NLLLoss、BCEWithLogitsLoss 的区别与适用场景?
CrossEntropyLoss 结合 LogSoftmax 和 NLLLoss,输入是原始 logits,目标为类别索引,用于多分类。NLLLoss 输入是 log 概率(如 F.log_softmax 输出),目标为类别索引。BCEWithLogitsLoss 结合 Sigmoid 和 BCE,输入 logits,目标为 0/1 概率,用于二分类或多标签分类。在机器人动作分类如离散动作空间用 CrossEntropyLoss;连续值回归用 MSELoss。
多分类直接喂原始分数用 CrossEntropyLoss,二分类或多标签每个类别独立判断用 BCEWithLogitsLoss,NLLLoss 是前者的手动档版本(需要你自己先做 softmax)。
14. 如何自定义损失函数?在 VLA 中如何结合多种损失?
继承 nn.Module,在 forward 中计算。例如,VLA 中可组合语言损失、动作损失和碰撞惩罚:
class VLALoss(nn.Module):
    def forward(self, pred_action, gt_action, pred_lang, gt_lang):
        loss_action = F.l1_loss(pred_action, gt_action)
        loss_lang = F.cross_entropy(pred_lang, gt_lang)
        return loss_action + 0.1 * loss_lang
15. SGD、Adam、AdamW 的区别?权重衰减(Weight Decay)在 Adam 中为何需要 AdamW?
SGD 简单,需调学习率,易陷入局部极小。Adam 自适应学习率,收敛快,但权重衰减实现有误(将 L2 正则与衰减混淆)。AdamW 将权重衰减与梯度更新解耦,正确实现衰减,泛化更好,是 Transformer 等模型的标配。在机器人训练中,AdamW 通常比 Adam 更稳定。
SGD 靠统一学习率慢慢爬,Adam 给每个参数单独调步子,跑得快但错误地把权重衰减混进了梯度里,AdamW 把权重衰减从梯度中解耦出来单独做,这才是正确的正则化,所以泛化更好、训练更稳定。
16. 如何为不同层设置不同学习率?在微调视觉编码器时有何应用?
通过 optimizer 的 param_groups:
optimizer = torch.optim.AdamW([
    {'params': model.backbone.parameters(), 'lr': 1e-5},
    {'params': model.head.parameters(), 'lr': 1e-3}
])
微调时,预训练视觉编码器用较小学习率,新初始化的动作头用较大学习率。
17. 为什么每次反向传播前需要 optimizer.zero_grad()?
PyTorch 默认累积梯度(.grad 属性累加),若不手动清零,梯度会混合多个 batch,导致更新方向错误。调用 zero_grad() 清空历史梯度,确保当前 batch 的梯度独立。
18. Dataset 和 DataLoader 的核心参数 num_workers、pin_memory、prefetch_factor 如何调优?
num_workers 是子进程数,0 表示主进程加载。建议设为 CPU 核心数或略高,但过大会导致进程切换开销和内存不足。pin_memory 若为 True,将数据张量复制到 CUDA 固定内存,加速 GPU 传输,适合 GPU 训练。prefetch_factor 是每个 worker 预取的样本数,增加可提高 GPU 利用率,但占用更多内存。在机器人数据加载中,若 num_workers>0 遇到 CUDA 错误,可尝试设为 0 或调整 persistent_workers。
num_workers 决定雇几个工人并行加载数据(通常设 CPU 核数),pin_memory 决定是否把数据锁进 CUDA 专属内存来加速传输,prefetch_factor 决定每个工人提前备多少货以防 GPU 饿死但备太多会撑爆内存。
19. 如何自定义 collate_fn?处理变长轨迹和字典格式数据?
collate_fn 将一个 batch 的样本列表整理成张量。对于变长轨迹,可 padding 到最大长度并返回 mask:
def collate_fn(batch):
    states = [item['state'] for item in batch]
    actions = [item['action'] for item in batch]
    padded_actions = torch.nn.utils.rnn.pad_sequence(actions, batch_first=True)
    return {'state': torch.stack(states), 'action': padded_actions}
20. WeightedRandomSampler 如何解决机器人数据长尾分布?
机器人数据中大部分是简单动作如静止,关键抓取动作极少。WeightedRandomSampler 为每个样本赋予权重,让少数类样本被更频繁地采样,从而平衡 batch 分布,防止模型只学习简单模式。
21. 分布式采样 DistributedSampler 的原理是什么?为何每个 epoch 需要 set_epoch?
DistributedSampler 将数据集分片,每个进程(GPU)只读取自己的分片,确保数据不重叠。每个 epoch 需调用 sampler.set_epoch(epoch) 以打乱分片顺序,否则每个 epoch 各进程读取的数据顺序相同,导致模型收敛到局部解。
22. 模型保存与加载:state_dict 和 load_state_dict 的最佳实践?
保存:torch.save(model.state_dict(), ‘model.pth’),同时可保存优化器状态、epoch 等。加载:model.load_state_dict(torch.load(‘model.pth’)),默认 strict=True,要求键完全匹配。若部分加载如只加载 backbone,设 strict=False。跨设备加载时指定 map_location=‘cuda:0’ 或 ‘cpu’。
23. 多卡训练时,模型保存为何只需要在主进程进行?如何加载到单卡?
多卡训练(DDP)中,模型参数在各进程间同步,只需主进程保存 state_dict。加载到单卡时,若保存的是 module. 前缀(DDP 包装),可用 torch.nn.Module.load_state_dict 并去除前缀,或直接 model = nn.parallel.DistributedDataParallel(model) 后加载。
保存时只存参数字典(别存整个模型),加载时原样塞回模型,键名对不上就关 strict,换设备记得指定 map_location。
24. DDP(分布式数据并行)的原理是什么?All-Reduce 如何同步梯度?
DDP 在每个 GPU 上复制模型,每个进程独立前向传播,计算梯度后通过 All-Reduce 操作在所有 GPU 间求梯度的平均值,然后各进程用平均梯度更新参数,保持模型一致。torchrun 启动多进程,自动设置环境变量。
25. 混合精度训练(AMP)中 autocast 和 GradScaler 的作用?离线 RL 中为何要慎用?
autocast 自动将部分操作转为 FP16,减少显存和加速。GradScaler 缩放损失,防止 FP16 梯度下溢,更新前再缩放回来。离线 RL 中,Q 值可能本身数值范围大,FP16 容易溢出或精度不足,导致 Q 值高估或低估,建议关键网络如 Q 网络使用 FP32。
26. 激活检查点(Gradient Checkpointing)如何节省显存?
以时间换空间,在前向传播中不保存中间激活值,而是在反向传播时重新计算。通过 torch.utils.checkpoint.checkpoint 包装模块,适合大模型如 Transformer 训练,显存可减少约一半,但训练时间增加约 20%。
27. BatchNorm 在训练和测试时的区别?DDP 中为何需要 SyncBatchNorm?
BatchNorm 训练时用当前 batch 的均值和方差,并累积 running_mean 和 running_var;测试时用累积的统计量。DDP 中,各 GPU 的 batch 较小,统计量不准确,需 SyncBatchNorm 在 GPU 间同步均值和方差,提升性能。
训练时 BN 拿当前 batch 现算均值并偷偷攒全局均值,测试时直接套用攒好的;多卡训练时单卡 batch 太小算出来不准,SyncBatchNorm 就是让所有卡凑一起算个准的。
28. Dropout 在机器人行为克隆中的作用?何时应该关闭?
Dropout 随机失活神经元,防止过拟合。在行为克隆中,可提升泛化能力。但在推理时必须关闭(model.eval()),否则输出随机。在离线 RL 中,若数据量少,Dropout 可能导致策略不稳定,需谨慎使用。
29. 如何使用 forward_hook 进行特征可视化或调试?
hook 是一个函数,当模块前向传播后被调用,可获取输入和输出。例如:
def hook_fn(module, input, output):
    print(output.shape)
    # 保存特征图
handle = model.layer.register_forward_hook(hook_fn)
可用于提取中间特征用于 t-SNE 可视化,或检查梯度消失。
30. TorchScript 和 ONNX 导出在机械臂部署中有何应用?
TorchScript 将 PyTorch 模型转换为静态图,可脱离 Python 运行(如 C++ 部署),适合嵌入式设备。ONNX 是开放神经网络交换格式,可转换为 TensorRT 等推理引擎,加速推理。在机械臂上,常将训练好的策略网络导出为 ONNX,用 TensorRT 加速,满足实时控制需求。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献33条内容

所有评论(0)