TrackFish3D 深度拆解:当一群鱼长得一模一样,怎么在 3D 里追踪每一条?
title: “TrackFish3D 论文深度解析:不用身份标注、不用外观特征,把多视图几何当监督信号”
paper: “TrackFish3D: Self-Supervised 3D Tracking of Schooling Fish from Multi-view Videos”
authors: “Patt Phurtivilai, Zhiyang Dou, Yifan Wu, Kinfung Chu, Yuan Liu, Lei Yang, Wenping Wang, Taku Komura”
institutions: “HKU / HKUST / Texas A&M / Centre for Transformative Garment Production”
venue: “NeurIPS 2026”
arxiv: “2609.38347”
一、介绍:一个"没有特征可用"的跟踪难题
先说场景。行为生态学、水产养殖、群体机器人都在研究一件事:鱼群为什么能聚成群、怎么躲避捕食者、局部交互规则是什么。要回答这些问题,前提是拿到每一条鱼在三维空间中随时间变化的完整轨迹——不是 2D 投影,是 3D 的。而获取手段上,视觉是唯一可扩展、无侵入的方案。
然后难题来了。鱼群的跟踪有三个叠加的"地狱级"设定:
- 跨视角关联(空间关联):多台相机看到同一群鱼,哪两个检测框是同一条鱼?
- 时序关联(时间关联):帧与帧之间,这条鱼还是刚才那条吗?
- 没有监督信号:跨视角身份标注没有、时序身份标注没有、3D 真值轨迹没有——因为给鱼打标签本身就不可行。
更糟的是,外观这条路也是死的。同一群鱼长得几乎一模一样,还频繁互相遮挡。传统多目标跟踪的两大法宝——跨视角重识别(ReID)和外观特征——在这里集体失效。
按方法家族分,现有工作各占一角(论文 Tab. 1 的浓缩版):
| 方法家族 | 空间关联 | 时间关联 | 免跨视角标注 | 免时序标注 | 免3D真值 | 免外观特征 |
|---|---|---|---|---|---|---|
| 单视角 MOT | ✗ | ✓ | ✓ | ✗ | ✓ | ✗ |
| 监督多视角关联 | ✓ | ✗ | ✗ | ✓ | ✓ | ✗ |
| 自监督多视角关联 | ✓ | ✗ | ✓ | ✓ | ✓ | ✗ |
| 多视角多目标 MOT | ✓ | ✓ | ✗ | ✗ | ✓ | ✗ |
| TrackFish3D | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
可以看到,没有一家同时满足六个"免"——而这些"免"恰恰是鱼群场景的全部刚需。TrackFish3D(港大 Taku Komura / Zhiyang Dou 组,合作方含港科大、德州农工,NeurIPS 2026)的核心洞察一句话:当外观不可分辨时,身份线索不该来自"长什么样",而应来自标定好的多视图几何与时间一致性本身。三角测量 + 重投影一致性就是免费的监督信号。
用视频编码的话打个比方:这相当于放弃内容分析,改用纯结构信息做关联——就像不分析图像内容,纯靠运动矢量的率失真一致性来判断两个块是不是同一个物体。标定相机给出的对极几何约束,就是那个永远可用、永远不骗你的"底层码流结构"。
主要贡献三个:
- TrackFish3D 框架:几何编码器 + 全局关联 Transformer + 时间预测器,三模块端到端联合训练,全部监督信号由多视图几何自产。不需要跨视角身份标注、时序标注、3D 真值、外观特征,甚至不需要测试时优化。
- SynFish 基准:Unreal Engine 5 渲染的合成基准,14 个场景、4–16 条外观近乎无差别的鱼、密集 3D 真值轨迹、7 种相机 rig 配置(测试集含一个训练时未见过的 rig)。
- 跨物种验证:真实斑马鱼基准 3D-ZeF 上 81.1% MOTA;鸽子数据 3D-POP 上 91.9% MOTA,证明这套几何驱动的配方不是鱼专属。
关键数字先睹为快:SynFish 测试集 MOTA 从最强基线 87.7% 拉到 95.8%(换 YOLO26+SAM2 检测器输入到 96.6%),IDSw 掉到 0–0.2;而整个模型只有 655K 参数,比 typical ViT tracker(>50M)小两个数量级。
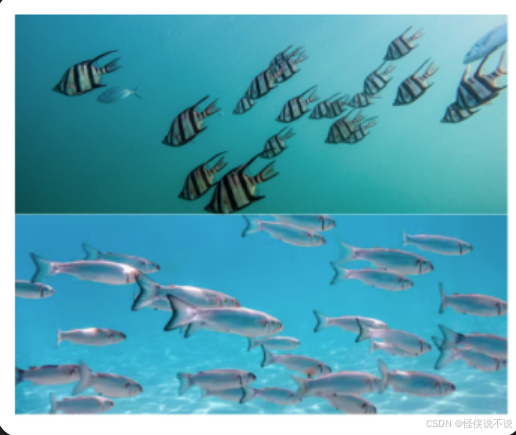
图 1(论文 Fig. 1):野生鱼群——外观几乎一致 + 密集互遮挡,这是 ReID 方法的天敌。
二、原理:三模块联动的自监督机器
输入设定极简:CCC 台标定相机(内参 KcK_cKc、外参 Rc,tcR_c, t_cRc,tc 已知),每帧每相机给 2D 检测(分割掩码质心 p=(u,v)p=(u,v)p=(u,v)、框尺寸、置信度 sss)。上游感知模型随意——论文用 YOLO26+SAM2 或 SAM 3,且明确不需要上游做任何时序跟踪,纯逐帧检测就行。
整体框架如图:
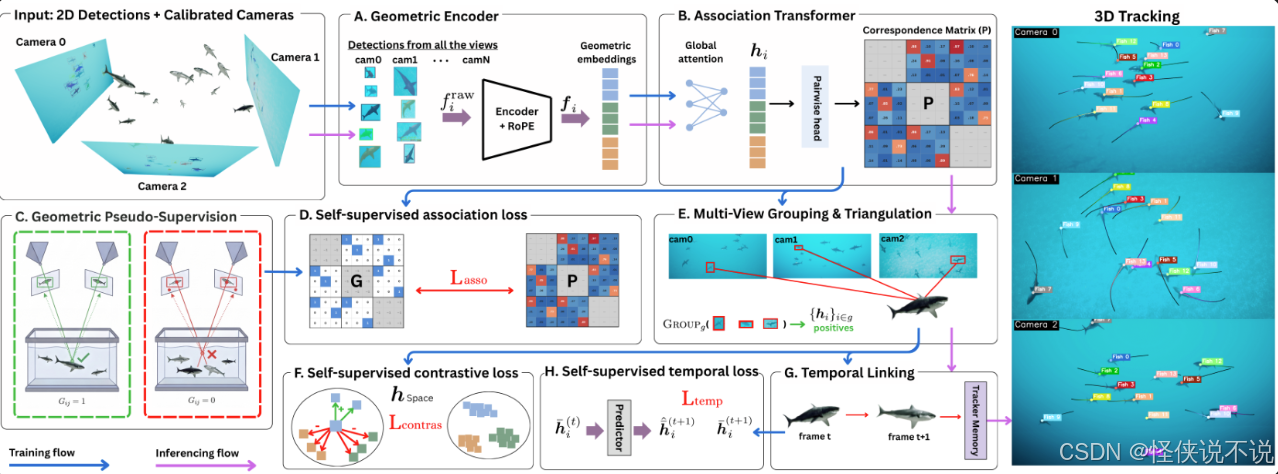
图 2(论文 Fig. 2):A/B 是前向通路(几何编码器 → 全局关联 Transformer → 成对概率 P),C/D 是帧内几何伪监督,E 是多视图分组三角化,F/G/H 分别是对比损失、时序损失与时序链接。蓝线训练流,紫线推理流。
2.1 几何编码器:把"像素坐标"翻译成"世界约束"
每个检测编码成一个 9 维原始特征:
firaw=[cxW,cyH,wW,hH,cC−1,s,rx,ry,rz]f_i^{raw} = \left[\frac{c_x}{W}, \frac{c_y}{H}, \frac{w}{W}, \frac{h}{H}, \frac{c}{C-1}, s, r_x, r_y, r_z \right]firaw=[Wcx,Hcy,Ww,Hh,C−1c,s,rx,ry,rz]
前五项都是归一化的 2D 量:质心、框宽高、相机索引;sss 是检测置信度;最后三项 (rx,ry,rz)(r_x, r_y, r_z)(rx,ry,rz) 是把质心经 K−1K^{-1}K−1 反投影、再经 R⊤R^\topR⊤ 旋转到世界系后的单位光线方向。这个光线方向是整个设计的点睛之笔——它把"这个像素在哪台相机的哪个位置"变成了"空间中的哪条射线",不同相机的检测因此有了可比的几何语言。
两层 MLP(9→64→128,ReLU + LayerNorm)输出 d=128d=128d=128 维嵌入 fi=ϕ(firaw)f_i = \phi(f_i^{raw})fi=ϕ(firaw)。注意整个编码器对任何外观信息失明——没有 RGB、没有 CNN 特征、没有 DINOv3(后面消融证明加了也没用)。
2.2 关联 Transformer:全局注意力 + 2D RoPE
编码后的所有检测 token(所有相机的全部检测一起)送进一个 4 层标准 Transformer encoder(4 头、d=128、FFN 256、pre-LN、dropout 0.1)。这里有个关键设计选择:不做相机对之间的 cross-attention,而是全帧 all-to-all 自注意力(思路类似 VGGT 的几何 token 处理)。这个选择值得展开讲。相机对式的 cross-attention 有个结构性缺陷:它做的是局部两两决策,而多视图对应天然要求传递性推理——相机 0 和相机 1 配上了、相机 1 和相机 2 配上了,那么 0 和 2 就应该配给同一个 3D 点;两两决策没有地方表达这个约束,只能靠事后的一致性检查打补丁。全局自注意力把这些决策放进同一个 softmax 里一次算完,传递性隐式地由注意力权重的共享上下文保证。更深一层,密集场景里多对跨视角候选可能同时满足相近的成对几何代价——"每条鱼各自决策"会错得理直气壮,只有让每个检测看到全场(包括其他相机里所有竞争者)才能消除"几何上说得通但其实是错"的匹配。这个消融后面会看到,非常猛:把 Transformer 换成 MLP-only,MOTA 直接掉 17.4 个点,甚至输给无学习的手工几何基线。
位置信息用 2D RoPE 注入:投影后的 token 按 (cy,cx)(c_y, c_x)(cy,cx) 的归一化质心做旋转位置编码,128 维拆成两个 64 维半区,垂直/水平轴各管一半:
θk=caxis100002k/64⋅π,k=0,…,31\theta_k = \frac{c_{axis}}{10000^{2k/64}} \cdot \pi, \quad k = 0, \dots, 31θk=100002k/64caxis⋅π,k=0,…,31
(x1′,x2′)=(x1cosθk−x2sinθk, x1sinθk+x2cosθk)(x_1', x_2') = (x_1 \cos\theta_k - x_2 \sin\theta_k,\ x_1 \sin\theta_k + x_2 \cos\theta_k)(x1′,x2′)=(x1cosθk−x2sinθk, x1sinθk+x2cosθk)
RoPE 零参数、相对编码、平移等变——密集鱼群里"挨得近的检测"和"离得远的检测"能被区分开,又不依赖任何固定分辨率假设。做编解码器的人可以把 RoPE 理解成一种参数为零的相位调制:给每个 token 盖一个随空间位置旋转的相位戳,注意力内积时相位差自然涌现相对距离。
成对关联头是一个小 MLP:Pij=σ(Linear128→1(ReLU(Linear256→128([hi∥hj]))))P_{ij} = \sigma(\text{Linear}_{128\to 1}(\text{ReLU}(\text{Linear}_{256\to 128}([h_i \| h_j]))))Pij=σ(Linear128→1(ReLU(Linear256→128([hi∥hj])))),只对不同相机的有序对 (i,j)(i,j)(i,j) 生效,同相机对在构造上就被屏蔽。注意 [hi∥hj][h_i \| h_j][hi∥hj] 是有序拼接——Pij≠PjiP_{ij} \neq P_{ji}Pij=Pji,后面分组时要用固定行列顺序处理这个不对称。
2.3 几何伪监督:三角测量就是老师
没有身份标注,谁来告诉模型 PijP_{ij}Pij 该是 1 还是 0?答案是几何自洽性:
对同一时刻、不同相机的每一对检测,先三角化出一个候选 3D 点(DLT),再把该点重投影回两个像平面。如果这对检测是同一条鱼,重投影点应该落回原来的框里;不是同一条,重投影就会飘。据此构造二值伪标签矩阵 G∈{0,1}N×NG \in \{0,1\}^{N\times N}G∈{0,1}N×N:三角化点重投影落在两个框内 ⟹ Gij=1G_{ij}=1Gij=1。同相机对和自身对被 mask 掉,不参与监督。
考虑到几何噪声,正样本对还配一个置信度权重:
Cij=11+errijC_{ij} = \frac{1}{1 + err_{ij}}Cij=1+errij1
errijerr_{ij}errij 是两视图平均重投影误差(像素)。重投影误差越小,监督越硬。这套机制的本质是:把标定几何当成一个永不疲倦的自动标注员,它唯一的假设是标定矩阵正确——这个假设的脆弱性后面踩坑点会展开。
2.4 自监督关联损失:正负样本分账本
拿到 (G,C)(G, C)(G,C) 之后,监督就是一个置信度加权的 BCE,但有个巧妙的细节——正负样本独立归一化:
Lasso=−∑Gij=1CijlogPij∑Gij=1Cij−∑Gij=0log(1−Pij)∣{Gij=0}∣\mathcal{L}_{asso} = -\frac{\sum_{G_{ij}=1} C_{ij} \log P_{ij}}{\sum_{G_{ij}=1} C_{ij}} - \frac{\sum_{G_{ij}=0} \log(1 - P_{ij})}{|\{G_{ij}=0\}|}Lasso=−∑Gij=1Cij∑Gij=1CijlogPij−∣{Gij=0}∣∑Gij=0log(1−Pij)
正样本按置信度加权、按总置信度质量归一;负样本均匀权重、按数量归一。为什么这么讲究?密集场景里正样本对是稀缺的(NNN 个检测里真正的同鱼对占比很小),如果放一个分母里,负样本梯度会淹没正样本。独立归一化保证正负两本的"账"各自平衡——这个技巧在所有正负样本极不均衡的对比/关联任务里都值得抄。
该损失同时对帧 ttt 和 t+1t+1t+1 施加。
2.5 多视图分组与三角化:从概率到 3D 假设
推理(以及训练后半程)时,学到的 PijP_{ij}Pij 和嵌入一起变成混合亲和度:
Aij=wPPij+wfcos(hi,hj)+12,wP=0.6, wf=0.4A_{ij} = w_P P_{ij} + w_f \frac{\cos(h_i, h_j) + 1}{2}, \quad w_P=0.6,\ w_f=0.4Aij=wPPij+wf2cos(hi,hj)+1,wP=0.6, wf=0.4
(cos 项平移到 [0,1][0,1][0,1] 与概率项同域。)然后四步走:
- 每个相机对跑匈牙利匹配(用有向子矩阵,不对称化);
- 接受的匹配当边,并查集求连通分量 → 跨相机组;组内同相机多检测只留置信度最高者;少于两个独立相机的组丢弃;
- 每组 DLT 三角化出 3D 点,重投影落框校验,失败即整组拒绝;共享检测的重叠组保留置信度高者;
- 组嵌入 hˉg=ℓ2-norm(1∣g∣∑i∈ghi)\bar{h}_g = \ell_2\text{-norm}\left(\frac{1}{|g|}\sum_{i \in g} h_i\right)hˉg=ℓ2-norm(∣g∣1∑i∈ghi),作为这条鱼的身份 token。
还有一个实现层的置信度启发式:
conf(g)=min(1.0, 0.2+0.2 ncams)×{0.75ncams=21ncams≥3conf(g) = \min(1.0,\ 0.2 + 0.2\, n_{cams}) \times \begin{cases} 0.75 & n_{cams}=2 \\ 1 & n_{cams}\ge 3 \end{cases}conf(g)=min(1.0, 0.2+0.2ncams)×{0.751ncams=2ncams≥3
两视图组置信度 0.45、三视图组 0.8——双相机三角化的固有歧义被显式降权,且配一个更严的 0.8 接受阈值。工程味很浓但很必要:三视图都错到同一个 3D 点上的概率远小于两视图。
2.6 对比损失:给嵌入空间装上"身份分离器"
伪标签告诉模型"哪些对是同鱼",对比损失则把这个信息压进嵌入空间的几何结构里。同组检测互为正样本,其余全为负样本,InfoNCE 标准配方(τ=0.07\tau=0.07τ=0.07):
Lctr(i)=−log∑j∈Piexp(Sij)∑k=1,k≠iNexp(Sik),Sij=zi⊤zjτ, zi=hi∥hi∥\mathcal{L}^{(i)}_{ctr} = -\log \frac{\sum_{j \in P_i} \exp(S_{ij})}{\sum_{k=1, k\neq i}^{N} \exp(S_{ik})}, \quad S_{ij} = \frac{z_i^\top z_j}{\tau},\ z_i = \frac{h_i}{\|h_i\|}Lctr(i)=−log∑k=1,k=iNexp(Sik)∑j∈Piexp(Sij),Sij=τzi⊤zj, zi=∥hi∥hi
效果见图 3:不开对比损失,同鱼检测的嵌入和其他身份糊在一起;开了之后,每条鱼形成紧凑、分离良好的簇。注意因果链:分组产生正样本对 → 对比损失塑形嵌入 → 更好的嵌入反过来改善分组。这是个自举(bootstrap)闭环,靠 warmup 阶段先把 PijP_{ij}Pij 学靠谱才转得起来。
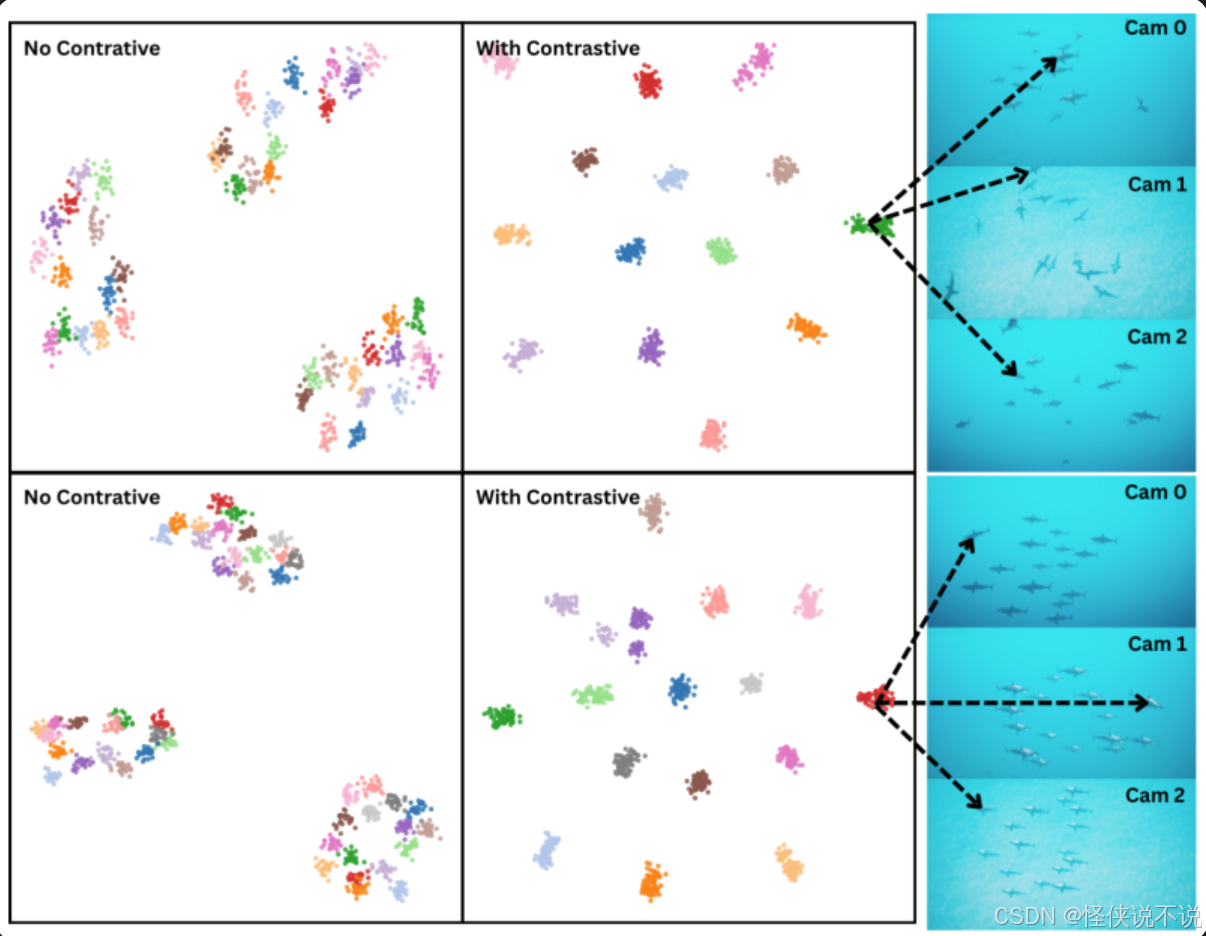
图 3(论文 Fig. 3):左列(无对比训练)同鱼嵌入与其他身份混杂;右列(有对比训练)每条鱼形成独立紧凑簇。右侧面板显示同一条鱼在三个相机中的观测被映射到同一簇。
2.7 时间预测器:嵌入空间里的"运动补偿"
帧内搞定了,帧间呢?TrackFish3D 的做法是在嵌入空间里做帧间预测——这可能是全文最有"编码器味"的设计。
相邻帧的组假设之间构造匹配代价:
cost(i,j)=α∥Xj(t+1)−Xi(t)∥dmax+β(1−cos(hˉi(t),hˉj(t+1))),α=0.6, β=0.4cost(i, j) = \alpha \frac{\|X_j^{(t+1)} - X_i^{(t)}\|}{d_{max}} + \beta \left(1 - \cos(\bar{h}_i^{(t)}, \bar{h}_j^{(t+1)})\right), \quad \alpha=0.6,\ \beta=0.4cost(i,j)=αdmax∥Xj(t+1)−Xi(t)∥+β(1−cos(hˉi(t),hˉj(t+1))),α=0.6, β=0.4
匈牙利匹配 + 距离门限(θdist=0.5\theta_{dist}=0.5θdist=0.5)+ 相似度门限(θsim=0.6\theta_{sim}=0.6θsim=0.6)双重门控,接受的匹配权重 wij=min(confi,confj)w_{ij} = \min(conf_i, conf_j)wij=min(confi,confj)。然后训练一个小 MLP 预测器 ρ\rhoρ(128→256→128):
hˉ^j(t+1)=ρ(hˉi(t)),Ltemp=∑(i,j)wij∥hˉ^j−hˉj(t+1)∥2∑(i,j)wij\hat{\bar{h}}_j^{(t+1)} = \rho(\bar{h}_i^{(t)}), \qquad \mathcal{L}_{temp} = \frac{\sum_{(i,j)} w_{ij} \| \hat{\bar{h}}_j - \bar{h}_j^{(t+1)} \|^2}{\sum_{(i,j)} w_{ij}}hˉ^j(t+1)=ρ(hˉi(t)),Ltemp=∑(i,j)wij∑(i,j)wij∥hˉ^j−hˉj(t+1)∥2
用视频编码的话说:ρ\rhoρ 就是嵌入空间的帧间预测器,hˉ(t)\bar{h}^{(t)}hˉ(t) 是参考帧,hˉ(t+1)\bar{h}^{(t+1)}hˉ(t+1) 是当前帧,Ltemp\mathcal{L}_{temp}Ltemp 预测残差能量最小化。它学到的不是恒速运动模型(那是 3D-SORT 干的事),而是"这条鱼在全场语境下下一个时刻的表征长什么样"——位置、朝向、与邻鱼的关系全在嵌入里。
推理时的收益直接兑现:track 消失 ggg 帧,就把 ρ\rhoρ 迭代滚 ggg 次(上限 5 次防漂移)去近似"它现在该是什么表征":hˉ^(t+g)=ρ(g)(hˉ(t))\hat{\bar{h}}^{(t+g)} = \rho^{(g)}(\bar{h}^{(t)})hˉ^(t+g)=ρ(g)(hˉ(t)),配合门限随 gap 松弛(θdistlocal=θdist(1+0.15g)\theta_{dist}^{local} = \theta_{dist}(1+0.15g)θdistlocal=θdist(1+0.15g)、θsimlocal=max(0.1,θsim−0.04g)\theta_{sim}^{local} = \max(0.1, \theta_{sim} - 0.04g)θsimlocal=max(0.1,θsim−0.04g))。这相当于把长期参考帧 + 自适应搜索窗口装进了跟踪器。位置侧另有指数平滑恒速外推 X^=Xlast+v(g+1)\hat{X} = X_{last} + v(g+1)X^=Xlast+v(g+1),v←0.7vnew+0.3voldv \leftarrow 0.7v_{new} + 0.3v_{old}v←0.7vnew+0.3vold——嵌入预测和位置外推双轨并行。
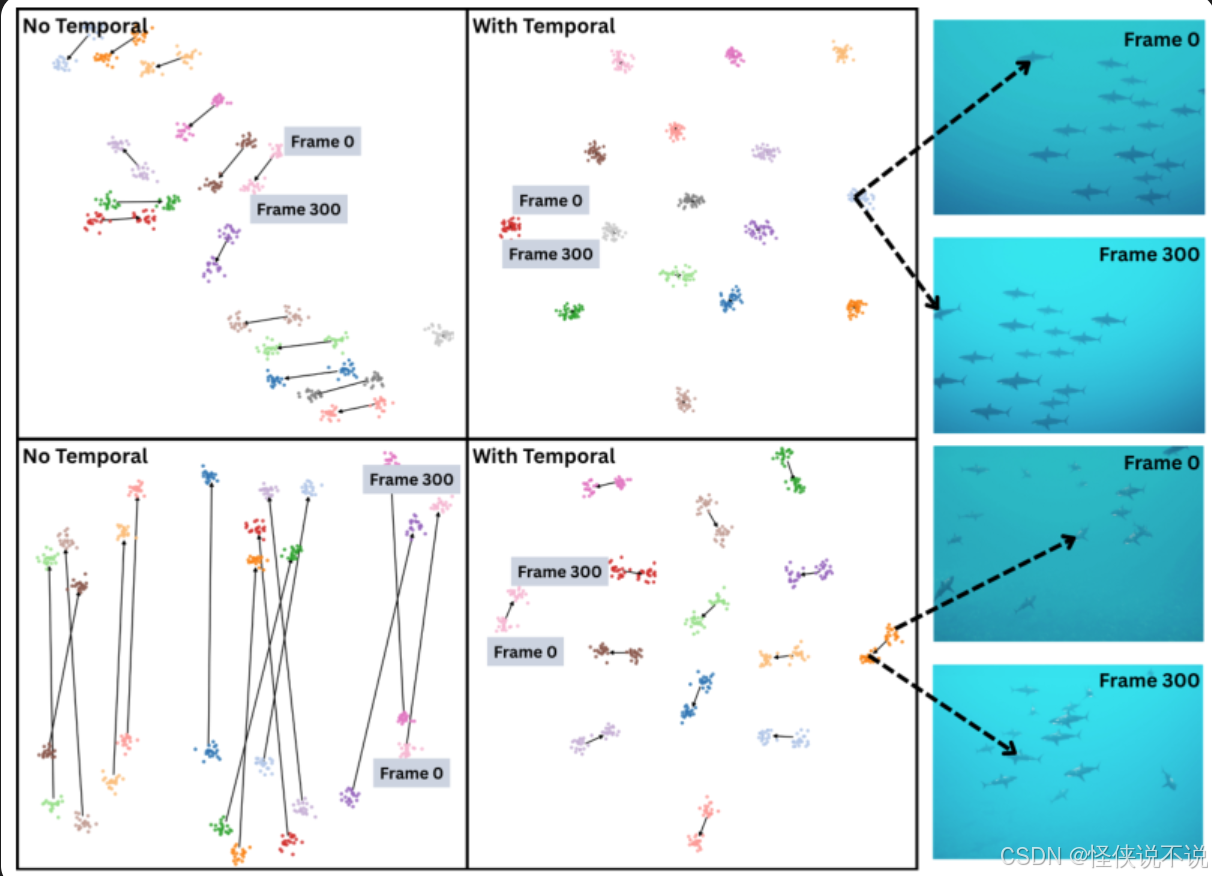
图 4(论文 Fig. 4):无时序训练时同鱼嵌入跨帧漂移导致 ID 切换;有时序训练后跨帧稳定,支撑遮挡桥接。
2.8 总损失与训练日程
L=Lasso+λctrLctr+λtempLtemp,λctr=0.5, λtemp=0.25\mathcal{L} = \mathcal{L}_{asso} + \lambda_{ctr}\mathcal{L}_{ctr} + \lambda_{temp}\mathcal{L}_{temp}, \quad \lambda_{ctr}=0.5,\ \lambda_{temp}=0.25L=Lasso+λctrLctr+λtempLtemp,λctr=0.5, λtemp=0.25
训练 400 epochs,前 100 epochs 只开 Lasso\mathcal{L}_{asso}Lasso(warmup)——先把跨相机对应关系学会,再引入分组→对比→时序的自举链条。三个损失各管一种失败模式:Lasso\mathcal{L}_{asso}Lasso 解跨视角歧义,Lctr\mathcal{L}_{ctr}Lctr 减帧内身份混淆,Ltemp\mathcal{L}_{temp}Ltemp 防时序身份漂移。
三、公式:监督信号的数学骨架
原理节已经把公式的角色讲清了,这里做一次系统化整理 + 两处推导,方便直接引用。
3.1 符号速查表
| 符号 | 含义 | 出处 |
|---|---|---|
| Kc,Rc,tcK_c, R_c, t_cKc,Rc,tc | 相机 ccc 内参、旋转、平移;投影 u=K[R∣t]Xu = K[R|t]Xu=K[R∣t]X | 输入假设 |
| pi=(ui,vi)p_i = (u_i, v_i)pi=(ui,vi) | 检测 iii 的分割掩码质心(像素) | 输入 |
| firaw∈R9f_i^{raw} \in \mathbb{R}^9firaw∈R9 | 归一化 2D 量 + 置信度 + 世界光线方向 | §3.1 |
| hi∈R128h_i \in \mathbb{R}^{128}hi∈R128 | Transformer 上下文化嵌入 | §3.2 |
| Pij∈(0,1)P_{ij} \in (0,1)Pij∈(0,1) | 跨相机有序对的同鱼概率(非对称) | §3.2 |
| Gij∈{0,1}G_{ij} \in \{0,1\}Gij∈{0,1}, Cij∈[0,1]C_{ij} \in [0,1]Cij∈[0,1] | 几何伪标签及其置信度 | §3.3 |
| hˉg\bar{h}_ghˉg | 组嵌入(ℓ2 归一化均值)= 身份 token | §3.5 |
| ρ\rhoρ | 时序预测器(128→256→128 MLP) | §3.7 |
3.2 DLT 三角化:伪标签的几何引擎
论文的伪标签生成依赖三角化(引 Hartley–Zisserman 的多视图几何)。DLT 的标准形式:世界点 X=(X,Y,Z,1)⊤X = (X, Y, Z, 1)^\topX=(X,Y,Z,1)⊤ 在相机 ccc 下的齐次投影满足 xc×(PcX)=0x_c \times (P_c X) = 0xc×(PcX)=0,其中 Pc=Kc[Rc∣tc]P_c = K_c[R_c | t_c]Pc=Kc[Rc∣tc],xcx_cxc 是观测像素的齐次坐标。把叉积展开成 3 个线性方程(其中 2 个独立),CCC 个视图堆叠出 2C2C2C 行的线性系统:
[⋮xc [Pc]3⋅−[Pc]1⋅yc [Pc]3⋅−[Pc]2⋅⋮]⏟A∈R2C×4X=0,X^=argmin∥X∥=1∥AX∥ (SVD 取最小奇异值对应的右奇异向量)\underbrace{\begin{bmatrix} \vdots \\ x_c\, [P_c]_{3\cdot} - [P_c]_{1\cdot} \\ y_c\, [P_c]_{3\cdot} - [P_c]_{2\cdot} \\ \vdots \end{bmatrix}}_{A \in \mathbb{R}^{2C \times 4}} X = 0, \quad \hat{X} = \arg\min_{\|X\|=1} \|AX\| \;\;(\text{SVD 取最小奇异值对应的右奇异向量})A∈R2C×4⋮xc[Pc]3⋅−[Pc]1⋅yc[Pc]3⋅−[Pc]2⋅⋮X=0,X^=arg∥X∥=1min∥AX∥(SVD 取最小奇异值对应的右奇异向量)
两条射线在 3D 里一般不相交(有噪声),DLT 给的是最小二乘意义下的"最近点"。伪标签的判据于是非常朴素:真匹配的两条射线近似共点,重投影误差 errijerr_{ij}errij 小;假匹配的两条射线在空间中乱指,重投影落不回原框。置信度 Cij=1/(1+errij)C_{ij} = 1/(1 + err_{ij})Cij=1/(1+errij) 是个饱和形函数——err→0err \to 0err→0 时权重趋 1,errerrerr 增大时按双曲线衰减,永不归零但对离谱匹配近乎 mute。
3.3 独立归一化 BCE 的梯度账本
普通 BCE 把正负项丢进同一个分母,梯度贡献比例由样本数天然决定——密集场景 N2N^2N2 量级的负对碾压少量正对。独立归一化后:
Lasso=−∑G=1CijlogPij∑G=1Cij⏟正项:按置信度质量归一−∑G=0log(1−Pij)∣{G=0}∣⏟负项:按计数归一\mathcal{L}_{asso} = \underbrace{-\frac{\sum_{G=1} C_{ij}\log P_{ij}}{\sum_{G=1} C_{ij}}}_{\text{正项:按置信度质量归一}} \underbrace{-\frac{\sum_{G=0}\log(1-P_{ij})}{|\{G=0\}|}}_{\text{负项:按计数归一}}Lasso=正项:按置信度质量归一−∑G=1Cij∑G=1CijlogPij负项:按计数归一−∣{G=0}∣∑G=0log(1−Pij)
对单个正样本对,其梯度权重是 Cij/∑kCkjC_{ij} / \sum_k C_{kj}Cij/∑kCkj——在正样本内部的相对权重,与负样本数量完全解耦;负样本同理。等价于两个各自归一的子损失的和,正负梯度流的比例被显式钉死在 1:1,不随 NNN、不随场景密度漂移。这就是论文说的"prevents negative-pair domination"的数学实体。
3.4 InfoNCE 的温度与"多正样本"变体
标准 InfoNCE 一个 anchor 只有一个正样本,这里 PiP_iPi 是集合(同组所有成员),分母仍是全体:
Lctr(i)=−log∑j∈Piezi⊤zj/τ∑k≠iezi⊤zk/τ,τ=0.07\mathcal{L}^{(i)}_{ctr} = -\log \frac{\sum_{j \in P_i} e^{z_i^\top z_j / \tau}}{\sum_{k \neq i} e^{z_i^\top z_k / \tau}}, \quad \tau = 0.07Lctr(i)=−log∑k=iezi⊤zk/τ∑j∈Piezi⊤zj/τ,τ=0.07
τ=0.07\tau=0.07τ=0.07 意味着 logits 除以 0.07(放大约 14 倍)——softmax 极度尖锐,损失集中在"最难区分的负样本"上,等价于一种 hard-negative 加权。分子里多正样本求和意味着:anchor 只要与任意一个同组观测靠近就不再受罚,这与"同一物体的多个视角观测天然等价"的多视图先验严丝合缝。
3.5 时序代价与门限松弛
时序匈牙利代价是位置与嵌入的凸组合:
cost(i,j)=0.6 ∥Xj(t+1)−Xi(t)∥dmax+0.4 (1−cos(hˉi(t),hˉj(t+1)))cost(i,j) = 0.6\,\frac{\|X_j^{(t+1)} - X_i^{(t)}\|}{d_{max}} + 0.4\,\big(1 - \cos(\bar{h}_i^{(t)}, \bar{h}_j^{(t+1)})\big)cost(i,j)=0.6dmax∥Xj(t+1)−Xi(t)∥+0.4(1−cos(hˉi(t),hˉj(t+1)))
通过条件:3D 距离 <θdist=0.5< \theta_{dist}=0.5<θdist=0.5 且 余弦相似度 >θsim=0.6> \theta_{sim}=0.6>θsim=0.6(双重硬门控,代价低不代表能配)。遮挡 ggg 帧后门限线性松弛、相似度门限线性收紧再夹底:
θdistlocal=θdist(1+0.15g),θsimlocal=max(0.1, θsim−0.04g)\theta_{dist}^{local} = \theta_{dist}(1 + 0.15g), \qquad \theta_{sim}^{local} = \max(0.1,\ \theta_{sim} - 0.04g)θdistlocal=θdist(1+0.15g),θsimlocal=max(0.1, θsim−0.04g)
距离门放宽(鱼会游远)、相似度门也放宽但有下限 0.1(嵌入完全不像的不许配)。附录 I 的消融显示 α∈[0.4,1.0]\alpha \in [0.4, 1.0]α∈[0.4,1.0] 全区间结果完全一致(95.8%),只有 α=0\alpha=0α=0(去掉距离项)才出现 IDSw/MTBF 劣化——即在关联质量足够好时,空间邻近性本身已是可靠的时序线索,嵌入项只是密集场景的保险。
3.6 事后拼接打分
score=sim−0.1⋅gap100−0.05⋅d3Dθmergescore = sim - 0.1 \cdot \frac{gap}{100} - 0.05 \cdot \frac{d_{3D}}{\theta_{merge}}score=sim−0.1⋅100gap−0.05⋅θmerged3D
相似度收益减去 gap 时间代价和 3D 距离代价,线性、无新参数、只在"3D 距离 ≤ 2.0 且余弦 > 0.45"的候选里挑最大值。一个典型的"够用就好"的工程公式——它不学习,纯粹复用训练好的嵌入做后验修复。
四、图示:一图看懂数据流
训练与推理的完整数据流(对应论文 Algorithm 1 与附录 D):
                        ┌─────────────────── 训练(Algorithm 1)───────────────────┐
                        │                                                          │
 2D 检测(各相机) ──► φ 编码 ──► RoPE ──► ψ Transformer ──► 成对头 ──► P_ij (跨相机有序对) │
                        │              │                              │           │
                        │              │            三角化+重投影落框 ──► G_ij, C_ij  │
                        │              │                              │           │
                        │              │            L_asso = 置信度加权BCE(独立归一化) │
                        │              │                              │           │
                        │              │    [warmup 后]               ▼           │
                        │              │    亲和度 A=0.6P+0.4·cos ──► 分组/三角化 ──► 组嵌入 h̄g
                        │              │                              │           │
                        │              │         InfoNCE(τ=0.07) ◄────┤ 同组=正样本│
                        │              │                              │           │
                        │              │         匈牙利(α·d3D+β·1-cos, 双门限)      │
                        │              │                    │                     │
                        │              │         ρ 预测器 + 加权MSE(L_temp)        │
                        │              └─── AdamW(lr 1e-4, clip 5) ◄──┘            │
                        └──────────────────────────────────────────────────────────┘

                        ┌─────────────────── 推理(三趟)──────────────────────────┐
                        │ Pass1: 逐帧编码→分组→三角化→3D假设+组嵌入                  │
                        │ Pass2: 时序跟踪(匈牙利+双门限;消失g帧→ρ滚动≤5次+          │
                        │         门限松弛;恒速外推;>15帧未现→移入坟墓)            │
                        │ Pass2.5: 事后拼接(非重叠片段, 3D距离≤2.0 + 余弦>0.45)    │
                        │ 后处理: 短缝线性插值 + 幽灵轨道过滤(所有方法统一,保公平)   │
                        └──────────────────────────────────────────────────────────┘
三个自监督信号的关系可以类比编码器模块:
| 自监督信号 | 作用位置 | 编码器类比 |
|---|---|---|
| 三角化+重投影伪标签 | 帧内跨视角 | 参考校验:重建点必须"落回"原框 |
| InfoNCE 对比损失 | 帧内嵌入空间 | 量化器:同一物体的观测映射到同一码字 |
| 时序预测损失 | 帧间嵌入空间 | 帧间预测:ρ\rhoρ 是嵌入空间的运动补偿 |
五、踩坑点:论文承认的与没明说的
范式级
坑 1:外观特征在视觉同质群体上是负资产。 这篇论文最狠的证据不是"我们好",而是"你们都烂":外观驱动的 Self-MVA 在 SynFish 上 MOTA −64.6%(96.9% 的轨迹 mostly-lost),SambaMOTR 在 3D-ZeF 上 −26.4%,MOTIP −45.9%。更扎心的是消融:把预训练 DINOv3 特征拼进来,MOTA 97.7→97.9(噪声级差异),MTBF 反而 283.1→270.2,IDSw 翻倍(0.5→1.1)。结论很清晰:当群体外观不可分辨时,外观特征不是弱信号,是噪声源。
坑 2:对比损失是承重墙,时序损失是锦上添花——且有依赖顺序。 消融数据说话:去掉 Lctr\mathcal{L}_{ctr}Lctr,MOTA 从 97.7 崩到 36.8(ML 从 0% 飙到 36.4%);去掉 Ltemp\mathcal{L}_{temp}Ltemp,97.7→86.0,IDSw 约翻四倍(0.5→2.0)。最 instructive 的是"两个都去掉"= 36.9 ≈ 只去 Lctr\mathcal{L}_{ctr}Lctr 的 36.8——没有视角一致的身份分离,时序预测根本没有可锚定的东西。想抄这套框架的人注意:自举链条的顺序(先关联 → 再对比 → 最后时序)不是可选项。
坑 3:伪标签精度随密度崩塌,但论文依然能用——靠的是"高召回噪声监督 + 学习式聚合"。 附录 S 的审计非常诚实:几何伪正样本对的精度从 4 条鱼的 70.8% 一路跌到 16 条的 25.3%、30 条的 17.0%,而召回始终 100%。也就是说,密集场景下大部分伪正样本其实是错的。为什么还能工作?论文的解释值得细读:学习式目标把噪声信号跨检测、跨视角、跨帧聚合后利用,而直接几何匹配把每个歧义关联当成最终决定。这本质上是"软判决 vs 硬判决"的老命题——和信道解码里软信息聚合优于逐比特硬判决是同构的。
坑 4:整套方法悬在标定精度这一根线上。 附录 J 做了外参扰动实验:σ=0.05\sigma=0.05σ=0.05 只掉 1.7pp,σ=0.1\sigma=0.1σ=0.1 掉 3.7pp,σ=0.2\sigma=0.2σ=0.2 直接掉 14.5pp(MT% 跌到 82.3%)。机理:外参误差经 P=K[R∣t]P = K[R|t]P=K[R∣t] 二次放大,物体离相机越远越糟。论文自己给出的工程红线:σR≲0.1°\sigma_R \lesssim 0.1°σR≲0.1°、σt≲0.1\sigma_t \lesssim 0.1σt≲0.1 世界单位。更糟的是附录 T:训练时就带标定噪声(σ=0.1 重新生成伪标签),3D-ZeF 从 81.1 掉到 66.8——系统不具备标定不变性,别指望"训练时见过的噪声"能免疫。
坑 5:检测噪声的密度放大效应。 附录 K 注入合成 FN/FP:σ=0.05 掉 5.5pp 还好;σ=0.4 时 MOTA 崩到 45.4%,且失败模式高度依赖密度——8 鱼场景还剩 51.4%,三个 16 鱼场景只剩 29–36%。原因很物理:FP 率高时每帧有效检测数约翻倍,跨相机组合的空间被组合爆炸。30 鱼压力测试(附录 R)同样如此:70.2% vs 16 鱼时的 95.8%——论文明确说这是单场景压力测试,不是容量声明。真实的大群高密度部署前,先掂量检测器质量。
工程级
坑 6:PijP_{ij}Pij 是非对称的,别手滑对称化。 成对头用有序拼接 [hi∥hj][h_i \| h_j][hi∥hj],Pij≠PjiP_{ij} \neq P_{ji}Pij=Pji。实现里匈牙利匹配用固定行/列相机顺序的有向子矩阵,不做对称化。这是论文附录 M.1 明确写的实现细节,复现时如果图省事对称化,等于丢掉了模型学到的方向性信息。
坑 7:双相机组要单独对待。 组置信度启发式给两视图组 0.45、三视图组 0.8,且推理时两相机组用更严的 0.8 接受阈值(其余 0.5)。双视图三角化的歧义是结构性的——两个平面射线永远交于一点,没有第三视图仲裁,误匹配率天然高。
坑 8:正文表格里有两组 bit-identical 的可疑数据。 Table 2 中 SAM3+Hungarian 与 SAM3+Greedy 六项指标完全相同(83.5 / 71.9 / 0.0 / 7.5 / 12.8 / 183.8),YOLO26+SAM2 的两行同样如此(连 MTBF 183.1 都一致)。匈牙利和贪心在简单场景给同样结果不奇怪,但 MTBF 这种对碎片模式敏感的统计量也逐位相同,更像是排版复制。另有内部不一致:消融表的"full"是 97.7%,而正文 Table 2 最好 96.6%、Table 5 是 95.8%——三处对不上,论文未解释消融的评测设置差异。引用数字时以 Table 2 为准,并建议对照原文核验。
坑 9:鸽子实验的诚实小字。 3D-POP Pigeon10 上 TrackFish3D 拿了最好的 MOTA(91.9%)和 recall(94.5%),但 IDF1(91.9% vs 95.1%)和 IDSW(3 vs 1)输给了 MOTIP。论文自己承认了。而且 Pigeon10 主要是地面行走、不是持续 3D 飞行——"跨物种泛化"的强度要按论文的措辞理解:初步证据,不是完全验证。
坑 10:自举闭环的工程配套缺一不可。 训练里有三个不起眼但关键的细节:① warmup 100 epochs 只开 Lasso\mathcal{L}_{asso}Lasso,否则分组还没谱就给对比损失喂垃圾正样本;② 伪 GT 预计算并缓存成 .npz,保证跨 epoch 确定性;③ 处理帧对 (t,t+1)(t, t+1)(t,t+1) 后,帧 t+1t+1t+1 的编码结果 detach 后复用为下一帧对的输入,编码成本减半。时序损失还需要滑动窗口 track memory(W=10)随序列推进累积——所以训练必须按时间顺序遍历帧对,不能打乱。
坑 11:别被 IDSw=0 骗了。 看 Table 2 里 SambaMOTR 那行:IDSw = 0.0,看着很美,但 MT% 只有 11.7%、ML 高达 73.8%、MOTA −10.5%。解读陷阱在于:轨迹死了再重生会被当成"新身份"而不是"切换",所以一条见谁灭谁的跟踪器可以刷出漂亮的 IDSw。照妖镜是 Frag 和 MTBF——前者数断点,后者算平均无故障时间。做评测、读评测都一样:单看任何一个 MOT 指标都能被讲故事,必须六项连读。
坑 12:难度指标是自定义的,跨论文不可比。 论文用 OccScore(帧-视图内最大两两 bbox IoU 的均值)和 %Overlap(有重叠的帧-视图比例,IoU>0.01)刻画难度,两个都是自造指标。SynFish test4 的 %Overlap=100% 意味着每个帧-视图里都有遮挡发生,但阈值定得很松。跟其他论文比"遮挡程度"时别拿这两个数直接对表,拿鱼数和分辨率这类硬量。
坑 13:伪标签审计的真值只做诊断、不进训练。 附录 S 用 SynFish 的 GT 身份审计伪标签质量,容易误读成"训练偷偷用了标注"——论文明确 GT 只用于该诊断。但有个更微妙的问题值得复现者警觉:伪标签精度审计只做了合成数据,真实场景(3D-ZeF)的伪标签精度论文没给——真实标定误差与检测误差叠加下的伪标签噪声有多大,只能从最终性能间接反推。
六、源码拆解:从 Algorithm 1 重建训练循环
论文未开源(截至写作),以下按附录 A 的 Algorithm 1 + 附录 B/C/D/M 的实现细节重建 Python 化伪代码(注明出处)。
6.1 模型参数预算(附录 B / Tab. 6)
| 模块 | 结构 | 参数量 | 占比 |
|---|---|---|---|
| 几何编码器 ϕ\phiϕ | MLP 9→64→128 + LayerNorm | 9,216 | 1.4% |
| 关联 Transformer ψ\psiψ | 输入投影 16,512 + 4 层 × 132,480 + 成对 MLP 33,025 | 579,457 | 88.5% |
| 时间预测器 ρ\rhoρ | MLP 128→256→128 + LayerNorm | 66,432 | 10.1% |
| 合计 | ≈655K | 100% |
整个模型比典型 ViT tracker 小两个数量级——因为鱼长得都一样,大视觉骨干网络根本没有存在必要。这个"负空间推理"式的架构决策本身就是论文论点的一部分。
6.2 训练主循环(对应附录 A Algorithm 1)
# 伪代码:出处 = 附录 A Algorithm 1 + 附录 C 训练细节
for epoch in range(1, 401):
    full = epoch > 100                        # warmup: 前 100 epochs 只开 L_asso
    for scene in train_scenes:                # 8 个 SynFish 场景
        M = TrackMemory(window=10)            # 滑动窗口轨迹记忆
        for t, t1 in consecutive_pairs(scene):  # 必须按时间顺序(L_temp 依赖 M)
            # ---- Stage 1: 编码与关联(帧 t 与 t+1 各一次)----
            F  = phi(dets)                        # [N,128] 几何嵌入
            H  = transformer(rope(proj(F)))       # 全局自注意力 + RoPE
            P  = pairwise_mlp(pair_cat(H))        # 仅跨相机有序对,σ 输出
            # ---- Stage 2: 伪监督与关联损失 ----
            G, C = pseudo_gt_cache[dets]          # 三角化+落框校验, 预计算 .npz
            loss_asso = weighted_bce(P, G, C)     # 正负样本独立归一化
            loss_ctr = loss_temp = 0
            if full:
                # ---- Stage 3: 分组与三角化 ----
                A = 0.6*P + 0.4*(cos_sim(H,H)+1)/2
                groups = group_and_triangulate(A, dets, cams)   # 匈牙利→并查集→DLT→落框校验
                groups = prune_by_confidence(groups)            # conf: 2视角0.45/3视角0.8
                hbar  = {g: l2_norm(mean(H[members])) for g in groups}
                # ---- Stage 4: 对比学习 ----
                loss_ctr  = infonce(H, same_group_pairs, tau=0.07)
                # ---- Stage 5: 时序链接与预测 ----
                T  = hungarian(cost=0.6*d3d_norm + 0.4*(1-cos),
                               gates=(dist<0.5, sim>0.6))
                Tf = fallback_match(groups[t1], M)              # gap 门限松弛 0.15/0.04
                loss_temp = weighted_mse(rho(hbar[t]), hbar[t1], T | Tf)
            loss = loss_asso + 0.5*loss_ctr + 0.25*loss_temp
            adamw_step(loss, grad_clip=5.0)
            M.append(groups[t])                   # 轨迹入记忆
两处工程优化值得注意(附录 C):伪 GT 一次性预计算缓存保证确定性监督;帧 t+1t+1t+1 的编码 detach 后跨帧对复用,编码成本减半且不影响梯度。checkpoint 按训练目标最低选取(epoch 396/397),测试集不参与模型选择。
6.3 推理跟踪器(对应附录 D,三趟式)
# Pass 1: 逐帧 3D 假设重建(no_grad, 可 FP16)
for t in frames:
    H = transformer(rope(proj(phi(dets[t]))))
    P = pairwise_mlp(...)                     # 推理阈值 0.5,两相机组 0.8
    groups = hungarian_per_cam_pair(A) → union_find → 每组每相机留最高分
    X, zg = dlt_triangulate(groups), l2norm(mean(H[members]))
    # 组间重叠 → 留置信度高的组

# Pass 2: 在线时序跟踪
for t in frames:
    for track in active_tracks:               # g = 消失帧数
        z_hat = l2norm(rho_iter(z_last, min(g, 5)))   # ρ 滚动,上限 5 防漂移
        X_hat = X_last + v*(g+1)                       # 指数平滑恒速外推
        θd, θs = 0.5*(1+0.15*g), max(0.1, 0.6-0.04*g)  # 门限随 gap 松弛
    T = hungarian(cost=0.6*d3d(X_hat,X)/θd + 0.4*(1-cos(z_hat,z)))
    未匹配组 → 新生 track;>15 帧未现 → 坟场

# Pass 2.5: 事后拼接(非重叠片段)
for B in dead_tracks:                          # 按出生时间排序
    for A in earlier_ending(A.end < B.start):
        if d3d(A.last, B.first) <= 2.0 and cos(A.last_emb, B.first_emb) > 0.45:
            score = sim - 0.1*gap/100 - 0.05*d3d/2.0   # 取最优者合并
# 后处理(所有基线统一): 短缝线性插值 + <2 次观测的幽灵轨道过滤
拼接打分 sim − 0.1·gap/100 − 0.05·d3D/θmerge 很有"率失真"味:相似度是收益,gap 和距离是代价,三项线性加权取最优——简单、无新参数、全程复用训练学到的表征。
6.4 关键超参数表(附录 C Tab. 7 节选)
| 类别 | 参数 | 值 |
|---|---|---|
| 优化器 | AdamW / lr / weight decay / grad clip | 1e-4 / 1e-4 / 5.0 |
| 损失权重 | λasso/λctr/λtemp\lambda_{asso} / \lambda_{ctr} / \lambda_{temp}λasso/λctr/λtemp | 1.0 / 0.5 / 0.25 |
| 分组 | θassoc\theta_{assoc}θassoc / (wP,wf)(w_P, w_f)(wP,wf) / θconf\theta_{conf}θconf / 双相机阈值 | 0.6 / (0.6,0.4) / 0.3 / 0.8 |
| 时序链接 | α/β/θdist/θsim\alpha / \beta / \theta_{dist} / \theta_{sim}α/β/θdist/θsim | 0.6 / 0.4 / 0.5 / 0.6 |
| 回退匹配 | gap 距离松弛 / 相似度衰减 | 0.15 / 0.04 |
| 事后合并 | θmerge\theta_{merge}θmerge / 相似度阈值 | 2.0 / 0.45 |
| 对比 | 温度 τ\tauτ / 粒度 | 0.07 / detection 级 |
| 调度 | 总 epochs / warmup / 记忆窗口 W | 400 / 100 / 10 |
七、效果对比:数字说话
7.1 SynFish 测试集(6 个 held-out 场景,4–16 鱼;Tab. 2)
| 方法 | MOTA↑ | MT%↑ | ML%↓ | IDSw↓ | Frag↓ | MTBF↑ |
|---|---|---|---|---|---|---|
| SAM3 + Hungarian | 83.5% | 71.9% | 0.0% | 7.5 | 12.8 | 183.8 |
| SAM3 + 3D-SORT | 87.7% | 77.1% | 0.0% | 4.0 | 9.0 | 209.4 |
| YOLO26+SAM2 + Hungarian | 82.2% | 69.8% | 0.0% | 8.7 | 12.2 | 183.1 |
| Self-MVA | −64.6% | 0.0% | 96.9% | 1.7 | 2.2 | 15.9 |
| ASNet | 33.3% | 49.6% | 11.5% | 20.8 | 29.0 | 60.7 |
| SambaMOTR | −10.5% | 11.7% | 73.8% | 0.0 | 7.8 | 51.8 |
| MOTIP | 14.7% | 21.4% | 42.9% | 0.0 | 25.7 | 41.2 |
| ReST | 61.3% | 74.8% | 0.0% | 173.7 | 78.5 | 17.5 |
| MCTR | 83.7% | 82.7% | 0.0% | 1.7 | 14.2 | 160.6 |
| TrackFish3D (SAM3) | 95.8% | 95.8% | 0.0% | 0.0 | 6.5 | 266.3 |
| TrackFish3D (YOLO26+SAM2) | 96.6% | 95.8% | 0.0% | 0.2 | 3.7 | 296.5 |
两个细节值得咀嚼:零 ID 切换(SAM3 版本六个场景 IDSw 全为 0),以及 ReST 那个刺眼的 IDSw=173.7——外观驱动的多相机方法在鱼群上不是"性能差",是"系统性崩溃"。
先给不常碰跟踪指标的读者补一下尺子:MOTA 综合误检、漏检和切换数(可裸奔到负值,所以表里那些 −64.6% 不是排版错误,是"错误比正确多");MT%/ML% 是轨迹级统计(80% 以上时间被跟踪到 / 丢失);IDSw 是身份切换次数;Frag 是轨迹碎片数;MTBF(平均无故障时间)用"两次失败间的平均帧数"把碎片和切换合成一个可读数——对应用侧这个指标往往比 MOTA 更诚实,因为一条频繁断-接的轨迹对行为分析毫无用处。
再看逐场景拆解(附录 Tab. 12),密度才是真正的试金石:
| 场景(鱼数 / 重叠率) | TrackFish3D (SAM3) | SAM3+Hungarian | MCTR | ReST |
|---|---|---|---|---|
| test1(4 鱼 / 0.2%) | 99.6% | 100% | 99.4% | 81.0% |
| test2(5 鱼 / 0.3%) | 99.9% | 100% | 46.9% | 73.1% |
| test3(8 鱼 / 68%) | 96.2% | 93.8% | 86.9% | 80.4% |
| test4(16 鱼 / 100%) | 86.2% | 55.2% | 83.3% | 54.2% |
| test5(16 鱼 / 99.9%) | 94.8% | 75.1% | 88.0% | 32.4% |
| test6(16 鱼 / 99.1%) | 98.0% | 77.1% | 97.5% | 46.8% |
稀疏场景(test1/test2)大家都满分——此时匈牙利匹配已经是最优解,学习没有增量价值。差距在 test4 拉开到 31 个百分点(86.2 vs 55.2):100% 帧重叠率的 16 鱼场景,正是 2.2 节说的"多个几何候选同样说得通"的设定,全局注意力的场景级上下文在这里兑现价值。有趣的是 test4 反而是 TrackFish3D 六个场景里最差的(86.2%),而同样 16 鱼的 test6 靠 98.0%——test4 的相机 rig 让三视图同时可见的鱼更少,再次印证:几何方法的软肋永远在可见性,不在模型容量。
密度曲线上(图 5)更直观:8 条鱼是分水岭,基线断崖式下跌,TrackFish3D 平滑滑落(16 鱼场景仍 >86%)。
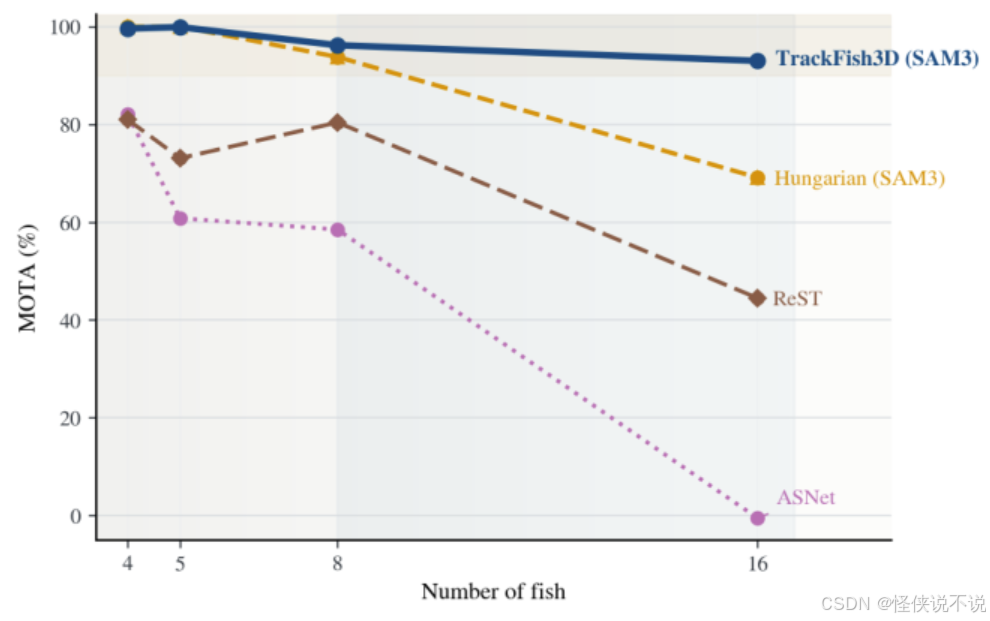
图 5(论文 Fig. 5):TrackFish3D(深蓝)随密度几乎不掉,Hungarian/ReST/ASNet 在 8 鱼后跳水。
定性对比(图 6)里更惨烈:ASNet 和 ReST 的跟踪结果被满屏红色"False"标签淹没,而 TrackFish3D 与真值几乎逐帧对齐。
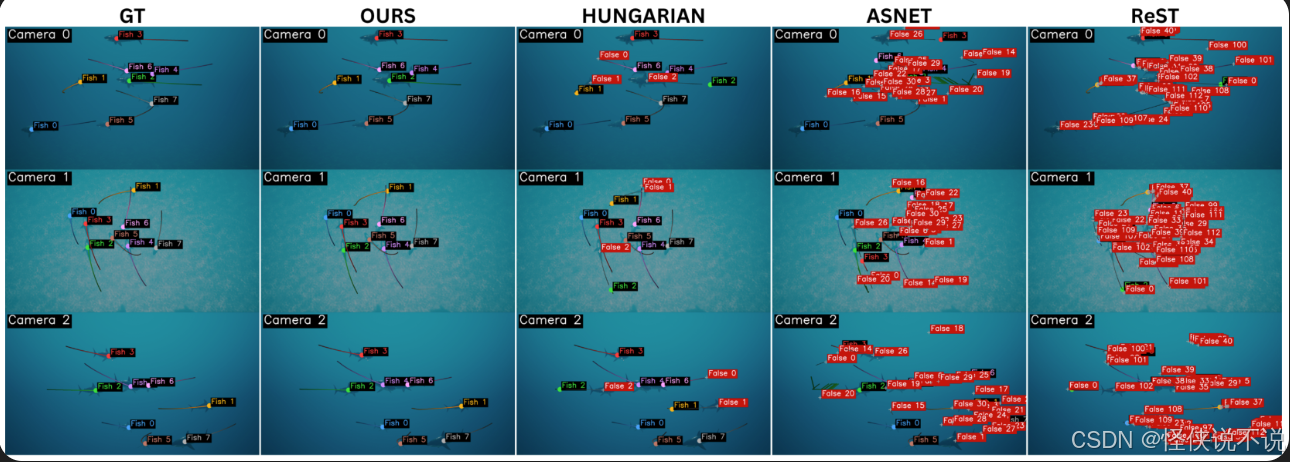
图 6(论文 Fig. 6):GT / TrackFish3D / Hungarian / ASNet / ReST 三视角轨迹对比,颜色编码鱼身份,断裂即身份切换或碎片。
7.2 真实数据 3D-ZeF(斑马鱼,Tab. 3)
| 方法 | MOTA↑ | MT%↑ | IDSw↓ | Frag↓ | MTBF↑ |
|---|---|---|---|---|---|
| Hungarian + NN | 77.4% | 90.0% | 6.0 | 73.0 | 42.5 |
| 3D-SORT | 75.6% | 90.0% | 13.5 | 65.5 | 43.4 |
| Self-MVA | 50.8% | 60.0% | 21.5 | 73.5 | 48.5 |
| ReST / MCTR | 0.0% / 0.1% | 0.0% | — | — | — |
| TrackFish3D | 81.1% | 90.0% | 4.0 | 30.5 | 93.6 |
只有 5 条鱼,跨视角关联本身稀疏,MOTA 差距不大(+3.7pp)。但身份稳定性是量级差异:碎片从 73 降到 30.5,MTBF 从 42.5 翻倍到 93.6——真实遮挡下,逐帧几何匹配不够,学出来的时序链接才是护城河。图 7 里 ReST 直接交白卷(无轨迹)。
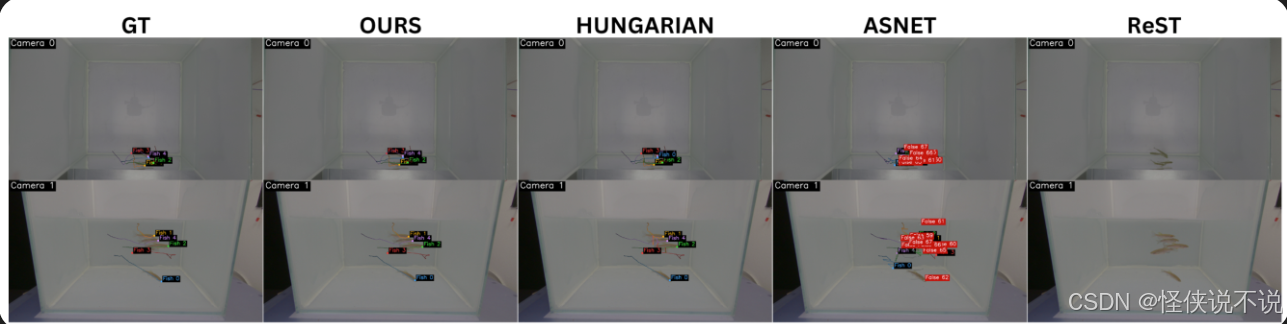
图 7(论文 Fig. 7):真实斑马鱼序列上的轨迹对比,TrackFish3D 在真实遮挡中保持身份一致。
7.3 消融(Tab. 4 / Tab. 5)
| 变体 | MOTA | MT% | IDSw | Frag | MTBF |
|---|---|---|---|---|---|
| TrackFish3D (full) | 97.7% | 98.3% | 0.5 | 3.1 | 283.1 |
| w/o Ltemp\mathcal{L}_{temp}Ltemp | 86.0% | 85.2% | 2.0 | 5.2 | 243.1 |
| w/o Lctr\mathcal{L}_{ctr}Lctr | 36.8% | 23.8% | 3.0 | 8.0 | 99.1 |
| w/o both | 36.9% | 25.6% | 3.8 | 9.8 | 88.8 |
| + DINOv3 外观特征 | 97.9% | 99.2% | 1.1 | 3.2 | 270.2 |
| Transformer → MLP-only | 78.4% | 64.2% | 2.0 | 16.3 | 172.9 |
MLP-only 这个消融常被忽略但信息量大:同样的数据、同样的三个损失,只把全局自注意力换成逐 token 独立处理,MOTA 78.4%,比无学习的 SAM3+Hungarian(83.5%)还低——独立 token 处理在密集场景里连手工几何代价都打不过。场景级上下文不是锦上添花,是必要条件。
7.4 学习式预测 vs 恒速 Kalman:附录 Q 的对照实验
3D-SORT(SAM3 + 匈牙利 + 恒速 Kalman)是全文最强的基线,值得单独拆:SynFish 上它把 Hungarian+NN 的 83.5% 提到 87.7%(IDSw 7.5→4.0,Frag 12.8→9.0)——Kalman 确实在平滑运动下桥接了短缝隙。但 3D-ZeF 上方向反了:MOTA 75.6%(比 Hungarian 还低 1.8pp),IDSw 反而 6.0→13.5。论文的解释一针见血:外观相同的鱼交叉或急转时,恒速外推的位置会离"另一条鱼"更近,Kalman 亲手把身份推给了别人。而 TrackFish3D 的 ρ\rhoρ 预测的不是坐标,是"这条鱼在全场语境下的下一帧表征"——位置、朝向、邻鱼关系全在 128 维嵌入里,做的是条件于场景的预测而非逐体的线性外推。这是"学出来的运动模型"对"手工运动模型"的一次正面胜利,也解释了为什么 SynFish(鱼群游动平滑)上 Kalman 有增益、3D-ZeF(真实鱼变向更随机)上变成负资产。
7.5 鲁棒性与成本(附录 J/K/L/R/T)
| 实验 | 条件 | MOTA |
|---|---|---|
| 标定噪声(推理期) | σ=0.05 / 0.1 / 0.2 | 94.1% / 92.1% / 81.3% |
| 检测噪声(FN+FP) | σ=0.05 / 0.1 / 0.2 / 0.4 | 90.3% / 84.1% / 72.3% / 45.4% |
| 训练期标定噪声 σ=0.1 | 3D-ZeF | 66.8%(clean 为 81.1%) |
| 30 鱼压力测试 | 单场景 | 70.2%(基线仅 29.9%) |
| 运行时 | A100, 655K 参数 | 训练 17h36m;推理 124.8 ms/帧;显存 0.02 GB |
推理一帧 125ms、显存 20MB——这不是大模型,是个嵌入式友好的轻量模块(16 鱼 × 3 相机才 48 个 token,注意力矩阵 2,304 项)。
7.6 跨物种与下游应用(附录 P / O)
鸽子(3D-POP seq48,4 序列训练 1 序列测试):MOTA 91.9%、recall 94.5%、Frag 4 均为最佳;IDF1 91.9% 仅次于 MOTIP 的 95.1%。
异常行为检测的原理性验证很漂亮。实验设置:8 鱼场景埋一条"病鱼"(游速减半、游离子群、游向紊乱),拿 TrackFish3D 的 3D 轨迹提取 9 维行为特征(均速、速度方差、路径直线度、质心距离、最近邻距离等),滑窗仅 3 帧(359 个窗)跑三种无监督检测器:
| 输入 | Iso. Forest F1 | LOF F1 | Z-score F1 | 共识 F1 |
|---|---|---|---|---|
| 2D Cam 0 | 48.2% | 45.7% | 85.2% | 52.1% |
| 2D Cam 1 | 51.8% | 44.0% | 0.0% | 42.9% |
| 2D Cam 2 | 36.5% | 25.9% | 12.3% | 25.9% |
| 3D(TrackFish3D) | 78.8% | 80.2% | 93.9% | 80.8% |
这张表的杀伤力在于 2D 侧的方差:同一套管线换个视角就从 85.2% 跌到 0.0%(Cam 1 里病鱼的投影运动和健康鱼没差别),而 3D 融合把视角不变性变现成了检测稳定性。病鱼"速度减半 + 质心距离拉大"的运动学签名,只有重建出 3D 轨迹才能跨视角稳定提取——3D 重建不是精度的锦上添花,是特征有效性的前提。
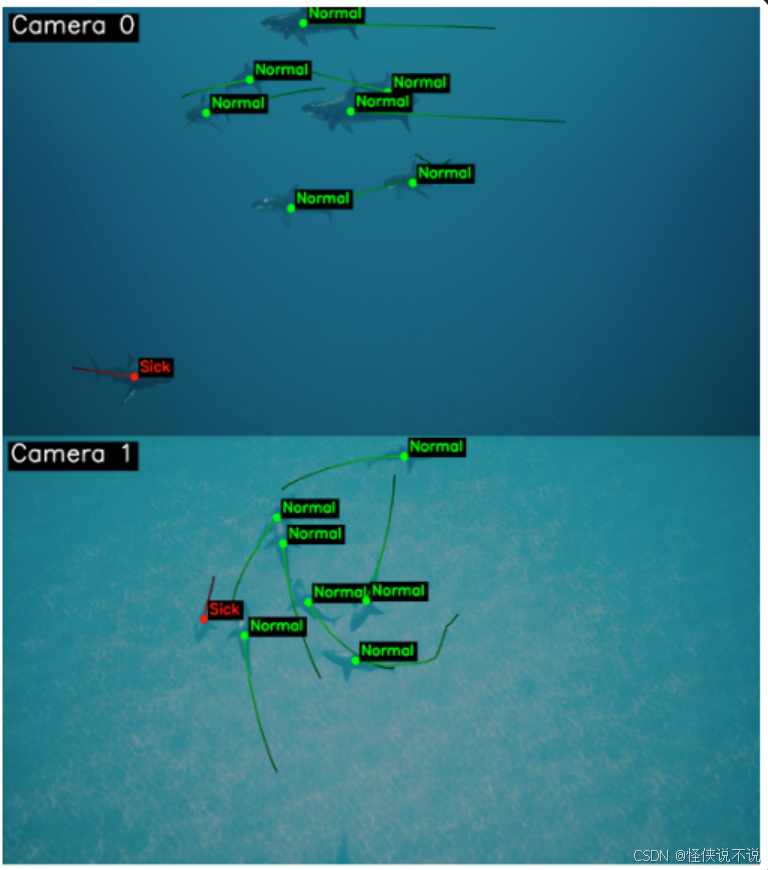
图 8(论文 Fig. 8):病鱼(红)与健康鱼(绿)在"均速 × 质心距离"特征平面上干净分离——全部来自预测轨迹,零行为标注。
八、总结
TrackFish3D 的核心命题可以浓缩成一句话:当外观失效时,几何和时间一致性就是免费的监督信号——三角测量-重投影自洽性生成跨视角伪标签,对比学习把伪标签铸进嵌入空间的分离结构,时序预测器把身份一致性延伸过遮挡。655K 参数、零身份标注、零 3D 真值、推理 125ms/帧。
边界也要说清楚:它悬在标定精度上(σR≲0.1°\sigma_R \lesssim 0.1°σR≲0.1° 的工程红线)、悬在检测质量上(σ=0.4 检测噪声时崩溃且密度越高越糟)、伪标签精度随密度衰减(30 鱼时仅 17%)、训练不具备标定不变性。30 鱼以上的真实大群还没验证——注意力 O(N2)O(N^2)O(N2) 反而不是瓶颈,几何可见性才是。
放到更大的图景里,这篇工作给我的启发有三条:
- "自监督"的正确打开方式不一定是对比学习或掩码重建,可以是物理一致性。多视图几何、重投影误差、时序平滑——这些"免费的物理约束"在被当成监督信号时,比任何人工标注都便宜且永不疲倦。这和视频编码里"率失真最优"从不依赖理解图像内容、只依赖数学约束是同一种工程哲学。
- 消融的诚实度决定论文的可信度。这篇论文的附录 S(伪标签精度只有 17% 依然能用)、附录 P(鸽子 IDF1 输给 MOTIP)、附录 T(训练期标定噪声掉 14pp)都在主动暴露自己的软肋——这种"给你看伤口"的写法比 95.8% 的 MOTA 更值得学习。
- 架构要为问题裁剪,而不是为榜单膨胀。既然鱼长得一样,就砍掉视觉骨干;既然每帧才 48 个 token,就用 4 层小 Transformer。最终 655K 参数、20MB 显存的模型打赢了所有 50M+ 的对手——在边缘设备部署动物行为监测这件事上,这个参数预算表可能比 MOTA 数字更有实用价值。
下一步如果关注这条线,值得盯的是:真实(非合成)高密度多相机动物数据集的出现,以及对标定误差的显式建模(比如把外参不确定性当作可学习的噪声项注入伪标签置信度 CijC_{ij}Cij)——这两件事任何一件落地,这套几何驱动的配方就有机会从水族箱游向真正的远洋。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献21条内容

所有评论(0)