【老计带你懂AI算法】19:强化学习与RLHF,在试错中学习,还教会了ChatGPT好好说话
【老计带你懂AI算法】19:强化学习与RLHF,在试错中学习,还教会了ChatGPT好好说话
开头:一种最像生物本能的学习方式
前面讲的模型,学习方式大体两类:监督学习(给标准答案照着学)和无监督学习(没答案自己找规律)。这一篇讲第三类,也是最像生物本能的一种,强化学习(Reinforcement Learning)。
想想你怎么学会骑自行车的?没人给你标准答案,你就是不停地试,歪了、摔了(惩罚),慢慢找到平衡、骑稳了(奖励),在一次次试错中掌握了这门技能。动物训练也一样,小狗做对动作就给块肉(奖励),它就慢慢学会了。这种"通过试错、根据奖惩来学习"的方式,就是强化学习。
它专门对付一类前面模型搞不定的问题,需要在一个环境里连续做决策、每一步影响后续、追求长期总回报的任务。下围棋、打游戏、控制机器人、自动驾驶决策,都是这类。而且它还立了个大功,教会了ChatGPT好好说话,这个后面重点讲。
强化学习的基本框架:智能体和环境的互动
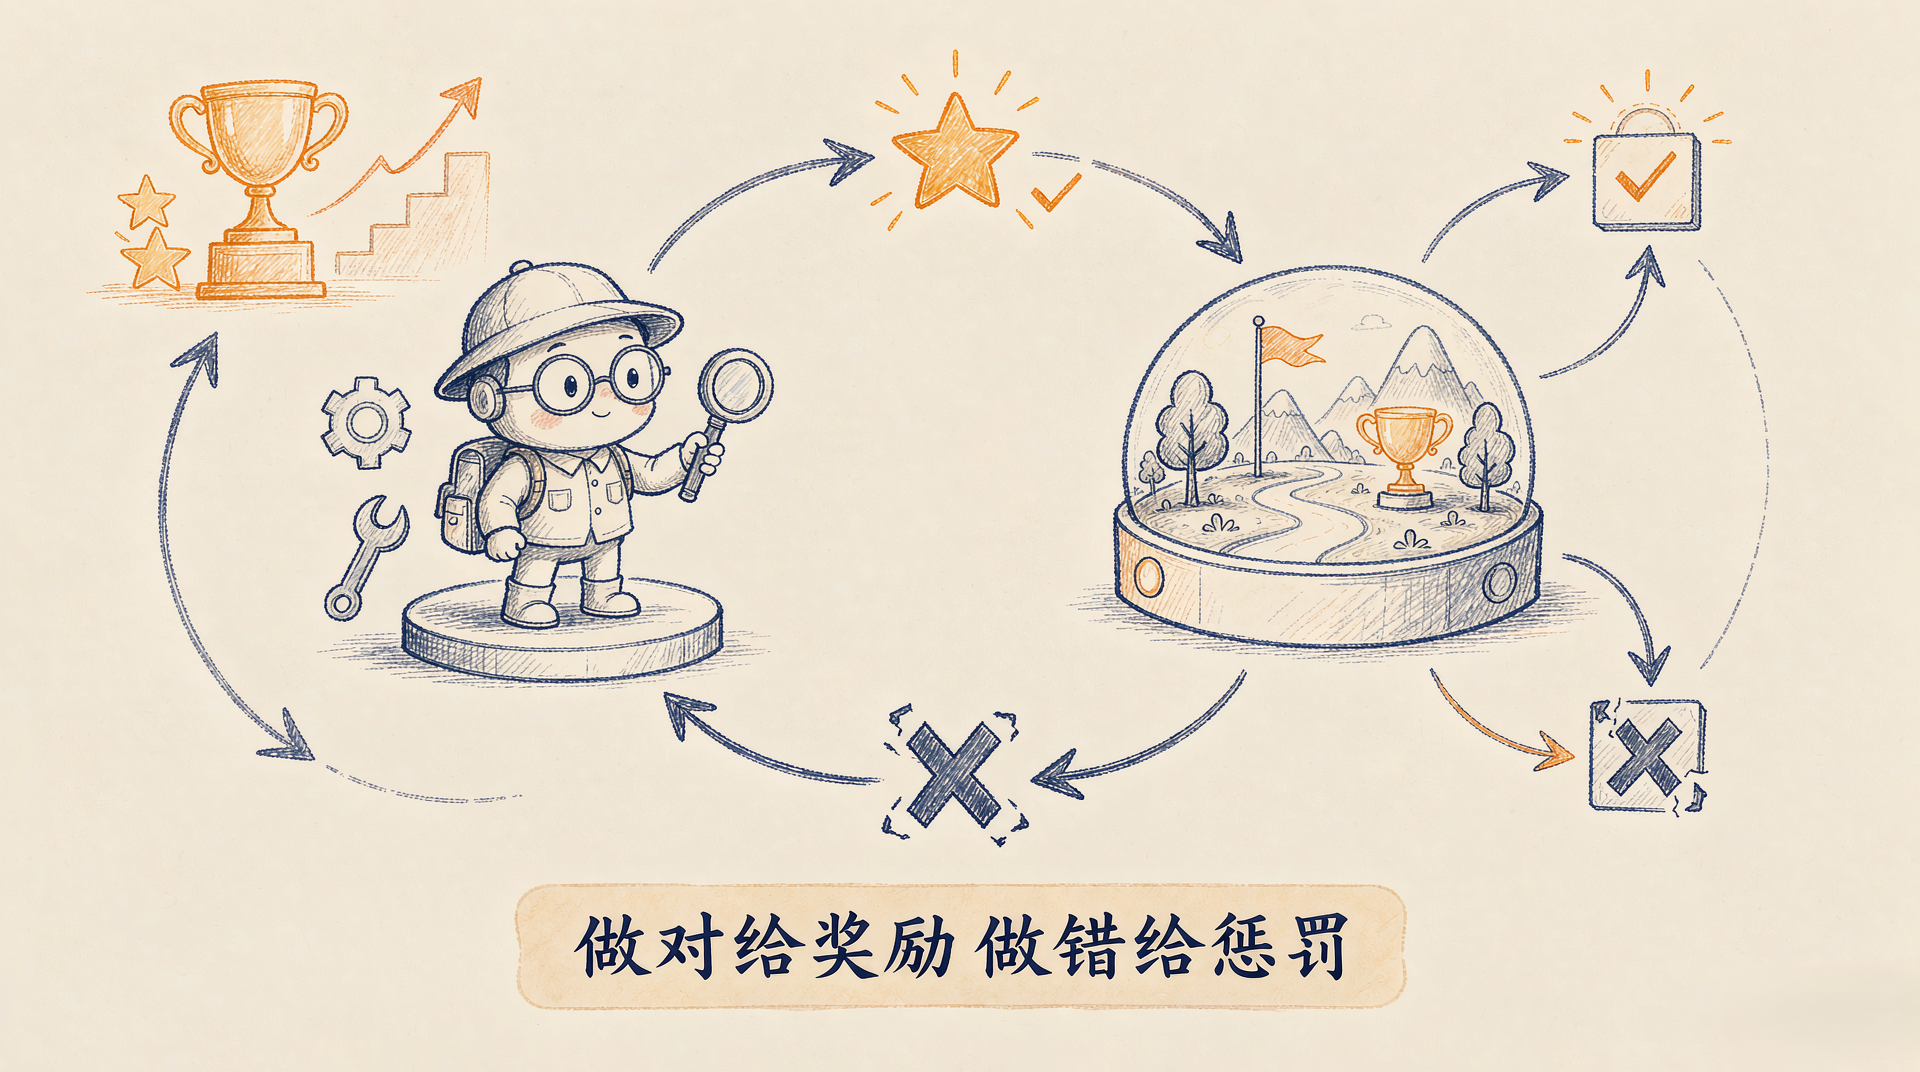
强化学习有一套很清晰的框架,理解了这几个角色,就懂了它的运作方式:
- 智能体:那个要学习、要做决策的主角(比如下棋的AI、玩游戏的AI)。
- 环境:智能体所处的世界(棋盘、游戏、真实道路)。
- 状态:环境当前的样子(当前的棋局、游戏画面)。
- 动作:智能体在某个状态下可以做的选择(下在哪、往哪走)。
- 奖励:智能体做完动作后,环境给的反馈(赢棋加分、输棋扣分、吃到金币加分)。
它们这样循环互动:智能体观察当前状态,做出一个动作,环境因此变到新状态、并给出一个奖励;智能体根据这个奖励调整自己以后的行为,再面对新状态做下一个动作……如此循环。智能体的唯一目标,是让长期累积的总奖励最大。
这里的关键词是"长期"。 强化学习最难也最迷人的地方,在于它要考虑的不是眼前这一步的即时奖励,而是一连串动作带来的长远回报。有时候为了赢,得先牺牲眼前的小利益。
最难的一课:延迟奖励与长远眼光
强化学习最核心的挑战,是延迟奖励,值得单独讲,因为它道出了这类问题的精髓。
下围棋,你不是每走一步都立刻知道好坏,往往要到几十步之后分出胜负,才知道之前那些棋到底走得对不对。奖励是延迟的、稀疏的,一个动作的真正价值,可能要很久以后才显现。 这就带来一个难题,赢了棋,功劳该记给中间哪几步妙棋?输了,又该怪哪一步臭棋?这叫信用分配问题。
打个比方:这就像人生里很多重要决定,读书时用功、年轻时选对方向,当下没有即时回报,甚至挺苦,但它对很久以后的人生有深远影响。强化学习要学的,正是这种为了长远的大回报、愿意在当下做出正确选择的智慧。 它必须学会评估每个动作对未来的长远价值,而不是只顾眼前爽不爽。这正是强化学习比前面那些"输入进、结果出"的模型更复杂、也更接近真实决策的地方。
探索与利用:一个经典的两难
强化学习还有个经典的两难,叫探索与利用,特别有生活智慧。
智能体面临选择:是利用已知的、目前看来最好的策略稳稳拿分,还是去探索那些还没试过的、可能更好也可能更差的新选择?
打个比方:你有家常去的餐馆,闭眼点都好吃(利用)。但你永远不去尝试新馆子,可能就错过了一家更棒的(探索不足)。可要是天天冒险试新的,又常踩雷(探索过度)。 强化学习必须在"守着已知的好"和"冒险找更好"之间找平衡,这个平衡拿捏,是它的一门核心功课。
AlphaGo:强化学习的高光时刻
强化学习最出圈的战绩,是AlphaGo在2016年击败围棋世界冠军李世石,这是AI发展史上的标志性事件。
围棋的可能局面比宇宙里的原子还多,没法靠穷举。AlphaGo的做法,简单说是先跟人类棋谱学(监督学习打底),再通过强化学习跟自己下海量的棋、不断自我对弈、在输赢的奖励里进化棋艺,最终下出了很多人类从未想到的妙手。它的进阶版AlphaGo Zero更狠,完全不看人类棋谱,纯靠自我对弈从零学起,反而更强。这震撼之处在于,它证明了强化学习能让AI通过自我试错,达到甚至超越人类顶尖水平,还能创造出人类没有的新知识。
重头戏RLHF:怎么教会ChatGPT好好说话
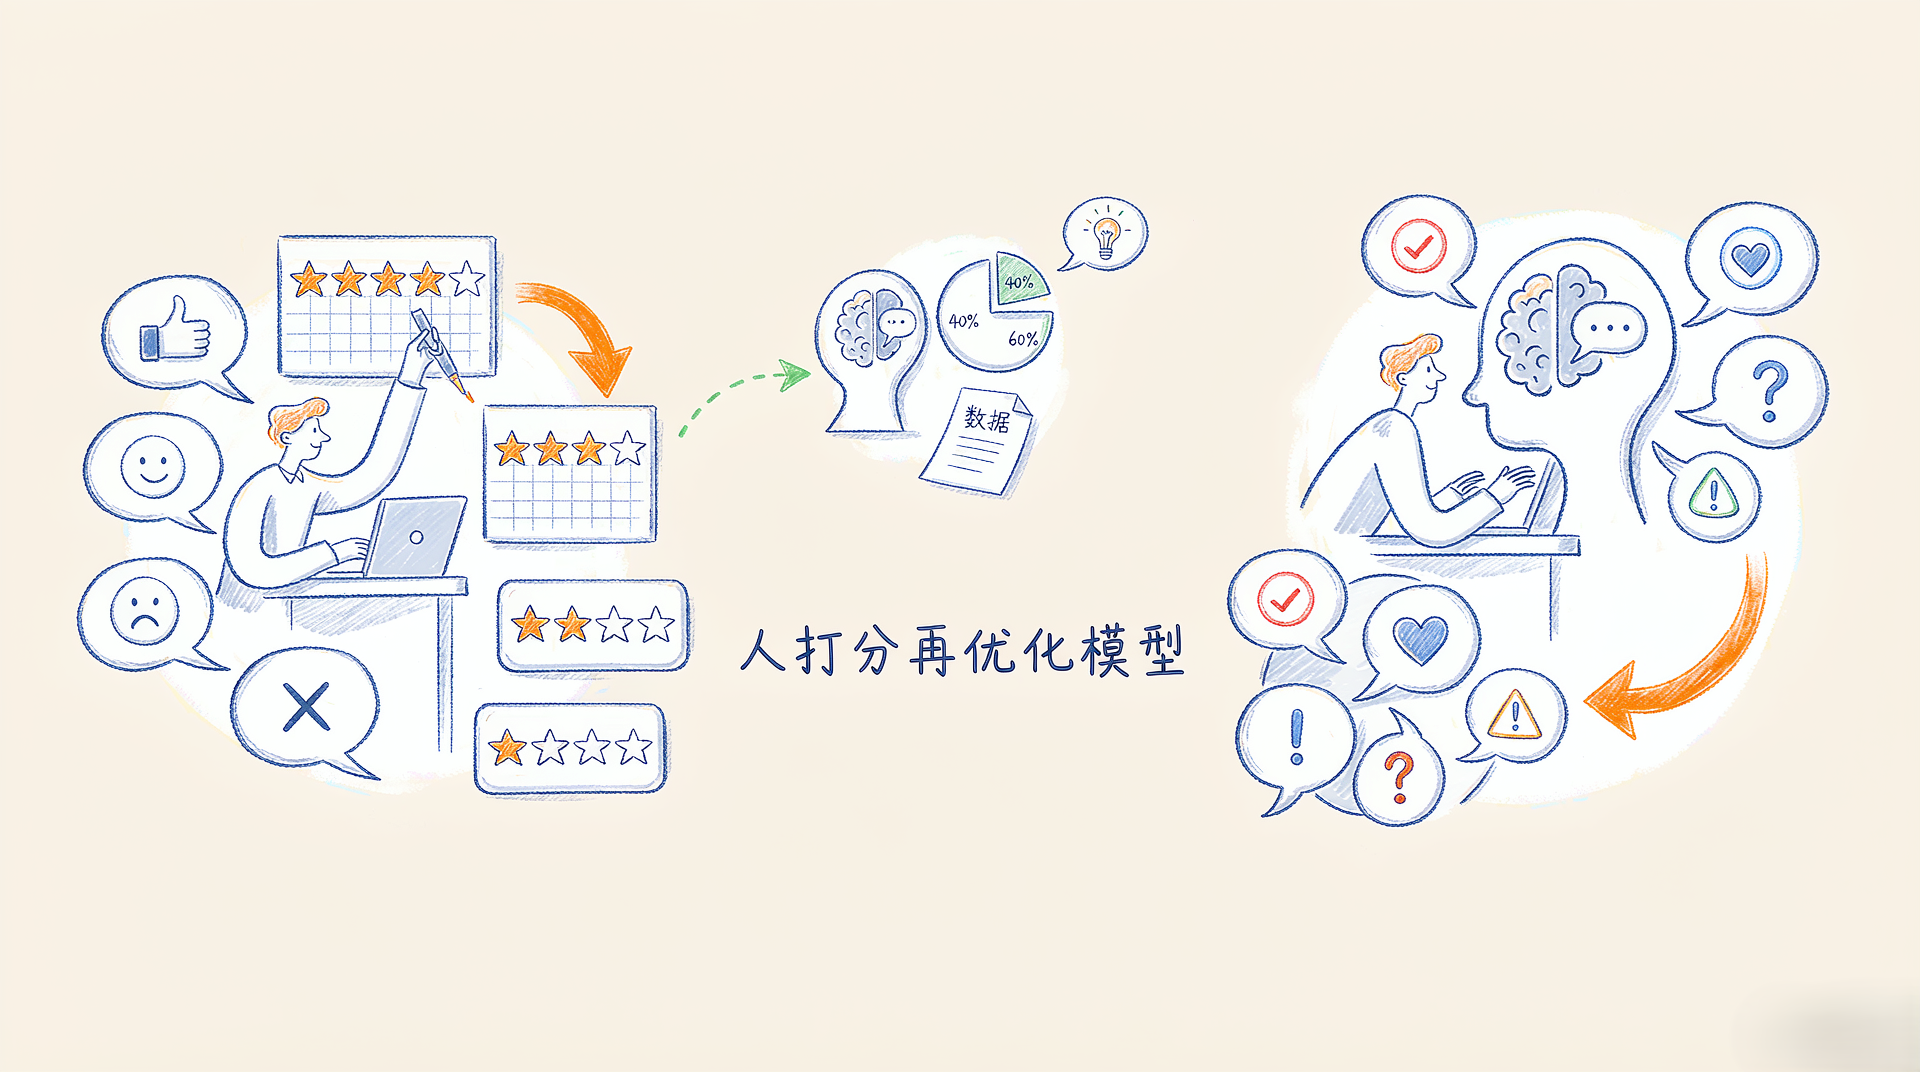
强化学习和你最相关的应用,是RLHF(基于人类反馈的强化学习),它是ChatGPT这类大模型能好好和你对话的关键功臣,一定要讲清楚。
先说个问题。一个大模型光靠海量文本预训练出来,它很能"续写",但不一定会好好回答你、不一定说人话、可能一本正经胡说八道或者说些有害的话。怎么让它变得有用、诚实、无害,符合人类的偏好?这靠预训练学不来,因为"什么样的回答是好回答"很难用标准答案定义。 这时候强化学习的思想就派上用场了。
RLHF大致分三步,用大白话说:
- 第一步,让人来打分。 让模型对同一个问题生成好几个不同回答,请人类标注员给这些回答排序(哪个更好、哪个更差)。
- 第二步,训练一个奖励模型。 用上面这些人类的偏好数据,训练出一个"奖励模型",它学会了模仿人类的喜好,能给任意一个回答打分(越符合人类偏好分越高)。这一步妙就妙在,它把"人类喜欢什么"这种说不清的东西,变成了一个能自动打分的模型。
- 第三步,用强化学习优化大模型。 现在有了会打分的奖励模型(充当环境的奖励),就可以用强化学习了,让大模型不断生成回答、奖励模型打分、大模型朝着"拿高分(更符合人类偏好)"的方向调整自己。
这么一来,大模型就在强化学习的框架下,逐渐学会了生成人类更喜欢的回答,变得有礼貌、有帮助、更安全。 你现在觉得ChatGPT对话体验好、通情达理,很大程度上是RLHF的功劳。它是强化学习思想在大模型时代焕发的第二春,也是连接前面所有内容和大模型的一座关键桥梁。
顺带把强化学习的两大类主流方法给你点一下,帮你听到那些术语时不发怵。一类叫基于价值的方法,代表是DQN(深度Q网络,当年就是它让AI学会打雅达利游戏)。它的思路是,让模型学会评估"在某个状态下做某个动作,未来能拿到多少长期回报",评估准了,每一步选那个价值最高的动作就行。另一类叫基于策略的方法,代表是PPO(也就是RLHF里用的那个)。它不绕道去评估每个动作的价值,而是直接学习一个"策略",也就是在每个状态下该以多大概率做各个动作,直接优化这个策略让总回报最大。打个比方,基于价值的像是先给每条路打个分再挑分高的走,基于策略的则是直接练出一套"遇到什么情况就怎么走"的直觉。 两类各有长处,实际中PPO这类策略方法因为稳定好用,在大模型对齐等复杂任务里特别受欢迎。你不用深究数学,记住这个分类和它们的直觉即可。
输入输出与代码
- 输入:环境的状态。输出:智能体在该状态下要采取的动作(策略)。整个学习过程的燃料是奖励信号。
下面用一个经典的平衡杆环境演示强化学习的基本样子。输入:杆子和小车的状态。输出:向左还是向右推。
# 依赖:pip install gymnasium
import gymnasium as gym
import numpy as np

# CartPole:经典强化学习环境,目标是左右移动小车让杆子不倒
env = gym.make("CartPole-v1")

# 这里用一个极简的随机策略演示"智能体-环境"互动循环(不是训练好的策略)
for episode in range(3):                 # 玩3局
    state, _ = env.reset()
    total_reward = 0
    done = False
    while not done:
        action = env.action_space.sample()      # 智能体做动作(这里随机选)
        state, reward, terminated, truncated, _ = env.step(action)  # 环境反馈新状态和奖励
        total_reward += reward                    # 累积奖励
        done = terminated or truncated
    print(f"第{episode+1}局 撑了{total_reward:.0f}步(奖励)")

env.close()
print("真实训练时,会用DQN/PPO等算法,让智能体从奖励中学会稳稳撑住杆子")
运行输出(示例,随机策略每次不同,通常只能撑十几到几十步):
第1局 撑了18步(奖励)
第2局 撑了13步(奖励)
第3局 撑了27步(奖励)
真实训练时,会用DQN/PPO等算法,让智能体从奖励中学会稳稳撑住杆子
这段代码展示了强化学习最核心的"智能体做动作、环境给状态和奖励"的互动循环。真实训练会用DQN、PPO这些算法(PPO正是RLHF里常用的那个),让智能体从奖励里学出好策略,而不是像这里随机乱动。 随机策略杆子很快就倒,训练好的智能体能撑很久。
优缺点与适用场景
优点:能解决需要连续决策、追求长期回报的复杂问题;能通过自我试错超越人类经验;是训练对齐大模型的关键。缺点:训练往往不稳定、需要大量试错(在真实世界试错代价高,常要先在仿真里练)、奖励函数难设计(设不好会学出钻空子的怪策略)、样本效率低。
适合场景:游戏AI、机器人控制、自动驾驶决策、推荐和广告的序列决策、大模型对齐(RLHF)、任何"在互动中通过奖惩学习最优策略"的场景。不适合:有现成标准答案、直接监督学习更省事的问题,那样用强化学习是杀鸡用牛刀、还费力不讨好。
多说一句奖励函数难设计这个坑,因为它特别能体现强化学习的微妙。智能体是不折不扣的"唯奖励论者",你给什么奖励,它就死磕什么,绝不管你的本意。曾有人训练玩赛艇游戏的AI,本想让它跑得快,结果奖励设成了得分,AI发现原地绕圈刷道具分比认真比赛得分还高,于是它就在原地转圈圈、压根不去终点。这就是奖励设计不当的经典翻车,智能体钻了奖励的空子,学出了一个符合奖励、却完全违背你本意的怪策略。 这提醒我们,用强化学习最见功力的往往不是算法,而是怎么把你真正想要的目标,翻译成一个不会被钻空子的奖励函数,这件事远比想象中难。
小结与承上启下
- 强化学习:像生物本能,通过试错、根据奖惩学习,追求长期累积回报最大。
- 框架:智能体在环境里观察状态、做动作、得奖励,循环往复优化策略。
- 核心难点:延迟奖励(要有长远眼光)、探索与利用的平衡。
- 重头戏RLHF:用人类偏好训个奖励模型,再用强化学习让大模型学会好好说话,是ChatGPT体验好的关键。
RLHF已经把我们引到了大模型的门口。而当今所有大模型的心脏,是一个叫Transformer的架构,正是它的横空出世,才有了这一切。下一篇,我们就来讲这个划时代的Transformer和它的核心,注意力机制,看清整个大模型时代的技术基石。
我们下一篇见。
延伸阅读
- Gymnasium 官方文档(本篇CartPole代码用的库,OpenAI Gym的继任者):https://gymnasium.farama.org
- 《强化学习导论》(Reinforcement Learning: An Introduction,Sutton & Barto,经典教材,有免费在线版):http://incompleteideas.net/book/the-book.html
- OpenAI 关于RLHF训练InstructGPT的介绍可按关键词InstructGPT检索
(说明:以上为官方与经典公开资料地址,可能随版本调整,如打不开可用标题搜索。)

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐



 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)