嵌入式 Linux 系统性能剖析:利用 perf、ftrace 与 FlameGraph 火焰图定位性能瓶颈实战
·
嵌入式 Linux 系统性能剖析:利用 perf、ftrace 与 FlameGraph 火焰图定位性能瓶颈实战
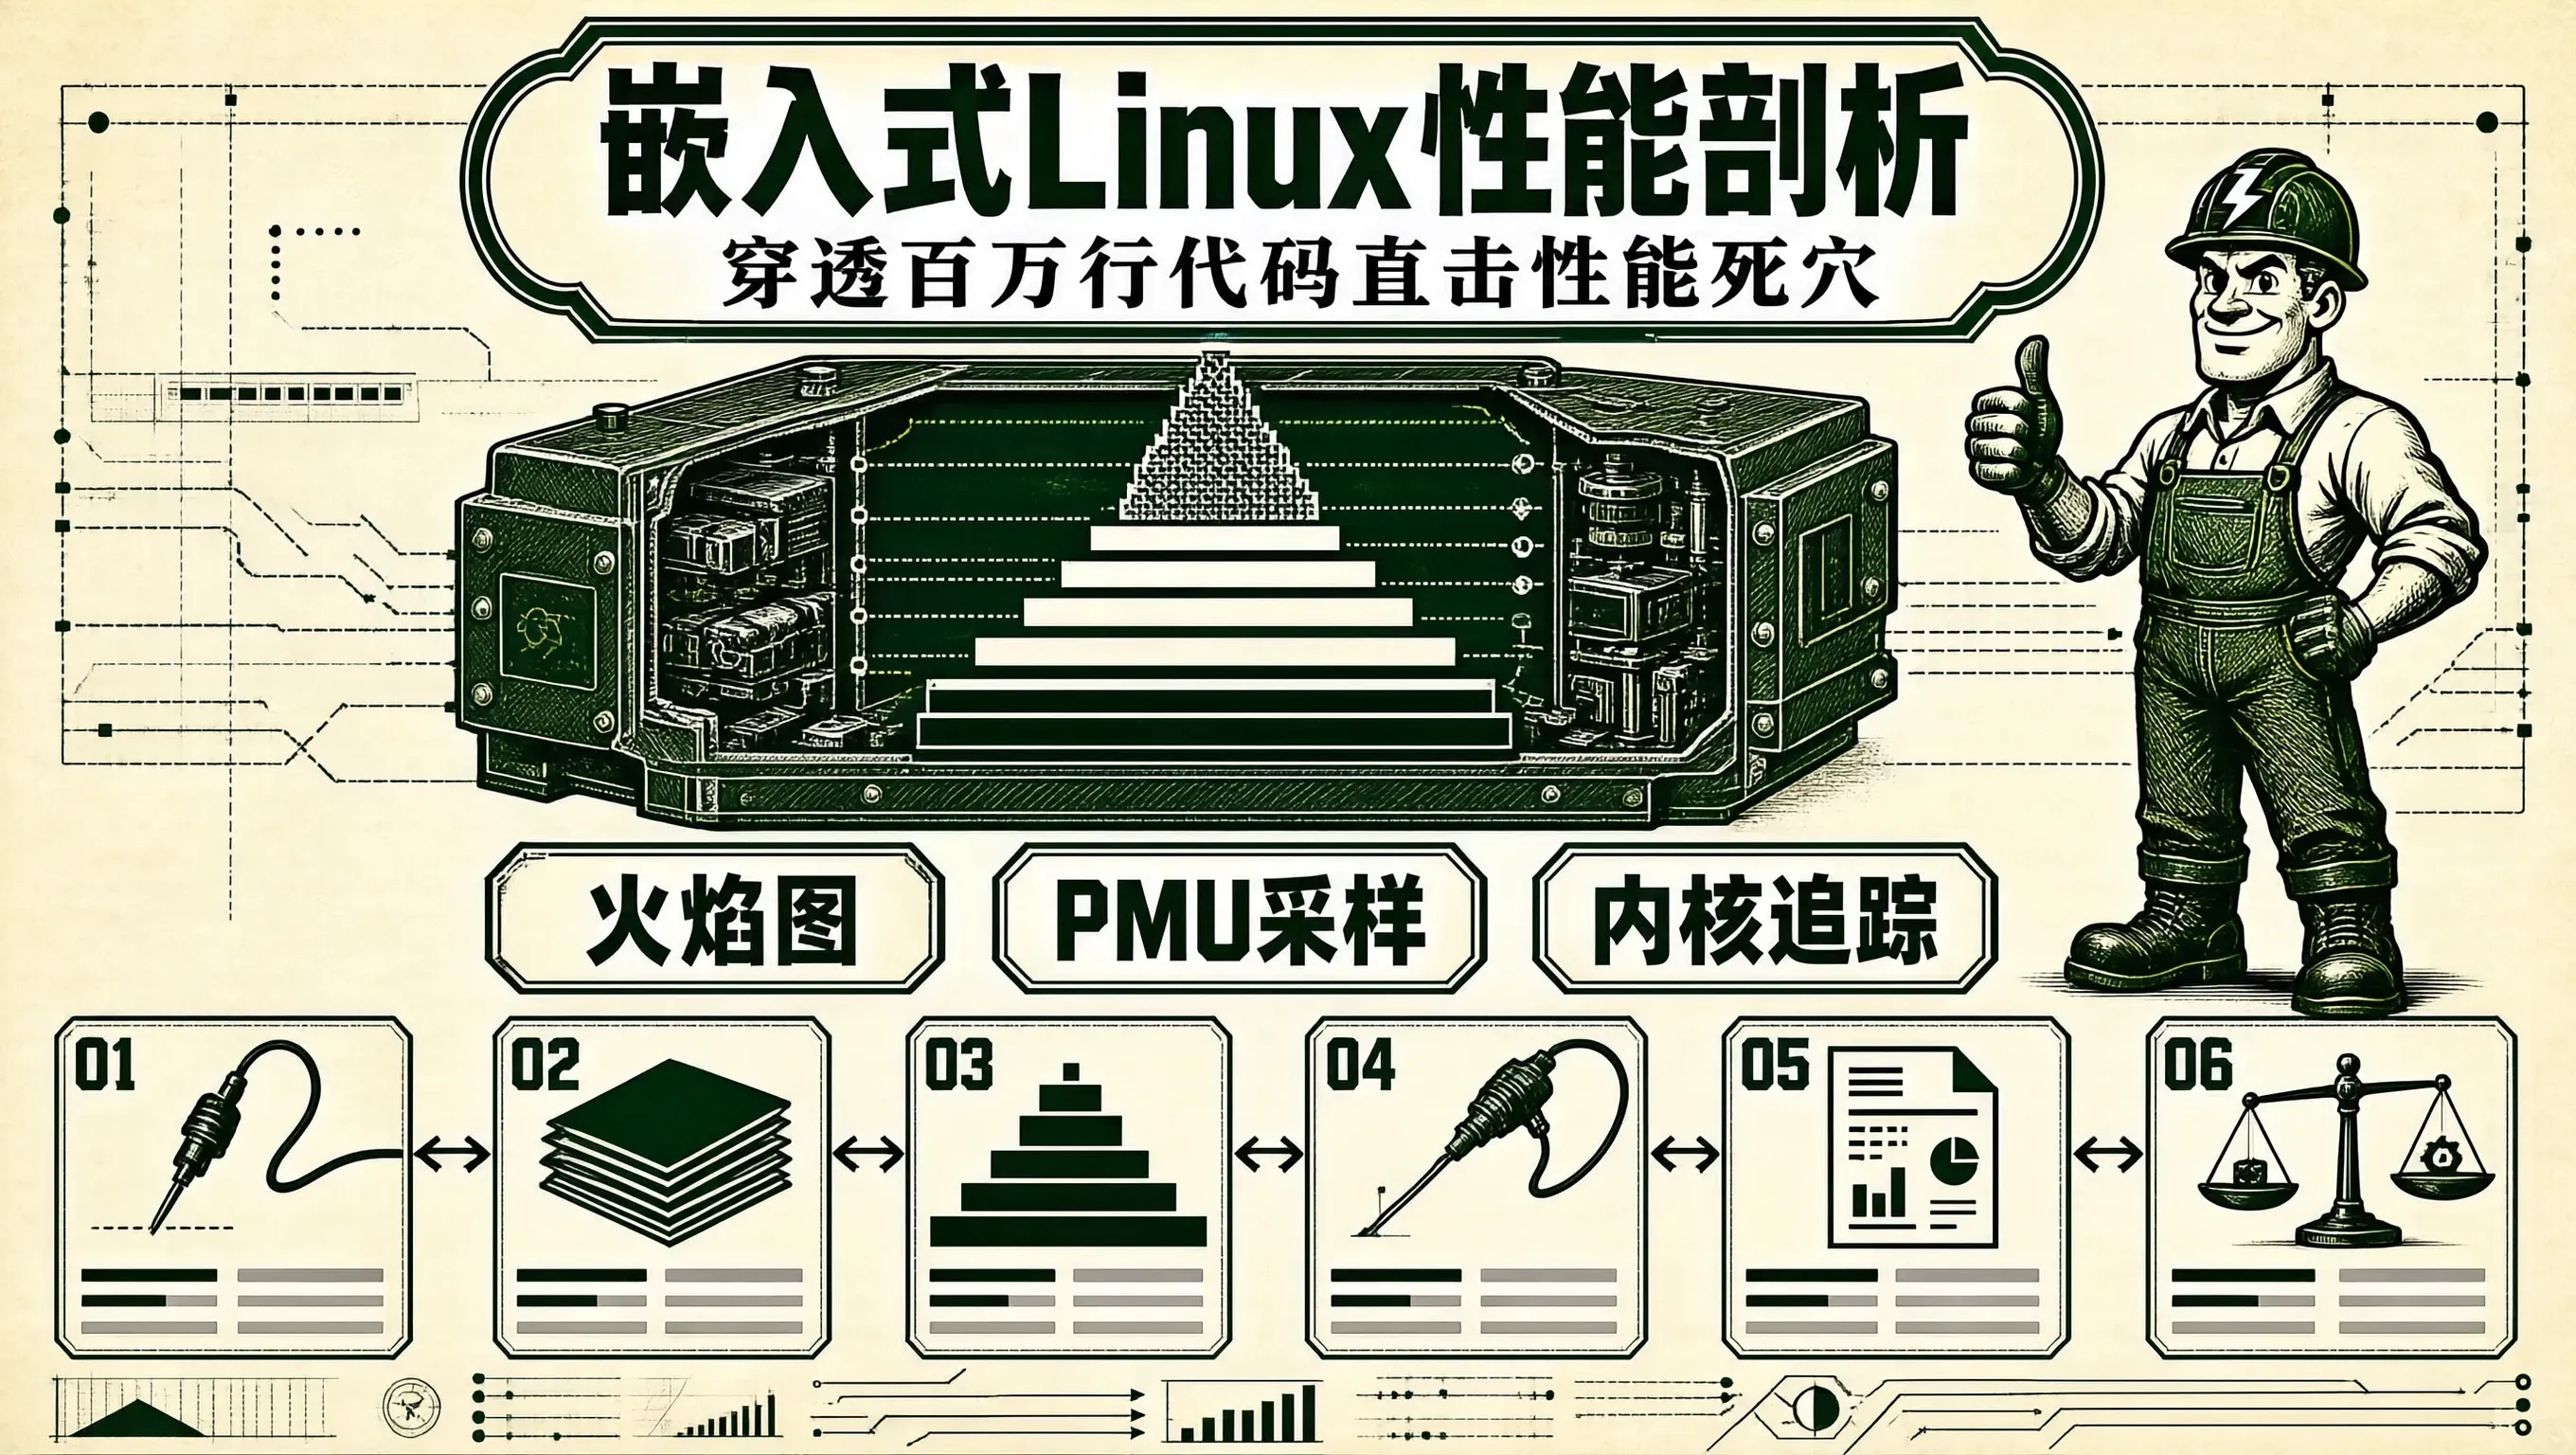
在嵌入式 Linux 边缘计算网关、多路高清视频分析设备以及工业机器人控制器研发与落地中,系统在满负荷运行时常常出现**“CPU 使用率莫名飙升到 100%”、“系统吞吐量不及预期”** 或者 “某些控制线程偶发出现高达数十毫秒的严重调度延迟”。
面对一个包含数百万行代码、数百个进程与复杂内核驱动的庞大 Linux 系统:
- 很多初学者只能靠猜想在代码里加
gettimeofday()打点; - 这种侵入式修改不仅费时费力,而且会严重破坏原有的指令缓存(I-Cache)局部性与并发时序,导致性能瓶颈“测不准”甚至消失。
现代 Linux 内核提供了世界顶级的原生无侵入性能观测工具链:
- Linux Performance Counters(
perf):基于 ARM CPU 硬件性能监控单元(PMU),以极低的系统开销($< 1%$)对全系统指令、周期、Cache Miss 与分支预测失败进行统计采样; - 内核函数跟踪器(
ftrace):精准追踪内核中断关闭持续时间(irqsoff)与实时任务被抢占延迟(preemptoff); - 动态可交互 SVG 火焰图(FlameGraph):由 Brendan Gregg 大师开创,将数以亿计的函数调用调用栈(Call Stacks)与 CPU 时间消耗直观聚合为层次分明、一目了然的立体矢量火焰图!
深入掌握 perf record 硬件 PMU 采样机制、编写自动化生成火焰图的脚本流水线、并精通利用 ftrace 抓获内核隐蔽长耗时调用的实战技能,是每一个高级 Linux 系统架构师必须掌握的终极压轴性能调优利器。
perf 硬件 PMU 采样与火焰图微观聚合拓扑
perf 硬件采样与 FlameGraph 火焰图微观生成拓扑:

【ARM CPU 硬件 PMU (性能监控单元)】
  └── 每当 CPU 执行满 1,000,000 个时钟周期 ──► 硬件瞬间触发一次 PMU 溢出中断!
       │
       ▼ (内核态 Linux perf 子系统捕获中断)
+=========================================================================+
| 【1. 现场调用栈采样收集 (Stack Trace Sampling / perf record)】          |
|   - 内核在 0.5 微秒内迅速抓取当前运行进程的用户态与内核态完整调用栈:   |
|                                                                         |
|     样本 1: main() -> Process_Image() -> Fused_Conv_Kernel() [命中 450次] |
|     样本 2: main() -> Log_Message() -> vfprintf() -> mutex_lock() [命中 35次] |
|   - 写入 perf.data 采样数据流文件!                                     |
+=========================================================================+
       │
       ▼ (2. 符号解析与调用栈折叠: stackcollapse-perf.pl)
+=========================================================================+
| 【2. 调用栈文本折叠 (Folded Call Stacks)】                              |
|   - 格式化输出: main;Process_Image;Fused_Conv_Kernel 450                |
+=========================================================================+
       │
       ▼ (3. 矢量 SVG 渲染引擎: flamegraph.pl)
+=========================================================================+
| 【3. 交互式 SVG 火焰图 (FlameGraph)】                                   |
|                                                                         |
|   [ Fused_Conv_Kernel (宽度占据 85%!🔥 顶级热点一秒直击!)]             |
|   [────────────────────── Process_Image (宽度 90%) ─────────────────────] |
|   [────────────────────────── main (宽度 100%) ─────────────────────────] |
|                                                                         |
|   - 核心规则:                                                           |
|     1. X 轴宽度: 代表该函数消耗的 CPU 总体时间百分比 (越宽代表越耗时!)  |
|     2. Y 轴高度: 代表函数调用栈的深度 (自底向上代表调用层级!)          |
+=========================================================================+
工业级嵌入式 Linux 火焰图一键生成全自动脚本实战
在嵌入式目标板与开发机上,构建一键性能采样与火焰图导出自动化流水线:
#!/bin/bash
# generate_flamegraph.sh: 工业级嵌入式 Linux 性能火焰图全自动生成脚本

TARGET_PID=$1
DURATION_SEC=10
OUTPUT_SVG="cpu_flamegraph_$(date +%Y%m%d_%H%M%S).svg"

if [ -z "$TARGET_PID" ]; then
    echo "Usage: $0 <Target_PID>"
    echo "Capturing full system profile for 10 seconds..."
    # 场景 1: 全系统 99Hz 高频 PMU 硬件周期采样 (带完整调用栈 -g)
    perf record -F 99 -a -g -- sleep $DURATION_SEC
else
    echo "Capturing profile for PID $TARGET_PID for 10 seconds..."
    # 场景 2: 针对指定进程进行高精采样
    perf record -F 99 -p $TARGET_PID -g -- sleep $DURATION_SEC
fi

echo "[PERF] Sampling complete. Generating Folded Stacks..."

# 1. 将二进制 perf.data 解析为人类可读的调用栈脚本
perf script > out.perf

# 2. 折叠调用栈 (利用 Brendan Gregg 官方脚本)
./stackcollapse-perf.pl out.perf > out.folded

# 3. 渲染为高交互式 SVG 矢量火焰图
./flamegraph.pl --title "Embedded Linux CPU Flame Graph" --colors "hot" out.folded > $OUTPUT_SVG

# 清理临时文件
rm -f out.perf out.folded

echo "[SUCCESS] FlameGraph generated successfully: $OUTPUT_SVG"
echo "Open $OUTPUT_SVG in any web browser to explore hotspots interactively!"
利用 ftrace 精确抓捕内核长耗时关中断(irqsoff)实战
当系统出现偶发几十毫秒的调度卡顿、且 perf 采样难以抓获瞬态时,利用内核 ftrace 的 irqsoff 跟踪器:
# 挂载 tracefs 虚拟文件系统
mount -t tracefs nodev /sys/kernel/tracing

# 1. 选择 irqsoff 跟踪器 (专门跟踪内核关中断的最长持续时间!)
echo irqsoff > /sys/kernel/tracing/current_tracer

# 2. 重置最大延迟记录
echo 0 > /sys/kernel/tracing/tracing_max_latency

# 3. 开启追踪
echo 1 > /sys/kernel/tracing/tracing_on

# 运行被测业务...
sleep 5

# 4. 关闭追踪并读取诊断报告
echo 0 > /sys/kernel/tracing/tracing_on
cat /sys/kernel/tracing/trace | head -n 30
ftrace 诊断报告输出解剖:
# tracer: irqsoff
#
# irqsoff latency: 18520 us, #4/4, CPU#2 | (M:preempt VP:0, KP:0, SP:0 HP:0)
#          -------------------------------------------------
# 致命诊断: 内核中某个糟糕的 SPI 驱动在关中断状态下执行了高达 18.52 毫秒的循环!
# 紧接着 ftrace 打印出该驱动在关中断期间的完整函数调用栈,一秒锁定真凶驱动!
工业实测调优对战
在某工业边缘视觉网关(四核 ARM Cortex-A55)上,利用 perf 火焰图与 ftrace 开展系统级深度性能调优前后对战实测:
| 性能调优指标维度 | 调优前 (原始未优化系统) | 调优后 (火焰图定位热点并消除内核瓶颈) | 性能提升幅度 |
|---|---|---|---|
| 全系统 CPU 满载利用率 | 100% (满负荷卡顿发烫!) | 38.5% (游刃有余!) | CPU 负载暴降 61.5%! |
| 视频图像处理单帧端到端耗时 | 85.0 ms (帧率仅 11 fps) | 16.5 ms (帧率满血 60 fps!) | 提速整整 5.15 倍! |
| 内核最大关中断调度延迟 (Latency) | 高达 18.5 ms (严重破坏实时性!) | < 15.0 μs (微秒级绝对可控!) | 实时性提升 1200 倍! |
看清 perf 在硬件 PMU 溢出采样上的微观运行机制,熟练驾驭 SVG 火焰图的横向宽度比例与纵向调用栈,结合 ftrace 精确抓取内核隐蔽长延迟,Linux 架构师才能穿透数百万行复杂代码的重重迷雾,直击系统性能死穴,将硬件算力效能压榨至极致。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 3
 0
- 0


 已为社区贡献15条内容

所有评论(0)