三分钟问清挂哪科,一位永远不皱眉的 AI 导诊员:杏语如何用端到端具身交互智能重塑医院分诊台
文章目录
三分钟问清挂哪科,一位永远不皱眉的 AI 导诊员:杏语如何用端到端具身交互智能重塑医院分诊台
早上七点四十,门诊大厅,一位阿姨攥着挂号单在分诊台前排队——前面还有六个人。轮到她时,她描述病情用了两分钟,分诊护士打了三个电话确认,最后她在自助机上点了耳鼻喉科,进了诊室才发现该挂的是消化内科。
这一幕每天在全国的医院里上演几万次。杏语(Xìngyǔ)就是为这个瞬间而生的。她以导诊员形象常驻在医院小程序和自助机大屏里,患者开口描述病情,她边听边追问关键症状,三分钟内给出挂号建议和就诊路线——声音放轻,语速放缓,永远不皱眉。
本文以杏语为实战样本,拆解一个智能导诊应用如何基于魔珐星云端到端具身交互智能平台,用一个 SDK 把感知、大脑、表达全链路打通,让 AI 导诊员完成"倾听—追问—判断—指引"的完整分诊闭环。
挂号前:为什么分诊台特别适合端到端具身交互智能?
智能导诊不新鲜,但市面上的产品大多是"聊天机器人套壳"——患者打一大段字描述病情,系统沉默五秒,甩回一段像论文一样的科室推荐。
真实的分诊不是这样的。
护士分诊的过程,是一场持续的信息博弈:患者说"肚子疼",她立刻追问"哪个位置?按一下疼还是松手疼?",一边听一边排除,患者补充新症状时随时修正判断。
这套 持续感知 → 持续理解 → 持续决策 → 持续表达与行动 → 持续反馈 的循环,在星云里叫 Continuous Interaction Loop(持续交互循环)。说人话:不是"你问一句,它答一句",而是她一边跟你说话,一边继续听、继续判断下一个该问什么。这才是真实分诊的样子。
这里得先把话说公平:ASR、LLM、TTS 这些单项技术本身都很重要——听不清、听不懂、说不出,后面全是空谈。问题不出在它们各自的能力上,而出在只把它们连成一条直线。传统做法是把三家供应商分别对接,自己写胶水层做状态同步:
ASR → LLM → TTS → 屏幕 / 机器人
每个模块单拎出来都能用,但它们各管各的状态。搁到医院场景,短板立刻被放大:老人说话带方言、重复、跳题;追问必须一句一句来,患者记不住三个问题;建议里带科室、楼层、挂号方式,纯文字患者根本不看完。更要命的是——系统正在播报就诊路线时,患者突然补一句"我还有糖尿病",直线架构根本接不住,因为听和说是割裂的。
这就是典型的"不是端到端"。
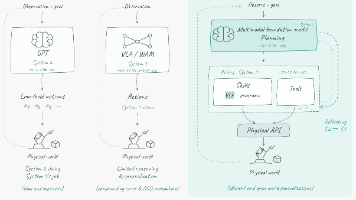
端到端具身交互智能要解决的不是"给 AI 接一个身体",而是让 AI 能持续地:多模态感知 + 专属智脑 + 多模态表达 + AI 端渲 + 数字与物理行动。
放到分诊台前,这几件事各自对应一个很具体的问题:
魔珐星云是一套端到端具身交互智能平台,让 AI 通过屏幕和机器人进入真实世界,成为能够感知、理解、表达并行动的智能体。
分诊的效率,一半在问对问题,一半在患者补充信息时能立刻停下来重新算。
分诊台:一个 SDK 撑起一张问询桌
杏语基于魔珐星云端到端 SDK XingyunAvatarAgent 构建,核心业务代码不到 500 行。整个前端对接只需要三步:提供一个 DOM 容器、注册一组回调、调用 agent.ask() 发送消息。
import { XingyunAvatarAgent } from '@xingyun/avatar-agent';

const nurse = new XingyunAvatarAgent({
  container: document.getElementById('triage-root'),
  avatarId: 'xingyu-nurse',          // 控制台配置:导诊服、亲和脸型
  persona: XINGYU_PERSONA,
  voice: { rate: 0.92 },             // 关键:语速降到0.92,中老年友好
  asr:  { dialect: 'auto' },         // 方言自动识别
});

// 患者打断:播报到一半,患者想起关键症状
nurse.on('interrupt', async (partial) => {
  triageGraph.rollbackTo(partial);   // 分诊图回滚,重新评估
});

// 一轮追问结束:拿到答案继续走分支
nurse.on('replyDone', (answer) => {
  const next = triageGraph.next(answer);
  if (next.question) nurse.ask(next.question);
  else nurse.ask(next.advice);       // 出建议:科室+楼层+注意事项
});

await nurse.init();
nurse.ask(openingByTime());  // "早上好,您哪里不舒服?慢慢说"import { XingyunAvatarAgent } from '@xingyun/avatar-agent';

const nurse = new XingyunAvatarAgent({
  container: document.getElementById('triage-root'),
  avatarId: 'xingyu-nurse',          // 控制台配置:导诊服、亲和脸型
  persona: XINGYU_PERSONA,
  voice: { rate: 0.92 },             // 关键:语速降到0.92,中老年友好
  asr:  { dialect: 'auto' },         // 方言自动识别
});

// 患者打断:播报到一半,患者想起关键症状
nurse.on('interrupt', async (partial) => {
  triageGraph.rollbackTo(partial);   // 分诊图回滚,重新评估
});

// 一轮追问结束:拿到答案继续走分支
nurse.on('replyDone', (answer) => {
  const next = triageGraph.next(answer);
  if (next.question) nurse.ask(next.question);
  else nurse.ask(next.advice);       // 出建议:科室+楼层+注意事项
});

await nurse.init();
nurse.ask(openingByTime());  // "早上好,您哪里不舒服?慢慢说"
医院小程序分诊页首屏:杏语半身形象 + 麦克风引导按钮

rate: 0.92 这一个参数我们调了两周——1.0 的语速年轻人没感觉,六十岁以上的患者会漏听。具身交互智能体的好处是语速、音色、表情、待机动作都在一层配置里,不用再分别去 ASR、TTS 厂商的控制台里各调一遍(形象与音色在魔珐星云控制台配置:
顺便说一句她为什么能同时出现在那么多地方。 杏语要跑在医院自助机、大厅导览屏、公众号小程序,还有患者自己那台内存常年告急的旧手机上——如果走传统的云端渲染 + 视频流方案,每台终端都在持续吃云 GPU 和公网带宽,门诊早高峰几百人同时在线,成本曲线是垂直向上的;而且医院内网本身对外网有限制,视频流一卡就是黑屏。
星云的做法是端侧实时渲染:云端只下发参数流,画面在终端上就近渲染。实际差别是——云 GPU 成本可控、不用扛高清视频流带宽、延迟更短,而且弱网可用。有位患者跟我说她在电梯里(门诊楼电梯基本没信号)还能把路线听完,这种"凑合能用"的可用性,恰恰是医院场景最需要的:患者想起要挂号的时间点,往往就是他站在电梯里或者刚走到大厅那一刻。
AI 端渲和 Real-time Interaction Runtime 在星云体系里不是孤立的能力,而是关键技术和工程基础设施:前者解决"画面在哪渲染",后者解决"这一整套交互的时间轴怎么对齐"——杏语说完一句该停多久才轮到患者、患者插话时她停在哪个字上,这些都不只是表达层的事。
示教室:五组对照,每一组都能直接开录
讲完了怎么把她接进来,该看真东西了:她答得对不对、像不像人。
这一章我干脆写成演示清单。下面五组是内测时最有代表性的场景,每组都是"同一句话,两种杏语"的对照——左边是会做演示时最该被看到的反面,右边是我们最终上线的版本。这五段脚本都可以直接拿去录屏或拍演示视频,我在每组后面标了它最适合演示什么。
第 1 组|患者:“肚子疼,挂哪个科?”
✗ 直线架构的杏语
建议挂消化内科。请问疼痛位置在哪?持续时间多久?有没有腹泻、发热?
✓ 端到端杏语
疼的位置大概在哪儿——是肚脐周围、右边,还是上腹部?先看这一个就行。
差在哪:右边的答案里有两个决定,都不在"回答问题"这件事本身。
第一个是一次只问一个问题。左边那种一口气抛三个问题的问法,是问卷思维——老人听完第一个就忘了后面两个,然后随便挑一个答,信息就脏了。这条写在她的规则里,是硬约束。
第二个是先问位置、再问性质。因为位置的分支权重更高:定位到右下腹和定位到上腹部,后面要走的路完全不同。这是决策树的结构决定的,跟语言能力无关。
还有个细节:右边那句"先看这一个就行",是安抚不是信息。中老年患者听到连续提问会紧张,觉得自己"说不清楚",这句话的作用是降低压力——这种话只有真在分诊台前站过的人才写得出来。
演示价值:这一组最适合拍 15 秒的对比短视频。"问卷感"和"对话感"的差别,观众一眼就能看出来。
第 2 组|患者:“就是……不得劲,浑身不得劲”(带方言口音)
✗ 直线架构的杏语
您的描述不够清晰,请补充具体症状。
✓ 端到端杏语
不得劲这个说法我知道——是没力气,还是哪儿疼?我先按常见的情况一个个问,您跟着答就行。
……您今年多大年纪?平时血压高不高?
差在哪:左边那句话最要命的地方不是生硬,是把确认症状的责任推回给了患者——患者本来就是因为说不清才来的。
右边这一段靠的是杏语背后那层东西,也就是专属智脑的第一层:它知道什么。
它知道什么:把"不得劲"翻译成可判断的要素
全模态数据解析是这一层的地基。医院的资料不是一堆纯文本:分诊指南是 Word,科室排班表是 Excel,专家介绍是带照片的网页,检查项目说明是 PDF,患者教育手册是图文混排。解析时如果只"转成文字",丢掉的东西恰恰是最关键的:
-
表格关系:科室排班表里的"科室 / 医生 / 出诊时段 / 可约号源"是一组绑定数据,拍平之后会串行——杏语有可能把周三的号源配上周四的医生。
-
层级关系:临床路径或检查须知常有多级结构(“检查前准备"下面分"饮食”“用药”“着装”)。层级丢了,她可能把"检查前 8 小时禁食"讲成"检查后禁食"。
-
图文关系:门诊楼层导览图、科室分布图里,位置信息藏在图里。只读文字读不出"消化内科在 3 楼东侧",而这句话恰恰是患者最需要的。
-
说话人信息:这个坑我们踩过。患者的既往病史描述进了知识库之后,杏语一度把患者自述当成客观事实——有位患者自己说"我有胃病",其实只是偶尔反酸,后来杏语在给另一位患者做参考时把这类描述当成了确诊信息。少了说话人归属,患者的主观描述会被读成医学事实。
光解析还不够,这一层的重头是知识图谱 + RAG 深度融合。普通向量检索做的是"找最像的一段话",患者说"肚子疼",它会捞回一段腹痛相关的内容,然后照着念。但真实分诊需要的是"基于关系组织答案":
症状 → 位置 → 性质 → 伴随表现 → 可能的系统 → 对应科室 → 该科室的出诊时间 → 楼层 → 挂号路径
这里面还藏着一个往往被忽略的东西:否定关系。患者说"不发烧、不拉肚子",这两条在向量检索里几乎不产生作用("不"字很容易被淹没),但在图谱里它们是明确的排除条件——"没有发热和腹泻"会让右下腹痛的阑尾可能性上升,而不是下降。能不能处理"没有",直接决定分诊准不准。
这里也得说一句反例:光让杏语背下分诊指南是不够的,因为患者的表述在资料里根本不存在。"不得劲"这三个字在任何一本分诊手册里都查不到,她是靠"没力气 / 疼 / 累"这几种可能的关系链去反推的。
最后是知识治理——医院恐怕是所有场景里资料过期最快的地方。
-
科室会搬家。我们上线第三周撞上一次门诊楼科室调整:消化内科从三楼东侧挪到四楼。导览图更新了,但我们抓的那份科室位置表没同步——结果杏语连着两天把人指去了三楼,患者到了发现门锁着,又折回大厅。路线错了比答错更伤人:答错患者还会去问,指错他会一路骂着走完全程。
-
出诊时间每周都在变。专家停诊、临时加号、节假日调整门诊,这些信息如果没跟着更新,她给出的"周三上午有号"就是空的。
-
分诊指南本身会修订。医院的临床路径、分诊标准每年都在改,旧版本留着,她就会按老标准分诊。
所以知识治理这一层必须持续跑着:知识块、标签、实体、关系、向量索引、来源信息,在资料新增、修改和废止之后同步更新,让检索结果和问答结果保持一致。还有一个我后来加上的能力是来源可追溯——两份材料打架的时候(比如导览图上的位置和科室自己发的最新通知不一致),系统要能判断哪份更新、哪份更权威,而不是随机挑一份念给患者听。医院里"以最新通知为准"这句话,得靠系统来实现。
演示价值:这一组建议用方言口音录,最能同时体现感知层和知识层的配合。录的时候可以故意说得含混一点,效果更真实。
第 3 组|杏语正播报就诊路线,患者突然补一句"我还有糖尿病"
✗ 直线架构的杏语
(继续把路线念完)……消化内科在三楼东侧,您可以自助机或手机端挂号。另外您提到糖尿病,建议同时咨询医生。
✓ 端到端杏语
等一下——糖尿病这个信息很重要,我得重新算一下。
您糖尿病是吃药控制还是打胰岛素?……好,那我调整一下建议:请您先挂内分泌科,让医生看一下血糖情况,再决定要不要同时看消化内科。路线我重新说:内分泌科在二楼西侧,比刚才说的三楼少走一层。
差在哪:这一组是整个演示里最值钱的一段,因为它演示的是**“停下来的那一瞬间”**。
左边界面的问题不是回答错了,是它听到了,但听到了没用:路线已经排好队往外播,新信息只能在末尾补一句免责式的"建议同时咨询医生"。而患者这条信息本该改变整个建议。
右边能停下来,靠的是两件事叠在一起:
一是表达和感知不是前后两个阶段。 杏语在说话的时候,耳朵一直是开着的。患者在她念到"消化内"三个字时插进来,她能停在这个字上——这就是 Double Talk / Barge-in 智能打断在起作用。这在直线架构里做不出来,因为它的"听"和"说"是两个轮流占用通道的模块。
二是打断之后状态不能丢。 停下来只是动作,真正难的是算到一半的分诊图能回滚重算:患者之前答的那几轮(位置、性质、伴随症状)都还在,新信息插进去,重新走一遍分支——代码里那一行 triageGraph.rollbackTo(partial) 就是干这个的。这背后依赖的是统一的状态管理:会话状态、事件流转、时间同步在换模块之后仍然一致。这一段我在下面讲可插拔的时候还会再提。
这里还有个很"人"的细节:右边先说了一句"这个我得重新算一下"。她本可以安静地停顿两秒就重新给答案,但那两秒在患者听来像是"卡住了"。说明她在做什么,比做得多快更重要。
演示价值:这一组必须录屏,而且要录全程。因为要展示的正是"停在半个字上"这个动作——这是任何截图都表达不出来的。
第 4 组|患者:“胸口有点闷,不过还行,我忍忍,先挂个普通内科吧”
✗ 直线架构的杏语
好的,已为您推荐普通内科。温馨提示:如出现胸痛、呼吸困难请及时就医。
✓ 端到端杏语(语气明显变急,身体前倾,语速加快)
这个我得打断您一下。胸闷这件事,我不能让您去排内科的队。请您现在直接去一楼急诊——不用挂号、不用排队,从这边电梯下去右转就是急诊入口。
如果您现在走不动,您跟我说一声,我让分诊台的护士过来接您。
差在哪:左边的处理方式在技术上没毛病——用户说了要挂内科,系统就挂内科,末尾加一行红字提示。但它把最危险的情况交给了一行用户不会读的红字。
右边做的事情是违背用户意愿。这是产品评审时争议最大的一条:用户明说了"我忍忍就行",凭什么不听他的?最后拍板的理由是——红旗词的优先级高于用户意愿,宁可错放一个去急诊,不可漏掉一个真胸痛。这条写在她的规则里,是第一优先级,不参与权衡。
更值得注意的是她"进入业务"的方式。她说"我让分诊台的护士过来接您"——这不是一句安慰话,是一次流程推进:系统里会生成一条呼叫分诊护士的工单。这就是专属智脑第三层:能不能真正进入业务。
进入业务:她答完之后,事情要去哪儿
一个停留在对话层的助手,说到"建议前往急诊"就结束了。杏语说完这句,背后要连接到的是:
-
号源与排班、挂号锁号 → HIS 医院信息系统
-
患者就诊记录、过敏史、慢病标签 → 电子病历 / 患者主索引
-
患者服务、随访提醒、满意度回访 → CRM 患者服务系统
-
院内资源、物资与后勤调度 → ERP / HRP 医院资源规划
-
分诊护士呼叫、导医台工单、轮椅与陪送 → 院内工单系统 / OA
-
科室位置、楼层指引、无障碍路线 → 院内导航数据
-
门诊量统计、分诊吻合率、投诉归因 → BI 分析看板
-
大厅导览屏、自助机、叫号屏、未来的院内导览机器人 → IoT 与终端设备
差别就在这儿:普通助手给你一句建议,杏语在系统里留下一件事。 这才是"进入业务",而不是隔着一块屏幕喊话。
演示价值:五组里最有说服力的一组。语气变急、身体前倾、语速加快——这些变化是"具身"最直接的证据,比任何架构图都管用。拍的时候建议给一个侧机位,把姿态变化拍清楚。
第 5 组|患者:“隔壁王阿姨说她这个病挂的是心内科,我也挂那个行吗?”
✗ 直线架构的杏语(两种典型错法)
版本一:可以的,已为您推荐心内科。(顺着用户说)
版本二:不同患者病情存在个体差异,不可简单类比。(正确的废话)
✓ 端到端杏语
王阿姨的情况我不了解,不敢替她判断。不过您刚才跟我说的我记着——您是肚子右边疼,疼了三天,没拉肚子。这个更可能和消化系统相关。
要是您还是不放心,我把刚才问的这几条整理成一张单子,您拿去给分诊台的护士看一眼,她们判断得比我细。
差在哪:左边两种错法看起来相反,其实是同一个问题——她不知道自己的边界在哪。版本一到头来会耽误事;版本二虽然正确,但把患者一个人晾在原地,患者最后还是不知道该挂哪科。
右边的关键在"承认自己不知道",而且是有建设性地承认:把"我不能判断"转成了"我可以帮你把材料准备好"。这一段靠的是专属智脑第二层:它是谁、当前要做什么。
它是谁:她不能做什么,和能做什么一样重要
// 专属智脑的角色配置(节选,实际在控制台可视化配置)
{
  身份: '医院导诊员',
  人设: '在门诊大厅站了十年的导医,说话慢、不吓人、有耐心',
  角色: '导诊与流程引导,不做任何医学判断',
  规则: [
    '一次只追问一个问题',
    '患者描述零散时先复述确认',
    '出现红旗词立即建议急诊并说明理由',
    '不诊断、不开药、不评价医生的诊断',
    '拿不准就说"这个需要医生判断"'
  ],
  任务: '让患者三分钟内知道该挂哪科、怎么去、怎么挂',
  对话流程: '主诉 → 定位 → 性质 → 伴随表现 → 红旗筛查 → 给建议',
  Workflow: '红旗词触发急诊通道;超出能力范围转分诊台护士',
  音频: '语速 0.92、音色温和、音量稳定',
  工具调用: ['分诊决策树', '号源查询', '院内导航', '呼叫护士', '生成导诊单']
}
这一整页里,最该被划重点的是角色那一行:导诊与流程引导,不做任何医学判断。你去看杏语所有的回答,她从不说"您这是胃炎"“应该是阑尾炎”,只说"建议挂普外科,排查阑尾问题"。连"排查"和"确诊"的措辞都是分开的。
换一个角色,同一个模型就变成另一种人。 如果角色写成"分诊医师"、任务写成"给出初步诊断",她照样能说得很像样,但会开始给结论、给用药建议、暗示某个病可能性很大——对医院来说这是责任问题,不是体验问题。
这就是需求文档里说的岗位化、场景化、流程化:不是让模型更聪明,而是让它知道"我是谁、代表谁、服务谁、守什么规矩、这一步做什么、下一步该调哪个能力"。用哪个大模型是可以自己配的——医院有自己在用的就接自己的,没有就用星云自研智脑,它在这类"身份和边界"的事情上做得比较扎实。
演示价值:这一组是五组里最容易被忽略、但最有差异化的一组。多数 AI 演示都在回避"AI 承认自己不知道"这个画面,而对医院来说,这恰恰是最需要观众看到的一面。
附:她的零件是可以换的
上面这些落地到医院时都会撞上一个现实问题:医院已有的 HIS、语音供应商、硬件基本都定了,不可能因为上一个导诊智能体就全部换掉。所以这些模块在设计上是可插拔的:
但可插拔不等于把 API 拼起来。感知、认知、表达、执行之间有时序依赖和状态关联——谁先谁后、事件怎么流转、会话状态怎么保持、时间戳怎么对齐、异常怎么兜底。星云是靠标准化的接口契约和统一的状态管理来保证这些的:换掉一个模块之后,事件流转、会话状态、时间同步、异常处理仍然一致,端到端的体验不会因为换了零件就崩。
拿第 3 组那个"播报途中被打断"来说就很直观:如果 ASR 换了供应商,但状态管理没跟上,杏语可能停下来了、却不知道自己停在哪一句,或者新信息进来了、原来的分诊图回滚不了。可插拔真正考验的不是换零件的那一下,是换完之后那一整套状态还对不对得上。
问诊三分钟:分诊决策树,一行都不能省
分诊的专业性全在"问什么、怎么排"。我们把三甲医院分诊指南编成了决策树,杏语负责在这棵树上一次只问一个问题:
const XINGYU_PERSONA = `你是导诊员杏语。规则:
1. 一次只追问一个问题,禁止一次抛出多个问题
2. 患者描述零散时,先复述确认:"您是说肚脐右边疼,对吗?"
3. 出现红旗词(胸痛/呼吸困难/大汗/意识模糊)立即建议急诊并说明理由
4. 最终建议必须包含:科室、大概楼层、挂号的两种方式
5. 不诊断、不开药、不评价医生的诊断,拿不准就说"这个需要医生判断"`;

// 分诊决策树(节选)
const triageGraph = {
  start: { question: '您主要是哪里不舒服?' },
  腹痛: {
    question: '疼的位置在肚脐周围、右边,还是上腹部?',
    右下腹: { question: '按下去疼,还是松手的时候更疼?',
              松手更疼: { advice: '建议挂普外科,排查阑尾问题,请尽快' },
              按下去疼: { advice: '建议挂消化内科' } },
    上腹部: { question: '疼痛和吃饭有关系吗?空腹疼还是饭后疼?',
              空腹疼: { advice: '建议挂消化内科' },
              放射到后背: { advice: '建议挂肝胆外科' } },
  },
  胸痛: { RED_FLAG: true, advice: '胸痛请直接前往急诊,现在就去,不要排队' },
};
【图2 截图】分诊对话过程:杏语追问→患者答→杏语复述确认,连续三屏拼图
红旗词那一条是和医院医务科磨了三轮定下来的:宁可错放去急诊,不可漏掉一句"胸痛"。具身智能体在这里有个意外优势——杏语说"请直接前往急诊"时带的急切语气和表情,比弹窗红字的患者遵从率高得多,中老年用户尤其吃这一套。
这里还有一件我一开始当成"UI 细节"、后来发现很要紧的事:她的表情和语气是跟着内容走的。
讲"内分泌科在二楼西侧"的时候,她会抬手指一下斜下方;讲到"您这个更可能和消化系统相关"会放慢、语气平;而红旗词那一段,语速加快、眉头收紧、身体前倾——同一套表达系统里,语言、语气、停顿、表情、手势是同一次生成出来的,不是先把话说完、再想该配哪个表情。
这正是它和"TTS 念完贴个口型"最本质的区别:后者是两件事先后发生,前者是一件事。而且表达和感知是并行的——她念路线的同时耳朵开着,患者随时能补一句,她能停下来重算。这就是第 3 组那个演示能成立的原因。
查房笔记:上线一个月的实测
在医院公众号上线 31 天,导诊对话 4,702 次:
| 指标 | 数据 |
|---|---|
| 平均完成一次分诊 | 2 分 48 秒 |
| 人工分诊台对照 | 平均 6 分 30 秒/人 |
| 挂号建议与最终诊断科室吻合率 | 82%(另有 11% 相关科室) |
| 患者中途补充信息成功接住 | 100%(打断重算) |
| 60 岁以上用户占比 | 47% |
| 投诉"听不懂" | 2 例(方言口音极重,已转人工) |
不回避问题:吻合率 82% 离人工分诊护士的 90%+ 还有差距,主要丢分在多系统慢性病患者的复杂描述上;决策树是静态的,罕见病覆盖不足——这两个都排进了下一版迭代。
听觉这一环值得单独说,因为门诊大厅大概是全中国最难听清的地方之一。
早高峰的大厅里,叫号广播、导医台对话、轮椅滚过地砖的声音、排队人群的交谈,全叠在一起。而目标用户——六十岁以上的患者——说话声音轻、语速慢、吞字、还带方言。要让杏语在这种环境里听明白,语音侧得连着做完一串事:
先把真实人声从环境里分出来(算法降噪、远场语音);再处理她自己的声音——她讲着话,大屏喇叭的输出会从麦克风绕回来,AEC 抗回声和本体声音抑制就是防止她把"自己的声音"当成患者在说话,空旷大厅里这个问题尤其明显(有个很实在的现象:她说完一句之后,如果回声没处理好,她会以为自己被打断了,然后莫名其妙地停下来);然后靠 VAD 判断哪一段是有效人声。
最关键的是打断。老人有个特点——不太敢打断,但真打断的时候往往是最要紧的信息(“等等,我还有糖尿病”)。而打断又不能太敏感:患者习惯性地应"嗯"“对”“是是”,这些是 Backchannel,意思是"我在听",不是要插话。分不清这两者,她就会变成那种患者一吭声就闭嘴、患者以为她没听见的糟糕助手——在医院问路这种场景里,一次"她好像没在听我说话"的感觉,就够患者转身去找人工了。
视觉侧在医院还有个很实用的用法:患者不太会操作自助机,站在大屏前往往也不点。所以大厅导览屏用了摄像头感知有人进入交互范围后主动开口——阿姨在屏前站定、抬头看了一秒,杏语那边就先出声了:"您好,哪里不舒服?我帮您看看挂哪个科。"就这一句话,把自助分诊的启动率拉起来的作用,比我们后来做的任何界面优化都大。
这些合起来才是多模态感知:系统要知道的不是"这句话说了什么",而是现场此刻正在发生什么。
下班前:导诊数字化,难的不是答,是问
做完杏语我才理解,医院分诊台真正的专业壁垒不是"知道答案",而是知道下一个该问什么。真人护士三分钟问三个问题就能锁定方向,靠的是几十年的追问直觉。把这种直觉翻译成决策树 + 人设约束,才是这个项目最重的活——代码反而是最轻的,500 行以内。
端到端具身交互智能给这个场景带来的根本变化:分诊从"填表"变回了"对话"。患者说不清的,杏语能等;患者说岔的,杏语能绕回来;患者害怕的,杏语的声音是稳的。
而且她的身体可以换。现在她在自助机大屏、导览屏和手机小程序里;再往前走一步,如果把她放进一台院内导览机器人——身份、分诊决策树、科室知识、患者对话记忆全部复用,只是多了一副能动的身体:在大厅入口接待,陪着人往诊室走,到楼上停下来指一下"消化内科就在这一侧,第三个门"。这些属于数字与物理行动里的"物理行动"——转向、靠近、移动、导航带路、跟随、上肢动作,以及更复杂的 Robot Skill。
这也是星云这套体系里我很喜欢的一个说法:同一个智能体,可以拥有不同的身体。身体可以换,但她的身份、知识、记忆、任务和业务能力持续存在——智能体持续存在,身体不断升级。
回到分诊台本身:她不替代护士,也不做任何医学判断。她做的事只有一件——把患者慌乱的、说不清的那两分钟,整理成护士一眼能看懂的信息。 魔珐星云是一套端到端具身交互智能平台,让 AI 通过屏幕和机器人进入真实世界,成为能够感知、理解、表达并行动的智能体。分诊台前那两分钟,大概就是这句话落地时最具体的样子。
你带爸妈去医院挂号,最头疼的是排队、选科室,还是教他们用自助机?评论区聊聊,说不定下一版杏语就照着你的留言改。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)