World-In-World: World Models in a Closed-Loop World
我们到底应该怎样判断一个 World Model 对机器人/具身智能有没有用?
作者认为,现在很多世界模型看起来“生成视频很漂亮”,但这并不意味着它真的能帮助机器人做决策。因此他们提出了一个 闭环世界模型评测框架 World-In-World,把世界模型真正放进 agent–environment 的交互循环里,看它能不能提高任务成功率。
1. 这篇论文为什么要做?
传统的世界模型评估,很多时候看的是生成质量,比如:
- 生成的视频清不清楚;
- 看起来真不真实;
- 视觉质量高不高。
但作者认为,这对于具身智能是不够的。
比如一个机器人看到面前有一个桌子,它准备“向左移动”。世界模型生成了一段非常高清、非常真实的视频,但是视频里的机器人实际上往右走了。
那么:
画面再漂亮,对机器人规划也没用。
因此作者提出一个很关键的观点:
World Model 应该按照它能不能提高 embodied task success 来评价,而不仅仅是按照生成视频的视觉质量评价。
论文明确指出,目前缺少一个统一 benchmark,去测试生成的世界是否真的能够帮助 agent 进行感知、规划、执行以及根据新观测重新规划。
这基本就是这篇论文的核心出发点。
2. World-In-World 到底是什么?
一个把各种 World Model 插进机器人决策循环里的统一“测试平台”。
它的核心流程在论文第 3 页 Figure 3 画得非常清楚。
整个过程可以压缩成:
Proposal → Simulation → Revision → Execute → Observe → 再循环
也就是:
真实环境
   ↓
当前观测 ot
   ↓
Proposal Policy
提出多个候选动作
   ↓
A1   A2   A3 ... AM
 ↓    ↓    ↓
        World Model
 ↓    ↓    ↓
预测未来状态
O1   O2   O3 ... OM
   ↓
Revision Policy
比较这些未来
   ↓
选择最好的动作
   ↓
在真实环境执行
   ↓
得到新的观测 ot+1
   ↓
重新规划
所以它不是简单地:
输入图片 → 世界模型 → 生成未来视频。
而是:
让世界模型变成 agent 的“想象器”。
机器人先在脑子里想:
“如果我执行动作 A,会发生什么?”
“如果我执行动作 B,会发生什么?”
“如果我执行动作 C,会发生什么?”
然后比较几个预测的未来,再决定真正执行哪个动作。
作者把这个过程形式化成一种 policy-guided beam search:proposal policy 产生 MM 个候选 action plan,World Model 分别 rollout 这些动作,然后 revision policy 对这些预测结果评分并选择最终决策。
这个思想其实非常重要。
3. 为什么需要 Unified Action API?
这里还有一个现实问题。
不同 World Model 接受的控制输入完全不一样。
有的模型接受:
文本:
"move forward and turn left"
有的接受:
camera trajectory
(x, y, θ)
还有的接受:
机器人低层 action
[x, y, z, rotation, gripper]
这样不同模型很难公平比较。
所以作者设计了一个:
Unified Action API
统一表示 agent 的动作:
然后通过一个映射:
转换成不同 World Model 需要的输入形式。这个 API 支持三大类控制方式:text prompt、camera trajectory/viewpoint、low-level actions。
于是就可以做到:
          Unified Action
                ↓
 ┌──────────────┼──────────────┐
 ↓              ↓              ↓
Text          Camera          Robot
Prompt       Trajectory       Action
 ↓              ↓              ↓
Wan          SE3DS          Action WM
LTX          PathDreamer     ...
...
这也是为什么作者能够把一堆非常不同的 World Model 放进同一个 benchmark。
4. 它测试了哪些任务?
这篇论文用了 4 类具身任务。
“世界模型 benchmark 里面到底什么叫一个 task?”
论文第 5 页 Figure 4 把四种任务放在了一张图里。
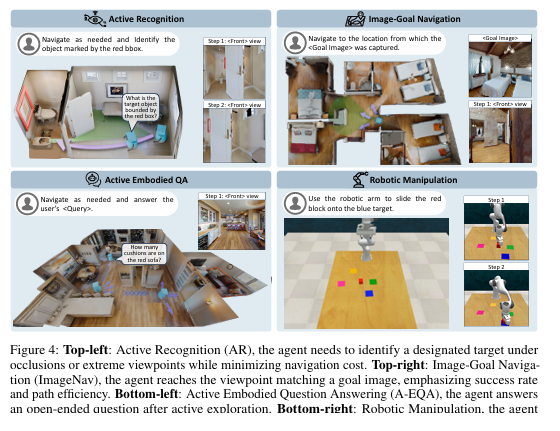
| Task | 世界模型帮助 agent 做什么 |
|---|---|
| Active Recognition | 主动移动视角,看清被遮挡物体 |
| Active Embodied QA | 在环境里探索,然后回答问题 |
| Image-Goal Navigation | 根据目标图片导航到对应位置 |
| Robotic Manipulation | 控制机械臂进行抓取、推动、放置等 |
这四类任务其实覆盖了:
Perception → Navigation → Reasoning → Manipulation
所以它不是只测“视频预测误差”,而是看:
预测出来的未来是否真的帮助 agent 完成任务。
5. 一个非常重要的设计:Post-training
作者还发现:
直接拿一个很强的视频生成模型当 World Model,效果其实没有想象中好。
原因很简单。
例如 Wan、SVD 这些模型主要是在大量互联网视频上训练的。
它可能知道:
“一个人在房间里走动应该长什么样。”
但是它不一定知道:
“机器人执行 action = MoveForward 后,相机应该精确移动多少。”
所以作者又做了一件事情:
Action-Observation Post-training
用类似:
Observation_t
+
Action_t
        ↓
World Model
        ↓
Observation_t+1
这样的 embodied 数据继续训练视频模型。
对于 Habitat-Sim 的导航任务,他们使用 HM3D 的 action-observation 数据;对于机械臂 manipulation,则使用 RLBench/CoppeliaSim 的 demonstration 数据进行 post-training。
这一步非常关键,因为它让普通的:
Video Generator
逐渐变成:
Action-conditioned World Model
6. 这篇论文最重要的实验结论
我认为真正值得记住的不是哪个模型高了几个百分点,而是下面三个现象。
第一:视频越漂亮 ≠ World Model 越好
这是整篇文章最重要的结论。
作者比较:
Generation Quality
        vs
Task Success Rate
发现相关性并不强。
反而:
Controllability
      vs
Task Success Rate
相关性明显更强。论文将 controllability 定义为模型预测与预期动作结果之间的对齐程度,并发现 action-conditioned post-training 后,这种控制一致性与任务成功率同步提高。
也就是说:
World Model 最重要的不一定是“画得像”,而是“动作给对以后,未来变化得对”。
这和普通 Video Generation 的目标是有明显区别的。
第二:训练一个更大的视频模型,不一定比增加 embodied 数据更重要
他们比较了不同 post-training 数据量:
400
4K
40K
80K
随着 action-observation 数据增加,成功率持续提高。
而且一个非常有意思的结果是:
Wan2.2 虽然预训练规模更大,但加入足够的 embodied action-conditioned 数据以后,较小/较早的模型也能接近它。
作者因此认为:
对 embodied world model 来说,post-training data scaling 可能比单纯升级 pretrained video generator 更有效。
这个结论其实很有研究价值。
第三:Inference-time Compute 也可以 Scaling
这个也非常有意思。
正常情况下可能只让 World Model 想象:
未来 3 种可能
但如果让它想:
未来 5 种
未来 8 种
未来 11 种
agent 就有更多候选未来可以比较。
实验发现,例如 SVD† 在 Active Recognition 中,平均 inference 次数从 3 增加到 11 后,success rate 从 53.36% 提高到 60.98%。
因此世界模型也存在类似 LLM 的:
Inference-time Scaling
也就是:
想得更多 → 比较更多未来 → 做出更好的决策。
7. 但是 Manipulation 出现了一个很值得注意的问题
这个地方我觉得你尤其要留意。
世界模型在:
Recognition
Navigation
EQA
上的帮助比较明显。
但是到了:
Robotic Manipulation
提升明显变小。
例如论文中:
VLM baseline:44.5%44.5\%
加入最好的 post-trained SVD:46.5%46.5\% 只提高了一点。
作者认为原因在于机械臂需要模拟:
- 接触;
- 摩擦;
- 机器人运动学;
- 物体精确移动;
- articulated object;
- deformable object。
而现有视觉 World Model 很容易出现:
画面看起来合理
≠
物理过程正确
因此作者在 Discussion 中明确把 precise interaction and dynamics modeling 列为未来的重要方向,包括 physics-guided generation、physical properties、physics-aware post-training 等。
这个问题其实非常关键。
8. 总结这
以前大家测试 World Model:
“你生成的视频像不像真的?”
World-In-World 说:
“我不管你视频多漂亮。我要把你放进机器人脑子里,让机器人用你预测未来,然后看看机器人任务成功率到底有没有提高。”
因此评价标准从:
Visual Quality\text{Visual Quality}
变成:
这就是这篇论文最大的思想贡献。论文结论也明确强调,World-In-World 是通过 embodied interaction 而非孤立视觉指标来评价生成式世界模型,并用统一 action API 与闭环 planning 将不同 World Model 纳入同一个评测框架。
这篇论文的创新点,重点其实不在“发明了一个新的世界模型网络结构”,而在于提出了一套新的评测与使用 World Model 的方法论。
最核心可以概括成 3 个创新点,而且这三点基本就是作者自己在论文里列的贡献。 WORLD-IN-WORLD WORLD MODELS IN …
-
提出 World-In-World:把世界模型放进真实的闭环任务里评测。
过去很多 benchmark 主要看生成质量,比如画面是否逼真、视频是否连贯;这篇论文认为这些指标不能说明 World Model 是否真的对机器人有用。于是它让 agent 在任务中不断经历“观察 → 提出动作 → 世界模型预测未来 → 选择动作 → 真正执行 → 再观察”的闭环,并最终用任务成功率来评价 World Model。 WORLD-IN-WORLD WORLD MODELS IN …
所以它的评价标准从“生成得好不好看”转成了“能不能帮助 agent 做成事情”。 -
提出统一的闭环规划框架 + Unified Action API。
不同世界模型的控制方式完全不同:有的吃文本,有的吃相机轨迹,有的吃机器人低层动作。作者设计了统一接口 \(I=C(A)\),把同一个候选动作序列转换成不同模型能够接受的控制形式;然后统一执行 proposal → simulation → revision 的规划流程。 WORLD-IN-WORLD WORLD MODELS IN …
这个创新的价值是:以前不同 World Model 很难在同一个 embodied benchmark 里公平比较,现在可以接进同一个框架。 -
系统研究了“怎样把普通视频生成模型变成更有用的 embodied World Model”,并发现两种 scaling 规律。
作者用 action-observation 数据继续微调已有视频生成模型,使其从“会生成合理视频”变成更“听动作指挥”的 action-conditioned world model。然后发现两个重要规律:一是增加 embodied action-observation post-training 数据,会持续提高任务表现;二是测试时增加 world-model rollout / inference 次数,也会提高闭环任务成功率。 WORLD-IN-WORLD WORLD MODELS IN …
他们还发现一个很关键的现象:视觉质量高并不一定意味着任务成功率高,controllability 反而更重要。 WORLD-IN-WORLD WORLD MODELS IN …
你可以把它压缩成一句论文式表述:
World-In-World 的主要创新不是提出新的生成模型,而是构建了一个面向具身智能的闭环世界模型评测平台,通过统一动作接口和在线规划框架,将异构世界模型用于真实决策,并系统揭示了 controllability、action-conditioned post-training data scaling 和 inference-time scaling 对任务成功率的重要性。
如果按“创新程度”再细分
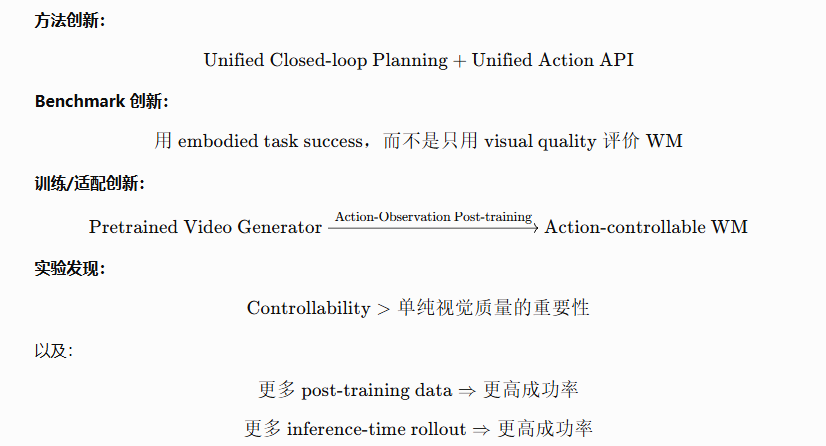
这里有一点尤其值得注意:Action-Observation Post-training 是论文的重要组成部分,但如果严格按作者自己列的“三条 contribution”,它不是单独一条主贡献,而是服务于第三条“training-time scaling / adaptation”的。 所以你以后汇报这篇论文时,不要把它讲成“作者主要提出了一个新的 post-training 算法”,这样会有点偏;这篇的主轴还是 closed-loop benchmark + unified interface + scaling/finding。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献4条内容

所有评论(0)