Python后端爬虫专题15:登录不是绕过——在明确授权下管理Session、Cookie与CSRF
Python后端爬虫专题15:登录不是绕过——在明确授权下管理Session、Cookie与CSRF
上一篇练习完整答案
完整并发脚本如下,峰值由 worker 内部在每次 await 前后记录,期望值来自 limit 而不是用被测函数计算:
import asyncio
from jobradar.concurrency import bounded_map

async def main() -> None:
    active = 0
    peak = 0
    lock = asyncio.Lock()

    async def square(value: int) -> int:
        nonlocal active, peak
        async with lock:
            active += 1
            peak = max(peak, active)
        await asyncio.sleep((10 - value) * 0.002)
        async with lock:
            active -= 1
        return value * value

    result = await bounded_map(list(range(10)), square, limit=3)
    assert result == [0, 1, 4, 9, 16, 25, 36, 49, 64, 81]
    assert peak == 3

asyncio.run(main())
6 个 Worker 每个最多 4 个详情,总理论峰值是 24;若三个任务访问 A、三个访问 B,则单域理论峰值各 12。共享 SQLAlchemy Session 写库会遇到并发 flush/transaction 状态冲突,而且某协程 rollback 可能撤销另一个协程未提交的工作。本项目只并发下载,随后在拥有 Session 的任务协程中顺序落库。
先划清边界
这一课只讨论你所属组织明确授权的内部系统:有测试账号、有负责人、有允许自动化访问的范围与频率。看到登录页不意味着有权自动登录;验证码、多因素认证、反机器人挑战表达的是额外控制,本课程不教授破解或规避。真实工作中应优先请求服务账号或正式 API。
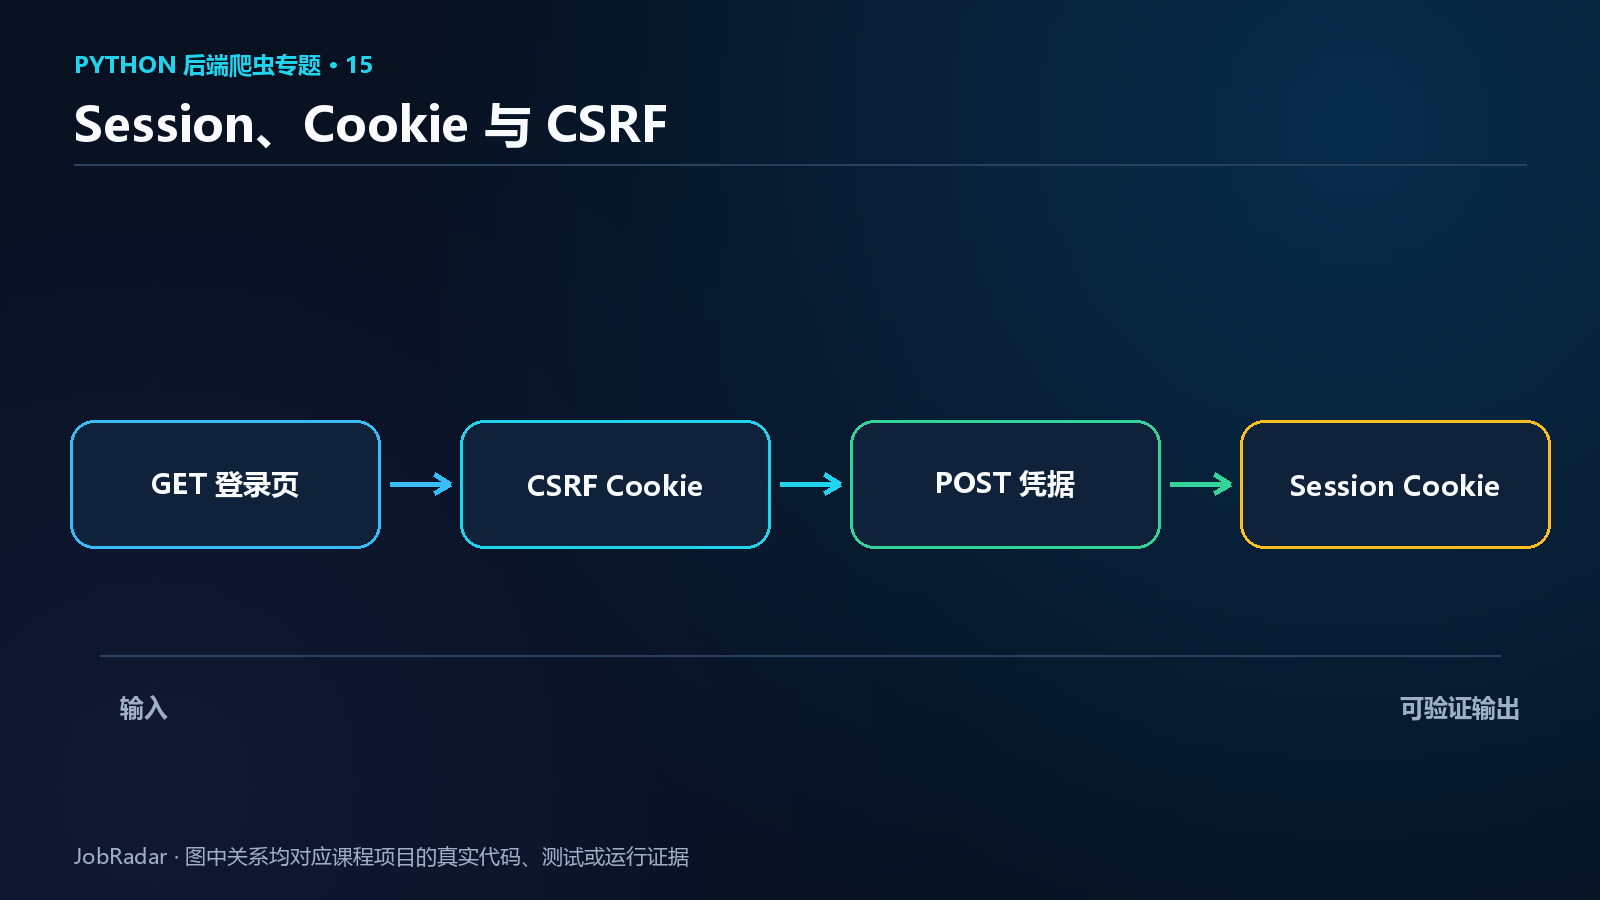
TargetLab 故意实现最小登录流程:GET /login 返回隐藏 csrf_token,同时设置 targetlab_csrf Cookie;POST /login 必须提交用户名、密码和表单 token,而且 Cookie token 必须相同;成功后服务器发 targetlab_session;随后 GET /internal/jobs 才能访问。少任一步都收到 401 或 403。
Session 到底保存了什么
HTTPX AsyncClient 内有 Cookie jar。第一次响应的 Set-Cookie 被保存,后续同源请求自动携带;这才是 Session 的实际意义。不要自己拼 Cookie 字符串,也不要把会话 Cookie 复制到日志或快照。连接复用是另一个收益,但它与身份认证不是一回事。
AuthorizedSession.login_and_fetch() 的调用者提供 login_url、protected_url、username、password。它先 GET 表单,用 BeautifulSoup 找 input[name=csrf_token];缺失时立即抛 AuthenticationFailed。然后 POST 表单,关闭自动重定向,避免错误登录被 302 到普通页面后误判成功;只接受明确成功状态,再访问受保护资源。
cd project
.\.venv\Scripts\python.exe -m pytest tests\test_auth_session.py::test_authorized_session_follows_csrf_login_before_internal_fetch -q
该测试使用真实 TargetLab 登录端点与 HTTPX Cookie jar,最后断言受保护页面内容。另一个测试伪造表单 token,即使已有 bootstrap Cookie 也必须 403。这证明 CSRF 校验比较的是两条独立通道,而不是“表单里有个字段就行”。
凭据从哪里来
示例测试可以写课程固定密码,生产代码不能。Worker 应从 Secret Manager、容器 secret 或部署环境读取,并限制只有对应来源的任务能取到。环境变量比把密码提交到仓库好,但仍可能从进程诊断或错误日志泄露;敏感值要定期轮换,账号只授予读取必要页面的最小权限。
日志可以记录 login_started、host、task_id、status,却不能记录 password、Cookie、Authorization、完整表单。第 24 篇的 sanitize_fields 提供纵深防御,但“事后打码”不能替代“根本不把秘密交给日志函数”。
CSRF 与爬虫解析为什么有关
CSRF token 不是固定配置,它通常与当前 Session、页面或时间绑定,所以必须在同一个 client 中先取表单再提交。把昨天 token 写入配置会过期;用正则随便从整页抓一串字符容易拿错。解析登录表单也应像解析职位一样检查必需字段,并在页面结构变化时明确失败。
若登录成功后返回 302,应验证 Location 在授权域名内,再决定是否跟随;否则开放重定向可能把带身份的请求引向错误位置。跨域重定向还要防止敏感头被转发。本课适配器保持流程短小,安全 URL 策略会在第 25 篇集中复盘。
失败如何分类
401 通常表示凭据错误或会话失效,应该停止并通知负责人,不要高速重试;403 可能是 CSRF 错误或账号无权限,同样需要检查合同;429 应服从 Retry-After;5xx 可有限重试。登录页返回 200 但没有 token 是页面合同变化,不应继续提交猜测字段。
登出、过期和并发 Session 是生产扩展点。若服务限制单账号同时会话数,多个 Worker 共享账号会互相踢出;解决方式是服务端颁发机器凭据或集中会话管理,而不是不断重新登录。
本篇完整授权会话模块
模块没有“验证码识别”或浏览器指纹。它只自动化一条获得许可、可审计、可在 TargetLab 中复现的标准表单链路,并把认证失败统一为不含密码的业务异常。
"""仅用于获得明确授权的内部站点登录采集。"""

from bs4 import BeautifulSoup
import httpx


class AuthenticationFailed(RuntimeError):
    """登录流程未建立可用会话;错误消息不包含提交的凭据。"""


class AuthorizedSession:
    """复用 HTTPX CookieJar,按表单合同提交服务器发放的 CSRF token。"""

    def __init__(self, client: httpx.AsyncClient) -> None:
        self._client = client

    async def login(self, login_url: str, *, username: str, password: str) -> None:
        form_response = await self._client.get(login_url)
        if form_response.status_code != 200:
            raise AuthenticationFailed(
                f"login form returned HTTP {form_response.status_code}"
            )
        soup = BeautifulSoup(form_response.text, "html.parser")
        token_input = soup.select_one("input[name=csrf_token][value]")
        if token_input is None:
            raise AuthenticationFailed("login form does not contain a CSRF token")
        response = await self._client.post(
            login_url,
            data={
                "username": username,
                "password": password,
                "csrf_token": str(token_input["value"]),
            },
        )
        if response.status_code != 200:
            raise AuthenticationFailed(f"login returned HTTP {response.status_code}")

    async def get(self, url: str) -> httpx.Response:
        """使用登录后 CookieJar 发请求;调用者仍负责 URL allowlist。"""
        return await self._client.get(url)
本篇课后练习
- 画出 GET 登录页、POST 凭据、Set-Cookie、GET 受保护页的请求顺序,标明两个 Cookie 分别何时产生。
- 运行三条授权会话测试,完整记录错误密码和伪造 CSRF 各返回什么,解释为什么不应自动重试。
- 写一份内部采集授权清单,至少包括数据负责人、允许路径、账号权限、频率、凭据轮换和停止机制。下一篇开始把相同解析合同接入 Scrapy 调度引擎。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 2
 0
- 0


 已为社区贡献2条内容

所有评论(0)