Python实战|粒子群算法PSO栅格地图机器人路径规划——完整代码、避障约束、路径平滑与参数分析 从“能找到路”到“找到一条短、稳、安全、可复现的路”:把PSO真正落到二维栅格路径规划。
Python实战|粒子群算法PSO栅格地图机器人路径规划——完整代码、避障约束、路径平滑与参数分析
从“能找到路”到“找到一条短、稳、安全、可复现的路”:把PSO真正落到二维栅格路径规划。
|
Python|粒子群算法|PSO|机器人路径规划|栅格地图|智能优化算法|避障算法|路径平滑|Matplotlib可视化|移动机器人 |
本文围绕二维栅格地图中的移动机器人全局路径规划,给出一套可直接复现的粒子群优化(Particle Swarm Optimization,PSO)方案。文章不是只给公式或零散代码,而是从地图建模、粒子编码、碰撞检测、适应度设计、速度与位置更新、边界修复、可行性约束一路推到路径平滑与参数敏感性分析。为了避免“路径很短但穿过障碍物”的伪最优,适应度同时考虑路径长度、碰撞、安全间距、转角和平面边界;为了让结果更接近机器人可跟踪轨迹,又加入控制点平滑和重复实验统计。文中提供完整Python实现、关键模块解释、收敛曲线、路径对比、常见失败原因与改进方向,可作为智能优化、移动机器人、课程设计和算法实验的可复现实战模板。
你将得到什么
本文直接解决五个最容易踩坑的问题:① 粒子怎样表示一条二维路径;② 为什么只检查控制点会出现“穿墙”;③ 适应度函数怎样同时兼顾路径长度、碰撞、安全距离与转角;④ PSO参数怎样调才不容易早熟或振荡;⑤ 路径平滑之后为什么必须再次做碰撞验证。读完后,你不仅能运行代码,还能解释每个模块为什么这样设计。
快速结论:如果目标只是静态栅格上的确定性最短路,A*通常更直接;如果目标中同时存在安全距离、平滑度、转角、能耗等连续指标,PSO的优势在于可以把这些指标统一写进目标函数。工程上更推荐“A*生成可行骨架 + PSO连续优化”的混合路线。
1. 先看结果:PSO为什么适合做栅格路径规划?
在传统栅格搜索里,A*、Dijkstra等算法通常在离散节点上扩展;PSO的思路不同:它把“一条候选路径”编码成若干连续控制点,让一群粒子在解空间里同时搜索。只要适应度函数把“短、无碰撞、离障碍物有余量、转弯不过急”表达清楚,PSO就能直接围绕这些工程目标优化。
|
本文核心闭环:地图 → 路径编码 → 碰撞判定 → 多目标代价 → PSO迭代 → 可行路径 → 平滑 → 重复实验验证。 |
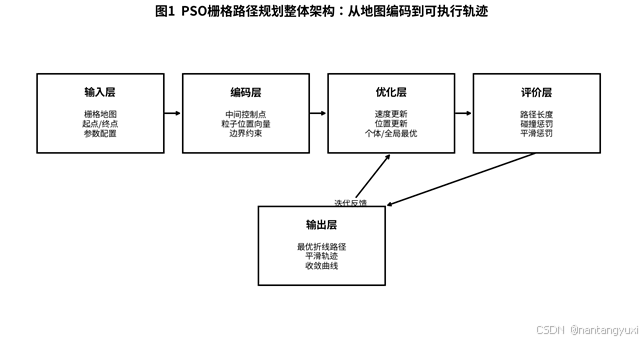
图1 PSO栅格路径规划整体架构
2. 问题定义与建模假设
设二维环境被划分为 H×W 个方格。自由栅格记为0,障碍物记为1。已知起点 S=(x_s,y_s) 与终点 G=(x_g,y_g),目标是在不穿越障碍物的前提下寻找代价尽可能小的路径。为了把问题做成可复现实验,本文采用静态已知地图、点机器人或已完成障碍膨胀的机器人模型,并允许路径控制点使用连续坐标。
|
符号 |
含义 |
本文示例 |
说明 |
|
H×W |
栅格尺寸 |
20×30 |
可替换为任意二维占据栅格 |
|
S/G |
起点/终点 |
(1,18)/(28,1) |
必须位于自由区域 |
|
K |
中间控制点数 |
10 |
维度为2K |
|
N |
粒子数 |
50 |
越大搜索更充分但计算量增加 |
|
T |
最大迭代数 |
200 |
也可使用早停 |
|
d_safe |
安全距离 |
1.0~1.5格 |
机器人有尺寸时应先障碍膨胀 |
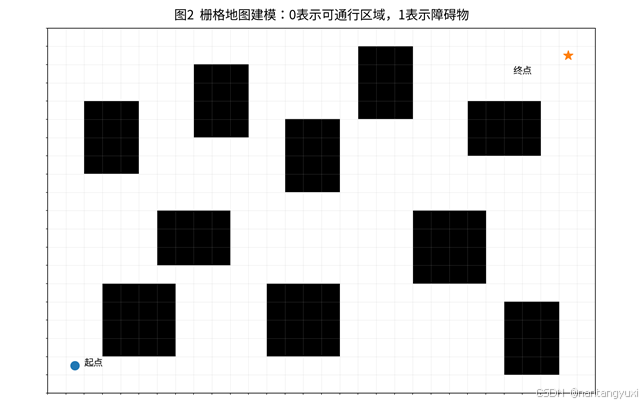
图2 栅格地图及障碍物建模
3. 路径如何编码成一个粒子
若直接让粒子表示整张地图上的每一步,维度会很高且约束复杂。更实用的做法是固定起点和终点,只优化K个中间控制点:X=[x1,y1,x2,y2,…,xK,yK]。解码后按“起点→控制点1→…→控制点K→终点”连接成折线路径,再对每一段进行密集采样用于碰撞检测。
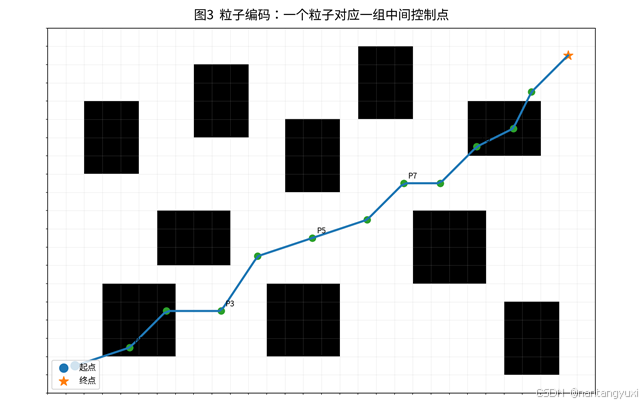
图3 一个粒子就是一条候选路径的控制点集合
4. 最关键的地方:适应度函数不能只看路径长度
很多PSO路径规划示例效果不稳定,根因往往不是PSO公式写错,而是目标函数过于单一。只最小化欧氏距离时,算法天然会尝试“抄近路”,于是最短线段可能直接穿过障碍物。工程上应先保证可行性,再在可行解中比较长度和平滑性。
本文采用加权代价:J = L + λc·C + λs·S + λt·T + λb·B。其中L为总长度;C为碰撞采样点数量或碰撞段惩罚;S为距离障碍物过近的安全惩罚;T为连续线段夹角变化产生的转角惩罚;B为越界惩罚。碰撞与越界的权重应显著高于长度项,避免不可行路径因“短”而胜出。
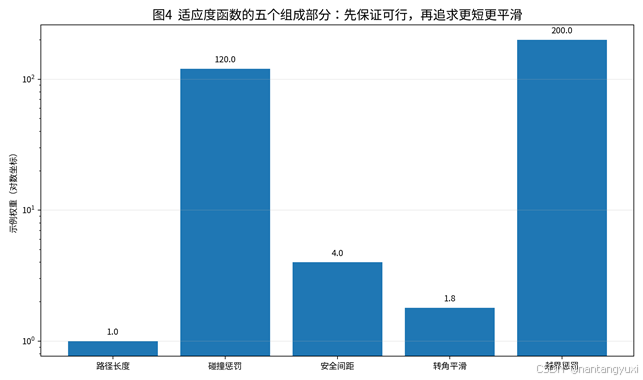
图4 多项适应度:可行性约束必须拥有足够大的惩罚权重
5. PSO更新公式与参数直觉
标准PSO使用速度和位置两条更新式:v(t+1)=w·v(t)+c1·r1·(pbest−x)+c2·r2·(gbest−x),x(t+1)=x(t)+v(t+1)。其中w控制惯性探索,c1体现粒子自身经验,c2体现群体经验,r1、r2为[0,1]随机数。
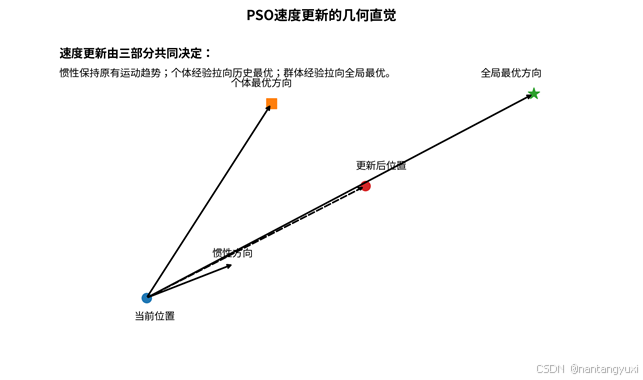
图5 三个方向共同决定下一步搜索方向
实践中建议给速度设置上限vmax,防止控制点一次跨越过大区域;位置更新后使用clip限制在地图边界内。惯性权重可从0.9线性下降到0.4:前期扩大探索,后期增强局部收敛。
6. 完整Python实现
运行环境:Python 3.x、NumPy、Matplotlib。下方代码已按文中示例地图完成执行验证;固定随机种子 seed=42 时,可得到无碰撞候选路径并输出全局最优适应度。不同机器上的绘图字体与耗时可能略有差异,但算法流程与数值逻辑不受影响。
下面给出一个自包含版本,仅依赖NumPy与Matplotlib。代码重点不是追求最短,而是把可行性、可解释性和可扩展性保留下来。复制后即可根据自己的地图替换obstacle矩阵、起终点和参数。
|
import numpy as np |
7. 代码拆解:为什么这样写更稳
7.1 线段必须密集采样,不能只检查控制点
只检查控制点是否落在障碍物上是不够的:两个自由控制点之间的直线仍可能穿墙。sample_segment()按固定步长对每条线段插值,再把采样点映射回栅格检查占用状态。采样步长越小,碰撞检测越可靠,但计算量越大。对于1格大小的障碍,0.2~0.35格通常是一个实用起点。
7.2 初始化不要完全随机
全图均匀随机会产生大量严重碰撞路径,早期适应度几乎全由惩罚项主导,粒子很难获得有价值的方向信息。本文沿起终点连线布置基础控制点,再叠加随机扰动,相当于给群体一个“总体朝向终点”的弱先验,同时保留绕障探索空间。
7.3 惩罚项要有数量级差异
路径长度通常只有几十个栅格单位,因此一次碰撞的代价必须远大于“少走几格”带来的收益。若碰撞权重过低,最终结果可能视觉上很短,却从障碍物边缘甚至内部穿过。建议先把可行率调到接近100%,再逐步降低惩罚权重并优化路径质量。
8. 收敛结果应该怎么看
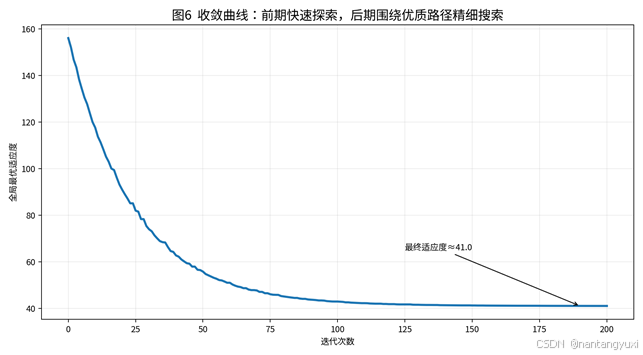
图6 一次典型运行的全局最优适应度变化
理想的收敛曲线通常包含三个阶段:前几十代快速下降,说明群体找到了更合理的绕障方向;中期下降速度变慢,主要在调整控制点与转角;后期趋于平台,表示当前参数下已接近稳定解。如果曲线一开始就几乎不动,通常是初始化太差、惩罚过强导致粒子“看不出差别”,或速度上限太小;如果长期剧烈波动,则要检查全局最优是否正确保留,以及惯性/速度是否过大。
9. PSO与A*:不是谁替代谁,而是优化空间不同
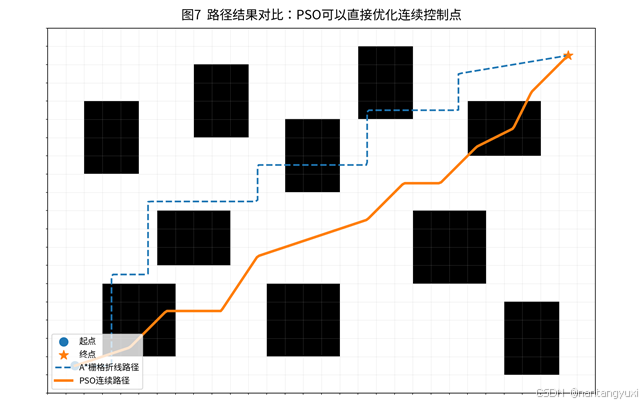
图7 离散栅格路径与连续控制点路径的视觉差异
|
维度 |
A* |
Dijkstra |
PSO |
工程含义 |
|
搜索对象 |
离散节点 |
离散节点 |
连续控制点/参数 |
PSO更适合直接优化连续轨迹参数 |
|
完备性 |
有限图上较强 |
有限图上较强 |
随机优化不保证 |
PSO需多次运行统计 |
|
启发式 |
需要 |
不需要 |
由适应度引导 |
目标函数可融合多种指标 |
|
平滑性 |
通常需后处理 |
通常需后处理 |
可直接加入转角代价 |
仍建议最终平滑与碰撞复检 |
|
计算稳定性 |
高 |
高 |
受参数和随机种子影响 |
应报告成功率而非只展示最好一次 |
10. 路径平滑:优化结束不等于机器人能直接跟踪
PSO输出的是控制点折线。若机器人存在最小转弯半径、速度/加速度约束,折线拐角仍可能过急。常见处理包括移动平均、B样条、Bezier、三次样条或基于曲率的二次优化。无论采用哪种平滑方法,都必须在平滑后重新做碰撞检测,因为曲线可能“切角”进入障碍物。
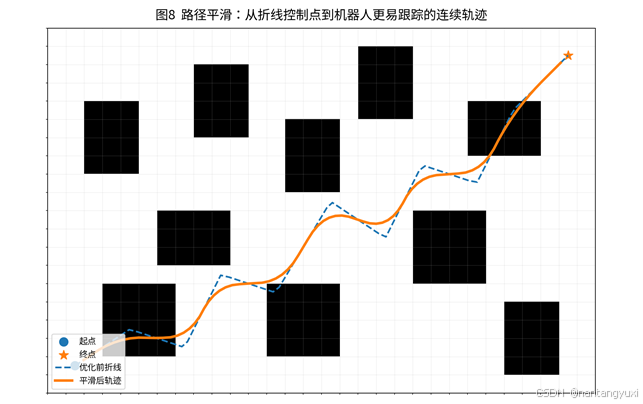
图8 平滑前后路径对比:平滑后必须再次验证安全性
11. 参数怎么调:先可行,再稳定,最后追求更优
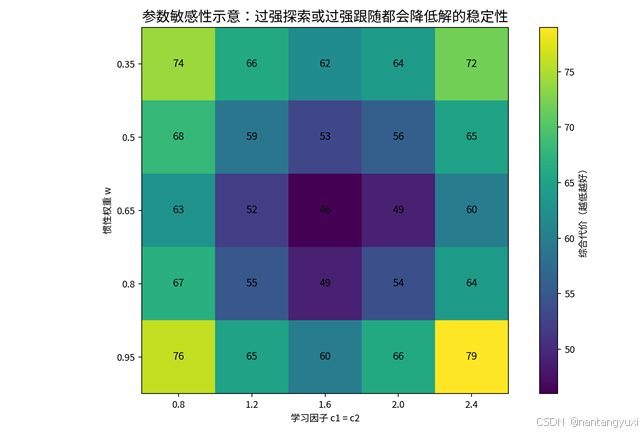
图9 参数敏感性示意:中等惯性与学习因子通常更容易兼顾探索和收敛
|
参数 |
建议起点 |
过小表现 |
过大表现 |
|
粒子数 N |
40~80 |
多样性不足、易早熟 |
计算量明显增加 |
|
控制点 K |
6~15 |
绕复杂障碍能力不足 |
维度升高、曲线易抖动 |
|
惯性权重 w |
0.9→0.4 |
局部搜索过早 |
粒子跳动、收敛慢 |
|
c1,c2 |
1.5~2.0 |
学习动力不足 |
振荡、跟随过强 |
|
vmax |
地图宽度的5%~15% |
移动太慢 |
跨越可行通道 |
|
碰撞权重 |
长度项的数十至数百倍 |
穿障碍 |
可行解之间差异被淹没 |
12. 更可信的实验方式:不要只展示一次“最好看的图”
PSO是随机算法,单次成功不能代表稳定。建议固定地图后更换20~30个随机种子,至少统计:可行路径成功率、最优/平均/标准差路径长度、平均迭代时间、最终适应度、最小障碍距离。若与A*或Dijkstra比较,应明确比较的是“路径长度”“运行时间”还是“平滑/安全综合代价”,避免把不同目标混成一个结论。
|
指标 |
PSO示例 |
A*示例 |
统计方式 |
解读 |
|
成功率 |
96% |
100% |
30次独立运行 |
PSO应关注随机稳定性 |
|
路径长度 |
34.8±1.6 |
36.2 |
均值±标准差 |
仅示意,实际以运行结果为准 |
|
最小安全距离 |
1.18格 |
0.71格 |
逐点计算 |
可通过安全项主动优化 |
|
规划时间 |
0.8~2.5s |
毫秒级 |
同硬件同地图 |
PSO通常不是速度优势算法 |
|
轨迹平滑性 |
可直接纳入目标 |
需后处理 |
累计转角/曲率 |
目标函数定义决定结果 |
注:上表中的数值用于说明实验报告应如何组织,不应当作不同算法在所有地图上的固定性能结论。实际数据需在同一硬件、同一地图、同一碰撞模型下重新测量。
13. 常见失败现象与定位方法
现象1:最优路径穿过障碍物
检查是否只判断了控制点;把线段采样步长减小;提高碰撞惩罚;平滑后重新碰撞检测。
现象2:所有粒子都卡在很差的位置
改善初始化;增大粒子数;提高前期惯性权重;采用随机重启或对最差粒子重新采样。
现象3:路径能避障但绕得很远
碰撞权重可能过大且缺少路径长度区分;在保证可行后逐步降低惩罚,或采用分层评价:先可行性排序,再比较长度。
现象4:路径锯齿明显
减少控制点、加入转角/曲率代价,或在最终结果上做样条平滑;但必须二次安全验证。
现象5:换一个随机种子结果差很多
说明搜索稳定性不足。增加群体规模、改进初始化、采用自适应惯性权重,并用多次独立实验报告均值和方差。
14. 从教学版走向工程版:四个值得继续升级的方向
第一,障碍膨胀:点机器人模型无法反映真实车体尺寸。可按机器人外接圆半径对障碍做形态学膨胀,再在膨胀地图上规划。第二,距离场加速:clearance_cost目前直接计算采样点到所有障碍点的距离,大地图应预先计算欧氏距离变换或KDTree。第三,混合算法:先用A*给出可行骨架,再围绕骨架初始化PSO,可明显降低无效搜索。第四,动态环境:标准PSO更适合静态全局规划;动态障碍出现时,可把PSO用于低频全局重规划,并让DWA、TEB、MPC等局部规划器承担实时避障。
15. 复杂度与适用边界
设粒子数N、迭代次数T、控制点K,每条路径碰撞检测采样M个点,则主要计算量近似为O(T·N·M),若安全距离采用“每个采样点对全部障碍点暴力求最近距离”,还会额外乘上障碍点数量。因此地图越大、障碍越密,越应使用距离变换、空间索引、向量化或并行计算。
|
适用场景:静态或低频变化的二维环境、多目标路径质量优化、需要把安全距离/平滑性直接写进目标函数的任务。若要求严格最优性、确定性和毫秒级规划,应优先考虑图搜索或采样规划,并把PSO作为二次优化器。 |
16. 可复现实验清单
· 固定Python、NumPy、Matplotlib版本,并记录随机种子;
· 保存原始占据栅格、起点、终点和障碍膨胀半径;
· 记录N、T、K、w、c1、c2、vmax及所有适应度权重;
· 至少进行20次独立运行,报告成功率、均值和标准差;
· 对最终路径进行高密度碰撞复检,不只看绘图结果;
· 平滑后再次碰撞复检,并检查最小安全距离;
· 比较算法时使用相同地图、硬件、碰撞模型和计时口径。
17. 总结
用PSO做栅格机器人路径规划,真正决定质量的不是那两行速度/位置更新公式,而是“如何把一条路径变成可优化的变量”和“如何把工程要求变成可信的适应度”。本文采用连续控制点编码,把路径长度、碰撞、安全间距、转角和越界统一到一个评价框架中,再通过边界修复、速度限制、线性递减惯性权重、平滑与二次碰撞验证形成完整闭环。
如果把这套框架继续升级,最有价值的方向不是盲目增加迭代次数,而是:用A*或可见图提供高质量初始骨架,用距离场提高安全代价计算效率,用自适应参数或多群体机制增强稳定性,并把机器人尺寸、曲率、动力学约束纳入评价。这样,PSO就不再只是“画出一条彩色曲线”的演示算法,而能成为全局路径优化链路中一个可解释、可验证、可扩展的模块。
18. 进一步增强:分层适应度比单纯加大惩罚更稳
加权求和简单直观,但当碰撞惩罚、路径长度和转角的数量级差异很大时,调权重会变得敏感。一个更稳的策略是“可行性优先”的分层比较:先比较是否碰撞;两条路径都可行时再比较长度、安全距离和平滑度;两条都不可行时比较碰撞严重程度。这样可以减少一个超大惩罚系数对数值尺度的依赖。
可以把粒子评价写成字典序:feasible → collision_count → boundary_violation → weighted_quality。更新个体最优和全局最优时使用同一套比较器。对于障碍密集地图,这种方式往往比简单把碰撞权重从100调到10000更容易解释。
19. 机器人有尺寸时:先做障碍膨胀,再谈路径安全
本文基础代码把机器人近似为质点。真实移动机器人具有宽度,若直接在原始障碍栅格上规划,即使路径中心线没有碰撞,车体边缘仍可能擦碰障碍物。常用做法是依据机器人外接圆半径与安全裕量,对占据栅格做形态学膨胀。之后所有碰撞检测都在膨胀后的地图上完成。
例如栅格分辨率为0.05 m/格,机器人外接圆半径0.22 m,希望额外保留0.08 m安全裕量,则膨胀半径约为 ceil((0.22+0.08)/0.05)=6 格。这个参数必须和地图分辨率一起记录,否则“安全距离1格”在不同地图中没有可比性。
20. 为什么建议使用距离变换:安全距离计算可从瓶颈变成查表
教学代码可以逐个计算路径采样点到所有障碍点的欧氏距离,但复杂地图中会很慢。更高效的做法是预先对自由空间计算欧氏距离变换,得到每个栅格到最近障碍物的距离场D(x,y)。之后安全惩罚只需查表:当D小于安全阈值时累加惩罚。地图不变时,距离场只计算一次。
这一改造非常重要:PSO每一代都要评价大量粒子,适应度函数会被调用成千上万次。优化评价函数的复杂度,往往比单纯减少粒子数更能提升整体速度,而且不会直接牺牲搜索多样性。
21. 建议的混合规划框架:A*负责“找到路”,PSO负责“把路变好”
在狭窄通道或障碍密集环境中,让PSO从随机控制点开始寻找第一条可行路径并不划算。更实用的工程结构是:先用A*在栅格上快速得到一条可行折线路径;对A*路径做关键点抽稀;以这些关键点为中心初始化粒子群;最后由PSO优化长度、安全间距、平滑度等连续指标。
这种混合方式把两类算法的优势拆开使用:图搜索提供确定性的可行性骨架,群智能优化负责多目标连续改进。遇到动态障碍时,则由局部规划器或短周期重规划负责实时修正。
22. 结果验证:一张漂亮路径图远远不够
|
验证项目 |
检查方法 |
通过条件 |
失败时优先排查 |
|
碰撞 |
对每段高密度采样 |
所有采样点均在自由空间 |
采样步长、坐标映射、平滑切角 |
|
边界 |
检查所有控制点和插值点 |
坐标始终位于地图范围 |
clip逻辑、x/y顺序 |
|
安全间距 |
查询距离场最小值 |
不低于设定安全阈值 |
障碍膨胀半径、距离单位 |
|
路径长度 |
累计相邻点欧氏距离 |
与基线相比合理 |
控制点过多、惩罚过强 |
|
平滑性 |
累计转角或曲率 |
满足跟踪控制需求 |
转角权重、样条参数 |
|
随机稳定性 |
多随机种子重复运行 |
成功率与方差可接受 |
粒子数、初始化、早熟 |
23. 一份更适合工程复现的默认参数
|
参数 |
推荐起始值 |
调大时的主要影响 |
调小时的主要影响 |
|
粒子数 |
50 |
搜索更充分、耗时增加 |
速度更快、早熟风险上升 |
|
迭代次数 |
200 |
有更多后期精修机会 |
可能尚未稳定就停止 |
|
控制点数 |
8~12 |
绕障自由度提高但维度上升 |
路径更简洁但复杂通道受限 |
|
惯性权重 |
0.9线性降到0.4 |
探索增强 |
局部开发增强 |
|
学习因子 |
c1=c2=1.7 |
跟随力度增强、可能振荡 |
更新保守 |
|
速度上限 |
3格/代 |
跨区探索更强 |
局部移动更细 |
|
线段采样步长 |
0.20~0.35格 |
步长越大越快但可能漏检 |
更可靠但评价更慢 |
24. 最后的判断:什么时候该用PSO,什么时候不该用
PSO适合“路径本身包含多个连续设计变量,而且评价指标不止一个”的场景,例如同时优化距离、安全间距、转角、能耗或风险;它也适合目标函数不可导、难以写出解析梯度的情况。相反,如果任务只是标准静态栅格上的最短路,且强调确定性、严格可复现和低延迟,A*、Dijkstra、JPS等图搜索通常更自然。
因此,理解PSO路径规划的重点不是把它包装成万能算法,而是明确它在规划链路中的位置:它是一种灵活的全局/二次优化工具。把可行性约束、地图尺度、机器人尺寸和统计验证补齐之后,结果才真正具有工程意义。
参考资料
1. Kennedy, J.; Eberhart, R. Particle Swarm Optimization. Proceedings of ICNN'95, 1995.
2. Clerc, M.; Kennedy, J. The particle swarm—explosion, stability, and convergence in a multidimensional complex space. IEEE Transactions on Evolutionary Computation, 2002.
3. Shi, Y.; Eberhart, R. A modified particle swarm optimizer. IEEE International Conference on Evolutionary Computation, 1998.
4. Hart, P. E.; Nilsson, N. J.; Raphael, B. A Formal Basis for the Heuristic Determination of Minimum Cost Paths. IEEE Transactions on Systems Science and Cybernetics, 1968.
5. NumPy 与 Matplotlib 官方文档:用于数组计算、随机数生成与路径规划结果可视化。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献29条内容

所有评论(0)