RTX 5090复现Openvla,部署,推理,微调、评估和结果分析全流程记录
精简版项目总结、实验结果和演示视频:GitHub记录
一、环境配置
OpenVLA 官方测试栈:Python 3.10、torch 2.2.0、torchvision 0.17.0、transformers 4.40.1、tokenizers 0.19.1、timm 0.9.10、flash-attn 2.5.5。OpenVLA LoRA:官方写明至少要27GB 显存,batch_size=16 约需 72G,等正式微调的时候改小即可。
我的卡是RTX 5090,显存32607MiB 显存,系统内存:31GiB 总量,部署时可用约 13GiB。足够部署和微调,但是5090的兼容性不是很好,比如flash-attn==2.5.5 没有为RTX 5090 sm_120 编译 CUDA kernel,所以不能完全按OpenVLA官方的 配置来。
1、创建conda环境
conda create -n openvla python=3.10 -y
conda activate openvla
2、安装适配 RTX 5090 的 PyTorch
RTX 5090 需要较新的 CUDA/PyTorch 栈支持 sm_120。官方 OpenVLA 的 torch==2.2.0 太老,不适合 5090。安装采用 PyTorch 官方 CUDA 12.8 wheel。最终确认的版本为
Python:      3.10
PyTorch:     2.9.1+cu128
torchvision: 0.24.1+cu128
torchaudio:  2.9.1+cu128
CUDA runtime bundled with torch: 12.8
3、安装openvla基础依赖
安装基础依赖时使用阿里云 PyPI 镜像加快下载:
python -m pip install \
  transformers==4.40.1 \
  tokenizers==0.19.1 \
  timm==0.9.10 \
  peft==0.11.1 \
  accelerate==1.14.0 \
-i https://mirrors.aliyun.com/pypi/simple-
transformers/tokenizers/timm模块:OpenVLA 模型结构和视觉编码相关。 -
peft模块:LoRA 微调需要。 -
accelerate模块:训练/加载大模型常用
4、安装本地openvla仓库
之前在配置另一个环境的时候已经拉到过本地,现在只需要直接引用进当前的openvla conda环境即可。
python -m pip install -e /path/to/openvla_repro/openvla --no-deps--no-deps是防止 pip 自动处理依赖,很可能会导致降级当前的 torch==2.9.1+cu128,进而破坏 RTX 5090 + CUDA 12.8 + FlashAttention (后续安装)的兼容环境。因此这里主动保留已经验证可用的新版本 PyTorch 栈。缺点是OpenVLA 的其他 Python 依赖需要手动补齐。
5、下载openvla-7b权重到本地
直接从modelscope下载,在openvla_env环境里执行
python -m pip install modelscope


modelscope download --model zixiaoBios/openvla-7b --local_dir /path/to/openvla_repro/models/openvla-7b
大约15GB。
6、安装缺失的依赖
根据导入openvla时的报错来依次缺什么装什么,比如第一次报错
ModuleNotFoundError: No module named 'dlimp'就安装
python -m pip install "dlimp @ git+https://github.com/moojink/dlimp_openvla" --no-deps注意因为dlimp 不在 PyPI 上,所以直接执行 pip install dlimp 找不到。--no-deps 依旧是为了先只装 dlimp 本体,避免自动拉依赖时改坏现有栈。
再次导入,报错
ModuleNotFoundError: No module named 'tensorflow'
ModuleNotFoundError: No module named 'tensorflow_datasets'
OpenVLA 官方依赖声明了 tensorflow==2.15.0、tensorflow_datasets==4.9.3、tensorflow_graphics==2021.12.3,这些主要用于 RLDS 数据加载/LoRA 微调数据管线。执行以下指令安装tensorflow模块:
python -m pip install "tensorflow==2.15.0"
python -m pip install "tensorflow-datasets==4.9.3" "tensorflow-graphics==2021.12.3" "matplotlib" -i https://mirrors.aliyun.com/pypi/simple
然后报错protobuf / tensorflow-metadata 冲突:
ImportError: cannot import name 'runtime_version' from 'google.protobuf'修复:
python -m pip install \
  "protobuf==3.20.3" \
  "tensorflow-metadata==1.14.0" \
  "absl-py==1.4.0" \
  --force-reinstall \
  -i https://mirrors.aliyun.com/pypi/simple
7、安装 RTX 5090 可用的 flash-attn
进行训练或者微调还需要安装 Flash Attention 2,它是一个更快、更省显存的 attention 实现,前面折腾了这么多归根结底就是因为要避免和flash-attn依赖冲突,官方要求2.5.5版本,但该版本面向较早 GPU 架构,不能保证含有 RTX 5090 的 sm_120 CUDA kernel。最终使用已为 CUDA 12.8 与 sm_120 编译的 wheel:
flash_attn-2.8.3+cu128sm120-cp310-cp310-linux_x86_64.whl执行以下指令安装
python -m pip install --no-deps --no-cache-dir \
  "https://github.com/HenryZ838978/flash-attn-blackwell/releases/download/v2.8.3-sm120/flash_attn-2.8.3+cu128sm120-cp310-cp310-linux_x86_64.whl"
可以写个脚本测试一下目前安装是否都成功了:
import torch
import flash_attn
from flash_attn import flash_attn_func

q = torch.randn(2, 256, 8, 64, dtype=torch.float16, device="cuda")
k = torch.randn(2, 256, 8, 64, dtype=torch.float16, device="cuda")
v = torch.randn(2, 256, 8, 64, dtype=torch.float16, device="cuda")

out = flash_attn_func(q, k, v)
print("flash_attn:", flash_attn.__version__)
print("torch:", torch.__version__, torch.version.cuda)
print("gpu:", torch.cuda.get_device_name(0))
print("capability:", torch.cuda.get_device_capability(0))
print("out:", out.shape, out.dtype)
print("finite:", torch.isfinite(out).all().item())
最终输出
flash_attn: 2.8.3
torch: 2.9.1+cu128 12.8
gpu: NVIDIA GeForce RTX 5090
capability: (12, 0)
out: torch.Size([2, 256, 8, 64]) torch.float16
finite: True
不过终端会有提示版本不一致的error比如
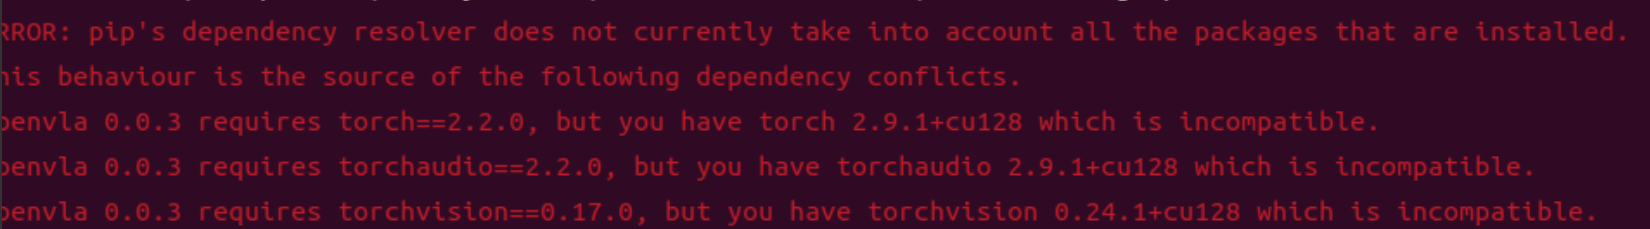
pip check 显示 OpenVLA 要求 torch==2.2.0,但不影响使用,降级了就和别的模块依赖冲突了。
8、安装 OpenVLA 的 LIBERO 评估依赖
LIBERO 是一个lifelong robot learning benchmark,里面同时包含任务套件、演示数据、训练、评测脚本,并且是 基于 MuJoCo 的操作任务环境。后续用到的训练数据集、测试数据集都来自这里。
8.1 安装 OpenVLA 跑 LIBERO eval 所需的仿真相关依赖
在OpenVLA 工作空间目录执行以下指令
python -m pip install -r experiments/robot/libero/libero_requirements.txt \
  -i https://mirrors.aliyun.com/pypi/simple
随即遇到问题,pip 自动安装了最新 mujoco==3.12.0,并把 numpy 1.26.4 升级成了 numpy 2.2.6。numpy 2.2.6 与 tensorflow==2.15.0 不兼容;mujoco 3.12.0 与 robosuite==1.4.1 不兼容问题,LIBERO reset/step 时触发 AssertionError。果然不--no-deps就会出问题。
OpenVLA 数据加载链路依赖 TensorFlow/TFDS,TensorFlow 2.15 要求
numpy >=1.23.5, <2.0.0所以执行以下指令修复Numpy版本为numpy==1.26.4
python -m pip install "numpy==1.26.4" --force-reinstall \
  -i https://mirrors.aliyun.com/pypi/simple
再将 MuJoCo 固定到与 robosuite 1.4.1 更匹配的版本:
python -m pip install "mujoco==3.1.6" --force-reinstall --no-deps \
  -i https://mirrors.aliyun.com/pypi/simple
8.2 安装 LIBERO 本体
在本地工作空间openvla_repro/LIBERO下执行:
python -m pip install -e . --no-depspip show libero 能看到安装成功,但 import libero 失败。原因是 LIBERO 仓库结构比较特殊,OpenVLA 需要:
from libero.libero import benchmark所以 Python 搜索根目录应该是 /path/to/openvla_repro/LIBERO,需要把最外层 LIBERO 仓库加入 PYTHONPATH,后续跑 LIBERO/OpenVLA eval 前都设置:
export PYTHONPATH=/path/to/openvla_repro/LIBERO 8.3 初始化 LIBERO 配置
终端显示
Do you want to specify a custom path for the dataset folder? (Y/N):选择默认路径:
printf 'n\n' | python -c "import libero; print('libero file:', libero.__file__); print('libero config initialized')"这样就会创建/path/to/.libero/config.yaml,里面会记录benchmark_root、datasets等。这些是LIBERO自己的用户配置,不是系统配置
到这里可以验证LIBERO导入能否成功:
python - <<'PY'
import numpy
import tensorflow as tf
import mujoco
import robosuite
import bddl
from libero.libero import benchmark

print("numpy:", numpy.__version__)
print("tensorflow:", tf.__version__)
print("mujoco:", mujoco.__version__)
print("robosuite:", robosuite.__version__)
print("LIBERO benchmark OK")
print("benchmark suites:", benchmark.get_benchmark_dict().keys())
PY
最终输出如下,一切正常
numpy: 1.26.4
tensorflow: 2.15.0
mujoco: 3.1.6
robosuite: 1.4.1
LIBERO benchmark OK
benchmark suites: dict_keys(['libero_spatial', 'libero_object', 'libero_goal', 'libero_90', 'libero_10', 'libero_100'])
二、评估验证
这里用已经预训练好的开源模型openvla-7b-finetuned-libero-spatial来做测试,目的仅仅只是看eval脚本能不能运行,数据指标和演示视频能否被记录,从而验证evaluation pipeline能否正常工作。不是必须完成,比如openvla-7b-finetuned-libero-spatial模型其实可以不用下载,但这里遇到的问题早晚得解决。
OpenVLA 官方 LIBERO 评估有四个主要 suite:
libero_spatial:空间关系任务
libero_object:物体变化任务
libero_goal:目标变化任务
libero_10:长程任务,也叫 LIBERO-Long
每个 suite 通常 10 个任务,官方 evaluation 默认每个任务 50 次 rollout,总共 500 次。我这里只是做个简单测试,所以只部署了最常用的libero_spatial并且每个任务只执行一次。
1、下载openvla-7b-finetuned-libero-spatial
huggingface上的openvla-7b-finetuned-libero-spatial
一开始直接用hf上的git指令单拉下来的只有1.9mb的模型框架,权重没下来:
git clone git@hf.co:openvla/openvla-7b-finetuned-libero-spatial故改为HuggingFace CLI部署,先在openvla环境里安装:
pip install -U huggingface_hub然后在要下载models的路径执行:
HF_ENDPOINT=https://hf-mirror.com hf download openvla/openvla-7b-finetuned-libero-spatial --local-dir ./openvla-7b-finetuned-libero-spatial部分成功..终端有一句显示是
Error: Local entry not found. Distant resource does not seem to be on huggingface.co.说明有某一个文件,hf 客户端尝试从 Hugging Face 获取,但是远端没有找到。执行ls -lh来检查发现缺model-00004-of-00004.safetensors。(safetensors 是 Hugging Face 推出的模型权重存储格式)
再次cd到path/to/models/openvla-7b-finetuned-libero-spatial执行
unset HF_ENDPOINT然后
hf download openvla/openvla-7b-finetuned-libero-spatial --local-dir .它会检查已有文件然后补安装,完整模型大约15GB。
2、验证evaluation pipeline
前面说了LIBERO Spatial10个任务每个任务只跑一次,故experiments/robot/libero/run_libero_eval.py里修改
num_trials_per_task: int = 1 # 原本是50然后cd到/openvla_repro/openvla执行(export PYTHONPATH的原因之前已经说了,如果不这样就会报错ModuleNotFoundError: No module named 'libero.libero')
export PYTHONPATH=/path/to/openvla_repro/LIBERO


python experiments/robot/libero/run_libero_eval.py \ --model_family openvla \ --pretrained_checkpoint /path/to/openvla_repro/models/openvla-7b-finetuned-libero-spatial \ --task_suite_name libero_spatial \ --center_crop True也可以参考这位博主的路径硬编码方法:OpenVLA学习记录(论文解读与复现微调)-CSDN博客
2.1 解决wandb 与 protobuf 版本冲突
现在的报错是
ImportError: cannot import name 'Imports' from 'wandb.proto.wandb_telemetry_pb2'wandb 与 protobuf 版本冲突,故尝试降低版本到wandb==0.15.12
pip uninstall wandb -y


pip install wandb==0.15.12
2.2 解决wandb 0.15.12 与当前 Python 环境里的 setuptools 版本冲突问题
报错显示
ModuleNotFoundError: No module named 'pkg_resources'执行pip show setuptools显示
Name: setuptools Version: 83.0.0 Location: /path/to/miniconda3/envs/openvla/lib/python3.10/site-packages Required-by: tensorboard, tensorflow, wandbSetuptools 已经安装,而且版本:setuptools==83.0.0非常新,但是问题在于setuptools 新版本已经不再默认提供 pkg_resources 这个旧接口。所以只调整setuptools版本
pip install setuptools==75.8.0 --no-deps2.3 解决transformers 和 huggingface-hub版本不兼容
又冲突了,我释怀地笑,目前环境transformers: 4.40.1,这个版本要求:huggingface-hub >=0.19.3,huggingface-hub <1.0,但是现在:huggingface-hub==1.29.0,所以降级:
pip install huggingface-hub==0.23.5 --no-deps2.4 解决PyTorch 2.6 的 torch.load() 默认安全策略变化导致 LIBERO 初始状态文件加载失败
还没完,报错
WeightsUnpickler error: Unsupported global: GLOBAL numpy.core.multiarray._reconstruct was not an allowed global by default. 因为LIBERO 数据集里的初始化状态init_states.pt不是纯权重文件,而是保存了 Python 对象(numpy array 等)。之前torch.load(path)默认weights_only=False,可以直接加载。
但是 PyTorch 2.6 改成:torch.load(path, weights_only=True)
只允许加载 tensor 权重。所以遇到numpy.core.multiarray._reconstruct这种对象就拒绝。
修改/path/to/openvla_repro/LIBERO/libero/libero/benchmark/init.py,把
init_states = torch.load(init_states_path)改为
init_states = torch.load(
    init_states_path,
    weights_only=False
)
2.5 解决保存任务视频崩溃的问题
OpenVLA eval 已经跑完 9/10 个任务,第 10 个任务执行到一半时,在保存视频阶段崩溃。
报错OSError: [Errno 24] Too many open files说明打开文件太多,Linux 中,一个运行中的程序不是只能打开普通文件。所谓 file descriptor(文件描述符,FD) 包括:还可能包括打开的文件 .txt、图片文件、视频文件、pipe(进程通信管道)、socket、GPU/EGL相关资源句柄、ffmpeg进程通信通道等。每个进程都有一个限制,执行如下指令让当前终端启动的程序最多可以打开65535个文件描述符。
ulimit -n 65535并且在当前 run_libero_eval.py 里加入保护机制:
替换原本的视频保存函数:
上游代码原本从 libero_utils.py 导入:
from experiments.robot.libero.libero_utils import (
    get_libero_dummy_action,
    get_libero_env,
    get_libero_image,
    quat2axisangle,
    save_rollout_video,
)
原始视频函数位于openvla_repro/openvla/experiments/robot/libero/libero_utils.py:
def save_rollout_video(rollout_images, idx, success, task_description, log_file=None):
    video_writer = imageio.get_writer(mp4_path, fps=30)
    for img in rollout_images:
        video_writer.append_data(img)
video_writer.close()问题在于:video_writer.close() 只会在所有帧都正常写完后才执行。如果append_data()、ffmpeg 管道或文件描述符分配中途报错,函数会直接异常退出,writer 和关联资源未必能及时关闭。
故改为run_libero_eval.py 不再导入 save_rollout_video,而是使用自己定义 _save_rollout_video():
video_writer = imageio.get_writer(str(mp4_path), fps=30)
try:
    for img in rollout_images:
        video_writer.append_data(img)
finally:
    video_writer.close()
finally 的含义是:无论 try 中正常完成、抛出异常,甚至中断执行,Python 离开该代码块前都会执行 video_writer.close()。这降低了 MP4 文件、ffmpeg 子进程管道和相关文件描述符在异常路径中残留的风险。记得额外加入:
import imageio修改保存逻辑
原本逻辑是在每个 episode 结束后直接保存视频:
save_rollout_video(
    replay_images,
    total_episodes,
    success=done,
    task_description=task_description,
    log_file=log_file,
)
没有 try/except。因此视频保存一旦出现之前的报错:
OSError: [Errno 24] Too many open files整个 evaluation 进程会异常终止,后续 task、成功率和日志都无法完成。故在eval脚本加入
video_save_enabled = True并将视频保存包装为:
video_saved = False

if video_save_enabled:
    try:
        _save_rollout_video(...)
        video_saved = True
    except Exception as e:
        video_save_enabled = False
        print(f"Warning: failed to save rollout video; disabling later video writes: {e}")
        log_file.write(
            f"Warning: failed to save rollout video for episode {total_episodes}: {e}\n"
        )
这样如果视频保存失败,也不会对模型推理、仿真、日志记录有影响。
每个 task 结束后显式关闭 LIBERO/MuJoCo 环境
原始 eval 脚本会针对每个 task 创建环境:
env, task_description = get_libero_env(task, cfg.model_family, resolution=256)但 task 的全部 episode 完成后,没有显式的env.close()。在 多 task或每 task 多 rollout 评估中,MuJoCo、EGL/OpenGL 上下文及相关资源可能跨 task 累积。故当前脚本在每个 task 的 episode 循环结束后,新增了
try:
    env.close()
except Exception as e:
    print(f"Warning: failed to close LIBERO environment for task {task_id}: {e}")
    log_file.write(f"Warning: failed to close LIBERO environment for task {task_id}: {e}\n")
finally:
gc.collect()env.close():请求 robosuite / MuJoCo 释放当前 task 的仿真资源;gc.collect():主动触发 Python 垃圾回收,尽快回收不再引用的 Python 对象;try/except/finally:即使关闭环境本身出现异常,也不让评估整体崩溃,且仍执行垃圾回收。
再次启动评估测试终于一切正常,视频都保存在rollouts文件夹下便于自行检查效果。
三、LoRA微调
1、下载训练数据集
OpenVLA README 里明确说微调用的是 Hugging Face 上的 openvla/modified_libero_rlds,包含 libero_spatial_no_noops 等 RLDS 数据集:https://huggingface.co/datasets/openvla/modified_libero_rlds
微调阶段只读取离线演示数据,不启动 MuJoCo,也不需要仿真窗口。MuJoCo 是后续 LIBERO 策略评测阶段使用的。
2、其他准备工作
为了确保能稳定长久地实现机器学习我休息所以在开始训练前还依次做了一些测试。比如在finetune脚本里加断点保存机制,这次中断退出后下次还能继续这个进度训练;并且每训练500step就保存一次,防止因为训练步数过多导致模型过拟合或者动作坍缩。另外也增设了一些安全阈值,后来正式训练时显存使用峰值29.26 GiB,CPU最高温度72°C,最高功耗538.17 W,最低可用RAM0.69 GiB,都没超过阈值。
参数配置如下
batch_size=4
gradient_accumulation_steps=4
effective_batch_size=16
LoRA rank=32
LoRA dropout:0
LR:0.0005
max_steps=8000
save_steps=500
FlashAttention 2
BF16OpenVLA官方要求batch_size=16 约需 72G,所以我正式训练时改成4,gradient_accumulation_steps相应地增大到4。数学上和OpenVLA官方的batch_size=16
gradient_accumulation_steps=1的effective batch一样,但是GPU执行方式完全不同。gradient_accumulation_steps是梯度累积步数,用来模拟更大的 batch size。相当于每次只把 4条样本放进 GPU,连续累积 4次梯度,再更新一次参数,所以 batch size 等效于 16。
数据记录在wandb里,正式训练前先在Weights & Biases: The AI developer platform注册并拿到5090,这里又有兼容性问题了,我之前终于不会和别的依赖冲突的wandb==0.15.12只能匹配旧版的40位API KEY,而现在wandb的API KEY都是86位。所以拿到86位KEY之后直接复制进终端
export WANDB_API_KEY='<YOUR_API_KEY>'然后在同一终端运行finetune脚本即可。训练指标在GitHub记录
四、模型效果评估
测试依旧是用的Libero Spatial,此时记得把之前验证evaluation pipeline时候的num_trials_per_task参数改回50。一共十类任务,每个任务跑50个episode。demos在GitHub记录
之前用Lora训练保存的都只是adapter,评估时需要再 adapter 挂载到 base model 后调用 merge_and_unload() 生成完整推理模型。根据train loss曲线我把6k到8k步训练过程中保存的模型都做了测试来看效果。如果运行eval脚本遇到问题可以会看第二节评估验证。
最终的测试成功率如下
| Checkpoint | 成功率 |
| 6k | 8.80% |
| 6.5k | 15.40% |
| 7k | 23.00% |
| 7.5k | 7.80% |
| 8k | 26.60% |
整体趋势并非单调上升。模型从 6k 到 7k 的闭环表现持续改善;7.5k 出现显著退化;8k 又恢复并取得当前最高的总体成功率。
在之前几个训练步的测试中的失败案例在肉眼看来大多都是机械臂完全静止,为区分到底是环境未执行动作还是和模型输出无效动作,从 7.5k 开始,在 eval 中加入了episode级action diagnostics。典型的 7.5k 失败 episode 输出为:
abs_mean=0.001211
abs_max=0.002985
delta_mean=0
gripper_raw_mean=0.996078
gripper_exec_mean=-1abs_mean:6D 位姿 action 的平均绝对幅度
abs_max:rollout 内 6D 位姿 action 的最大绝对幅度
delta_mean:相邻两次 action 的平均变化量
gripper_raw_mean:模型原始 gripper 输出均值
gripper_exec_mean:归一化、符号转换后送入环境的 gripper 均值
这说明模型不仅动作小,而且连续时间步之间没有变化。它更像是在生成一个固定的默认动作序列。而且由于 500 个 episode 都完整完成、视频保存正常,且其他 checkpoint 可以正常控制机械臂,因此可以排除 MuJoCo、EGL 渲染或环境步进整体失效。所以判定异常的原因是:7.5k checkpoint 对大量视觉输入输出了重复的近似 No-op 动作,从而导致闭环策略退化。
不过后续梯度也不是只会让模型越来越差。7.5k 之后继续训练时,模型又见到了新的样本、图像增强结果和任务组合,参数继续更新。如果 7.5k 的 No-op 模式不是稳定收敛点,而只是暂时的坏状态,那么后续梯度可以把它拉出来,就像8k那样。
容易产生困扰的是,看loss曲线在模型训练后期也是缓慢平稳下降,但是到7.5k时测试成功率出现异常。那是因为train loss 是平均的逐 token 指标,闭环成功率则是长时序、二值、极其敏感的指标。一个小小的 token logit 排名变化,比如原本最高概率是向目标移动的动作 token,而更新后最高概率是接近零位移的动作 token。这在在训练 loss 上可能只产生很小变化,但argmax会直接切换输出动作:第一步没有靠近目标 → 下一帧仍然看见类似场景 → 再输出近似 No-op → 220 步重复 → timeout,失败。因此,训练 loss 平稳和 rollout 成功率剧烈波动同时存在这并不矛盾。
以效果最好的8k为例,不同任务的成功率如下
| Task | 成功率 |
Task 1 | 26% |
Task 2 | 40% |
Task 3 | 10% |
Task 4 | 74% |
Task 5 | 50% |
Task 6 | 26% |
Task 7 | 4% |
Task 8 | 10% |
Task 9 | 0% |
Task 10 | 26% |
其中,Task9 的 50 次全失败,其中有 44 个视频近似静止;Task5 则没有静止视频,但仍有 25 次失败,说明该任务的主要瓶颈已是抓取、放置或精细控制。
有明显运动但最终失败的 episode里,有一些是肉眼检查也能明显发现问题比如:
- Task 1的episode1 :看上去像是停顿了挺长时间才开始移动最终导致超时。
- Task1的episode2 :连续抓空后几乎静止,不再移动,同时第一次抓空后机械臂抖动严重。
- TASK1的episode5 :成功抓取,动作流畅但是放置偏移。
-
TASK5的episode202 :没能成功从抽屉中抓取目标,而且似乎卡在抽屉里出不来了,这个任务的确有难度。
-
Task5的episode203: 抓夹角度太大夹到抽屉了。
关于 episode 2的分析:
视频显示它在前约 0-90 帧持续向目标碗移动并尝试操作,之后停在失败状态。其诊断数据也明显更活跃:
abs_mean=0.105071
delta_mean=0.043254
gripper_exec_mean=-0.127273
相较 episode 1,动作幅度和相邻动作差都更大;夹爪输出也在开闭之间切换,而不是固定保持打开。
至于“抖动”,通常是三件事叠加:
-
动作 token 在相邻观测之间切换:模型输出的平移/旋转增量可能在相反方向来回变化。
-
接触动力学放大误差:夹爪接近或碰撞碗、桌面时,小的姿态变化会被碰撞响应放大为视觉上的抖动。
-
抓空后的分布偏移:演示数据主要覆盖成功抓取轨迹;一旦抓空,后续画面进入较少见状态,行为克隆策略没有明确的恢复策略,可能转而输出低幅度默认动作。
因此,后期看似“完全静止”应该是模型输出的执行效果已接近零,控制器在当前姿态下达到局部平衡。
此外一些是肉眼观察成功但是程序判定为false的情况。所有spatial任务的目标都是“on the plate”,但是LIBERO 的on并不是图像语义上的“碗在盘子里”。它实际调用 check_ontop(),同时要求:
-
碗和盘子的物理碰撞体仍接触;
-
碗与盘子的 XY 中心距离小于
0.03 m,即 3 cm; -
满足指定的高度关系。
渲染画面使用的是视觉网格,人眼容易把“压着盘沿、略微偏心、被夹爪悬着、看似落入但碰撞体未接触”理解为成功;但仿真只认可严格的几何和接触条件。而且 eval时 每执行一步动作都会检查 done,一旦成功会立即中止该 episode。因此episode跑到timeout说明在任一控制步结束时,都没有满足成功条件,不是脚本漏掉了一个已经被判为成功的状态。比如:
-
Task 9 / episode 408:约 frame 75 已将碗移到盘附近,之后大部分时间停在目标区域上方或附近。视觉上碗与盘重叠明显,但机械臂仍贴近目标。
gripper_exec_mean=0.636表明夹爪整体更偏向闭合,推测是碗仍被夹持或处于轻微悬空或者盘沿接触状态,未满足成功条件。 -
Task 9 / episode 418:约 frame 90 到达盘附近,之后停住。夹爪整体更偏打开,
gripper_exec_mean=-0.564;更像已尝试释放,但碗可能偏离盘中心、压在边缘,或接触关系不满足。 -
Task 10 / episode 452:约 frame 135 完成搬运并到达盘区域,后续保持静止。视觉上看着动作流畅完成任务但日志记录是timeout。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)