π0.5论文阅读
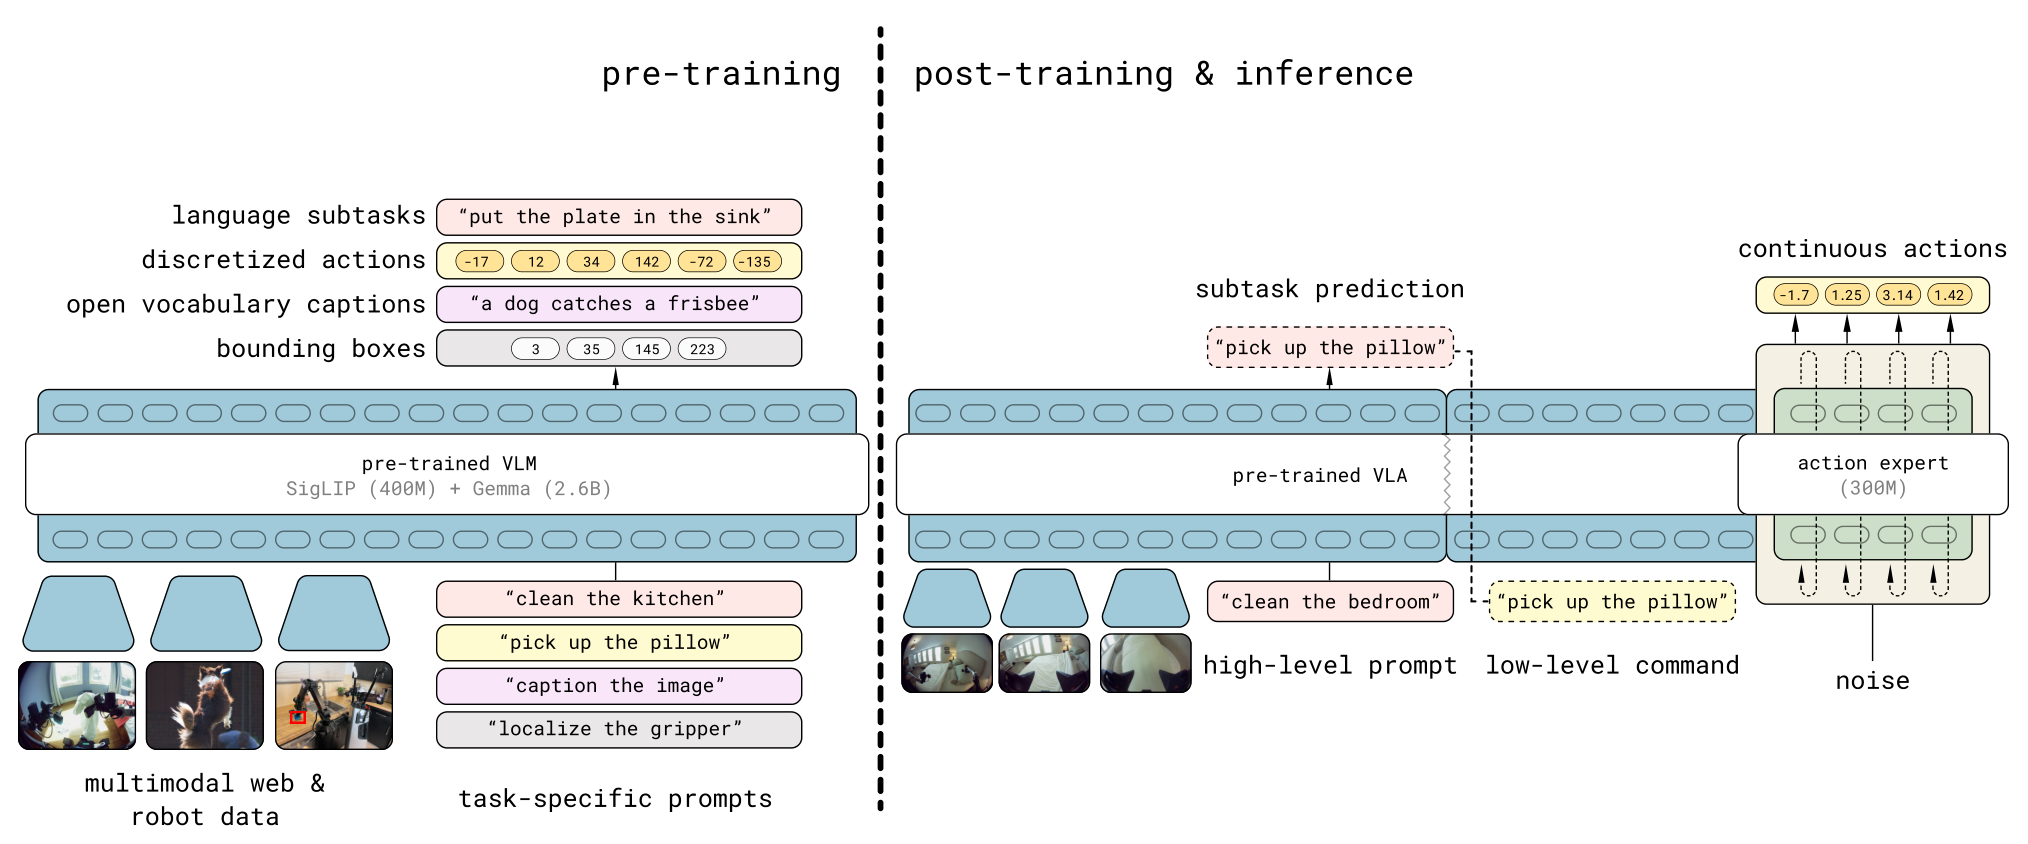
训练过程:
1、模型权重从在网络上训练的标准视觉语言模型初始化(Gemme)。
2、首先数据方面,预训练阶段整合所有数据源,生成带有离散token的初始变长度动作。数据包含来自多种机器人平台的数据、高层语义动作预测数据以及网络数据。机器人的动作采用FAST action tokenizer 将动作转换为token。纳入了一组多样化的网络数据,包括预训练阶段的图像描述、问答以及目标定位任务。对于目标定位,通过添加带有边界框标注的室内场景和家居物品额外网络数据,对标准数据集进行了进一步扩展。对于所有动作数据,训练模型来预测目标关节和末端执行器位姿。为了区分这两者,我们在文本提示词中添加了‘<control_mode> joint/end effector <control_mode>’。所有动作数据均通过各数据集每个动作维度的1%和99%分位数归一化至[−1,1]。将动作action的维度设置为固定值(和Π0一样),以适配所有数据集中最大的动作空间。对于配置和动作空间维度较低的机器人,对动作向量进行零填充(和Π0一样)。
3、后训练阶段针对移动操作的低层和高层推理对模型进行定制,利用与任务最相关的数据,包括人类监督者的语言指令。该阶段使用流匹配来表示动作分布(动作专家),实现高效的实时推理,并能表示细粒度的连续动作序列。推理时,模型先推理出高层子任务,再基于该子任务预测动作。
4、推理时,模型首先为机器人生成要执行的高级子任务,然后基于该子任务,通过动作专家预测低级动作。(仿佛不是端到端,更像是训练了两个模型,上层是视觉语言模型,下层是语言动作模型,但其实不是,这两个共享同一个神经网络,模型既完成了对任务的分解,又完成了基于子任务的动作输出)
5、预训练阶段,Π基于机器人与非机器人数据进行训练,作为标准的transformer进行训练。
6、高级子任务预测,将高层级任务指令(打扫卧室)拆解为(整理毯子、捡起枕头)等更为简短的子任务,能够帮助训练好的策略对当前场景进行推理,更好地确定下一步动作。训练模型既能充当高层级策略(输出子任务)又能充当底层级策略(执行这些子任务所对应的动作)
推理过程的设计:
1、采用了两阶段的推理流程,首先推理出高层语义子任务(例如拿起盘子),再基于该子任务预测动作。
2、高层推理过程的运行频率远低于底层动作推理。
3、动作token单独由动作专家进行推理
4、控制系统为Π0.5直接输出机械臂、夹爪、躯干的升降指令目标位姿,通过动作模块以50HZ的频率控制基座目标速度。这些通过PD控制器进行调节输入给机器人。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 3
 0
- 0


 已为社区贡献4条内容

所有评论(0)