用 Python 定时任务把 AI 日报自动推送到微信:WorkBuddy 实践
为什么想搞一个"AI 日报"
我每天会花不少时间翻各种 AI 相关的信息源,问题是这件事本身很零碎:早上刷一遍,中午刷一遍,晚上再刷一遍,真正有价值的内容可能就三五条,剩下的都是重复转发和标题党。时间一长我就想,与其自己反复刷,不如让机器每天固定时间帮我收一遍、筛一遍、压缩成一份短报,推到我微信上,我扫一眼就行。
这个需求拆下来其实就四件事:
- 到点自动触发,不用我手动跑;
- 从几个固定来源抓取当天内容;
- 用大模型做去重、筛选和摘要,输出结构化结果;
- 推送到微信,最好是我平时就在用的那个入口。
我把它叫 WorkBuddy,其实就是个跑在自己机器上的小服务,没什么花哨的东西。下面按我实际的搭建顺序讲,代码都是我自己跑过的,涉及版本的地方我会写清楚。
整体链路和技术选型
先说我最后定下来的结构:
定时器(APScheduler)
      │
      ▼
抓取模块(requests + feedparser)
      │
      ▼
处理模块(调用大模型做筛选+摘要)
      │
      ▼
渲染模块(生成 Markdown / 纯文本)
      │
      ▼
推送模块(企业微信机器人 Webhook)
几个关键选型说明一下。
| 方案 | 优点 | 缺点 | 适用场景 |
|---|---|---|---|
| APScheduler | 纯 Python,进程内定时,配置灵活 | 进程挂了任务就没了,需要自己保证常驻 | 单机、任务量小的个人服务 |
| 系统 crontab | 稳定,跟进程解耦 | 环境变量、日志、依赖管理麻烦 | 简单脚本、运维熟悉的场景 |
| 云函数定时触发 | 不用管机器 | 冷启动、依赖打包、调试成本 | 不想维护服务器 |
我选 APScheduler,原因是整个服务就是一个 Python 进程,日志、配置、异常处理都在一处,调试方便。代价是得保证这个进程别挂,这个后面讲。
微信推送这块要先说清楚:个人微信没有官方开放的、稳定的机器人消息接口,市面上那些"个人微信机器人"方案大多依赖逆向或 hook,稳定性和合规性都有问题,我不建议在正式场景用。我实际用的是企业微信的群机器人 Webhook,自己建一个只有自己的群,机器人往里发消息,手机上的企业微信就能收到推送。这一点如果你没有企业微信,需要先想清楚替代入口(比如邮件、Telegram、Server 酱之类),本文的推送部分只讲企业微信 Webhook。
依赖版本(我实际环境):
python==3.11
APScheduler==3.10.4
requests==2.31.0
feedparser==6.0.11
openai==1.30.1   # 用于调用兼容 OpenAI 协议的大模型服务
openai 这个库我说明一下:它现在更多是作为一个"兼容 OpenAI Chat Completions 协议的客户端"在用,很多国内模型服务也提供兼容接口,所以换 base_url 就能接。具体你用的服务支持哪些参数,以它的文档为准。
定时:每天十点半触发
APScheduler 的用法不复杂,核心是选对 trigger。
from apscheduler.schedulers.blocking import BlockingScheduler
from apscheduler.triggers.cron import CronTrigger

def build_scheduler(job_func):
    scheduler = BlockingScheduler(timezone="Asia/Shanghai")
    scheduler.add_job(
        job_func,
        trigger=CronTrigger(hour=10, minute=30),
        id="daily_ai_report",
        max_instances=1,
        misfire_grace_time=600,
        coalesce=True,
    )
    return scheduler
几个参数我解释下为什么这么设:
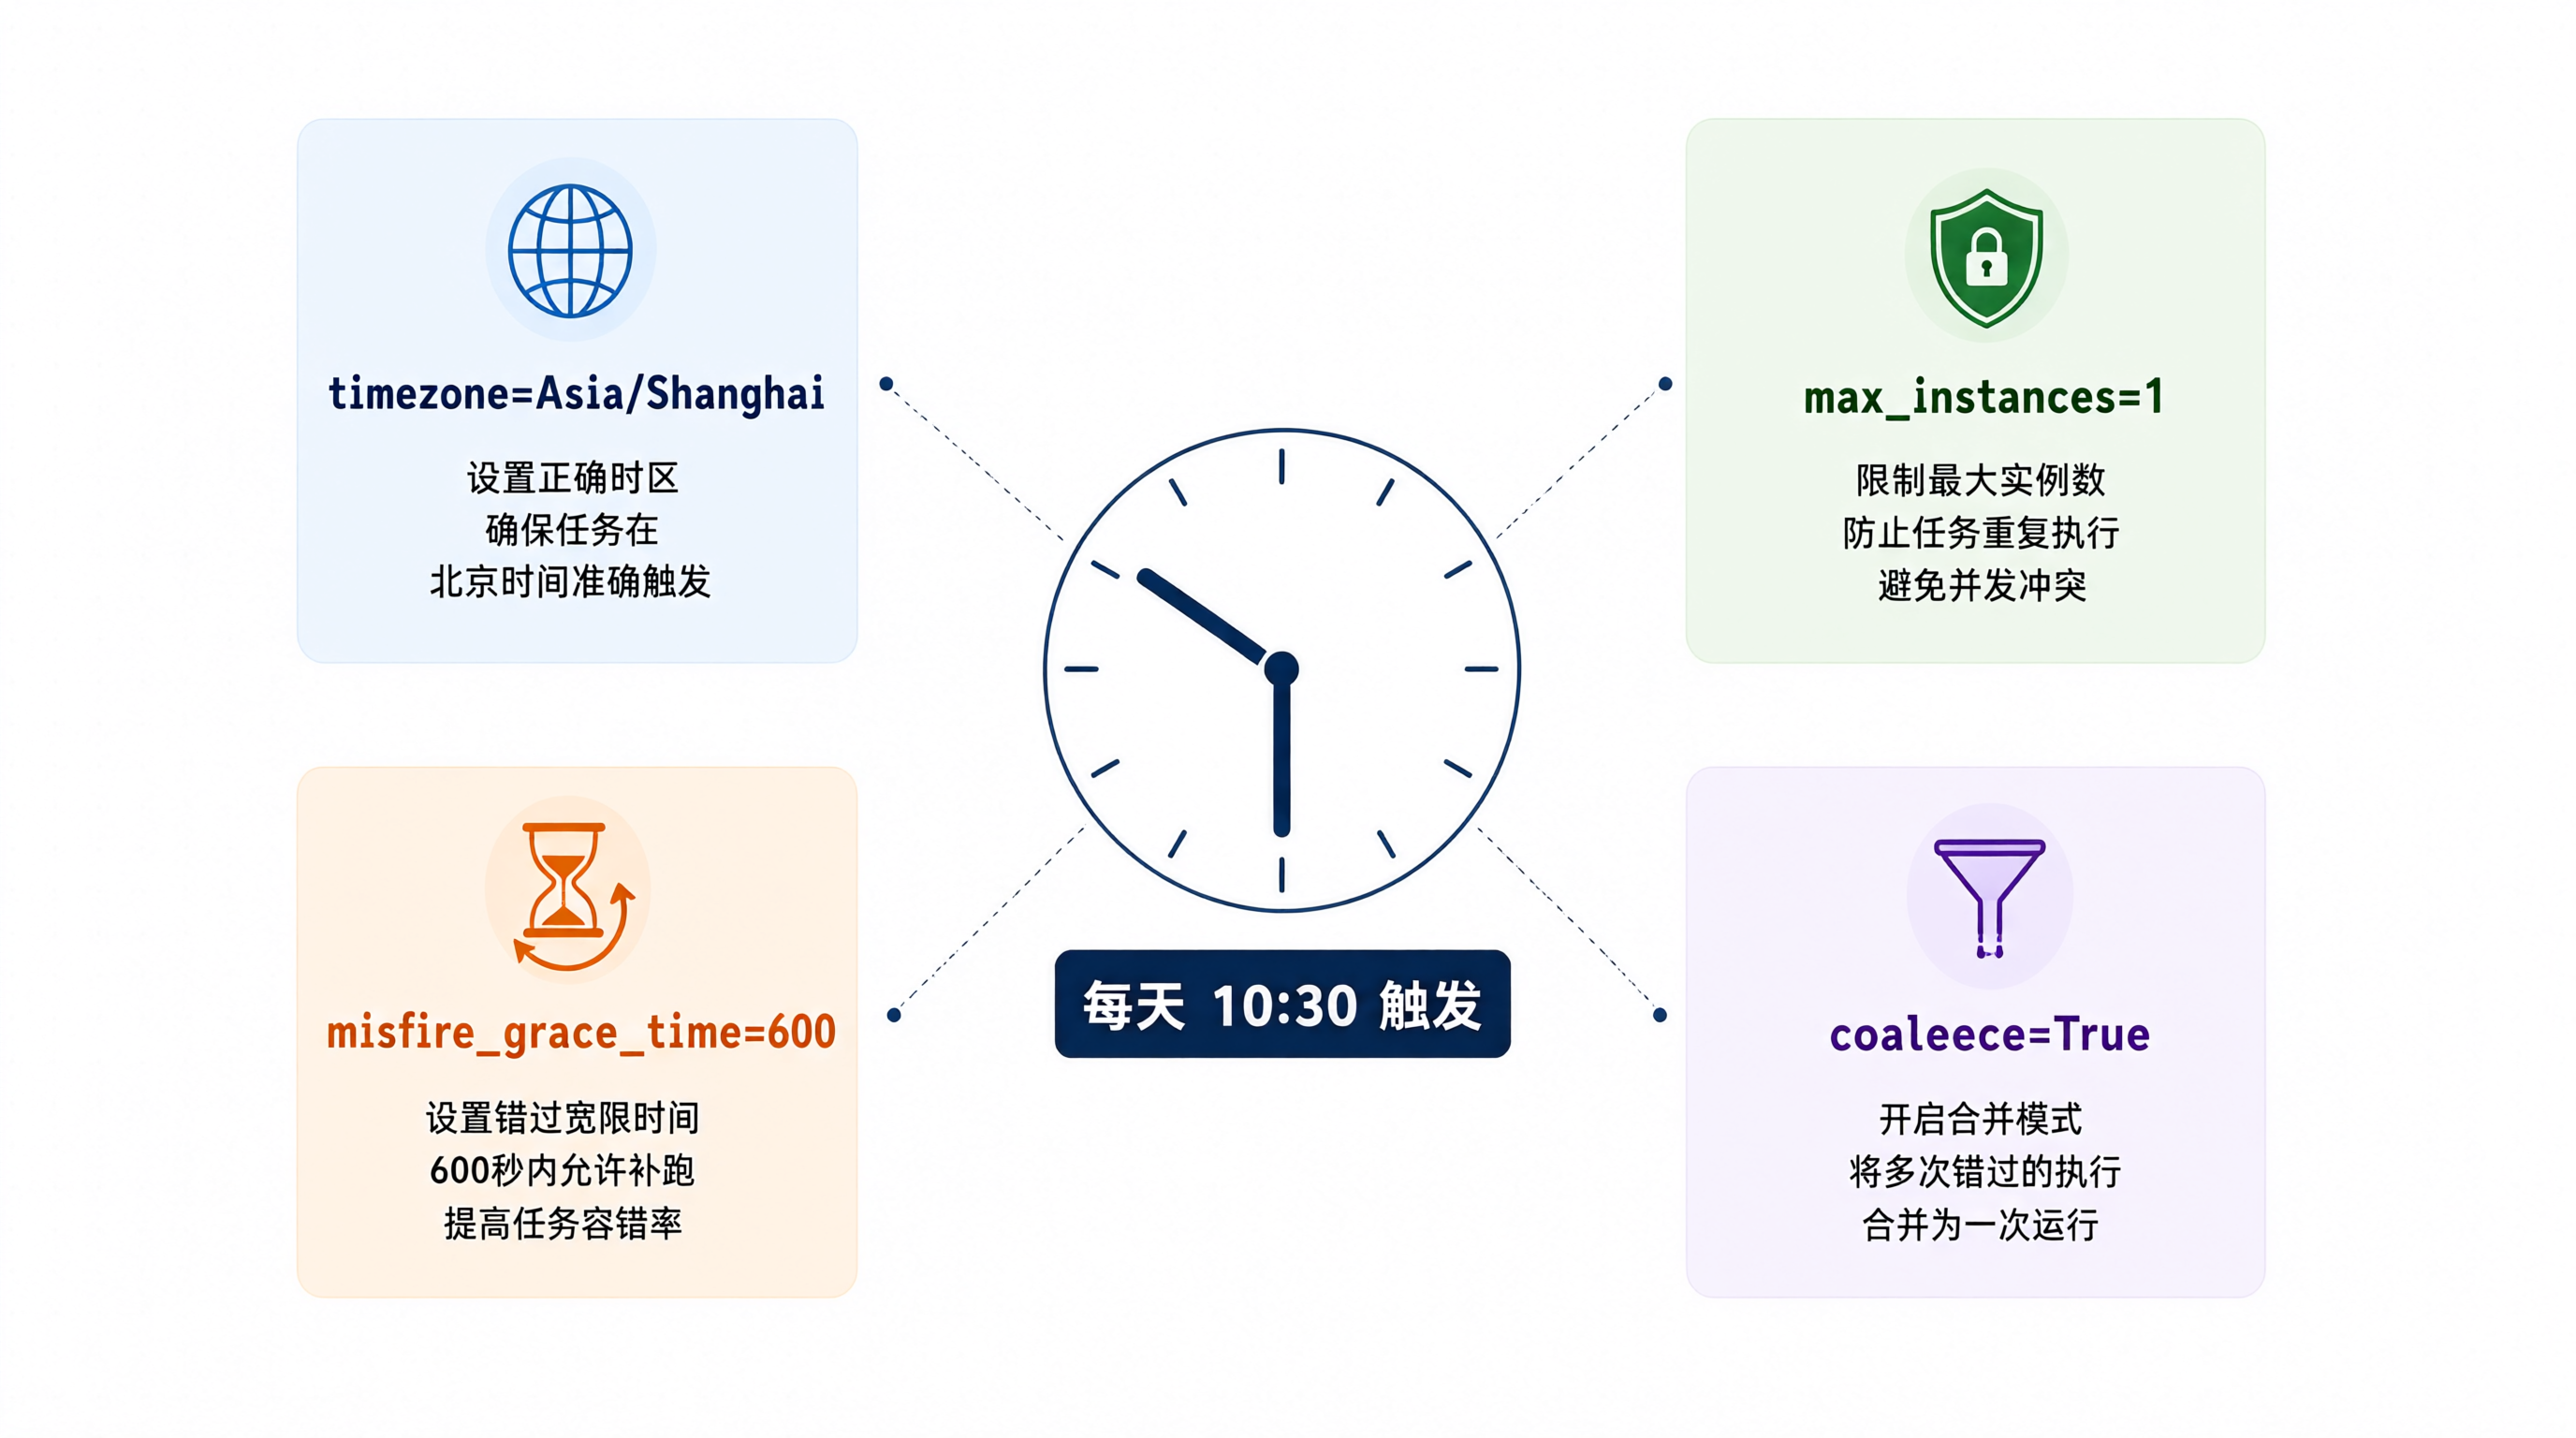
timezone="Asia/Shanghai":容器里默认经常是 UTC,不显式指定,十点半会变成北京时间十八点半,这个我一开始就写错了。max_instances=1:防止上一次任务还没跑完,下一次又被触发,导致重复推送。misfire_grace_time=600:如果进程刚好在十点半那一刻重启,允许 10 分钟内补跑一次。coalesce=True:如果积压了多次触发,合并成一次。
【踩坑提醒】BlockingScheduler 会阻塞当前线程,如果你还要在这个进程里跑 web 服务,得用 BackgroundScheduler。我这里是纯定时任务进程,所以用 blocking 版本就够。
抓取:别一上来就上爬虫框架
内容源我一开始想得很复杂,后来发现大部分 AI 资讯站都有 RSS,直接 feedparser 解析就行,没必要上 Scrapy。
import feedparser
import requests

HEADERS = {
    "User-Agent": "Mozilla/5.0 (compatible; WorkBuddy/1.0)"
}

def fetch_feed(url: str, timeout: int = 15):
    resp = requests.get(url, headers=HEADERS, timeout=timeout)
    resp.raise_for_status()
    parsed = feedparser.parse(resp.content)
    items = []
    for entry in parsed.entries:
        items.append({
            "title": entry.get("title", "").strip(),
            "link": entry.get("link", "").strip(),
            "summary": entry.get("summary", "").strip(),
            "published": entry.get("published", ""),
        })
    return items
这里有几个实际会碰到的点:
第一,直接用 feedparser.parse(url) 让它自己去请求,有时候会因为 UA 被拦,所以我先用 requests 拿内容再交给 feedparser 解析,这样 header、超时、重试都能自己控。
第二,entry.get("summary") 里经常带 HTML 标签,后面喂给模型之前要清洗,否则模型会把它当正文的一部分,摘要里冒出 <p> 之类的东西。
第三,发布时间格式各家不统一,published 字段可能是 RFC822,也可能是 ISO8601。我现在的做法是不在这层做严格解析,而是把原始字符串一起丢给模型,让它自己判断是不是当天的内容——这样省事,但会多消耗一点 token。如果你对成本敏感,可以用 dateutil.parser 统一解析后再过滤。
抓取这一层我加了简单的失败容忍:单个源失败不影响其他源。
def fetch_all(sources):
    results = []
    for name, url in sources.items():
        try:
            items = fetch_feed(url)
            results.extend(items)
        except Exception as e:
            print(f"[warn] {name} 抓取失败: {e}")
    return results
【注意】我没有在代码里做多线程抓取。源的数量如果到几十个,串行会明显变慢,那时候再考虑 concurrent.futures。现在几个源,串行十几秒就跑完了,没必要提前优化。
处理:让模型做"编辑"而不是"翻译"
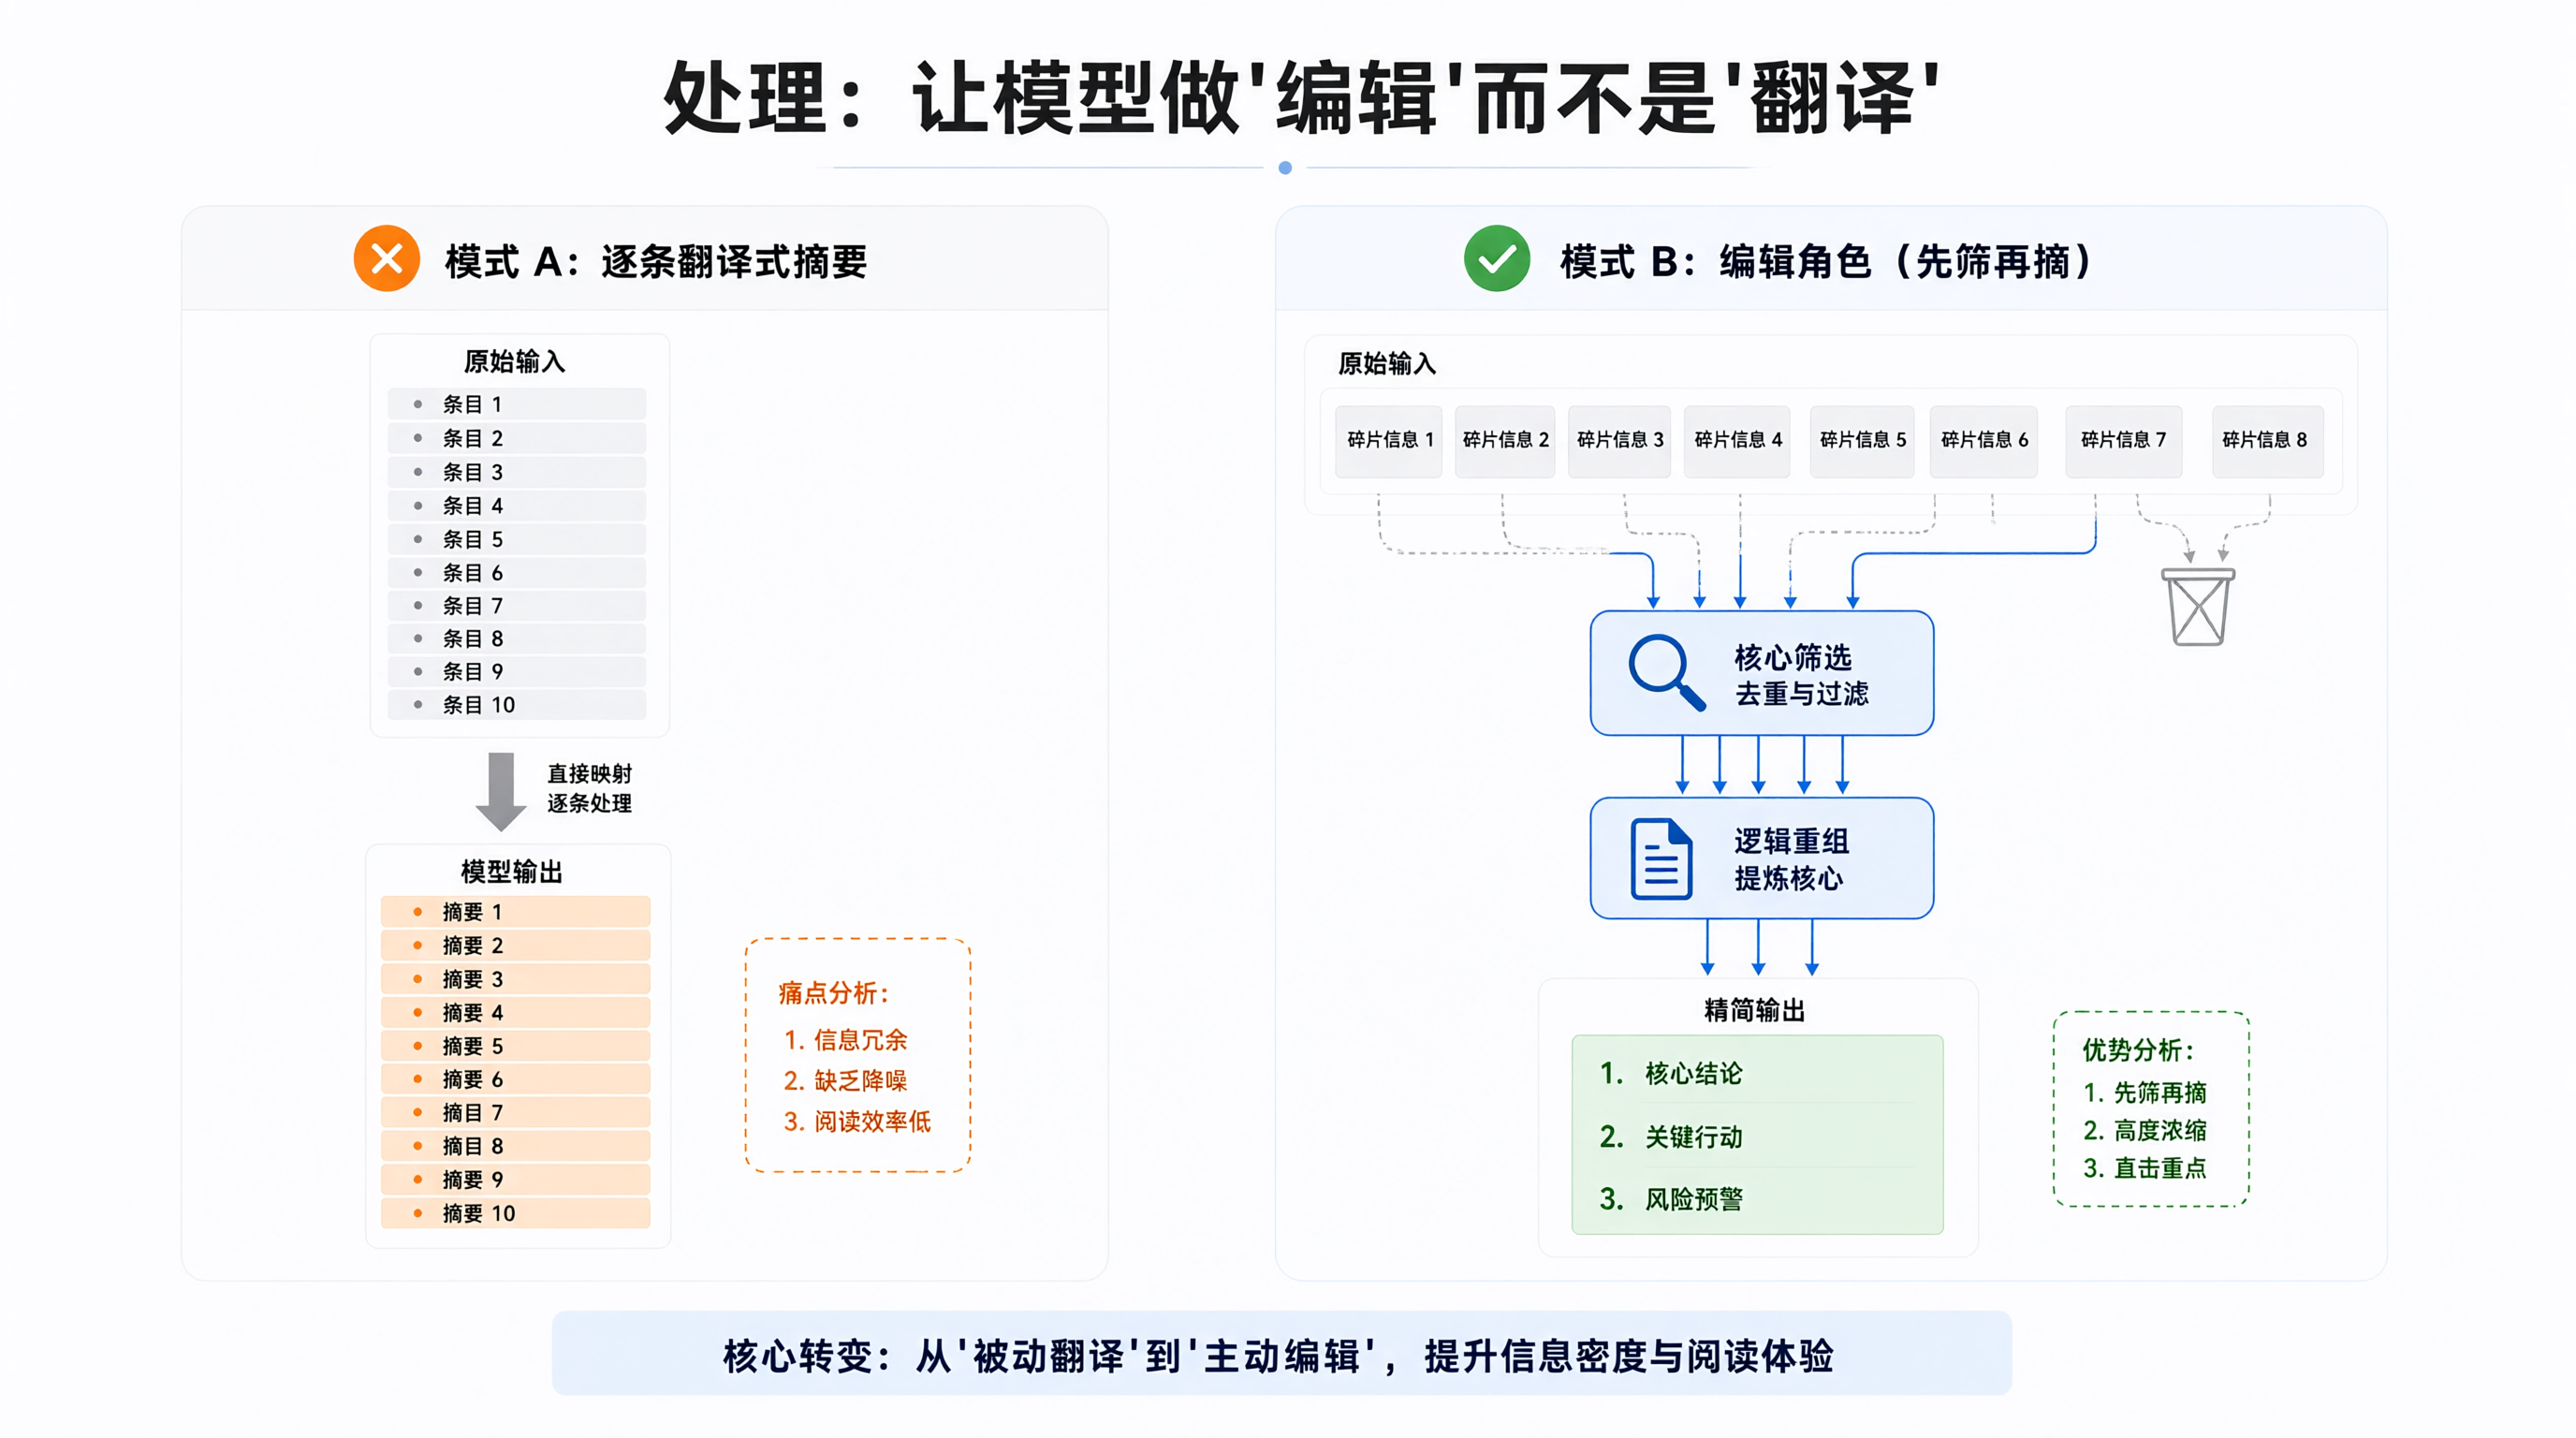
这一步是整个链路里最关键的。我最开始的做法是让模型把每条内容都摘要一遍,结果就是——十条内容给我十条摘要,跟没筛一样。后来改成让模型扮演"编辑"角色,先筛再摘。
提示词大致是这样组织的(这里给的是结构,不是逐字模板,你可以按自己需求调整):
SYSTEM_PROMPT = """你是一个 AI 领域的技术编辑。
你的任务是从用户提供的原始资讯列表中,筛选出真正值得关注的内容,并生成一份简报。

要求:
1. 优先保留:新模型发布、重要论文、有实质内容的工程实践、有影响力的行业事件。
2. 过滤掉:纯营销稿、标题党、重复内容、没有信息增量的转发。
3. 最多保留 8 条,宁缺毋滥。
4. 每条输出:一句话标题 + 2~3 句说明 + 原文链接。
5. 如果某条信息你不确定真伪,标注"待核实"。
6. 直接输出 Markdown,不要额外解释。"""
调用部分:
from openai import OpenAI

client = OpenAI(api_key="YOUR_KEY", base_url="YOUR_BASE_URL")

def build_report(raw_items):
    # 把原始条目拼成给模型的输入
    payload = "\n\n".join(
        f"标题: {it['title']}\n链接: {it['link']}\n摘要: {clean_html(it['summary'])}"
        for it in raw_items
    )
    resp = client.chat.completions.create(
        model="YOUR_MODEL_NAME",
        messages=[
            {"role": "system", "content": SYSTEM_PROMPT},
            {"role": "user", "content": payload},
        ],
        temperature=0.3,
    )
    return resp.choices[0].message.content
几点说明:
model具体填什么取决于你用的服务,我不在这里写死,避免版本对不上。temperature=0.3是我自己的偏好,日报这种偏事实性的内容,低温度更稳。这不是硬性要求。- 输入长度要控制。如果一天抓下来几百条,直接全塞进去会超上下文。我现在的做法是在喂给模型之前,先按来源和时间做一轮粗筛,只保留当天的条目。
【关键结论】这一步的产出质量,八成取决于提示词里"筛选标准"写得够不够具体。"帮我总结一下"这种指令,模型只能给你一份平庸的汇总。"优先保留 X,过滤掉 Y,最多 N 条"这种约束,效果差别很大。
推送:企业微信 Webhook 的几个细节
企业微信群机器人的 Webhook 调用很简单,一个 POST 就完事:
import requests

def push_to_wecom(webhook_url: str, markdown_text: str):
    body = {
        "msgtype": "markdown",
        "markdown": {"content": markdown_text}
    }
    resp = requests.post(webhook_url, json=body, timeout=10)
    data = resp.json()
    if data.get("errcode") != 0:
        raise RuntimeError(f"推送失败: {data}")
    return True
实际用的时候有几个点要注意:
- Markdown 语法是企业微信自己的一套,不是标准 Markdown。比如它支持
<font color="info">这种标签,但表格支持有限,标题层级也跟标准语法不完全一样。我一开始按标准 Markdown 排版,推过去显示是乱的,后来改成以列表为主,简单很多。 - 消息长度有限制,具体上限以官方文档为准,我没有去逐字核对。我的日报控制在 8 条以内,一般不会触发限制。如果你要推很长的内容,得做分片。
- Webhook URL 是敏感信息,里面有 key,别硬编码在代码里,也别提交到 Git。我用环境变量读。
import os

WECOM_WEBHOOK = os.environ["WECOM_WEBHOOK"]
把整条链路串起来
主任务函数就是把上面几块拼起来:
def daily_job():
    print("[info] 开始生成 AI 日报")
    sources = {
        "source_a": "https://example.com/feed",
        # 其他源
    }
    raw_items = fetch_all(sources)
    if not raw_items:
        print("[warn] 没抓到任何内容,跳过本次推送")
        return

    report = build_report(raw_items)
    header = "## WorkBuddy AI 日报\n"
    push_to_wecom(WECOM_WEBHOOK, header + report)
    print("[info] 推送完成")


if __name__ == "__main__":
    scheduler = build_scheduler(daily_job)
    scheduler.start()
注意那个 if not raw_items 的判断。如果没有内容还照推,用户收到一条空日报,体验很差。宁可跳过。
让它真正"每天"跑起来
代码跑通只是第一步,真正的难点是让它连续跑一周、一个月不出问题。我实际处理过的几个问题:
进程挂了没人知道。 我用 systemd 把它托管起来,配 Restart=always,挂了自动拉起。这是最省事的做法。
[Unit]
Description=WorkBuddy AI Daily Report
After=network.target

[Service]
ExecStart=/usr/bin/python3 /opt/workbuddy/main.py
Restart=always
RestartSec=10
Environment=WECOM_WEBHOOK=xxxxx

[Install]
WantedBy=multi-user.target
时区问题。 前面提过,容器和服务器默认时区经常是 UTC,一定要在 CronTrigger 里显式指定 Asia/Shanghai,或者把系统时区改掉。我两种都做了,双保险。
模型调用失败。 大模型接口偶尔会超时或返回错误,代码里要包一层异常,失败时记录日志,不要整个任务崩掉。是否要重试,看你自己的容忍度——我现在的做法是失败就跳过本次推送,不发半成品。
重复推送。 有一次进程重启后,misfire_grace_time 触发了补跑,加上原本的定时,一天推了两次。后来我把 max_instances=1 和 coalesce=True 都加上了,同时在外面加了个简单的"今日已推送"标记文件做兜底。
一些我没验证但需要提醒的地方
有几件事我明确说清楚,避免误导:
- 个人微信推送:我没有用任何个人微信机器人方案,也不建议用。本文推送部分只涉及企业微信 Webhook。
- 具体模型的上下文长度、价格、限流规则:这些变化很快,我没有在这里写死数值,你需要以自己所用服务的当前文档为准。
- RSS 源的稳定性:不同站点对爬取频率和 UA 的策略不一样,我没有做统一的限流和重试策略,如果你的源比较多,这块要自己补。
- 内容准确性:模型摘要可能出错,尤其是涉及具体数字、版本号的时候。我在提示词里加了"不确定就标注待核实",但这只能降低概率,不能消除。日报定位是"快速浏览线索",不是"权威信息源",重要的东西还是要回原文。
写在最后
这套东西搭下来,代码量其实不大,真正花时间的是调提示词和调排版——怎么让模型筛得准、怎么让企业微信里显示得不难看。技术上没什么门槛,难的是把它当成一个每天都要交付的小产品去对待:失败要有日志,空结果要跳过,重复要防住。
如果你也想给自己搭一个类似的日报机器人,我的建议是先跑通最小闭环:一个源、一次调用、一条推送,确认整条链路通了,再加源、加筛选、加排版。反过来做,很容易卡在细节里出不来。
=备用标题=
- 每天十点半自动收到 AI 日报:我用 Python 搭了一套定时推送服务
- 从抓取到大模型筛选再到微信推送:一个 AI 日报机器人的完整实现
- 用 APScheduler + 大模型 + 企业微信 Webhook 做一份自动 AI 日报
- 不想再手动刷 AI 资讯了,我写了个每天定时推送的日报机器人
- WorkBuddy 实践:把 AI 资讯抓取、筛选、推送串成一条自动链路

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 2
 0
- 0


 已为社区贡献2条内容

所有评论(0)