智能体如何在一个未知的多层楼里连续找完三样东西:LifelongCrossNav 的持久 3D 语义记忆
0. 简介
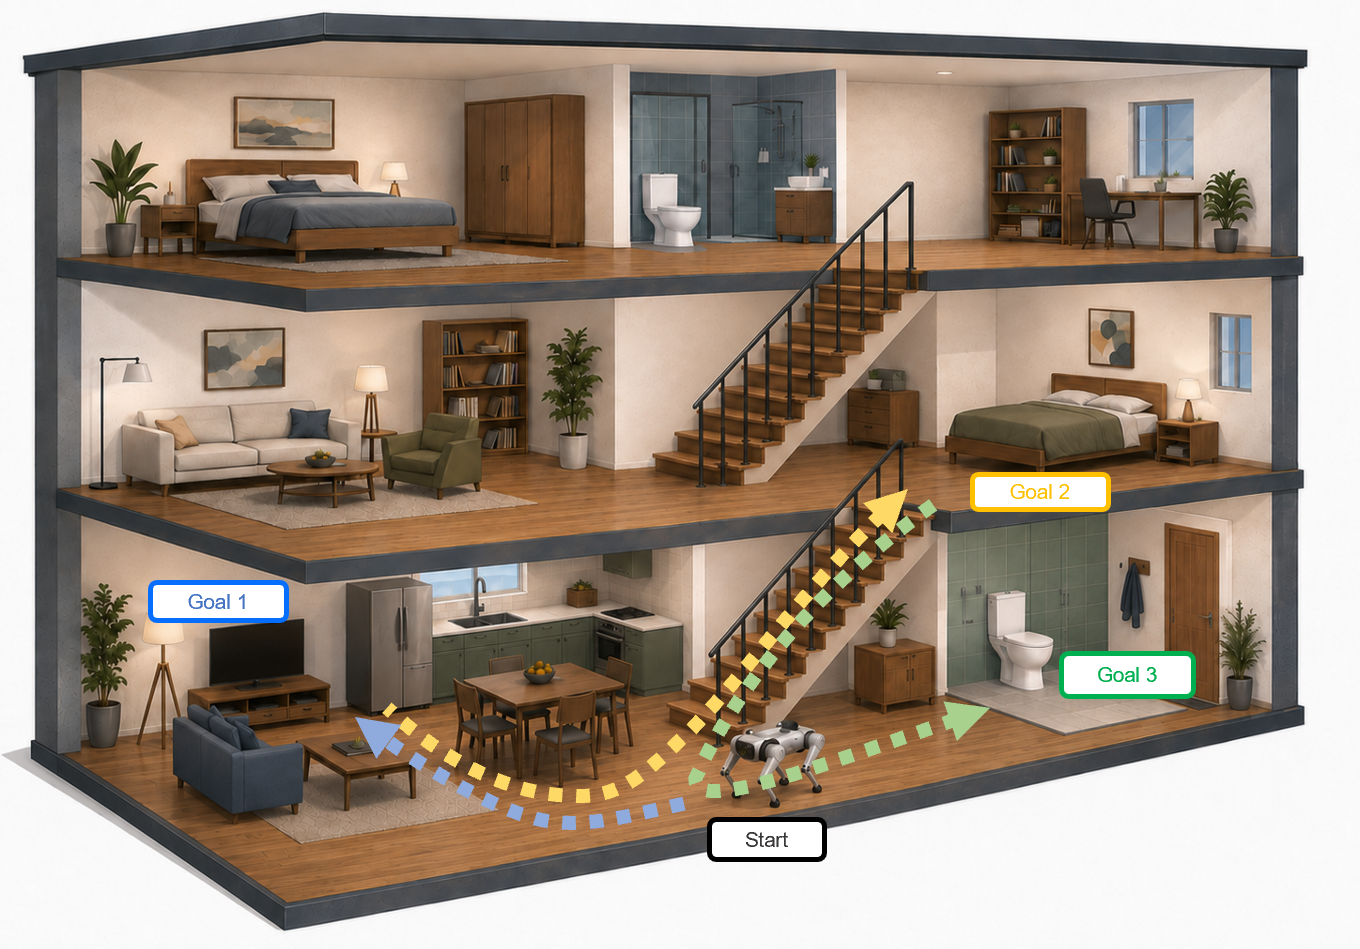
一个家用机器人接到一条连续指令:先去客厅找电视,找到之后再去卧室找床,最后再去卫生间找马桶。这三样东西很可能分布在一栋两层甚至三层的住宅里,而机器人对这个房子从未做过探测,也不知道楼梯在哪。这就是 LifelongCrossNav 要解决的任务——未知多楼层室内环境里的序列式多物体目标导航。现有研究几乎总是把"跨楼层通行"和"持久记忆"分开做:跨楼层方法(ASCENT、MFNP、TravExplorer)能建模楼梯,但一次只找一个物体,找完就清空记忆;多物体方法(MultiON、OneMap)能跨多个目标复用地图,却普遍用平面鸟瞰表示,会垂直折叠重叠的房间和楼梯平台。LifelongCrossNav 用一套支撑感知的稀疏 3D 体素地图同时承接几何结构、可通行状态和与目标无关的视觉语言特征,再配合一套统一导航策略在探索、楼梯通行、历史兴趣点检索之间切换,并用事后分阶段评测协议在一个新基准 HM3D-MFMON 上验证。全文重点拆解三件事:体素地图如何区分楼层、语义记忆如何跨目标复用、跨楼层任务该如何公平度量。相关代码可以在Github上拿到。
1. 研究问题与现有方法的具体缺口
1.1 Open-set 目标导航跳过了"楼层"这个维度
目标导向导航(ObjectGoal Navigation,ObjectNav)的标准设定是:智能体在陌生环境里移动,走到某个指定物体类别的一个实例面前停止。近几年的进展集中在开放词汇感知、语义建图和前沿探索上,让智能体在未见过场景里找到目标的能力明显提升。但绝大多数工作默认环境是平面或单层的,智能体只需要在同一块水平地面上移动。真实建筑不是这样的——垂直方向上房间会重叠,走廊、平台、楼梯穿插其中,同一个建筑可能有两三层。真正落地的服务机器人,其任务往往不是"找一样东西",而是"在一个循环里连续找好几样东西",并且可能要上下楼。
1.2 两条技术线互不相通,是当前的结构性矛盾
这里值得注意,现有工作把这两个能力拆成了两套互相独立的系统。第一类是多物体导航:MultiON 提出序列式多目标任务,智能体每完成一个目标才收到下一个目标,OneMap 用持久化的开放词汇二维语义地图跨目标复用。它们的优点是记忆可以延续,但用的是平面鸟瞰图。平面投影会丢失高度信息,垂直重叠的空间在图上被折叠成同一片区域;楼梯、斜坡、楼层跳转在二维语义图上根本没有位置。第二类是跨楼层导航:ASCENT、MFNP、TravExplorer 显式建模楼梯、楼层跳转或楼层推理,能把智能体从一层带到另一层,但它们通常一次只考察一个物体目标,任务结束后环境记忆就被清空。换句话说,一个方法要么能上下楼但记不住,要么记得住但跨不了层——这两条需求在现有方法里从未统一进同一套闭环。
1.3 平面表示对"必须跨层"的任务是硬伤
更深一层的问题在于平面语义地图本身的表达能力。当任务目标都落在同一层时,二维地图勉强够用;一旦序列里某个目标要求换层,平面表示就拿不出可执行的解。OneMap 这类方法在纯平面任务上有不错的表现,但在需要楼梯连接的任务上,它的图里没有"楼梯"这个状态,也就无法规划出一条能真正跨层的路径。LifelongCrossNav 的核心判断是:一个统一方案必须同时提供两样东西——垂直可通行性(能建模并提出楼梯)与持久可查询的语义记忆(跨目标保留视觉观察),而不是在两者之间选一。这也决定了整套系统的设计取向:几何与语义共用同一套稀疏 3D 体素坐标,让一次探测产出的结构信息在后续目标里复用。
2. 整体框架:几何与语义共用一套稀疏 3D 坐标
2.1 任务定义与输入输出接口
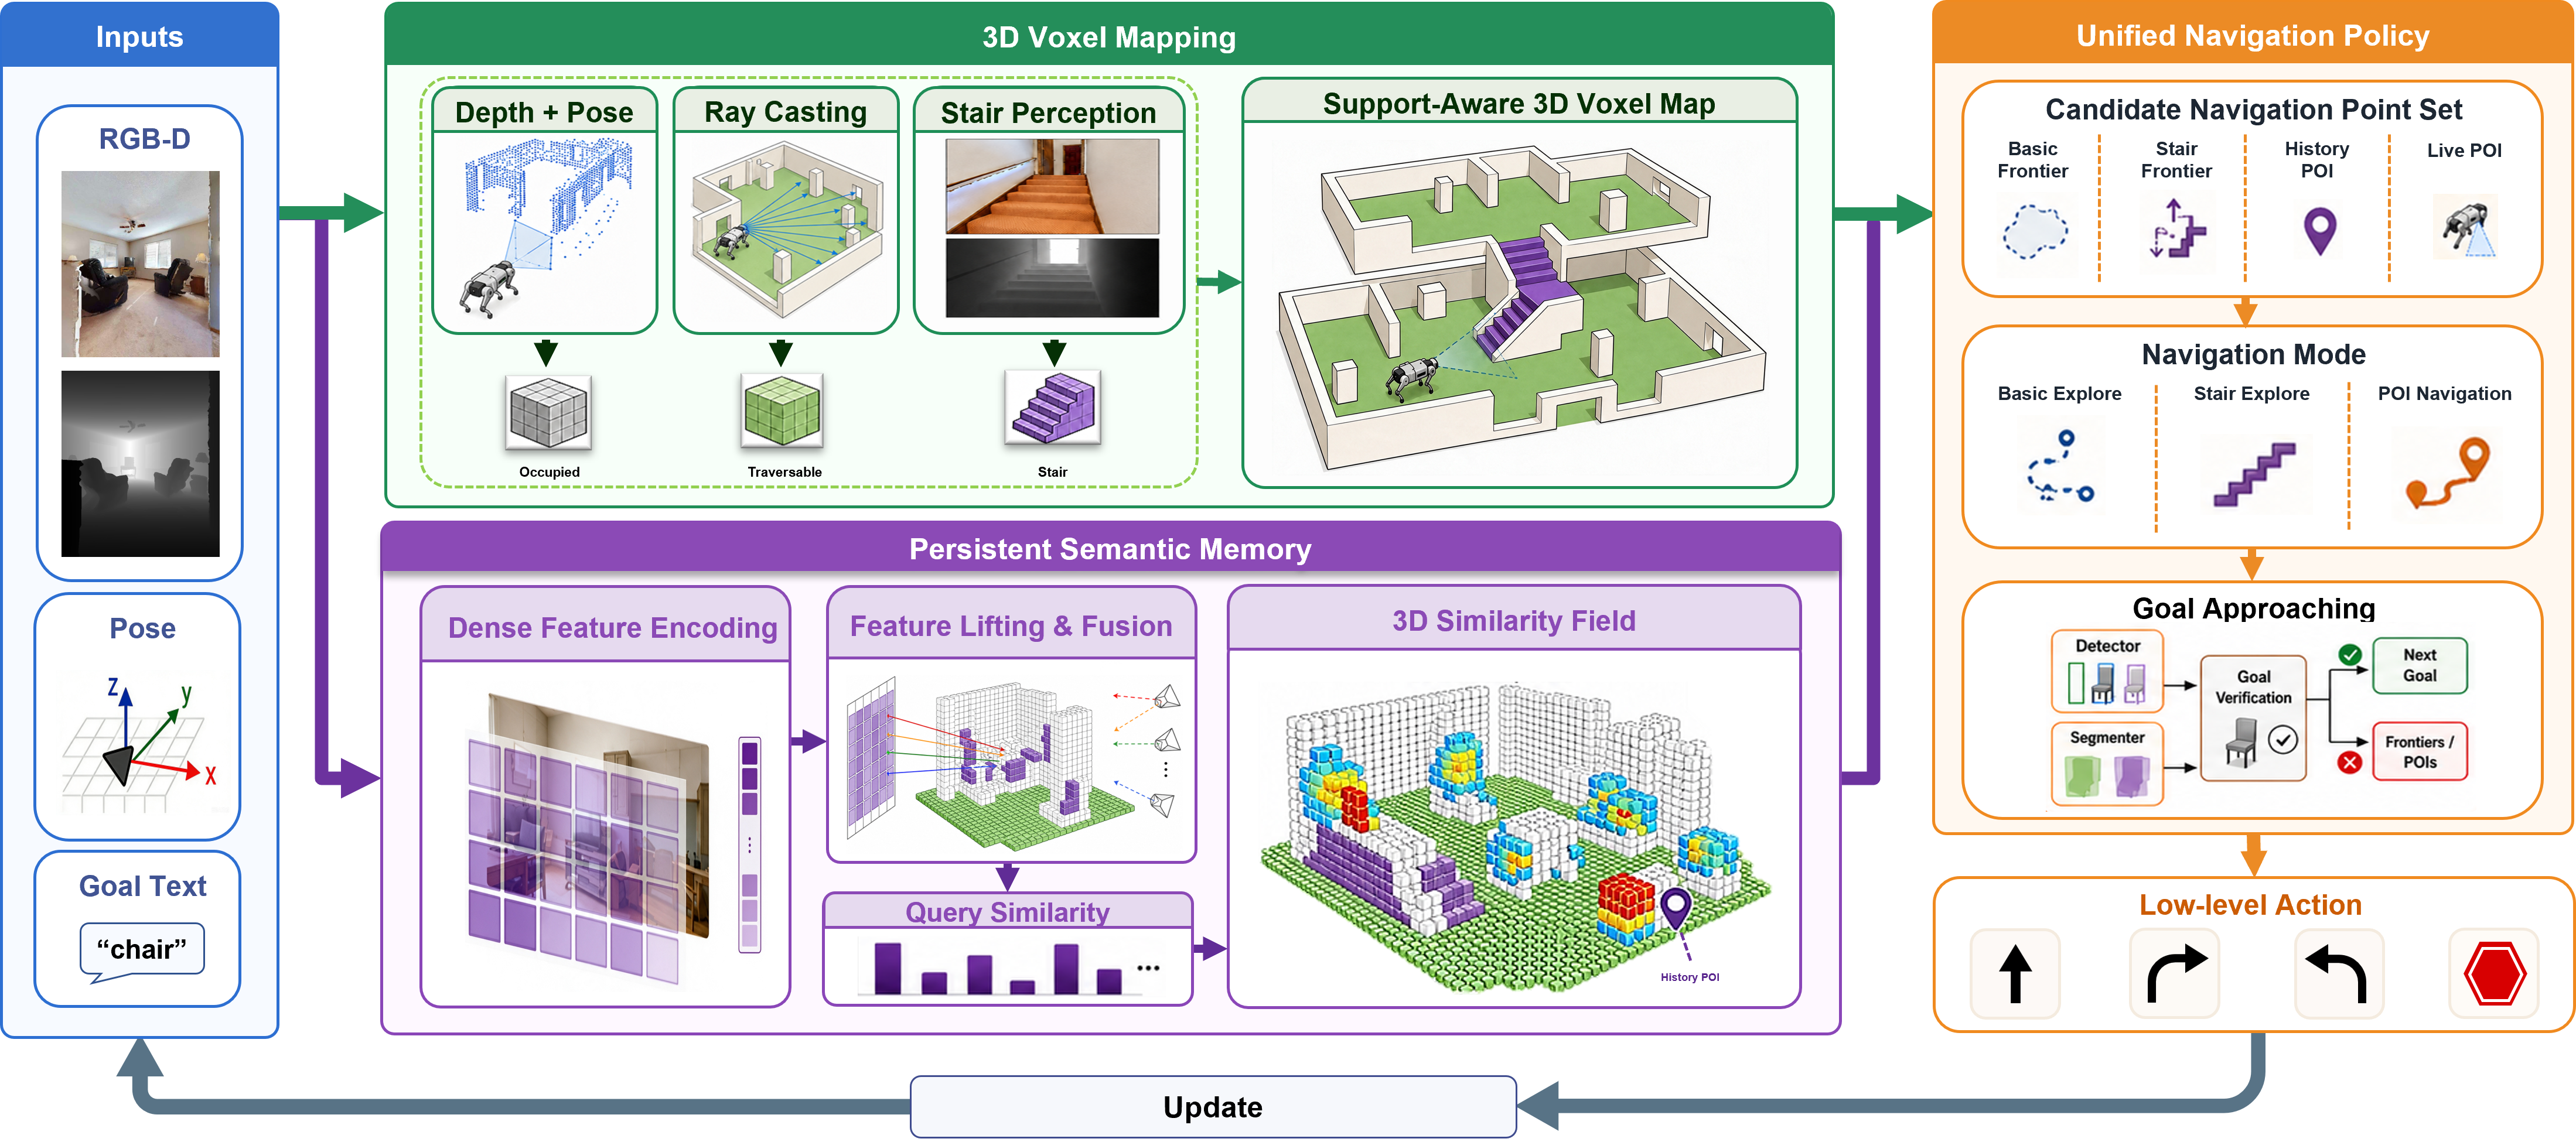
每个 episode 由一个有序的目标序列组成,记作 ( g 1 , g 2 , … , g K ) (g_1, g_2, \dots, g_K) (g1,g2,…,gK)。智能体在任意时刻只收到当前目标 g k g_k gk,只有当前子任务成功完成后,下一个目标 g k + 1 g_{k+1} gk+1 才会被揭示并激活。这构成"终身"(lifelong)设定:环境、已建地图、已存记忆在连续的多个子任务之间持续存在,而不是每个目标都推倒重来。在每个时间步 t t t,智能体拿到一张以自我为中心的 RGB 观测 I t I_t It、深度观测 D t D_t Dt、6 自由度相机位姿 T t T_t Tt 以及当前目标 g k g_k gk。离散动作空间包含 MoveForward、TurnLeft、TurnRight、LookUp、LookDown 和 Stop。MoveForward 让智能体前进 0.25 0.25 0.25 m,转向与俯仰动作每次改变 30 ∘ 30^\circ 30∘。某个子任务成功,是指智能体在到达某个有效目标实例的成功半径内发出 Stop。
这套设定有一个关键不对称:几何地图、楼梯状态、目标无关的视觉语言特征在整个 episode 内持续保留,而一旦目标切换,与旧目标绑定的部分被重建。具体来说,当新目标被激活,系统重算目标的文本嵌入与查询条件相似度场,同时把此前目标关联的兴趣点 POI、导航路径、目标校验状态全部重新初始化。几何与语义记忆不随目标切换清空,这是与单物体跨楼层方法最本质的差异。
2.2 双分支闭环:几何分支 + 语义分支 + 统一策略
系统的总体结构可以概括为三个部分。几何分支从 RGB-D 观测、位姿与当前目标出发,结合支撑感知的射线投射,构建多楼层可通行性地图,并通过语义几何楼梯证据在楼层之间建立连接。语义分支把与目标无关的视觉语言特征提升并融合到 3D 表面体素,形成跨目标持久的语义记忆。统一导航策略则从基本前沿、楼梯前沿、历史兴趣点与实时兴趣点中挑选导航目标,并在基本探索、楼梯探索、兴趣点导航与最终目标逼近之间做模式感知的 3D 规划。当前目标完成之后,累积的环境记忆被保留,下一个目标被激活,进入下一轮导航。
3. 第一条核心机制:支撑感知的稀疏 3D 体素地图
3.1 为什么不用平面投影,而用体素
平面鸟瞰图把整个环境压成一个二维网格,代价是失去高度。一个房间里可能叠着另一个房间,走廊上可能是另一个平台,楼梯口在平面上与普通地面没有区别。体素表示则保留高度,能区分垂直重叠的房间、走廊、平台与楼梯。问题在于体素通常比二维网格贵很多,而且多数房间的大部分体积其实是空气,不需要记录。LifelongCrossNav 的做法是用稀疏 3D 体素,只为被观测到的体素和局部推断出的可通行状态分配存储,让地图随探索增量增长,而不是一次性分配一个稠密的三维网格。
3.2 七类体素状态与支撑分类
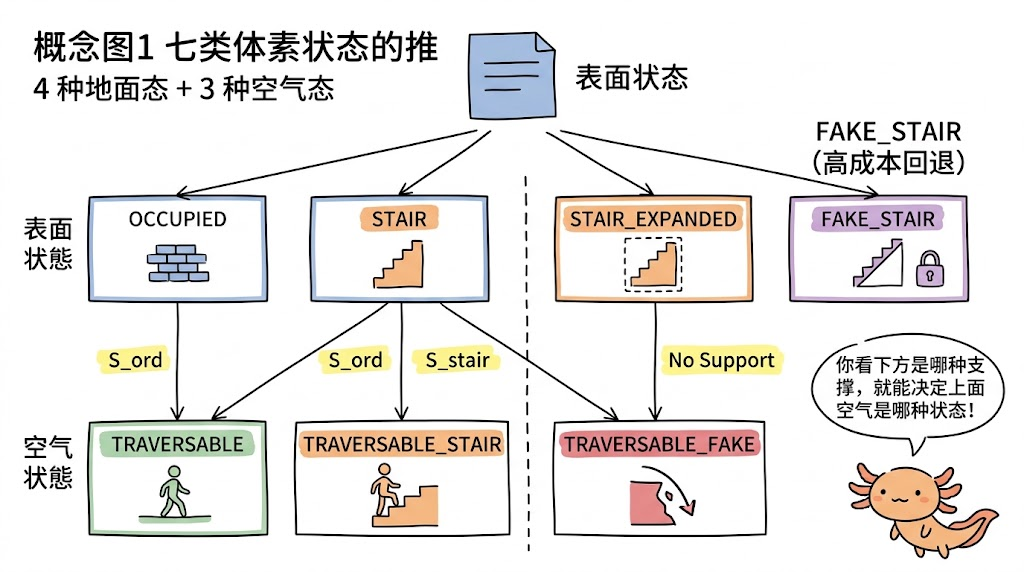
稀疏地图维护七种操作态体素。这里要厘清的是这七类不是随意命名,每一种都承载不同的几何含义与规划角色。OCCUPIED 表示被有效 RGB-D 深度返回产生的表面体素,代表墙壁、家具、普通地板等观测到的几何,可能携带语义特征,不可通行、不可设为目标。TRAVERSABLE 是射线观测到的自由空间体素,其向下 0.4 0.4 0.4 m 内找到的第一个有效支撑是 OCCUPIED 或可逆的 FAKE_STAIR,是同一层导航的主力状态。TRAVERSABLE_STAIR 则是自由空间体素,其第一支撑是 STAIR 或 STAIR_EXPANDED。TRAVERSABLE_FAKE 是射线观测到但支撑搜索深度内找不到任何有效支撑的自由空间,标记无支撑空气、落差或楼梯空洞,不可通行。STAIR 是经过语义与三维几何校验后被接受为楼梯几何的表面体素。STAIR_EXPANDED 是被并入已确认楼梯组件的相邻 OCCUPIED 体素,用于改善稀疏几何连续性。FAKE_STAIR 是被拒绝或可逆的楼梯证据,作为高成本临时连接与可逆支撑状态保留,而不是即时丢弃。
支撑分类的判定可以用数学描述。设 s ( v ) s(v) s(v) 表示体素 v v v 向下搜索找到的第一个有效支撑类型,定义普通支撑集合与楼梯支撑集合分别为 S o r d = { OCCUPIED , FAKE_STAIR } S_{\mathrm{ord}}=\{\texttt{OCCUPIED},\texttt{FAKE\_STAIR}\} Sord={OCCUPIED,FAKE_STAIR}、 S s t a i r = { STAIR , STAIR_EXPANDED } S_{\mathrm{stair}}=\{\texttt{STAIR},\texttt{STAIR\_EXPANDED}\} Sstair={STAIR,STAIR_EXPANDED},这两个集合代表"能作为普通地面支撑的"和"能作为楼梯支撑的"两类状态,是判定空气体素能不能走、以及按什么方式走的关键。派生的空气态由下式决定:
τ a i r ( v ) = { TRAVERSABLE , s ( v ) ∈ S o r d , TRAVERSABLE_STAIR , s ( v ) ∈ S s t a i r , TRAVERSABLE_FAKE , s ( v ) = ∅ . \tau_{\mathrm{air}}(v)=\begin{cases}\texttt{TRAVERSABLE}, & s(v)\in S_{\mathrm{ord}},\\ \texttt{TRAVERSABLE\_STAIR}, & s(v)\in S_{\mathrm{stair}},\\ \texttt{TRAVERSABLE\_FAKE}, & s(v)=\varnothing.\end{cases} τair(v)=⎩ ⎨ ⎧TRAVERSABLE,TRAVERSABLE_STAIR,TRAVERSABLE_FAKE,s(v)∈Sord,s(v)∈Sstair,s(v)=∅.
直观理解是:智能体站在一块地面上,下方是否有可支撑的实体,决定了这块空域能不能走;而下方的支撑是普通地板还是楼梯,决定了走的时候是普通通行还是楼梯上通行。TRAVERSABLE_FAKE 是"悬空的空气",它和 FAKE_STAIR(一种可逆的表面态)不是一回事,后者是表面状态,前者是空气状态,两者不可混淆。这七种状态彼此之间的派生关系,用一张状态转换图比一大段文字清楚得多:
下面这段代码按论文方法重建,展示支撑分类的核心判定逻辑。它把"下方支撑类型"这一输入直接翻译成"空气体素状态"这一输出,是整个 3D 地图把普通地面、楼梯上方、悬空空域三件事区分开的核心一步。这段逻辑虽短,却决定了地图上哪些格能规划、哪些格是障碍、哪些格是跨层通道,也决定了这套系统与平面语义地图最本质的差别所在:
# mapping/voxel_map.py
class VoxelType(Enum):
    OCCUPIED          = 1   # 深度点云障碍物,携带CLIP特征
    TRAVERSABLE       = 2   # 地板可通行:下方有OCCUPIED支撑
    TRAVERSABLE_STAIR = 3   # 楼梯可通行:下方有STAIR/STAIR_EXPANDED支撑
    TRAVERSABLE_FAKE  = 4   # 无支撑悬空:标记落差,不可通行
    STAIR             = 5   # SAM确认的楼梯体素
    STAIR_EXPANDED    = 6   # 楼梯邻域扩展体素
    FAKE_STAIR        = 7   # 楼梯误检体素:A*可经过,但不可作为目标/前沿

# 支撑提供者:下方支撑类型决定空气态
SUPPORT_FLOOR = frozenset({VoxelType.OCCUPIED, VoxelType.FAKE_STAIR})
SUPPORT_STAIR = frozenset({VoxelType.STAIR, VoxelType.STAIR_EXPANDED})

# mapping/voxel_map.py  _validate_traversability 中的支撑分类核心
for dz in range(1, self.support_check_depth + 1):        # 向下搜 0.4 m
    below = (vid[0], vid[1], vid[2] - dz)
    below_vd = self.voxels.get(below)
    if below_vd is None:
        continue
    if below_vd.voxel_type in SUPPORT_FLOOR:             # OCCUPIED/FAKE_STAIR
        proposed = VoxelType.TRAVERSABLE
        break
    if below_vd.voxel_type in SUPPORT_STAIR:             # STAIR/STAIR_EXPANDED
        proposed = VoxelType.TRAVERSABLE_STAIR
        break
# 无可支撑 → 默认 TRAVERSABLE_FAKE(悬空,不可通行)
这段代码做的是把"下方有什么支撑"翻译成"上面能不能走"。这一层之所以重要,是因为它让同一个体素地图既承接平面导航,又承接楼梯导航:普通地面走 TRAVERSABLE,楼梯上方走 TRAVERSABLE_STAIR,落差与楼梯空洞被显式标记为 TRAVERSABLE_FAKE 而不被误当成可走区域。工程细节上,支撑搜索深度是 0.4 0.4 0.4 m,这个值决定了"多近的下方有个实体算作支撑",太大会把楼下的地板错误当成楼上地板,太小会把普通地面误判成悬空。
3.3 楼梯的延迟校验与状态晋升
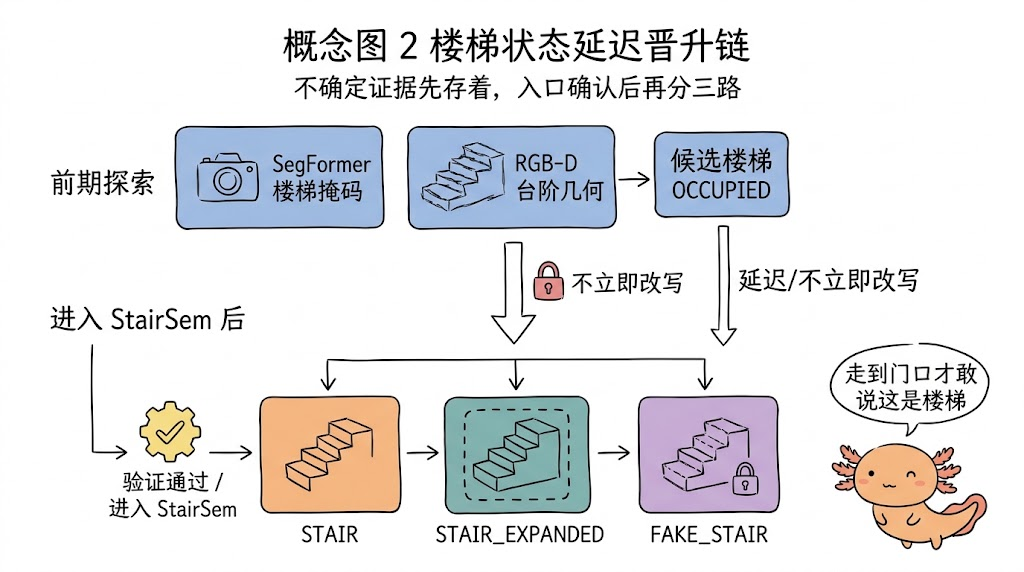
楼梯是整个系统里最容易出错的环节。核心问题在于,普通探索阶段 SegFormer 分割出的楼梯掩码与 RGB-D 几何可能产生上行或下行证据,但这些证据并不一定可靠——远处看一眼"像楼梯"的地方可能只是家具堆。因此系统不在发现证据时就把 OCCUPIED 体素改写为已确认楼梯。只有当智能体走到对应楼梯入口并验证通过、控制器进入楼梯探索(StairSem 模式)之后,才做延迟晋升:被接受的表面体素晋升为 STAIR,相邻被占用格可能成为 STAIR_EXPANDED,被拒绝的证据保留为 FAKE_STAIR,然后局部重分类依赖支撑的空气体素。这种延迟晋升能防止普通探索阶段收集到的不确定楼梯观测直接改变跨楼层规划图。用论文的话说,候选楼梯先被标记,只有在智能体实际到达楼梯入口、进入楼梯探索模式之后,候选体素才被正式标记为可通行楼梯。
工程价值:这一招本质是"先怀疑、后确认"。楼梯不像普通地面那样一眼就能确认,提前把不确定的楼梯写成可通行,会让规划器在错误的走廊里策划一条跨层路径;延迟到入口处再晋升,等于把"这到底是不是楼梯"的判定留给近距离、多帧一致的证据,而不是远距离的像素分割。这条"候选 → 入口确认 → 三类分支"的晋升路径值得单独画清楚:
4. 第二条核心机制:跨目标持久的 3D 语义记忆
4.1 为什么需要"目标无关"的语义特征
持久记忆的难点在于:下一个目标在当下是未知的,所以不能只存"当前目标相关的特征"。LifelongCrossNav 的做法是让语义分支存储与目标无关的视觉语言特征,存进和几何地图同一套稀疏 3D 坐标里,等目标切换时再按需查询。这带来一个直接好处:完成当前目标后,已经积累的视觉观察不会丢失;换到下一个目标时,只需要对存好的特征做一次查询,就能得到"我之前在哪个区域见过类似语义"的线索,而不需要重新把整个房子再扫一遍。
4.2 稠密特征编码、特征提升与多视角累积融合
语义分支采用 SED 的稠密视觉语言编码。给定当前 RGB 观测,编码器产生一个 24 × 24 × 768 24\times 24\times 768 24×24×768 的空间特征图,对齐到 CLIP 文本嵌入空间。这个特征图被双线性上采样到深度分辨率,于是每个有效深度像素都能关联一个局部上下文视觉特征。像素特征被提升到对应深度射线所到达的 3D 表面体素上,且只赋给被观测到的表面,不穿过自由空间体素传播。当同一帧内的多个像素被量化到同一个体素 v v v 时,这些特征用观测质量权重聚合:
f ˉ v ( t ) = ∑ p ∈ P v q p f p ∑ p ∈ P v q p + ϵ , \bar{\mathbf{f}}_{\mathbf{v}}^{(t)}=\frac{\sum_{p\in\mathcal{P}_{\mathbf{v}}}q_{p}\mathbf{f}_{p}}{\sum_{p\in\mathcal{P}_{\mathbf{v}}}q_{p}+\epsilon}, fˉv(t)=∑p∈Pvqp+ϵ∑p∈Pvqpfp,
这里的 P v \mathcal{P}_{\mathbf{v}} Pv 是赋给体素 v v v 的像素集合, f p \mathbf{f}_{p} fp 是对应像素的视觉特征, q p q_{p} qp 反映该观测的质量。观测质量不是固定常数,而是由深度相关项算出:深度不连续处、偏离优选距离 d 0 d_0 d0 太远的像素会被调低权重,这相当于让"看得清楚、距离合适、画面平滑"的观测优先注入记忆。跨不同视角观察同一个体素时,再用累积加权平均融合:
F v ( t ) = C v ( t − 1 ) F v ( t − 1 ) + c v ( t ) f ˉ v ( t ) C v ( t − 1 ) + c v ( t ) , C v ( t ) = C v ( t − 1 ) + c v ( t ) . \mathbf{F}_{\mathbf{v}}^{(t)}=\frac{C_{\mathbf{v}}^{(t-1)}\mathbf{F}_{\mathbf{v}}^{(t-1)}+c_{\mathbf{v}}^{(t)}\bar{\mathbf{f}}_{\mathbf{v}}^{(t)}}{C_{\mathbf{v}}^{(t-1)}+c_{\mathbf{v}}^{(t)}}, \qquad C_{\mathbf{v}}^{(t)}=C_{\mathbf{v}}^{(t-1)}+c_{\mathbf{v}}^{(t)}. Fv(t)=Cv(t−1)+cv(t)Cv(t−1)Fv(t−1)+cv(t)fˉv(t),Cv(t)=Cv(t−1)+cv(t).
其中 F v ( t − 1 ) \mathbf{F}_{\mathbf{v}}^{(t-1)} Fv(t−1) 与 C v ( t − 1 ) C_{\mathbf{v}}^{(t-1)} Cv(t−1) 是已存的特征与累积置信度, c v ( t ) c_{\mathbf{v}}^{(t)} cv(t) 是当前单帧观测的置信度。这是一个累积加权平均,不是指数移动平均。这意味着,同一表面被反复看清楚,特征就越可靠、置信度越高;偶尔一张模糊远近失真的帧不会被当成真相。多视角的融合逻辑可以用一段重建代码表达,它把"历史置信度 × 历史特征"与"当前观测置信度 × 当前观测特征"按置信度配比合并,而不是简单覆盖:
# mapping/voxel_map.py  VoxelData.merge —— 语义特征的置信度加权累积融合
def merge(self, new_feat: np.ndarray, new_conf: float) -> None:
    """Cumulative Weighted Average using accumulated observation confidence."""
    total = self.confidence + new_conf
    if total < 1e-9:
        return
    w_old = self.confidence / total
    w_new = new_conf / total
    self.feature = self.feature * w_old + new_feat * w_new
    self.confidence = total
这段代码展示的是语义记忆跨目标复用的核心:特征不是每次覆盖,而是按置信度累积。这里的关键是只要置信度持续增长,越常被清晰观察到的表面,其特征就越稳定、越可信,而一张模糊或深远的帧不会覆盖掉已有的可靠观察。语义记忆因此在序列里的多个目标之间持续存在,而不是每个目标都重来。
4.3 目标切换时的查询——条件化 3D 检索
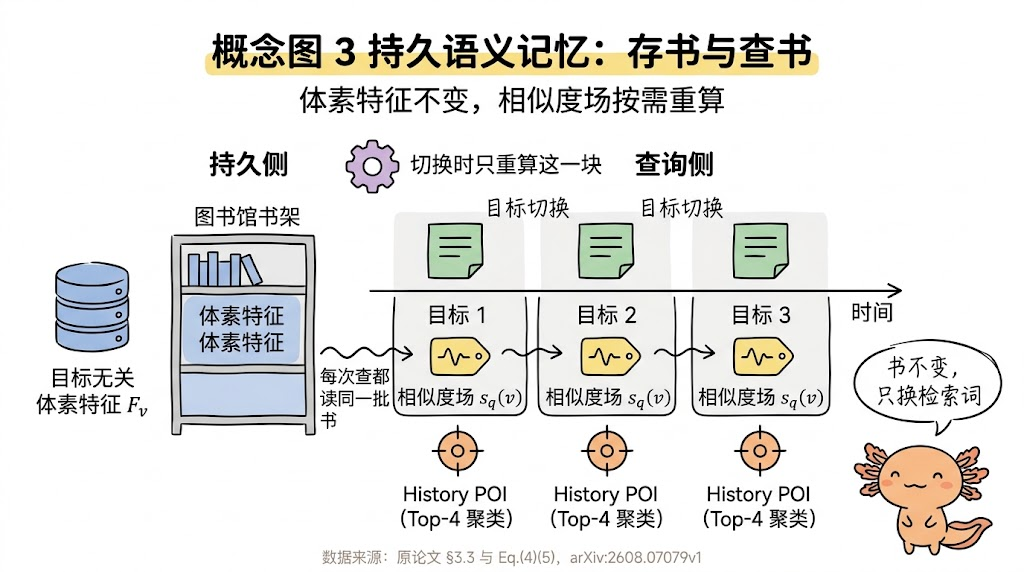
当某物体目标被激活,它的文本嵌入会与所有携带特征的表面体素做余弦相似度比较,形成一个查询条件化的 3D 相似度场。高响应的历史区域被做 3D 邻域聚类,之后取前 K K K 个候选保留为历史兴趣点(History POI),并分配附近可到达的导航位置。这里的关键是不管目标怎么变,几何与语义记忆本身不动,只重新计算相似度场与历史兴趣点。目标切换后,相似度场与历史兴趣点会针对新文本重算,但已存的体素特征不变。相似度计算如下:
s q ( v ) = f v ⊤ t q ∥ f v ∥ 2 ∥ t q ∥ 2 , s_{q}(v)=\frac{\mathbf{f}_{v}^{\top}\mathbf{t}_{q}}{\|\mathbf{f}_{v}\|_{2}\,\|\mathbf{t}_{q}\|_{2}}, sq(v)=∥fv∥2∥tq∥2fv⊤tq,
其中 q q q 是当前目标文本, t q \mathbf{t}_{q} tq 是其规范化文本嵌入, f v \mathbf{f}_{v} fv 是体素 v v v 上已存的特征。这里的 f v ⊤ t q \mathbf{f}_{v}^{\top}\mathbf{t}_{q} fv⊤tq 是特征与文本嵌入的内积,除以两边范数后得到余弦相似度。这个相似度场是查询相关的,本身不属于持久记忆;目标一换,它就重算。正是因为它由当前目标的文本嵌入驱动,系统才能在未预训练目标类别的情况下,复用存储在体素上的目标无关视觉语言特征去检索任意开放词汇的物体。
难点提示(查询条件化检索是怎么回事):可以把它想成在图书馆里查资料。一批书(表面体素)已经按内容贴好了标签(CLIP 特征)摆在那里,但"标签"是通用的,不针对某一本。检索时你拿一个检索词(当前目标文本)去跟所有标签比对,找出相似的书,这个相似度才是"查询条件化"的。换一个检索词,书不动,只重做一遍比对。体素特征持久保存,相似度场按需生成,正是这个"存书"与"查书"的分离,让换目标不用重建地图。从"一次性注入"到"跨目标复用"的整条链路,也值得用一张图串起来:
5. 统一导航策略:候选点 + 分层模式切换 + 共用 A*
5.1 四类候选导航点
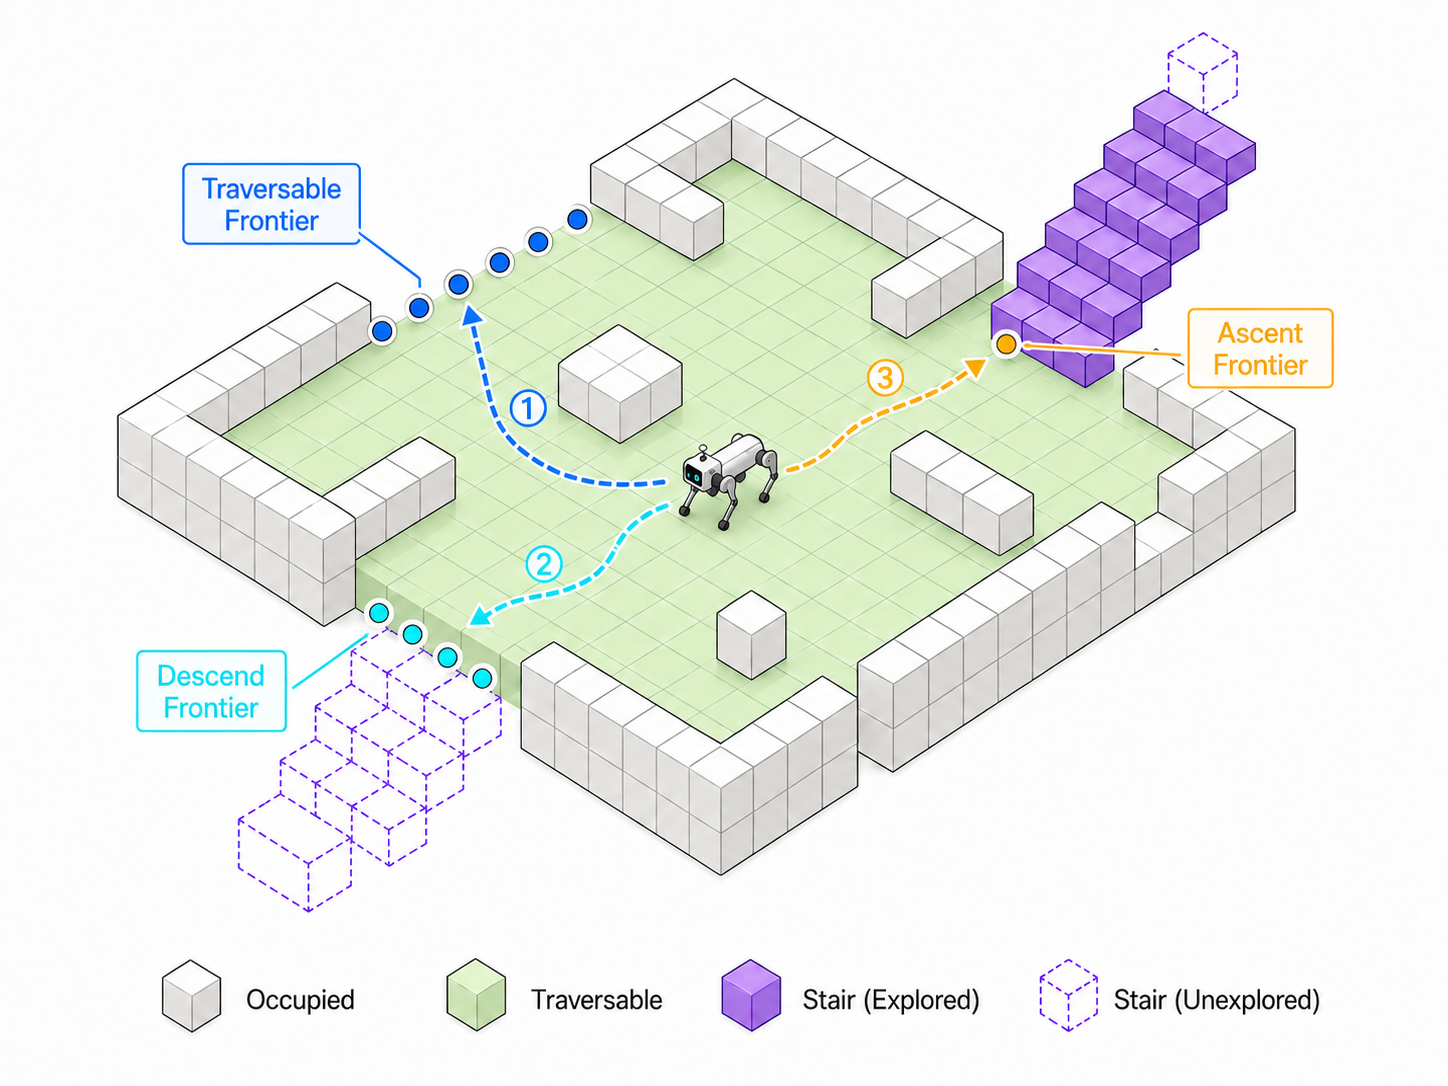
统一策略从四类候选里挑导航目标:基本前沿、楼梯前沿、历史兴趣点、实时兴趣点。基本前沿对应普通探索时的三种平面候选。可通行前沿(Traversable Frontier)是 TRAVERSABLE 体素与真正未知空间之间的边界。下行前沿(Descend Frontier)出现在 TRAVERSABLE 与 Unsupported 体素的边界附近,指示潜在向下的转移。上行前沿(Ascent Frontier)由楼梯语义证据、RGB-D 台阶几何与多帧一致性共同产生,其导航位置停留在当前探索平面、靠近潜在上升入口附近。三类有默认的优先顺序:可通行优先,下行次之,上行最后;下行会默认先于上行尝试,但顺序可以根据最近一次成功换层方向调整。
楼梯前沿是方向感知的,从当前已确认的楼梯体素簇中提取,高度随观察到的楼梯而变化,允许智能体在楼梯结构内继续向上或向下探索。历史兴趣点来自对持久语义记忆的查询,因此支持超出固定检测器标签集之外的语义检索。实时兴趣点则由可配置的目标检测接口产生——按照 OneMap 的做法,对 HM3D 的六个目标类别(椅子、床、马桶、绿植、沙发、电视)用 YOLOv7,因为这六类被 MS-COCO 覆盖;落在该类别集之外的查询则切到 YOLO-World。MobileSAM 用于提取检测到物体的掩码,再结合深度与位姿恢复其 3D 位置。
5.2 分层模式切换与优先级
候选选择遵循一个明确的优先级。这个顺序决定了智能体在每个时刻先看哪类候选,是整套导航策略"先找证据、再探索未知"行为模式的直接来源。它把可靠而有证据的实时兴趣点与历史兴趣点放在最前,把未探索的几何候选放在后面,从而在"冲证据"和"探索未知"之间取得平衡。四类候选的并集与先后关系如下:
C t = P t l i v e / h i s t o r y ∪ F t t r a v ∪ F t d e s c ∪ F t a s c , \mathcal{C}_{t}=\mathcal{P}_{t}^{\mathrm{live/history}}\cup\mathcal{F}_{t}^{\mathrm{trav}}\cup\mathcal{F}_{t}^{\mathrm{desc}}\cup\mathcal{F}_{t}^{\mathrm{asc}}, Ct=Ptlive/history∪Fttrav∪Ftdesc∪Ftasc,
# mapping/navigation3d/frontier_manager.py  _compute_frontiers_and_POIs
# 正式 ObjectNav 优先级:POI > 普通前沿 > 下假楼梯 > 上楼梯 > 记忆返回
# Stair 语义前沿仅在 stair_sem_mode 内激活
for cluster in self.frontier_clusters:
    if cluster.is_stair_frontier:
        if self._is_fake_frontier_region_blacklisted(cluster):
            continue
        if check_fake_frontier_has_stair_below(cluster, self.one_map, support_check_depth):
            continue
        self._remember_stair_frontier("down", cluster.nav_voxel_id, cluster=cluster)
        hint_bonus = self._down_stair_hint_bonus(cluster)
        if hint_bonus:
            cluster.frontier_score += hint_bonus
        stair_geo_frontiers.append(cluster)
    else:
        basic_frontiers.append(cluster)

# 同一类别内部统一排序:按智能体到候选的物理 3D 欧氏距离升序
ordered.sort(key=lambda item: (item[0], item[1]))
这里的关键是可靠与可达优先于未知。可靠的当前目标证据和可达的兴趣点被优先于未探索的几何候选。当没有有效的语义候选时,基本探索先访问当前楼层上的可通行前沿;只有没有可达的普通前沿时,才考虑下行与上行前沿。一旦楼梯入口被验证,策略激活楼梯探索,并沿着楼梯前沿前进直到到达一个新平台。一个激活的楼梯会话保持控制权,因此楼梯穿越不会被普通前沿或无关语义候选打断。候选被选中后还会被提交一小段宽限期,让增量地图更新不至于引起频繁的目标切换,这是一种稳定性机制而非新的候选类别。
直觉理解:这就像人在陌生大楼里找厕所。你优先看眼前有没有"厕所"标识(兴趣点);没有,就先把这层没去过的地方走一遍(可通行前沿);这层都走完了,才考虑"是不是要下楼"(下行前沿)或"是不是要上楼"(上行前沿)。重点在于一旦你已经踏上了楼梯,就不会因为中途看到一扇门就临时拐进去——楼梯会话保持控制权,直到到达新平台。这个"上了楼梯就不回头"的约束,正是跨层导航能完成的工程前提。
5.3 模式感知的 3D A* 规划
所有模式共用同一个 3D A* 规划器,但各自的可行体素类型与图连通性不同。基本探索用当前可通行区域上的严格 26 邻域图。兴趣点导航在选中点位于另一层时,用常规图配合先前建立的楼梯连通性。楼梯探索接纳已确认的楼梯体素,并把端点邻域扩展到固定物理半径(1.0 m)以内,以连接体素图中可能较稀疏的楼梯观测。A* 的启发函数是当前体素到目标的 3D 欧氏距离:
h ( n ) = ( i x − g x ) 2 + ( i y − g y ) 2 + ( i z − g z ) 2 , h(n)=\sqrt{(i_x-g_x)^{2}+(i_y-g_y)^{2}+(i_z-g_z)^{2}}, h(n)=(ix−gx)2+(iy−gy)2+(iz−gz)2,
转移代价为 c ( n , n ′ ) = ∥ n − n ′ ∥ 2 + p ( τ n ′ ) c(n,n')=\|n-n'\|_{2}+p(\tau_{n'}) c(n,n′)=∥n−n′∥2+p(τn′),其中 p ( τ n ′ ) p(\tau_{n'}) p(τn′) 由目标体素状态决定。注意楼梯末端之间的 RGB-D 观测可能留下超过一个体素的空隙,所以楼梯探索把固定的 26 邻域关系替换为 1.0 m 物理球内所有存在的可通行端点,这个邻域定义在米制 3D 空间里而不是固定的体素偏移。
论文给出的体素类型代价惩罚表如下,A* 规划器在搜索路径时据此权衡"平坦优先"与"楼梯可达"。这张表解释了为什么规划器在普通地面上走最顺、在楼梯上走要付代价、而假楼梯几乎不被选中——它同时保证常规导航高效、跨层可通行,又不会让不确定的楼梯证据污染平坦路径。A* 在规划时据此权衡:
# mapping/voxel_map.py  A* 搜索内的 voxel_type_penalty
def voxel_type_penalty(vd: VoxelData) -> float:
    if not prefer_traversable_cost:
        return 0.0
    if vd.voxel_type in (VoxelType.TRAVERSABLE, VoxelType.TRAVERSABLE_STAIR):
        return 0.0
    if vd.voxel_type == VoxelType.STAIR:
        return 4.0
    if vd.voxel_type == VoxelType.STAIR_EXPANDED:
        return 5.0
    if vd.voxel_type == VoxelType.FAKE_STAIR:
        return 10.0
    return 20.0

# 转移代价 = 欧氏距离 + 目标体素类型惩罚;膨胀体素再乘 inflated_cost_multiplier
move_cost = (dx * dx + dy * dy + dz * dz) ** 0.5 + voxel_type_penalty(vd_nb)
if vd_nb.inflated:
    move_cost *= float(inflated_cost_multiplier)
这里值得注意两点。第一,普通地面与楼梯上空的代价都是 0,说明规划器在平坦可走空间里没有人为惩罚,优先走平坦地面;而楼梯本体、扩展楼梯代价更高,是因为楼梯更稀疏、更不确定,只有确实需要跨层时才值得走。第二,FAKE_STAIR 代价最高,它只作为高成本回退,永远不会被选为导航终点。普通规划优先非膨胀体素,当一个模式显式允许可膨胀的可通行终点时,其转移代价会乘 2;如果智能体已经在可膨胀可通行区域内部,规划器可能临时保留膨胀状态让智能体离开该区域,之后恢复严格规划。
6. 接近目标:从"到兴趣点"到"确认目标"
6.1 最终目标逼近与多层校验
抵达一个历史兴趣点或实时兴趣点本身不意味着子任务完成。系统必须先获得稳定的目标证据:检测掩码被投影到 3D,再选一个附近的、安全的观察位置。在逼近过程中,系统持续更新检测,并用检测置信度、掩码质量、可见性、观察方向、3D 距离五个维度校验目标物体。只有当某个当前目标物体的观察通过了校验标准,子任务才算完成,此时下一个目标被激活,而几何地图、楼梯结构、目标无关的语义记忆全部保留。如果校验失败,系统回到候选选择,继续探索。
6.2 历史兴趣点如何改变路径效率
…详情请参照古月居

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献160条内容

所有评论(0)