学了十年英语还是开不了口?端到端具身交互智能口语教练让你真正开口说
项目简介
英语学习的悖论在于:背了上万单词、刷了无数语法题,真遇到老外开口时还是卡壳。线下外教一对一动辄 300 元/小时,时间地点都不自由;自学 APP 又只能对着屏幕念句子,没人纠正发音,更没法随时打断追问。学习者最缺的从来不是教材,而是一个随时在线、耐心陪练、能听能看能纠正的口语搭子。
大模型让 AI 学会了理解语言,而要让 AI 真正成为你的口语陪练,还需要一项关键能力:端到端具身交互智能——让 AI 拥有可视化的智能体载体,能听见你的发音、看见你的表达,用语音、表情、手势实时回应,支持你随时打断、反复练习,把"哑巴英语"变成"开口自信"。
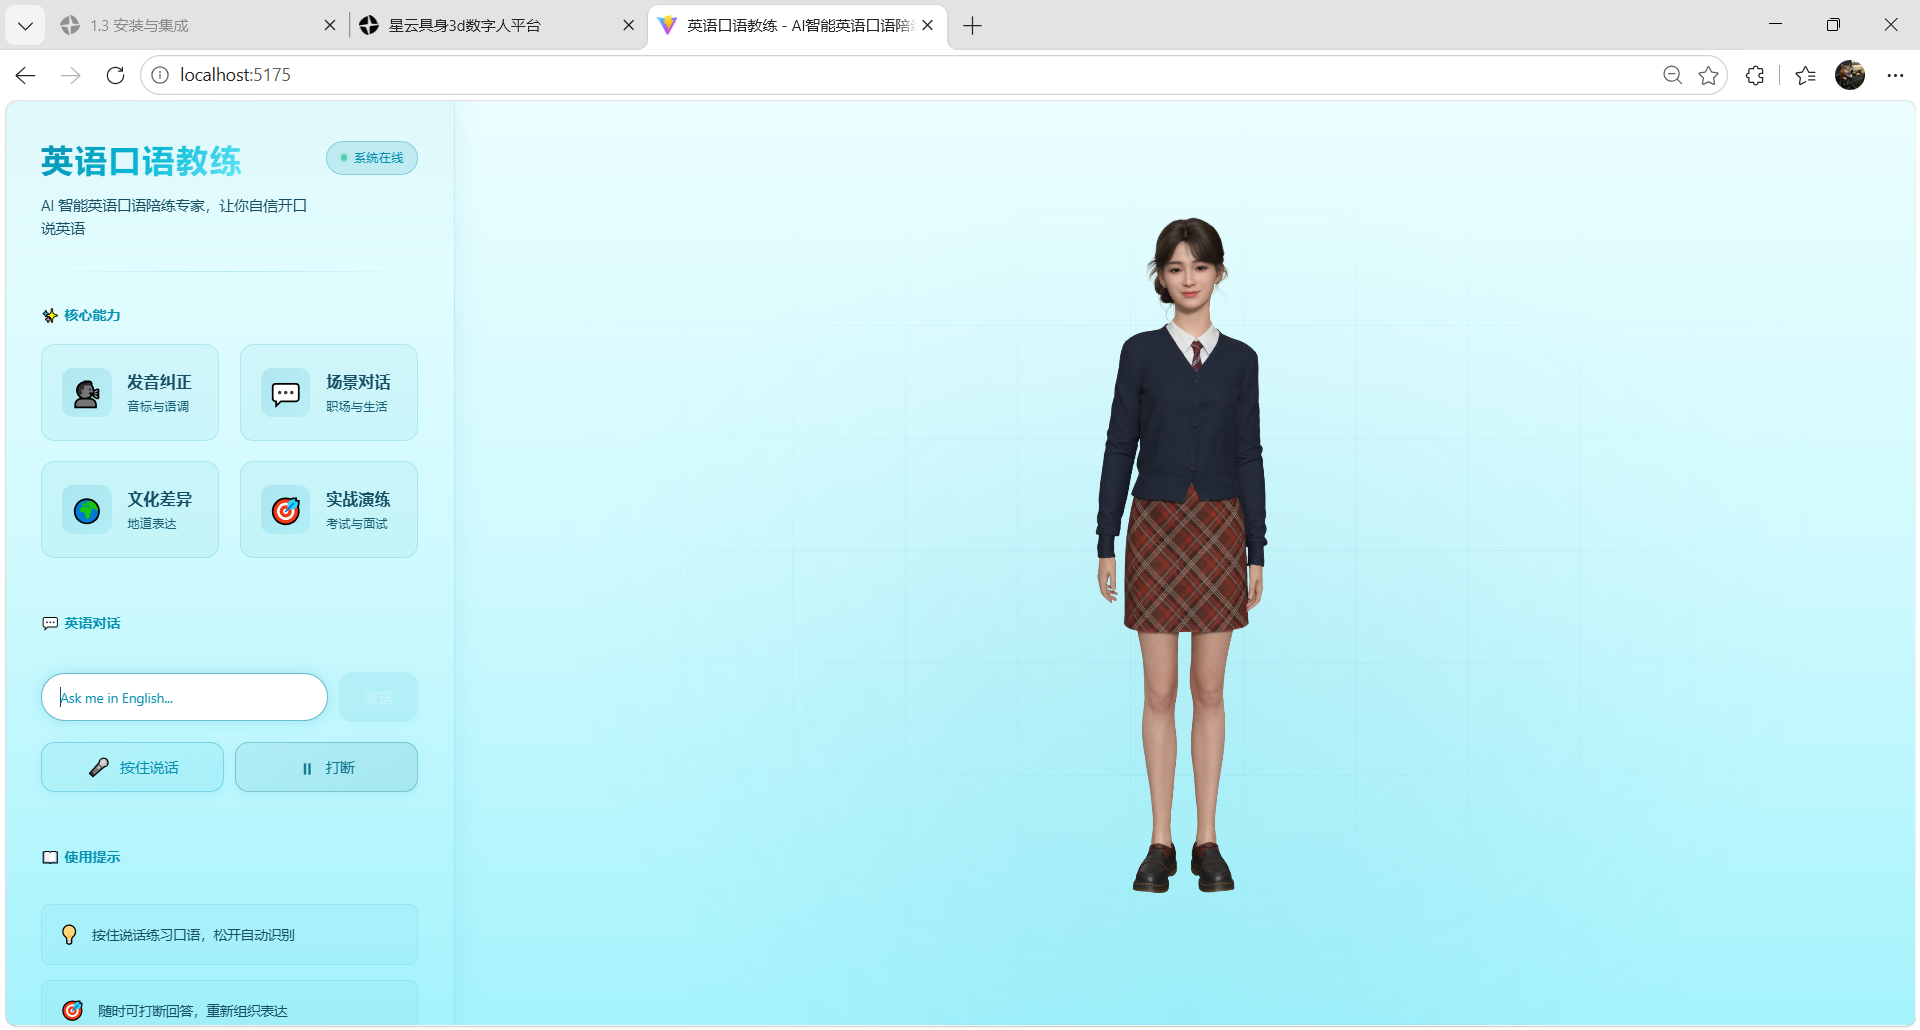
四种练口语的方式,哪种真能治好哑巴英语?
| 方式 | 能否纠正发音 | 能否打断追问 | 沉浸感 | 成本 |
|---|---|---|---|---|
| 线下外教 | 支持 | 支持 | 面对面 | 高 |
| 自学 APP | 不支持 | 不支持 | 对着屏幕 | 低 |
| 纯文本 AI | 不支持 | 支持 | 缺画面 | 中 |
传统方案只能满足其中一两样,学习者的真实痛点被卡在"不敢开口"“没人纠正”"坚持不下去"的死循环里。
什么是端到端具身交互智能?
想象一下:你打开 APP,一位"英语口语智能体"站在你面前。你说"我想练习面试英语",她微笑着开始引导,手势自然、眼神专注。你卡在某个表达上,她立刻放慢节奏,给出替换词。你突然想起"等等,这个单词和刚才那个有什么区别?",她马上停下,转向你的新问题。
这就是端到端具身交互智能——不是 ASR + LLM + TTS 的简单拼接,而是围绕一次完整的人机交互设计整个系统,形成持续交互循环(Continuous Interaction Loop):
持续感知 → 持续理解 → 持续决策 → 持续表达 → 持续反馈
也就是说,智能体不是“你问一句、它答一句”,而是一边和你交流,一边继续听、继续看、继续判断接下来应该怎么回应。你随时插话,她随时响应;她正在表达时你开口,她能识别出是你而不是自己的声音。
前端接入这一切,只需要创建一个 XingyunAvatarAgent 实例。下面是本项目 src/services/avatar.ts 中创建智能体的真实代码:
this.agent = new window.XingyunAvatarAgent({
  container: this.containerEl,         // 挂载的 DOM 容器(必须有明确宽高)
  appId,
  appSecret,
  gatewayServer: SDK_CONFIG.GATEWAY_URL, // 星云端到端网关
  agentCallbacks: {
    onAgentStateChange(state) { /* 智能体状态变化:idle / speak / listen ... */ },
    onASRResult(result)         { /* 语音识别结果:实时 + 最终 */ },
    onConversationChange(event) { /* 对话状态变化 */ },
    onError(error)              { /* 错误回调 */ },
  },
})

// 初始化:一次性建立渲染、网关、ASR 三条连接
await this.agent.init({ onDownloadProgress(progress) { /* 资源加载进度 */ } })
这段代码做了三件事:
- 传入容器和凭证:container 是智能体渲染的 DOM 元素,appId / appSecret 是星云后台分配的应用凭证,gatewayServer 指向端到端网关。
- 注册四大回调:智能体状态、语音识别结果、对话状态、错误——这四项回调让前端能实时感知智能体的“感知 → 理解 → 表达”全过程。
- 调用 init() 建立三条连接:初始化完成后,智能体即进入 running 状态,可直接调用 ask(text) / startASR() / stopASR() 等 API。
注意:init() 不会在失败时主动 reject,必须自己包一层超时保护(本项目用 Promise.race 加 60s 超时),否则页面会无限停在“正在连接”。
技术实现:五大能力支撑一次完整的口语陪练
这套方案的底层架构,对应着魔珐星云的五项核心能力:
多模态感知:智能体通过麦克风持续接收你的语音输入,算法降噪、回声消除、智能打断(Barge-in)一体运行。你开口时她立刻停下,你停顿时她判断你是卡壳还是说完,不会机械地“等指令”。核心优势:持续感知,而不是一次输入——智能体不只在你说话时才工作,而是在整个交互过程中持续判断现场正在发生什么。
前端调用非常简洁,本项目 src/stores/app.ts 中启动 / 停止语音输入的核心逻辑:
async startVoiceInput() {
  appState.ui.text = ''                 // 启动前清空输入框
  await avatarService.startASR()        // 调用 SDK 内置 ASR
  appState.asr.isListening = true
}

async stopVoiceInput() {
  await avatarService.stopASR()
  // isListening 由 onASRResult 最终结果时更新,避免提前置 false
}
这里有两个细节:
- 启动前清空输入框:避免上一次残留的文本干扰本次识别结果。
- 不在 stopASR() 后立即置 isListening = false:因为 SDK 的 ASR 最终结果(isFinal: true)可能在停止后才回填,必须等 onASRResult 回调的最终结果到达后再更新状态,否则会丢失最后一段识别文本。
专属智脑:智能体的“大脑”不是绑死的——用户可自由接入豆包、DeepSeek、ChatGPT 等用惯的大模型;如果没有现成的大模型,也可直接使用魔珐星云自研的智脑,低延迟、强逻辑、场景化理解、数据安全可控,专为具身交互场景优化。它解决三个层面的问题:它知道什么(院校、报录比、分数线)、它是谁(以什么身份、遵循什么规则)、它要做什么(下一步该推荐院校还是调整计划)。场景化 prompt 注入,让智能体从“通用回答”升级为“面向具体身份和业务的智能体能力”。
多模态表达:智能体输出的不只是文字,而是语音、口型、表情、眼神、手势和身体动作的统一实时生成。她讲到一个地道表达时会挑眉,你答对了她会微笑点头,这些表达和语言是同一次交流的一部分,不是各自播放。核心优势:统一、连续、同步——语言、语气、表情、动作本就是同一次交流的一部分,智能体让 AI 的这些表达真正统一起来。
AI 端渲:渲染运行在你的设备端(手机、平板、PC 浏览器),不再依赖云端 GPU 持续推流。端到端延迟 < 500ms,弱网环境下依然稳定运行。它解决的不仅是“画面流不流畅”,而是更底层的工程问题:降低云 GPU 成本、降低带宽占用、支持大规模并发、支持低成本 AI 终端。核心优势:更低成本、更低延迟、弱网可用、更稳定、更容易规模化。教培机构的大屏、学员的手机都能流畅对话,并发不再受云端渲染资源限制。
数字与物理行动:智能体在屏幕端以具身交互智能体的形式,把答案“说出来、演出来、表达出来”。从“生成一段文字答案”升级为“以语音、表情、动作自然互动”,让口语陪练真正具备面对面交流的质感。值得注意的是,同一个智能体,可以拥有不同的身体——同一个英语口语智能体,可以运行在学员的手机、教培机构的大屏、甚至未来的 AI 屏幕上,身份、知识、记忆、任务持续复用,身体随终端形态升级。
前端发送一次文本对话,只需要一行调用。本项目 src/stores/app.ts 中发送消息的核心逻辑:
async sendMessage() {
  const text = appState.ui.text?.trim()
  if (!text || !appState.avatar.instance) return

  await avatarService.ask(text)   // 云端自动完成:Brain 推理 → TTS → 具身表达
  appState.ui.text = ''           // 发送后清空输入框
}
ask(text) 背后是整条云端链路的联动:大模型根据文本推理出回复,TTS 把回复转为语音,同时驱动智能体的口型、表情、手势和身体动作同步表达。前端不需要分别调用 LLM / TTS / 动作接口,一次 ask() 调用就是一次完整的具身表达。
实际对话效果:
- 学员:“我想练习英文面试,自我介绍怎么说?”
- 口语智能体:(微笑,手势自然展开)“Good question. 面试自我介绍建议控制在 90 秒内,分三段:身份背景、核心亮点、求职动机。我先给你一个模板,你试着填一下自己的内容?”
- 学员:(打断)“等等,‘core strengths’ 和 ‘key highlights’ 有什么区别?”
- 口语智能体:(立即停下,转向新问题)“好问题。‘Core strengths’ 强调你长期积累的能力,比如数据分析、团队管理;‘Key highlights’ 更偏向你过往经历中的亮点成果。简历里用 strengths,面试口述用 highlights 更自然。”
这种听得懂语境、看得见表情、随时能插话的体验,正是端到端具身交互智能的核心价值。
四大核心能力,覆盖口语学习全场景
- 发音纠正:音标、连读、语调逐句打磨,告别中式口音
- 场景对话:职场面试、出国旅游、日常社交全覆盖
- 文化差异:地道表达、俚语习惯、跨文化沟通避坑
- 实战演练:雅思口语、商务英语、面试模拟全真训练
写在最后
英语口语教练智能体的价值,不在于替代人类老师,而在于让高质量的 1 对 1 口语陪练从"稀缺资源"变成"日常基础设施"。它 24 小时在线、耐心无限、千人千面,让每一位学习者都能按自己的节奏开口说英语。
大模型让 AI 学会了理解语言,魔珐星云让 AI 以端到端具身交互智能的方式成为你身边的口语搭子。当 AI 不再只是屏幕里的文字,而是站在你面前、能打断、会纠正的具身交互智能体,英语学习就真正从"输入"变成了"对话"。
魔珐星云是一套端到端具身交互智能平台,让 AI 通过屏幕和机器人进入真实世界,成为能够感知、理解、表达并行动的智能体。
想为自己的英语学习找一位具身交互智能口语教练? 访问魔珐星云官网领取 SDK 免费试用,快速把口语陪练升级为可交互的具身智能体:https://xingyun3d.com/?utm_campaign=daily&utm_source=juzhen

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 55
 0
- 0


 已为社区贡献46条内容

所有评论(0)