当 AI 面试官走进沉浸式空间:面境背后的端到端具身交互智能实战手记
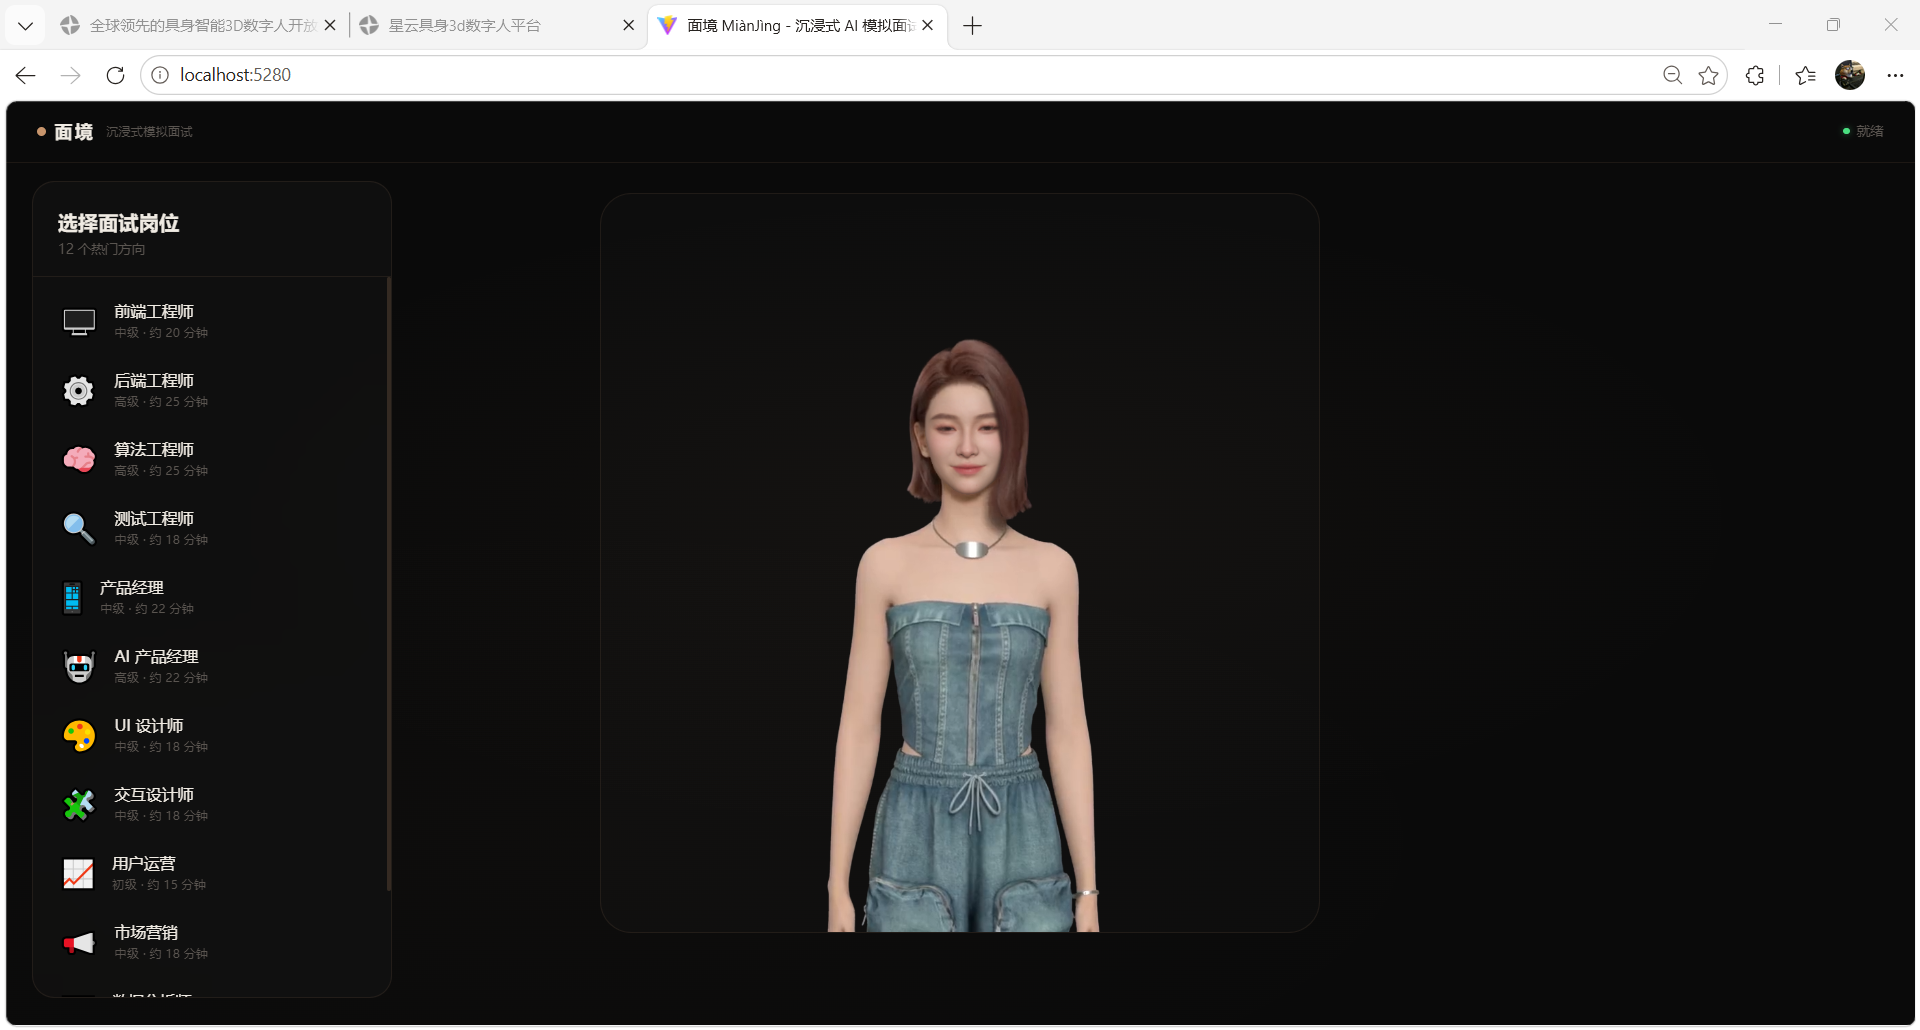
想象这样一个场景——你打开一个网页,一位资深面试官正面对着你,目光自然、神态沉稳。你开口回答,他一边听一边判断你的思路,追问、点评、引导,节奏和真人面试几乎没有差别。
这不是视频通话,也不是预录好的动画。屏幕对面的,是一个由端到端具身交互智能驱动的具身交互智能体——「面境」。
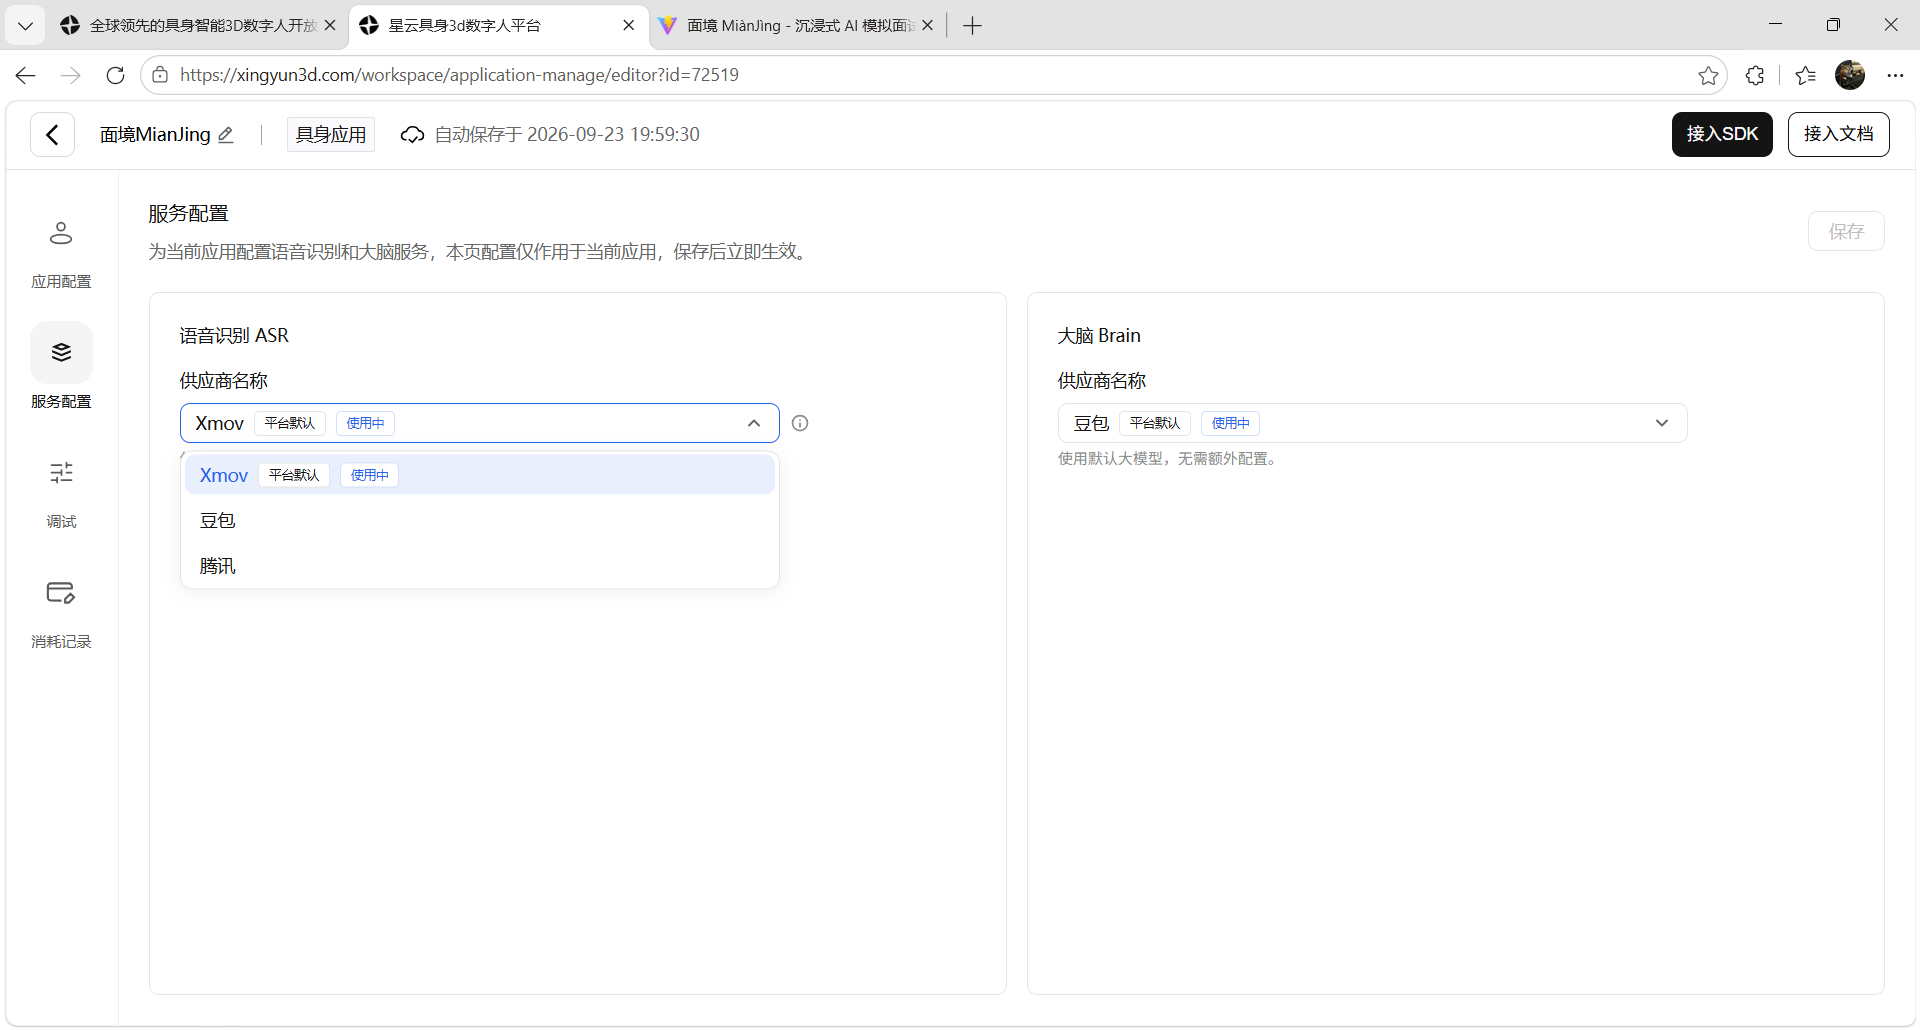
本文将以面境这个沉浸式 AI 模拟面试应用为切入点,拆解它是如何基于魔珐星云平台,用一个端到端 SDK 打通感知、大脑与表达全链路,让 AI 真正通过屏幕进入真实交互场景的。
开场白:为什么面试场景特别适合端到端具身交互智能?
AI 面试并不新鲜,但过去的体验往往很"机械"——用户提一个问题,后台拼一条流水线,等两三秒后播一段语音。本质上还是"你问一句,它答一句"。
真实的面试不是这样的。
面试官在你回答的过程中,一直在听、在观察、在判断你说到哪个重点了、是不是该追问、要不要打断你换个方向。这种持续感知 → 持续理解 → 持续决策 → 持续表达与行动 → 持续反馈的循环,才是真实交互的样子。
这正是魔珐星云提出的端到端具身交互智能要解决的核心问题:不是把几个模块串起来,而是围绕一次完整的人机交互,设计整个系统。
面境要做的,就是把这种能力搬进一个沉浸式的面试空间里。
一面:从三条管线到一个 SDK
传统方案:ASR → LLM → TTS 的拼接困境
在面境之前,我们做过一版传统管线式的 AI 面试官:
- 腾讯 ASR 负责语音识别
- OpenAI 兼容接口调豆包 LLM 负责推理
- XmovAvatar 参数流 SDK 负责语音合成和具身交互智能体驱动
- 中间还有一层 ActionManager 手动做流式分片、拼 SSML
三个模块各自工作,代码量 2000+ 行,延迟层层叠加,首字响应要 1.5 到 3 秒。更关键的问题是——模块之间的状态是割裂的。ASR 不知道 LLM 正在推理,TTS 不知道用户已经开口打断,整个链路像三段各跑各的接力赛。
这就是典型的"不是端到端"。
端到端方案:一行 agent.ask() 打通全链路
面境基于魔珐星云的端到端 SDK XingyunAvatarAgent 重构后,核心代码缩减到不到 500 行。
// 创建具身交互智能体实例
const agent = new window.XingyunAvatarAgent({
  container: containerEl,
  appId,
  appSecret,
  gatewayServer: 'https://nebula-agent.xingyun3d.com/user/v1/ttsa_v2/session',
  agentCallbacks: {
    onAgentStateChange(state) { /* 智能体状态持续更新 */ },
    onASRResult(result) { /* 实时语音识别,支持智能打断 */ },
    onConversationChange(event) { /* 对话状态持续流转 */ },
    onError(error) { /* 异常兜底 */ },
  },
})

// 初始化:一次性建立感知、大脑、表达三条通道
await agent.init()

// 发送消息:文本 → 大模型推理 → 具身交互智能体播报,全链路一行搞定
await agent.ask('请介绍一下你做过的最复杂的项目')
端到端具身交互智能和简单模块拼接的本质区别在于:感知、理解、决策、表达不再是前后两个独立阶段,而是在同一次交互中持续并行运行。智能体一边说话,一边继续听你有没有插话,一边判断接下来该怎么回应。
不是"你问一句它答一句",而是一边交流,一边持续感知、持续判断、持续行动。
二面:在魔珐星云控制台配置一个具身交互智能体
面境的具身交互智能体并不是从零搭建的,它的能力底座来自魔珐星云控制台的完整配置体系。这里用截图还原一下实际配置过程。
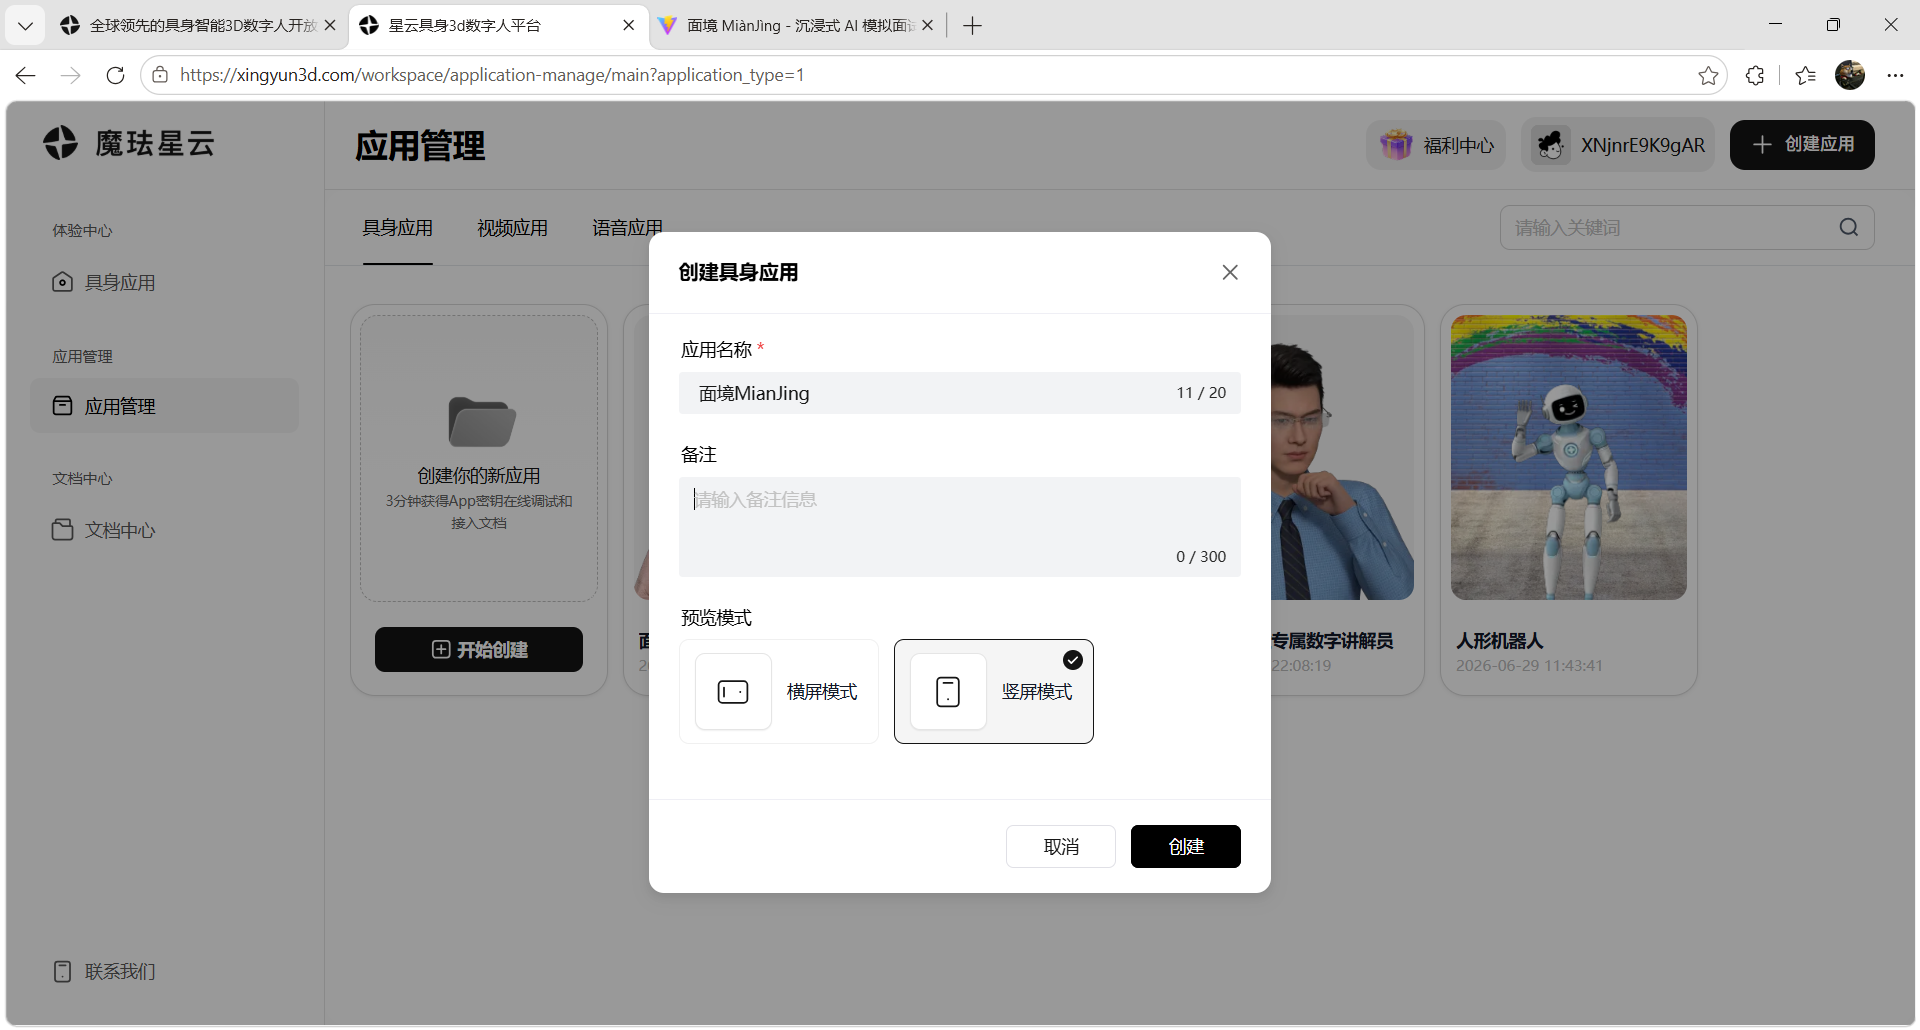
1. 创建具身交互智能体应用
在魔珐星云控制台创建一个新应用,系统会自动分配 App ID 和 App Secret,这就是后续 SDK 连接所需的身份凭证。
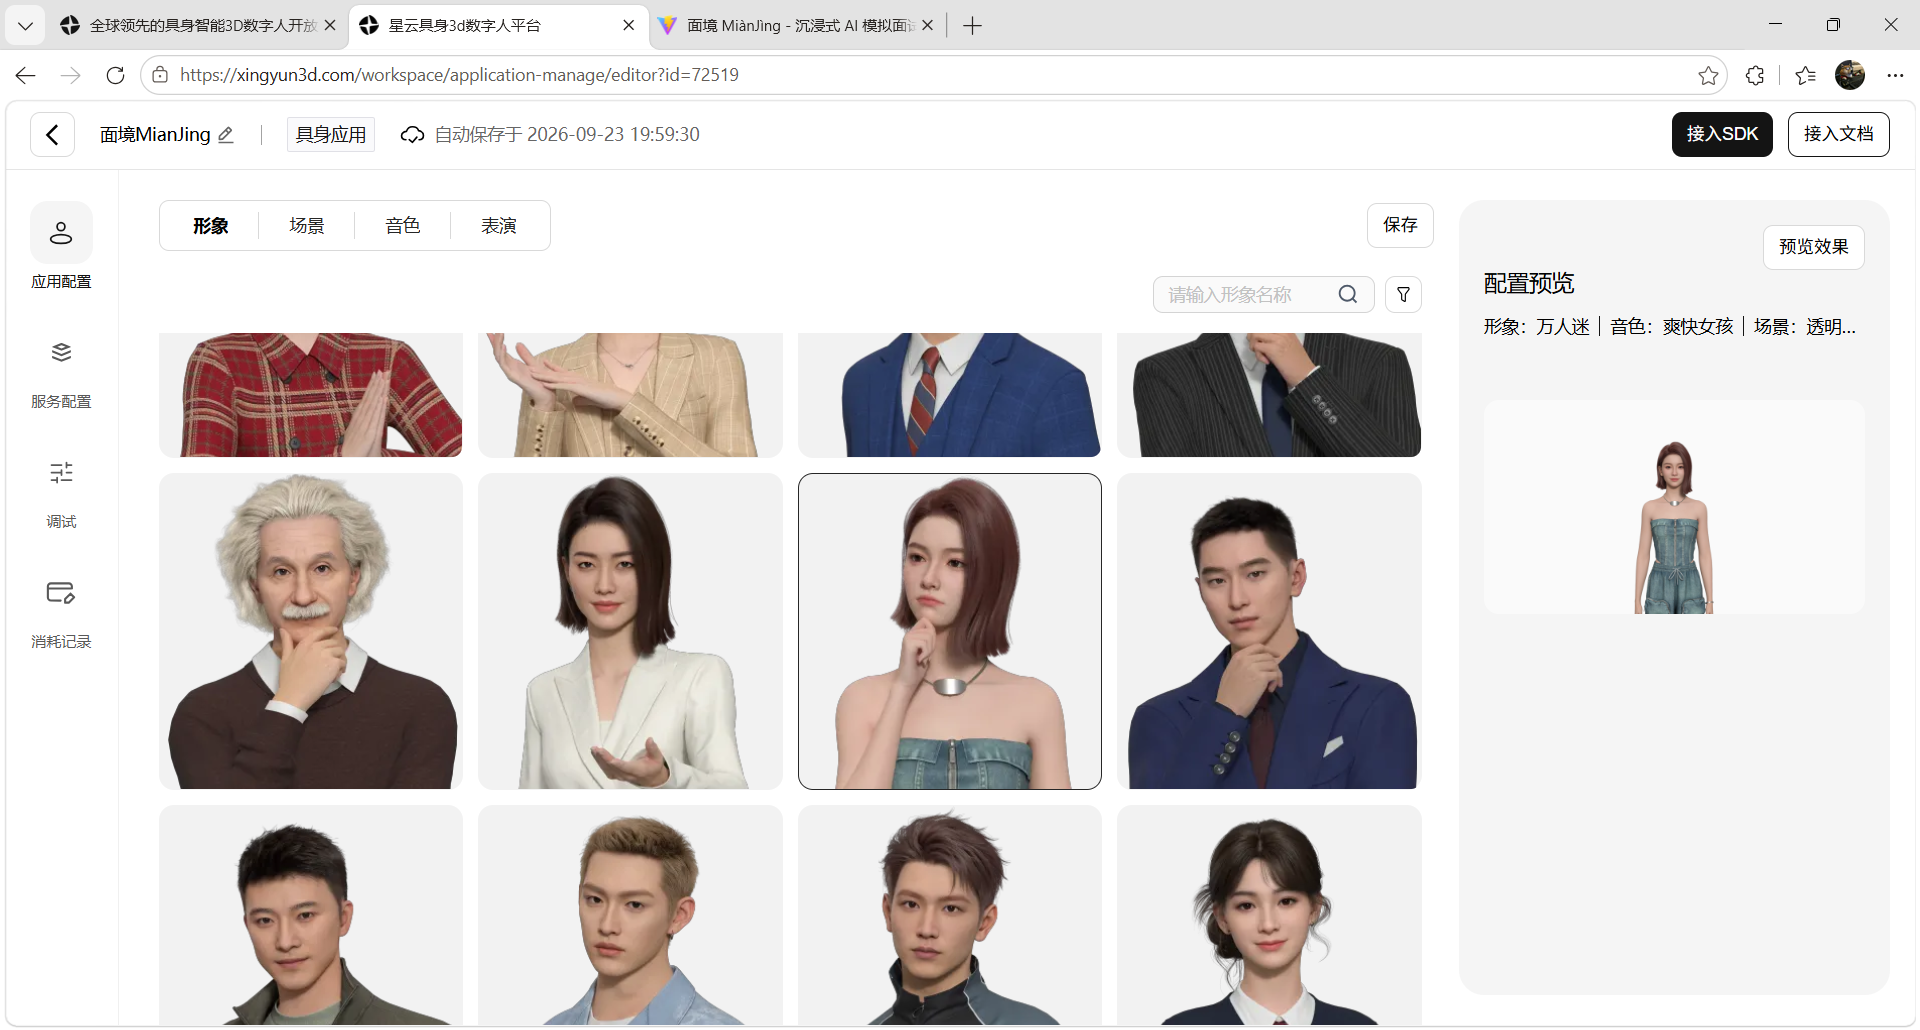
2. 形象配置
选择智能体的外在形象——面境需要的是一位专业沉稳的资深面试官。平台提供多种形象可选,也可以自定义。
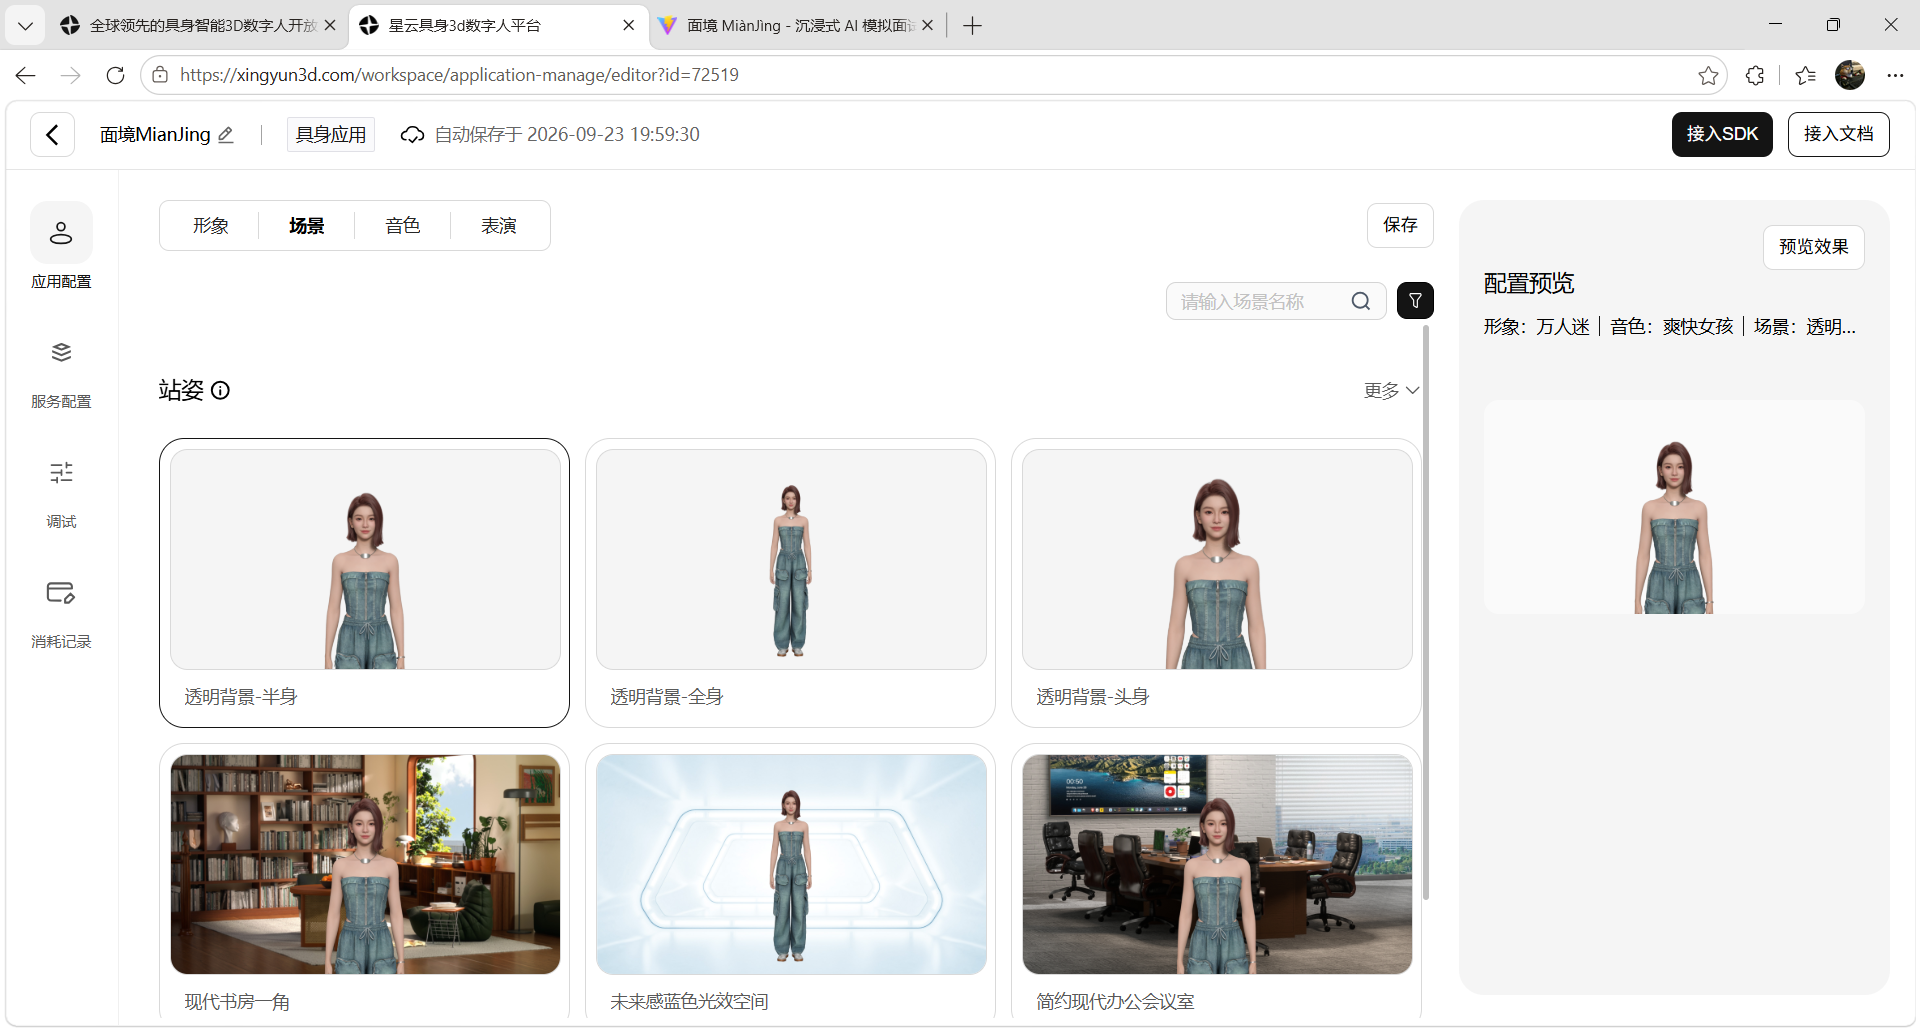
3. 场景配置
为智能体设定交互场景的背景环境。面境采用的是深色沉浸式风格,和前端 UI 的炭黑琥珀金主题保持一致。
4. 音色配置
选择智能体的语音风格。面试官需要的是专业沉稳、语速适中的音色,魔珐星云自研 TTS 支持多语言多风格。
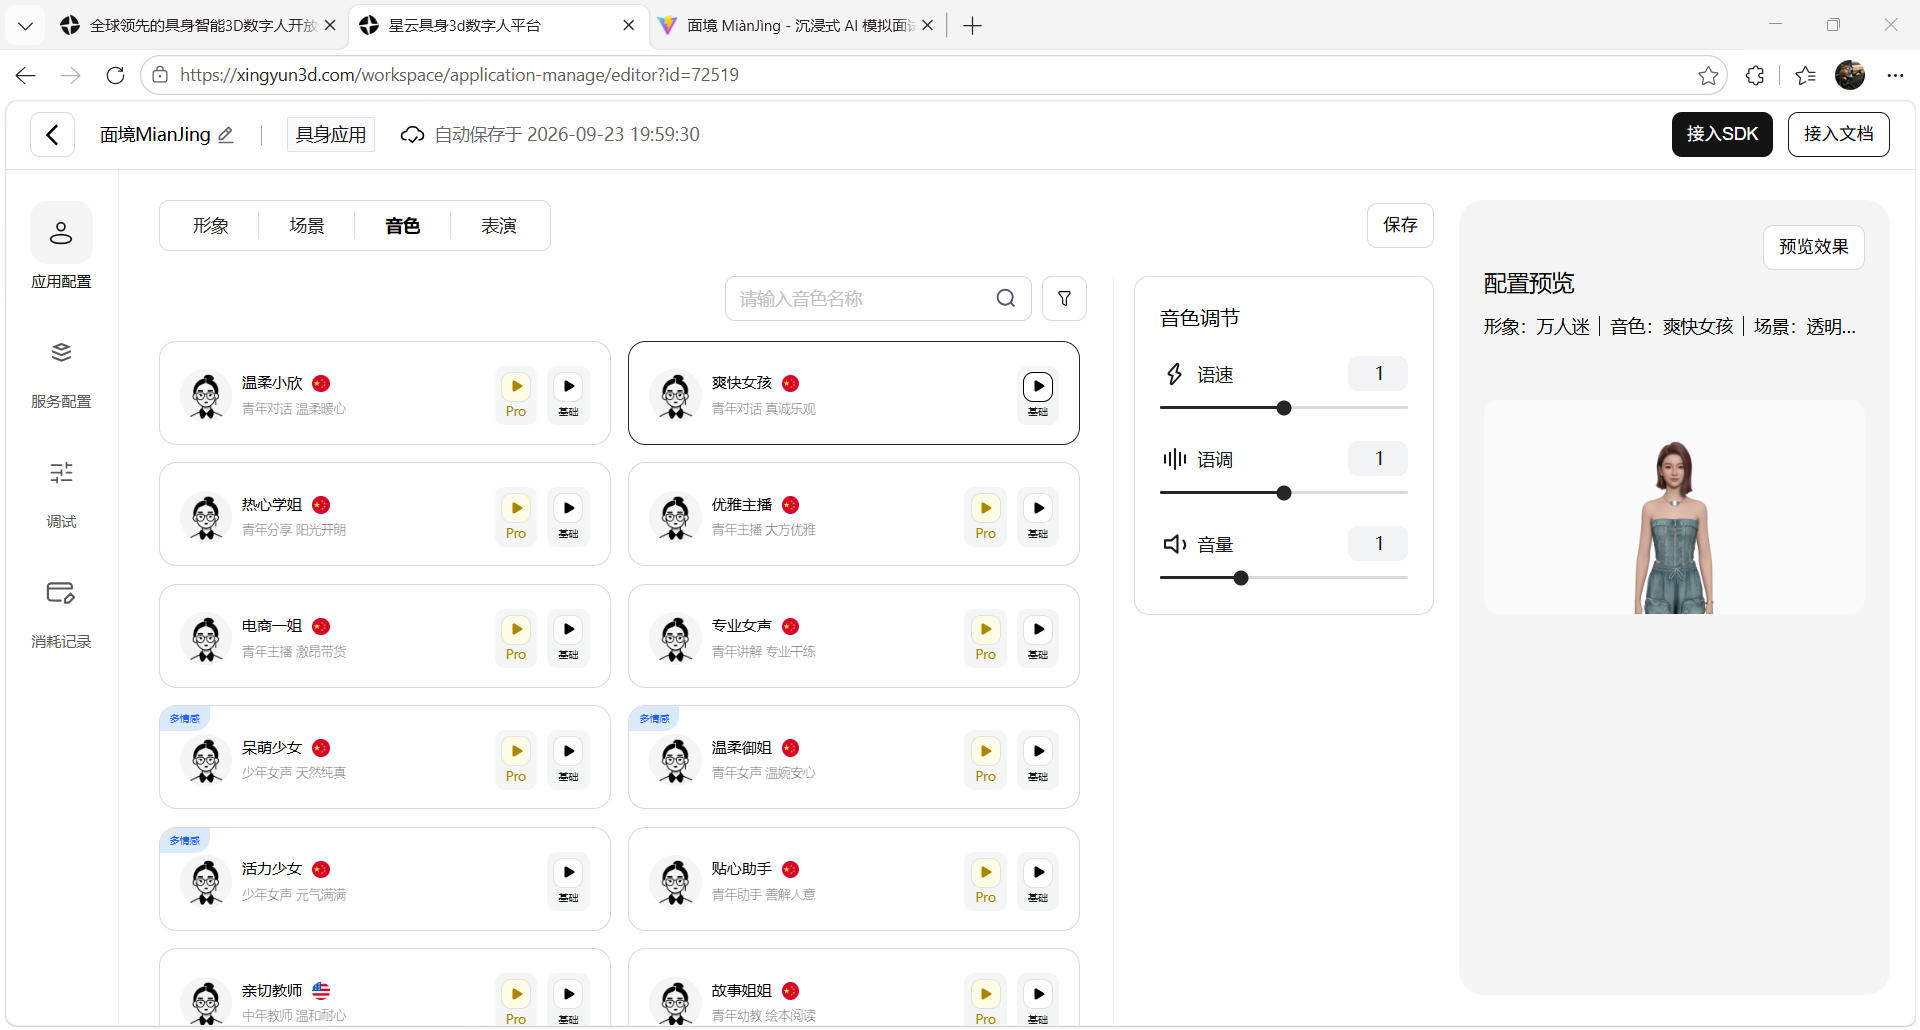
5. 表演配置
配置智能体的肢体语言和表情系统——这正是多模态表达的核心。不是简单的口型同步,而是语气、表情、手势、头部动作和身体动作的统一生成。
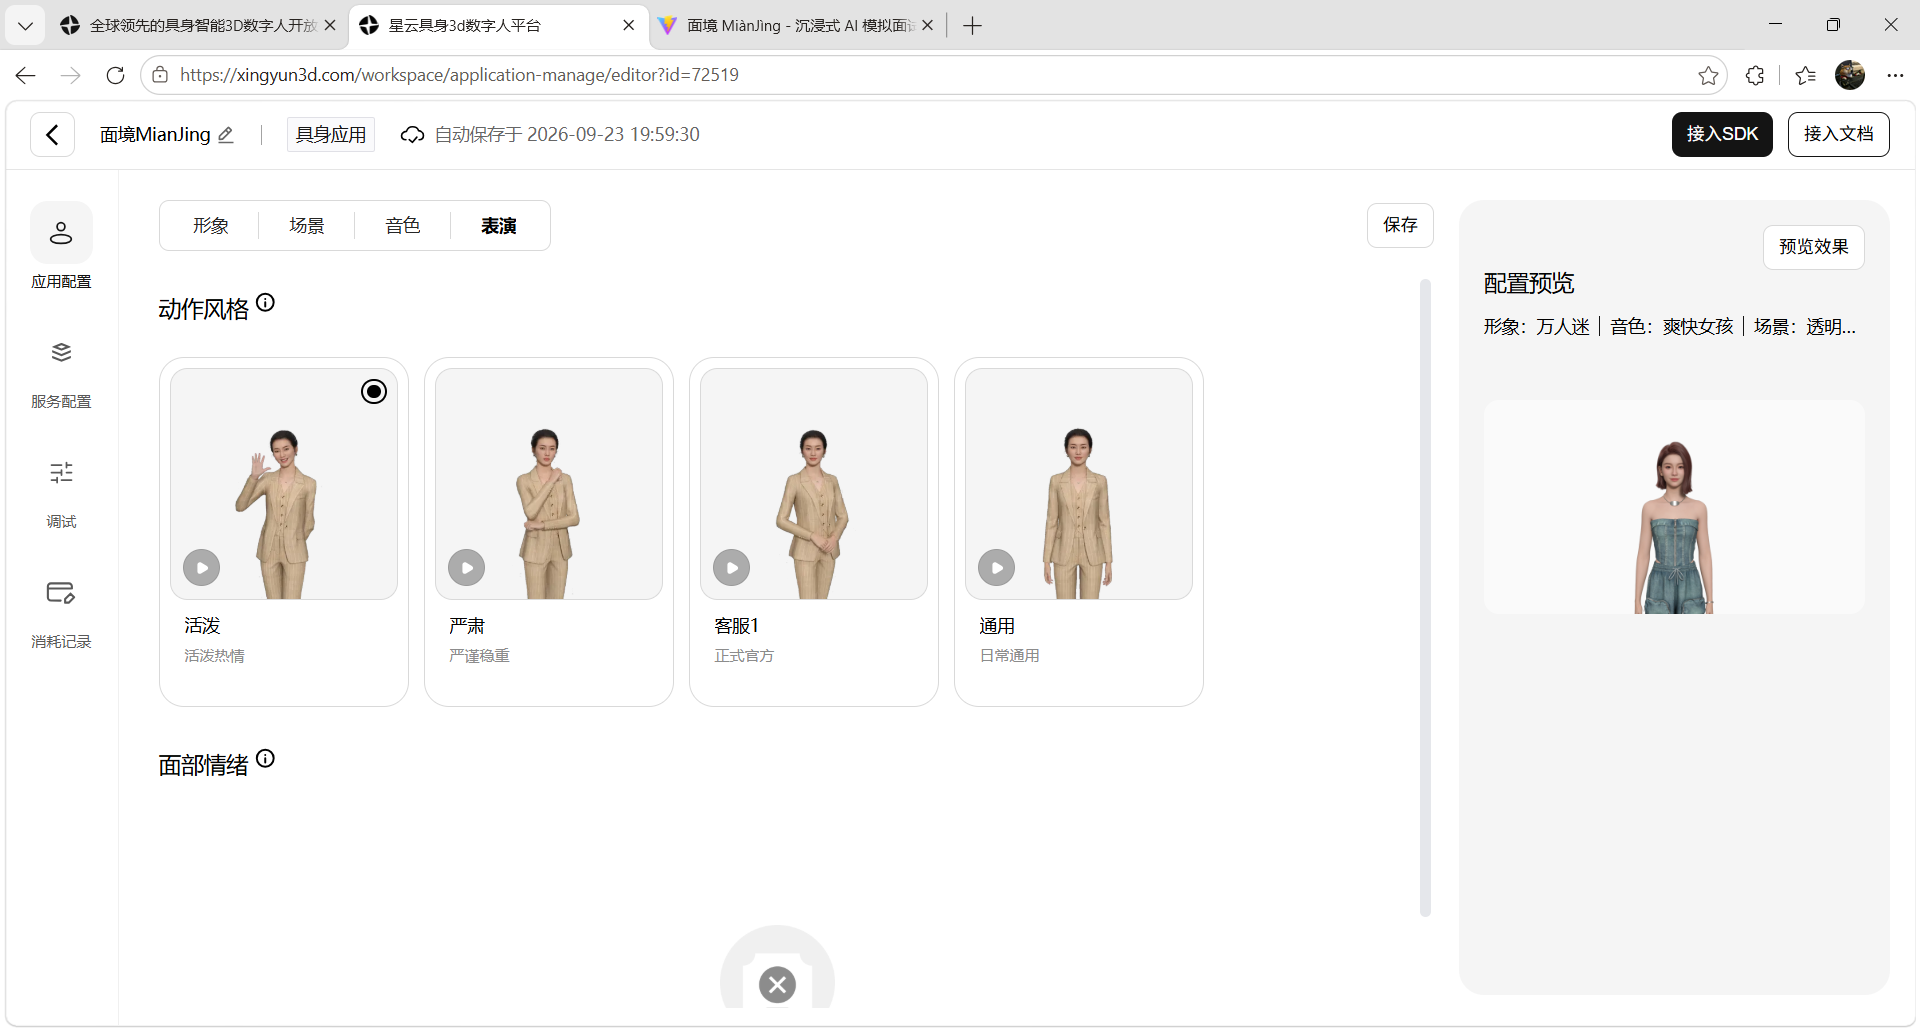
6. 服务配置:ASR 与大脑
为当前应用配置语音识别和大模型服务。这一步体现了星云的可插拔架构 ——可插拔并非简单的 API 拼接,平台依靠标准化接口契约与统一状态管理,保障模块替换后会话状态、事件流转、交互闭环不受破坏。ASR 支持 Xmov 自研、豆包、腾讯等多家供应商,大脑支持魔珐自研、豆包、OpenAI 兼容协议等多种接入模式。
这些配置完成后,保存即生效。前端只需要拿着 App ID 和 App Secret,通过 SDK 一行代码就能连上整套能力。
同一个智能体,可以拥有不同的身体。 今天它是 Web 端的面试官,明天可以换一套形象变成线下展厅的讲解员,身份、知识、记忆和业务能力持续复用——这是端到端具身交互智能平台赋予的灵活性。
三面:五项核心能力在面境中的真实体现
魔珐星云定义了五项核心能力。在面境这个产品里,它们不是抽象概念——每一行代码背后,都是一次真实可感的交互体验。
多模态感知:面试官一直在听
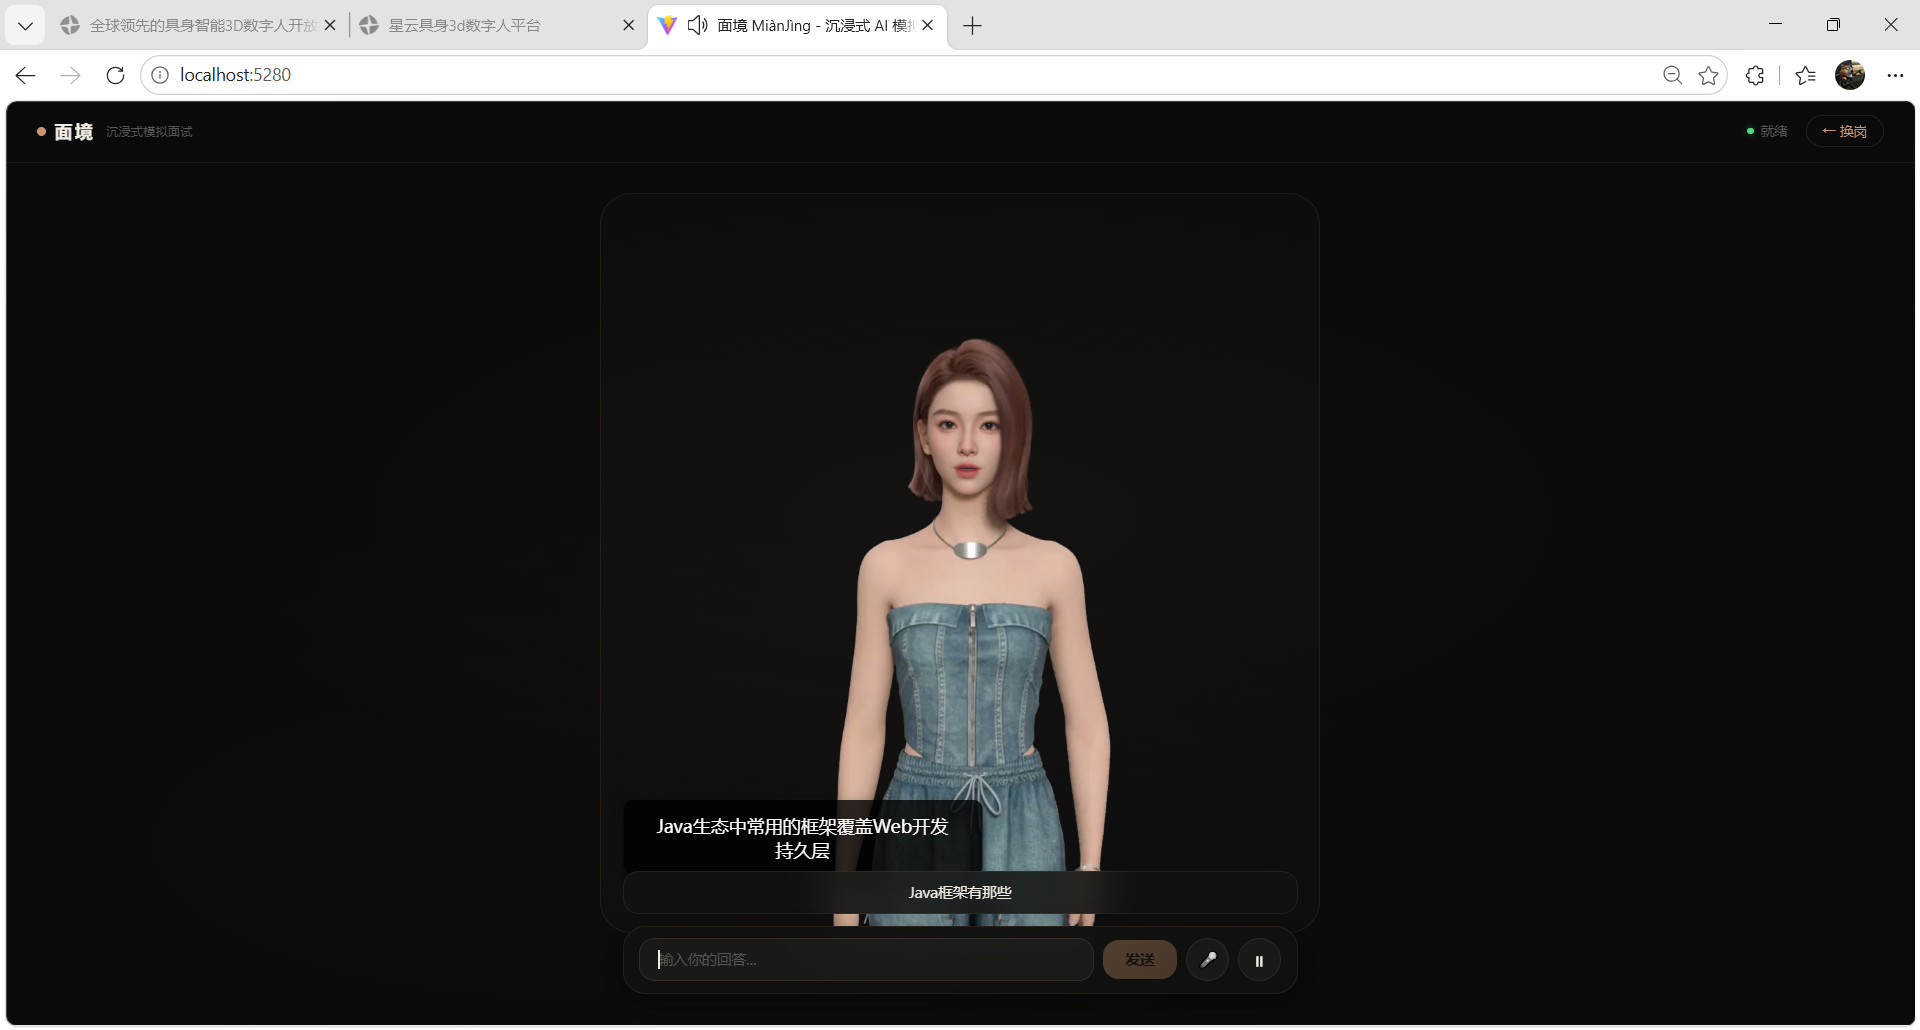
面境的语音感知不是"等你说完再处理"。SDK 内置的 ASR 持续运行,支持 Barge-in 智能打断——智能体正在播报时,你随时可以开口,系统自动识别真实用户声音、去除本体回声、检测有效打断,然后停止当前表达,进入新一轮交互。
在代码层面,这体现为一组实时回调:
// src/services/avatar.ts — 感知层回调(真实代码)
agentCallbacks: {
  onAgentStateChange(state: any) {
    console.log('[E2E SDK] Agent 状态:', state)
    onStateChange(typeof state === 'string' ? state : state?.type || '')
  },
  onASRResult(result: any) {
    console.log('[E2E SDK] ASR 结果:', result.text, result.isFinal ? '(最终)' : '')
    onASRResult(result.text || '', !!result.isFinal)
  },
  onConversationChange(event: any) {
    console.log('[E2E SDK] 对话状态:', event.state)
    // 对话状态变化时,可用于更新字幕
    if (event.state === 'idle' || event.state === 'listening') {
      onSubtitleOff()
    }
  },
  onError(error: any) {
    console.error('[E2E SDK] Agent 错误:', error.code, error.message)
    onError?.(error)
  },
}
前端只需要监听这些回调,就能实现实时字幕、智能打断等交互:
// src/stores/app.ts — 语音输入(真实代码)
/**
 * 开始语音输入(E2E 内置 ASR,无需外部 SDK)
 */
async startVoiceInput(): Promise<void> {
  if (!appState.avatar.agent) return
  appState.asr.isListening = true
  try {
    await avatarService.startASR(appState.avatar.agent)
  } catch (error) {
    console.error('[AppStore] startASR 失败:', error)
    appState.asr.isListening = false
  }
}

/**
 * 停止语音输入
 */
async stopVoiceInput(): Promise<void> {
  if (!appState.avatar.agent) return
  appState.asr.isListening = false
  try {
    await avatarService.stopASR(appState.avatar.agent)
  } catch (error) {
    console.error('[AppStore] stopASR 失败:', error)
  }
}
这就是持续感知:不是"听见一句话",而是持续知道现场正在发生什么。
专属智脑:知道自己是面试官
面境的智能体不是通用 Chatbot。通过星云控制台配置的身份、人设、规则和面试能力,它知道"我是面境,一位资深面试官,我应该围绕岗位考察重点循序渐进地提问"。
而支撑这套能力的"大脑",用户可以按需自由选择。在星云控制台的服务配置中,大脑一栏同时提供豆包、OpenAI 兼容协议等多种第三方大模型接入——如果你已有习惯使用的大模型,可以直接接入,身份、人设和业务知识无缝迁移。如果没有现成的大模型,也可以使用星云自研的智脑:它与平台的感知、表达和状态管理体系深度耦合,在具身交互场景下响应更快、上下文理解更准,开箱即用,无需自行采购或部署模型。
无论选择豆包还是智脑,前端代码完全一致——调用大模型推理只需要一行:
// src/stores/app.ts — 发送消息(真实代码)
/**
 * 发送消息(E2E:一行 ask() 搞定 文本→LLM→播报 全链路)
 */
async sendMessage(): Promise<string | undefined> {
  if (!appState.ui.text || !appState.avatar.agent) return

  const text = appState.ui.text
  appState.ui.text = ''

  try {
    // 显示用户输入为字幕
    appState.ui.subTitleText = text
    // E2E 全链路:文本 → 大模型推理 → 具身智能体播报
    await avatarService.ask(appState.avatar.agent, text)
    return 'success'
  } catch (error) {
    console.error('[AppStore] ask 失败:', error)
    throw error
  }
}
传统方案里,这一行背后需要你自己对接 LLM API、拼接 system prompt、管理上下文窗口、处理流式返回。而在端到端具身交互智能架构下,专属智脑把身份、知识、规则、任务全部内化——前端只管发文本,剩下的智能体自己完成。大脑选豆包还是智脑,对业务代码零影响。
从通用回答能力,升级为面向具体身份、岗位和场景的智能体能力。
多模态表达:不只是念稿
面境的智能体在回答时,语言、语气、表情、手势和身体动作是统一生成、同步呈现的。它不会面无表情地朗读一段文字,而是像真人面试官一样,用自然的语气提问,配合适当的手势和表情。
这种统一表达由 SDK 的状态机驱动,前端通过回调感知当前表达状态:
// src/services/avatar.ts — 表达层状态流转(真实代码)
onAgentStateChange(state: any) {
  console.log('[E2E SDK] Agent 状态:', state)
  onStateChange(typeof state === 'string' ? state : state?.type || '')
}
不是 TTS 播放,而是实时生成统一、连续、同步的具身表达。 更关键的是,表达过程中感知仍然持续运行——onASRResult 和 onConversationChange 在智能体说话的同时照常工作,所以你随时可以打断它。
AI 端渲:低延迟、弱网可用
面境通过星云的端侧实时渲染能力,将智能体画面直接在前端浏览器中渲染,不需要持续依赖云端 GPU 和视频流传输。
在代码中,端渲的接入非常简单——只需提供一个 DOM 容器:
// src/services/avatar.ts — 端侧渲染接入(真实代码)
const containerEl = document.getElementById(this.containerId)
if (!containerEl) {
  throw new Error(`容器 #${this.containerId} 不存在,请确保 AvatarRender 组件已渲染`)
}

// 1. 创建 E2E 实例(SDK 自动在容器内启动端侧渲染)
const agent = new window.XingyunAvatarAgent({
  container: containerEl,
  appId,
  appSecret,
  gatewayServer: SDK_CONFIG.GATEWAY_URL,
  onMessage(error: any) {
    console.error('[E2E SDK] 渲染错误:', error.code, error.message)
  },
  agentCallbacks: { /* ... */ },
})

// 2. 初始化(建立三条连接:感知/大脑/表达)
await agent.init({
  onDownloadProgress(progress: number) {
    console.log(`[E2E SDK] 资源下载进度: ${progress.toFixed(0)}%`)
  },
})
SDK 加载后,所有渲染都在浏览器本地完成。这意味着更低的延迟、更少的带宽占用,以及弱网环境下依然可以运行的稳定性。
对于面试这种需要实时对话的场景,低延迟就是体验本身。
数字行动与物理行动:从"生成一段文字"到"自然地表达出来"
传统智能体的输出方式是一段文字。面境进一步为智能体补上了多模态表达与行动层——在屏幕端,智能体不仅生成内容,还通过语音、口型、表情、手势和身体动作把答案自然地"说出来、演出来、表达出来"。
这整个链路在前端只需要一行代码触发:
// 用户输入文本 → 智能体推理 → 语音播报 + 口型 + 表情 + 手势 + 身体动作
// 所有表达形式在同一次交互中统一生成,而非各自独立播放
await agent.ask('请介绍一下你做过的最复杂的项目')
而打断也是即时的:
// src/services/avatar.ts — 客户端即时打断(真实代码)
/**
 * 客户端打断当前播报
 */
interrupt(agent: any): void {
  agent.interrupt('speak')
}
这就是数字行动:智能体不再停留在"理解问题、生成文字答案",而是能够以具身交互智能体的形式,在真实终端上与用户自然互动。传统管线版需要手动拼接 ASR → LLM → TTS → SSML → ActionManager 流式分片共 2000+ 行代码才能实现的表达能力,在端到端具身交互智能架构下,缩减为一行 agent.ask()。
在屏幕端,这套能力体现为数字行动;当同一个智能体走进人形机器人或线下实体设备时,同样的感知—理解—决策—表达链路延伸为物理行动——在真实物理空间中与人自然交互。同一个智能体,可以拥有不同的身体;智能体持续存在,身体不断升级。五项核心能力,一套体系,两种落地形态。
终面:沉浸式交互的产品设计
技术底座之上,面境在产品设计上也做了差异化。
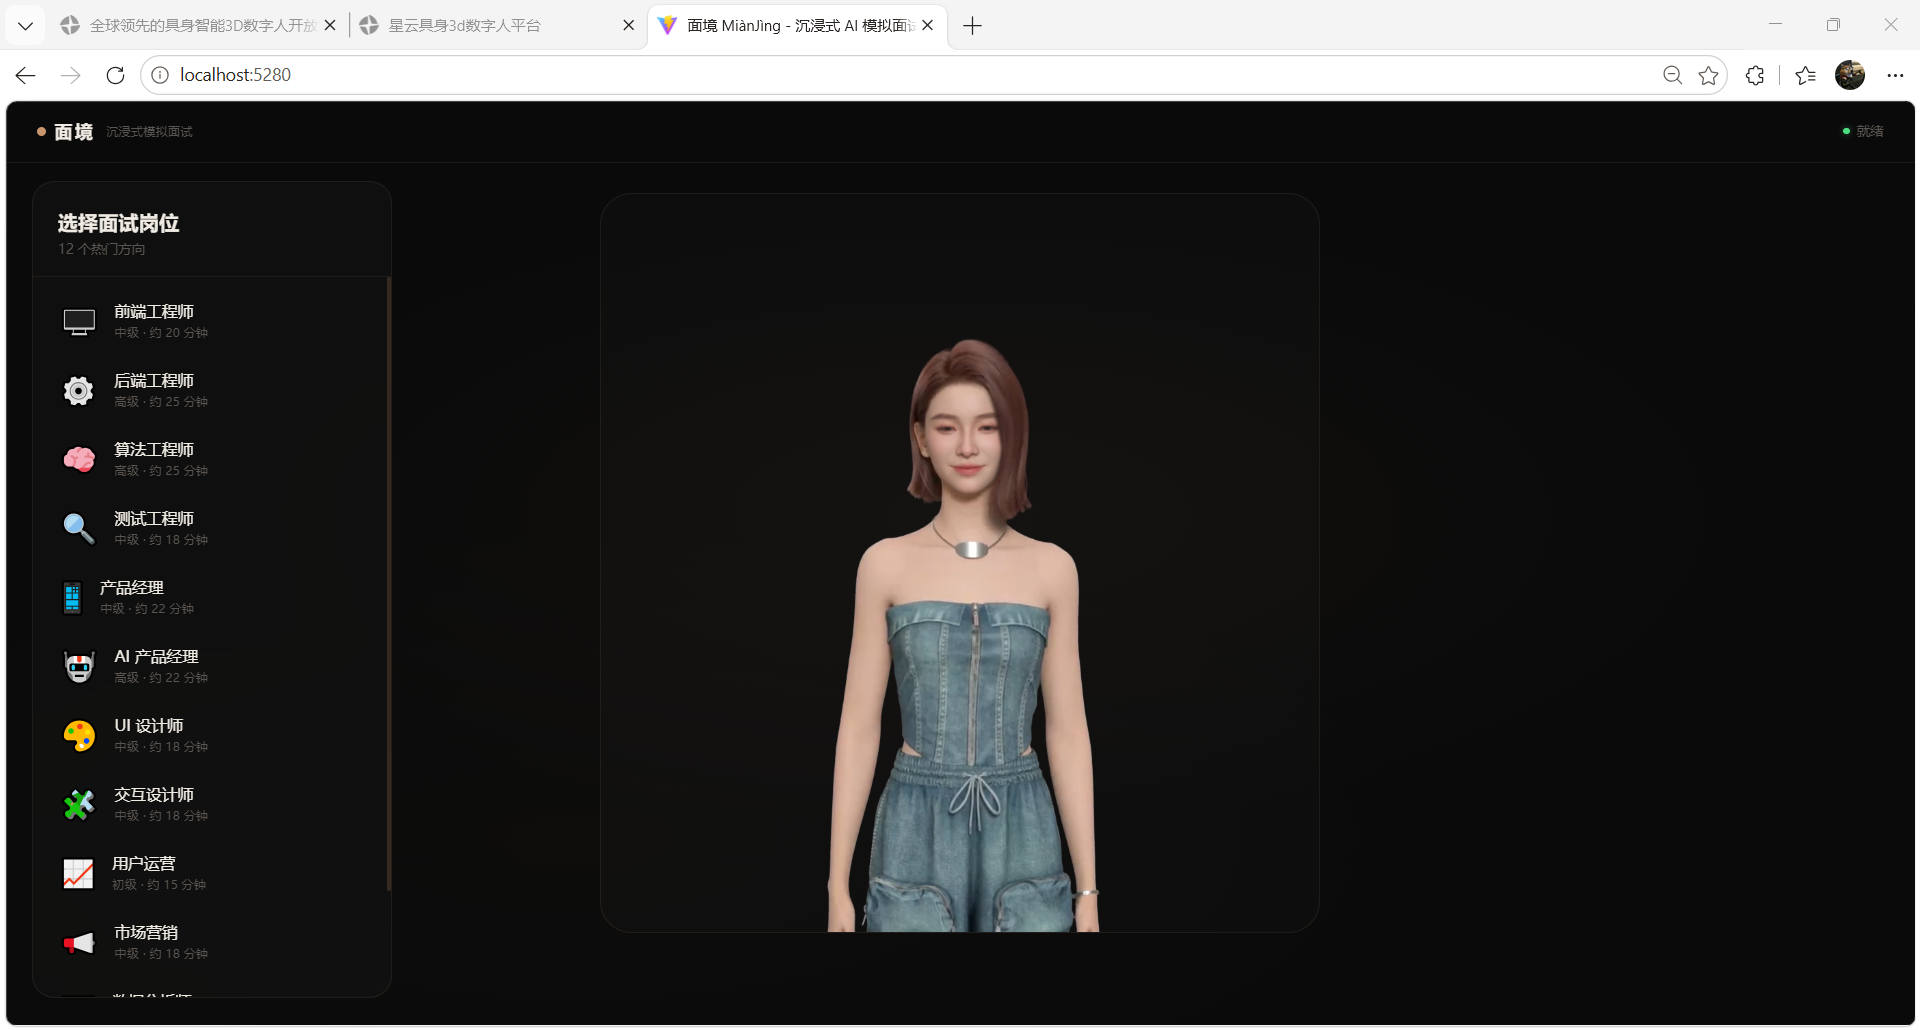
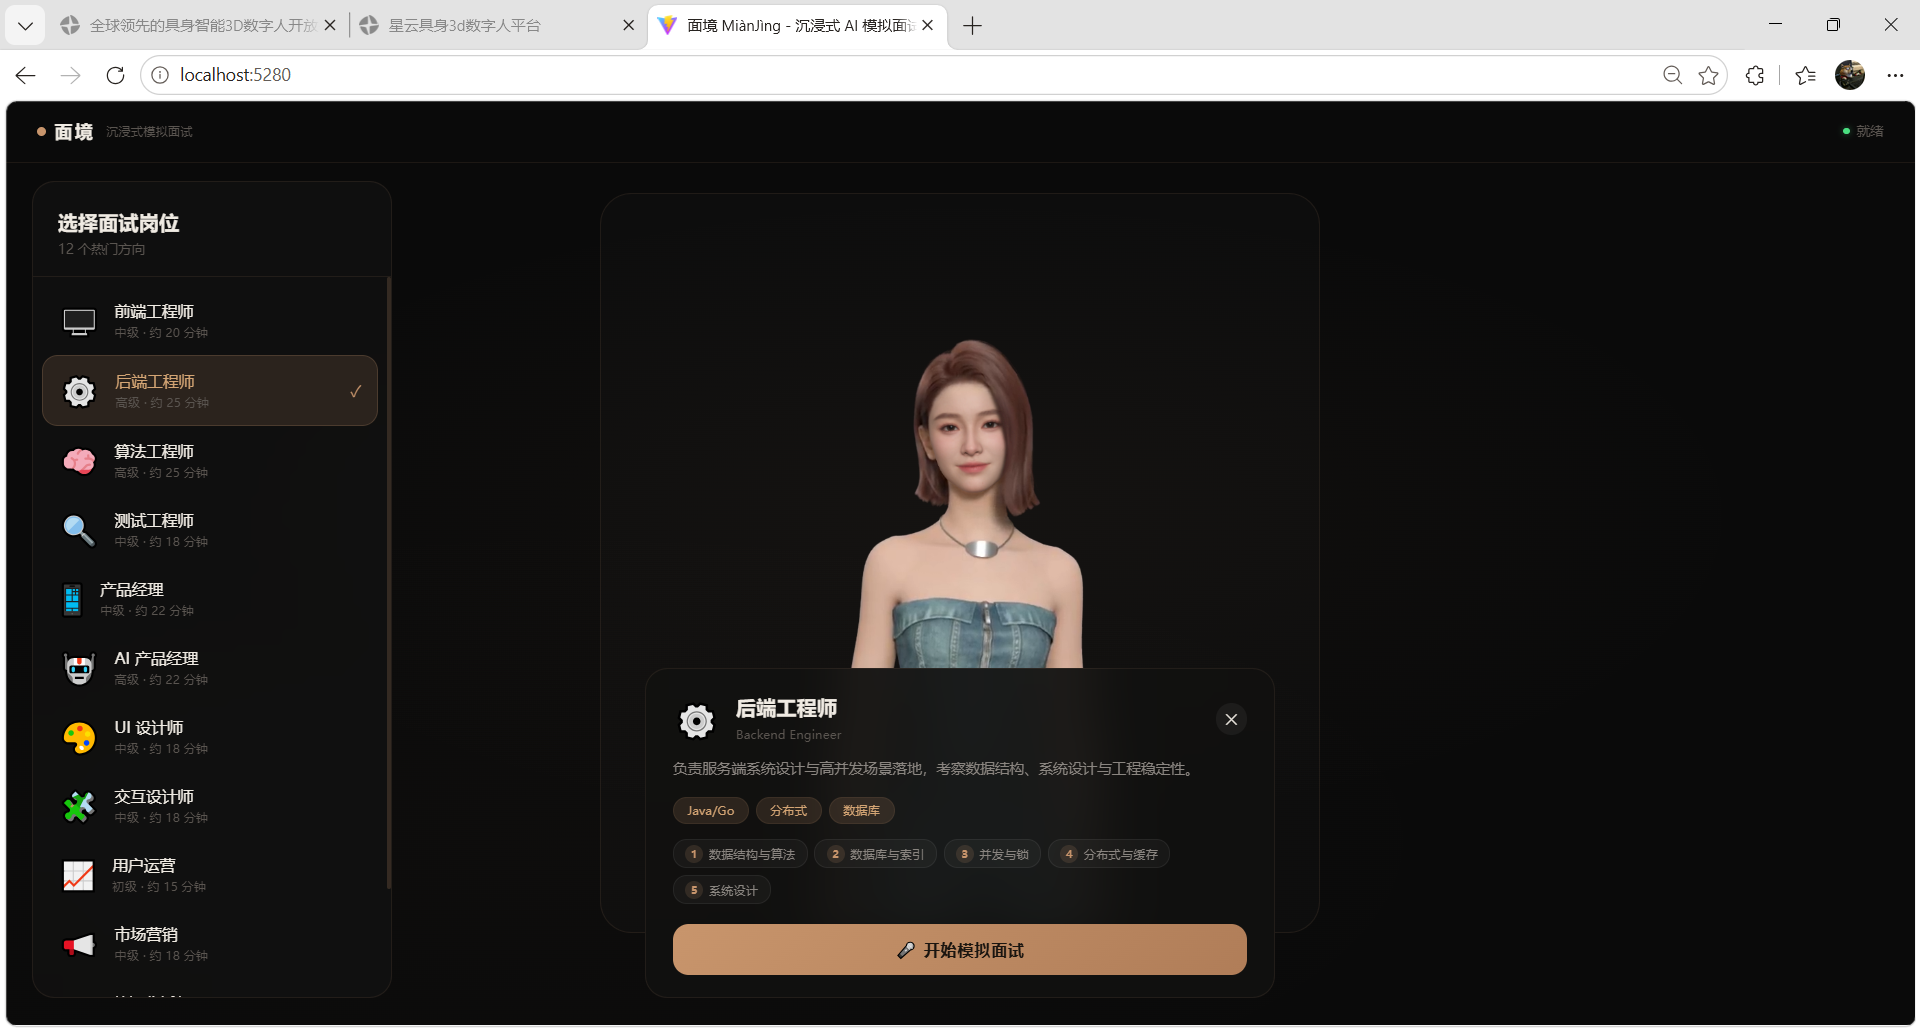
全屏沉浸式布局:具身交互智能体占据屏幕中央,高度 80vh,是整个产品的绝对主角。没有多余的侧边栏、没有复杂的导航,用户打开页面就面对面试官,像走进一间真实的面试室。
极简交互流:左侧滑入岗位列表 → 选中后底部浮出岗位详情 → 点击"开始模拟面试"进入对话模式 → 底部玻璃态面板支持文字输入、语音输入和实时打断。
琥珀金主题:炭黑底色(#0a0a0a)搭配琥珀金强调色(#c8956c),营造高端私人面试教练的视觉气质,和市面上千篇一律的蓝色科技风形成明显区隔。
这些设计选择都服务于同一个目标:让具身交互智能体成为用户体验的核心,而不是让技术本身成为焦点。
复盘:端到端具身交互智能,让 AI 通过屏幕进入真实世界
从传统管线到端到端 SDK,面境的实战经历验证了一个核心认知:
端到端不是 ASR + LLM + TTS 的简单拼接,而是围绕一次完整的人机交互,把感知、理解、决策、表达和行动连接成一套持续运行的系统。
| 对比维度 | 传统管线 | 端到端具身交互智能 |
|---|---|---|
| 核心代码量 | 2000+ 行 | ~500 行 |
| 首字响应 | 1.5 ~ 3 秒 | ~500ms |
| 打断能力 | 需手动管理状态 | 客户端即时生效 |
| 状态同步 | 模块间各自独立 | 全链路统一流转 |
| 部署复杂度 | 三套服务分别对接 | 一个 SDK 全搞定 |
面境只是端到端具身交互智能的一种落地形态。同一个智能体,今天可以是 Web 端的 AI 面试官,明天可以出现在手机、Pad、AI 屏幕甚至人形机器人上——身体可以变化,但身份、知识和业务能力持续复用。
魔珐星云是一套端到端具身交互智能平台,让 AI 通过屏幕和机器人进入真实世界,成为能够感知、理解、表达并行动的智能体。
这不只是技术架构的升级,而是 AI 从"对话框"走向"真实交互"的必经之路。
如果你想亲自体验端到端具身交互智能的魅力,或者基于魔珐星云平台搭建属于自己的具身交互智能体,欢迎访问魔珐星云官网,开启你的具身交互智能实战之旅:https://xingyun3d.com?utm_campaign=daily&utm_source=CSDNwanfen2&utm_medium=&utm_term=&utm_content=

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献46条内容

所有评论(0)