ICRA 2026 | OmniVLA:面向机器人导航的全模态视觉-语言-动作模型【文献解读】
文献:OmniVLA: An Omni-Modal Vision-Language-Action Model for Robot Navigation
会议:IEEE International Conference on Robotics and Automation(ICRA 2026)
作者:Noriaki Hirose, Catherine Glossop, Dhruv Shah, Sergey Levine
机构:UC Berkeley / Toyota Motor North America / Princeton University
论文地址:https://arxiv.org/abs/2509.19480
项目主页:https://omnivla-nav.github.io/
开源代码:https://github.com/NHirose/OmniVLA
1. 文献概述
OmniVLA 研究的是一个非常具体但长期没有被统一解决的问题:机器人导航目标并不天然只有一种表达方式。同一个导航任务可以通过自然语言描述,例如“沿着墙走到入口”;可以通过二维目标位姿或 GPS 坐标指定“去哪里”;也可以通过一张目标位置的第一视角图像告诉机器人“到达与这张图对应的位置”。现实任务甚至经常需要这些信息同时出现,例如“到达这个 GPS 位置,并沿草地一侧行驶”。
过去的大多数视觉导航策略通常围绕某一种目标模态单独训练:图像目标导航、二维位姿目标导航、语言目标导航各自形成独立方法。这不仅使模型使用方式受限,也导致大量数据无法联合使用——没有语言标注的数据无法直接训练语言策略,没有 GPS 的数据无法直接训练位姿策略。OmniVLA 的核心思路不是再训练三个彼此独立的专家,而是建立一个统一的 Omni-Modal Vision-Language-Action(全模态视觉-语言-动作)导航模型,让不同目标模态映射到共享表示空间,并通过随机模态选择与注意力掩码共同训练。
论文最终形成两种模型:一是以 OpenVLA 为基础的大模型 OmniVLA,利用大规模视觉-语言与跨机器人预训练知识;二是面向算力受限部署的 OmniVLA-edge,基于 ViNT 风格的轻量导航 Transformer。训练数据约 9,500 小时、覆盖 10 种平台,并通过真实机器人实验验证语言、二维目标位姿、第一视角目标图像、多模态组合、新模态微调以及跨机器人本体迁移能力。
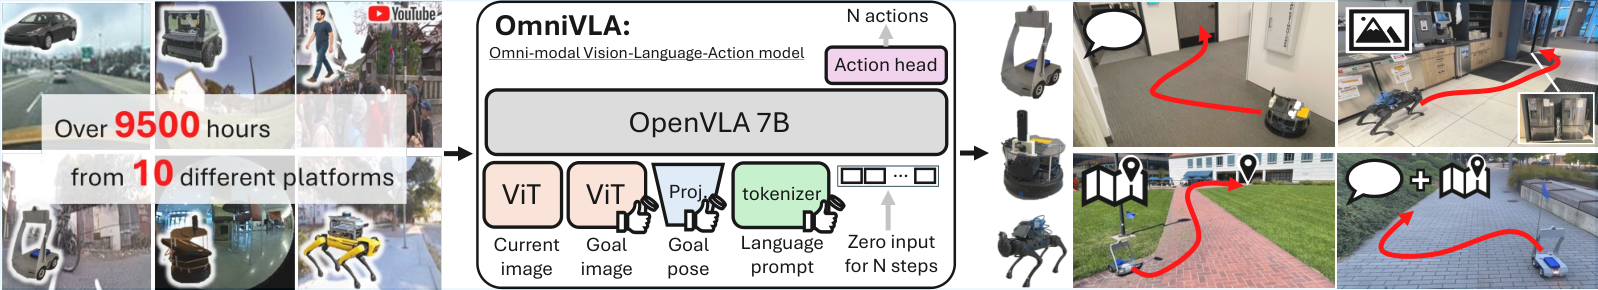
2. 论文要解决的关键科学问题与技术挑战
2.1 单模态导航策略无法覆盖真实的人机交互方式
传统目标条件导航通常固定一种任务表示:
- Egocentric goal image:给定目标位置的第一视角图像;
- 2D goal pose:给定机器人坐标系或地图坐标系中的二维目标位置;
- Language prompt:使用自然语言描述目标或行为约束。
这三类信息本质上分别强调视觉匹配、几何关系和语义意图。单独学习任何一种模态,都容易让模型形成偏向某一类特征的表示。OmniVLA 希望回答的问题是:
是否可以在一个端到端导航策略中统一学习几何、视觉与语义目标,使模型根据实际可获得的信息自由组合条件?
这也是论文中“Omni-Modal”与一般“Multi-Modal”的关键区别:重点不是简单地把多种输入拼在一起,而是允许不同样本拥有不同模态、允许某些模态缺失,并允许推理时任意选择一个或多个目标模态。
2.2 数据集模态不完整且严重不平衡
现实中的公开导航数据并没有统一标注格式。某些数据拥有轨迹和目标图像,某些拥有 GPS,某些只有语言标注,另一些来自汽车或人类视频,动作空间和机器人本体甚至完全不同。
如果直接把多模态输入全部拼接训练,会出现两个问题:
- 某个模态只在少量数据中出现,模型可能忽略它;
- 某个模态缺失时,网络输入结构不一致,难以共享训练样本。
论文因此引入 modality dropout(模态随机丢弃) 与 attention masking(注意力掩码):每个样本只激活随机选中的可用模态,其余模态对应 token 被注意力掩码屏蔽,从而让不同数据源可以进入同一个训练流程。
2.3 跨本体数据的动作分布不一致
OmniVLA 希望利用尽可能多的数据,而大规模数据之一 BDD-V 来自汽车行驶视频。汽车与低速小型移动机器人之间存在明显 embodiment gap:
- BDD-V 约 1 Hz,而其他导航数据通常按 3 Hz 使用;
- 汽车速度远高于小型机器人;
- GPS 动作标签精度有限;
- 车内仪表台会干扰基于视觉几何的碰撞代价。
因此论文不能简单把 BDD-V 原始动作直接加入训练,而是额外训练 MBRA reannotation model(基于模型的动作重标注模型),把高速汽车数据重新转成目标机器人可执行的低速轨迹。
2.4 模型不仅要识别“去哪里”,还要理解“怎么去”
二维位姿可以非常明确地告诉机器人 where,但不能表达“沿墙走”“走草地”“从两个物体之间穿过”等 how。自然语言能表达行为约束,却可能缺乏精确的远距离几何目标。
OmniVLA 进一步研究二者组合:
2D goal pose: where + language: how → navigation action \text{2D goal pose: where} + \text{language: how} \rightarrow \text{navigation action} 2D goal pose: where+language: how→navigation action
这使模型从“多种输入任选一种”进一步走向真正的跨模态组合推理。
2.5 大模型能力与机器人端部署算力之间存在冲突
完整 OmniVLA 以 OpenVLA 为基础,总规模约 7.5B,其语言主干为 Llama 2 7B。这种模型具有更强的语言先验和跨模态泛化能力,但不适合所有边缘设备实时运行。因此作者同步设计约 50M 参数的 OmniVLA-edge,用于研究资源受限时的性能与泛化能力。
3. OmniVLA 总体技术路线
整个方法可以概括为:
异构导航数据 → 动作重标注/统一采样 → 多模态编码 → 共享 token 空间 → 随机模态掩码 → VLA 主干 → N-step action chunk \text{异构导航数据} \rightarrow \text{动作重标注/统一采样} \rightarrow \text{多模态编码} \rightarrow \text{共享 token 空间} \rightarrow \text{随机模态掩码} \rightarrow \text{VLA 主干} \rightarrow \text{N-step action chunk} 异构导航数据→动作重标注/统一采样→多模态编码→共享 token 空间→随机模态掩码→VLA 主干→N-step action chunk
训练阶段同时利用多种数据源和多种目标条件;部署阶段则根据任务拥有的信息选择语言、目标位姿、目标图像中的任意一种或组合。
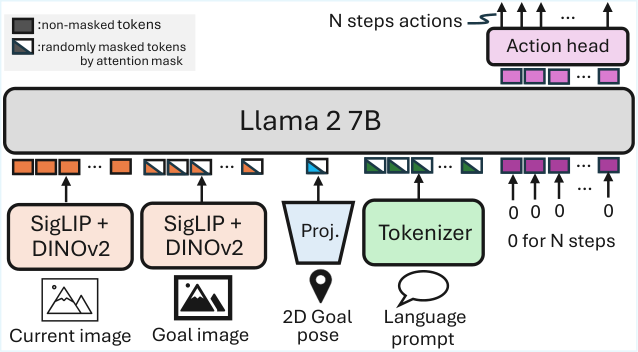
4. OmniVLA 网络结构与算法原理
4.1 输入与输出定义
论文将策略写为:
{ a ^ i } i = 1 N = π θ ( I c , I g , p g , l g , t m ) \{\hat{\mathbf a}_i\}_{i=1}^{N}=\pi_{\theta}(I_c,I_g,\mathbf p_g,l_g,t_m) {a^i}i=1N=πθ(Ic,Ig,pg,lg,tm)
其中:
- I c I_c Ic:当前机器人第一视角图像;
- I g I_g Ig:目标位置第一视角图像;
- p g \mathbf p_g pg:二维目标位姿;
- l g l_g lg:自然语言目标或行为指令;
- t m t_m tm:当前样本随机选中的目标模态组合;
- a ^ i \hat{\mathbf a}_i a^i:第 i i i 个预测导航动作;
- N N N:Action Chunk 中的动作步数。
论文统一把输出记为 a ^ i \hat{\mathbf a}_i a^i,即一段未来动作序列。实际机器人接口最终使用该策略生成的导航输出控制机器人,并向移动机器人发送线速度与角速度命令。因此这里的 VLA “Action”应理解为导航控制动作/轨迹级输出,而不是机械臂 VLA 中常见的末端执行器位姿或关节动作。
4.2 当前视觉观测编码
OmniVLA 继承 OpenVLA 的视觉-语言主干设计。当前图像通过 SigLIP + DINOv2 视觉编码器提取特征:
- SigLIP 更偏重视觉-语言语义对齐;
- DINOv2 提供强视觉表征和空间/外观特征;
- 两者组合使网络同时保留语义和视觉结构信息。
这种设计对于导航尤其重要,因为机器人既要判断“这是什么”,又要理解场景中的可通行区域、结构和目标相对位置。
4.3 目标图像编码
目标图像 I g I_g Ig 使用与当前图像相同类型的视觉主干编码,并转换为 LLM 可处理的视觉 token。于是模型可以在共享特征空间内比较:
I c ↔ I g I_c \leftrightarrow I_g Ic↔Ig
这类图像目标导航本质上需要学习一种视觉相对定位与可达性表示:当前观测与目标观测越接近,策略越需要输出趋向目标并最终停止的动作。
4.4 二维目标位姿编码
二维目标位姿 p g \mathbf p_g pg 不经过视觉模型,而是通过一个 Projector(投影器) 转换到与 LLM token 兼容的嵌入空间:
z p = f p r o j ( p g ) \mathbf z_p=f_{proj}(\mathbf p_g) zp=fproj(pg)
其目的不是把坐标“翻译成文字”,而是把低维几何目标转换成与视觉 token、语言 token 可共同参与 Transformer 注意力计算的表示。
实际评估时,作者使用 GPS 获取机器人和目标的位置,并计算机器人相对目标的二维位姿 p g \mathbf p_g pg。因此模型接收的是相对导航几何条件,而不是直接把绝对经纬度输入语言模型。
4.5 语言指令编码
自然语言 l g l_g lg 经 tokenizer 转换为文本 token,并直接利用预训练 LLM 的语义先验。完整 OmniVLA 的核心优势之一,就是继承了大模型已经获得的开放词汇、空间关系和行为描述能力,因此即使训练语言数据主要是“move toward X”这类目标描述,模型仍可在测试中处理训练集未直接出现的 OOD 行为语言,例如:
- move along the wall;
- move on the grass;
- move between objects A and B。
这也是完整 OmniVLA 在语言泛化上明显强于 50M OmniVLA-edge 的主要原因之一。
4.6 共享 Token 空间与 Transformer 融合
视觉、位姿和语言条件最终被映射到同一个 token 序列中,并输入 LLM 主干:
Z = [ Z c , Z g , Z p , Z l , Z a ] \mathbf Z=[\mathbf Z_c,\mathbf Z_g,\mathbf Z_p,\mathbf Z_l,\mathbf Z_a] Z=[Zc,Zg,Zp,Zl,Za]
其中 Z a \mathbf Z_a Za 可以理解为对应未来 Action Chunk 的动作位置/占位表示。Transformer 通过自注意力建立不同 token 之间的依赖,使目标几何、视觉场景、语义行为和当前环境共同影响动作输出。
这与简单的“各模态分别预测,再做后融合”不同。OmniVLA 的核心是让导航决策发生在共享 Transformer 表示中,从而促使模型学习跨模态可复用的导航概念,例如“目标方向”“可通行区域”“门口”“沿边界移动”等。
4.7 Action Head 与 Action Chunk
作者参考 OpenVLA-OFT,在 LLM 输出后增加线性 Action Head,一次预测未来 N N N 步动作:
H a → f a c t i o n ( H a ) → { a ^ 1 , … , a ^ N } \mathbf H_{a}\rightarrow f_{action}(\mathbf H_a)\rightarrow\{\hat{\mathbf a}_1,\ldots,\hat{\mathbf a}_N\} Ha→faction(Ha)→{a^1,…,a^N}
训练中:
N = 8 , f = 3 H z N=8,\qquad f=3\ \mathrm{Hz} N=8,f=3 Hz
论文将其描述为约 2.4 s 的未来动作序列。Action Chunk 相比单步动作有两个好处:一是降低逐帧预测造成的抖动;二是使模型能够显式学习短时未来轨迹结构,而不只是瞬时转向。
5. Modality Dropout:OmniVLA 最关键的训练机制
5.1 为什么不能直接把所有模态全部输入
不同数据集拥有的条件不同。如果模型要求每条数据都同时具有图像目标、位姿和语言,那么可使用数据量会急剧下降;如果缺失模态统一填零,但训练时从不主动改变组合,模型又容易依赖出现频率最高的模态。
因此 OmniVLA 对每个样本从其可用目标模态集合中随机选择一个子集:
t m ∼ P ( M a v a i l a b l e ) t_m\sim\mathcal P(\mathcal M_{available}) tm∼P(Mavailable)
例如 GNM 样本可能选择:
{ 2D pose } , { goal image } , { 2D pose, goal image } \{\text{2D pose}\},\quad \{\text{goal image}\},\quad \{\text{2D pose, goal image}\} {2D pose},{goal image},{2D pose, goal image}
然后为未选中或本身缺失的模态建立 attention mask,使 Transformer 不关注这些 token。
5.2 Modality Dropout 与 Modality Masking 的关系
这两个概念容易混淆:
- Modality Dropout:训练时随机决定“当前样本使用哪些目标模态”,是一种数据与条件采样策略;
- Modality Masking / Attention Mask:网络层面屏蔽未使用 token,是实现模态缺失的计算机制;
- 推理时也可以通过 mask 只激活用户当前提供的模态。
因此它并不是普通神经网络 Dropout 随机将单个神经元置零,而是在任务条件层面随机丢弃整个模态。
5.3 为什么这种方法能产生跨模态表示
如果某个场景同时拥有目标位姿和目标图像,训练过程中模型有时只看位姿,有时只看目标图像,有时二者同时看。为了在三种条件下都输出相同或相近的正确轨迹,网络被迫把不同模态映射到某种共享的“导航任务语义”中。
可以将这一过程理解为隐式约束:
f p o s e ( p g ) ≈ f i m a g e ( I g ) ≈ f l a n g ( l g ) at the task-semantic level f_{pose}(\mathbf p_g)\approx f_{image}(I_g)\approx f_{lang}(l_g)\quad \text{at the task-semantic level} fpose(pg)≈fimage(Ig)≈flang(lg)at the task-semantic level
论文没有显式加入跨模态对比损失,上述一致性主要由共享动作监督 + 随机模态组合训练产生。这一点是 OmniVLA 的关键设计价值:跨模态对齐不是依赖额外人工配对损失,而是在统一导航行为监督下形成。
6. 训练目标函数
6.1 主模仿学习损失
模型首先使用 N 步专家/重标注动作做监督模仿:
J i l = 1 N ∑ i = 1 N ∥ a i r e f − a ^ i ∥ 2 2 J_{il}=\frac{1}{N}\sum_{i=1}^{N}\left\|\mathbf a_i^{ref}-\hat{\mathbf a}_i\right\|_2^2 Jil=N1i=1∑N airef−a^i 22
该损失要求整个预测 Action Chunk 接近参考动作序列。
6.2 语言目标到达损失
对于 LeLaN 数据,作者加入目标物体位置监督:
J o b j = ∥ p o b j − a ^ N ∥ 2 2 J_{obj}=\left\|\mathbf p_{obj}-\hat{\mathbf a}_{N}\right\|_2^2 Jobj=∥pobj−a^N∥22
它约束 Action Chunk 的最后一步靠近语言对应的目标物体位置 p o b j \mathbf p_{obj} pobj,使语言 grounding 不只是“语义上理解了物体”,还必须落到实际运动终点。
该损失只在 LeLaN 数据上启用:
m o b j = { 1 , LeLaN sample 0 , otherwise m_{obj}=\begin{cases}1,&\text{LeLaN sample}\\0,&\text{otherwise}\end{cases} mobj={1,0,LeLaN sampleotherwise
6.3 动作平滑正则项
作者进一步约束相邻预测动作变化:
J s m = 1 N − 1 ∑ i = 1 N − 1 ∥ a ^ i + 1 − a ^ i ∥ 2 2 J_{sm}=\frac{1}{N-1}\sum_{i=1}^{N-1}\left\|\hat{\mathbf a}_{i+1}-\hat{\mathbf a}_{i}\right\|_2^2 Jsm=N−11i=1∑N−1∥a^i+1−a^i∥22
该项抑制 Action Chunk 内部突变,使轨迹更加平滑。
6.4 总目标函数
最终训练目标为:
min θ J = J i l + m o b j J o b j + J s m \min_{\theta}J=J_{il}+m_{obj}J_{obj}+J_{sm} θminJ=Jil+mobjJobj+Jsm
可以看到,OmniVLA 的策略优化并不是强化学习,而是以监督模仿学习为主,通过目标到达和轨迹平滑项加入导航任务结构先验。
7. 数据构建:9,500 小时、多平台、多模态导航数据
表 1. 论文 Table I:OmniVLA 训练数据混合
| 数据集组 | 平台 | 最大速度 | 使用时长 | 原始动作 | 采样频率 | 动作标签 | 语言 | 2D Pose | Ego. Image | Satellite | 场景 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| GNM mixture | 6 platforms | 0.5–5.0 m/s | 62.0 h | ✓ | 3.0 Hz | raw | — | ✓ | ✓ | — | 越野、办公室、人行道 |
| LeLaN mixture | 3 platforms | 0.5–1.0 m/s | 128.7 h | — | 3.0 Hz | NoMaD | ✓* | ✓* | — | — | 办公室、家庭、人行道 |
| FrodoBots-2K | ERZ | 1.0 m/s | 700 h | ✓ | 3.0 Hz | MBRA | — | ✓ | ✓ | ✓ | 人行道 |
| BDD-V | Car | 20.0 m/s | 8680 h | ✓ | 1.0 Hz | modified MBRA | — | ✓ | ✓ | — | 道路 |
其中 * 表示合成标签。论文将 GNM 与 LeLaN 本身视为多个公开数据集的混合,因此整个训练语料共涉及 13 个公开数据集、10 种平台。四组数据按论文统计约为 9,500 小时级别。
GNM mixture 由 RECON、CoryHall、TartanDrive、Seattle、SCAND、SACSoN 和 GO Stanford 4 等组成;LeLaN 则利用 SACSoN、GO Stanford 2/4、HumanWalk 与 YouTube 等机器人及非机器人数据,并附带合成语言/动作标注。
8. BDD-V 动作重标注:如何把汽车视频用于低速机器人
BDD-V 是整个训练集中时长最大的组成部分,但它与小型移动机器人差异最大。作者采用修改后的 MBRA 进行动作重标注,其逻辑可以拆成四步。
首先,使用 GNM + BDD-V 混合数据训练 MBRA,使网络适应 BDD-V 的道路视觉分布。其次,原 MBRA 会利用估计三维点施加虚拟碰撞惩罚,但 BDD-V 图像中经常出现汽车仪表台,容易被误认为障碍物,因此作者只对 GNM 数据启用碰撞避免目标,避免模型因仪表台产生错误碰撞。再次,将生成轨迹的线速度限制在:
v ∈ [ 0 , 0.5 ] m / s v\in[0,0.5]\ \mathrm{m/s} v∈[0,0.5] m/s
角速度限制在:
ω ∈ [ − 1.0 , 1.0 ] r a d / s \omega\in[-1.0,1.0]\ \mathrm{rad/s} ω∈[−1.0,1.0] rad/s
最后,加入同轴双轴移动机器人的运动学约束,使重新生成的轨迹更加符合目标机器人运动特性。
这部分工作的重要性并不只是“数据清洗”。它说明 OmniVLA 的大规模训练建立在一个关键前提上:不同 embodiment 的数据必须先被映射到相容的导航行为分布中,否则单纯扩大数据量并不能形成有效的跨本体策略。
9. 训练配置与参数高效微调
完整 OmniVLA 的训练设置如下:
- Action Chunk: N = 8 N=8 N=8;
- 训练频率:3 Hz;
- 数据采样比例:LeLaN : GNM : FrodoBots : BDD-V = 4 : 1 : 1 : 1;
- OpenVLA 版本使用 8 张 H100;
- 单卡 batch size = 7;
- gradient accumulation = 4;
- 有效 batch size: 7 × 8 × 4 = 224 7\times8\times4=224 7×8×4=224;
- 对 OpenVLA 版本采用 LoRA,可训练参数约占总参数的 5%。
LoRA 的意义不仅是减少显存占用。OmniVLA 需要保留 OpenVLA 从互联网视觉-语言数据与跨本体机器人数据中获得的先验,如果完全重新训练全部参数,既昂贵,也可能破坏预训练表征。因此 LoRA 在这里承担的是参数高效适配 + 先验保持的双重作用。
10. 实验平台与任务设计
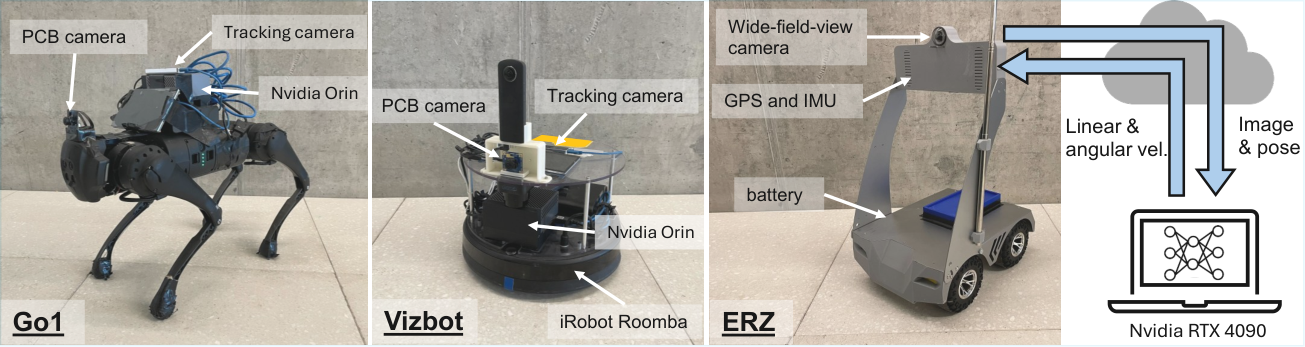
10.1 语言条件导航
作者在 40 个环境中进行语言导航实验,包括办公室、厨房区域、入口大厅、公园和人行道等,目标距离机器人初始位置约 5–30 m。
训练数据中的语言主要类似“move toward X”,为了验证大模型是否拥有超出训练模板的先验,实验中有一部分任务使用 OOD 行为语言,并在 17 个环境中额外加入起点与目标之间的障碍物。
评估不仅看是否最终到达目标,还单独统计:
- SR:总体成功率;
- Behavior:是否遵循 OOD 行为语言;
- SR S ^S S:简单、无障碍环境成功率;
- SR C ^C C:复杂、有障碍环境成功率。
10.2 第一视角目标图像导航
直接图像目标任务主要设置在 3 m 内。为了扩展导航距离,作者使用与 ViNT、NoMaD 等方法类似的 topological memory(拓扑记忆):
- 遥操作机器人走一遍目标路线;
- 按 1 Hz 记录图像节点;
- 部署时估计当前最接近的拓扑节点;
- 将下一节点图像作为 I g I_g Ig;
- OmniVLA 输出当前局部导航动作;
- 不断切换下一个目标节点,实现长距离导航。
因此需要特别区分:OmniVLA 本身负责局部目标条件动作生成,长距离图像导航依靠外部拓扑记忆进行目标分段。
10.3 二维目标位姿导航
二维目标位姿实验距离为 25–100 m。GPS 用于获取机器人与目标位置,并实时转换为相对目标位姿 p g \mathbf p_g pg。作者在 7 个环境、不同时间分别进行 3 次测试,以考虑 GPS 抖动带来的影响。
10.4 多模态组合导航
最有代表性的组合任务为:
2D pose (where) + language (how) \text{2D pose (where)}+\text{language (how)} 2D pose (where)+language (how)
实验覆盖 10 个环境,目标距离仍为 25–100 m。语言不再仅指定“去某个物体”,而是给出行为约束,例如沿墙、走草地、从两个物体之间通过。
11. 单模态实验结果
表 2. 论文 Table II:不同单一条件模态下的定量结果
| 方法 | Language SR | Behavior | SR S ^S S | SR C ^C C | 2D Pose SR | 2D Pose Prog. | Image SR | Image Prog. |
|---|---|---|---|---|---|---|---|---|
| CoW | 0.30 | 0.05 | 0.55 | 0.24 | — | — | — | — |
| LeLaN | 0.43 | 0.15 | 0.64 | 0.35 | — | — | — | — |
| CounterfactualVLA | 0.33 | 0.45 | 0.18 | 0.24 | — | — | — | — |
| MBRA-pose | — | — | — | — | 0.86 | 0.92 | — | — |
| NoMaD | — | — | — | — | 0.33 | 0.47 | 0.63 | 0.77 |
| ViNT | — | — | — | — | — | — | 0.50 | 0.68 |
| MBRA-image | — | — | — | — | — | — | 1.00 | 1.00 |
| SmolVLA | 0.10 | 0.15 | 0.00 | 0.12 | 0.38 | 0.70 | 0.38 | 0.45 |
| MiniVLA | 0.23 | 0.15 | 0.27 | 0.12 | 0.43 | 0.75 | 0.25 | 0.36 |
| OmniVLA-edge | 0.60 | 0.25 | 0.82 | 0.47 | 0.91 | 0.95 | 1.00 | 1.00 |
| OmniVLA | 0.73 | 0.65 | 1.00 | 0.65 | 0.95 | 0.98 | 1.00 | 1.00 |
其中 Prog. 表示到目标的部分进度。结果说明三个值得注意的现象。
第一,图像目标导航已经接近饱和。OmniVLA 与 MBRA-image 都达到 1.00 SR,因此这一任务本身不能单独证明大 VLA 的优势。
第二,二维位姿导航体现了统一大模型训练的收益。OmniVLA 的 SR 从 MBRA-pose 的 0.86 提升到 0.95,Prog. 从 0.92 提升到 0.98。
第三,最大的差距出现在语言导航尤其是 OOD 行为遵循。OmniVLA 的 Behavior 达到 0.65,而 LeLaN 为 0.15、CounterfactualVLA 为 0.45,表明大规模预训练语言模型的语义先验在“训练模板之外的行为描述”中发挥了明显作用。
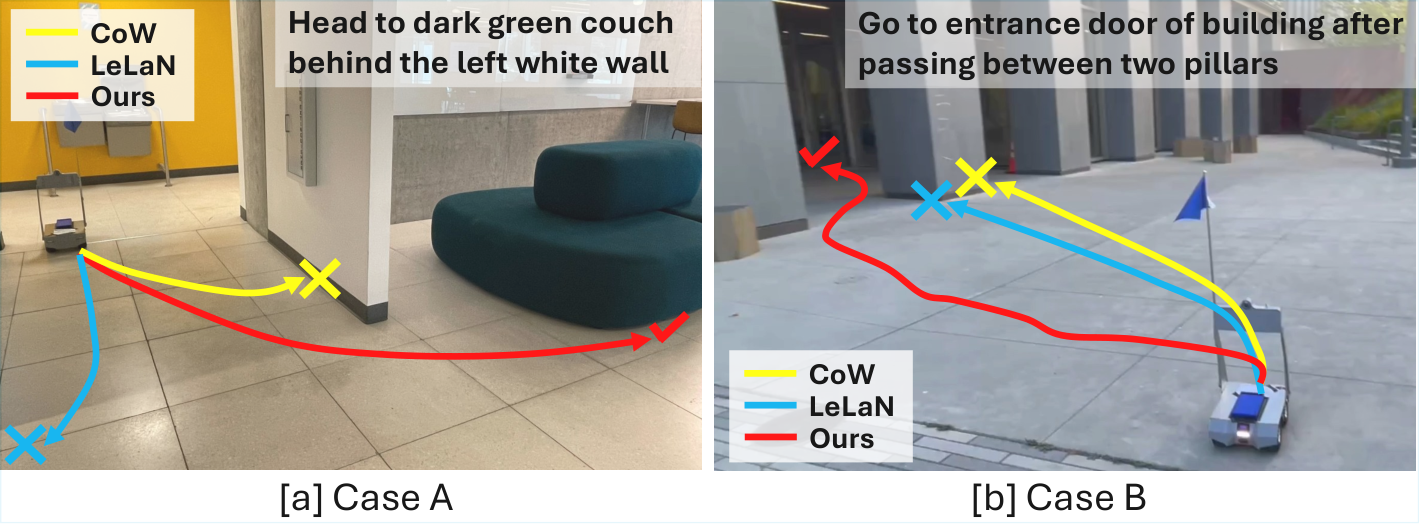
12. 多模态训练消融实验
论文使用 OmniVLA-edge 固定模型结构,对比“只训练单一模态”和“联合 omni-modal 训练”。其测试结果中,单模态专家与统一模型的关键差异如下。
表 3. 论文 Table III:多模态训练消融的关键测试结果
| 训练设置 | Language SR | 2D Pose SR | Ego. Image SR | Satellite Image SR |
|---|---|---|---|---|
| 单语言模态 | 0.43 | — | — | — |
| 单 2D Pose 模态 | — | 0.86 | — | — |
| 单 Ego. Image 模态 | — | — | 1.00 | — |
| 单 Satellite Image 模态 | — | — | — | 0.19 |
| Omni-modal 联合训练 | 0.60 | 0.91 | 1.00 | 0.57 |
最典型的是卫星图像模态:即使卫星图像并不是 OmniVLA 主训练阶段的核心模态,联合训练得到的导航表征仍显著提高了新模态学习能力。论文还指出,引入跨本体的 BDD-V 数据后,可以恢复大约一半原本失败的案例,说明数据多样性本身能够增强底层导航 affordance 表示。
13. “Where + How”:真正的多模态组合导航
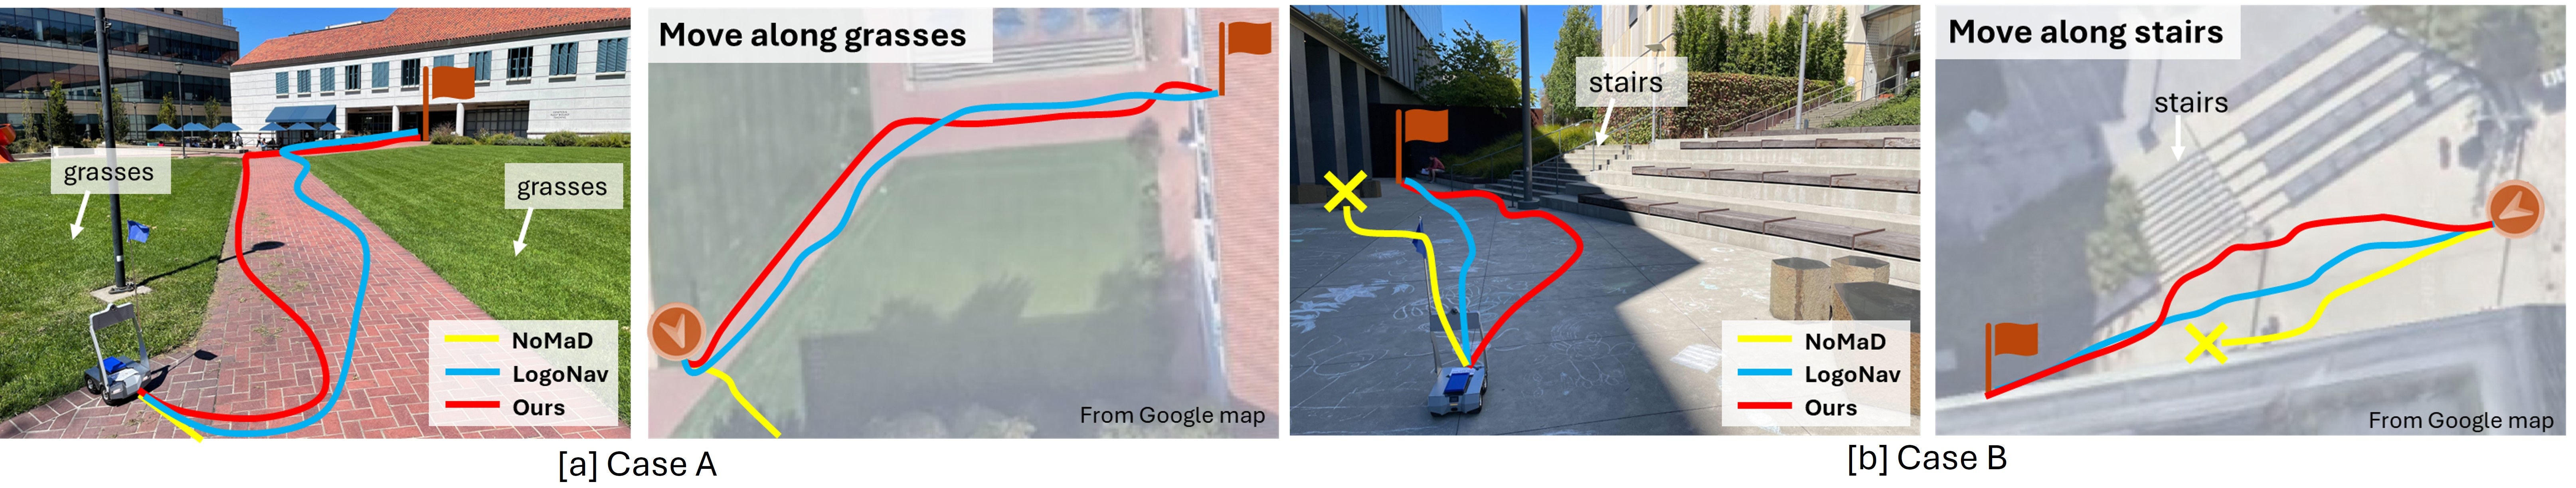
表 4. 论文 Table IV:二维目标位姿与语言联合条件实验
| 方法 | SR | Prog. | Behavior |
|---|---|---|---|
| SmolVLA | 0.10 | 0.35 | 0.20 |
| MiniVLA | 0.30 | 0.53 | 0.00 |
| NoMaD | 0.40 | 0.57 | — |
| MBRA-pose | 0.70 | 0.80 | — |
| OmniVLA | 0.80 | 0.86 | 0.60 |
| OmniVLA-edge | 0.30 | 0.56 | 0.10 |
完整 OmniVLA 达到 80% 成功率,同时 Behavior = 0.60。相较单独语言条件时 0.65 的 Behavior,仅下降约 0.05。这表明模型没有因为加入精确位姿条件就完全忽略语言约束。
这一实验比“单独支持三种模态”更重要,因为它证明 OmniVLA 确实学习到可组合的任务表示:位姿负责确定终点,语言改变到达终点的路径行为。
同时,OmniVLA-edge 在该任务上明显退化,说明小模型虽然能完成单一模态导航,却不一定拥有足够容量同时保持几何目标和复杂语言约束。
14. 适应新模态、新环境和新语言域
14.1 新目标模态:Satellite Goal Image
作者首先预训练一个不包含卫星图像模态的 OmniVLA-edge,然后冻结大部分网络,只把原来的目标图像编码器替换为卫星图像编码器,并仅训练被替换的编码器。
结果:卫星图像导航的成功率由单独训练专家的 0.19 提升到 0.62。
这表明预训练 OmniVLA 中已经形成了可复用的导航 affordance,新增模态只需要学习“如何把新输入映射到已有导航表示”,而不必重新学习完整的避障与到达行为。
14.2 少量新环境数据微调
作者仅采集 1.2 小时新环境数据进行微调。
表 5. 论文 Table V:少量新环境数据微调结果
| 模态 | 是否微调 | SR | Prog. |
|---|---|---|---|
| Satellite goal image | 否 | 0.57 | 0.75 |
| Satellite goal image | 是 | 0.83 | 0.92 |
| 2D goal pose | 否 | 0.81 | 0.90 |
| 2D goal pose | 是 | 0.86 | 0.96 |
新环境微调对卫星图像模态提升尤其明显,说明跨模态预训练模型能够以较少数据进行目标域适配。
14.3 新语言域微调
论文还使用 CounterfactualVLA/CAST 风格的新语言数据继续微调完整 OmniVLA。为了避免新语言数据破坏原有多模态平衡,作者在 fine-tuning batch 中保留原训练分布的一部分数据,而不是只使用新语言集。
微调后:
( S R , B e h a v i o r , S R S , S R C ) = ( 0.825 , 0.700 , 1.000 , 0.765 ) \left(SR,Behavior,SR^S,SR^C\right)=(0.825,0.700,1.000,0.765) (SR,Behavior,SRS,SRC)=(0.825,0.700,1.000,0.765)
原始模型对应为:
( S R , B e h a v i o r , S R S , S R C ) = ( 0.725 , 0.650 , 1.000 , 0.647 ) \left(SR,Behavior,SR^S,SR^C\right)=(0.725,0.650,1.000,0.647) (SR,Behavior,SRS,SRC)=(0.725,0.650,1.000,0.647)
这说明 OmniVLA 可以继续吸收新出现的语言任务数据,并提升复杂障碍环境下的语言遵循能力。
15. 跨本体泛化
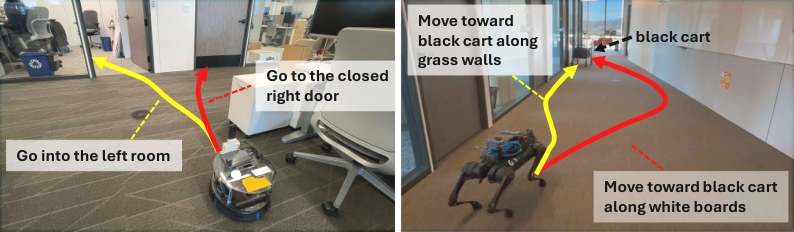
论文训练数据来自多个机器人与非机器人平台,因此作者进一步测试模型是否真正学到了与具体机器人外形弱耦合的导航表示。实验将模型部署到 VizBot 和 Unitree Go1,并使用与主要测试平台不同的摄像头。
从方法层面看,这种迁移能够成立的原因包括:
- 输入主要依赖第一视角 RGB、相对目标与语言,而不是特定机器人关节状态;
- 训练数据跨多个 embodiment;
- BDD-V 等数据经过动作重标注,使高层导航行为被压缩到较统一的低速移动分布;
- 策略最终通过移动平台速度接口控制,而不是直接输出特定机器人关节级动作。
因此 OmniVLA 的“Action”仍然是导航层动作接口。对于四足机器人,VLA 负责决定移动方向/速度或轨迹,而具体足端接触、步态生成和关节力矩通常仍由下层 locomotion controller 负责。这也是该方法能够跨轮式与四足平台迁移的重要工程前提。
16. OmniVLA-edge:轻量级全模态导航模型
完整 OmniVLA 的优势是强语言先验,但 7B 级模型部署成本较高。作者在附录提出 OmniVLA-edge,其参数量约 50M。
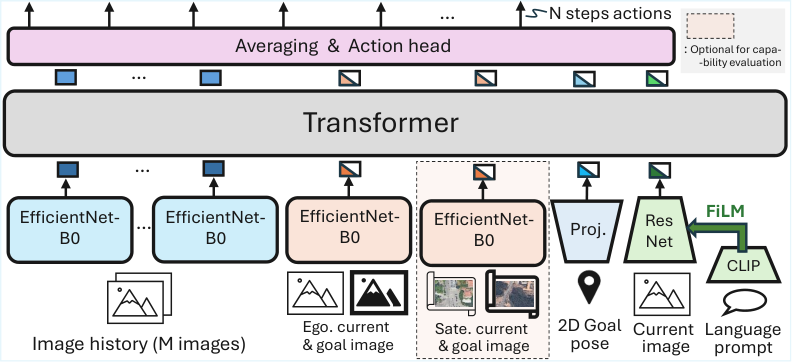
16.1 输入历史
为了在轻量模型中保持时间一致性,OmniVLA-edge 输入最近:
M = 5 M=5 M=5
个图像时刻的历史,而不是只使用单帧当前图像。
16.2 多模态编码
- 图像历史:EfficientNet-B0;
- 当前/目标图像:EfficientNet-B0;
- 2D Goal Pose:Projector;
- Language Prompt:CLIP + ResNet,并通过 **FiLM(Feature-wise Linear Modulation,特征级线性调制)**融合语言条件。
FiLM 的典型形式为:
F i L M ( h ∣ l ) = γ ( l ) ⊙ h + β ( l ) \mathrm{FiLM}(\mathbf h\mid l)=\boldsymbol\gamma(l)\odot\mathbf h+\boldsymbol\beta(l) FiLM(h∣l)=γ(l)⊙h+β(l)
语言编码生成缩放系数 γ \boldsymbol\gamma γ 与偏置 β \boldsymbol\beta β,从而直接调制视觉特征。
16.3 Early Fusion
与完整 OmniVLA 把不同模态映射成 token 后交给 LLM 统一推理不同,OmniVLA-edge 使用 early fusion(早期融合):各模态先作用到对应 token,再送入 Transformer。
Transformer 输出 token 求均值后输入 Action Head:
h ˉ = 1 K ∑ k = 1 K h k \bar{\mathbf h}=\frac{1}{K}\sum_{k=1}^{K}\mathbf h_k hˉ=K1k=1∑Khk
{ a ^ i } i = 1 N = f a c t i o n ( h ˉ ) \{\hat{\mathbf a}_i\}_{i=1}^{N}=f_{action}(\bar{\mathbf h}) {a^i}i=1N=faction(hˉ)
16.4 完整模型与 Edge 模型的差异
表 6. 论文 Table VI:VLA/OmniVLA 模型主干对比
| 模型 | Language Backbone | Visual Backbone | 模型规模 |
|---|---|---|---|
| SmolVLA | SmolLM2 | SigLIP | 500M |
| MiniVLA | Qwen2.5-0.5B | DINOv2 + SigLIP | 1.0B |
| CounterfactualVLA | Gemma-2B | SigLIP | 2.9B |
| OmniVLA-edge | CLIP | EfficientNet-B0 | 50M |
| OmniVLA | Llama 2 7B | DINOv2 + SigLIP | 7.5B |
OmniVLA-edge 在图像目标和二维位姿导航中已经非常强,但在复杂语言与多模态组合任务中明显落后于完整 OmniVLA。这说明导航网络并不是参数越多越好,而是语言先验与模型容量在复杂语义组合任务中成为主要瓶颈。
17. 与相关方法的关系
17.1 与 ViNT 的关系
ViNT 是通用视觉导航基础模型,主要解决当前图像与目标图像之间的导航映射。OmniVLA-edge 直接吸收了 ViNT 的视觉导航 Transformer 思路,但增加:
- 二维目标位姿投影;
- 语言条件分支;
- 模态随机丢弃;
- 多数据集联合训练。
因此可以把 OmniVLA-edge 看成“ViNT/NoMaD 风格视觉导航策略向多目标模态的统一扩展”。
17.2 与 NoMaD 的关系
NoMaD 是 Goal-Masked Diffusion Navigation。OmniVLA 论文并没有直接使用扩散模型作为完整策略的动作头,但在数据构建、Edge 结构和对比实验中吸收了 NoMaD 的经验。尤其是 LeLaN 数据中的合成导航动作与 Edge 网络输出处理都与此前视觉导航体系存在连续关系。
17.3 与 MBRA 的关系
MBRA 的核心作用是 model-based reannotation(基于模型的动作重标注)。OmniVLA 使用它把缺乏合适目标机器人动作标签的大规模视觉数据转成可训练导航轨迹,尤其用于 FrodoBots 与 BDD-V。
因此 MBRA 解决的是“数据如何变成可监督动作”,而 OmniVLA 解决的是“不同数据、不同目标模态如何训练到一个统一策略”。
17.4 与 LeLaN 的关系
LeLaN 关注语言条件导航,并通过机器人/非机器人视频、VLM 推理和合成动作扩大语言导航数据。OmniVLA 继承 LeLaN 的语言 grounding 数据与目标物体损失,但把语言从单一任务条件扩展成统一 VLA 中的一种可选模态。
17.5 与 OpenVLA 的关系
OpenVLA 最初面向通用机器人操作任务。OmniVLA 并不是简单把 OpenVLA “直接拿来导航”,而是对其输入条件与动作输出进行了导航化扩展:
- 添加目标图像条件;
- 添加二维目标位姿 projector;
- 引入随机模态掩码;
- 改为导航 Action Chunk;
- 使用导航大规模数据进行 LoRA 训练。
所以 OmniVLA 的核心贡献更准确地说是:把高容量 VLA 的视觉-语言先验迁移到多模态目标条件导航,并设计适合异构导航数据的统一训练机制。
18. 主要创新点与学术贡献
18.1 将三种导航目标表示统一为一个端到端 VLA
论文将自然语言、二维目标位姿、第一视角目标图像及其组合统一到一个策略中。作者将 OmniVLA 定位为首个统一多种任务模态的端到端导航 VLA。
其价值不只是减少模型数量,而是把不同模态共享的导航技能从“目标描述形式”中解耦出来:避障、路径跟随、目标逼近等能力可以由更多数据共同训练。
18.2 Modality Dropout 使异构数据真正可以联合训练
OmniVLA 没有要求所有数据都拥有完整模态,而是随机选择现有条件并通过 attention mask 屏蔽其他模态。该机制同时解决:
- 模态缺失;
- 模态不平衡;
- 单模态依赖;
- 训练/推理目标模态组合不一致。
这是整个数据规模能够扩大到近万小时的关键工程与算法设计。
18.3 利用动作重标注把非目标本体数据转化为导航监督
BDD-V 贡献了训练数据中的绝大多数时长,但与小型机器人差异极大。论文通过修改 MBRA、限制速度和加入目标机器人运动学约束,实现跨 embodiment 数据重用。
因此 OmniVLA 展示了一条更一般的机器人基础模型数据路线:
heterogeneous video/data → action reannotation → shared policy pretraining \text{heterogeneous video/data}\rightarrow\text{action reannotation}\rightarrow\text{shared policy pretraining} heterogeneous video/data→action reannotation→shared policy pretraining
18.4 从“多模态输入”推进到“多模态任务组合”
二维目标位姿提供 where,语言提供 how。论文直接验证二者同时输入,而不是只分别测试三种单模态,这使 OmniVLA 的“Omni-Modal”有了更强的实验证据。
18.5 验证导航基础模型的三种迁移能力
论文没有只证明预训练模型在原任务上更好,而是从三个方面验证 foundation model 属性:
- 新模态:Satellite Goal Image;
- 新数据/新环境/新语言域:少量数据微调与 CounterfactualVLA 数据适配;
- 新机器人本体:VizBot 与 Unitree Go1。
这使论文的贡献从“一个更强导航模型”扩展为“一个可继续适配的导航基础模型训练范式”。
18.6 同时给出大模型与 Edge 版本
完整 VLA 与 50M Edge 模型形成了很有价值的能力边界:
- 几何和视觉局部导航并不一定需要 7B 模型;
- 复杂语言理解、OOD 行为指令和多模态组合明显受益于大规模 VLM/LLM 先验。
该结论对于实际机器人部署具有直接意义。
19. 论文的局限性与值得继续研究的问题
19.1 语言导航仍明显没有达到稳定可靠水平
论文自己也指出语言条件导航仍有较大提升空间。完整 OmniVLA 的 Language SR 为 0.73,Behavior 为 0.65,复杂障碍环境 S R C SR^C SRC 为 0.65。这说明大语言先验提高了 OOD 泛化,但**“理解语言”与“稳定完成实体导航”之间仍存在明显差距**。
19.2 长距离目标图像导航仍依赖外部拓扑记忆
第一视角图像模式直接测试的目标距离主要在 3 m 内。更远距离依赖预先遥操作建立 1 Hz 图像拓扑图。因此模型还不是纯端到端、无记忆基础设施的长距离视觉导航系统。
19.3 2D Pose 模态依赖定位系统
长距离二维目标位姿模式需要 GPS 来估计机器人与目标位置。室内、地下或 GNSS 拒止环境中,需要额外用 VIO、SLAM、LiDAR-Inertial odometry 等系统提供同类相对位姿,论文没有重点研究这一误差链路。
19.4 多模态组合实验仍然有限
模型结构允许图像、位姿和语言组合,但论文最系统验证的组合是:
2D pose + language \text{2D pose}+\text{language} 2D pose+language
三模态同时输入、目标图像 + 语言、模态相互矛盾时如何仲裁等问题仍值得继续研究。
19.5 大模型实时部署成本较高
7.5B OmniVLA 的完整训练使用多张 H100,评估中策略运行在 RTX 4090 本地计算机并通过网络控制机器人。对于完全板载部署,需要量化、蒸馏、更小 VLA 或 OmniVLA-edge 等技术进一步降低延迟和显存需求。
19.6 跨本体并不等价于统一全身控制
OmniVLA 能跨轮式与四足机器人迁移,主要因为它工作在导航动作层。对于四足平台,它并没有直接学习足端接触、关节力矩和动态平衡。因此不能把本文的 cross-embodiment navigation 与“一个 VLA 直接统一不同机器人的低层全身控制”混为一谈。
20. 从算法视角重新理解 OmniVLA
如果只从网络结构看,OmniVLA 可以被概括为“OpenVLA + 多个目标编码器 + Action Head”。但真正使这篇论文成立的不是简单的结构拼接,而是三层统一:
第一层:任务条件统一。 语言、目标图像、目标位姿都被解释为“导航目标”的不同表达。
第二层:数据统一。 不同数据集不再要求具有相同标注,只要拥有至少一种目标模态和可获得/可重标注的动作,就可以进入同一个预训练流程。
第三层:行为表示统一。 不同模态最终都通过共享 Action Chunk 监督学习避障、路径跟随与目标逼近,使几何、视觉和语义在“如何行动”这一层形成对齐。
因此 OmniVLA 更值得关注的公式并不只是某个 Transformer 模块,而是下面这个训练逻辑:
Different goal representations + Shared navigation actions + Random modality masking ⇒ Reusable navigation representation \text{Different goal representations}+\text{Shared navigation actions}+\text{Random modality masking}\Rightarrow\text{Reusable navigation representation} Different goal representations+Shared navigation actions+Random modality masking⇒Reusable navigation representation
这也是论文能够在新模态、OOD 语言、新环境和新机器人平台上继续迁移的核心原因。
21. 技术路线总结
OmniVLA 的完整流程可以概括为:
- 收集 GNM、LeLaN、FrodoBots、BDD-V 等大规模异构导航数据;
- 对缺少合适动作监督的数据使用 NoMaD/MBRA 等方法生成或重标注动作;
- 将当前图像、目标图像、二维目标位姿和自然语言分别编码;
- 将各目标模态映射到共享 token 空间;
- 对每个样本随机采样可用模态组合 t m t_m tm;
- 使用 attention mask 屏蔽未选择/缺失模态;
- 通过预训练 VLA 主干融合当前视觉、目标条件和语言语义;
- Action Head 一次生成 N = 8 N=8 N=8 步导航 Action Chunk;
- 通过 J i l + m o b j J o b j + J s m J_{il}+m_{obj}J_{obj}+J_{sm} Jil+mobjJobj+Jsm 完成监督训练;
- 部署时根据任务自由选择语言、2D Pose、目标图像或其组合;
- 对新模态、新环境和新语言域可进行少量微调;
- 通过统一导航接口迁移至不同移动机器人 embodiment。
22. 核心结论
OmniVLA 的研究价值在于把“导航基础模型”从单一目标形式的视觉策略推进到可组合任务条件的统一 VLA。论文证明,语言、二维目标位姿和第一视角目标图像并不一定需要分别训练三个导航专家;通过共享 VLA 主干、Modality Dropout、注意力掩码、大规模异构数据和动作重标注,可以让不同模态共同学习底层导航 affordance。
实验最有说服力的部分并不是图像目标任务的 100% 成功率,而是三个更难的现象:完整 OmniVLA 对 OOD 行为语言的明显提升;2D Pose + Language 的 where/how 组合任务达到 0.80 SR;以及预训练模型对卫星图像、新环境、新语言域和新机器人本体表现出的持续适配能力。
从更广泛的具身智能视角看,OmniVLA 给出的路线是:先统一任务表示,再统一异构数据,最后让跨模态信息通过共享动作监督在行为层对齐。 这一路线不局限于轮式导航,也为四足机器人、移动操作机器人以及未来更统一的视觉-语言-动作导航系统提供了可扩展的训练范式。
23. 相关资料
- OmniVLA Project Page:https://omnivla-nav.github.io/
- OmniVLA Paper:https://arxiv.org/abs/2509.19480
- OmniVLA Code:https://github.com/NHirose/OmniVLA
- OpenVLA:https://arxiv.org/abs/2406.09246
- ViNT:https://arxiv.org/abs/2306.14846
- NoMaD:论文 Goal Masked Diffusion Policies for Navigation and Exploration, ICRA 2024
- LeLaN:https://arxiv.org/abs/2410.03603
- MBRA:https://arxiv.org/abs/2505.05592
- CounterfactualVLA / CAST:https://arxiv.org/abs/2508.13446

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献49条内容

所有评论(0)