AI Agent 到底是什么?我用 100 行 Python + DeepSeek 从零写了一个
AI Agent 到底是什么?我用 100 行 Python + DeepSeek 从零写了一个
你有没有发现,今年打开任何一个 AI 产品,标题里都挂着"Agent(智能体)"三个字?
ChatGPT 能自己调工具帮你订机票、Manus 能自己点鼠标打开网页填表格、Claude 能自己读文件改代码……它们和过去"你问一句它答一句"的聊天机器人,到底差在哪?
这篇文章不堆概念、不画大饼,直接从 0 到 1 手写一个能跑的 Agent:先讲清楚它是什么、靠什么干活,再把核心代码一行行拆给你看。看完你会发现——所谓的"AI 智能体",剥开外壳,核心就是一个**"想一步、做一步、看结果、再想下一步"的循环**。
👥 适合谁:没写过 Agent、想真正跑通一个能用智能体的初学者;会一点点 Python 基础、跟着 PyCharm 点鼠标就行。
✅ 看完你能收获:① 搞懂 Agent 到底是什么;② 10 分钟跟着搭好一个能自己查天气、算数、多步协作的小 Agent;③ 知道下一步怎么往真实项目升级。
📌 先说明:本文写的是一个教学用最小可运行 Agent(约 100 行核心代码),不是生产级框架。但它包含了真实 Agent 的全部骨架:大脑、记忆、工具、主循环。骨架懂了,再去看 LangGraph、AutoGen 就不会懵。
一、Agent 到底是什么?和聊天机器人差在哪?
先把一个最容易被搞混的问题说清楚:Agent ≠ 聊天机器人。
| 聊天机器人(Chatbot) | 智能体(Agent) | |
|---|---|---|
| 你问一句 | 它答一句 | 它会自己拆任务、调工具、根据结果继续做 |
| 能不能动 | 只能说话 | 能调用外部工具(搜网页、跑代码、操作文件) |
| 谁决定下一步 | 你 | 它自己根据中间结果决定 |
| 目标 | 回答问题 | 完成一个目标(哪怕要十几步) |
举个最直白的例子:
- 🤖 你对聊天机器人说:"帮我查一下上海今天天气,再算一下我出差 5 天带伞的概率。“它只能告诉你"我不会查天气”。
- 🧑💻 你对 Agent 说同样的话,它会:
- 💭 自己想:我需要先调天气工具 →
- 🌤️ 调用天气 API 拿到数据 →
- 👀 自己看结果:“哦,上海今天降水概率 80%” →
- 💭 自己想:接下来该用计算器算 5 天都带伞的概率 →
- 🔢 调计算器工具 →
- 📤 把结果整理成你能看懂的话交给你。
一句话定义:Agent = 大模型当大脑 + 能调用工具 + 能记住过程 + 一个"想—做—看"的循环。
它有什么用?为什么今年突然火了?
因为大模型本身有两个硬伤:
- 它不知道今天发生了什么(知识有截止日期,也不知道实时天气、你的文件、最新新闻);
- 它只会动嘴,不会动手(不能真的去查、去算、去改文件)。
Agent 就是给大模型装了"手"和"眼睛"——让它能查到最新信息、能真的把事做了。2024 年底到 2025 年,随着模型的"函数调用(Function Calling)"能力成熟,Manus、OpenAI Operator、Claude Computer Use 这类产品接连出现,Agent 才从实验室真正走进大众视野。
二、拆骨架:一个 Agent 就这 5 个零件
别看产品包装得花里胡哨,所有 Agent 拆到底,都是这 5 块:
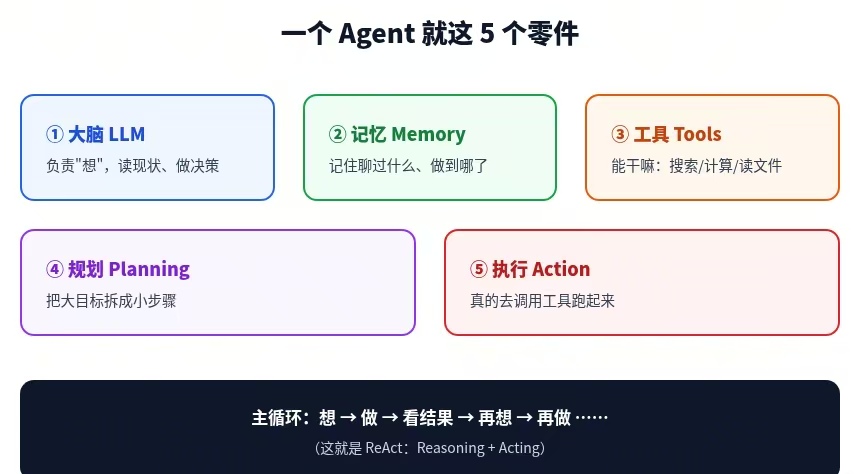
一个 Agent 拆开就这 5 个零件,外加一个不停转的主循环:
| 零件 | 作用 |
|---|---|
| ① 大脑(LLM) | 负责"想",读现状、做决策 |
| ② 记忆(Memory) | 记住之前聊过什么、做到哪了 |
| ③ 工具(Tools) | 能干嘛:搜索 / 计算 / 读文件 |
| ④ 规划(Planning) | 把大目标拆成小步骤 |
| ⑤ 执行(Action) | 真的去调用工具跑起来 |
🔁 主循环:想 → 做 → 看结果 → 再想 → 再做……(这就是 ReAct:Reasoning + Acting)
我们一个个用通俗的话解释:
- 大脑:就是你接的大模型(DeepSeek、豆包、GPT 都行)。它负责"读现在的情况,决定下一步该干嘛"。
- 记忆:就是把你之前说的话、工具返回的结果,全部存下来,下次一起喂给大脑——不然它转头就忘。
- 工具:就是你提前给它注册的几个"函数"。比如
calculator(算式)、get_weather(城市)。它自己决定什么时候用哪个。 - 规划:复杂任务先拆成几步。简单任务可以不要,先跑通循环再说。
- 执行:大脑说"我要调 calculator",程序就真的去跑这个函数,把结果塞回对话里。
💡 这篇文章的代码里,①②③⑤ 全部会手写出来;④规划用最简单的"边想边做"代替(这就是业界经典的 ReAct 思路)。
三、先跑通最小版本:一个"会调工具"的 ReAct 循环
我们不先上框架(LangGraph 之类的先放一边),先手写一个循环,你才知道框架到底帮你包了什么。
3.1 它是怎么"想—做—看"的?
这就是经典的 ReAct(Reasoning + Acting),流程长这样:
- 🧑 用户说一个目标;
- 📦 把【目标 + 之前的记忆 + 可用工具列表】一起丢给大模型;
- 🧠 大模型回复:我下一步要做什么(调用哪个工具、参数是啥);
- ⚙️ 程序真的去执行这个工具,拿到结果;
- 📝 把这个结果记进记忆,再丢回给大模型;
- 🤔 大模型看了结果:够了 → 给出最终回答;不够 → 继续调用工具;
- 🔁 重复,直到任务完成(或步数用完)。
💡 你可能会问:它怎么知道自己有哪些工具可用?答案就在流程第 2 步——每次请求时,我们都把工具清单(名字+用途+参数)一起发给模型。模型读完,就知道"我现在能干这几件事",再决定下一步用哪个。
3.2 新手手把手:用 PyCharm 从 0 跑到出结果
代码不难,真正卡小白的是环境和账号。下面**全程用 PyCharm(免费版)**操作,不用敲命令行,跟着点鼠标就行。
第 1 步:装 Python
- 去官网 https://www.python.org/downloads/ 下载最新版安装。
- Windows 安装时一定要勾选 “Add Python to PATH”。
- PyCharm 后面会自动找到它;万一没找到,我们在第 3 步手动选。
第 2 步:装 PyCharm(用免费社区版)
- 去 https://www.jetbrains.com/pycharm/download/ 下载 PyCharm Community Edition(社区版,免费),不用下付费的 Professional。
- 一路下一步装好,第一次打开会让你建项目。
第 3 步:新建项目
- 打开 PyCharm → 点 New Project(新建项目)。
- Location(位置):选个好找的文件夹,名字填
my_agent。 - Python interpreter:选之前装的 Python 3.x(PyCharm 一般会自动识别;没有就点下拉选
System Interpreter,找到你装的 python.exe)。 - 点 Create。
⚠️ 如果 PyCharm 弹"Install missing packages"之类的提示,先点关掉,我们下一步在项目里统一装依赖。
第 4 步:在项目里建两个文件
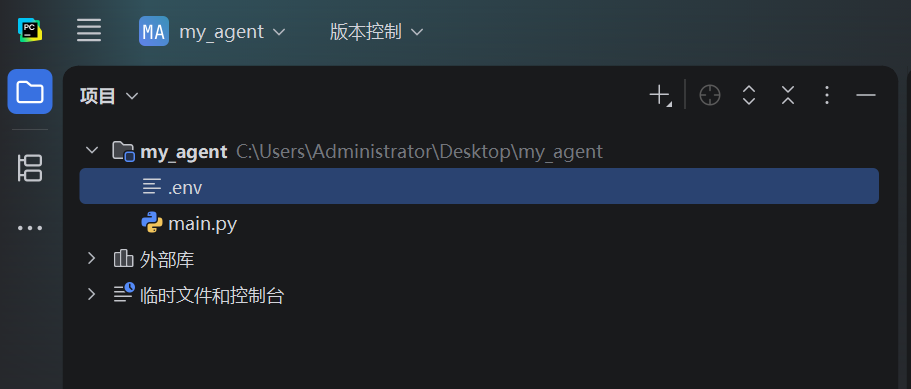
建好项目后,左边能看到项目结构。右键项目名 my_agent → New:
- 选 Python File,名字填
main(回车后 PyCharm 自动建成main.py),把 3.3 的代码整个粘进去。 - 再 右键项目名 → New → File,名字填
.env(注意:是 New → File,不是 Python File;文件名就叫.env)。
建好后左边长这样,两个文件都在:
.env 里写(把引号换成你复制的真实 Key):
OPENAI_API_KEY=sk-把你复制的真实key粘到这里
OPENAI_BASE_URL=https://api.deepseek.com/v1
MODEL_NAME=deepseek-v4-flash
💡 注意:DeepSeek 已停用旧模型名
deepseek-chat,现在用deepseek-v4-flash(非思考模式,便宜、速度快,适合跑本文这种小 Agent)。用别的服务商就把base_url和model换成对应服务的。
第 5 步:在 PyCharm 里装依赖库
PyCharm 自带终端,不用另开 cmd:
- 点 PyCharm 底部工具栏的 Terminal(终端),会看到命令行已经自动进到你的项目文件夹。
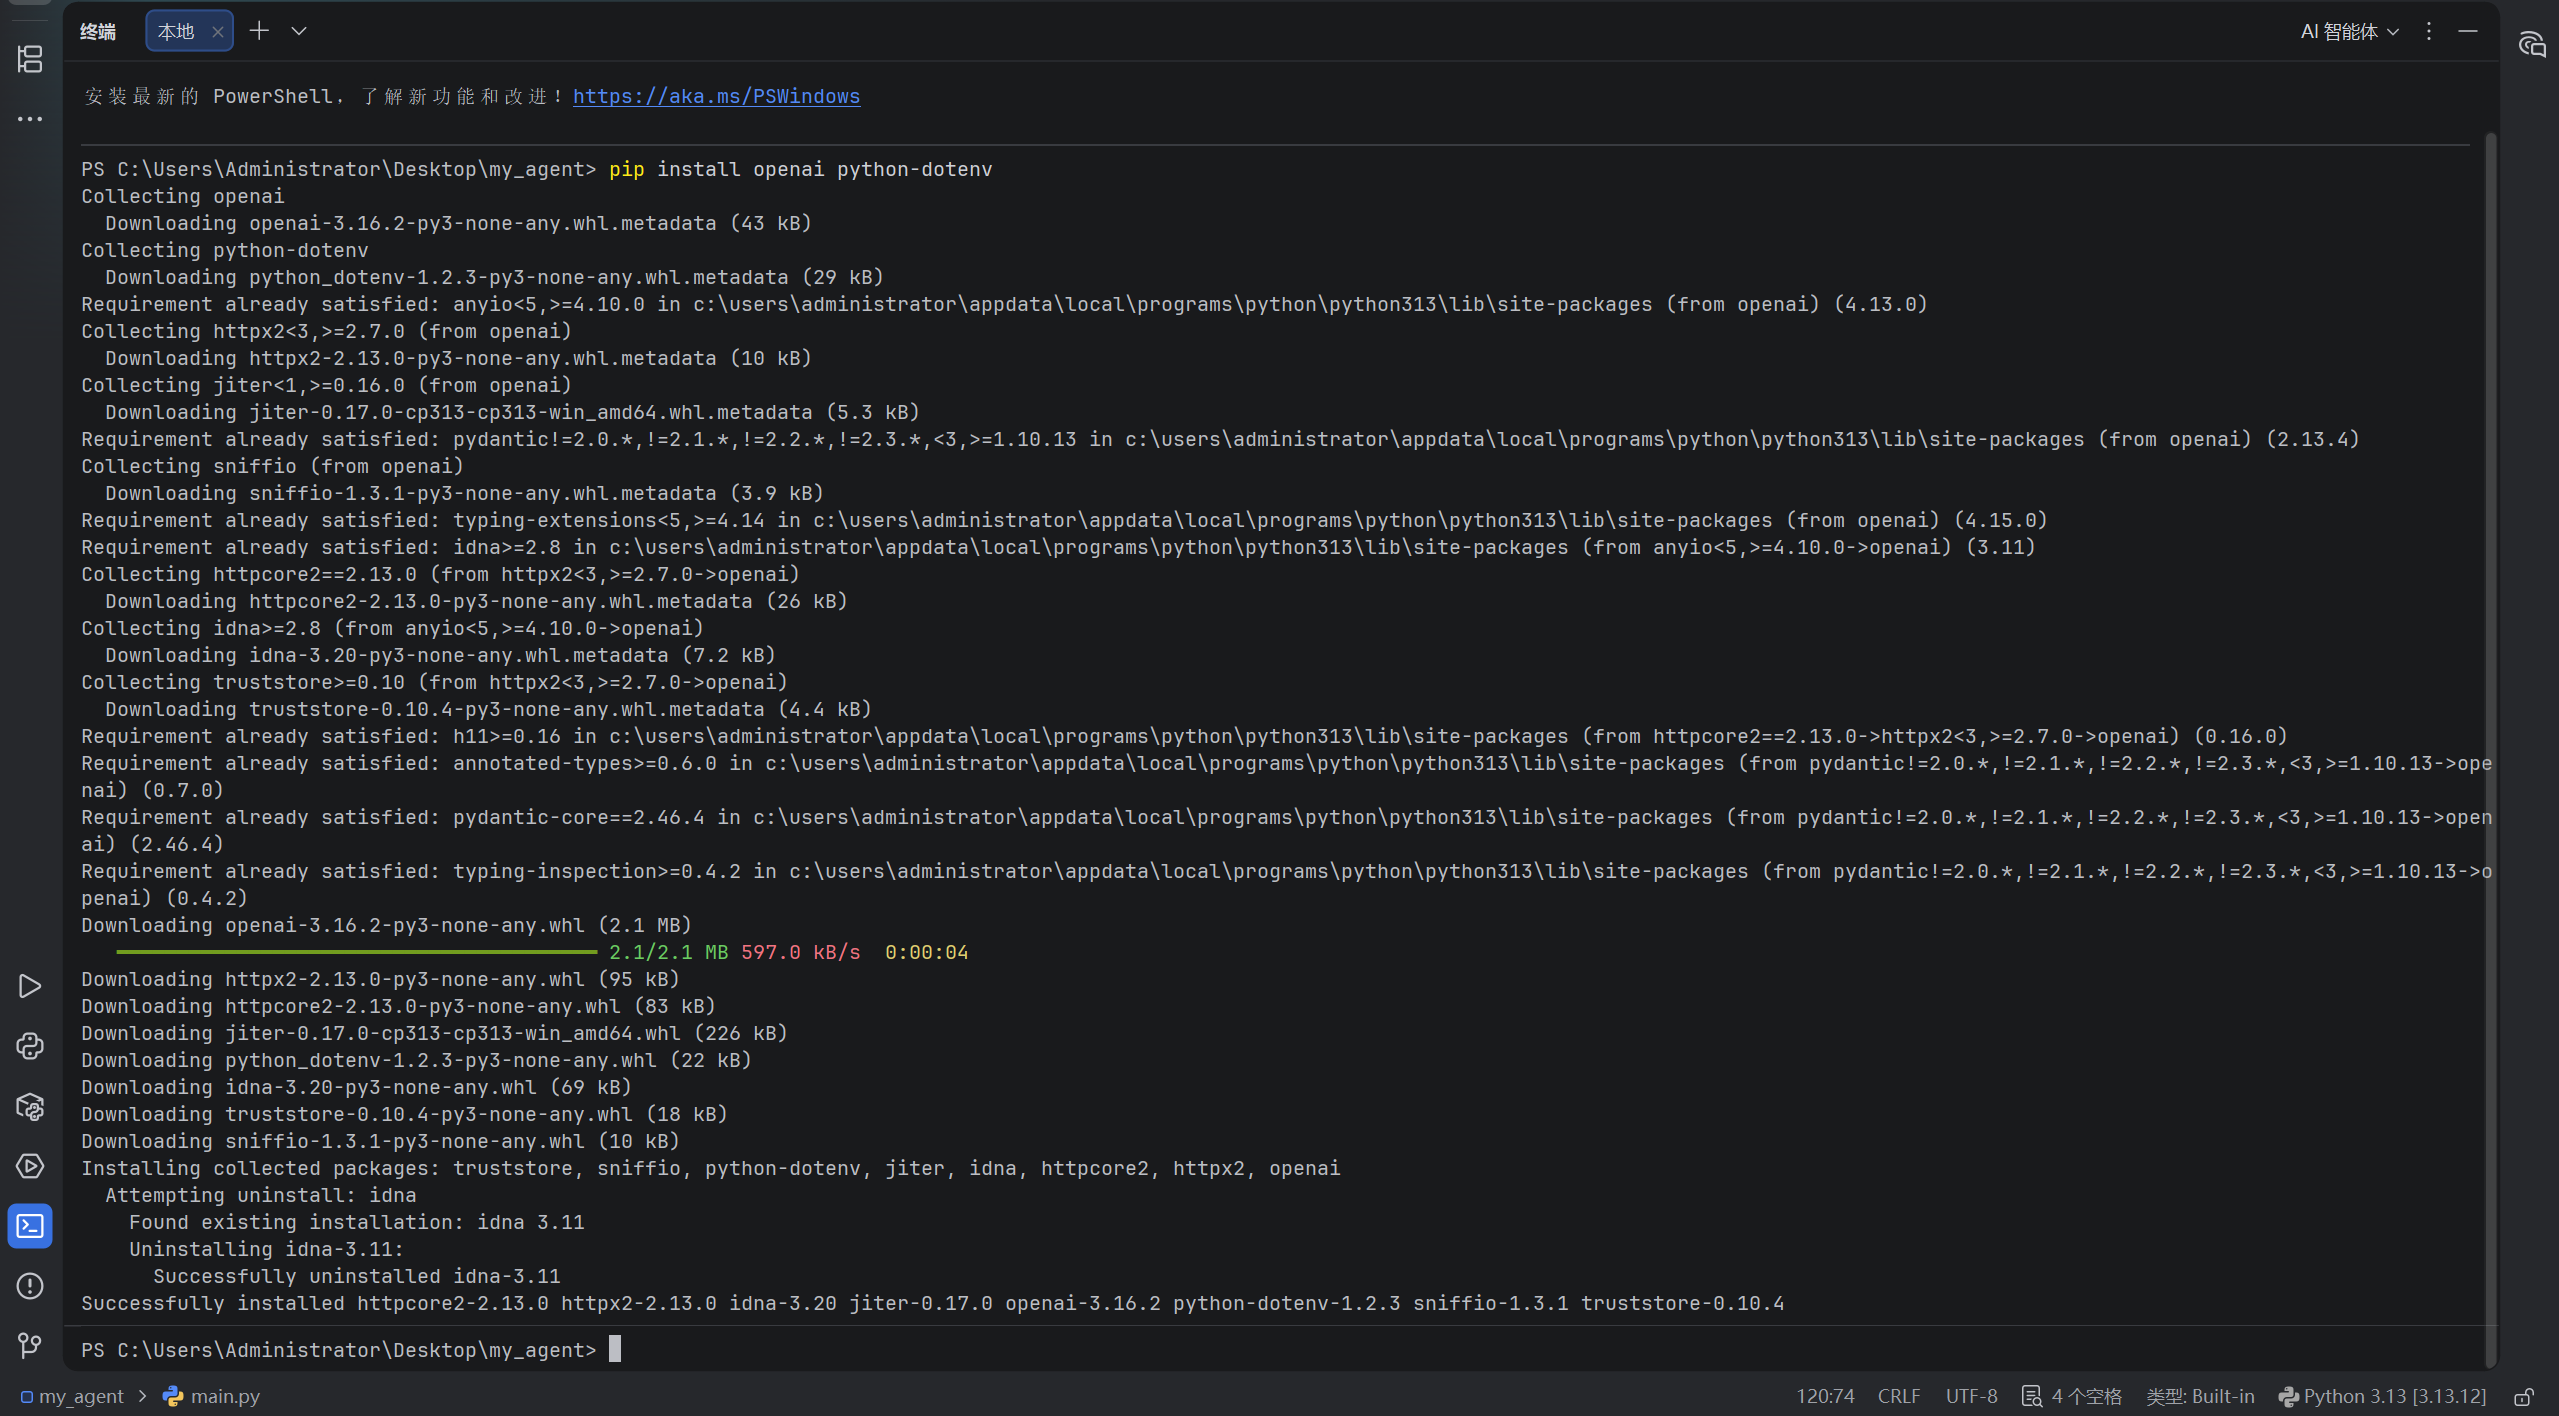
- 输入并回车:
pip install openai python-dotenv
看到最后一行 Successfully installed openai-... python-dotenv-... 就说明装好了:
如果提示
pip 不是内部命令,就用:
python -m pip install openai python-dotenv
或者:点底部 Python Packages 面板,搜openai和python-dotenv,点安装,效果一样。
第 6 步:拿一个 API Key
- 打开 DeepSeek 开放平台 https://platform.deepseek.com/ ,注册登录(新用户一般送免费额度)。
- 左侧「API Keys / 密钥」→「创建 API Key」。
- 复制那串
sk-开头的密钥,粘回你项目的.env文件里。
用豆包/通义也一样:去它们的开放平台建应用、拿 Key,再改
.env里的base_url和model。
第 7 步:运行
- 打开
main.py。 - 在代码编辑器里右键空白处 → Run ‘main’,或者点右上角那个绿色三角 ▶。
- 看 PyCharm 底部的 Run(运行)窗口,就会一轮一轮打印:
调用工具 → 工具返回 → 最终答案。
看到它自己调了天气、又调了计算器,最后给出"上海降水概率 80%、5 天至少下雨约 99.97%",就说明 Agent 跑通了。
常见问题对照表(PyCharm 版)
| 现象 | 原因 | 怎么办 |
|---|---|---|
| 右键没有 Run / 跑不了 | Python 解释器没配对 | File → Settings → Project → Python Interpreter,选到装的 Python 3.x |
红字 ModuleNotFoundError: openai | 依赖没装 | 底部 Terminal 跑 pip install openai python-dotenv |
红字 AuthenticationError / 401 | API Key 错了 | 检查 .env 里的 Key 是否复制全、有没有多空格 |
| 一直不调用工具,只会聊天 | 模型不支持工具调用 | 确认 MODEL_NAME=deepseek-v4-flash |
.env 读不到 Key | 文件建错名(成了 .env.txt) | 右键重命名,确保就叫 .env |
⚠️ 重要:绝对不要把真实 API Key 直接写进代码、传上 GitHub 或贴进博客。
用.env文件存 Key,.env永远不公开。
3.3 完整核心代码(约 100 行,注释齐全)
import os
import json
from dotenv import load_dotenv
from openai import OpenAI

# ========== 0. 初始化:读配置、连大模型 ==========
load_dotenv()  # 从 .env 读 API_KEY 等配置
client = OpenAI(
    api_key=os.getenv("OPENAI_API_KEY"),
    base_url=os.getenv("OPENAI_BASE_URL"),
)
MODEL = os.getenv("MODEL_NAME", "deepseek-v4-flash")

# ========== 1. 定义"工具":Agent 能干嘛,全靠这里注册 ==========
# 每加一个能力,就是写一个普通函数 + 一份"说明书"(JSON Schema)
def calculator(expression: str) -> str:
    """一个简单计算器:输入一个算式字符串,返回结果"""
    try:
        # 注意:教学示例用 eval,真实项目请用更安全的解析方式
        return str(eval(expression, {"__builtins__": {}}, {}))
    except Exception as e:
        return f"算式出错:{e}"

def get_weather(city: str) -> str:
    """查天气:这里用假数据示意,真实项目换成天气 API"""
    fake_db = {"北京": "晴,26℃,降水概率 10%", "上海": "小雨,24℃,降水概率 80%"}
    return fake_db.get(city, f"暂时没有 {city} 的天气数据")

# 工具的"说明书",告诉大模型:有哪些工具、参数怎么填
TOOLS = [
    {
        "type": "function",
        "function": {
            "name": "calculator",
            "description": "计算一个数学算式,比如 '(1+2)*3'",
            "parameters": {
                "type": "object",
                "properties": {
                    "expression": {"type": "string", "description": "要计算的算式"}
                },
                "required": ["expression"],
            },
        },
    },
    {
        "type": "function",
        "function": {
            "name": "get_weather",
            "description": "查询某城市当前天气",
            "parameters": {
                "type": "object",
                "properties": {
                    "city": {"type": "string", "description": "城市名,比如 北京"}
                },
                "required": ["city"],
            },
        },
    },
]

# 工具名 -> 真实函数 的映射,方便后面按名字调用
TOOL_IMPL = {"calculator": calculator, "get_weather": get_weather}

# ========== 2. 主循环:Agent 的心脏 ==========
def run_agent(user_query: str, max_steps: int = 6):
    # ② 记忆:一个列表,装着所有对话和工具结果
    messages = [
        {"role": "system", "content": "你是一个会用工具的小助手。需要时调用工具,完成后用中文简洁回答。"},
        {"role": "user", "content": user_query},
    ]

    # 循环最多跑 max_steps 步,防止它死循环
    for step in range(1, max_steps + 1):
        print(f"\n--- 第 {step} 轮思考 ---")

        # ① 大脑:把记忆 + 工具列表丢给大模型,让它决策
        resp = client.chat.completions.create(
            model=MODEL,
            messages=messages,
            tools=TOOLS,
        )
        msg = resp.choices[0].message

        # 把这一轮的"想法"存进记忆
        messages.append(msg.model_dump())

        # 如果大模型没有要求调用工具,说明它认为任务完成了
        if not msg.tool_calls:
            print(f"Agent 给出最终答案:{msg.content}")
            return msg.content

        # ③ 有工具要调用:逐个执行
        for call in msg.tool_calls:
            tool_name = call.function.name
            args = json.loads(call.function.arguments)
            print(f"  → 调用工具 {tool_name},参数:{args}")

            # ⑤ 执行:真的跑函数。模型偶尔会"幻觉"出不存在的工具名,这里兜底,不让程序崩
            if tool_name not in TOOL_IMPL:
                result = f"报错:没有名为 {tool_name} 的工具,请改用已有工具。"
                print(f"  ← {result}")
            else:
                result = TOOL_IMPL[tool_name](**args)
                print(f"  ← 工具返回:{result}")

            # ④ 把工具结果存进记忆,下一轮大脑就能看到
            messages.append({
                "role": "tool",
                "tool_call_id": call.id,
                "content": result,
            })

    return "(步数用完了还没完成)"

# ========== 3. 跑一下试试 ==========
if __name__ == "__main__":
    # 这个问题必须先查天气、再算数,正好考验 Agent 的"多步协作"
    # 题目:已知每天降雨概率 80%,连续出差 5 天,至少有一天会下雨的概率是多少?
    # 思路:5 天都不下雨 = 0.2**5,至少一天下雨 = 1 - 0.2**5
    run_agent("我在上海出差,这里每天降雨概率是80%,连续5天都要出门。请帮我算一算:这5天里,至少有一天会下雨的概率是多少?")
3.4 它实际是怎么跑的?(真实运行截图)
接上真实模型后,这是我实际跑出来的输出。注意看第 1 轮:模型第一次算的时候把乘方写成了 1 - 0.2^5,计算器报错,它看了错误信息后,自己改成 1 - 0.2**5 重新算——这就是"看结果、再想下一步":
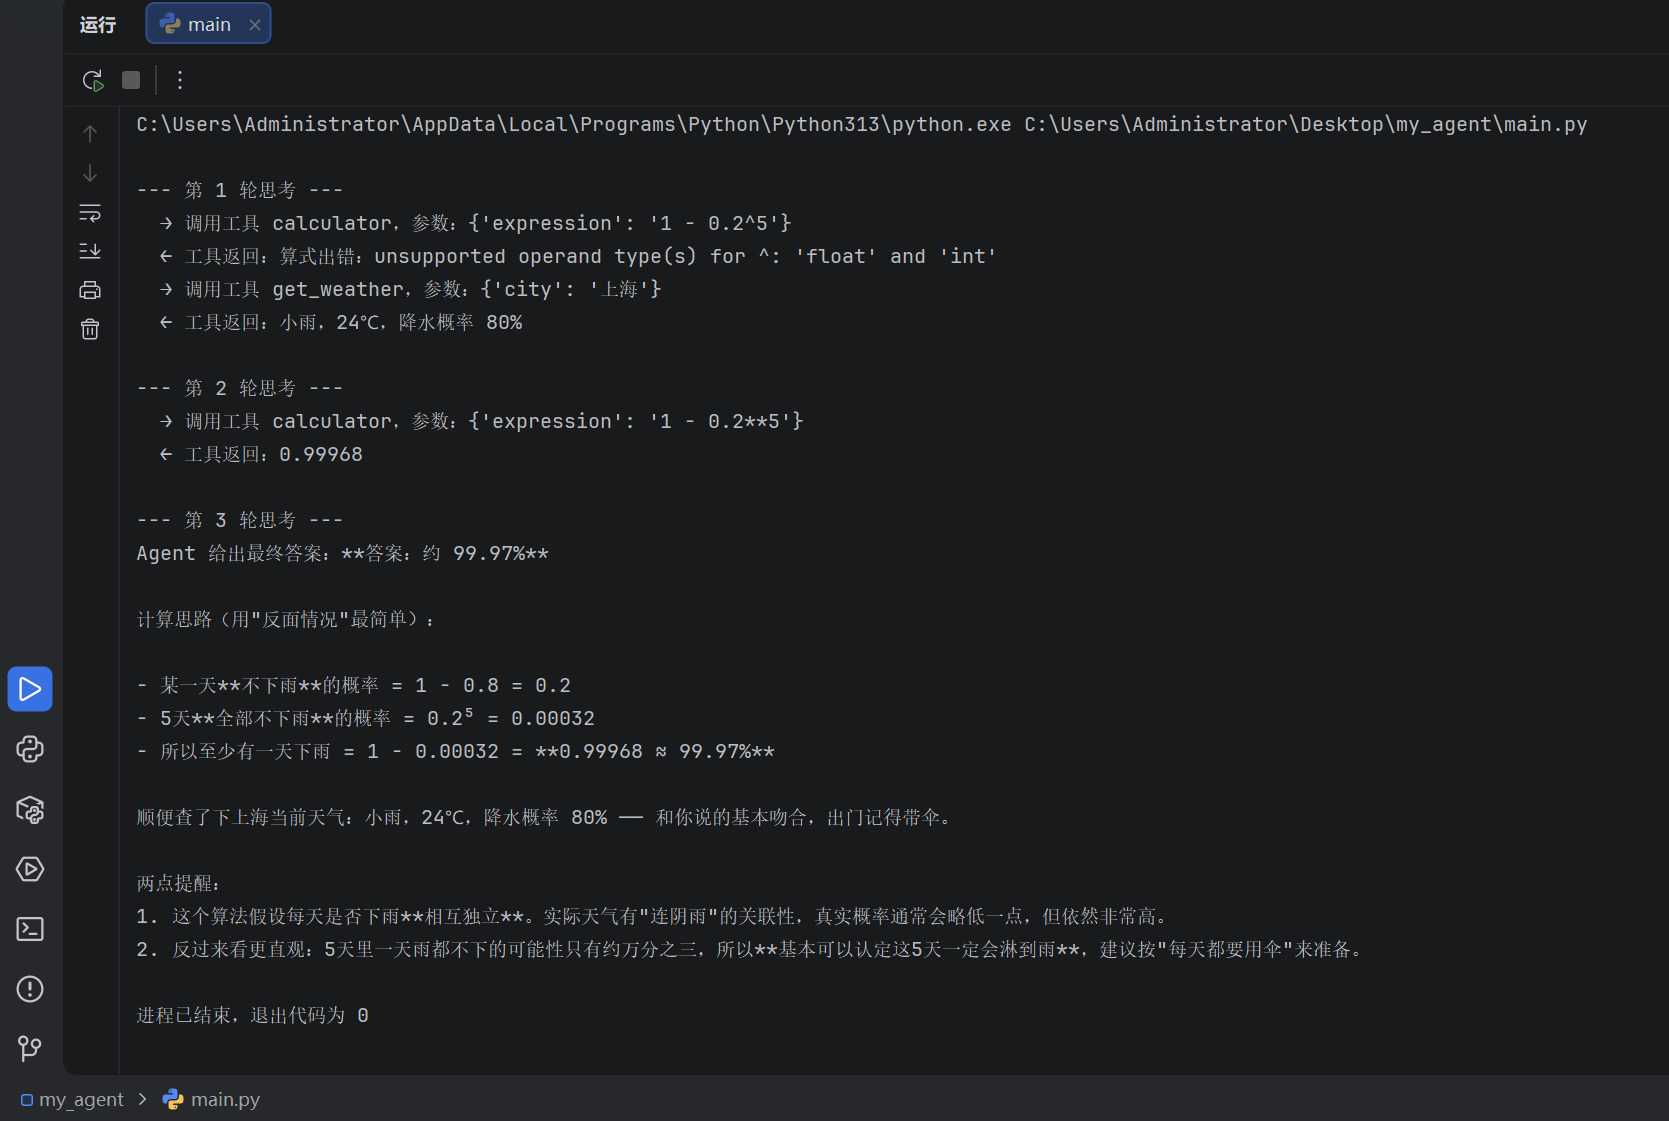
看明白了吗?它不是一次答出来的——它先自己调工具、遇到错误看一眼报错、换个写法重算,拿到结果后才组织语言回答。这就是"Agent 自己在干活"。
四、对照代码,再回头看那 5 个零件
现在你再看,就完全对得上了:
- 大脑:
client.chat.completions.create(...)这一行,每次都在"想"。 - 记忆:
messages这个列表,每轮把用户、模型、工具的话都塞进去。 - 工具:
calculator、get_weather两个函数,加TOOLS说明书。 - 执行:
TOOL_IMPL[tool_name](**args)这一行,按名字真的去跑函数。 - 规划:这里没单独写,是靠大模型在每一轮"想"的时候顺带完成的——简单任务够用了。
💡 你发现没?真正难的不是代码,是怎么把"工具说明书"写清楚。你给大模型的工具描述写得越准,它调工具就越准。这也是为什么现在大家说"写 Agent 一半功夫在 prompt 和工具设计上"。
五、从"玩具"到"项目":一个真实 Agent 项目长什么样?
如果你想把它做成一个正经项目,目录一般这么组织(照着搭就行):
| 文件 / 目录 | 作用 |
|---|---|
.env | 放 API Key(永远别上传) |
main.py | 入口,跑主循环 |
agent/loop.py | 主循环(想—做—看) |
agent/memory.py | 记忆管理(短期 + 长期) |
agent/planner.py | 规划(可选) |
tools/calculator.py | 计算器工具 |
tools/weather.py | 天气工具 |
tools/search.py | 搜索工具 |
requirements.txt | 依赖清单 |
真实项目里,再往深走会遇到这几件事(知道有这回事就行):
- 长期记忆:上面的
messages会越来越长、越来越贵。真实项目会把历史存进数据库,只挑相关的塞回给模型(这就是 RAG 的思路)。 - 工具变多:从 2 个变成几十个,就要做"工具路由"——先让模型判断用哪个,而不是全丢给它。
- 错误处理:工具可能报错、可能超时,Agent 要学会"换个方式再试",而不是直接崩。
- 别让它瞎跑:必须设
max_steps,并对eval这类危险操作做权限限制。
六、往深走一步:4 个关键认知(懂了就超过一半初学者)
1. 模型其实"不会执行",它只是"开了张药方"
这是最多人搞混的一点:大模型本身一次代码都不会跑。它做的事,只是输出一段结构化的话——“我要调 calculator,参数是 1-0.2**5”。真正按下回车、把算式算出来的,是你写的那行 TOOL_IMPL[tool_name](**args)。
换句话说:模型是"大脑",你的 Python 代码才是"手脚"。大脑只负责决策,手脚负责执行。想明白这一点,你就懂了为什么 Agent 的能力上限,其实取决于你给它接了多少真能用的工具。
2. 模型是"无状态"的,所以记忆才是工程问题
上面说"工具结果必须喂回去",背后有个更本质的原因:模型本身是无状态的。每次 client.chat.completions.create() 都是一次全新调用,它不记得上一轮发生了什么。
所以"记忆"不是模型自带的,而是你用 messages 列表手动喂出来的——这也是为什么 messages 会越攒越长:每轮都得把全部历史重新发一遍。这既是记忆的来源,也是成本的来源。
3. 上下文窗口是会"爆"的,这就是长期记忆存在的意义
模型不是无限大的,它有个"上下文窗口"(比如 128K token)。你的 messages 越攒越长,迟早顶满,而且每轮都全量重发,又慢又贵。
真实项目里的做法是:不把所有历史都塞进去,而是——
- 把旧对话存进数据库;
- 每次只挑"和当前问题最相关"的几段塞进
messages; - 这就是 RAG(检索增强生成) 的核心思路。
你之前听到的 RAG,和这里的"记忆管理"其实是一回事。
4. 更高阶的玩法:从 ReAct 到规划、到多智能体
我们写的是最朴素的 ReAct(想一步做一步)。再往上还有几类,知道名字和区别就行:
- Plan-and-Execute(先规划后执行):复杂任务先让模型列出完整步骤清单,再一步步执行,不容易走偏。
- 多智能体(Multi-Agent):不是一个模型包打天下,而是"一个负责规划、一个负责写代码、一个负责审查",像一个团队分工。
- MCP(Model Context Protocol):一套"工具怎么接"的统一标准。以前每个工具都要单独适配,MCP 让工具写一次、任何模型都能用——这是 2024 年底后很火的方向。
💡 不用现在就上手这些。先把手写的 ReAct 跑顺,知道它们都是"在这个循环上做文章",以后学框架就是顺水推舟。
七、常见疑问,一次性说清
Q1:我一定要用 LangChain / LangGraph 吗?
不一定。上面 100 行手写代码,已经能跑通一个最小 Agent。框架的价值在于:当你有十几个工具、要做多智能体协作、要持久化记忆时,帮你少写胶水代码。但建议你先手写一遍,再去看框架,否则永远被它的抽象绕晕。
Q2:手写的和 Manus 那种产品差在哪?
差在"手脚的广度"和"稳定性"。产品级 Agent 能操作浏览器、能看屏幕、能调用几十上百个工具、有大量工程化的容错和安全设计。但核心循环,和我们上面写的是同一回事。
Q3:为什么我接了模型,它不调用工具?
八成是这几个原因:① tools 参数没传对;② 你用的模型不支持函数调用;③ 工具的 description 写得太模糊,模型不知道什么时候该用。
Q4:安全吗?它会不会把我电脑搞坏?
会,如果你把危险操作(比如删文件、跑任意命令)注册成工具的话。原则:只暴露你允许它做的事,危险操作要加确认和权限控制。
八、写在最后
剥开所有包装,Agent 的核心朴素得惊人:
给大模型一份"能干嘛"的清单,让它读一眼现状、决定下一步、真的去做、把结果记下来,然后再来一遍。
就这么一个循环,撑起了现在所有的"AI 自动帮你干活"。你今天写的这 100 行,和 Manus 背后的东西,是同一个思想——只是人家做得更大、更稳、工具更多。
动手跑一遍,比看十篇概念科普都管用。跑通之后你再回头看各种 Agent 框架,会发现它们都在解同一个问题。
🚀 下一期预告:做一个进阶版 Agent
这一期我们做的是"玩具版"——工具是写死的假数据、没有记忆、只会现想现做。
下一期,我们把它升级成真正能用的版本,计划加上:
- 🌐 真实联网搜索:不再是假数据,真的去搜实时天气、新闻;
- 🧠 长期记忆:把聊过的事存下来,下次它还记得你;
- 🧰 多工具自动路由:工具从 2 个变成十几个,让它自己挑;
- 🛡️ 错误重试和安全控制:工具报错了它会换个方式再试,危险操作要你确认。
如果你想先看哪一部分(比如"真实联网搜索"或"长期记忆"),评论区告诉我,我下一期先讲呼声最高的。点个关注,下一期不见不散~
🎉 跑通的同学,评论区扣个 “1” 让我看看;没跑通的,把报错截图贴出来,我帮你一起看。
📝 本文代码为教学用最小实现,
calculator里的eval仅作演示,生产环境请替换为安全的表达式解析库。文中涉及的模型接口均为 OpenAI 兼容格式,更换服务只需改.env里的base_url和model。你打算用 Agent 解决什么问题?或者在搭 Agent 时踩过什么坑?欢迎评论区聊聊~

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐

 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)