机器人训练中的几个概念及相互关系:stable_baseline3、Gym、PPO、PyBullet、MoJoCo、ROS2
一、一个机器人训练流程大致可分为三个核心阶段:
第一阶段:环境搭建(The Virtual Gym)
使用 PyBullet 或 MuJoCo 作为物理引擎创建一个机器人仿真模型(机械臂、四足机器人等)和物理世界。为了让强化学习算法能控制这个机器人 Testudog,需要用 Gym 标准把它包装成一个环境 TestudogEnv。该环境会定义观测空间 self.observation_space = spaces.Box()(主要是机器人的关节角度、速度等)和动作空间 self.action_space = spaces.Box()(主要是施加在关节上的力矩),并提供 step() 方法来执行动作、返回新的观测、奖励、判断是否需要 reset()、是否训练结束。
第二阶段:算法训练(The Training Loop)
选择 SB3 库中的 PPO 算法来训练智能体。SB3 会通过 Gym 接口与环境进行成千上万次的交互:它输出一个动作,环境执行后返回观测和奖励,SB3 根据这些数据更新PPO策略网络。这个过程会不断循环,直到机器人学会在仿真环境中稳定行走或完成特定任务。
第三阶段:部署与迁移(Sim-to-Real)
当训练完成后,把学到的策略(一个神经网络模型)部署到真实的机器人上。这时 ROS2 就登场了,通常会创建一个 ROS2节点,这个节点负责:
(1)订阅真实机器人的传感器数据(如IMU、关节编码器)。
(2)将这些数据转换成 Gym 环境所需的观测格式。
(3)运行训练好的 SB3 模型进行推理,得到动作指令。
(4)发布控制指令给机器人的底层控制器(如电机驱动器)驱动机器人。
二、Gym的接口作用
PPO算法本身不实现 reset() 和 step(),但它会调用环境的 reset() 和 step(),并且调用代码的方式是写死的,即env.reset() 和 env.step(action) ,所以为了保证PPO能正确调用到这两个函数,Gym作为接口提供gym.Env环境基类,用户继承该基类后可定义自己的环境子类,在python里继承可这样写class TestudogEnv(gym.Env),TestudogEnv就是环境子类,在该环境子类中必须以reset() 和 step()定义函数名并实现里面的代码,确保PPO能正确调用。
虽然完全不用Gym接口,也可以自定义环境,并实现PPO算法,但是需要手动补充很多功能,比如随机数生成器的管理、向量化、评估、日志等。这些功能单个实现起来都不难,但细节比较多,容易出错,既然Gym提供了统一的接口,直接用就好。
三、 2个空间是 Gym 写好的
动作和观测空间长什么样,是 Gym 已写好的,只需要调整参数
self.action_space = spaces.Box(low=-1, high=1, shape=(12,), dtype=np.float32)
self.observation_space = spaces.Box(low=-50, high=50, shape=(45,), dtype=np.float32)
PPO 内部会读取这2个空间属性,来构建神经网络的输入输出维度。比如:
看到 action_space.shape == (12,),PPO 就知道策略网络要输出 12 维动作。
看到 action_space.low == -1、high == 1,PPO 就知道要用 tanh 把输出压缩到这个范围。
看到 observation_space.shape == (45,),PPO 就知道价值网络和策略网络的输入是 45 维。
四、reset() 和 step()需要具体实现
两个函数是环境的“灵魂”,每个环境都不一样,四足机器人和机械臂的 step() 完全不一样,MuJoCo 和 PyBullet 的 step() 也不一样,即使同一个机器人,想训练“快走”和“稳走”,奖励函数也不一样。均只有自己定义: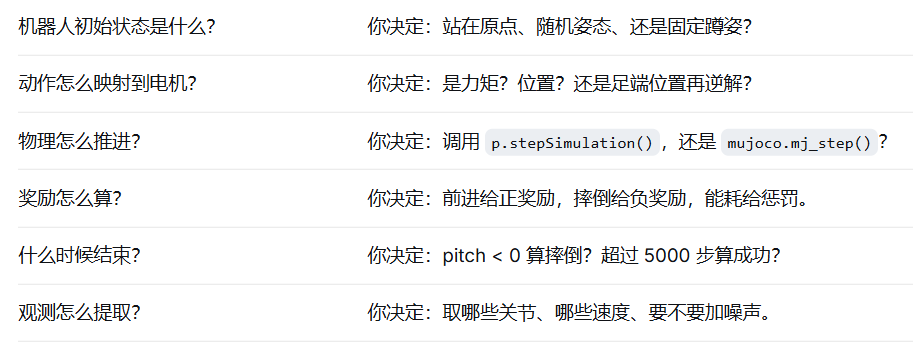
五、真机部署与仿真的区别
部署到真实机器人时,函数名reset()、step()、 PPO 的调用方式均保持不变,但reset() 和 step() 里不会再调用 PyBullet,代码中的p.connect(p.GUI)、p.stepSimulation() 等都会消失,取而代之的是真实机器人 SDK、ROS2 通信、电机指令、传感器读取和安全逻辑。 这就是 Gym 接口的价值:算法模型(PPO) 本身完全不变,只是环境实现从“仿真”换成了“真机”。环境与算法解耦,各自开发运维,需要时通过Gym接口连接。
此时代码不再使用仿真物理引擎,以下是仿真代码和真机代码对比。
def reset(self):
p.disconnect()
obs = self.init_state()
self.state = obs
return obs
def init_state(self):
self.count = 0
# p.connect(p.DIRECT) # 无GUI模式
p.connect(p.GUI) # 启用图形界面
p.resetSimulation()
p.setGravity(0,0,-9.8) # 设置重力加速度
p.setRealTimeSimulation(0) # 关闭实时仿真
p.setAdditionalSearchPath(pybullet_data.getDataPath())
p.loadURDF(“plane.urdf”,[0,0,0],[0,0,0,1]) # 加载地面
self.testudogid = p.loadURDF(“urdf/testudog.urdf”,[0,0,0.25],[0,0,0,1]) # 加载机器人
…
obs = list(body_pos) + list(body_lin_vel) + list(body_rot_rpy) + joint_pos + joint_vel + joint_torque
obs = np.array(obs).astype(np.float32)
return obs
def step(self,action):
…
p.stepSimulation()
…
return obs, reward, done, info
真实机器人
def init_state(self):
self.robot.connect()
self.robot.enable_motors()
self.robot.move_to_initial_pose() # 回到初始姿态
…
obs = self.robot.read_sensors() # 读取 IMU、编码器、力传感器等
return obs。
def step(self, action):
# 把策略输出的动作映射成真实电机指令
motor_cmds = self._action_to_motor_commands(action)
motor_cmds = self._safety_clip(motor_cmds) # 安全限幅
self.robot.send_commands(motor_cmds) # 通过 ROS2/串口/CAN 发送
time.sleep(self.control_dt) # 等待真实控制周期
obs = self.robot.read_sensors() # 读取新观测
reward = self._compute_reward(obs) # 部署时通常不需要 reward,但可以计算用于监控
done = self._check_done(obs)
return obs, reward, done, info

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献3条内容

所有评论(0)