LIT只改视觉到动作的接口,四套VLA架构泛化最多涨10.7个百分点
(1)《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见 WeThinkIn/AIGC-Interview-Book,欢迎 Star!
(2)AIGC / LLM / AI Agent 算法岗与开发岗求职面试内推学习社群,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(https://t.zsxq.com/33pJ0)!
论文标题:Breaking the Vision-Action Shortcut: Latent Interface Training for Generalizable Robotics Foundation Models
论文作者:华南理工、NUS MAGIC Lab与南洋理工
发表时间:2026年9月11日
本文要点
(1)LIT是华南理工大学、新加坡国立大学MAGIC Lab和南洋理工大学2026年9月11日挂上arXiv的训练策略,骨干和动作专家保持原样,改的是视觉送进动作的那一层。
(2)四套架构上LIBERO-Plus总成功率提高3.87到10.70个百分点,π0.5从68.97%做到79.67%。
(3)做法分两步,先无图像用每个动作块的终点位姿条件化学动作,再用位姿监督的隐式接口作为动作专家唯一的视觉通路。
(4)短板在语言扰动和真机分任务表现,MolmoAct2语言项掉2.11个百分点,聚合涨幅盖住了Keep LEGOs换灯光、Wipe trash加干扰物这几处回撤。
(5)文末附官方仓库README里的MolmoAct2训练和评测命令。
2026年9月11日,华南理工大学、新加坡国立大学MAGIC Lab和南洋理工大学把LIT论文挂上arXiv,编号2609.12641。Hugging Face论文页目前76个赞。我把HTML版报告、项目页和GitHub README对了一遍。
VLA和WAM在LIBERO这种训练分布里分数不低,换成新相机、新灯光、新背景就往下掉。论文把这个现象叫做视觉-动作捷径。动作专家在训练里学会了拿任务无关的视觉线索去凑示范动作,线索一变,动作就跟着错。
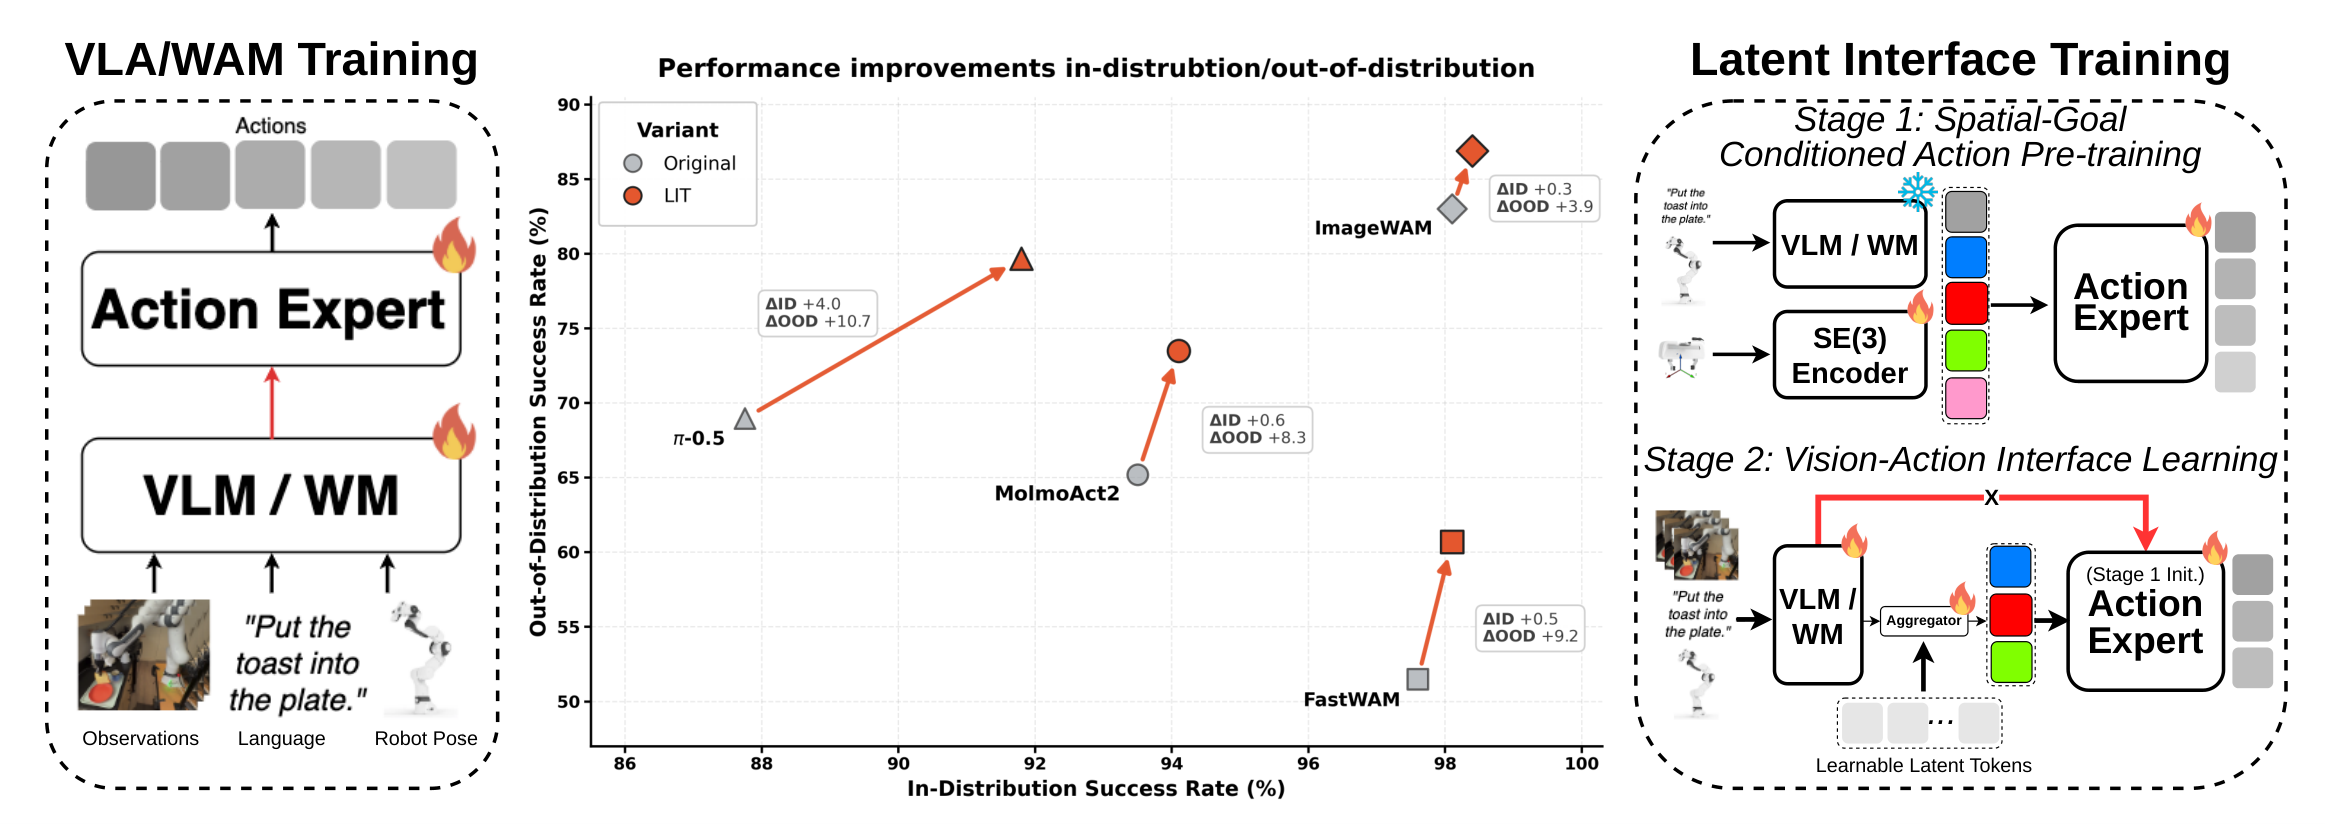
一、反事实干预揭示视觉动作捷径
只看分布外掉点,还分不清模型是不会做,还是在背训练场景里的视觉答案。他们在MolmoAct2上做了两组反事实干预。
画面里加干扰物,或者把图弄糊,指令、空间目标和机器人状态都不动。基线轨迹会明显偏离干净画面下的那条,LIT的轨迹贴得更近。
更硬的一刀是改目标。画面和机器人状态不动,只改指令里的目标。基线继续朝原来的目标走,LIT会改道去新目标。
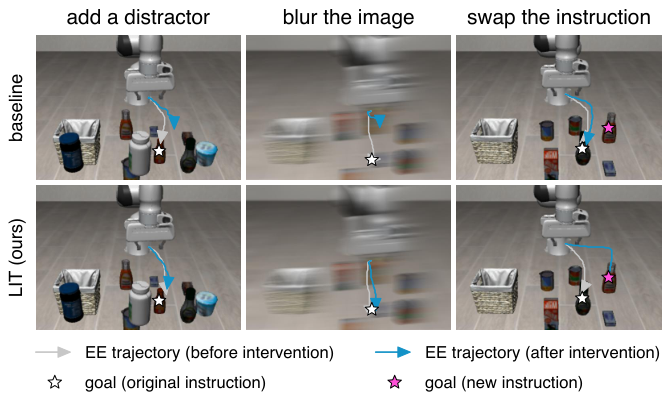
基线在这一刀上的表现,很像看图背答案。画面没变,它就继续走老路。
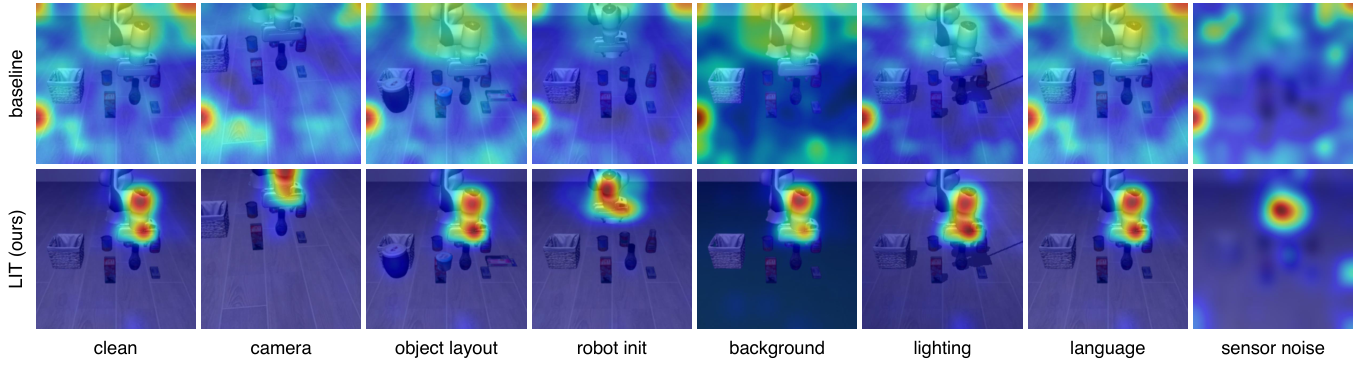
注意力图也顺着这个方向。基线是动作专家直接看图,LIT要把动作专家到隐式token、再从隐式token到图像这两段拼起来。分布一变,基线的注意力会漂到别处,LIT更稳地停在机器人和物体附近。
二、无图像动作先验与位姿监督接口
论文认为,把表示做丰富,管不住动作专家怎么用这些表示。Qwen-VLA、LA4VLA这类先无图再看图的训练,也没有给每个动作块一个明确的空间目标,后面一旦把视觉接回去,捷径还是能长出来。
LIT的第一阶段把图拿掉。冻结的骨干只吃语言指令和机器人状态。
每个示范动作块的终点写成一个8维目标,末端位置3维、轴角朝向3维、夹爪2维。这个目标经过三层MLP编成token,和语义表示拼在一起,去条件化从零训的动作专家。
这一步学的是,给定一个空间目标,动作块该怎么走完,跟画面无关。推理时这个位姿编码器会丢掉,不需要特权位姿。MolmoAct2上第一阶段跑完1万步,动作流匹配损失落到0.029。
第二阶段把视觉接回来,动作专家不许直接看骨干的视觉token。中间加100个可学习的隐式token。每一层先自注意力,再交叉注意力去聚合语义和视觉,然后用各架构原来的条件化方式喂给动作专家。
这些token还要重建第一阶段用过的那个终点位姿,重建损失权重0.3,加在原来的动作损失上。位姿在这里当接口的监督,逼隐式token把动作需要的空间信息留下来。视觉只能走这条窄路,任务无关的线索更难直接灌进动作专家。
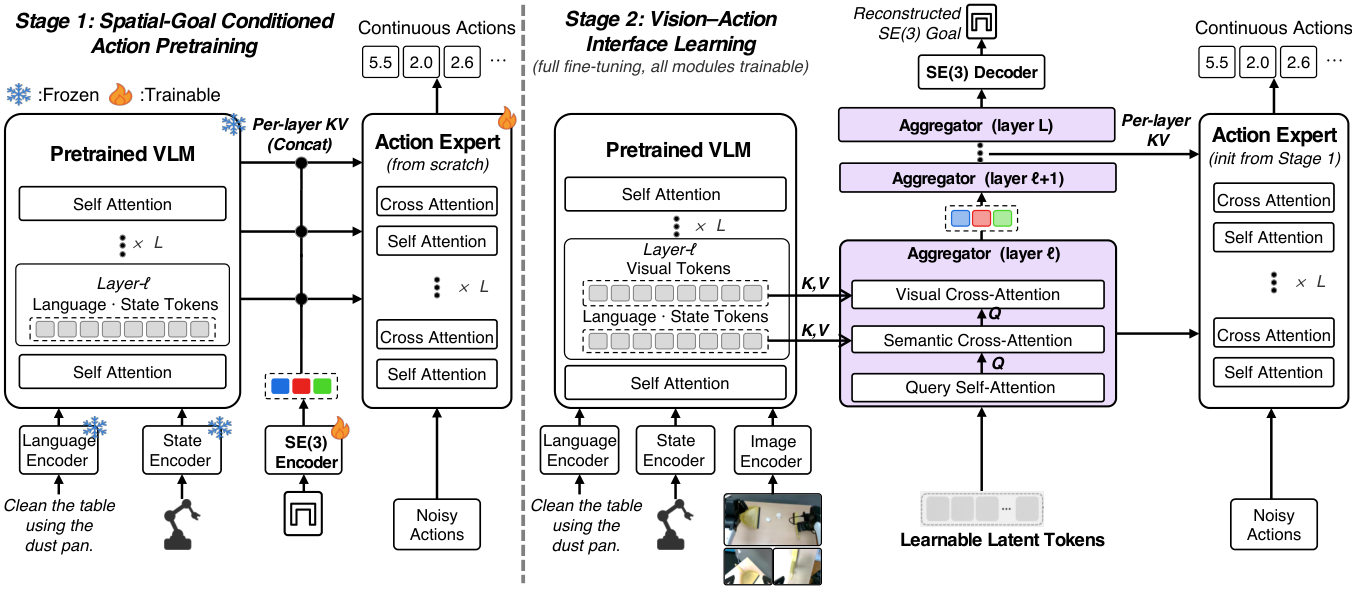
第二阶段再跑2万步,位姿重建损失落到0.003。基线一共训3万步,LIT把同样的步数拆成第一阶段1万加第二阶段2万。接口设置四套架构共用。仓库README还写了token维768、内部维512。推理时只留隐式接口,第一阶段的位姿编码器和第二阶段的位姿解码器都不用。
三、π0.5的LIBERO-Plus升至79.67
对照实验都从同一份预训练骨干出发,动作专家随机初始化,不微调已经发布的VLA或WAM策略权重。论文自己说,这些基线不能直接拿去跟公开的微调成绩比。
四套模型接视觉的方式本来就不一样。π0.5靠共享自注意力,MolmoAct2靠动作专家对VLM逐层交叉注意力,FAST-WAM只在训练时做未来视频预测,ImageWAM推理时仍做图像编辑去噪。
LIBERO上40个任务,每任务50次,共2000条回合。LIBERO-Plus是10030个扰动实例,每种扰动一次,固定种子。Overall是七个扰动轴的算术平均。
| 模型 | 路线 | LIBERO均分 | LIBERO-Plus Overall | 相机视角 | 语言指令 |
|---|---|---|---|---|---|
| π0.5基线 | VLA | 87.75 | 68.97 | 58.29 | 52.15 |
| π0.5+LIT | VLA | 91.80 | 79.67 | 80.30 | 71.50 |
| MolmoAct2基线 | VLA | 93.50 | 63.62 | 39.40 | 75.69 |
| MolmoAct2+LIT | VLA | 94.10 | 71.92 | 48.41 | 73.58 |
| FAST-WAM基线 | WAM | 97.60 | 51.44 | 16.40 | 68.90 |
| FAST-WAM+LIT | WAM | 98.10 | 60.63 | 43.83 | 69.55 |
| ImageWAM基线 | WAM | 98.10 | 83.02 | 82.16 | 90.97 |
| ImageWAM+LIT | WAM | 98.40 | 86.89 | 84.55 | 90.05 |
π0.5的LIBERO-Plus从68.97%做到79.67%,相机视角一项加了22.01个百分点。FAST-WAM在相机视角上从16.40%做到43.83%,加了27.43个百分点,是表里最大的单列增益。
28组架构乘扰动里,LIT赢了26组,掉点不超过2.11个百分点,都出在语言指令轴。MolmoAct2从75.69%掉到73.58%,ImageWAM从90.97%掉到90.05%。视觉被管住以后,语言这一路没有跟着变好。π0.5的语言项反倒从52.15%做到71.50%,这件事在四套架构里并不整齐。
真机用的是MolmoAct2,YAM双臂,三个任务一起训一个策略,每个任务100条示范,共300条。Keep LEGOs要把积木拆进盒子,Wipe trash要用簸箕清桌面,Transfer egg要把鸡蛋从锅里夹进碗。分布内每任务25次,共75次。每种分布外条件每任务10次,共90次。
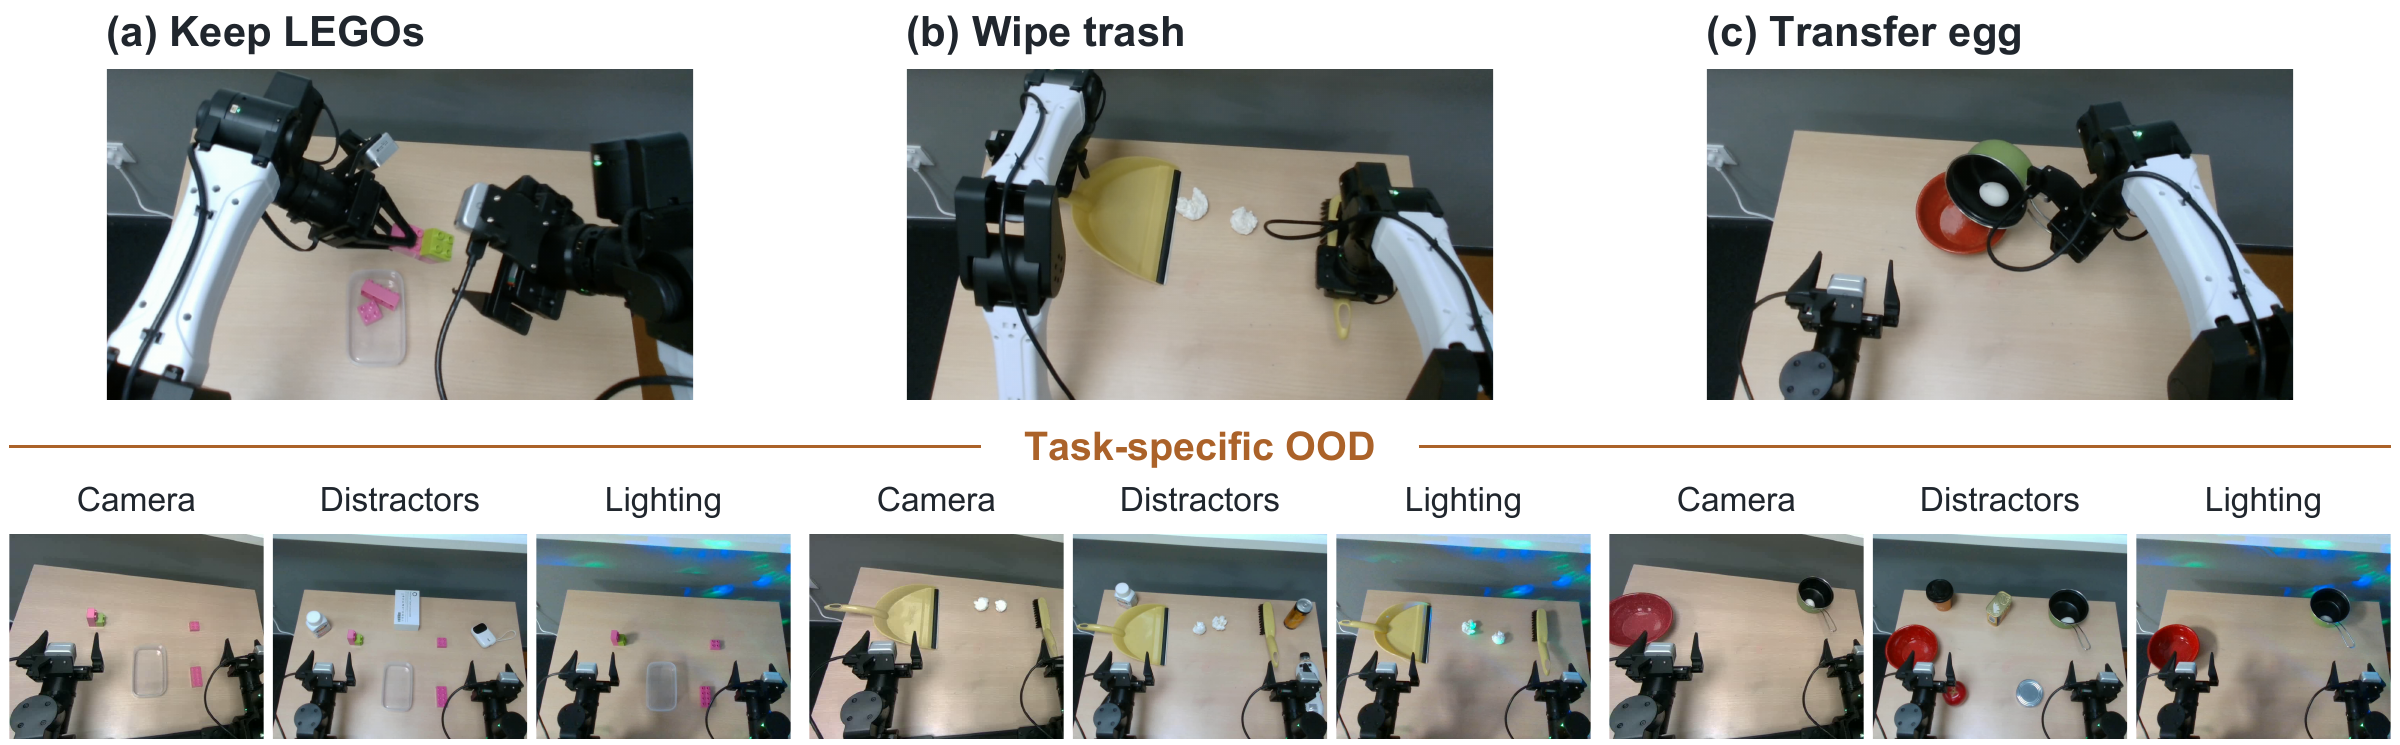
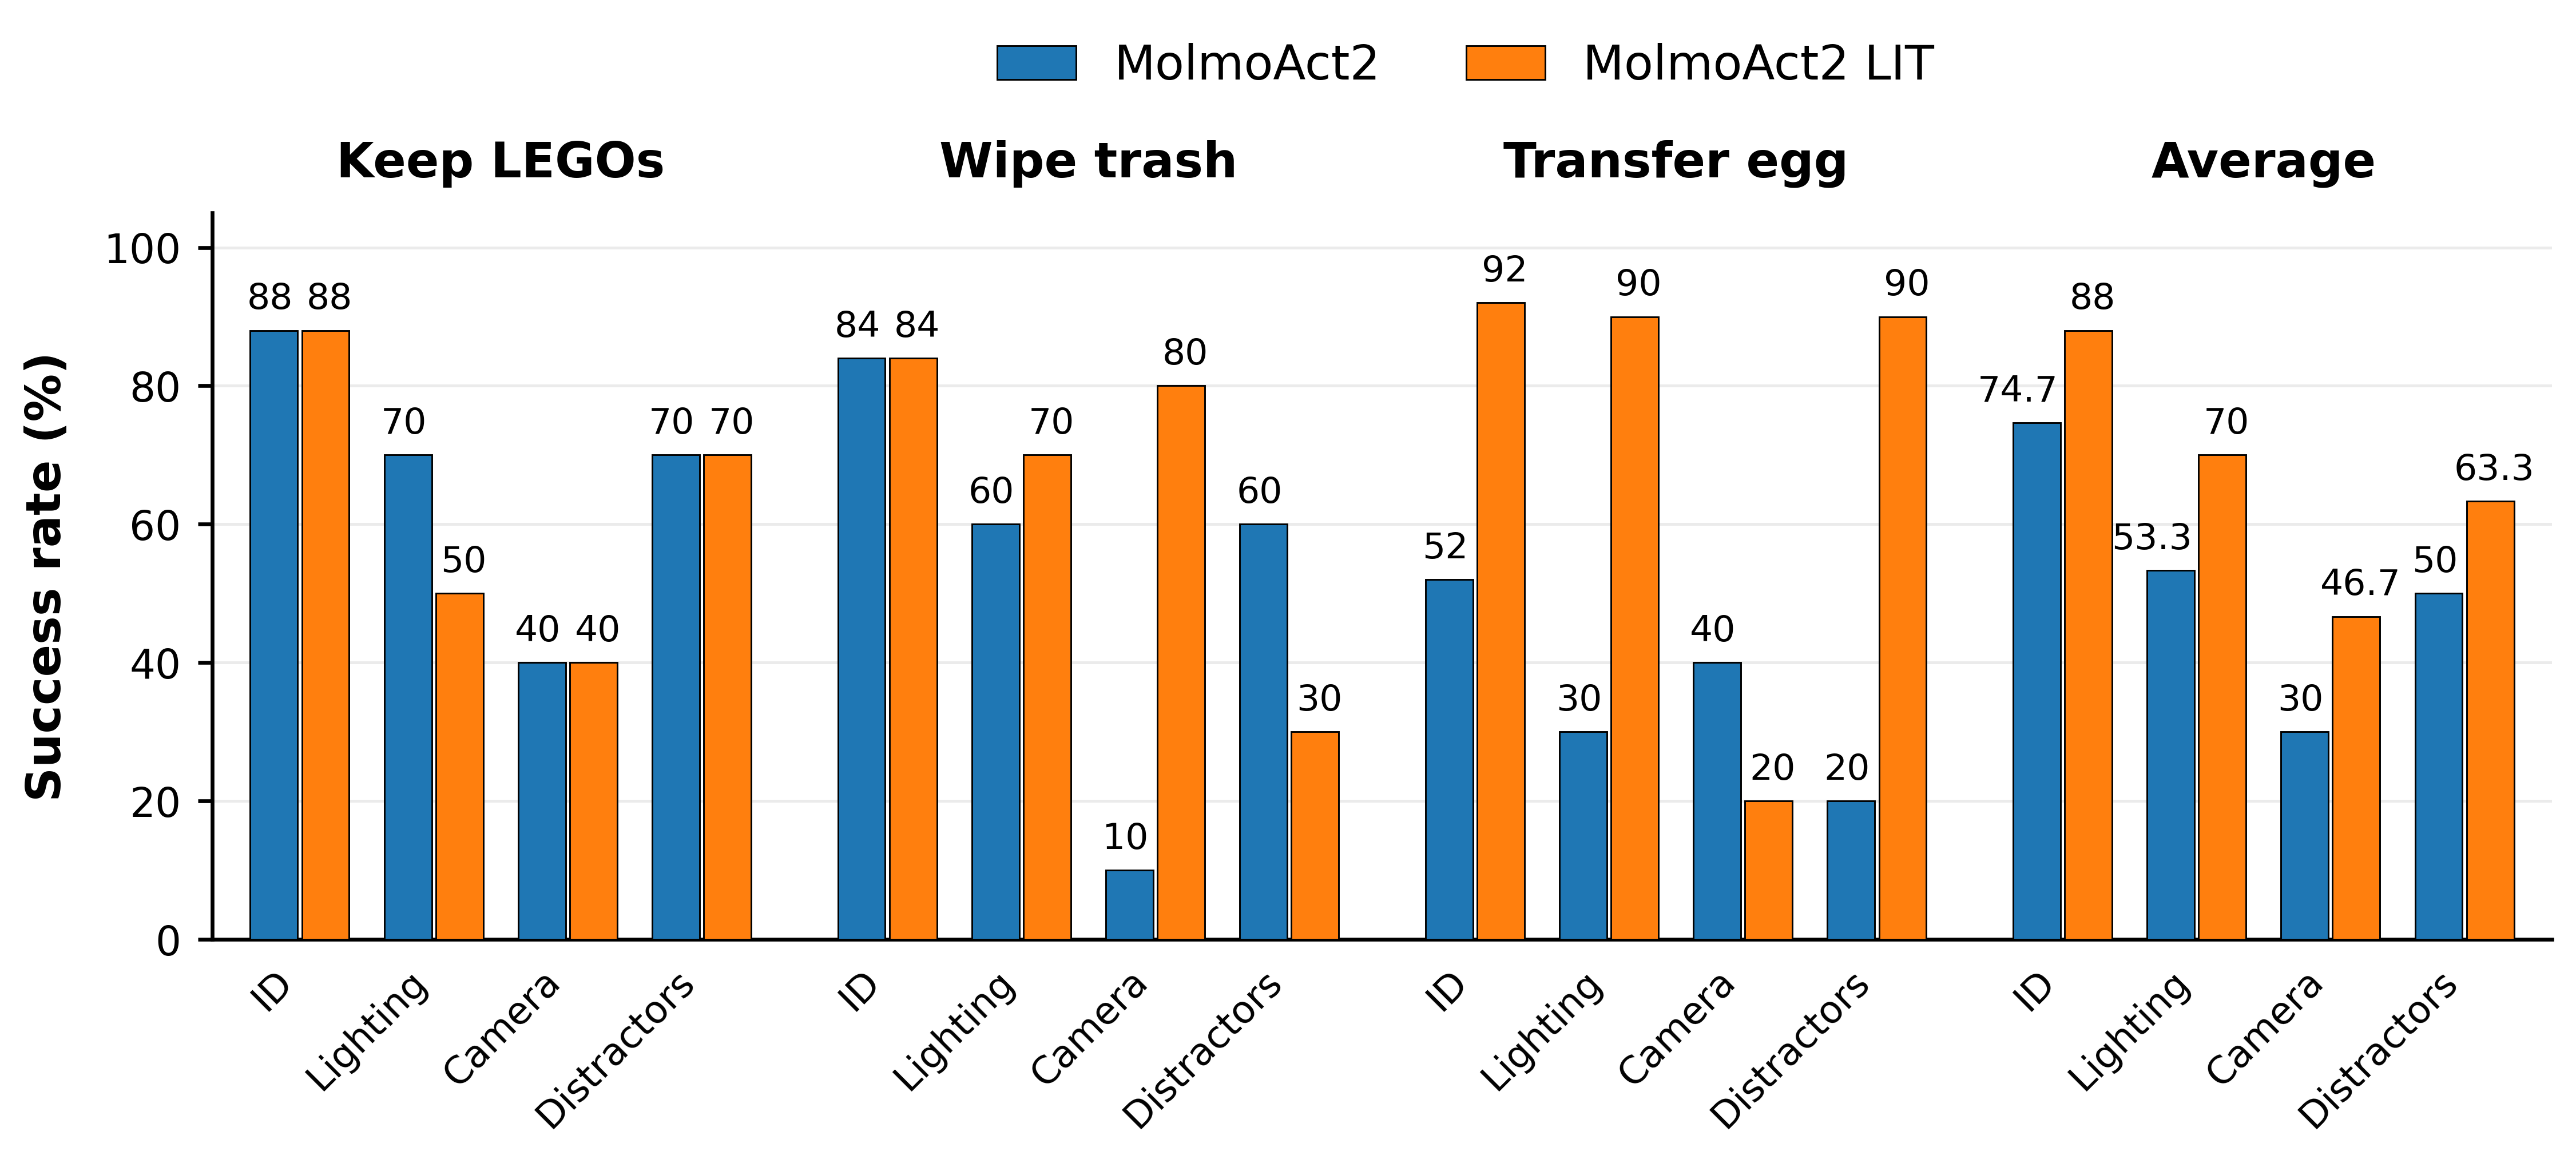
聚合三个任务,分布内从74.7%做到88.0%,新灯光从53.3%到70.0%,只留顶视相机从30.0%到46.7%,加干扰物从50.0%到63.3%。Transfer egg这项分布内从52.0%做到92.0%,增益很大。
图6把分任务拆开以后,故事没那么顺。Keep LEGOs换灯光从70掉到50,Wipe trash加干扰物从60掉到30,Transfer egg只留顶视从40掉到20。聚合数字把这几处回撤盖住了。只留顶视相机时整体仍停在46.7%,这一档还远谈不上稳。
四、直连视觉消融分布外掉4.18个百分点
消融都在MolmoAct2上做。先把三个零件逐个拆掉。
| 变体 | LIBERO均分 | LIBERO-Plus Overall |
|---|---|---|
| MolmoAct2基线 | 93.50 | 63.62 |
| 无第一阶段 | 93.70 | 68.23 |
| 无位姿监督 | 93.50 | 68.86 |
| 打开直连视觉 | 94.25 | 67.74 |
| 仅隐式token聚合 | 93.45 | 65.70 |
| LA4VLA式两阶段 | 93.75 | 65.46 |
| 基线加位姿监督 | 93.20 | 65.45 |
| LIT | 94.10 | 71.92 |
去掉第一阶段,动作专家随机初始化再进第二阶段,LIBERO-Plus从71.92%掉到68.23%。去掉位姿重建损失,掉到68.86%,传感器噪声从70.77%掉到60.02%。
第三条我看得最重。隐式接口、两阶段、位姿监督全留着,只把动作专家直接看视觉的那条路重新打开。LIBERO上94.25%,比完整LIT的94.10%还略高一点。LIBERO-Plus从71.92%掉到67.74%,掉了4.18个百分点。
分布内几乎不疼,分布外立刻往下掉。这条直连视觉的路确实在帮模型走捷径。
他们还试过三个更简单的解释。只保留隐式token聚合、做成LA4VLA那种无图再看图、只给基线加位姿重建,Overall分别是65.70%、65.46%、65.45%,都离71.92%差六个百分点上下。零件拆开以后,谁也撑不起完整LIT。
五、本地部署与推理实践
以下命令来自官方仓库MAGICLAB-NUS/LIT的README,MolmoAct2那条完整配方。
git clone --recursive -b feat/libero-goal-prior-v4 https://github.com/jianmanlincjx/Molmoact2.git
git clone https://github.com/MAGICLAB-NUS/LIT.git && cd LIT

export LIT_MOLMOACT2=/path/to/Molmoact2
export LIBERO_PLUS_ROOT=/path/to/LIBERO-plus
export DATASET_ROOT=/path/to/libero_lerobot_format
bash scripts/preflight.sh
cd "$LIT_MOLMOACT2"
bash scripts/libero_goal_prior_v3/train_stage1.sh
bash scripts/libero_goal_prior_v3/train_stage2.sh

cd /path/to/LIT
bash scripts/eval_libero_plus.sh lit <checkpoint-dir>
bash scripts/eval_libero.sh      lit <checkpoint-dir>
真机权重可以直接拉。
hf download shailes-h/Molmoact2-LIT
hf download shailes-h/yam_bimanual_manipulation --repo-type dataset
几个值得留意的参数。评测脚本默认打开LIBERO_PLUS_FIX_LANG=1,不上这个开关,LIBERO-Plus会把扰动文件名里的参数当成指令喂给策略,每个轴都会掉好几个点。Overall按七个扰动轴做算术平均,按任务加权大约再低两个点。接口超参四套架构没分开调。
六、总结与思考
把视觉和动作之间的接口单独拿出来训,比继续把表示做厚更对准这件事。打开直连视觉那条消融,是我觉得全篇最硬的证据,分布内分数还能更好看,分布外立刻往下掉。
短板也清楚。语言扰动没有吃到同样的好处,真机每种分布外条件只有每任务10次,样本很瘦。图6里已经有任务在个别条件下比基线差,聚合涨幅不能当成每个场景都更稳。只留顶视时整体仍停在46.7%,换相机这一关还没过。
基线也不是公开的微调权重,表格里的涨幅只能在这篇的配对设定里读。换到已经在大规模机器人数据上微调过的VLA上,捷径还在不在、接口还能不能挡住,这篇答不了。论文自己把更大的真机规模写成了未完成的事。
参考链接
- 论文原文 arXiv 2609.12641 v1,2026年9月,HTML版
- 项目页 Latent Interface Training
- 代码 MAGICLAB-NUS/LIT,Apache 2.0
- 真机权重 shailes-h/Molmoact2-LIT
- 真机数据 shailes-h/yam_bimanual_manipulation
- 对照架构 π0.5、MolmoAct2、FAST-WAM、ImageWAM
- 评测基准 LIBERO、LIBERO-Plus

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献18条内容

所有评论(0)