漫剧场景道具错乱、肢体畸形?知漫剧自动场景匹配
Meta描述: 场景道具错乱和肢体畸形是AI漫剧中最隐蔽的返工来源。本文拆解这两类问题的成因,分析知漫剧自动场景匹配和角色身体数据锁定的机制,给出从首集建档到批量生成的实操路径和对比数据。
做AI漫剧的人,都有过这种经历。一集内容生成完了,画面看着都不错,角色也没漂。把成片连着播一遍,突然发现第三镜里主角左手边的茶杯,到了第七镜跑到了右手边。第五镜里墙上挂着一幅画,第九镜里画不见了,换成了一个壁挂。第十二镜里角色的手臂比例明显不对,小臂比上臂还长,手掌的形状也歪了。这些问题不像角色漂移那样一眼就能看出来,也不像配音割裂那样一听就出戏。它们藏在画面的角落里,藏在肢体的细节中。但观众的大脑对空间关系和人体比例有天然敏感度,道具错乱和肢体畸形会让观众在潜意识里感到“不对劲”,观看沉浸感一点点被侵蚀。
知漫剧(aw.jiaxunai.cn) 的自动场景匹配机制,针对的正是这类隐蔽但高频的返工来源。它把场景空间信息和道具身份信息编码为结构化数据,存入场景库,后续所有镜头从库中自动调用。这篇文章拆解场景道具错乱和肢体畸形的成因,分析自动场景匹配的运行逻辑,给出从首集建档到批量生成的实操路径。
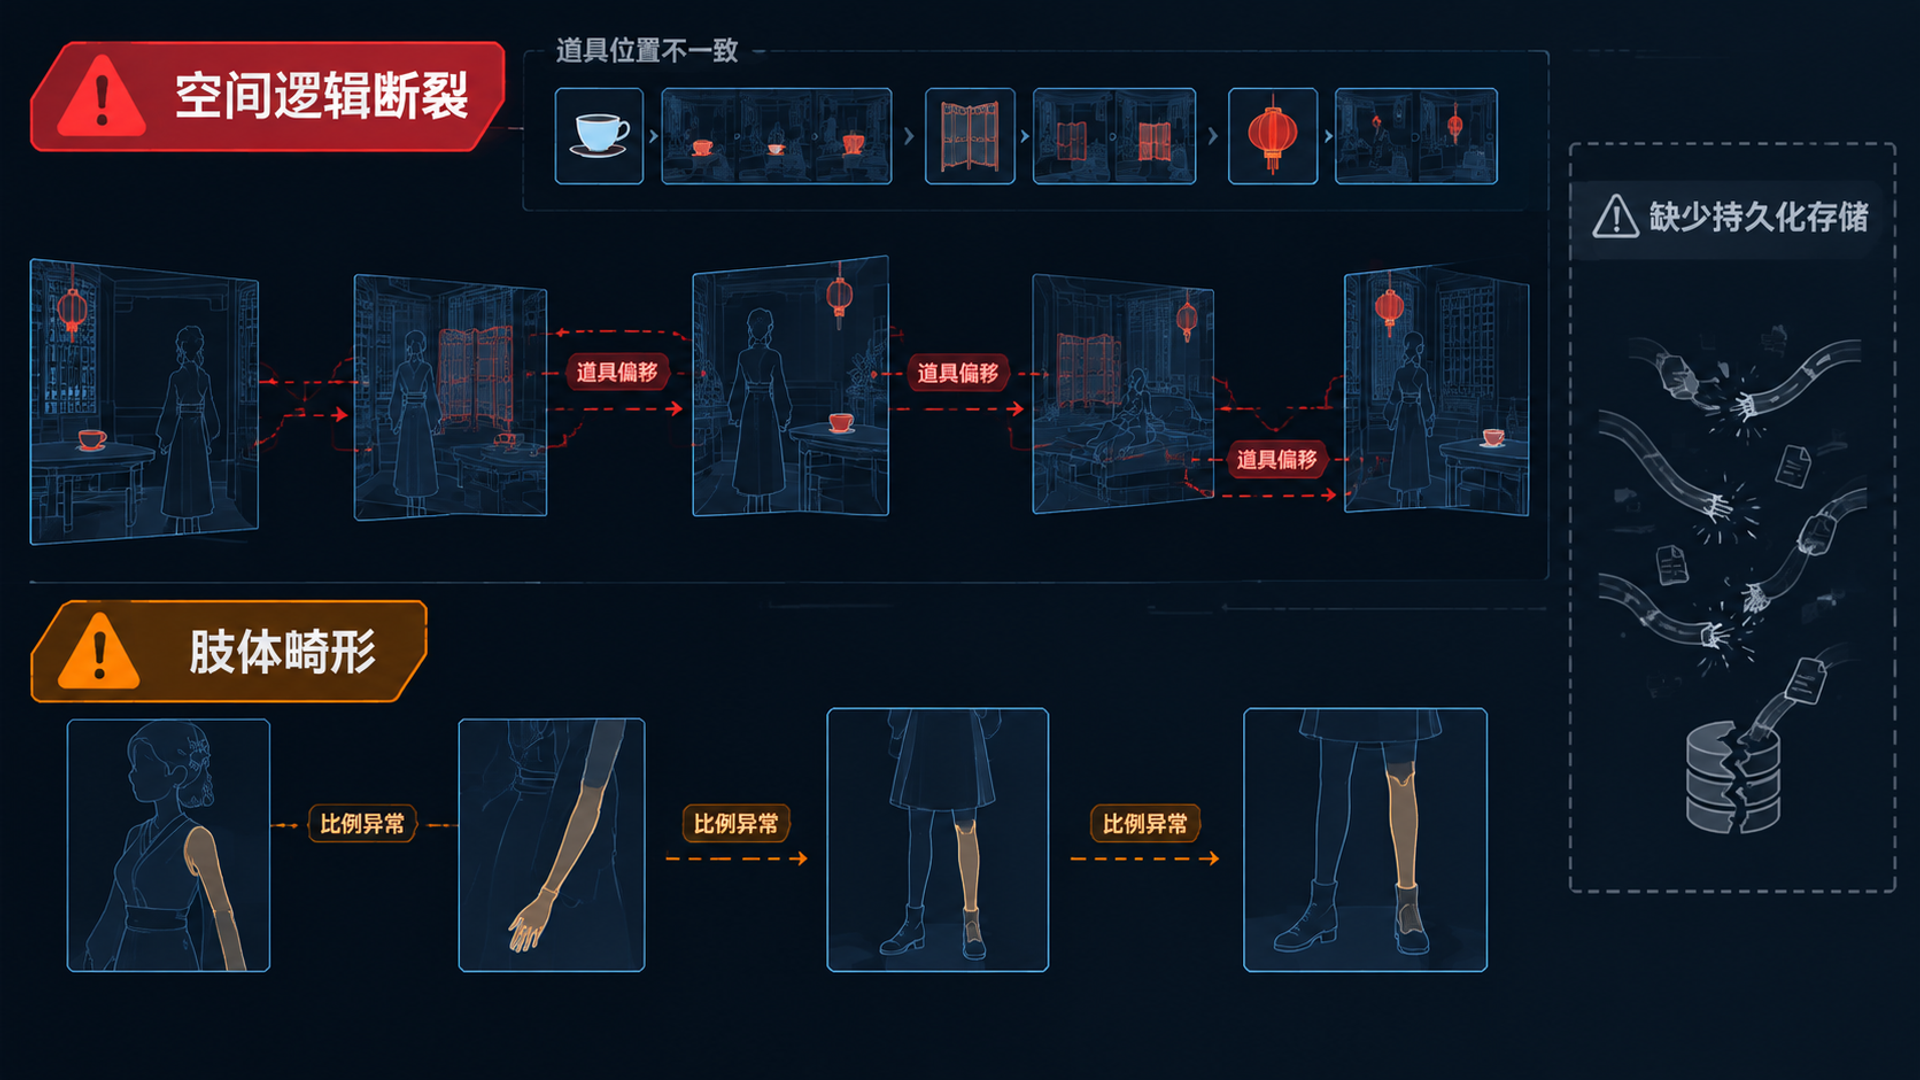
一、场景道具错乱和肢体畸形的三个成因
成因一:场景空间关系没有持久化存储。
在散装工具里,场景的生成依赖用户的文字描述。你在第一个镜头的提示词里写“窗户在左边,桌上有一盏茶壶”,生成出来的画面里窗户在左、茶壶在桌上。但到了第五个镜头,你重新描述场景时可能忘了写“茶壶在桌上”,或者写的顺序变了,模型对这个场景的理解就产生了偏差。每一次生成都是独立推理,模型不会记住上一次生成的场景里有什么、东西放在哪里。
成因二:道具没有独立的数据身份。
散装工具里,场景中的每一个道具——茶杯、书籍、屏风、灯笼——都是画面的一部分,没有被单独编码和存储。第一镜里茶杯是青花瓷,第五镜里可能变成白瓷;第一镜里屏风是四扇,第七镜里可能变成三扇。道具没有独立的数据身份,就无法在不同镜头中被稳定地调用和复用。
成因三:人体结构缺乏专门约束。
在生成角色做大幅度动作的镜头时,模型对人体结构的空间理解可能出现偏差。手臂的关节位置、手指的数量和形状、腿部的比例关系,在复杂姿态下容易变形。传统工具没有对人体结构进行专门的约束,模型在自由发挥时可能生成不符合解剖学的画面。用户只能在生成后逐帧检查,发现畸形后重新生成,而重新生成的结果仍然不可控。
场景道具错乱与肢体畸形的成因对照表:
| 问题类型 | 直接成因 | 散装工具下的表现 | 自动匹配的解决方向 |
|---|---|---|---|
| 道具位置错乱 | 空间关系无持久化存储 | 同一道具在不同镜头中位置偏移 | 场景库结构化存储空间数据 |
| 道具细节变化 | 道具无独立数据身份 | 茶杯颜色、屏风扇数等细节漂移 | 场景元素编码为可复用数据 |
| 肢体畸形 | 人体结构无专门约束 | 手臂比例失准、手指变形 | 角色库锁定身体比例数据 |
| 空间交互错误 | 角色和场景分开生成 | 角色穿墙、坐空、脚陷地板 | 角色与场景数据在系统内协同 |
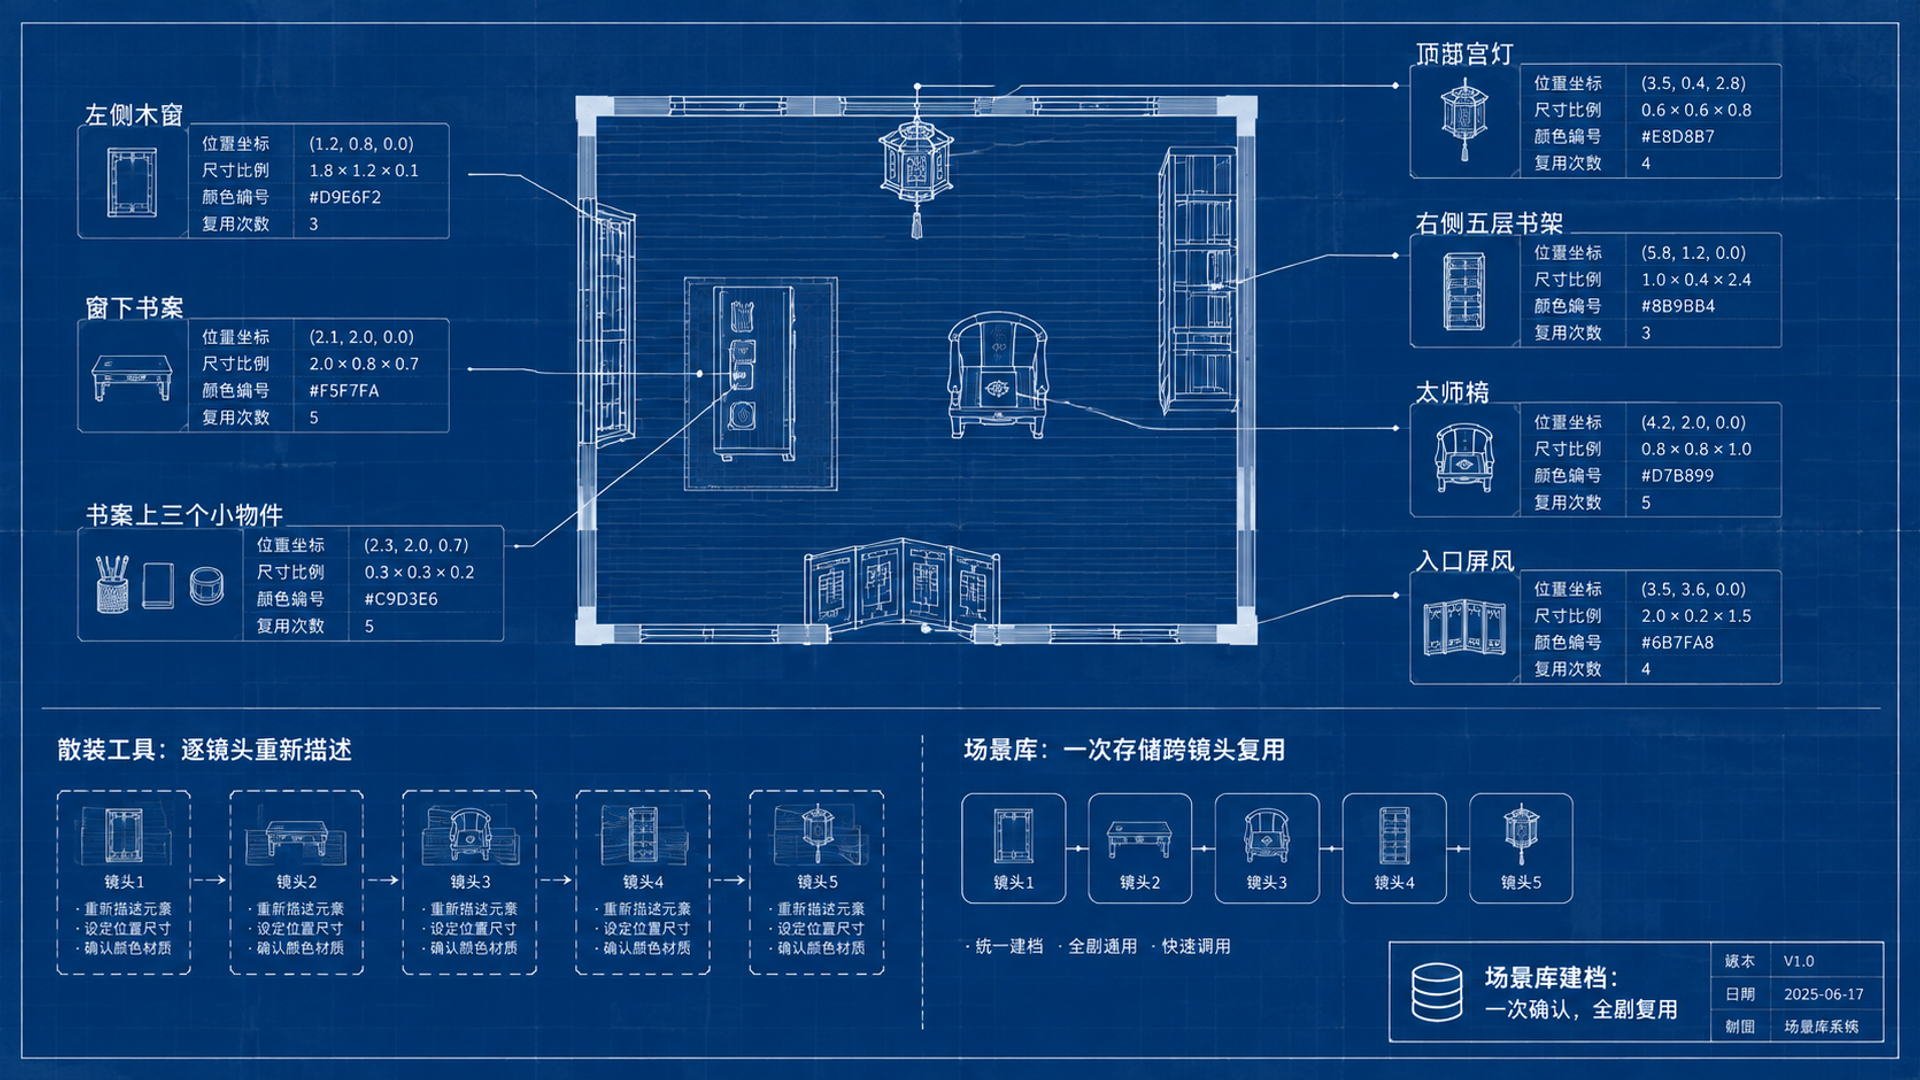
二、自动场景匹配的运行逻辑
自动场景匹配的核心,是把场景的空间信息和道具的身份信息编码为结构化数据,存入场景库。后续所有镜头中同一场景出现时,系统从场景库中调用同一套空间数据。
场景库的建档机制。 场景在首次出现时,系统自动识别核心空间元素——墙壁位置、门窗朝向、家具布局、装饰物摆放、地面材质、光线方向——并将这些信息编码为结构化数据。用户只需要在首集分镜检查时确认场景布局是否符合预期。确认后的场景数据写入场景库。
道具的独立编码。 场景中的关键道具被单独编码为场景数据的一部分。这些道具在后续镜头中再次出现时,系统从场景库中调用同一套道具数据,保持道具的位置、形状、颜色和数量的一致性。第一镜里的青花瓷茶杯,到第十镜里还是青花瓷茶杯。
空间交互的自动匹配。 角色在场景中的位置由剧本中的镜头信息决定。系统在生成分镜时,自动将角色的站位与场景的空间数据匹配。角色坐在椅子上时,椅子的位置和角色的身体位置在生成时被同时约束;角色推门时,门的位置和角色的手臂动作在生成时被同时考虑。
角色身体数据的锁定。 角色创建时,除了面部特征、发型发色、服装配色,角色的身体比例——身高、肩宽、四肢长度、手部尺寸——也被编码为结构化数据,存入角色库。这些数据在后续所有镜头中作为角色身体生成的基础约束。大幅度动作中的肢体畸形发生率因此降低。
自动场景匹配与传统方式对比表:
| 对比维度 | 自动场景匹配 | 散装工具手动维护 |
|---|---|---|
| 空间关系存储方式 | 场景库结构化存储,跨镜头自动复用 | 提示词描述,每次生成重新推理 |
| 道具一致性 | 道具独立编码,位置和细节稳定 | 靠提示词反复描述,容易漂移 |
| 多角度场景一致性 | 系统自动保持空间逻辑 | 用户手动协调,容易错乱 |
| 角色与场景交互 | 角色数据和场景数据协同生成 | 分开生成,交互靠描述维持 |
| 跨集场景复用 | 场景库持久化,续集自动调用 | 每集重新描述,维护成本高 |
| 逐帧修图需求 | 大幅减少,场景自动保障 | 频繁出现,需逐帧检查和返工 |
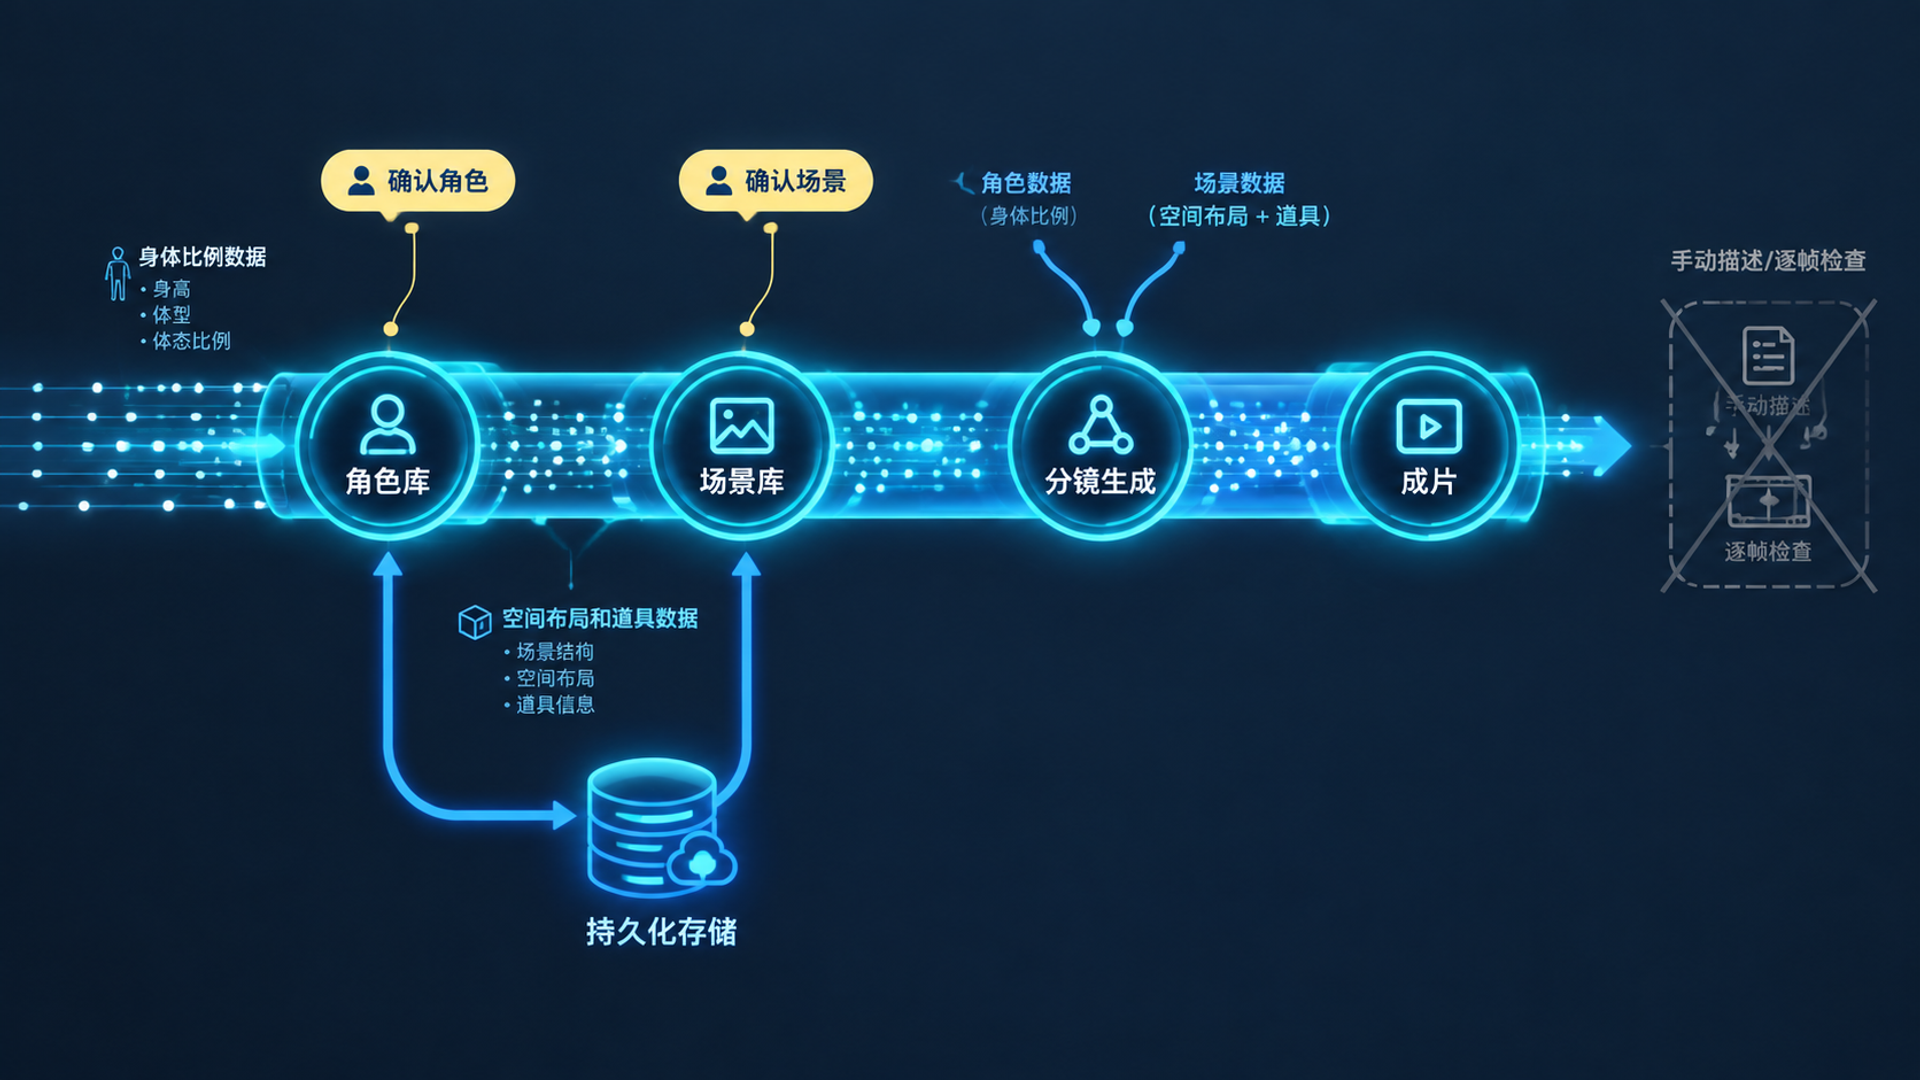
三、实操路径:从首集建档到批量生成
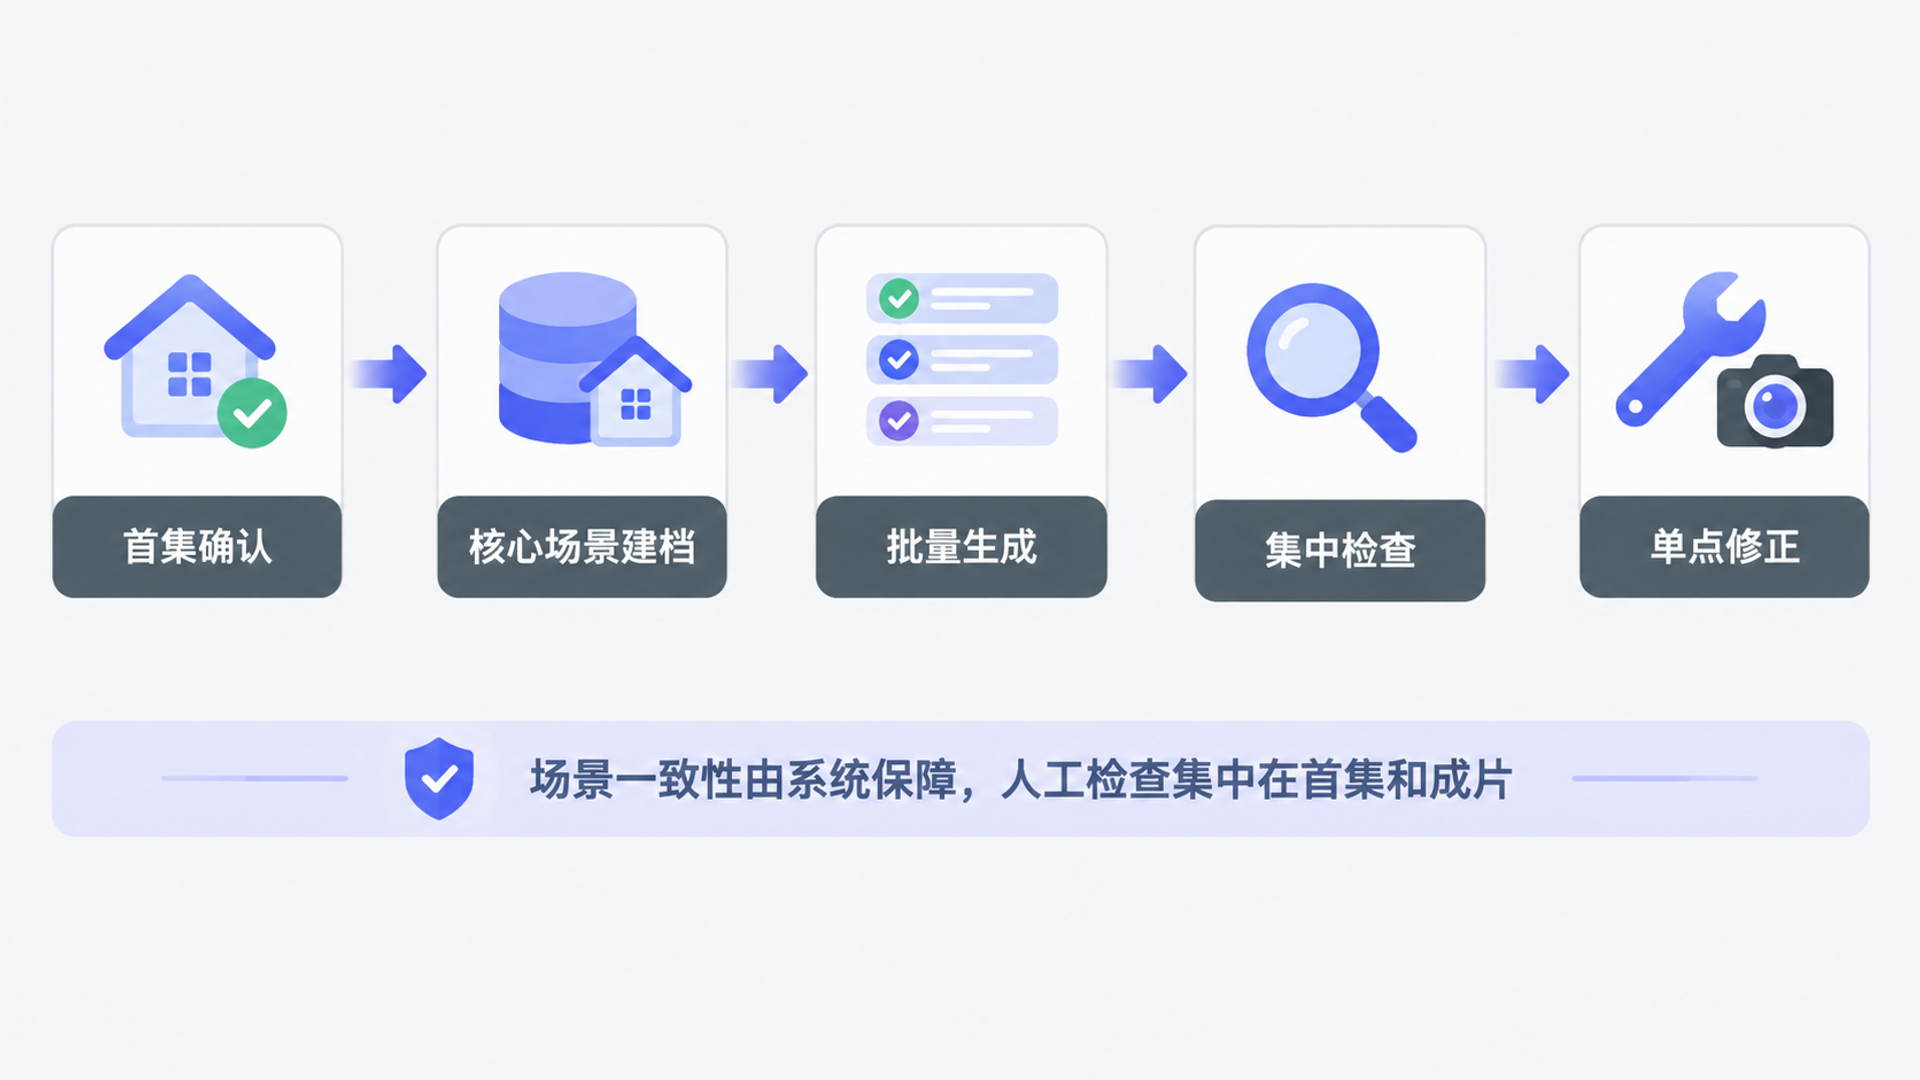
第一步:首集分镜检查时确认场景布局。 第一集分镜生成后,在检查角色和节奏的同时,关注场景的空间布局。确认门窗位置、家具摆放、道具细节是否符合剧情设定。如果某个道具的位置或细节需要调整,在首集就进行调整,系统会更新场景库数据。
第二步:核心场景在前两集集中展示。 故事中的核心场景——主角的家、宗门大殿、经常出现的街道——尽量在前两集中出现一次,完成场景库建档。建档之后,后续集数中这些场景再次出现时自动调用同一套空间数据。
第三步:批量生成时场景自动复用。 角色库和场景库就绪后,使用批量生成功能产出多集内容。系统在生成每一集的分镜时,自动从场景库中调用对应场景的空间数据,道具位置和空间关系保持一致。
第四步:检查时关注空间逻辑。 批量生成完成后,集中检查各集成片。在检查角色一致性和剧情节奏的同时,留意镜头切换时的空间关系是否稳定,道具位置是否前后一致。如果发现异常,用单镜头重新生成来处理,不需要逐帧修正。
第五步:场景变化时的处理。 如果剧情中某个场景发生了变化(比如房间重新布置了),可以在对应集数中对场景进行调整。修改后的场景数据从该集开始生效,之前已生成的集数不受影响。
场景匹配操作清单:
| 操作步骤 | 用户操作 | 系统自动完成 | 检查重点 |
|---|---|---|---|
| 首集场景确认 | 确认空间布局和道具细节 | 场景数据写入场景库 | 门窗位置、家具布局 |
| 核心场景建档 | 前两集集中展示核心场景 | 自动建档 | 场景完整性 |
| 批量生成 | 设置队列,系统自动执行 | 场景库自动调用 | 跨集场景一致性 |
| 集中检查 | 浏览成片,关注空间逻辑 | 无 | 道具位置、空间关系 |
| 单点修正 | 对异常镜头单独重新生成 | 更新该镜头 | 不影响其他镜头 |
四、常见问题解答
Q1:自动场景匹配能处理室外大场景吗?
可以。场景库机制对室内场景和室外场景同样适用。室外场景的空间元素更多、比例更大,但同样可以被编码为结构化数据。首次确认场景布局后,系统在后续生成中自动维持空间关系。室外大场景在多角度生成时难度较高,建议在首集确认时多花时间仔细检查。
Q2:如果某个道具在后续集数中需要发生变化,怎么处理?
可以在对应集数中对场景进行调整。场景库支持在特定集数中修改场景数据,修改后的场景从该集开始生效,之前已生成的集数不受影响。这种机制适合处理剧情中道具损坏、更换或场景变化的场景。
Q3:肢体畸形的问题能完全避免吗?
任何基于生成式AI的工具在极端复杂的动作场景中仍可能出现瑕疵。角色库机制把身体比例数据作为生成约束,大幅降低了肢体畸形的发生率。如果某个镜头仍然出现畸形,可以用单镜头重新生成来处理。
Q4:批量生成时,场景库会自动应用到所有集数吗?
是的。批量生成队列中的每一集都从场景库调用对应场景的空间数据,不需要逐集手动设置。场景库的持久化存储保证跨集场景一致性。
Q5:场景库建档需要额外操作吗?
场景库建档发生在首集分镜生成时,系统自动为出现的场景建立空间档案。用户只需要在首集分镜检查时确认场景布局是否符合预期。如果某个场景需要调整,在首集进行调整即可。建档完成后,后续集数自动复用。
结语
场景道具错乱和肢体畸形,是AI漫剧里最隐蔽也最消耗耐心的返工来源。它们不像角色漂移那样一眼可见,但观众的空间感知和人体感知会捕捉到这些不一致,观看沉浸感被一点点侵蚀。散装工具下,空间关系没有持久化存储,道具没有独立数据身份,人体结构缺乏专门约束,用户只能在生成后逐帧检查、反复返工。知漫剧的自动场景匹配机制把场景空间信息和道具身份信息编码为结构化数据,存入场景库。后续所有镜头从场景库调用同一套数据,道具位置和细节保持稳定。角色库锁定身体比例数据,动作生成时受到身体约束,肢体畸形率大幅降低。首集确认场景布局,后续集数自动复用,逐帧修图的需求从流程中被大幅削减。场景和道具的事情交给系统,创作者把精力留给故事和节奏。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)