2022-2026年AI核心名词通俗解析:从会说话到会思考,再到会干活、会组团!
这两年,不管刷手机还是开会,满屏都是 AI 黑话:LLM、RAG、Agent、MCP……这篇文章不绕弯子,把 2022 年以来最重要的 35 个 AI 名词,按年份讲清楚。每个词都按三步拆:它是什么 → 有什么用 → 本质是啥(本质我会打个比方)。
先记住一句话,整篇文章都是围绕它展开的:这五年AI干的事,就是从「会说话」到「会思考」,再到「会干活」、最后「会组团」。
一、2022 年:AI 突然会说话了
- Generative AI(/ˈdʒenərətɪv ˌeɪ ˈaɪ/,生成式人工智能)
🔤是什么:能自己「造内容」的 AI——写文章、画图、编代码都行。以前那种只会分类判断的 AI 不叫这个。
🎯有什么用:AI 从「看懂」变成「会创作」,整个内容行业被改写。
🧬本质:本质是「概率续写」。它背下了海量内容里的规律,你给个开头,它按概率把「最像样」的后续补出来。所谓创作,其实是预测。
- LLM(/ˌel el ˈem/,Large Language Model /lɑːrdʒ ˈlæŋɡwɪdʒ ˈmɑːdl/,大语言模型)
🔤是什么:用海量文本训练出来的巨型神经网络,专门处理语言。
🎯有什么用:所有现代 AI 应用的地基。ChatGPT、DeepSeek 背后都是它。
🧬本质:把全人类的文本「压缩」成几百上千亿个数字参数。它没有记忆、没有意识,只有一项技能——接龙。你感觉它在「理解」,其实它在「续写」。
- ChatGPT(/tʃæt dʒiː piː tiː/,Chat Generative Pre-trained Transformer /tʃætˌdʒenərətɪv priː ˈtreɪnd trænsˈfɔːrmər/)
🔤是什么:OpenAI 做的聊天机器人,2022 年 11 月上线。
🎯有什么用:AI 的「iPhone 时刻」——5 天破百万用户,把 AI 从实验室送进普通人的手机。
🧬本质:技术上没有革命性新发明,本质是「大模型+聊天界面+人类反馈」的产品化封装。真正的突破是:让不会编程的人也能直接「吩咐」AI。
- RLHF(/ɑːr el eɪtʃ ef/,Reinforcement Learning from Human Feedback /ˌriːɪnˈfɔːrsmənt ˈlɜːrnɪŋ frəm ˈhjuːmən ˈfiːdbæk/,基于人类反馈的强化学习)
🔤是什么:让人给 AI 的回答打分,AI 据此学会「人类喜欢什么样的回答」。
🎯有什么用:ChatGPT 说话「像人、有用、不冒犯」的秘诀。
🧬本质:用人类偏好当「奖励信号」。好比老师给作文打分,学生反复改,直到摸清老师的评分标准。
- Prompt Engineering(/prɑːmpt ˌendʒɪˈnɪrɪŋ/,提示工程)
🔤是什么:通过精心设计提问的话术,让 AI 输出更高质量的答案。
🎯有什么用:催生了「提示词工程师」这个职业——同一个 AI,问法不同,答案质量天差地别。
🧬本质:引导 AI 的「猜测范围」。好提示词 = 把 AI 的选择范围缩小到正确答案附近。
- Hallucination(/həˌluːsɪˈneɪʃn/,幻觉)
🔤是什么:AI 一本正经地编造不存在的事实,语气还特别笃定。
🎯有什么用:大模型最著名的缺陷,让行业意识到 AI 不能盲信,催生出一整条「防幻觉」产业。
🧬本质:续写机制的必然副作用。模型只负责「下一个词像什么」,不负责「是不是事实」。不知道答案时,它不会说「不会」,而是编一个最像答案的——像个过度自信的吹牛者。
二、2023 年:AI 越来越专业了
- GPT-4(/dʒiː piː tiː fɔːr/,Generative Pre-trained Transformer 4)
🔤是什么:OpenAI 第四代旗舰大模型,能识图,能通过律师资格考试。
🎯有什么用:让公众第一次接受「AI 达到人类专业水平」。
🧬本质:缩放定律的又一次验证——数据、参数、算力一起堆,能力就水涨船高。没有新架构,就是「堆规模」堆出了质变。
- Multimodal(/ˌmʌltiˈmoʊdl/,多模态)
🔤是什么:AI 能同时处理文字、图片、声音、视频等多种信息。
🎯有什么用:AI 从「文盲」变成「通感者」——看图说话、听声写字,解锁大量真实场景。
🧬本质:把不同感官的数据翻译成同一种「内部语言」,再放进同一个模型里对齐学习。就像人用「意义」打通了视觉和语言。
- Alignment(/əˈlaɪnmənt/,对齐)
🔤是什么:让 AI 的目标和价值观与人类一致。
🎯有什么用:把 AI 从技术问题升级成安全伦理问题——「怎么保证 AI 不骗人、不伤人、不失控」。
🧬本质:给能力装方向盘。模型像马力巨大的车,对齐就是确保它往人类想去的方向开。
- Fine-tuning(/ˌfaɪn ˈtuːnɪŋ/,微调)和 LoRA(/ˈlɔːrə/,Low-Rank Adaptation /loʊ ræŋk ˌædæpˈteɪʃn/,低秩适配)
🔤是什么:在通用模型基础上,用你自己的小数据「加训」,得到专用模型。LoRA 是其中一种特别省钱的微调方法。
🎯有什么用:企业能低成本定制专属 AI,LoRA 把微调成本从百万级降到几千块。
🧬本质:在通才基础上上专业课;LoRA 是只改写「一小块记忆区」,改得少、改得快、还省电。
- RAG(/ræɡ/,Retrieval-Augmented Generation /rɪˈtriːvl ɔːɡˈmentɪd ˌdʒenəˈreɪʃn/,检索增强生成)
🔤是什么:回答前先到资料库里检索相关内容,再基于资料作答。
🎯有什么用:解决「幻觉」和「知识过时」的主流方案,企业知识库问答的标准架构。
🧬本质:给 AI 配图书馆+查证习惯——先翻书再回答,还给你标出处。
- AGI(/ˌeɪ dʒiː ˈaɪ/,Artificial General Intelligence /ˌɑːrtɪˈfɪʃl ˈdʒenərəl ɪnˈtelɪdʒəns/,通用人工智能)
🔤是什么:像人一样,几乎什么智力活都能干的 AI。
🎯有什么用:整个行业的「终局目标」,围绕它的争论影响了全球科技政策。
🧬本质:现在的 AI 是「概率续写机」,再强也是单项通才;AGI 要求的是「不靠堆数据就能学会新任务」。目前仍是目标,不是现实。
- Token(/ˈtoʊkən/,词元)
🔤是什么:AI 处理文本前,先把文字切成的「小块」。约等于大半个汉字。
🎯有什么用:AI 的计价单位和能力标尺——API 按 Token 收费,模型记忆长度也按 Token 算。
🧬本质:把连续语言「离散化」。语言没法直接喂给数学模型,得先切成块、转成数字。Token 就是 AI 消化文本的最小颗粒。
三、2024 年:AI 会思考了
- Sora(/ˈsɔːrə/,OpenAI 的文生视频模型)/ Text-to-Video(/tekst tə ˈvɪdioʊ/,文生视频)
🔤是什么:输入一句话,生成一段逼真的短视频。
🎯有什么用:震动影视和广告行业——AI 从「写剧本」进化到「直接拍片」。
🧬本质:在数据里学会物理规律。视频要符合重力、遮挡、光影,模型靠看海量视频把这些规律学进参数。本质还是概率预测,只是预测对象从文字变成了像素。
- GPT-4o(/dʒiː piː tiː fɔːr oʊ/,o = Omni /ˈɑːmni/,全模态)
🔤是什么:原生支持文字、语音、图像实时交互的模型,2024年 5 月发布。
🎯有什么用:AI 对话延迟压到毫秒级,能像真人一样实时听、说、看、打断你。
🧬本质:以前多模态是「几个模型拼装」,GPT-4o 是「一个大脑直连五官」——所有模态进同一个网络一起训练,反应快、理解连贯。
- CoT(/ˌsiː əʊ ˈtiː/,Chain-of-Thought /tʃeɪn əv θɔːt/,思维链)
🔤是什么:让模型把推理过程一步步写出来,再给结论。
🎯有什么用:数学、逻辑、编程题的正确率大幅提升,是「推理模型」的核心机制。
🧬本质:让 AI 打草稿。一步到位容易错,把中间步骤写出来,每一步的难度都变低,还能自我检查——用「过程」换「准确率」。
- Test-Time Compute(/test taɪm kəmˈpjuːt/,测试时计算)/ Inference-Time Scaling(/ˈɪnfərəns taɪm ˈskeɪlɪŋ/,推理时扩展)
🔤是什么:在「回答问题」阶段多花算力多思考,而不只是在训练阶段堆算力。
🎯有什么用:打破了「只有训练才能变强」的认知——答题时多想一会儿,能力也能显著提升。
🧬本质:思考时间换能力。好比考试时允许你多用草稿纸反复验算。
- MoE(/ˌem əʊ ˈiː/,Mixture of Experts /ˈmɪkstʃər əv ˈekspɜːrts/,混合专家)
🔤是什么:把大模型拆成多个「专家模块」,每次只激活一小部分来干活,配一个「路由器」派活。
🎯有什么用:用更少算力做到更大规模,DeepSeek 等模型降本的关键技术。
🧬本质:大公司的「按需用人」。看起来是千亿参数的大公司,每次干活只花一小部分预算。
- World Model(/wɜːrld ˈmɑːdl/,世界模型)
🔤是什么:让 AI 学习物理规则、空间关系、因果规律,能在脑中「模拟」世界运转。
🎯有什么用:通向自动驾驶、机器人、通用智能的关键技术。
🧬本质:给 AI 装「世界观」——知道苹果会往下掉、水往低处流。人类不用想的常识,模型得从数据里一点点内化。
- VLM(/ˌviː el ˈem/,Vision-Language Model /ˈvɪʒn ˈlæŋɡwɪdʒ ˈmɑːdl/,视觉语言模型)
🔤是什么:同时理解图像和文字、并能在两者间自由转换的模型。
🎯有什么用:让 AI 能「看着说明书干活」,是多模态模型的底层技术。
🧬本质:给眼睛接上语言中枢。图像和文字都转成数字,放进同一空间对齐学习,让「看见的」和「说出的」能互相翻译。
- MCP(/ˌem siː ˈpiː/,Model Context Protocol /ˈmɑːdl ˈkɑːntekst ˈproʊtəkɔːl/,模型上下文协议)
🔤是什么:统一规定 AI 如何连接外部工具、数据和软件的标准协议(2024 年底发布,2025 年爆火)。
🎯有什么用:被称作「AI 界的 USB-C」——工具做一次适配,所有 AI 都能用。
🧬本质:统一插头标准。就像 USB-C 统一了充电口,MCP 把「AI 和工具怎么对接」标准化了。
- DeepSeek-V3(/diːp siːk viː θriː/,深度求索第三代/diːp siːk/)
🔤是什么:DeepSeek(深度求索,中国 AI 公司)2024 年 12 月发布的第三代大模型,6710 亿参数混合专家(MoE)架构,开源。
🎯有什么用:训练成本仅约 560 万美元,性能却比肩耗资数亿美元的国外顶尖模型——「便宜大碗」震动全球 AI 圈。
🧬本质:把「大力出奇迹」变成「巧力出奇迹」。靠MoE 稀疏激活 + 极致工程优化,用别人零头的成本做出同一水平的能力,撕开了「AI 只能靠烧钱」的认知。
四、2025 年:AI 开始干活了
- DeepSeek-R1(/diːp siːk ɑːr wʌn/,深度求索推理模型)
🔤是什么:DeepSeek 2025 年 1 月发布的开源推理模型——会用思维链(CoT)一步一步思考,再输出答案。
🎯有什么用:数学、代码等推理能力追平 OpenAI o1,训练成本却低两个数量级,且完全开源。发布即引爆全球,被称作「AI 界的 DeepSeek 时刻」。
🧬本质:用「可验证奖励强化学习(RLVR)+ 组相对策略优化(GRPO)」让模型自己学会思考——没有秘密配方,靠公开的算法和工程优化,把顶尖推理能力从巨头专属变成人人可复现。
- AI Agent(/ˌeɪ ˈaɪ ˈeɪdʒənt/,智能体)/ Agentic AI(/eɪˈdʒentɪk ˌeɪ ˈaɪ/,智能体式 AI)
🔤是什么:能自主规划步骤、调用工具、执行多步任务、出错了还会自己改的 AI。
🎯有什么用:AI 从「顾问」变成「员工」——订机票、写代码、跑业务流程,2025 年被称为「智能体元年」。
🧬本质:给大脑装上手脚和循环。大模型负责想,工具调用负责做,环境反馈负责改,形成「感知-决策-行动」闭环。
- Computer Use(/kəmˈpjuːtər juːs/,计算机操作)
🔤是什么:AI 像人一样看屏幕、动鼠标、敲键盘,直接操作现有软件。
🎯有什么用:所有现存软件不用改造,AI 就能用,企业自动化门槛大降。
🧬本质:用人类的操作界面当接口——与其给 AI 开发专用接口,不如让它学会「用鼠标点」这种最通用的能力。
- Distillation(/ˌdɪstɪˈleɪʃn/,蒸馏)
🔤是什么:用强大的「教师模型」去训练一个更小的「学生模型」,让学生学会老师的大部分能力。
🎯有什么用:顶尖能力被「浓缩」进小模型,手机、个人电脑也能跑。
🧬本质:师承制。老师傅带徒弟,徒弟没有师傅的资历,但有师傅的手艺。
- RLVR(/ɑːr el viː ɑːr/,Reinforcement Learning with Verifiable Rewards /ˌriːɪnˈfɔːrsmənt ˈlɜːrnɪŋ wɪð ˈverɪfaɪəbl rɪˈwɔːrdz/,可验证奖励强化学习)
🔤是什么:用「有标准答案」的任务(数学题、代码能不能跑)自动评判 AI 对错,再强化训练。
🎯有什么用:DeepSeek-R1 等推理模型的训练秘诀,AI 在「对错分明」的领域自我进化。
🧬本质:用客观标准当考官。答案对就是对,错就是错,机器可以无限自练——像刷题机器,对一下标准答案就知道学得怎么样。
- GRPO(/ˌdʒiː ɑːr piː ˈoʊ/,Group Relative Policy Optimization /ɡruːp ˈrelətɪv ˈpɑːləsi ˌɑːptɪməˈzeɪʃn/,组相对策略优化)
🔤是什么:DeepSeek 提出的强化学习算法,让一批模型对同一问题各自作答,再互相比较优劣来更新。
🎯有什么用:训练成本大降,让「训出会推理的模型」不再是巨头专属。
🧬本质:同学互评代替请家教。传统方法要额外雇「裁判模型」当老师(贵),GRPO 让多个答案内部竞争,比出谁更好就行。
- Vibe Coding(/vaɪb ˈkoʊdɪŋ/,氛围编程,也叫口述编程)
🔤是什么:用自然语言说需求,让 AI 生成代码,人只负责提需求和验收。
🎯有什么用:编程门槛被击穿,不懂语法的人也能做出工具和网站。
🧬本质:人机分工转移。人从「写代码」解放出来,专注「说清楚要什么、检查做得对不对」。
- Digital Employee(/ˈdɪdʒɪtl ɪmˈplɔɪiː/,数字员工)
🔤是什么:能独立承接完整业务流程、像正式员工一样被「雇佣和管理」的智能体。
🎯有什么用:企业 AI 应用从「工具辅助」升级为「岗位替代」,财务、客服、运营岗位出现「AI 同事」。
🧬本质:把岗位流程软件化。一个人的完整工作流(查数→分析→写报告→发通知)被拆成智能体的固定动作链。
五、2026 年:AI 组团上桌了
- Kimi K3(/ˈkiːmi keɪ θriː/,月之暗面旗舰模型)
🔤是什么:月之暗面(Moonshot AI)2026 年 7 月发布的旗舰大模型,总参数 2.8 万亿,支持 100 万 Token 上下文和原生图像视频理解。
🎯有什么用:发布即登顶全球开源模型榜首——前端代码能力全球第一,国产开源模型首次在规模与能力上全面对标国际顶尖闭源模型,被称为「AI 超级大脑」。
🧬本质:把「规模即智能」推到新高度——2.8 万亿参数 + 百万级上下文,用极致规模换通用能力;同时选择开源,把「最强」和「开放」同时握在手里。
- Skills(/skɪlz/,技能)
🔤是什么:把 AI 完成某类任务的方法封装成可复用的模块(如「做 PPT」「写合同」)。
🎯有什么用:正在取代「提示词工程」——从「每次教 AI 怎么干」变成「一键调用现成技能包」。
🧬本质:能力的封装与复用。像手机 App 一样,把 AI 的手艺打包成即点即用的应用。
- A2A(/ˌeɪ tə ˈeɪ/,Agent-to-Agent /ˈeɪdʒənt tə ˈeɪdʒənt/,智能体间通信协议)
🔤是什么:规定不同公司、不同系统的 AI 智能体如何互相协作、派活、汇报的标准。
🎯有什么用:智能体从「单兵作战」走向「团队协作」,不同厂商的 AI 能协同干活。
🧬本质:给智能体定「社交礼仪」。就像 HTTP 让不同公司的网站能互相链接,A2A 让不同家的 AI 能握手、派活、交结果。
- Embodied AI(/ɪmˈbɑːdid ˌeɪ ˈaɪ/,具身智能)
🔤是什么:拥有物理身体(机器人、自动驾驶汽车)的 AI,能感知真实世界并作用于它。
🎯有什么用:人形机器人、自动驾驶的「大脑」,被看作 AI的下一波浪潮。
🧬本质:智能需要身体去落地。不摸、不走、不搬,AI 就学不会物理规律,只能在数字世界里「纸面聪明」。
- Agent Orchestration(/ˈeɪdʒənt ˌɔːrkɪˈstreɪʃn/,智能体编排)
🔤是什么:协调管理多个智能体的分工、优先级、出错处理,让一群 AI 协同完成复杂任务。
🎯有什么用:复杂业务(如整个公司的订单到交付流程)可以交给一组 AI 分工完成。
🧬本质:组织管理问题。单个智能体再强也是单兵,编排解决的是「谁干什么、信息怎么传、出错了谁来兜底」——相当于给智能体团队配个项目经理。
最后唠两句
为什么AI大模型成为越来越多程序员转行就业、升职加薪的首选
很简单,这些岗位缺人且高薪
智联招聘的最新数据给出了最直观的印证:2025年2月,AI领域求职人数同比增幅突破200% ,远超其他行业平均水平;整个人工智能行业的求职增速达到33.4%,位居各行业榜首,其中人工智能工程师岗位的求职热度更是飙升69.6%。
AI产业的快速扩张,也让人才供需矛盾愈发突出。麦肯锡报告明确预测,到2030年中国AI专业人才需求将达600万人,人才缺口可能高达400万人,这一缺口不仅存在于核心技术领域,更蔓延至产业应用的各个环节。
那0基础普通人如何学习大模型 ?
深耕科技一线十二载,亲历技术浪潮变迁。我见证那些率先拥抱AI的同行,如何建立起效率与薪资的代际优势。如今,我将积累的大模型面试真题、独家资料、技术报告与实战路线系统整理,分享于此,为你扫清学习困惑,共赴AI时代新程。
我整理出这套 AI 大模型突围资料包【允许白嫖】:
- ✅从入门到精通的全套视频教程
- ✅AI大模型学习路线图(0基础到项目实战仅需90天)
- ✅大模型书籍与技术文档PDF
- ✅各大厂大模型面试题目详解
- ✅640套AI大模型报告合集
- ✅大模型入门实战训练
这份完整版的大模型 AI 学习和面试资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】

①从入门到精通的全套视频教程
包含提示词工程、RAG、Agent等技术点
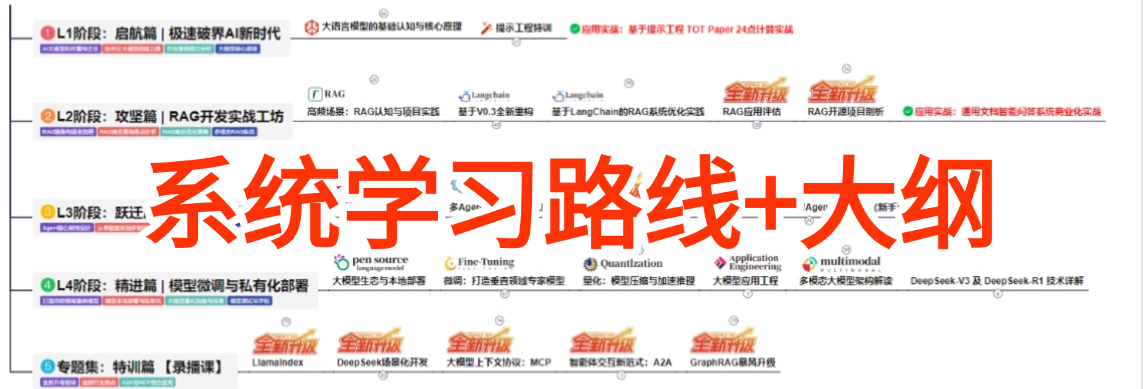
② AI大模型学习路线图(0基础到项目实战仅需90天)
全过程AI大模型学习路线
③学习电子书籍和技术文档
市面上的大模型书籍确实太多了,这些是我精选出来的
④各大厂大模型面试题目详解
⑤640套AI大模型报告合集
⑥大模型入门实战训练
如果说你是以下人群中的其中一类,都可以来智泊AI学习人工智能,找到高薪工作,一次小小的“投资”换来的是终身受益!
应届毕业生:无工作经验但想要系统学习AI大模型技术,期待通过实战项目掌握核心技术。
零基础转型:非技术背景但关注AI应用场景,计划通过低代码工具实现“AI+行业”跨界。
业务赋能 突破瓶颈:传统开发者(Java/前端等)学习Transformer架构与LangChain框架,向AI全栈工程师转型。
👉获取方式:
有需要的小伙伴,可以保存图片到wx扫描二v码免费领取【保证100%免费】🆓


DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献90条内容

所有评论(0)