用 Python 和 LLM 搭一个具身交互销售陪练:把话术练成肌肉记忆的工程实践
销售培训这件事,真正的难点从来不是「不知道话术」。产品卖点、异议处理、逼单话术,公司给的资料一大把,背都能背下来。难的是客户突然来一句「你们比隔壁贵 30%,凭什么」,你脑子里那套标准话术根本来不及调出来,嘴已经先动了,说了一句「我们质量好」,然后单子就凉了。
这个差距,行话叫「知道」和「做到」之间的距离。运动员练肌肉记忆靠重复对抗,销售练话术其实也需要一个能对抗的对手。真人陪练成本高、约时间难、还不好意思反复虐同一个人。所以这两年「AI 销售陪练」这个方向开始有人做。
我最近完整搭了一套端到端的东西,从语音输入到客户模拟再到复盘打分跑通了一遍。这篇文章不讲商业价值,只讲工程上怎么落地,以及哪些地方踩了坑、哪些地方我到现在也没完全解决。
先把问题拆清楚:陪练系统到底要解决什么
在动手写代码之前,我先把「一次有效的陪练」拆成几个必须满足的条件,不然很容易做成一个「和 ChatGPT 聊天」的玩具。
第一,客户必须是会施压的。一个只会说「好的好的」的客户,练不出任何东西。真实的客户会打断你、会质疑、会沉默、会突然问一个你没准备的问题。所以客户模拟 Agent 的核心不是「扮演客户」,而是「按策略制造阻力」。
第二,复盘必须具体到句子。如果训练完只给一句「你表现得不错,继续保持」,那和没有一样。有效的反馈要能指出「你在客户第二次提到价格时,用了防御性表达,而不是先共情再转移」。
第三,交互要接近真实通话。打字聊天和打电话是两种完全不同的压力。打字你能想三秒再回,打电话时沉默三秒客户就以为你卡壳了。所以语音链路不是锦上添花,是核心。
第四,要能重复练同一个场景。今天价格异议没处理好,明天还能再练一遍,直到形成条件反射。这就是「肌肉记忆」在工程上的含义——同一个刺激,稳定触发同一套应对。
把这四条对上,系统架构基本就出来了。
系统架构:三个 Agent + 一条语音链路
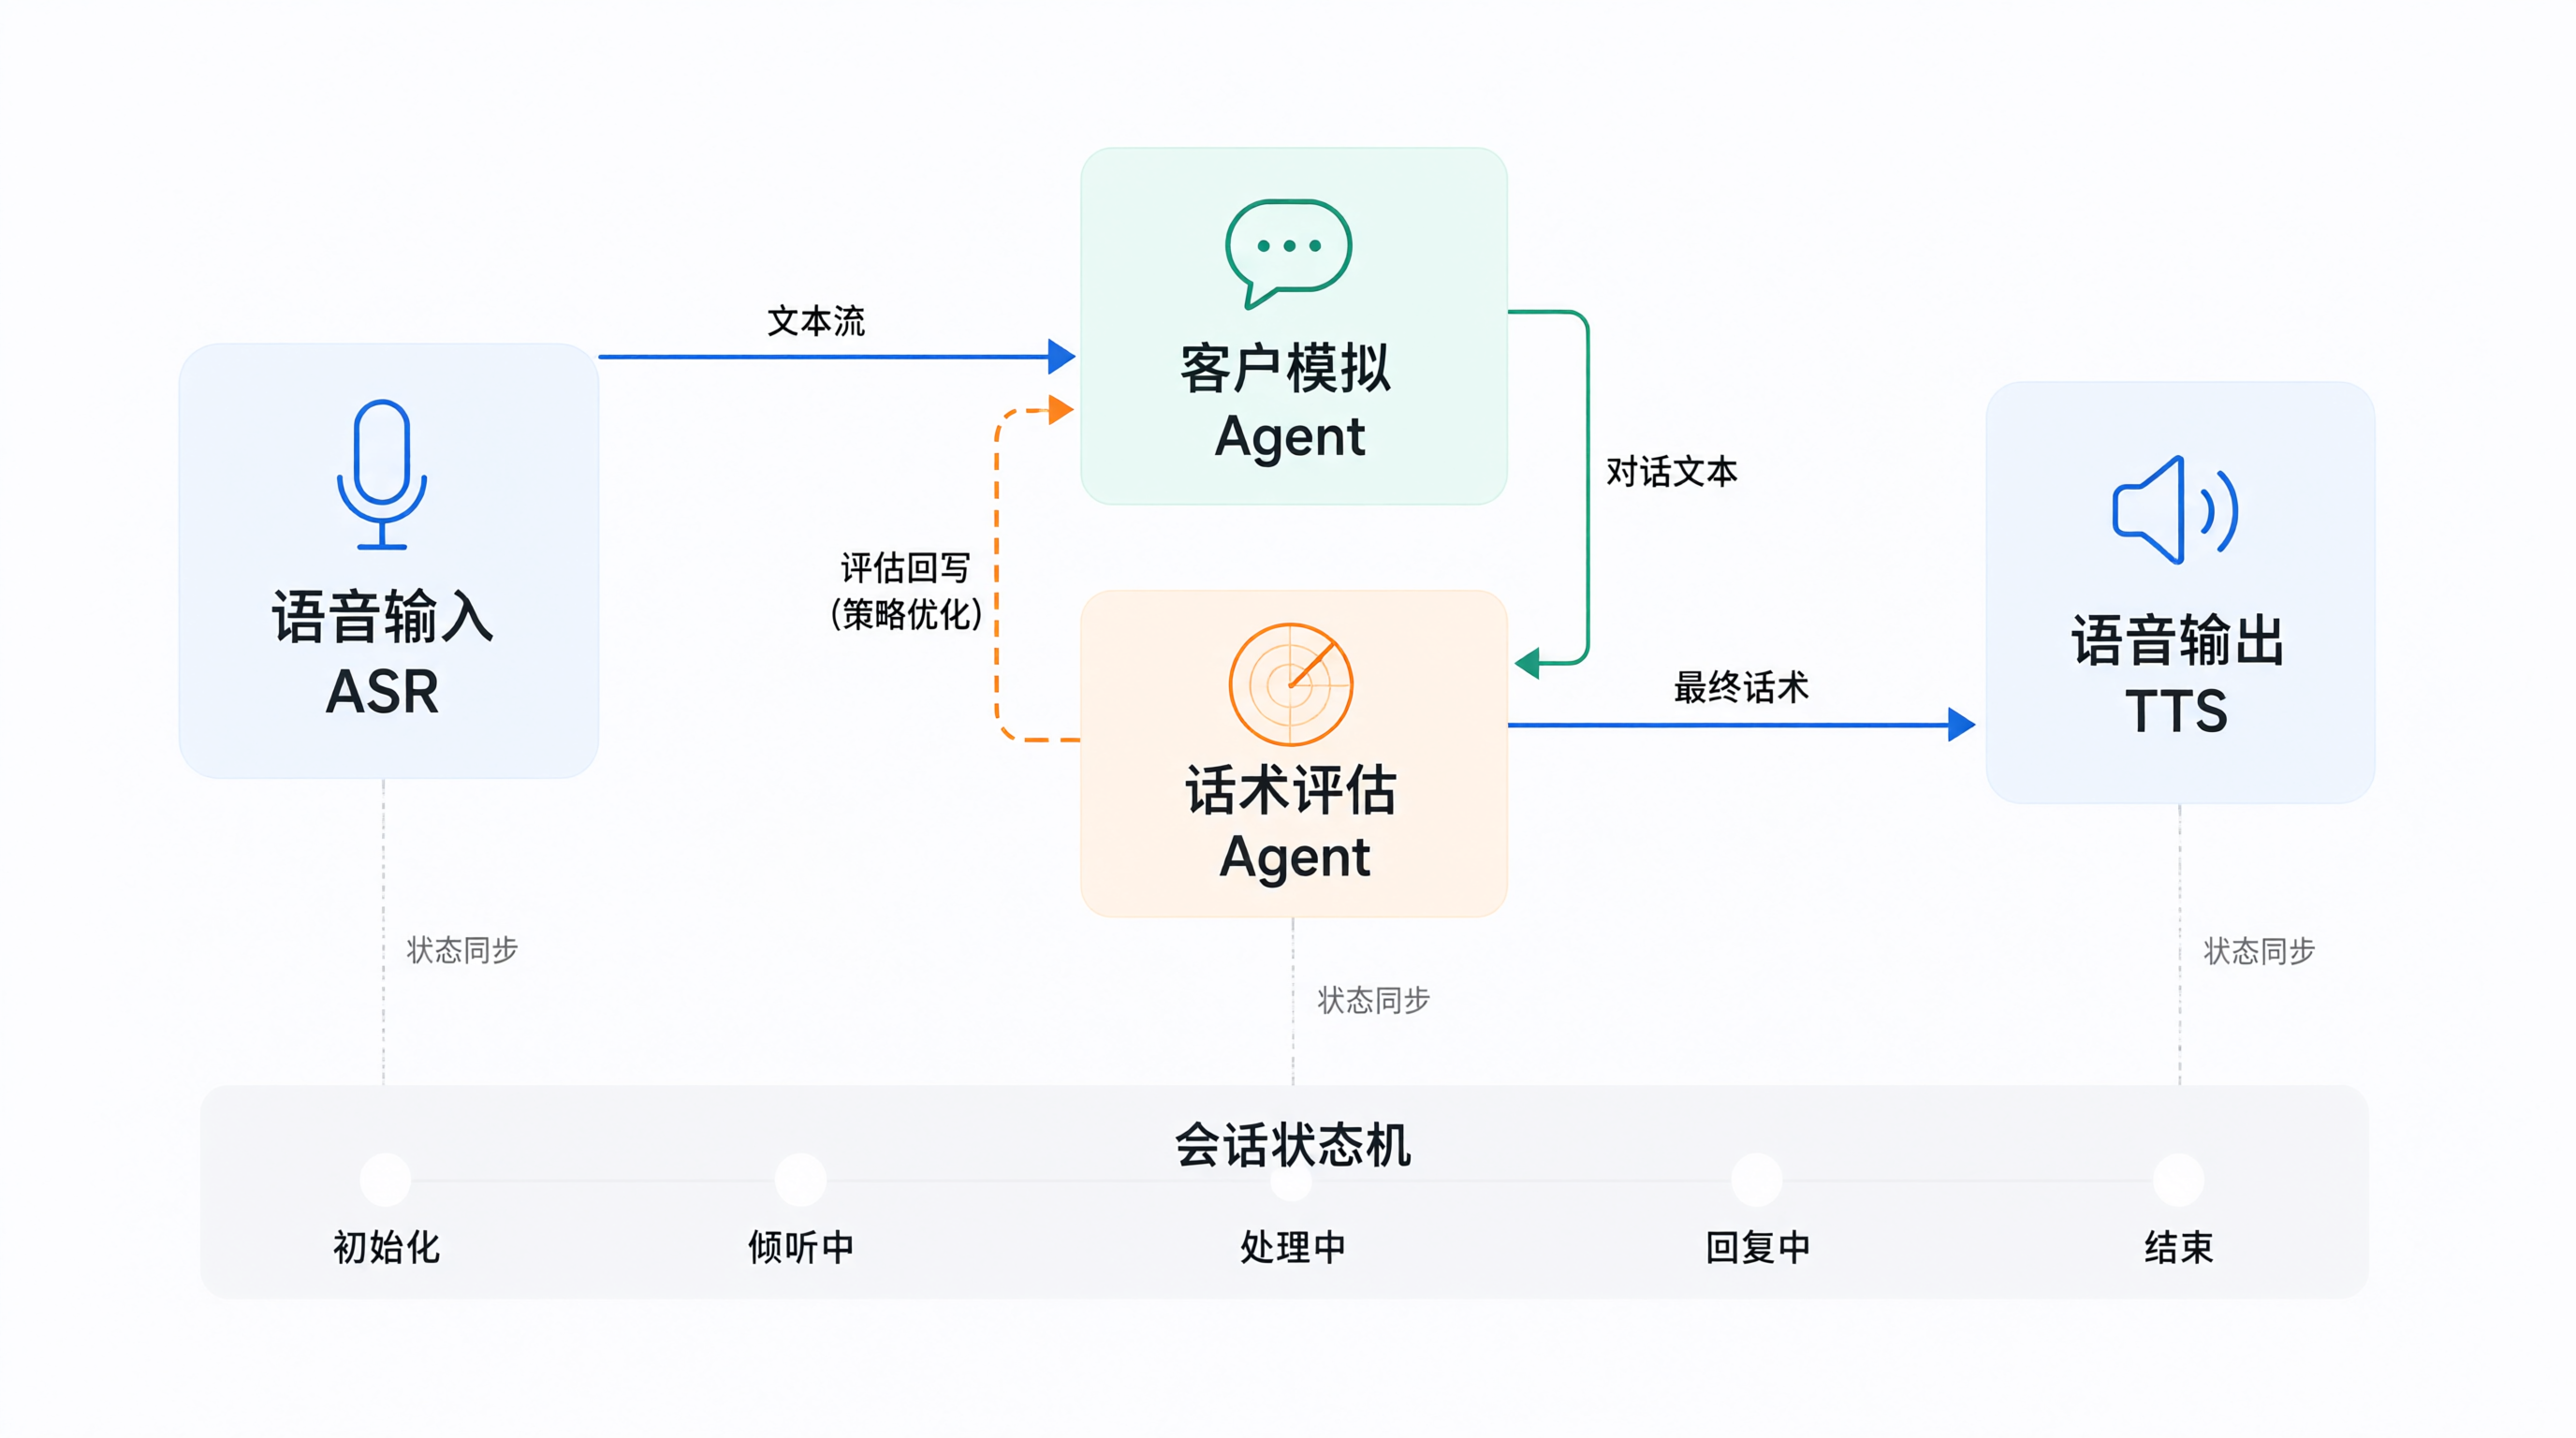
整体分成四块:
- 语音输入层:把销售的语音转成文本(ASR)
- 客户模拟 Agent:根据场景配置和对话历史,生成客户的下一句回应
- 话术评估 Agent:在对话结束后(或实时)对销售的每一轮发言打分
- 语音输出层:把客户的回应转成语音播出来(TTS)
中间用一个会话状态机串起来,管理「谁在说话」「当前处于哪个阶段」「场景是否结束」。
用一张图说明数据流:
销售说话 → ASR → 文本 → 客户模拟Agent → 回应文本 → TTS → 播放给销售
                              ↓
                        对话历史(共享)
                              ↓
                     话术评估Agent → 评分 + 建议
这里有个设计选择值得说:评估是实时做还是结束后做?
我一开始想实时做,每轮都打分,销售能立刻看到反馈。后来发现不行——实时打断会破坏沉浸感,销售一边说话一边看分数,根本没法专注。而且很多话术问题要看整体节奏,单轮看不出来。
所以最终方案是:实时只做轻量的「风险提示」(比如检测到明显的防御性词汇),完整的评估放到会话结束后批量跑。这个取舍后面还会细说。
客户模拟 Agent:怎么让 AI「不好对付」
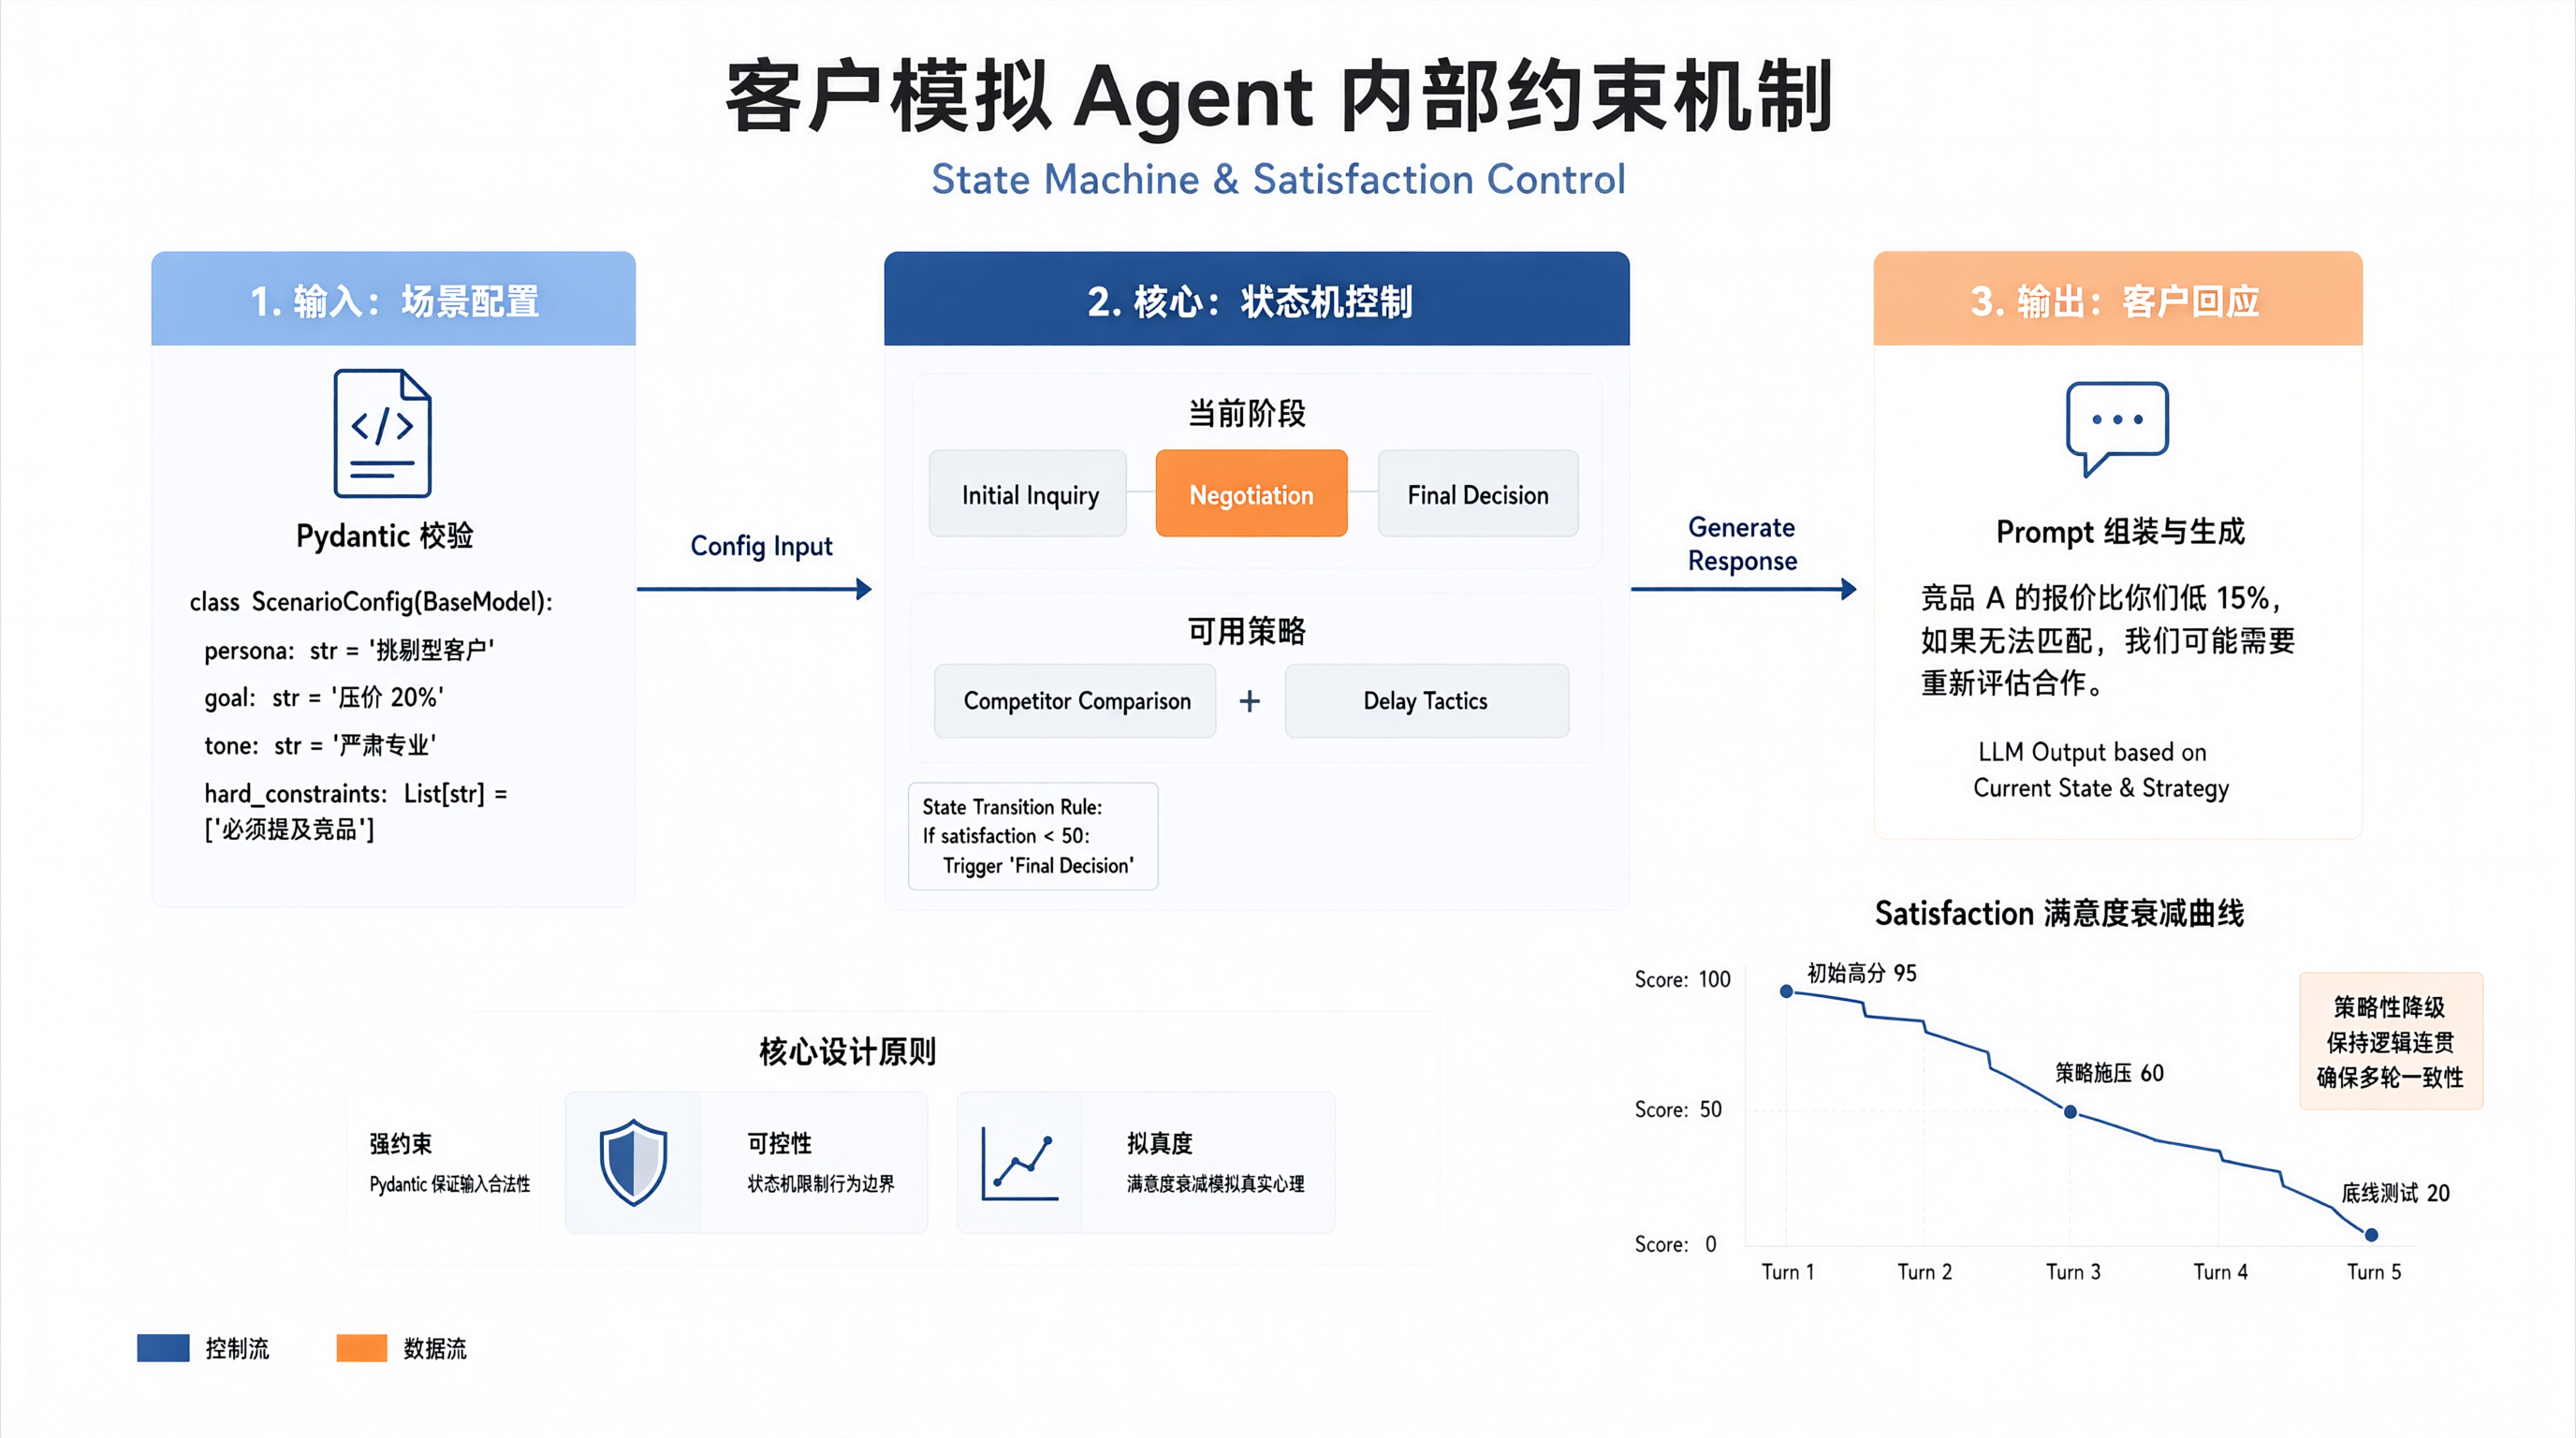
这是整个系统里最需要调的部分。直接给大模型一句「你现在扮演一个挑剔的客户」,它会演得很温和,因为大模型默认倾向于配合。
我的做法是用场景配置 + 状态机来约束它。
先定义场景配置,用一个结构化的东西描述客户的人设、当前阶段、可用策略。这里我用 Pydantic 做校验,避免配置写错导致 Agent 行为跑偏。版本上我用的是 pydantic>=2.0,openai>=1.30,Python 3.11。
from pydantic import BaseModel, Field
from typing import Literal

class CustomerProfile(BaseModel):
    name: str
    role: str                          # 例如「采购经理」
    personality: Literal["aggressive", "hesitant", "analytical", "friendly"]
    pain_points: list[str]             # 客户关心的点
    budget_sensitivity: int = Field(ge=1, le=5)  # 1-5,越高越在意价格
    objection_style: Literal["direct", "indirect", "silent"]

class ScenarioState(BaseModel):
    stage: Literal["opening", "discovery", "pitch", "objection", "closing"]
    turn_count: int = 0
    raised_objections: list[str] = []  # 已经提过的异议,避免重复
    satisfaction: int = 50             # 0-100,粗略衡量客户情绪
satisfaction 这个字段是我后来加的。起因是发现客户 Agent 会无脑一直挑刺,练到后面销售心态崩了。加了一个情绪值之后,如果销售应对得当,客户会慢慢软化,这样训练才有正反馈。
然后客户模拟的 prompt 核心逻辑是这样的:
CUSTOMER_SYSTEM_PROMPT = """你是一名销售场景中的客户,不是助手。
你的任务是真实地扮演客户,不要主动帮销售解决问题,不要轻易被说服。

当前客户画像:
- 姓名:{name}
- 身份:{role}
- 性格:{personality}
- 关注点:{pain_points}
- 价格敏感度:{budget_sensitivity}/5

当前对话阶段:{stage}
当前满意度:{satisfaction}/100

行为规则:
1. 根据性格决定语气。aggressive 会直接质疑,hesitant 会犹豫和拖延,
   analytical 会追问细节和数据,friendly 相对配合但仍会提异议。
2. 满意度低于 40 时,倾向于提出新的异议或准备结束对话。
3. 满意度高于 70 时,可以表现出兴趣,但仍不会主动成交。
4. 每次回复控制在 1-3 句话,模拟真实通话的节奏,不要长篇大论。
5. 不要重复已经提过的异议:{raised_objections}
6. 绝对不要跳出角色,不要给销售任何建议。
"""
【踩坑提醒】这里第 6 条「不要跳出角色」非常关键。我早期版本没写这句,结果客户 Agent 经常在销售说得不好时,突然来一句「其实你可以这样回应我……」,瞬间出戏。大模型的「助人倾向」比想象中强,必须在 prompt 里明确压制。
生成客户回应之后,还有个状态更新的步骤,用另一个轻量调用(或者同一轮的结构化输出)来判断满意度变化和阶段推进:
import json
from openai import OpenAI

client = OpenAI()

def update_state(state: ScenarioState, sales_utterance: str,
                 customer_reply: str) -> ScenarioState:
    prompt = f"""根据销售的这句话,判断客户满意度的变化(-20 到 +20)和当前阶段。
销售说:{sales_utterance}
客户回:{customer_reply}
当前满意度:{state.satisfaction}
当前阶段:{state.stage}

只返回 JSON,格式:
{{"satisfaction_delta": <int>, "new_stage": "<stage>", "new_objection": "<没有则填 null>"}}
"""
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": prompt}],
        response_format={"type": "json_object"},
        temperature=0,
    )
    data = json.loads(resp.choices[0].message.content)
    state.satisfaction = max(0, min(100, state.satisfaction + data["satisfaction_delta"]))
    state.stage = data["new_stage"]
    if data.get("new_objection"):
        state.raised_objections.append(data["new_objection"])
    state.turn_count += 1
    return state
用 temperature=0 是因为这里要的是稳定判断,不需要创造性。response_format={"type": "json_object"} 是 OpenAI 的结构化输出能力,能显著降低解析失败率——这个参数在较新的 SDK 里支持,如果你的版本比较老可能没有,需要自己用正则兜底。这一点我没有在非常老的版本上验证过,用之前建议先确认 SDK 版本。
话术评估 Agent:怎么打分才有意义
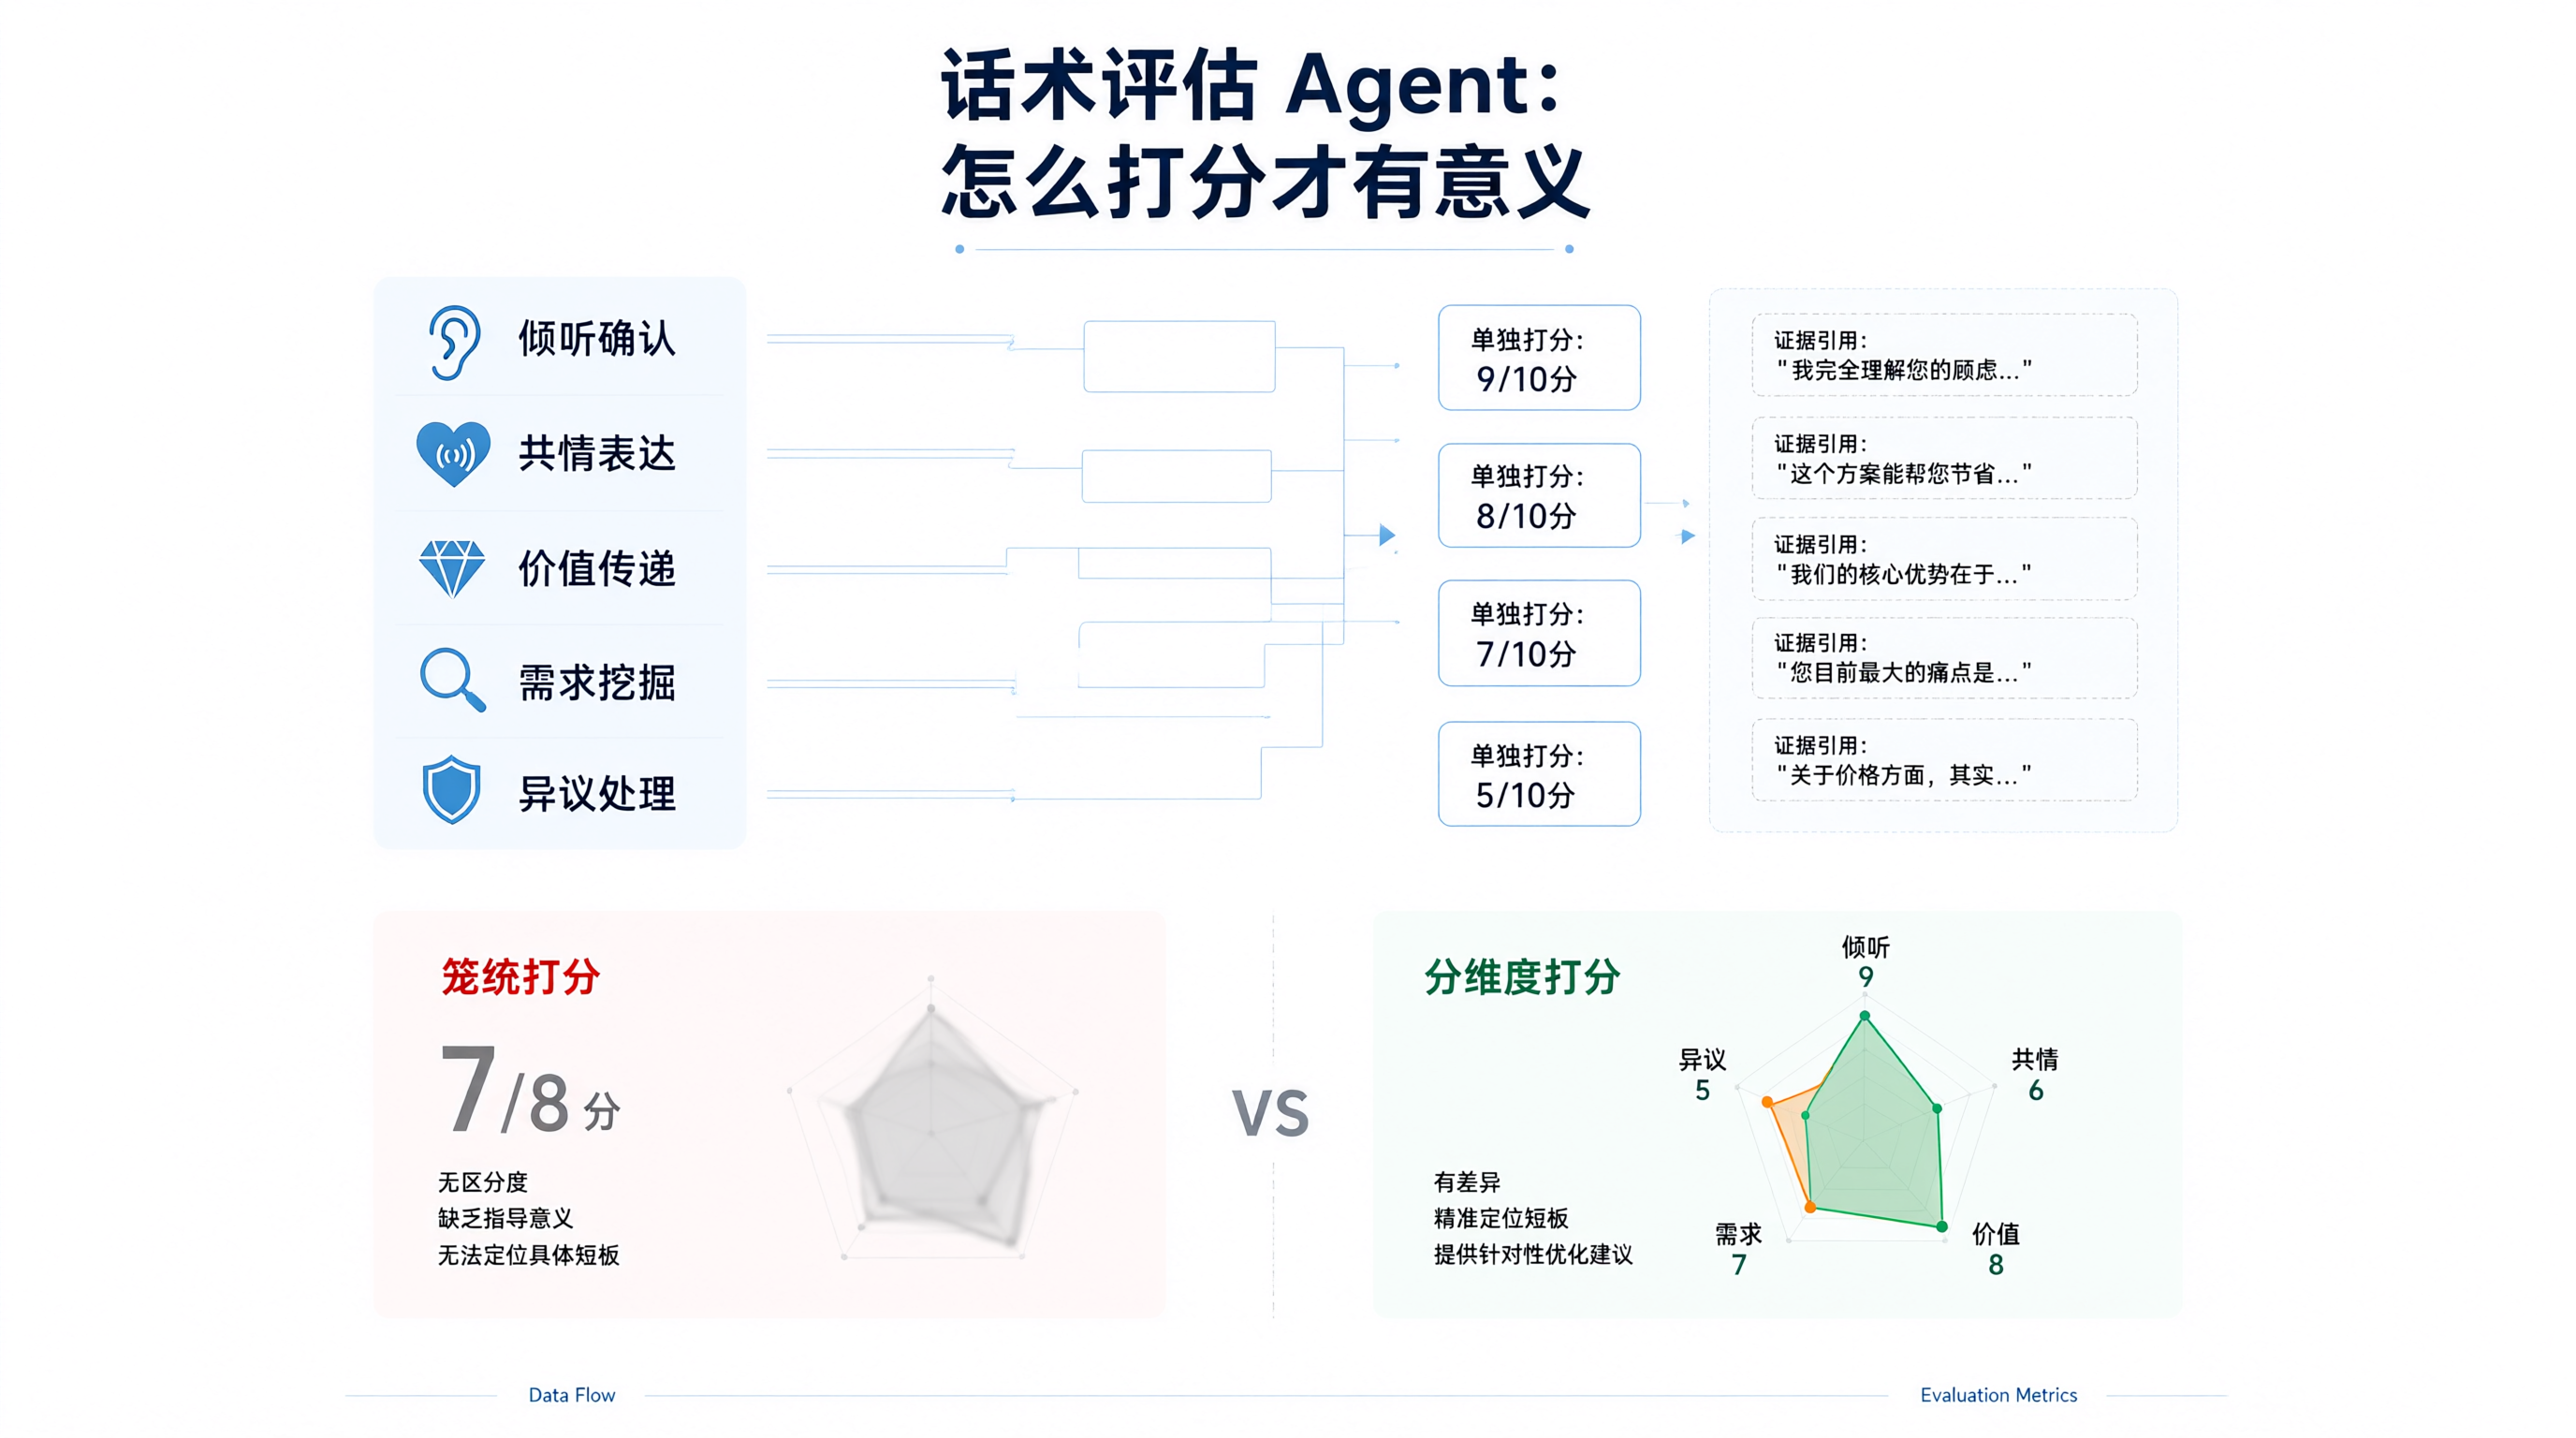
评估是整个系统里最容易被做废的部分。如果只是让大模型「给这段话打个分」,它会给你一堆 7 分 8 分,毫无区分度。
我的做法是先定义维度,再让模型对每个维度单独打分并给出证据。维度是我根据常见销售方法论拆的,不追求学术严谨,只求可操作:
| 维度 | 说明 | 评分关注点 |
|---|---|---|
| 倾听与确认 | 是否先确认客户意思再回应 | 有没有复述/确认客户观点 |
| 共情表达 | 是否先处理情绪再处理问题 | 有没有认可客户感受 |
| 价值传递 | 是否把卖点转成客户收益 | 有没有用「对你来说意味着」这类转化 |
| 异议处理 | 是否正面接住异议 | 有没有回避、防御、硬刚 |
| 推进意识 | 是否在合适时机推进 | 有没有自然的下一步动作 |
| 语言简洁度 | 是否啰嗦 | 单轮字数、有没有绕圈子 |
评估的 prompt 里,我要求模型必须引用原句作为证据,否则分数无效:
EVAL_SYSTEM_PROMPT = """你是一名资深销售教练,负责复盘一段销售对话。
对销售(不是客户)的每一轮发言,按以下维度打分(1-5 分):

- listening:倾听与确认
- empathy:共情表达
- value:价值传递
- objection:异议处理
- advancing:推进意识
- conciseness:语言简洁度

要求:
1. 每个分数必须附带一句原文引用作为证据(evidence 字段)。
2. 如果某轮发言没有体现该维度,如实打低分,不要脑补。
3. 最后给出 2-3 条最值得改进的具体建议,每条建议要指向具体轮次。
4. 不要给笼统的鼓励性评价。

只返回 JSON。"""

def evaluate_conversation(history: list[dict]) -> dict:
    formatted = "\n".join(
        f"[{h['role']}] {h['content']}" for h in history
    )
    resp = client.chat.completions.create(
        model="gpt-4o",
        messages=[
            {"role": "system", "content": EVAL_SYSTEM_PROMPT},
            {"role": "user", "content": formatted},
        ],
        response_format={"type": "json_object"},
        temperature=0.2,
    )
    return json.loads(resp.choices[0].message.content)
这里评估用的是更强的模型(gpt-4o),模拟客户用的是更便宜的(gpt-4o-mini)。原因是评估需要更强的判断力,而客户模拟主要是遵循规则,便宜模型够用。这个搭配是成本和质量之间的实践取舍,具体用哪个模型你可以按自己的预算调整。
【关键结论】评估维度一旦定义好,就可以做成雷达图给销售看,比一串分数直观得多。而且同一维度多轮训练的趋势对比,才是「肌肉记忆是否形成」的量化指标——如果「异议处理」这一项连续几次训练都在 4 分以上,说明这个反应基本固化了。
语音链路:延迟才是真正的敌人
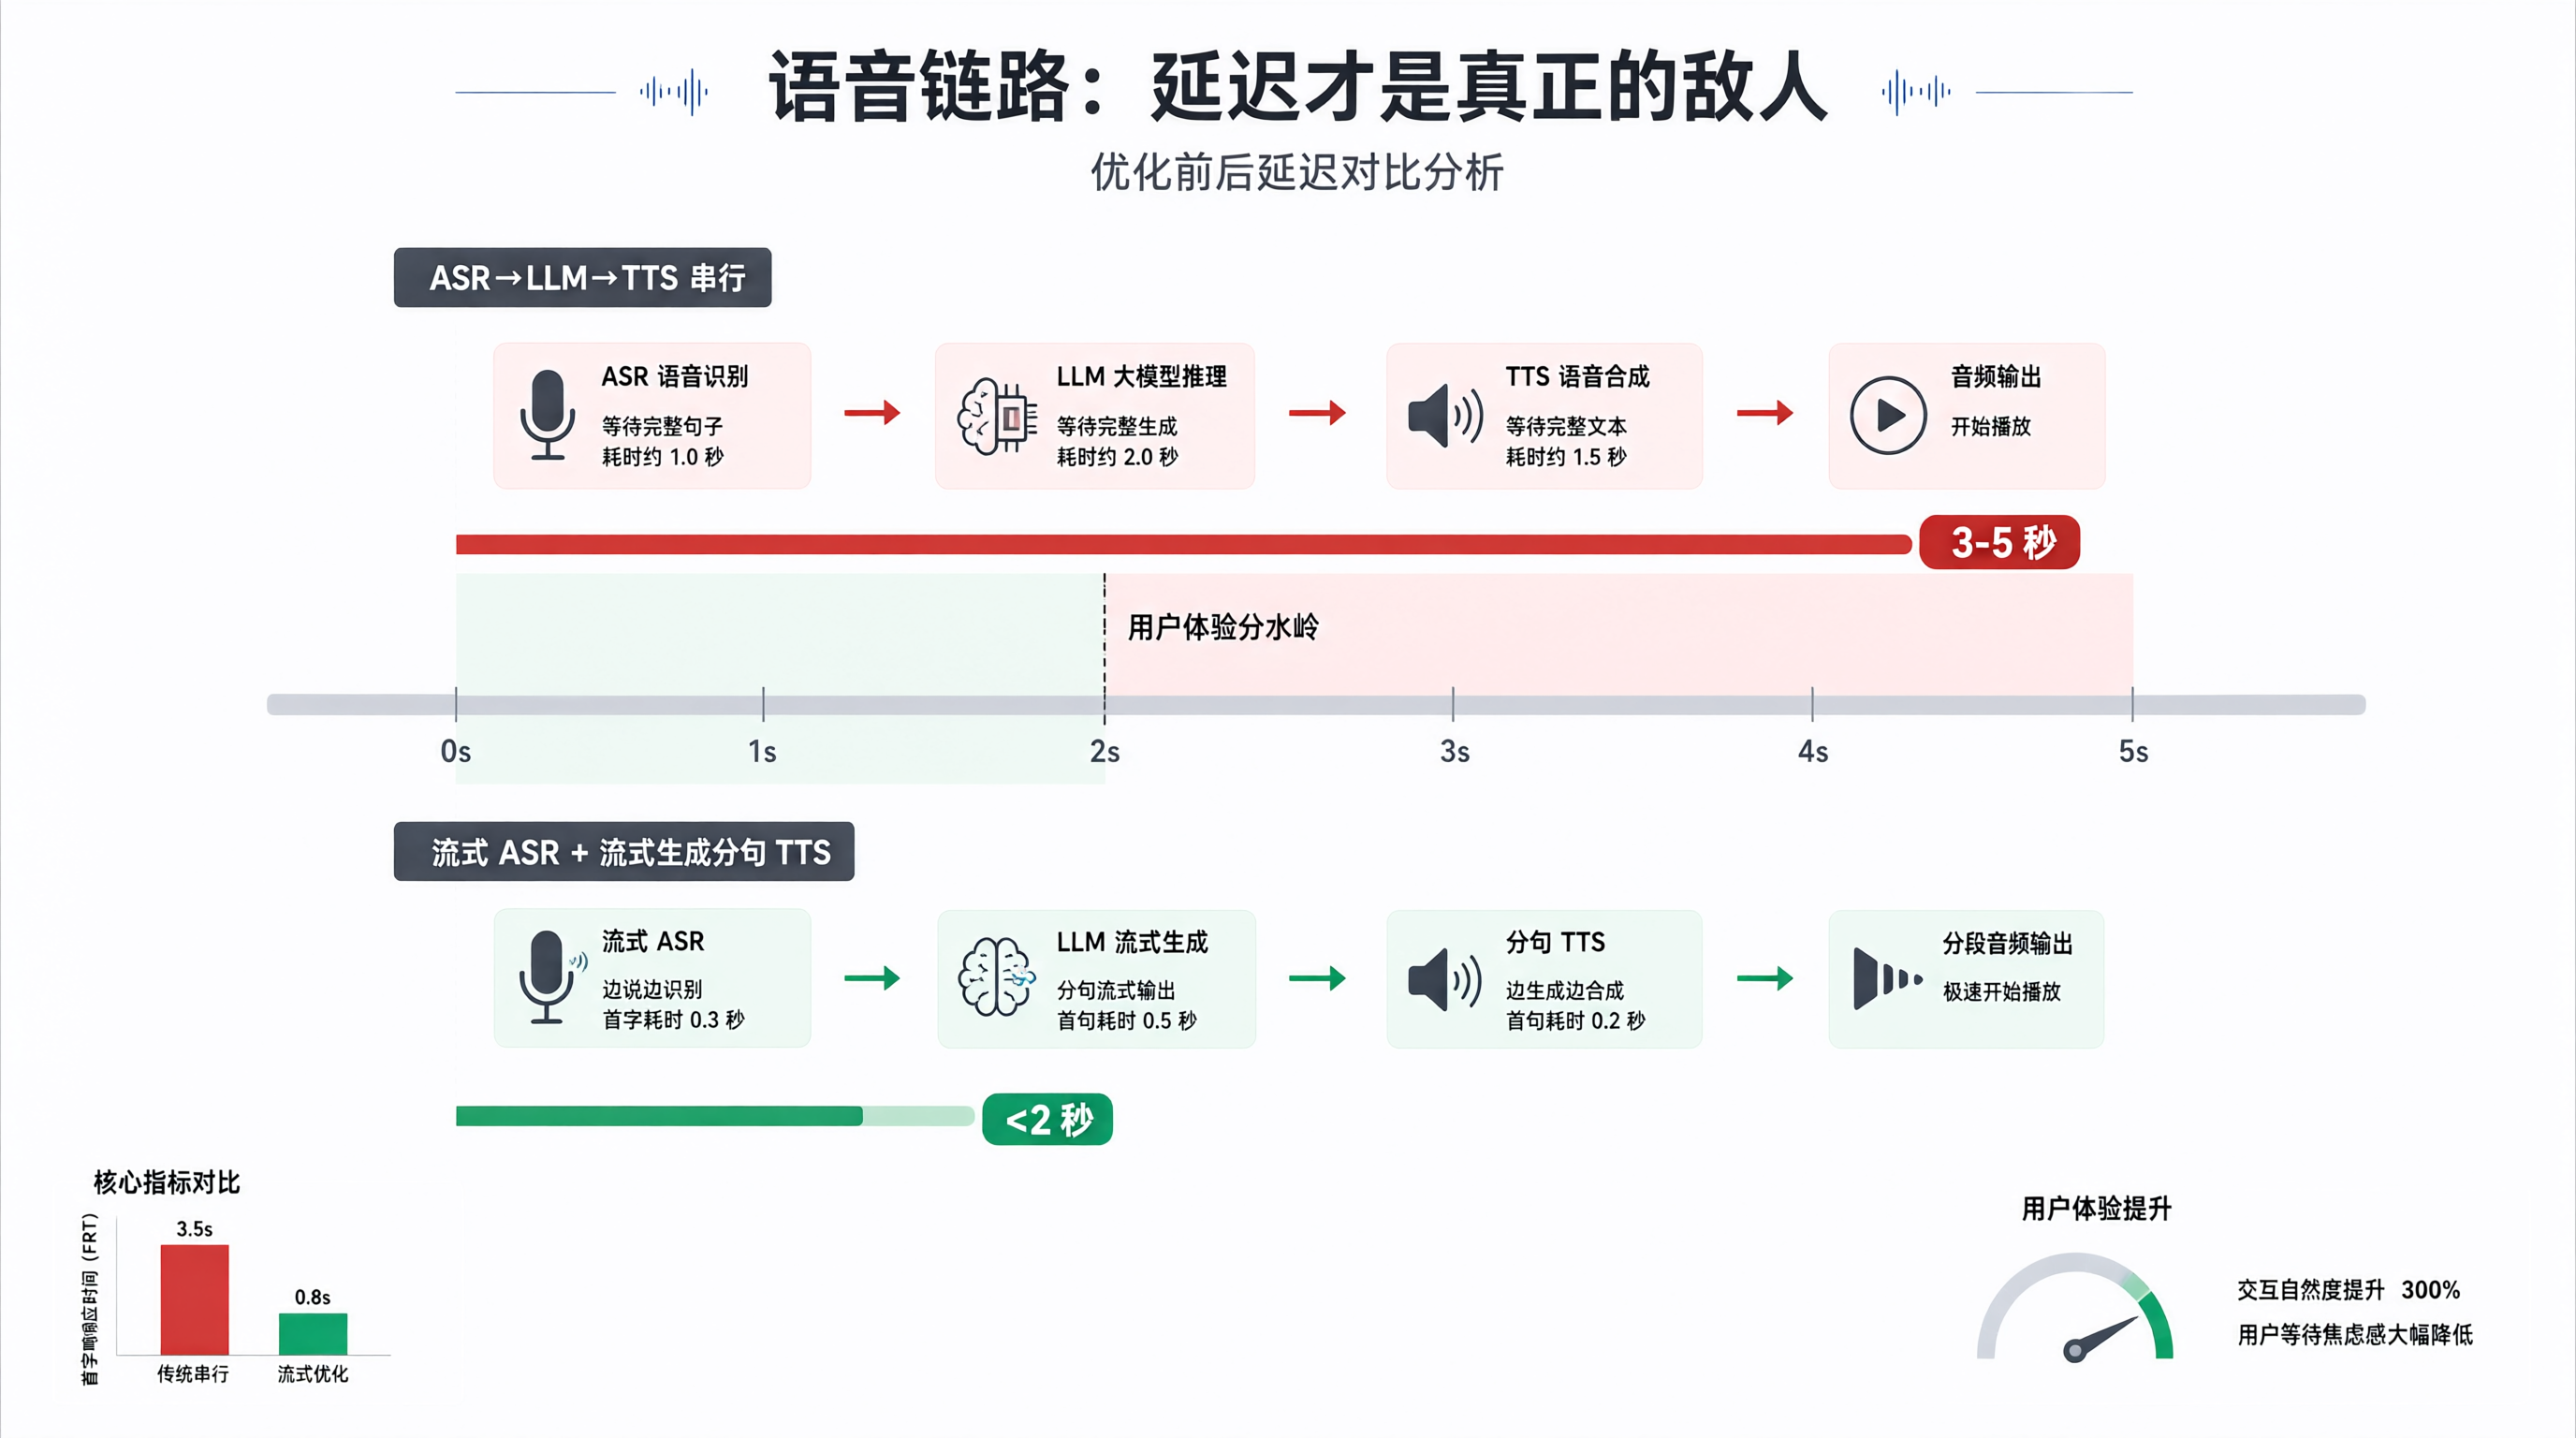
前面都是文本层面的,接上语音之后问题才真正暴露。
语音链路是 ASR → LLM → TTS 三段串行。每一段都有延迟,加起来如果超过 2 秒,对话就明显卡顿,沉浸感全没了。
我实测(在普通云服务上,非专门优化环境)三段加起来经常在 3-5 秒,体验很差。后来做了几个优化:
第一,把 ASR 做成流式。 不要等销售说完一整段才转文字,边说边转,说完立刻拿到结果。市面上主流的流式 ASR 服务都支持,具体选哪家看你自己的环境和预算。
第二,客户 Agent 的回复做流式生成 + 分句 TTS。 不要等整段生成完再合成语音,生成一句就合成一句、播一句。这样首句响应能压到 1 秒左右。
第三,也是最有效的:预生成常见回应。 像「嗯」「我理解」「然后呢」这种客户高频的短回应,可以提前生成好语音缓存,需要时直接播,零延迟。这个技巧在真实产品里很常见,能显著改善体感。
import asyncio

async def stream_customer_reply(history, state):
    """流式生成客户回复,按句切分后送入 TTS。"""
    buffer = ""
    async for chunk in llm_stream(history, state):
        buffer += chunk
        # 遇到句末标点就切一句出去合成
        if any(buffer.rstrip().endswith(p) for p in "。!?.!?"):
            sentence = buffer.strip()
            buffer = ""
            if sentence:
                asyncio.create_task(tts_and_play(sentence))
    if buffer.strip():
        await tts_and_play(buffer.strip())
【注意】分句 TTS 有个副作用:如果模型生成的句子很短,会频繁触发 TTS 请求,反而增加开销。实际用的时候我加了一个最小长度阈值,太短的句子先攒着和下一句合并。这个阈值设多少要看你用的 TTS 服务的计费和延迟特性。
会话状态机:别让对话跑飞
文本 + 语音都通了之后,还有一个容易被忽视的问题:对话会跑飞。
比如销售一直不推进,客户 Agent 就一直陪着聊,聊到 20 轮还没结束。或者销售说了一句很奇怪的话,客户 Agent 不知道怎么办,开始胡言乱语。
解决方式是加一个会话状态机,在每一轮之后检查是否满足结束条件:
MAX_TURNS = 15

def should_end(state: ScenarioState) -> tuple[bool, str]:
    if state.turn_count >= MAX_TURNS:
        return True, "达到最大轮次"
    if state.satisfaction <= 10:
        return True, "客户情绪过低,对话终止"
    if state.stage == "closing" and state.satisfaction >= 75:
        return True, "客户表现出成交意向"
    return False, ""
一旦判定结束,就把完整对话丢给评估 Agent 跑复盘。这样每次训练都是「完整的一局」,有明确的开始和结束,符合肌肉记忆训练的「重复同一场景」原则。
落地时真正麻烦的几个问题
说到这里,代码骨架基本齐了。但真正上线前,还有几个问题绕不过去。
话术泄露。 客户 Agent 和评估 Agent 用的是同一套场景配置,如果配置写得不好,客户 Agent 可能会「知道」标准答案,然后有意无意引导销售。我的做法是客户 Agent 只拿到「客户视角」的信息,不拿到「标准话术」;评估 Agent 才拿完整信息。这个隔离必须在数据层面做,不能只靠 prompt 隔离。
评估的稳定性。 同一个对话跑两次,评估分数可能会不一样。我测下来同一段对话(temperature=0.2)跑多次,各维度分数波动大概在 ±0.5 分左右。对趋势判断够用,但如果你要做绝对精确的评分,这个稳定性是不够的。这一点目前没有特别好的解法,只能靠多轮平均或者更结构化的评估方式。
隐私和录音。 训练过程会录到销售的真实语音,这里面涉及员工数据处理的问题。技术上能做的是本地 ASR、录音加密存储、定期清理。这一块我不是合规专家,只提醒一句:做产品之前先想清楚数据怎么存、存多久,不要等出了问题再补。
这套东西到底有没有用
回到开头那个问题:练话术能不能练成肌肉记忆?
我的判断是——能,但前提是评估维度要稳定,场景要能重复,交互要接近真实。三者缺一个,效果都会打折。只有文本聊天没有语音,压力不够;只有语音没有评估,练完不知道自己错在哪;只有评估没有重复场景,练十次十个样,形不成条件反射。
工程上最难的不是接大模型,而是把「一次有效训练」的边界定义清楚:什么算开始、什么算结束、怎么算进步。这些定义清楚了,大模型只是执行工具。
有一个问题我到现在还在想:评估维度是我拍的,未必适合所有销售团队。如果要做成通用产品,评估维度可能需要可配置,甚至让团队自己定义。但维度一多,评估 Agent 的判断质量就会下降。这个「灵活性」和「稳定性」的平衡,我还没有找到特别好的答案。如果你在做类似的东西,欢迎交流。
=备用标题=
- Python 实战:用 LLM 搭一套能施压的销售陪练系统
- 销售话术练不成肌肉记忆?我搭了一个具身交互陪练 Agent
- 从客户模拟到话术评分:一套端到端销售陪练系统的工程拆解
- 别再用 ChatGPT 陪练销售了:多 Agent 状态机才是正解
- 语音 + 多 Agent:把销售培训做成可重复对抗训练的实践

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 12
 0
- 0


 已为社区贡献3条内容

所有评论(0)