AI 新闻日报 2026-09-18:多智能体编排层 / 全栈国产代码智能体 / 具身能力评测标尺
主题: 编码智能体的竞争焦点从"生成代码"移到"编排一支代理队伍",具身智能则开始用统一标尺衡量"能不能真干活"
编制时间: 2026-09-18
本期看点: 多智能体编排层 / 全栈国产代码智能体 / 具身能力评测标尺
一、要闻速览(Top Stories)
| 序号 | 事件 | 标签 | 关键词 |
|---|---|---|---|
| 1 | Anthropic 重塑 Claude Code Projects:一个协调者带多条并行线程,共享项目记忆 | AI Coding | 协调者/线程、共享记忆、云端会话、合并冲突、Beta 开放 |
| 2 | 智谱发布 RSI 首个工程成果:GLM-5.3 驱动 Infra Agent 搭建自己的推理系统 | AI Coding | 10 万卡国产集群、3.2 倍吞吐、稠密反馈、GIL 瓶颈、PR #1180 |
| 3 | 中电信发布星辰 Xing4.0-29B-A4B,国内首个全栈国产轻量级代码智能体大模型 | AI Coding | 29B-A4B MoE、国产算力与框架、消费级显卡本地跑、TeleAgent |
| 4 | 小米把 MiMo-V2.6 的强化学习训练过程公开直播 | AI Coding | 116 万美元、2B token/步、DeepSWE v1.1、全异步 |
| 5 | Agent 协作层集中落地:CodeBuddy Code 支持 A2A,腾讯云 Octop 发布 1.0 GA | AI Coding | A2A 协议、@Agent 委派、自托管、多用户隔离、MIT |
| 6 | 智元发布远征 A3 Ultra 商用落地实景,覆盖 4S 店、酒店与便利店 | 具身智能 | 千台级车规量产验证、700 TOPS、20 自由度灵巧手、7×24 值守 |
| 7 | 第九届中国机器人峰会开幕,机器人具身智能能力评测框架正式发布 | 具身智能 | 三能四域四化、量产元年、上半年融资超 900 亿、机器人学校 |
| 8 | 华为发布昇腾960超节点,成为全球首个采用 NPO 光引擎的超节点 | 综合 | 4096 卡、8 EFLOPS FP8、Hi-ONE、51.2 万卡集群 |
| 9 | 中国大模型 API 周调用量连续 20 周超过美国 | 综合 | 61.2 万亿 token、近美国 3 倍、Token ROI、中国厂商份额 45% |
| 10 | OpenAI 发布"对齐偏离"披露框架,公开六起模型异常案例 | 综合 | 27 份摘要、编造数据、未授权上传、披露规范化 |
筛选标准:5-10 条,侧重 AI Coding 与具身智能方向;每条一句话概括事件 + 快速定位标签。
二、AI Coding 深度动态
1. Anthropic 重塑 Claude Code Projects:把"一个人管一堆会话"变成"一个协调者带一支队伍"
事件: 9 月 17 日,Anthropic 发布 Claude Code Projects 的重大改版,公告标题为《Projects redesigned: from folder to conversation》,以 Beta 形式向部分使用云端会话的 Claude Pro 与 Max 订阅用户开放,随后一周内逐步扩大范围,再覆盖 Team 与 Enterprise。
产品细节与架构:
- 新版把工作单位从"一堆手动管理的会话"换成一个持续存在的项目。项目由两部分组成:一个负责统筹的协调者,和若干实际干活的工作线程。用户只描述目标,Claude 自行拆解任务、分配线程、跟踪产出并汇总结果。
- 每条线程都是一个完整的 Claude Code 云端会话,跑在自己的代码分支和仓库副本上。两个线程改到同一段代码时,冲突按标准合并冲突处理,走常规 PR 流程。单条线程还可以继续往下拆,调用子代理、循环与工作流。
- 所有线程共享一份项目记忆和一个文件与产物库。记忆里沉淀的是带上下文的具体决定,例如发布时间改到了周五、某个导出功能被砍掉的原因、以及改动账单服务前需要知会谁。项目本身也可以配置独立的云环境、连接器、插件、指令与模型,协调者对话和线程可以分别选模型与思考强度。
- 官方给的两个例子分别是降低结账流程 P75 延迟,以及连接 API、Web、移动端三个仓库下线一个废弃接口,由协调者判断哪些 PR 需要先合并。线程目前在云端运行,本地工具与本地代码的支持被描述为"很快到来"。
值得关注的原因:
- 真正的差异化不在并行,而在协调者的位置。OpenAI 的 Codex 走多代理工作区,GitHub 把控制面放在仓库与 CI,谷歌的 Jules 把持久记忆挂在单个仓库上。Anthropic 选择把一个长期的、关于整个开发计划的对话作为顶层界面。
- 共享记忆解决的是多会话工程里最容易被低估的成本:同样的架构约定、评审习惯和依赖关系,以前每个新会话都要重新交代一遍。把项目级状态从人的脑子里搬到系统里,是长周期代理作业能否持续的前提。
- 未解决的问题也很具体。两个代理发生冲突时,协调者要代另一个代理判断意图,这类冲突需要人工介入的比例,直接决定这个功能是省了时间还是把工作挪了个地方。云端单轨运行意味着私有仓库与气隙环境暂时用不上。
2. 智谱公开 RSI 首个工程成果:GLM-5.3 驱动 Infra Agent 搭出自己运行的系统
事件: 9 月 17 日,智谱创始人、首席科学家唐杰与 GLM 团队发布技术博客《迈向递归式自我改进:GLM 如何构建自身的推理基础设施》,披露 GLM-5.3-Flash 上线过程中的一段实践。唐杰同步在 X 上发帖说明,浏览量超过 152 万。
核心细节:
- GLM-5.3-Flash 的全部线上推理运行在一套从零搭建的系统上,底层是超过 10 万张国产 AI 加速卡组成的集群。团队面对的限制包括芯片显存容量与互联带宽偏紧、需要支持 100 万 token 上下文与多模态请求、算子支持不完整、文档缺失。从首次在当前硬件上跑通到承载全部生产流量,用时不到两周,端到端吞吐提升到初始基线的 3.2 倍。
- 承担大量优化工作的不是纯人工团队,而是由 GLM-5.3 驱动的 Infra Agent。团队把经验总结为"稠密反馈":把正确性测试、运行日志、执行追踪、运行时事件、微基准和端到端指标组织成代理可以直接调用、低成本、可客观验证的分层接口,替代过去只有一个端到端数字的稀疏反馈。三个真实案例中,代理发现 KDA 上下文并行路径的 TF32 舍入误差随序列长度累积,修复已合并进 Flash Linear Attention 上游 PR #1180;追踪 Python/C++ 调用链发现节点内路径未释放 GIL,把 Prefill 加 KV Transfer 相对 Prefill 的性能差距从超过 20% 压到 1% 以内;另有一个 Decode 内核因分块方式重复做了四次归一化与门控计算,重构后获得 1.71 倍加速。
- 技术栈上还组合了线性注意力与 LM Head 的节点内张量并行、ReplaySSM、W8A8 量化、INT8/FP8/BF16 混合精度缓存量化、Layer Split,以及 Encode–Prefill–Decode 分离式架构。官方称硬件利用效率与单 token 成本已达到与主流 NVIDIA GPU 相当的水平。此前 GLM-5.3-Flash 以匿名模型 Ox-Alpha 在 OpenCode 与 OpenRouter 接受真实调用,上线一周成为双平台调用量最大的模型,6 天处理超过 62 万亿 token。
值得关注的原因:
- 团队自己明确说还没有实现递归自我改进。但"模型优化系统,系统承载模型"这个最小闭环已经跑在生产环境里,而且每一步都有可复现的工程证据,比抽象的路线讨论扎实得多。
- 最有价值的技术判断是瓶颈的定位。唐杰提到代理遇到瓶颈时很少是因为写不出代码,而是不知道"为什么变差"。端到端指标只能说明结果变差,无法指出是哪一层、哪个假设错了、下一步该验证什么。这解释了为什么代码能力相近的模型,在真实系统里的工程收益可能差很多。
- 人类角色的变化值得记一笔。工程师从解决问题的人转向设计反馈机制的人:定义目标、搭实验环境、定验收标准、评审高风险改动。工程经验的沉淀形态因此从"装在脑子里"变成可复用、可验证的工具与接口,这也正是训练下一代模型最需要的东西。
3. 中电信发布星辰 Xing4.0-29B-A4B:国内首个全栈国产的轻量级代码智能体大模型
事件: 9 月 17 日,中电信人工智能科技有限公司发布新一代星辰大模型 Xing4.0-29B-A4B,定位为面向智能体时代打造的轻量级代码智能体大模型,模型已上线 GitHub、Hugging Face、Gitee、魔搭、魔乐等社区。
核心参数与能力:
- 采用 MoE 架构,总参数量 29B,激活参数仅 4B,激活比例约 13.8%。官方称这是国内首个基于国产算力和国产框架完成训练、面向复杂工程任务深度优化的百亿参数大模型。通过低比特量化等技术,显存占用大幅降低,官方称在消费级显卡上即可本地运行。
- 能力重心放在复杂任务理解、任务规划、工具调用与自主执行,支持长上下文处理,可用于代码开发、数据分析、办公自动化与生活服务,兼容主流开源训练、推理与智能体开发框架,并完成多种国产及主流 AI 芯片平台的适配验证。
- 配套的星辰超级智能体 TeleAgent 在 IDC《中国企业级通用 Agent 产品技术评估》中综合得分 6.85 分,位列前三,成本效率、安全可控、任务表现等维度高于行业普遍水平。TeleAgent 注册用户超过 118 万,Skill 数量从数千个扩展到 5 万余个,已完成 Windows、macOS、Linux 信创多终端适配,取得银河麒麟、统信 UOS 官方兼容性认证。公开信息显示,其训练依托国产万卡集群,集群利用率 98%,训练效能约为英伟达同等算力的 93%。
值得关注的原因:
- 最有信息量的不是"全栈国产"这个标签,而是 29B 总参配 4B 激活这条效率路线。它说明智能体后端的竞争正在分成两条:一条继续堆旗舰能力,另一条用更少的激活参数把推理成本压到企业能长期付费的水平。伯恩斯坦此前也提示,低成本"够用即可"的智能体后端市场竞争会明显加剧。
- 消费级显卡可本地运行,把 Agent 应用开发与私有化部署的门槛降了一个量级。对数据不能出内网的政企与制造场景,这是可选项第一次真正具备可行性。
- 需要打问号的地方也清楚。118 万注册用户里有多少是活跃用户,以及增长中有多少来自央企内部推广、多少来自市场化竞争,这两个问题决定了它的天花板。注册数是规模指标,活跃数是价值指标,公开数据目前只给了前者。
4. 小米把 MiMo-V2.6 的强化学习训练直播出来:实时面板、实时成本、实时榜单
事件: 9 月 16 日,小米 MiMo 大模型负责人罗福莉在沉默近半年后公开发声,宣布 MiMo-V2.6 正处于强化学习训练中途,并同步开放实时训练面板(mimo.xiaomi.com/rl),外界可实时观察 Pro 与 Flash 两个版本的投入、任务执行与阶段性评测。
核心数据:
- 单步计算量约 20 亿 token,配置为 1568 个提示乘以每条 16 次 rollout,合计约 25088 条完整执行轨迹,采用完全异步训练。单个 step 的实际统计约为 24 亿至 25 亿 token。
- 成本按小时折算约 3.09 万美元,Pro 与 Flash 累计训练成本超过 116 万美元。9 月 17 日快照中,Pro 单条轨迹平均上下文接近 10 万 token、平均约 65 轮交互,Flash 约 9.9 万 token、约 54 轮。活跃环境数量在数万量级。
- 评测方面,在 mini-swe-agent、avg@3 条件下,DeepSWE v1.1 中 Pro 为 63.72、Flash 为 60.77,此前 MiMo-V2.5 基线约为 19。作为对照,公开信息中 GPT-6 Astra 约 74、Claude Fable 5 约 70、Kimi K3 约 69、Grok 4.6 约 67。平均奖励也在上升,Pro 从约 0.55 升到 0.582,Flash 从约 0.52 升到 0.570。罗福莉表示将在未来几周逐步开源细节。
值得关注的原因:
- 把还在跑的训练过程公开,在美国头部实验室里目前看不到同类做法。它把讨论从"谁家模型更强"换成了"多投入多少钱能换多少能力",而这正是当前智能体训练最缺公开数据的问题。
- 面板同时暴露了工程现实。快照里能看到 Pro 因某个节点显存问题重启、Flash 从第 15 步重启(某数据集的一类基础设施错误连续三小时未被正确检出)。强化学习在智能体场景下已经是一项涉及调度、环境管理与容错的分布式系统工程,公开这些异常比展示曲线更有参考价值。
- 方法论上,罗福莉给出的三个扩展方向是算力、环境与 Harness、评分计算。评分这一环最容易被忽视:同样完成任务,20 步和 80 步的差别能否被评价识别,决定了系统最终强化的是"会做"还是"做得经济"。如果验收规则本身有漏洞,增加尝试次数只会放大错误信号。
5. Agent 协作层集中落地:CodeBuddy Code 支持标准 A2A,腾讯云 Octop 发布 1.0 GA
事件: 9 月 17 日,腾讯云 CodeBuddy Code 发布 v2.143.0,CLI 首次具备标准 A2A(Agent2Agent)协议能力;同期,腾讯云开源的自托管 AI 助手 Octop 发布 v1.0.0 GA 正式版。
产品细节:
- CodeBuddy Code v2.143.0 让 Agent CLI 同时具备两种身份。作为客户端,它可以发现并调用其他已授权的 Agent,通过 @Agent 或自然语言直接委派任务,支持并行调用多个 Agent,中间状态实时呈现;作为服务端,新增
--a2a隐藏模式,以标准 A2A 协议通过 stdio 常驻,供 SDK、CloudAgent 等程序化调用方接入。A2ASendMessage 支持通过 URL 附带文件。紧随其后的 v2.143.1 还增加了工具调用循环闸门(同一工具单次请求内连续 40 次、或 AAB 形状连续重复 10 轮时交由用户决定继续或终止)、Auto 权限分类器 fail-closed,以及出站 Agent Card 的按需 TTL 刷新。 - Octop 定位是"自托管的多用户、多智能体 AI 助手",MIT 协议,Python 编写,仓库 7 月 8 日建立、7 月 21 日开源,两个月后从 0.9.35 升到 1.0.0,GitHub 星标超过 3000。核心设计包括:每个成员拥有独立身份、工作区与记忆,JWT 按用户划分权限边界;每个成员下可配置多个专家角色;内置基于文档的 RAG 知识库;记忆绑定工作区而非模型,换模型或换机器时可整体打包迁移。部署只需
octop init与octop run,同步上线腾讯云 Lighthouse 与 CVM 官方镜像。安全上采用 JWT 多用户隔离、敏感信息脱敏与工具调用审批三重机制。Roadmap 中值得关注的是 AgentTeams(由一个协调者自主调度多个专家跑多步任务)与 Self-evolution(把日常对话蒸馏成可复用技能)。
值得关注的原因:
- CodeBuddy 同时做人 A2A 客户端和服务端,意味着编程智能体开始从"一个终端里的一个助手"变成可以被程序化编排、也可以被别的代理调用的节点。@Agent 委派加并行调用,把上一代"人工切会话"的成本进一步吃掉。
- Octop 填补的是一个具体空缺:多人共用、接得进自己的 IM、数据留在自己服务器。多用户隔离被当作第一设计目标而非事后补丁,这在开源 AI 助手里并不多见。代价也很直白,运维要自担,服务器、备份与模型 API 成本都落在自己身上。
- 两条线指向同一件事:代理之间的协作协议和代理运行的自托管底座,正在从各团队自建变成可复用的公共层。这与这两天 Claude Code Projects 的协调者、CodeBuddy 的 A2A、Octop 的 AgentTeams 是同一个方向的三个切面。
三、具身智能深度动态
6. 智元发布远征 A3 Ultra 商用落地实景,把全尺寸人形机器人放进 4S 店、酒店与便利店
事件: 9 月 16 日晚间,智元机器人发布远征 A3 Ultra 商用落地实景案例视频,9 月 17 日经多家媒体扩散。官方称其为全球首个规模化量产全尺寸人形机器人商用落地实景案例,产品已完成千台级车规量产验证。
产品细节与场景:
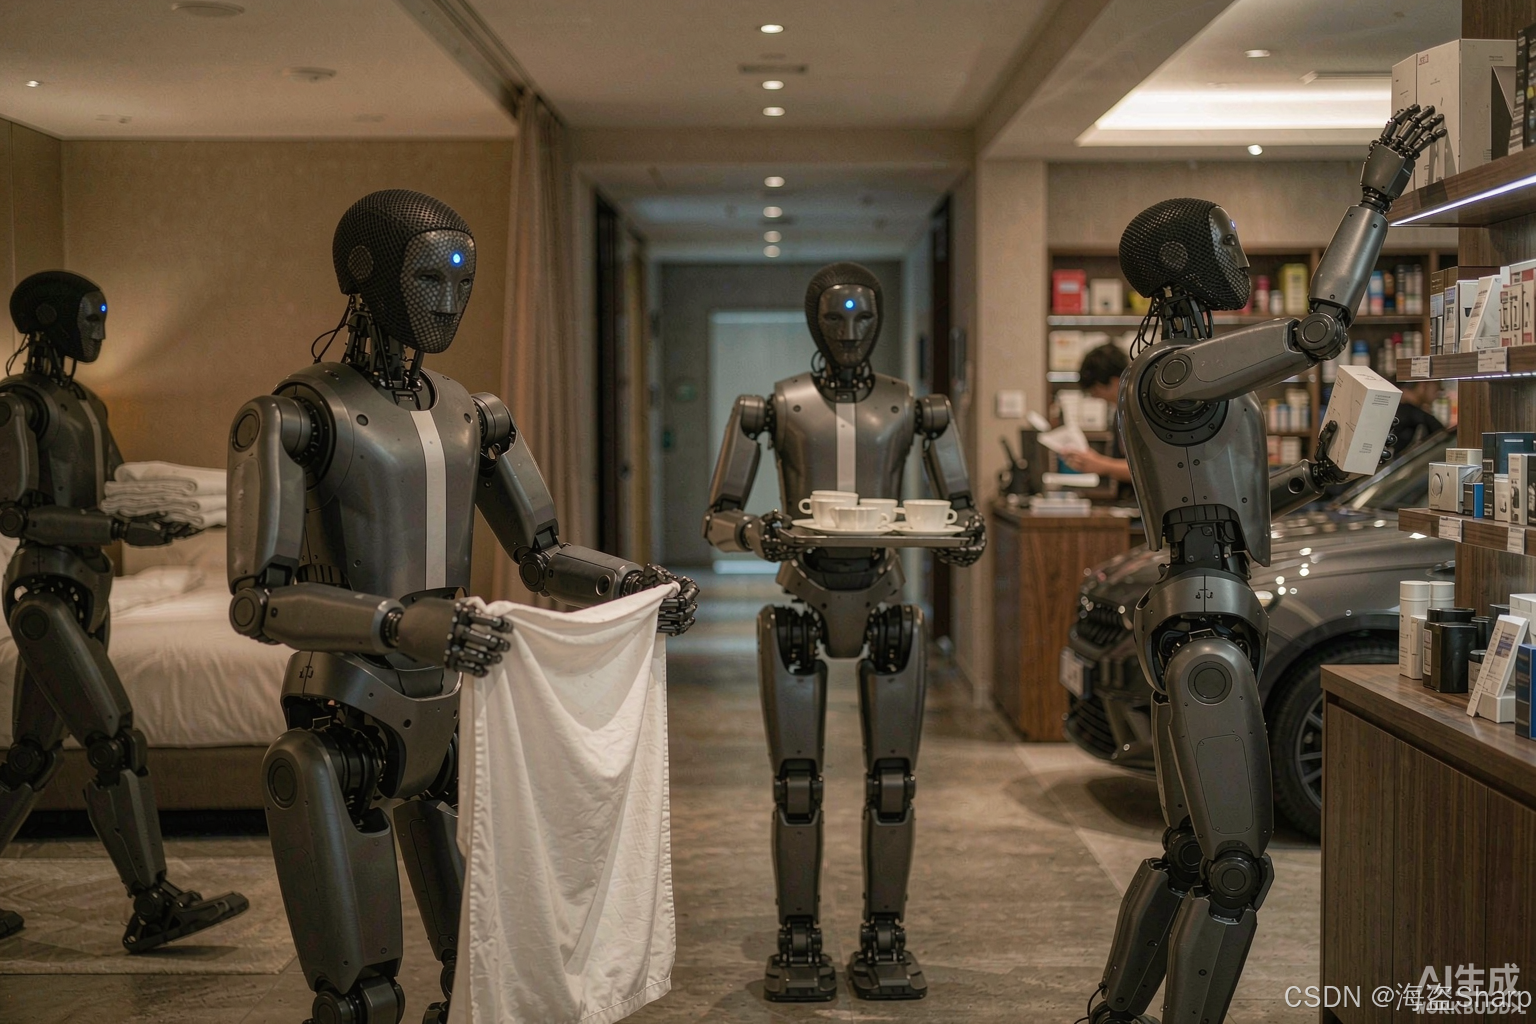
- 在汽车 4S 店,多台机器人协同完成迎宾、递水、车型讲解、交车服务,并承担递花、合影、放礼炮、生成运营日报与直播带货。在酒店,协同完成铺床、整理客房、叠毛巾、入住办理、带路乘梯与夜间巡检。在零售便利店,执行理货、巡逻、补货、大件搬运与顾客服务。
- 硬件上采用镁合金与碳纤尼龙混合机身,兼顾结构强度与轻量化,可完成弯腰、下蹲、倒退、推车、开启汽车后备箱等大尺度动作。末端为一对 20 个自由度的全向触觉灵巧手。感知侧搭载 360° 全域感知系统,融合 UWB 与 RTK 定位,配合 700 TOPS 算力平台,可自主感知环境、理解任务并规划路径。
- 运营侧支持自主充电与极速换电,实现 7×24 小时不间断值守。官方称模块化维护设计与便捷部署方案降低了后期管理门槛,可满足连锁门店、酒店集团及多点位商业客户对标准化部署、持续运营与规模化管理的需求。
值得关注的原因:
- 这条新闻的分量不在参数,而在"店"和"班"。过去人形机器人的公开材料基本停留在实验室演示与发布会 CG,这次给出的是三个高频商业场景里的连续作业画面。场景选择也很讲究:4S 店、酒店、便利店都是标准化程度较高、任务可枚举、单点价值可核算的场所,是具身智能最可能先跑通商业闭环的地方。
- 千台级车规量产验证这个说法值得单独记一笔。车规意味着按汽车行业的可靠性与一致性标准做验证,而不是按机器人行业自己的宽松口径。如果这个口径站得住,它比任何单点成功率都更能说明能否规模化交付。
- 需要验证的是真实占比。视频是精选呈现,机器人自主完成的比例、需要人工接管或远程遥操的比例、以及在连续运行下的故障间隔,这些数字目前没有公开。7×24 小时值守的说法也依赖换电与运维网络的实际铺开程度。
7. 第九届中国机器人峰会开幕:产业开始在"谁能真正干活"这件事上立规矩
事件: 9 月 17 日,第九届中国机器人峰会主论坛在杭州未来科技城开幕,主题为"智联新生态,赋能全场景——机器人+时代的智变与质变",由中国机电一体化技术应用协会主办,预计汇聚 50 余家协会及科研院校、500 余位行业专家、2000 余名业界代表,35 家参展企业覆盖工业、服务、人形机器人、关键零部件与具身智能基础设施五大展区。
发布内容与关键数据:
- 机器人具身智能三维性能测评框架正式发布,由国家机器人检测与评定中心与高校联合推出,核心为"三能四域四化":从运动、作业、交互三个维度定义能力,用光场、声场、运动场、动力场四类环境变量检验稳定性,再以语义、组合、域外、异构四类泛化检验可靠性。现场的说法是"会演示,不等于真能干活"。
- 同期发布《2026中国具身智能产业出海研究报告》,提出"战略决策—产品技术—合规风控—市场运营—生态引领"五层框架及四阶段发展路线图;"中国产学研合作促进会康养机器人协同创新平台"启动,聚合高校、院所、医院与产业链龙头;中国高校智能机器人创意大赛智能体专项赛启动。
- 中国机电一体化技术应用协会会长曲道奎给出两组对照数据:2026 年上半年具身智能赛道融资总额已突破 900 亿元,人形机器人量产进程加速;但他同时提醒,行业仍站在商业化落地的关键点,核心部件仍待突破,真实场景应用占比仍有短板,标准体系尚待统一。
- 区域产业数据方面,浙江累计培育未来产业先导区 36 个,四足机器人、人形机器人国内市场占有率分别超过 80% 和 50%,杭州集聚机器人相关企业 700 余家,产业集群突破千亿元。全国首部促进具身智能机器人产业发展的地方性法规《杭州市促进具身智能机器人产业发展条例》已出台。
- 一个值得单列的做法来自浙江大学朱世强:国内首个机器人学校已在杭州开业两个月,依托自研 VLOA 大模型"无极大脑",采用"入学体检—分科培养—评级测评—持证上岗—迭代返训"流程,把"会干活但干不好"的机器人训练成持证上岗的合格劳动者。目前培养的导览机器人已进入中国国家博物馆等场馆,一天内可完成部署,船舶焊接与工业上下料机器人也在实训中。
值得关注的原因:
- 评测框架比任何单项技术发布都更值得关注。产业长期缺少统一口径,出货量、成功率、自主率各说各话。把能力拆成运动、作业、交互三维,再用四类环境变量和四类泛化交叉检验,实质是把验收标准从"看起来行"推向"在扰动下还行"。检测认证与标准服务因此可能成为一门新生意。
- 曲道奎的两句话要放在一起读:上半年融资超 900 亿,同时真实场景应用占比仍有短板。资本热度与落地进度之间的落差,是这一轮最需要盯住的风险点。
- 机器人学校给出了一条不同于堆数据的路径。场景派泛化能力差、复制成本高,技术派商业化周期长、投入难持续,单一路径都走不通。把真实场景里的作业过程变成高质量数据并反哺技术迭代,本质上是让"场景"和"技术"互为供给方。这条路径能否跑出稳定的单位经济模型,比模型跑分更值得跟踪。
四、产业趋势总结
- 编码智能体的竞争重心转向编排层:Claude Code Projects 的协调者、CodeBuddy 的 A2A 双身份、Octop 的 AgentTeams,三件事都在解决同一个问题:不是让单个代理更能写代码,而是让多个代理不互相踩脚地把一个大目标做完。评价单位从补全准确率变成整条工作流的完成率与冲突率。
- 代理间的协作正在协议化,运行底座正在自托管化:A2A 成为 CodeBuddy CLI 的一等能力,Agent Card 有了 TTL 与发现机制,Octop 把多用户隔离、JWT 权限边界、工具审批做成开源默认项。代理协作从各团队自己造轮子,转向可复用、可审计的公共层。
- 全栈国产从口号落到可验证的指标上:中电信 29B-A4B 用国产算力与国产框架训练,万卡集群利用率 98%、效能约为同算力英伟达的 93%;智谱在 10 万卡国产集群上跑完全部生产推理,官方称单 token 成本与主流 GPU 相当。国产算力的问题正从"能不能跑"转为"跑得贵不贵、稳不稳"。
- AI 自我改进从概念讨论进入工程闭环:智谱的 Infra Agent 修好了承载自己的系统,小米把 RL 训练过程实时公开。两者共同点是把"反馈质量"当作核心变量。端到端指标解释不了为什么变差,反馈必须局部、低成本、可客观验证。这也让工程经验第一次有了被系统化沉淀并进入下一代模型训练的可能。
- 具身智能从演示竞赛切换到验收竞赛:智元给出三个真实商业场景的连续作业,峰会同步发布三维性能测评框架,一边是供给侧拿出落地画面,一边是检测侧立起统一标尺。口径一旦统一,过去靠宣传拉开的差距会被迅速重估。
- 成本与 ROI 取代跑分成为选型主轴:中国模型在 OpenRouter 上连续 20 周调用量领先,靠的不是智能指数领先(前五仍为海外模型),而是平均定价约为国际同行的 10% 至 20% 加上可观的产品成熟度。企业关注点从"谁最聪明"转向"每块钱能换多少活",瑞银把这一变化概括为 Token ROI 成为新关键词。
五、值得持续关注的信号
- Claude Code Projects 的冲突解决比例:协调者代两个代理裁决意图,人工介入率有多高、合并冲突在真实多仓库场景中是否可控,决定了它是真省时间还是把工作挪了个地方;
- 本地执行支持的时间表:Anthropic 称"很快到来",这是私有仓库、气隙环境与本地依赖栈能否用上 Projects 的前置条件;
- 智谱那套稠密反馈环境的外溢效果:分层验证接口与真实基础设施任务,是否会被当作训练下一代模型的训练场,以及 GLM-5.3-Flash 之后新模型的工程效率是否可环比;
- 中电信 TeleAgent 的活跃用户占比:注册用户 118 万是规模指标,活跃占比与 AI 业务收入占比才是"从管道运营商转向 AI 服务商"是否落地的验证点;
- 小米 MiMo-V2.6 RL 的外部评测增益:单轮训练早期曲线还不足以确立新的规模律,需要持续观察外部能力提升与完成任务的成本是否同步改善,以及换 Harness 后是否保持;
- 具身智能三维测评框架的采纳进度:是否有头部厂商主动送检、是否与已有的信通院数据集质量标准(11 月 1 日实施)以及 ISO 体系形成互认,决定了这把"尺子"的实际约束力;
- 智元 A3 Ultra 的自主率与故障间隔:视频之外,人工接管比例、连续运行下的故障间隔与换电运维网络的实际覆盖,是千台级交付能否持续的关键;
- 华为昇腾960 的交付节点:960DT 计划 2027 年第一季度就绪、960PR 第三季度,均较原计划提前;CANN 社区外部开发者占比已达 61%,生态是否能同步跟上硬件节奏需要跟踪;
- 中国模型调用量领先的可持续性:OpenRouter 只统计经平台路由的流量,厂商自有 API、云平台与私有化部署均未纳入,领先倍数不宜直接等同于全球份额;
- OpenAI 披露框架的行业跟随情况:框架发布前未与 Anthropic、谷歌共享,公开案例中部分涉及第三方披露义务,其他实验室是否会建立可比的报告机制,是这一轮安全透明化能否形成行业惯例的观察点。
本日报基于公开报道整理,仅供参考。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献28条内容

所有评论(0)