Python基础(二)
第三章 AI应用
AI大模型:也称为大语言模型(Large Language Models, LLM),是AI技术的一个分支。其实就是一个用代码模拟人脑神经网络的程序(参数量极其庞大,通常达到数十亿至数千亿级别),通过大量的数据训练后,使其具备理解人类语言、思考、推理并输出人类语言的能力。
AI应用-基础
大模型部署
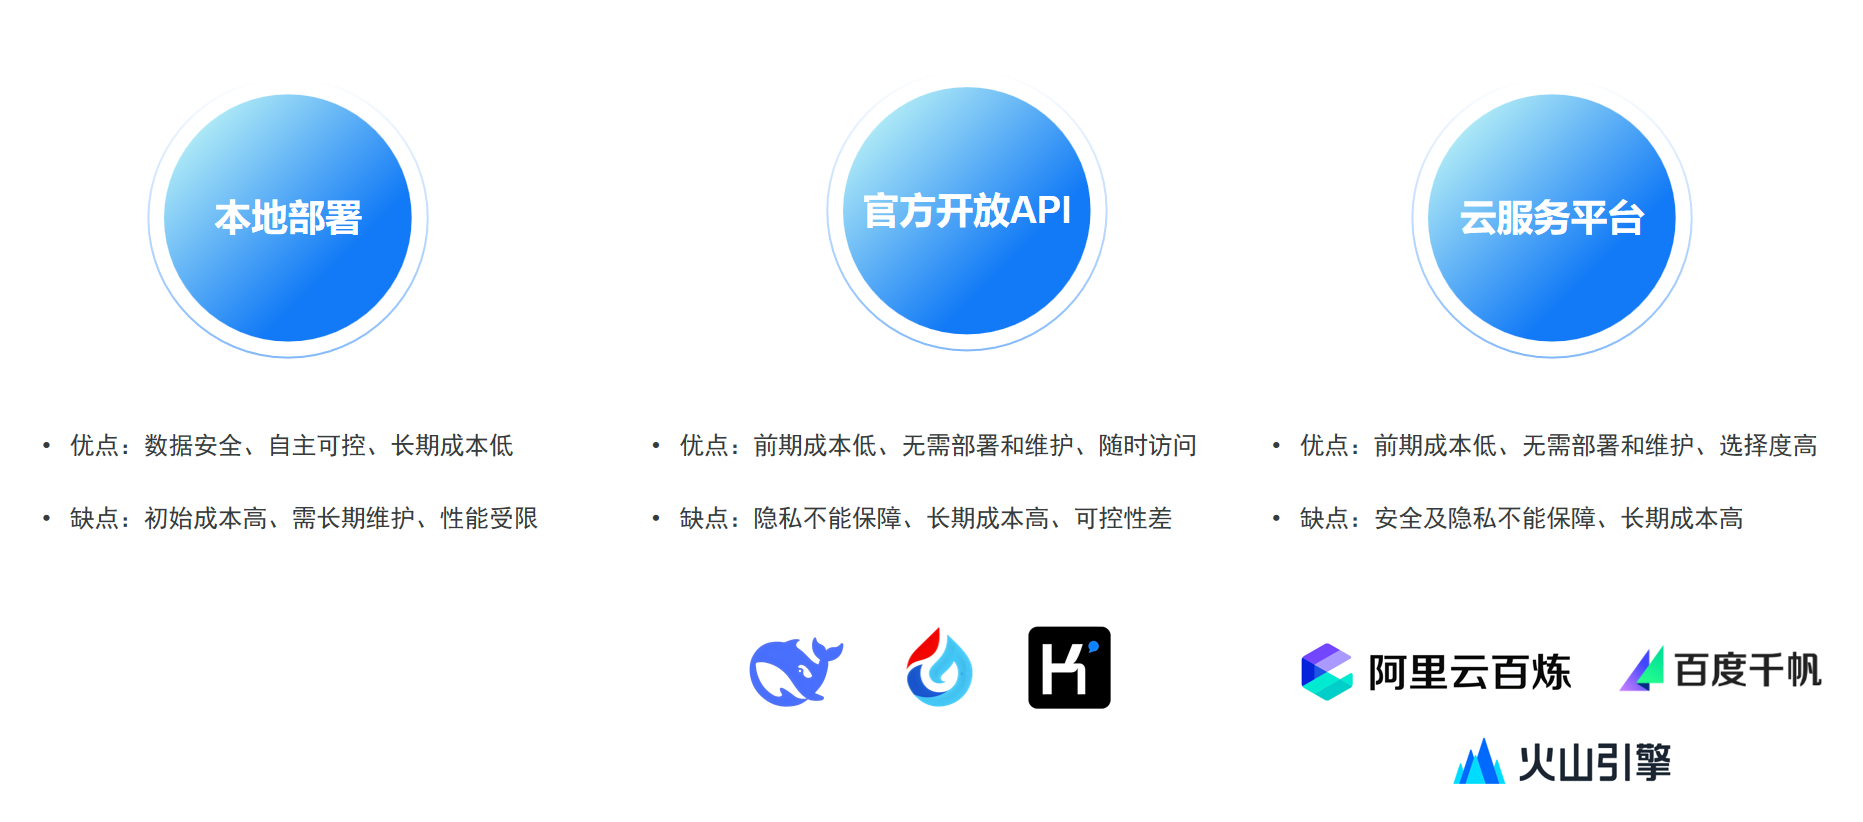
API:应用程序编程接口(Application Programming Interface),是软件间的标准化的 “桥梁”,允许开发者无需知晓内部细节即可调用外部功能或数据。
Ollama是一个在本地运行、管理大语言模型的工具。官网:https://ollama.com/
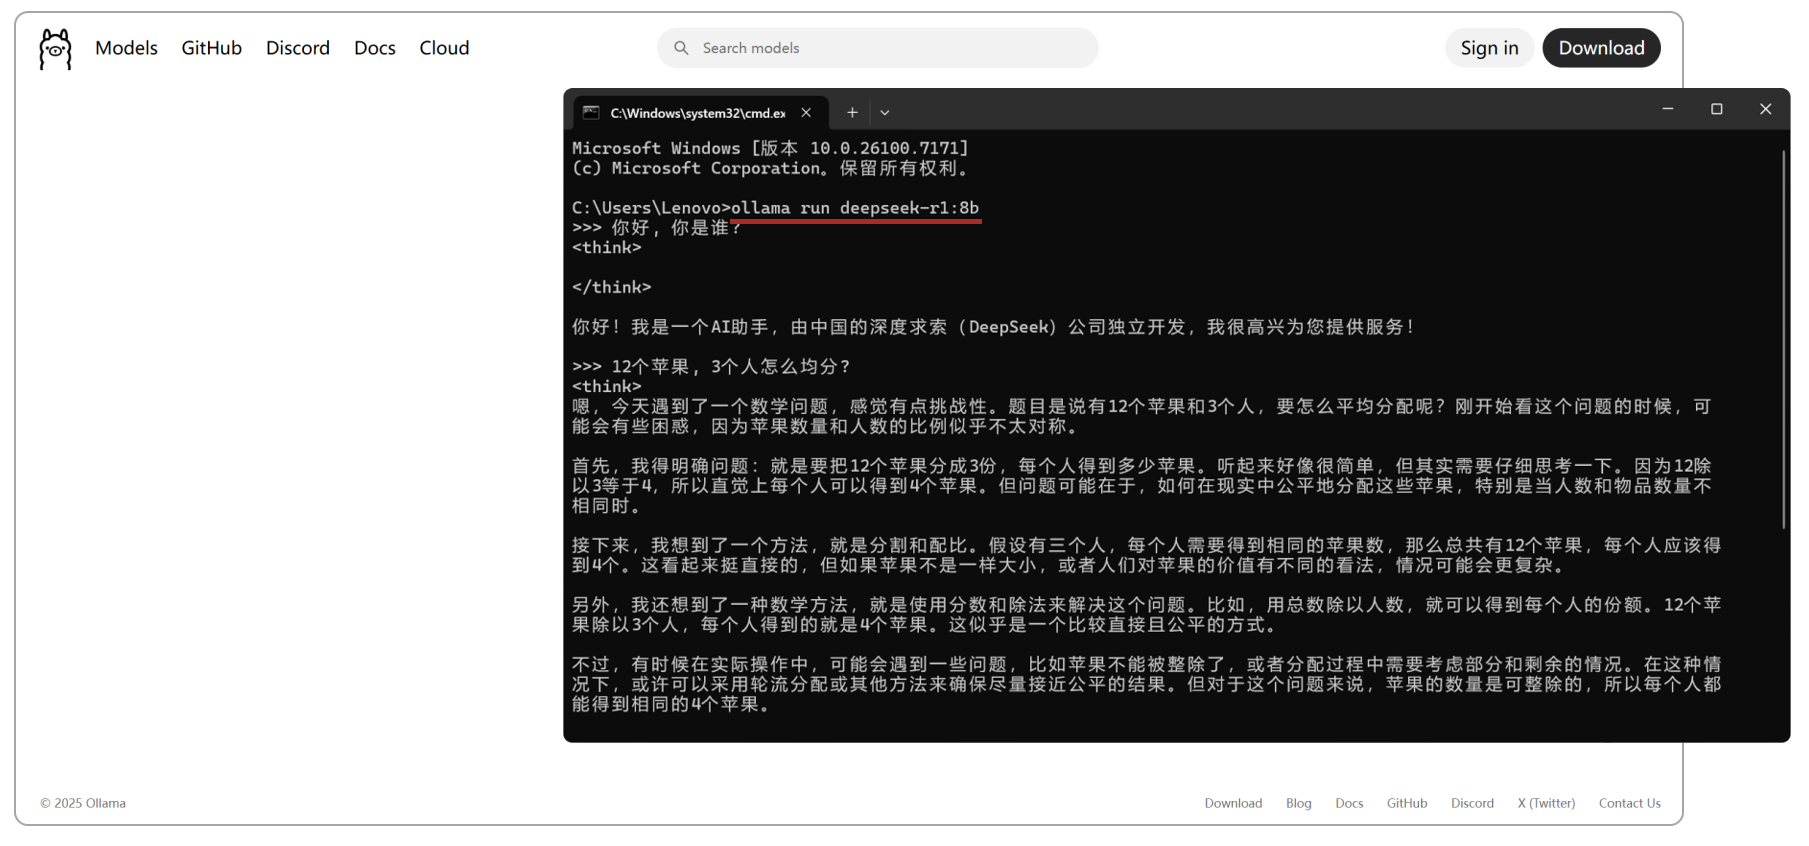
- 自定义安装
注意:
Ollama默认安装目录是C盘的用户目录,如果不希望安装在C盘的话(其实C盘如果足够大放C盘也没事),就不能直接双击安装了。需要通过命令行安装。
1). 命令行安装方式如下:
在OllamaSetup.exe所在目录打开cmd命令行,然后命令如下:
OllamaSetup.exe /DIR=你要安装的目录位置
比如:
OllamaSetup.exe /DIR=D:/develop/ollama
2). 配置环境变量
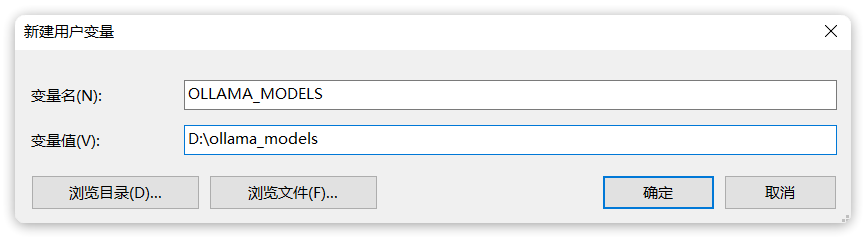
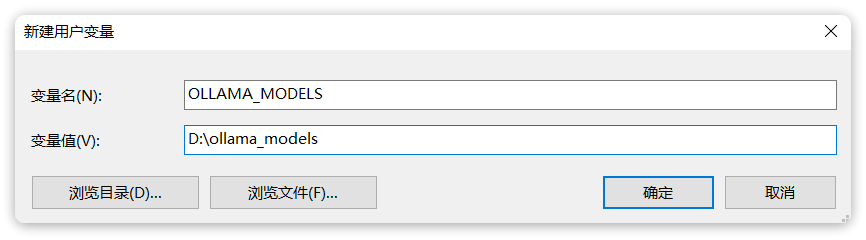
OK,安装完成后,还需要配置一个环境变量,更改Ollama下载和部署模型的位置。环境变量如下:
OLLAMA_MODELS=你想要保存下载的模型的目录
环境变量配置方式,在前面的课程中已经讲过了,和之前配置的方式是一致的,这里不再赘述,配置完成如图:
✋
- 部署大模型
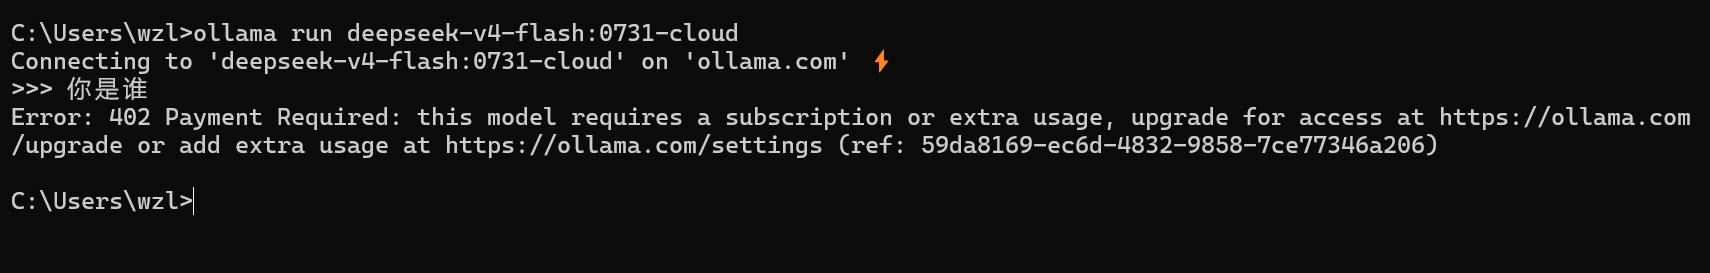
先登录ollama,连接设备,
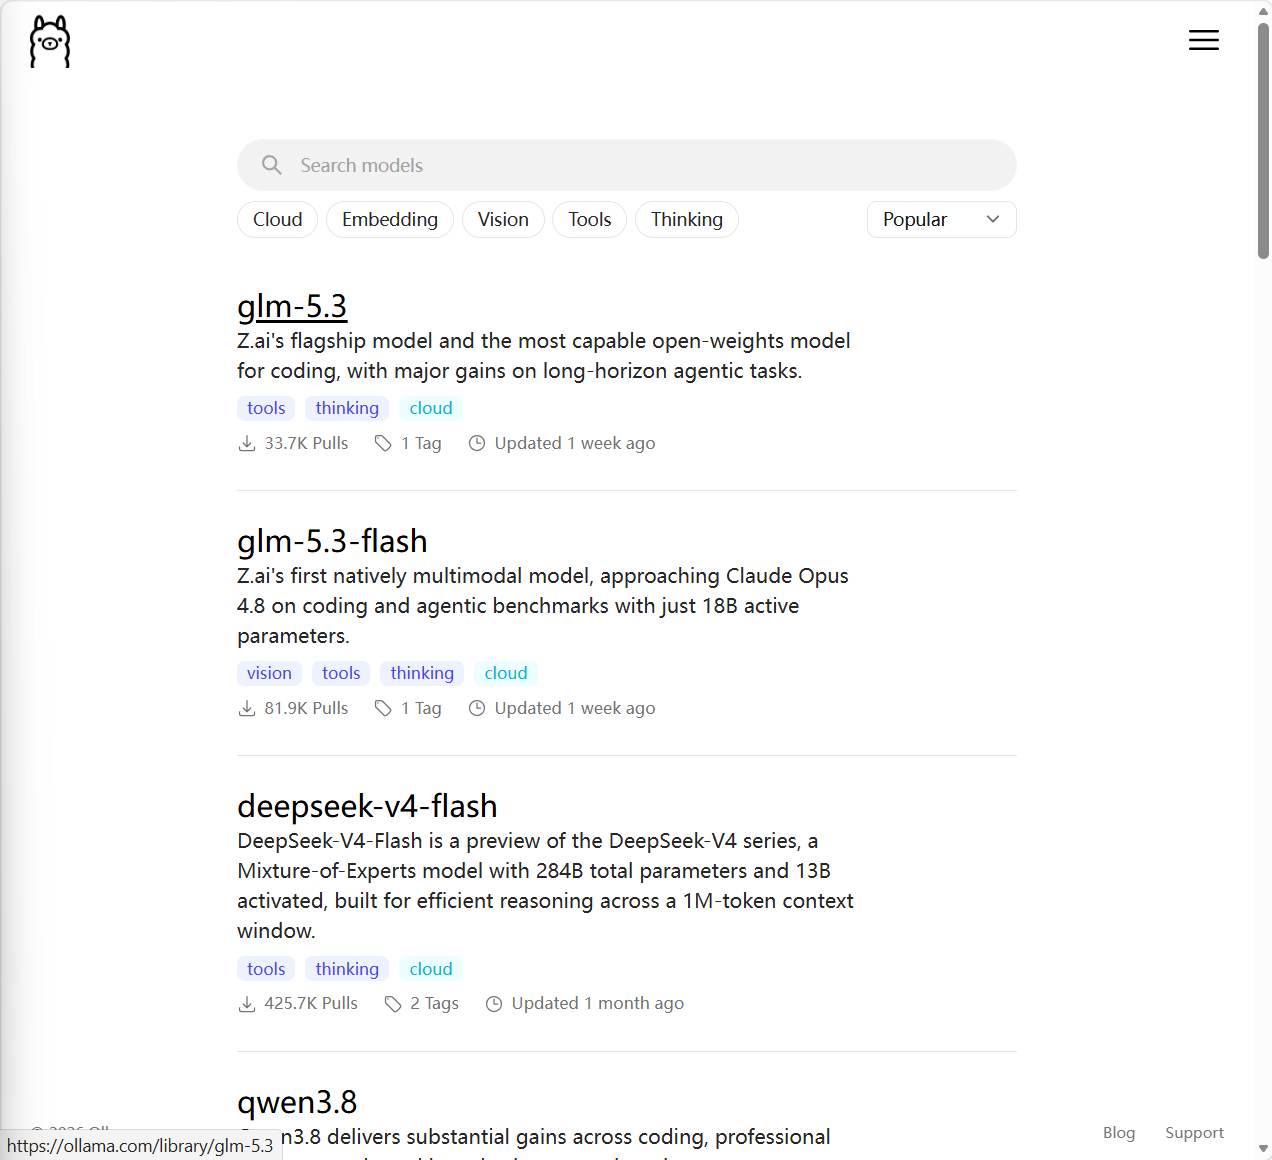
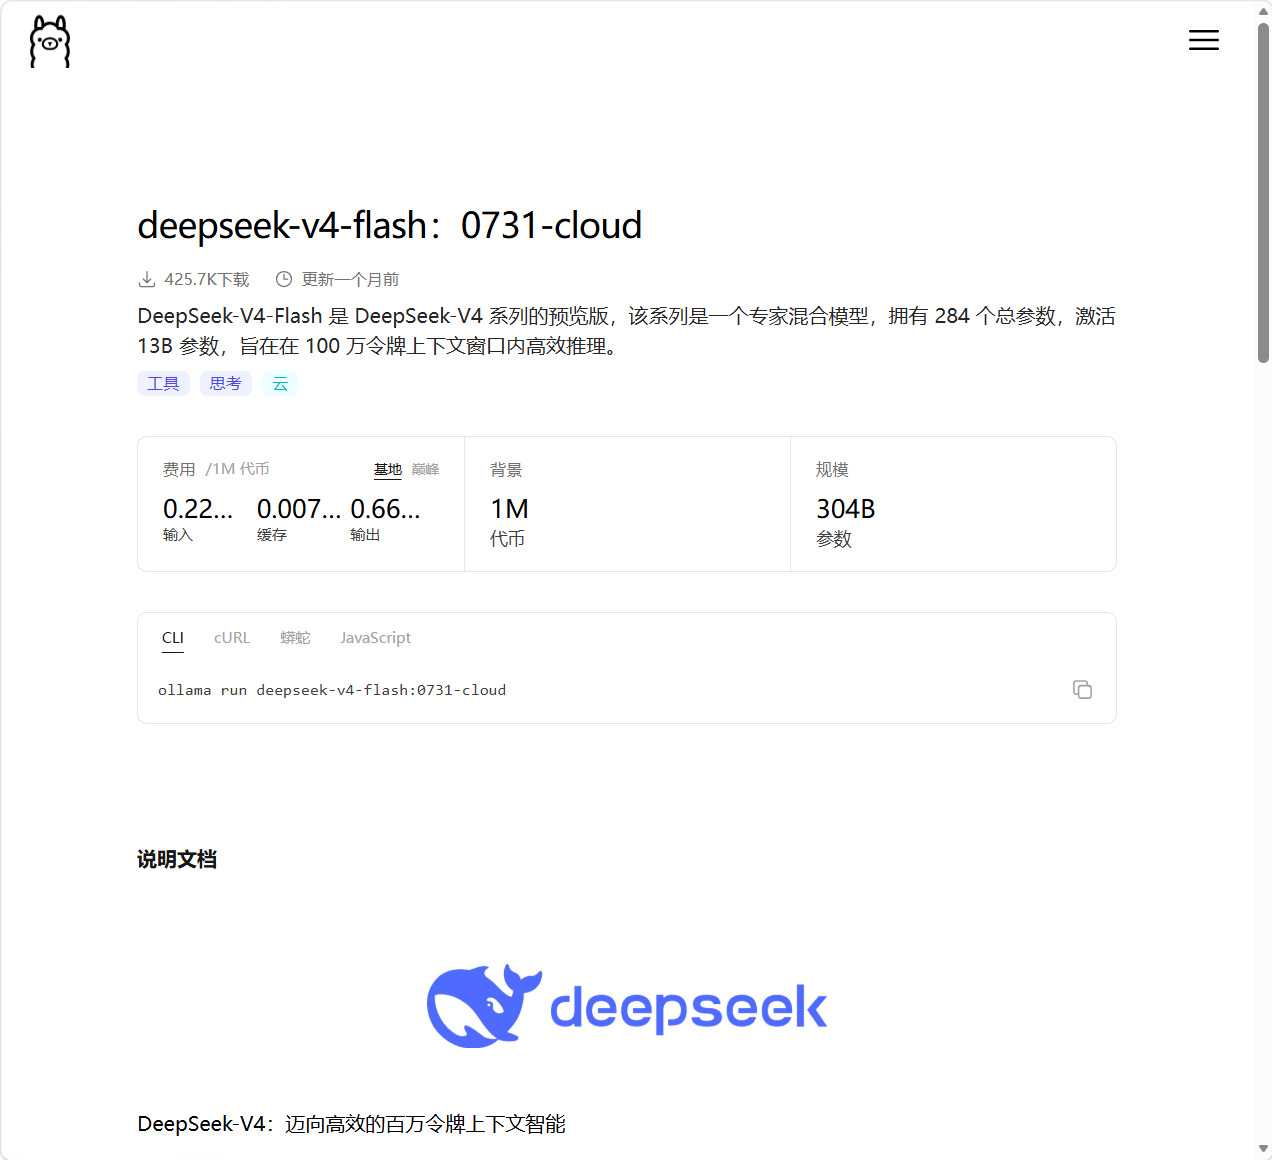
ollama run deepseek-v4-flash:0731-cloud
💩要钱
官方开放API
主流的大模型(如:DeepSeek、Kimi等)官方都提供了开放API,无需部署,就可以直接调用访问。

✋
注册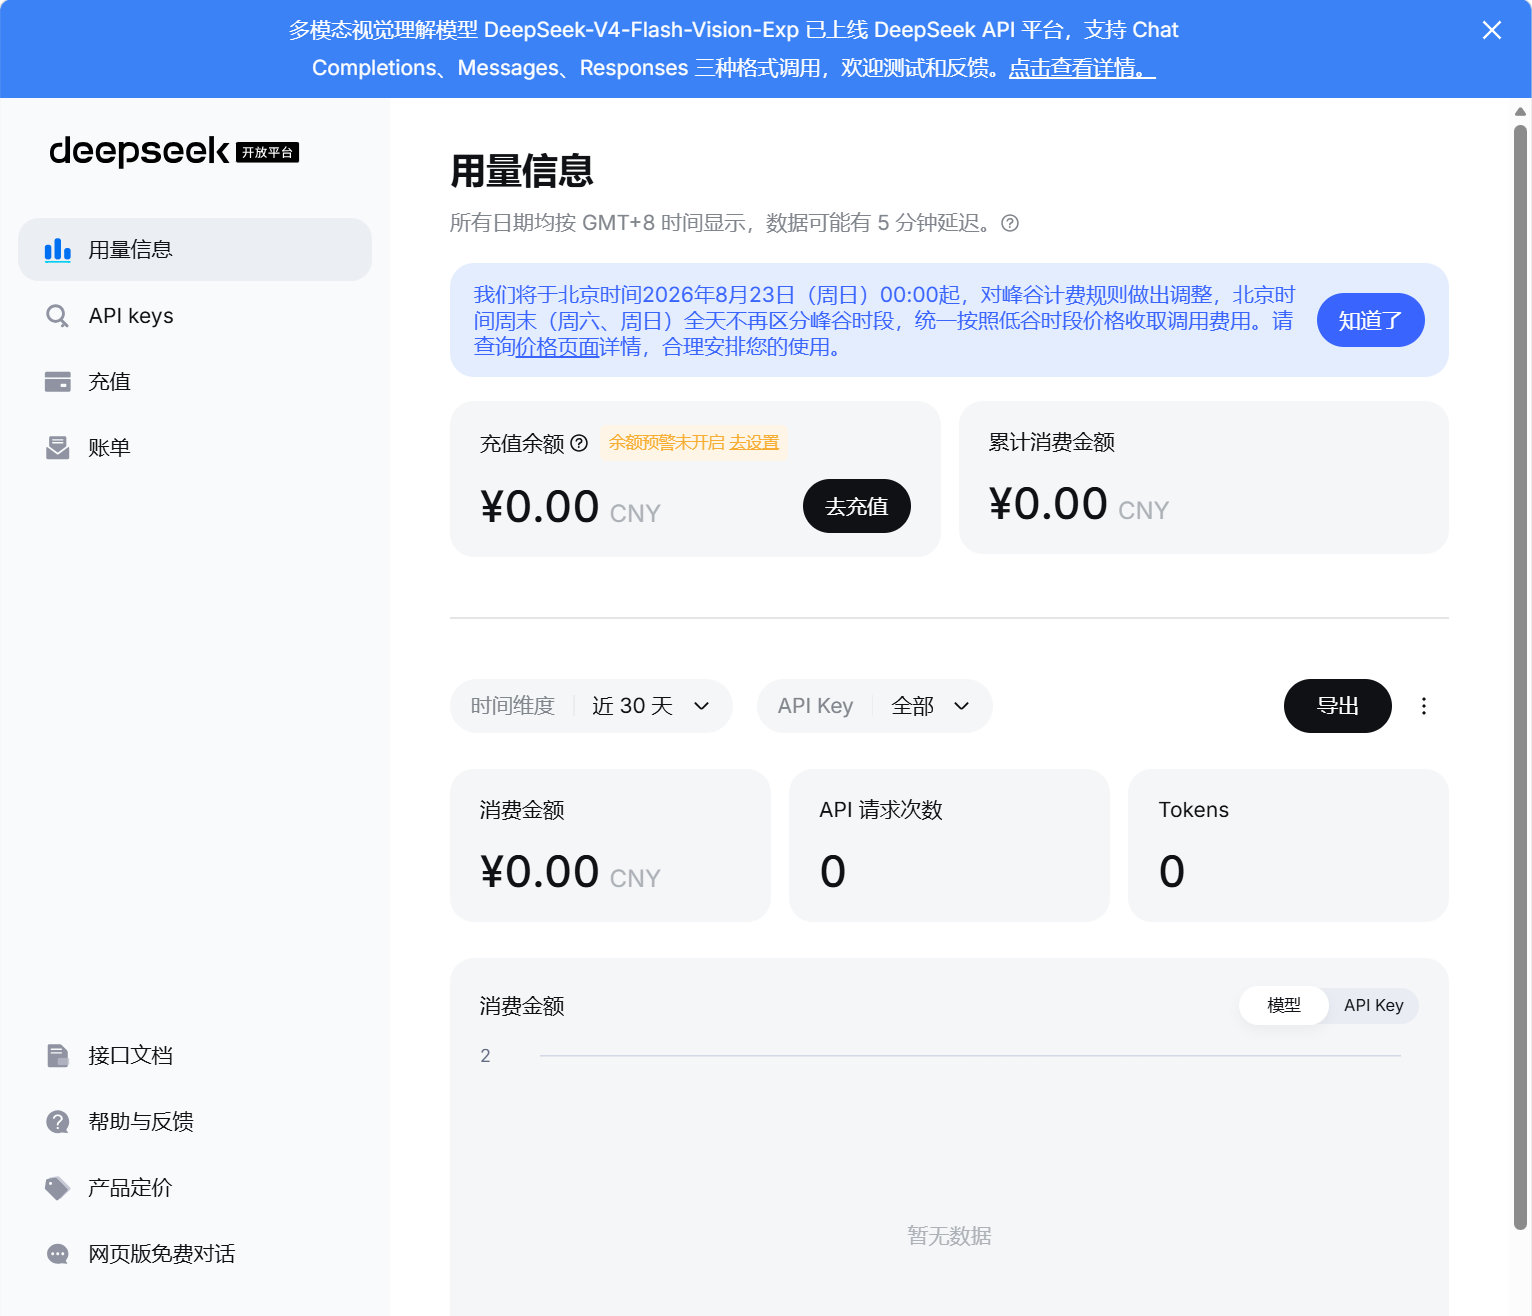
充值一元,
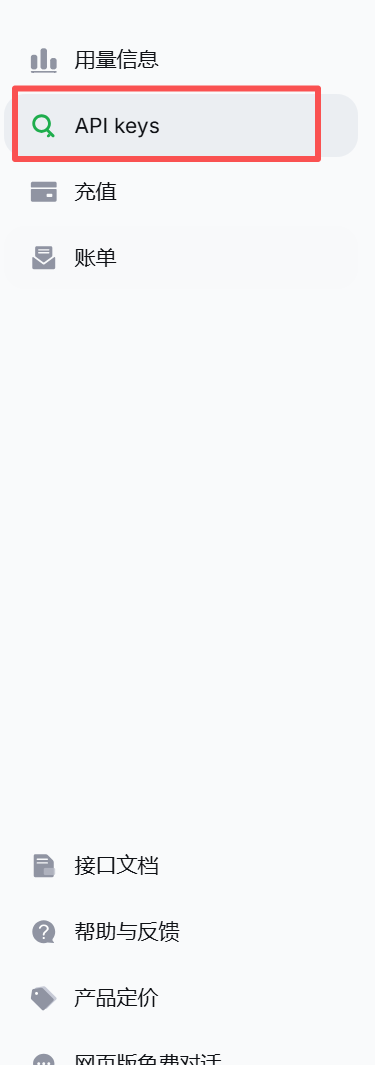
创建密钥,
复制密钥,
大模型调用
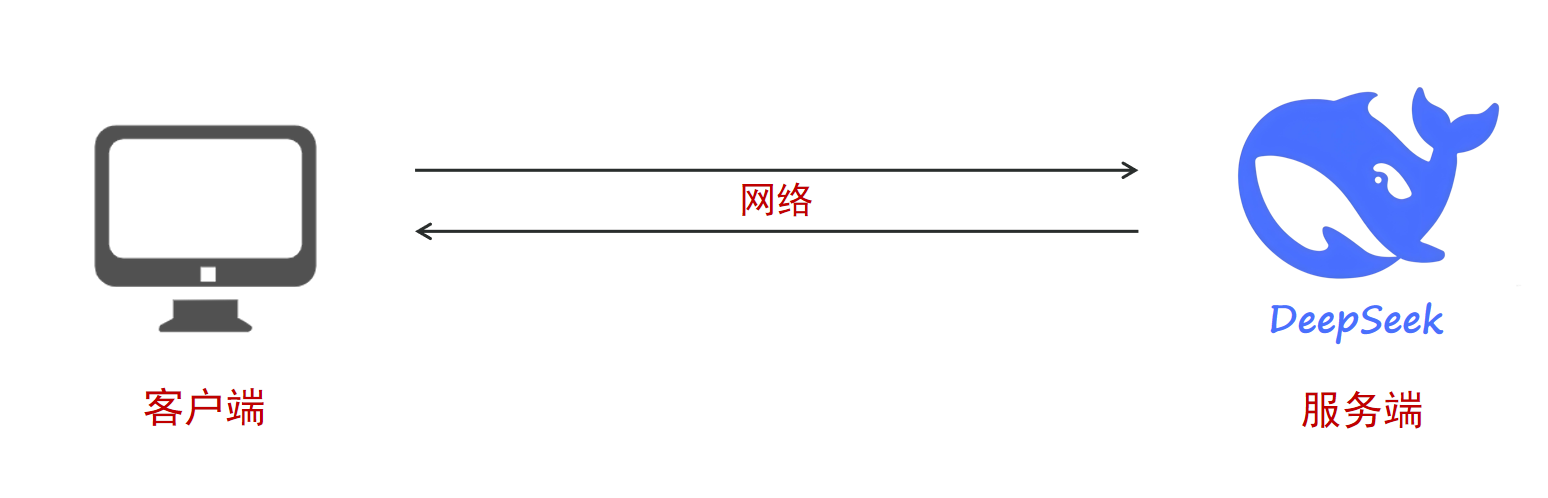
客户端调用服务端涉及网络知识
网络基础知识
-
网络,也就是我们通常所说的互联网(Internet),就是由无数个计算机网络设备连接起来形成的全球性的网络基础设施。
-
IP地址可以理解为就是设备在互联网中的地址(唯一身份证),每一个连入网络的设备都有一个自己的IP地址,用来定位设备在互联网中的位置。
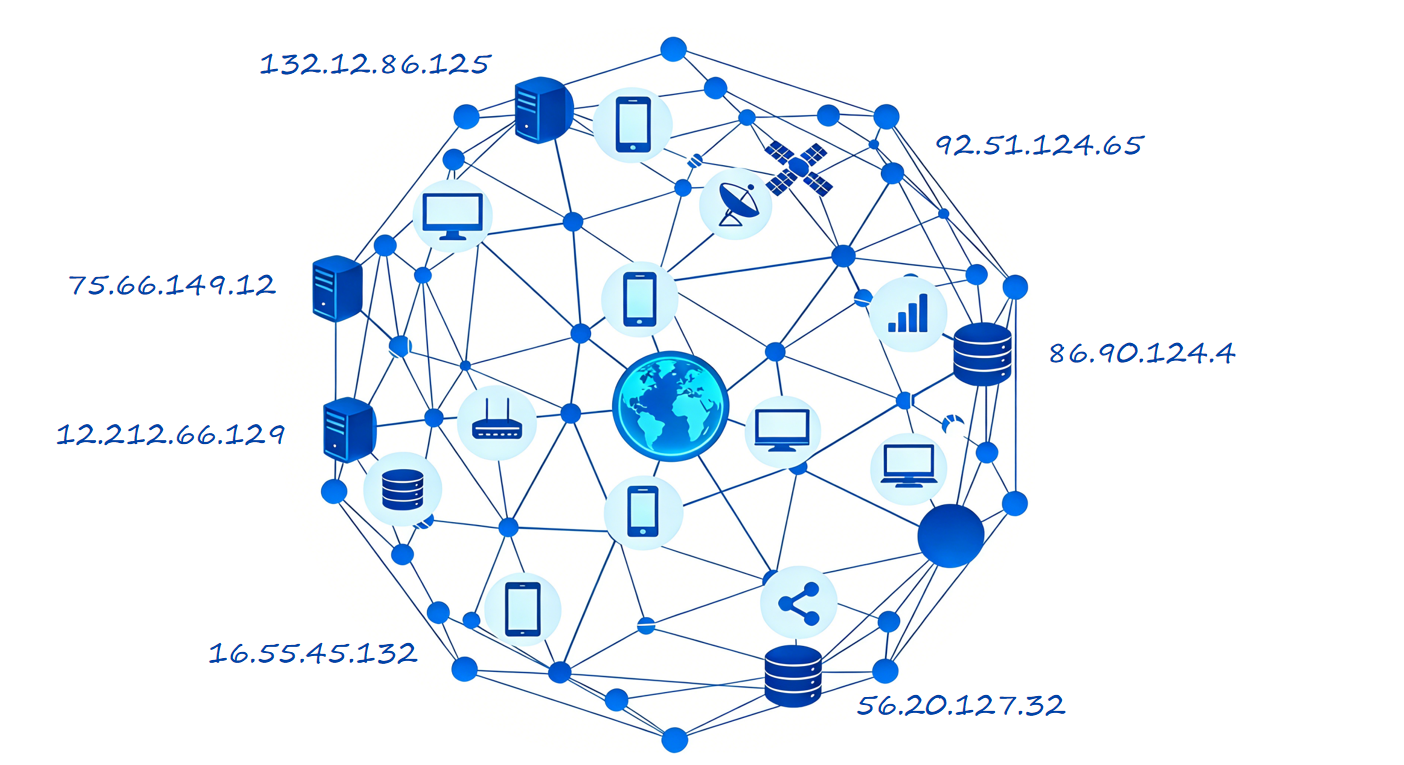
IPv4地址:32位二进制
IPv6地址:128位二进制
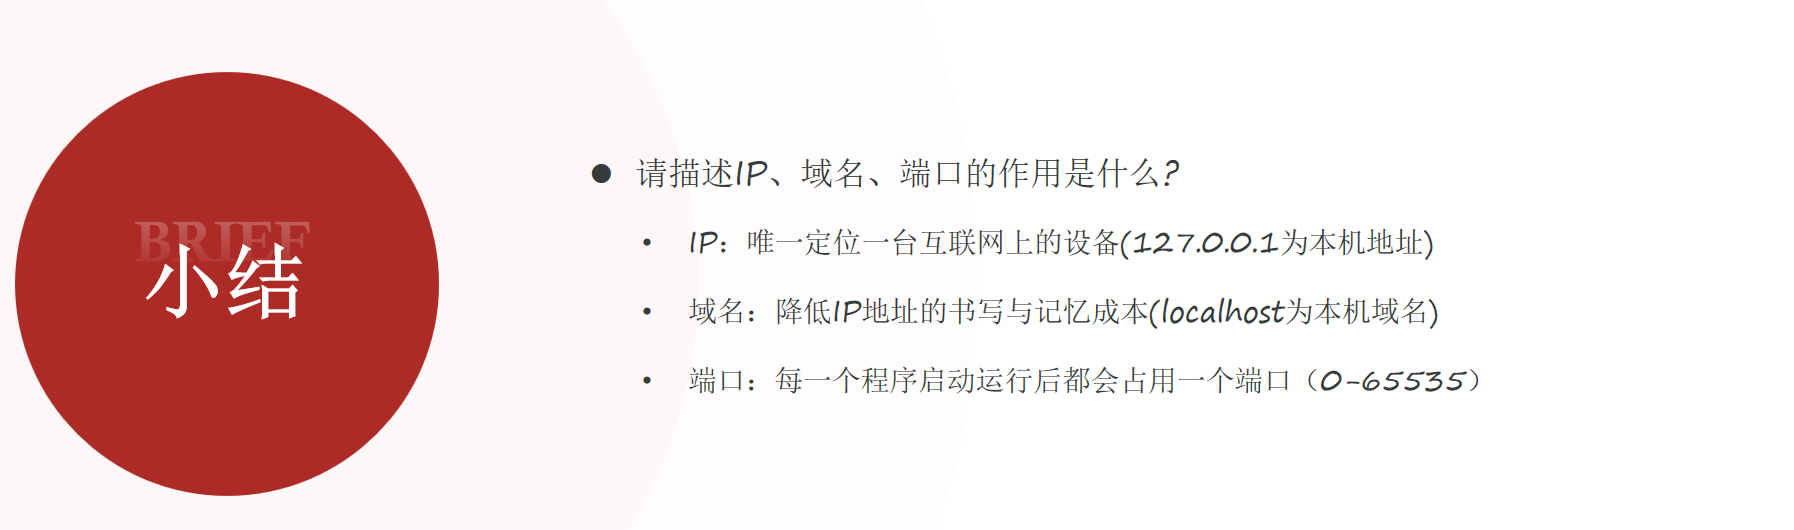
注意:127.0.0.1 是一个非常特殊的IP地址,表示的是本机地址(也称为本地回环地址)。
也就是localhost
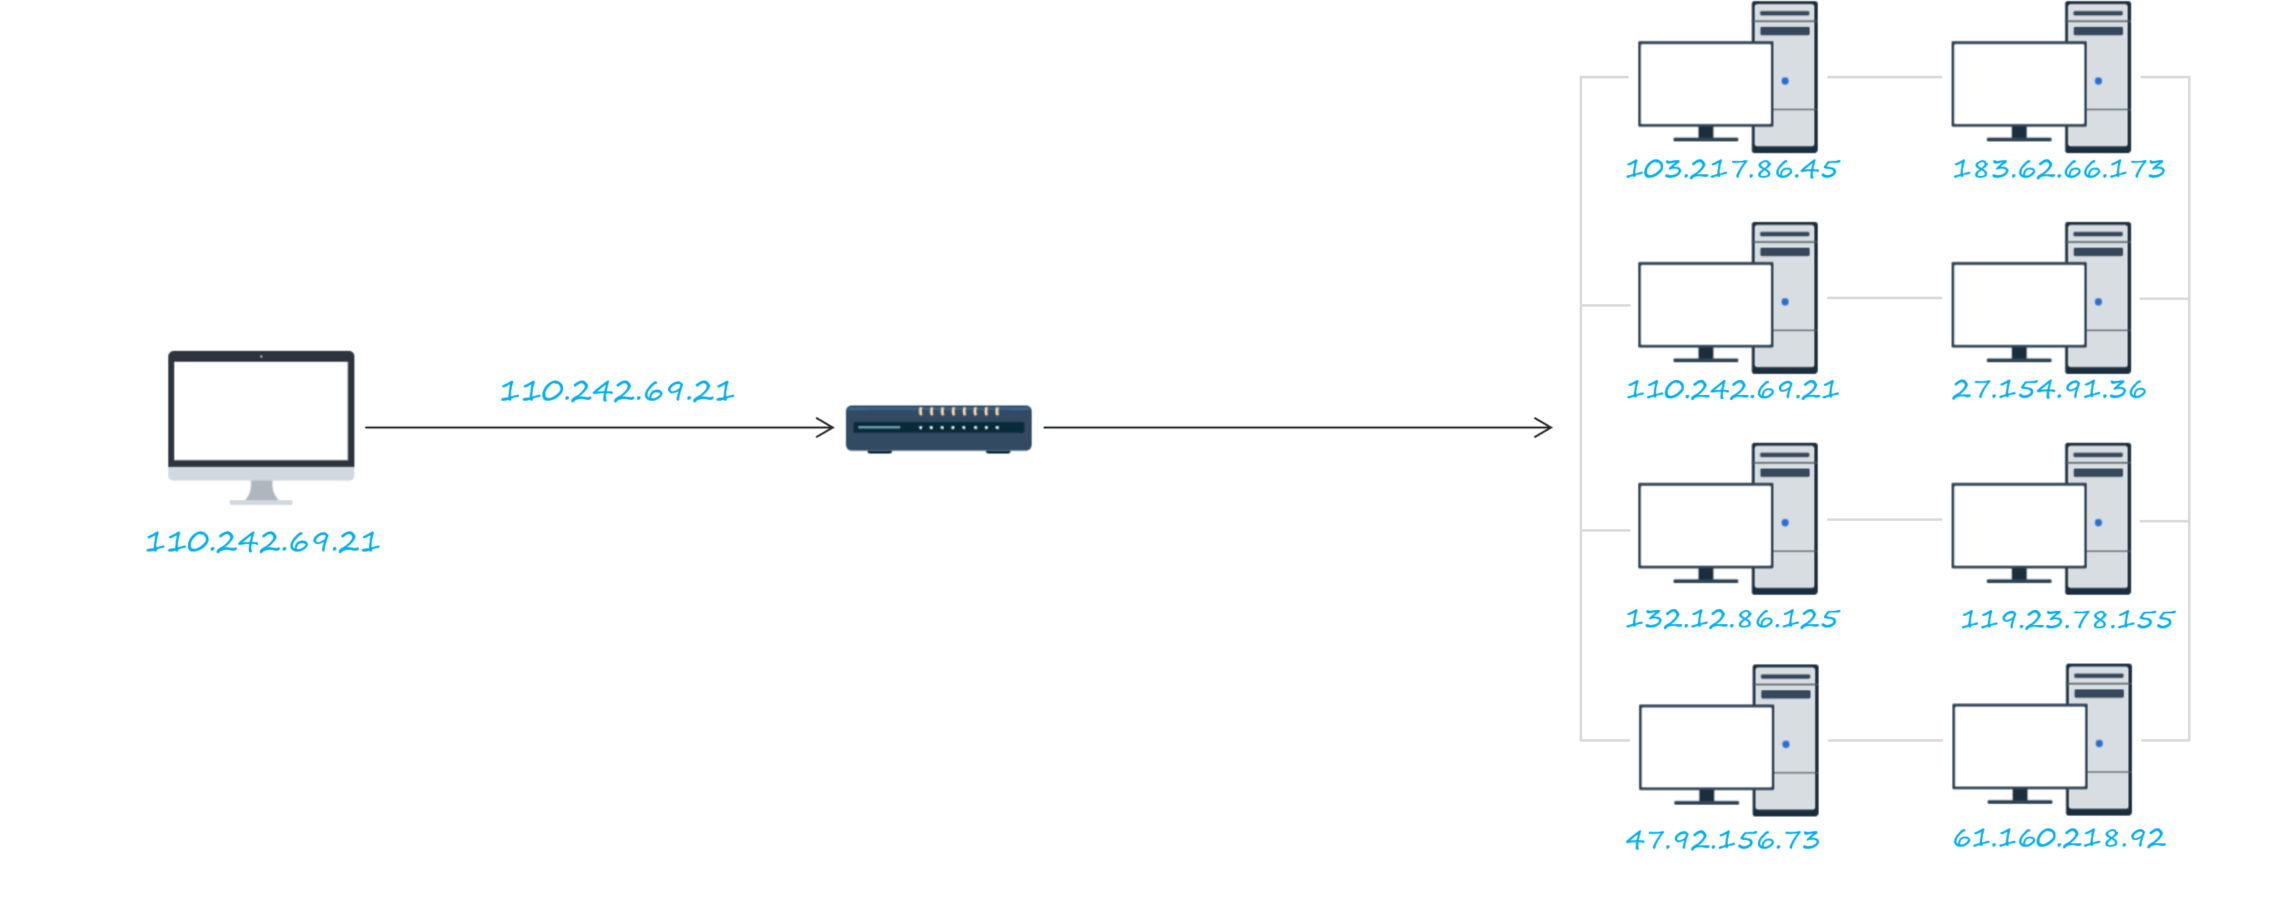
平时我们访问百度的时候也没有输入地址,而是访问域名
- 域名(Domain Name),是由一串用点分隔的英文字母组成的。IP地址不便于记忆,因此设计出了域名,并通过DNS(域名解析服务器)来将域名和IP地址相互映射,便于记忆和访问。
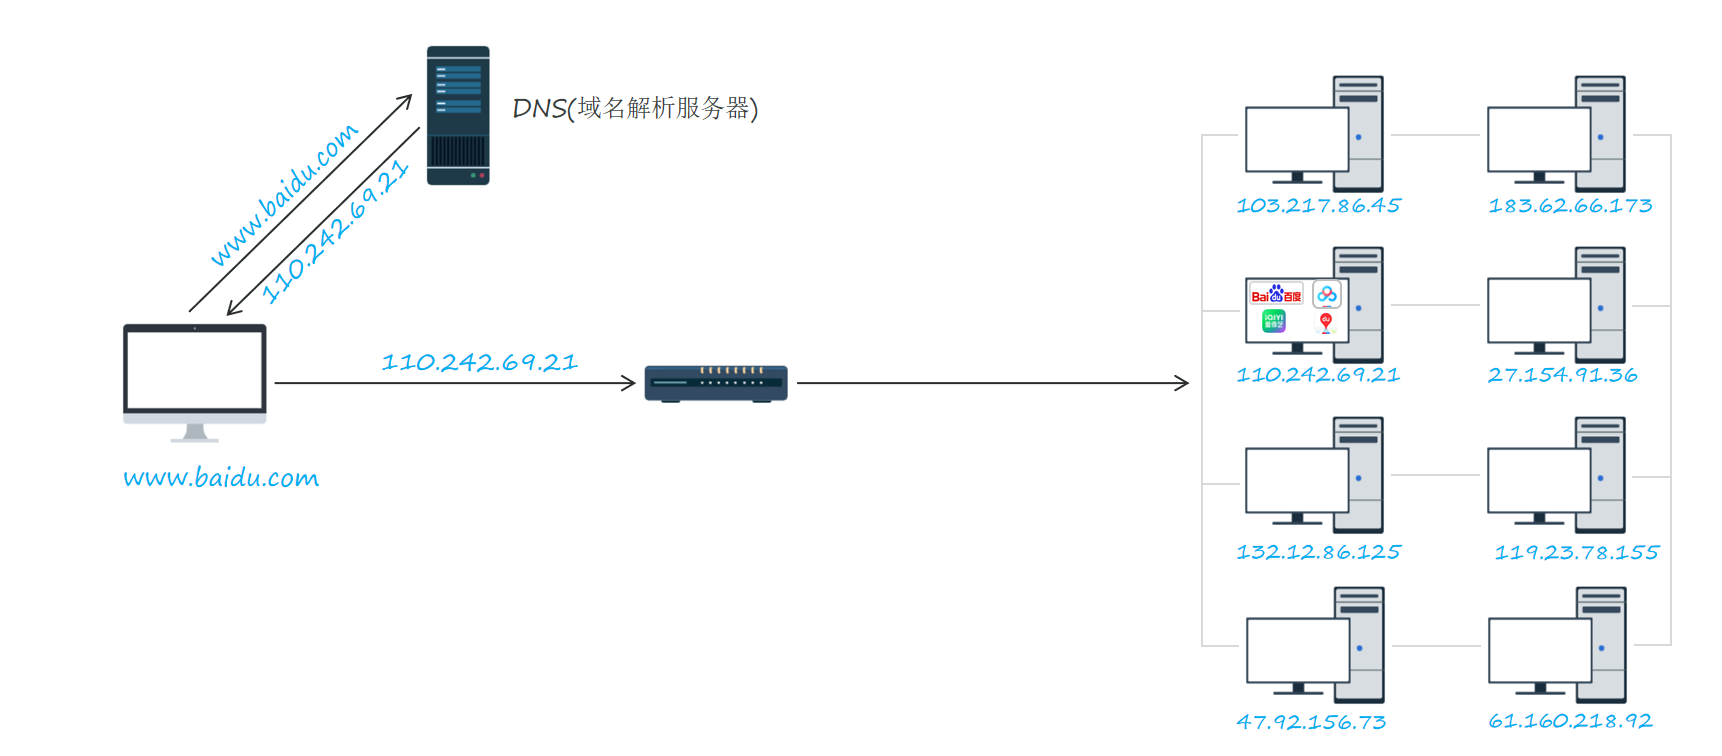
那怎么知道访问服务器上哪个服务呢?用端口号区别
- 端口号(Port)是整数,取值范围在0-65535,它是用来标识计算机设备中的运行中的程序。
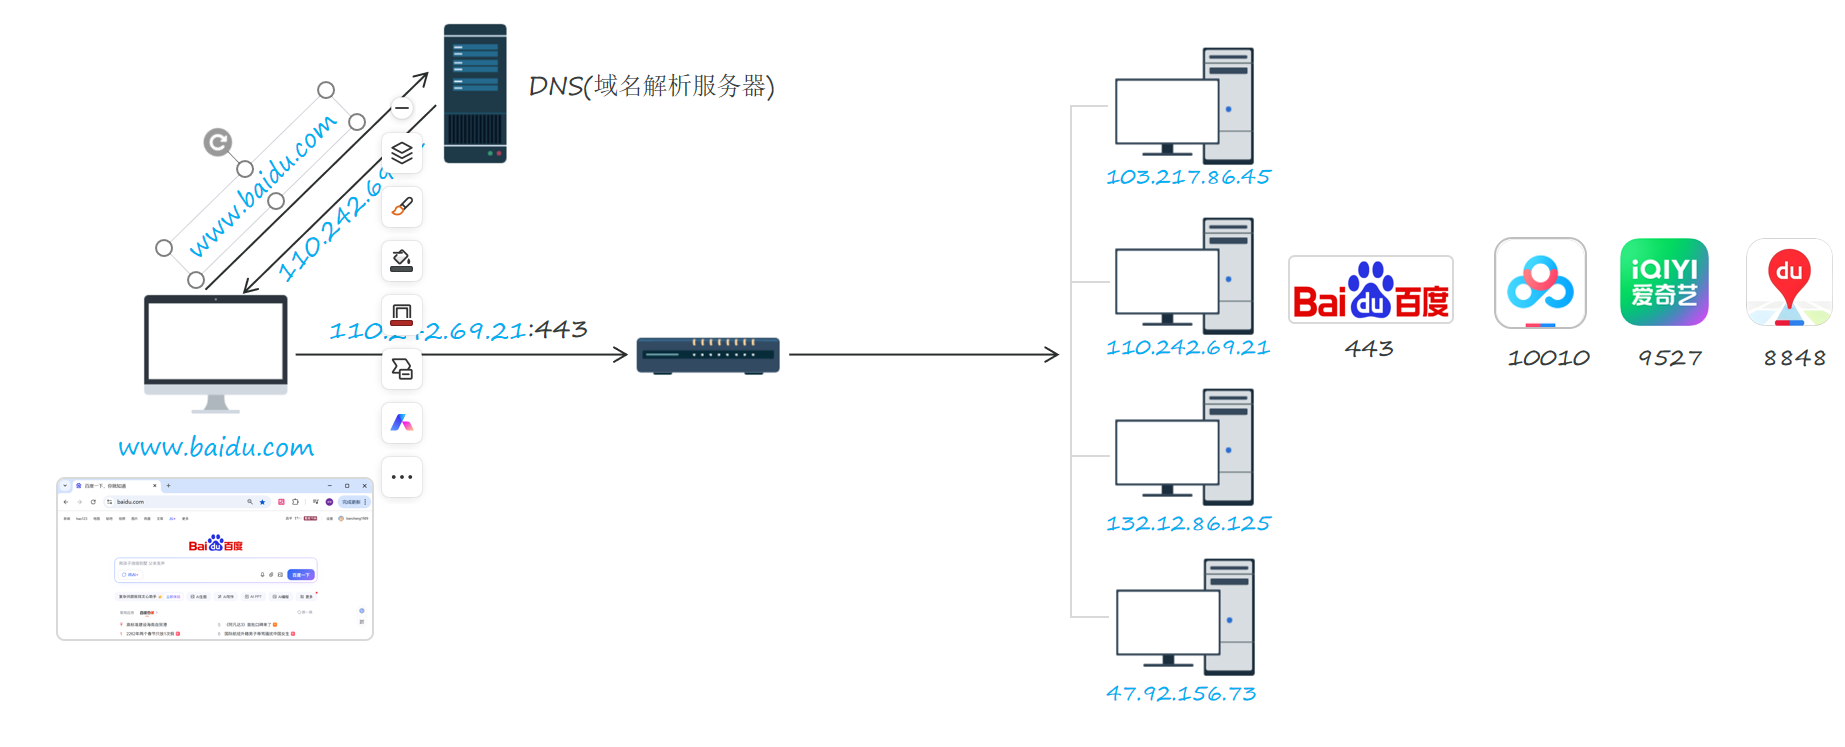
注意:HTTP协议默认端口号为 80,HTTPS协议默认端口为 443 。
- 网络模型
互联网(Internet)连接了数以亿计的设备,网络四通八达就如同时城市的复杂的道路。网络中传输的数据就像是城市道路中的车流,如果不加以管理那必然会出现混乱。在国际ISO组织就统一了程序在网络中通信的模型和标准。包括:
OSI网络模型:全球网络互连标准模型
TCP/IP网络模型:可以认为是OSI的简化版
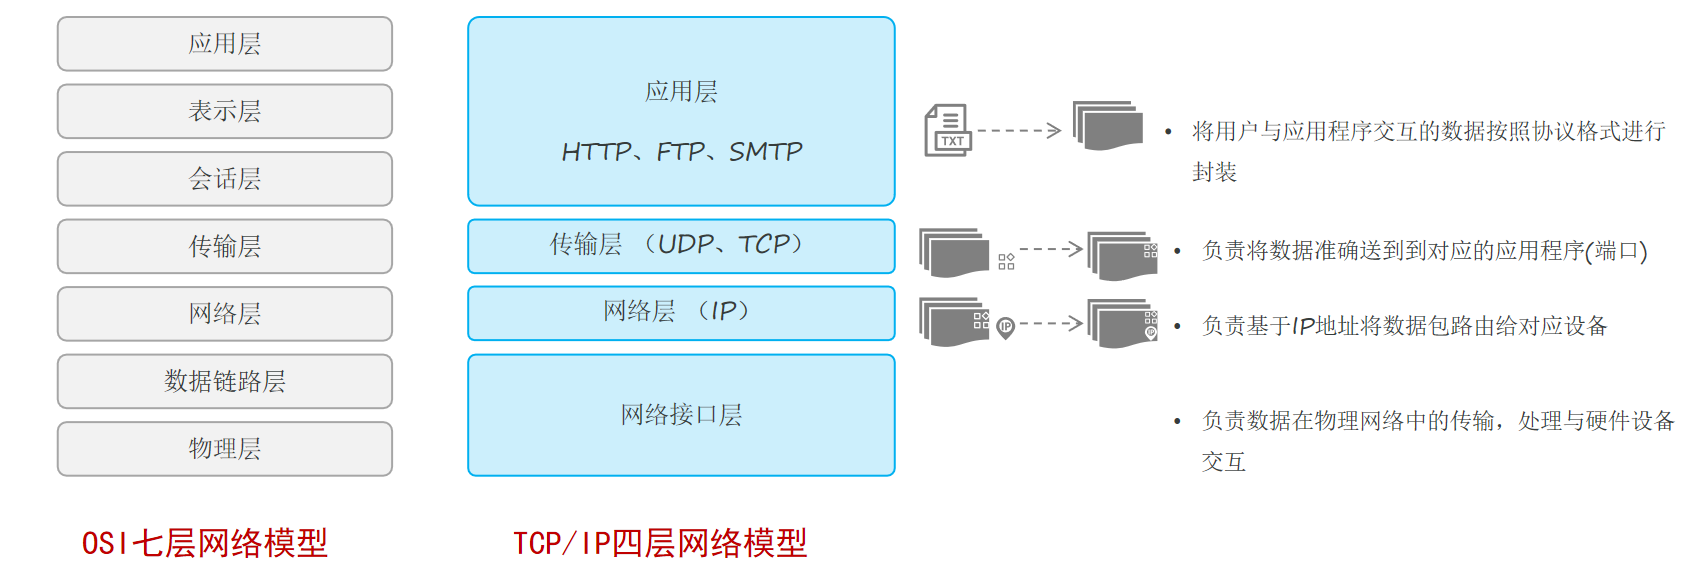
tcp四层模型:名字来自两大基石协议 TCP + IP
- HTTP协议
概念:Hyper Text Transfer Protocol,超文本传输协议,规定了客户端和服务器之间数据传输的规则。(只有在请求及响应中都遵循了统一的规则,服务端才能读懂客户端发送来的请求,客户端才能解析服务端响应的结果)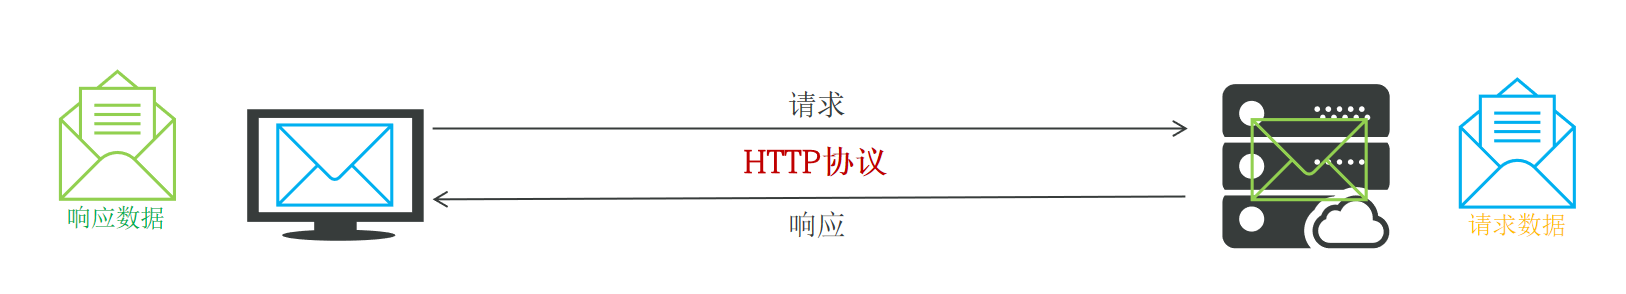
特点:
- 基于文本的协议:请求和响应的部分的协议内容为文本格式,底层通过TCP协议传输,稳定性强。
- 基于请求-响应模型:一次请求对应一次响应,必须由客户端先发起请求,服务端才会返回响应。
- 无状态:服务端不会记忆与客户端的历史交互信息,每次请求-响应都是独立的。
- HTTP协议-请求数据格式
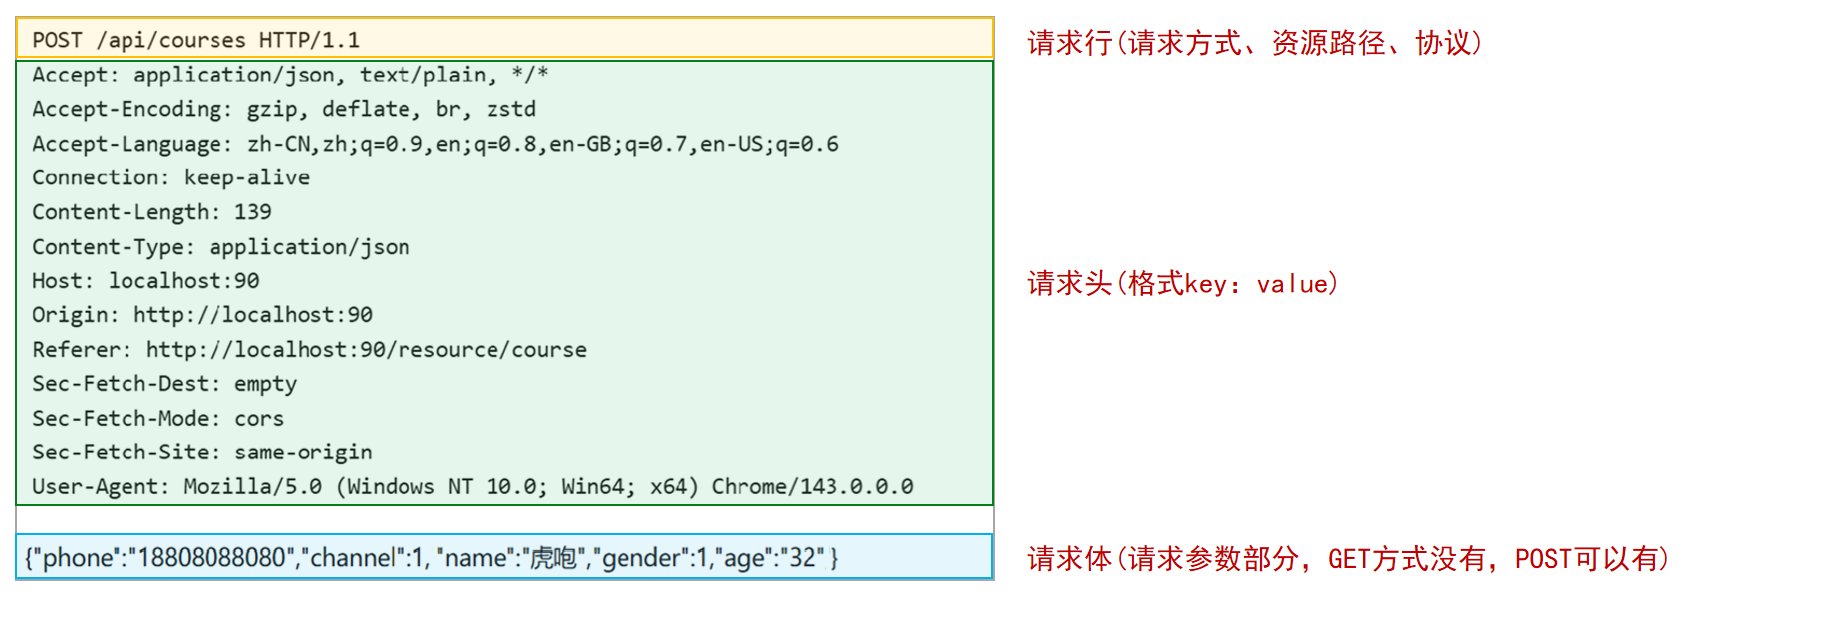
请求方式:
- GET: 请求参数在请求行中,没有请求体。如:/api/courses?name=Python&status=1 。GET请求请求参数大小在浏览器中是有限制的。
- POST: 请求参数在请求体中,POST请求大小是没有限制的。
- HTTP协议-响应数据格式
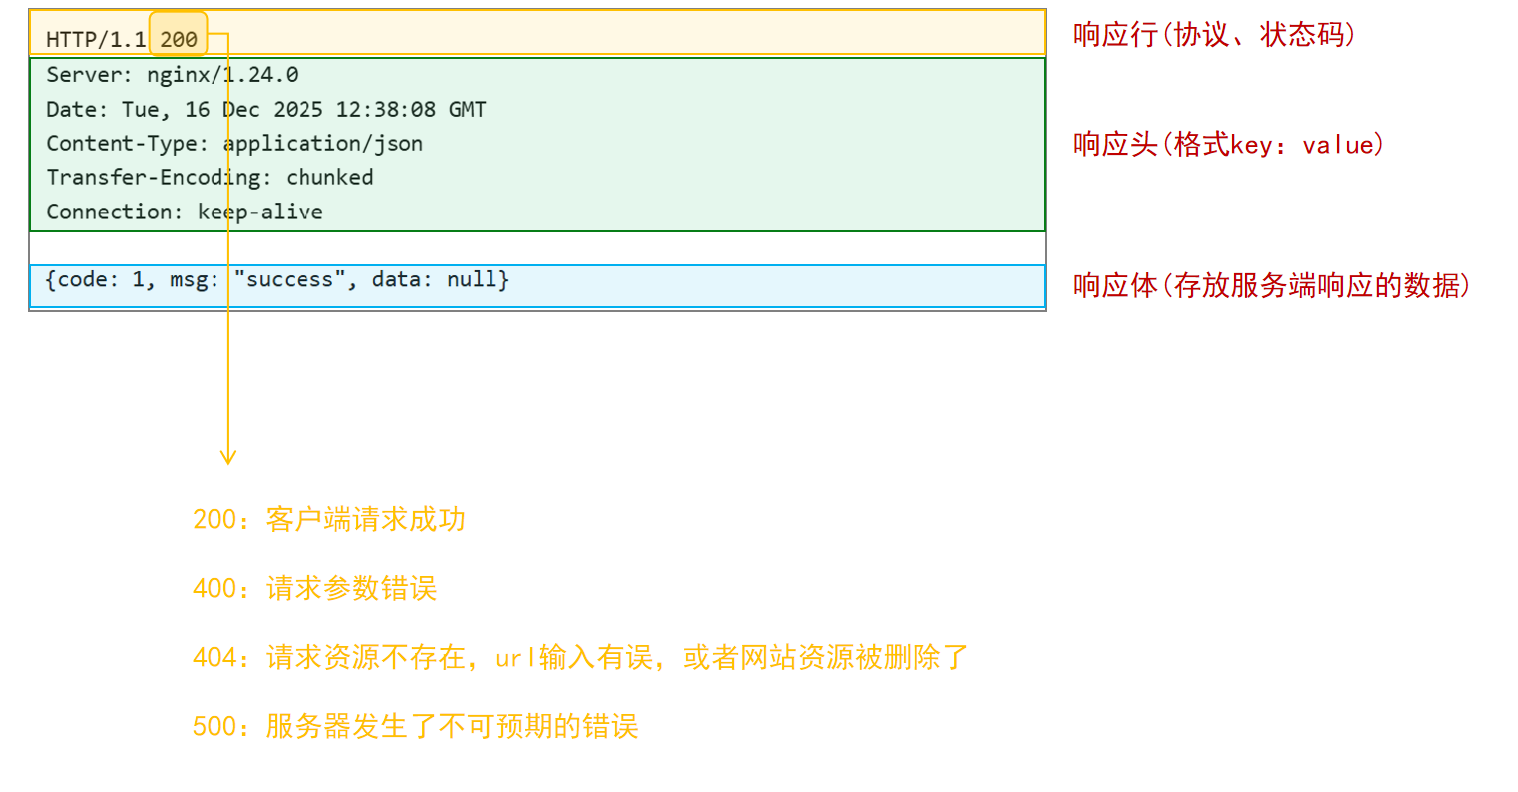
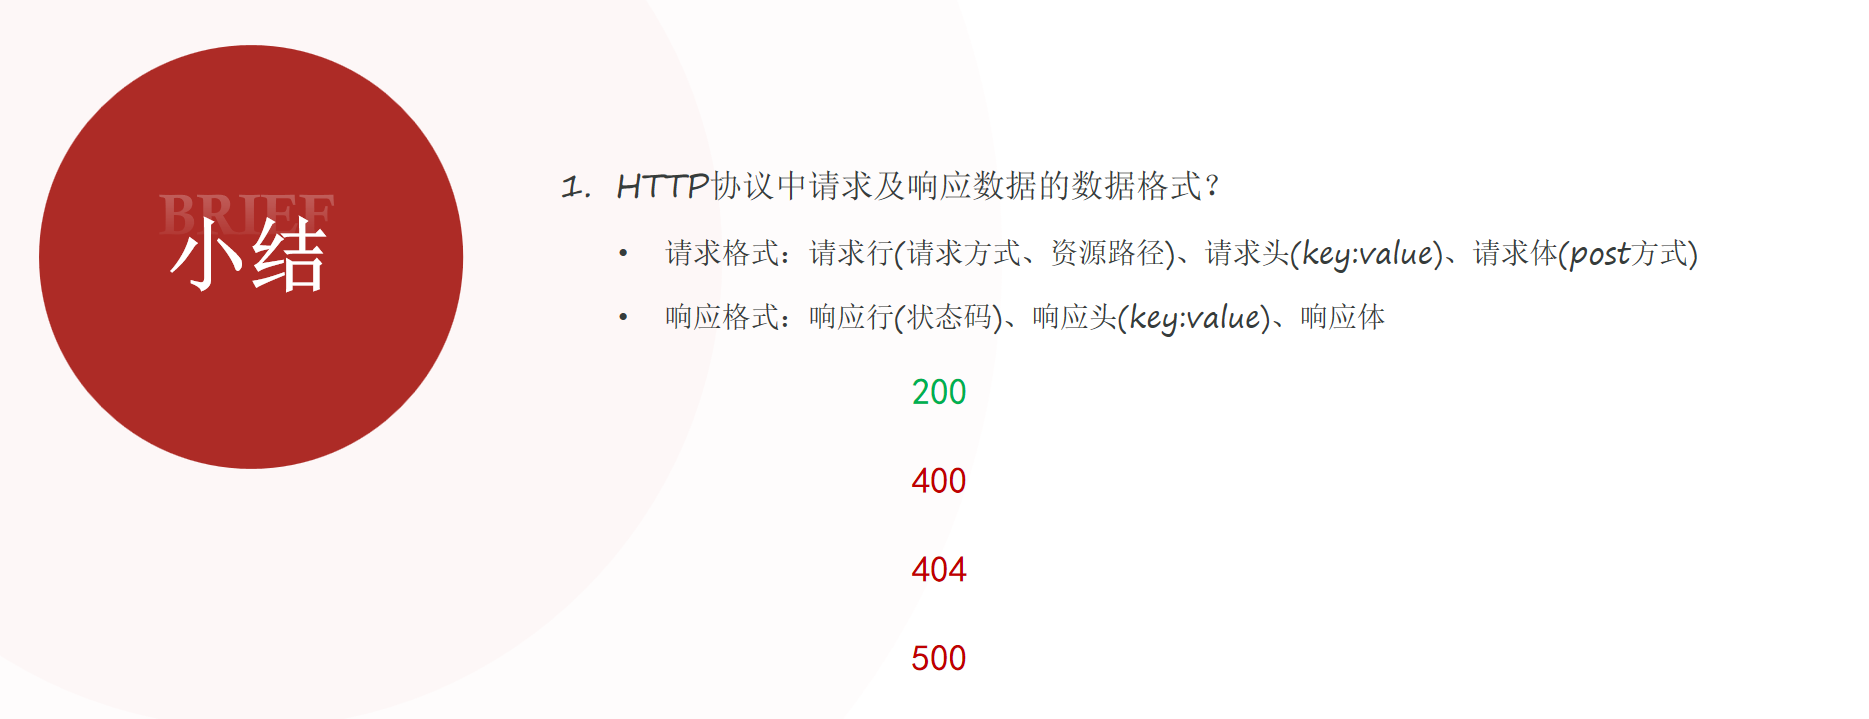
Apifox测试
Apifox是一款API设计、开发、测试的一体化协作平台,是项目开发中进行API接口测试的神器。
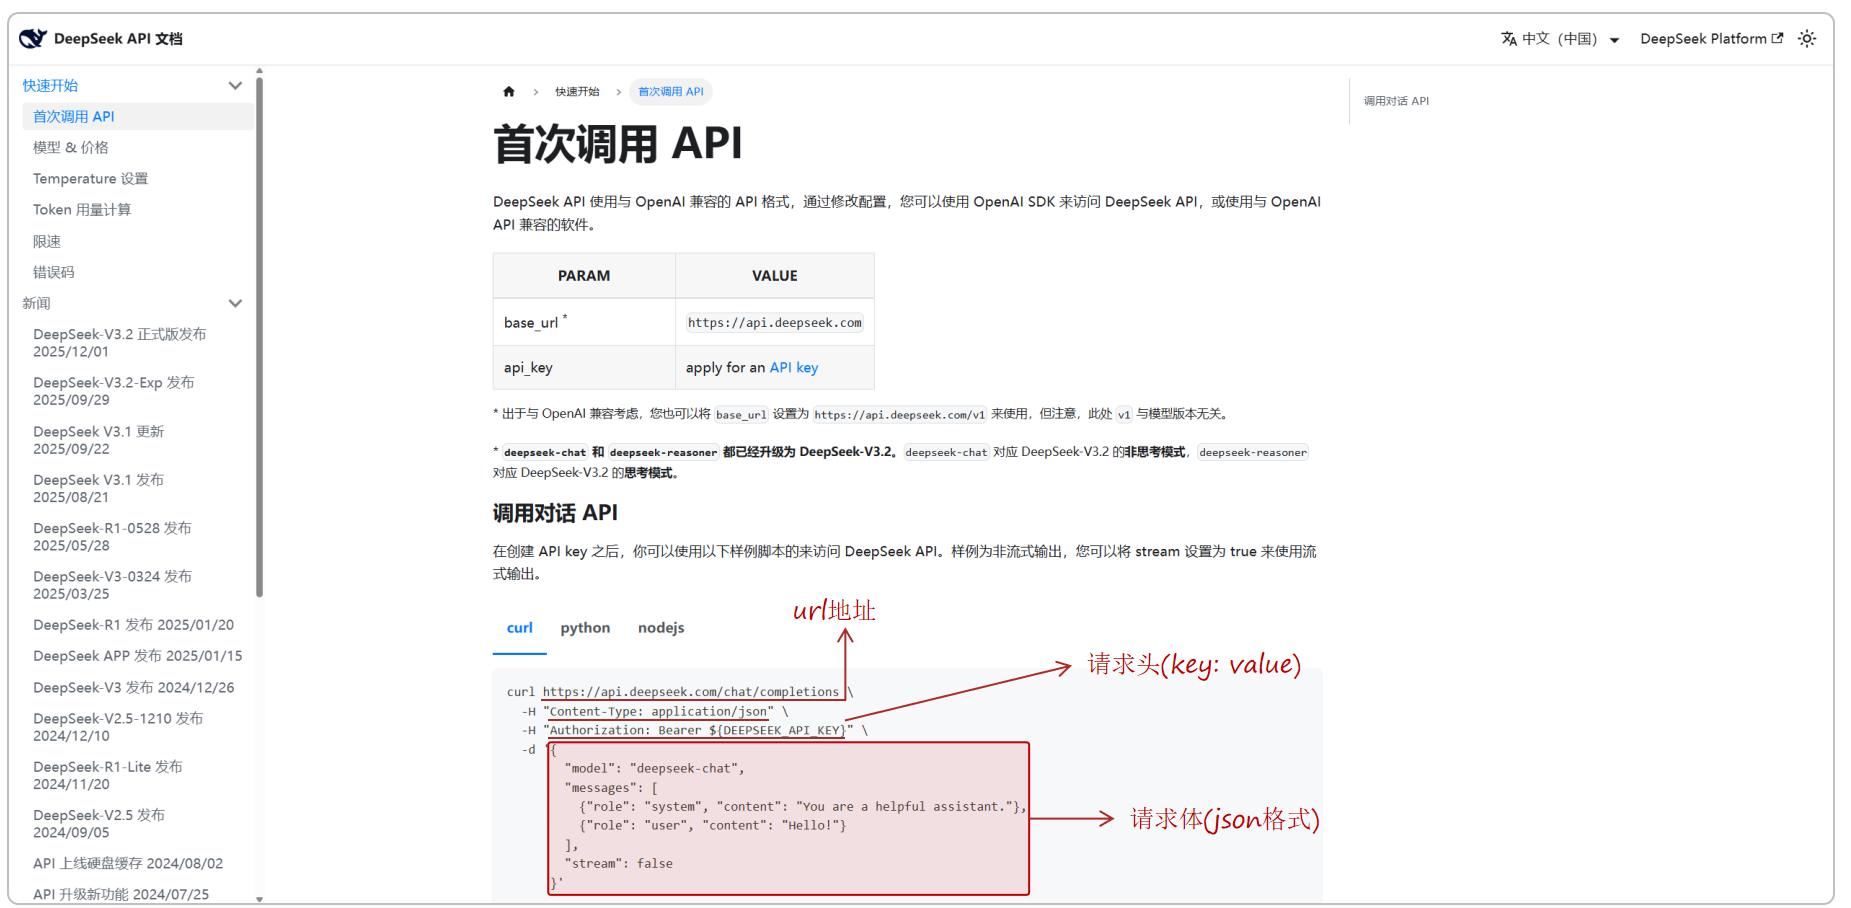
查看API文档,快速开始,
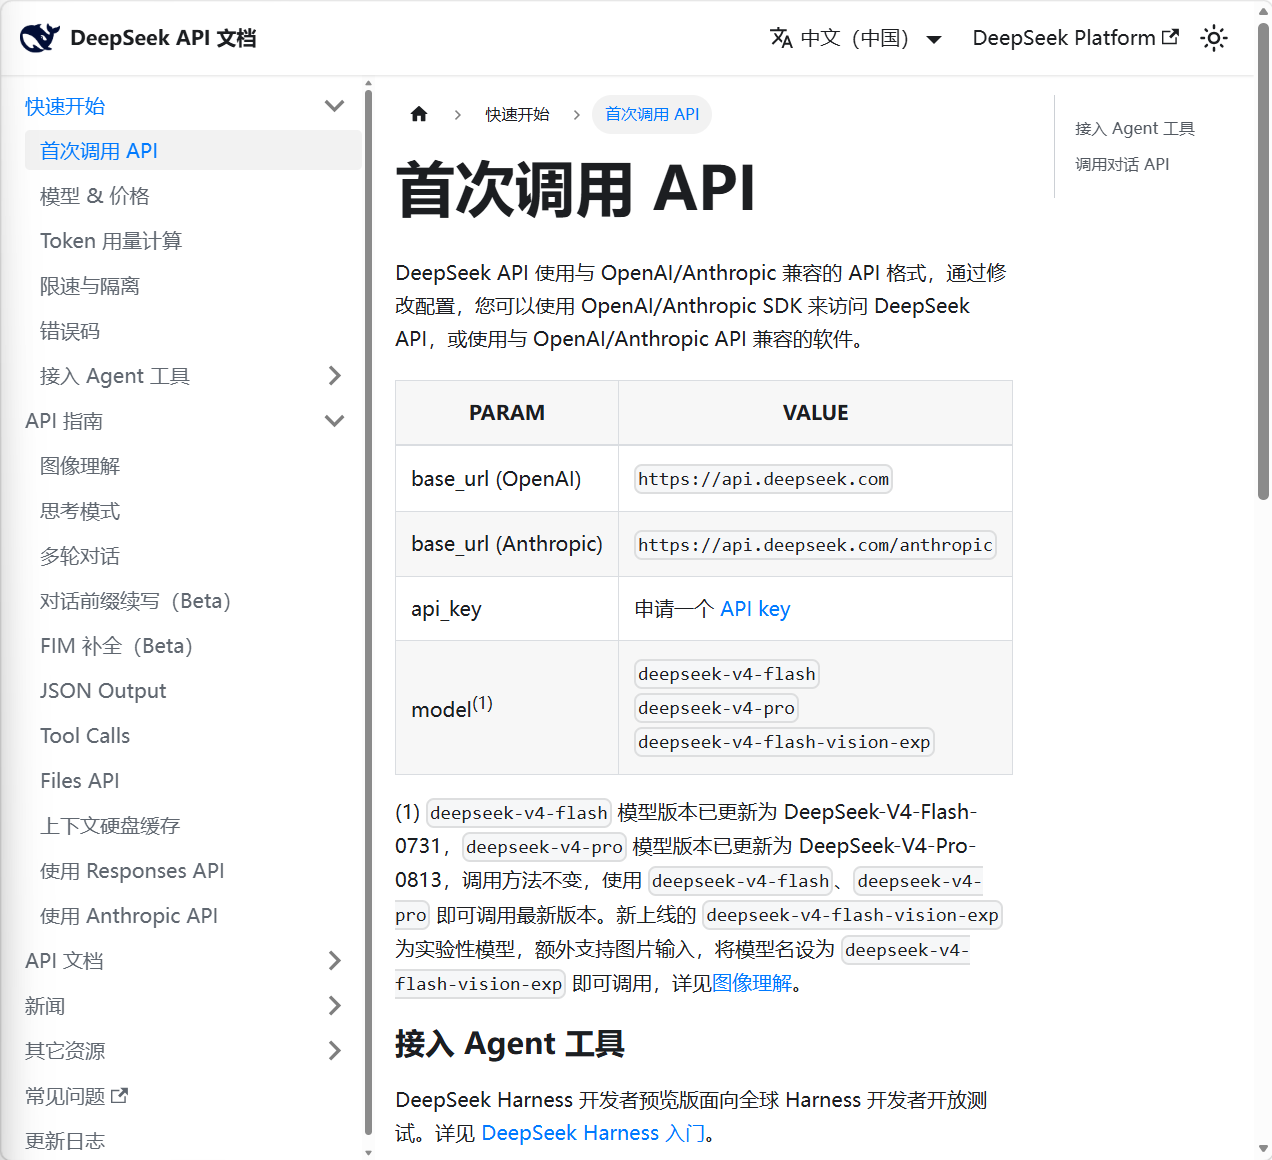
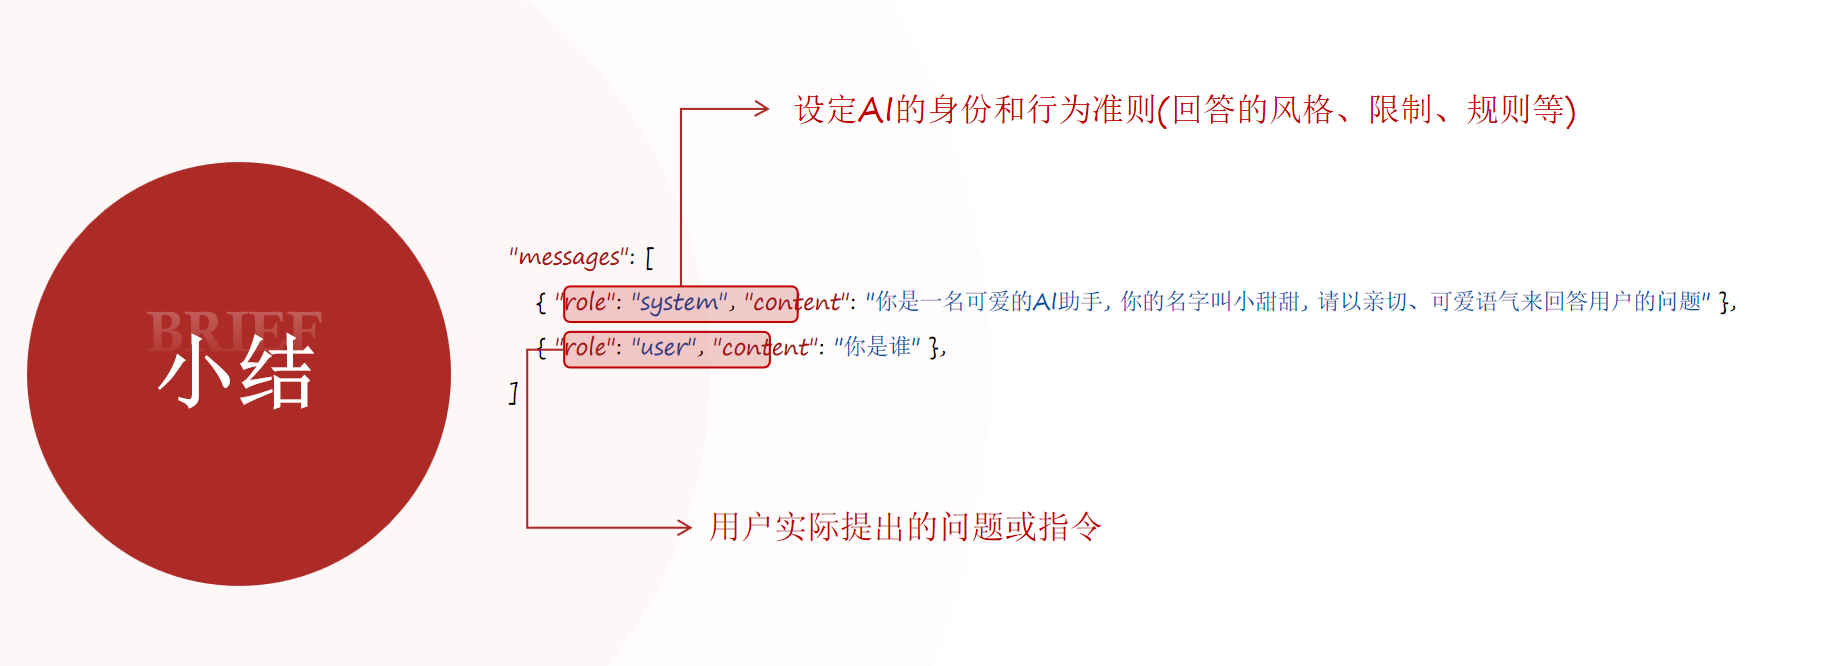
- Json格式
JSON(JavaScript Object Notation)是前端的一种对象表示方法。表示形式类似于Python中的字典,都是key:value这种形式,不过所有的key都必须使用双引号引起来 ,值可以是任何类型: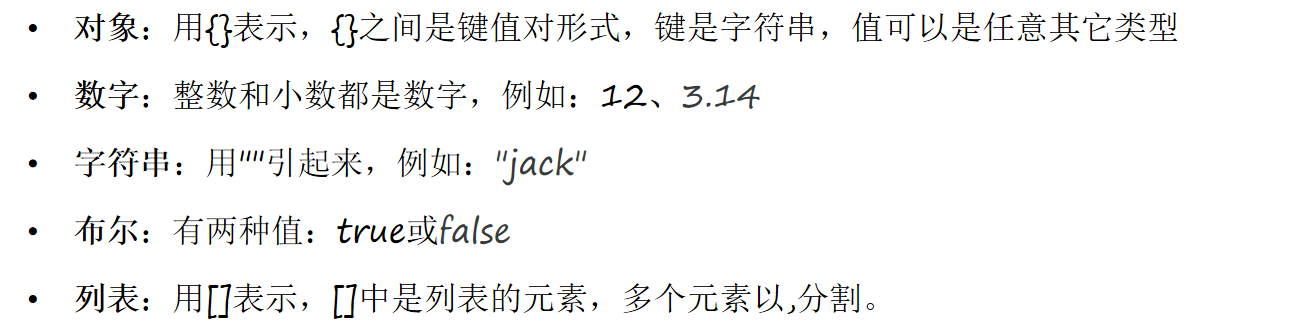
{
   "model": "deepseek-chat",
   "messages": [
         {"role": "system", "content": "You are a helpful assistant."},
         {"role": "user", "content": "Hello!"}
   ],
   "stream": false
}
✋
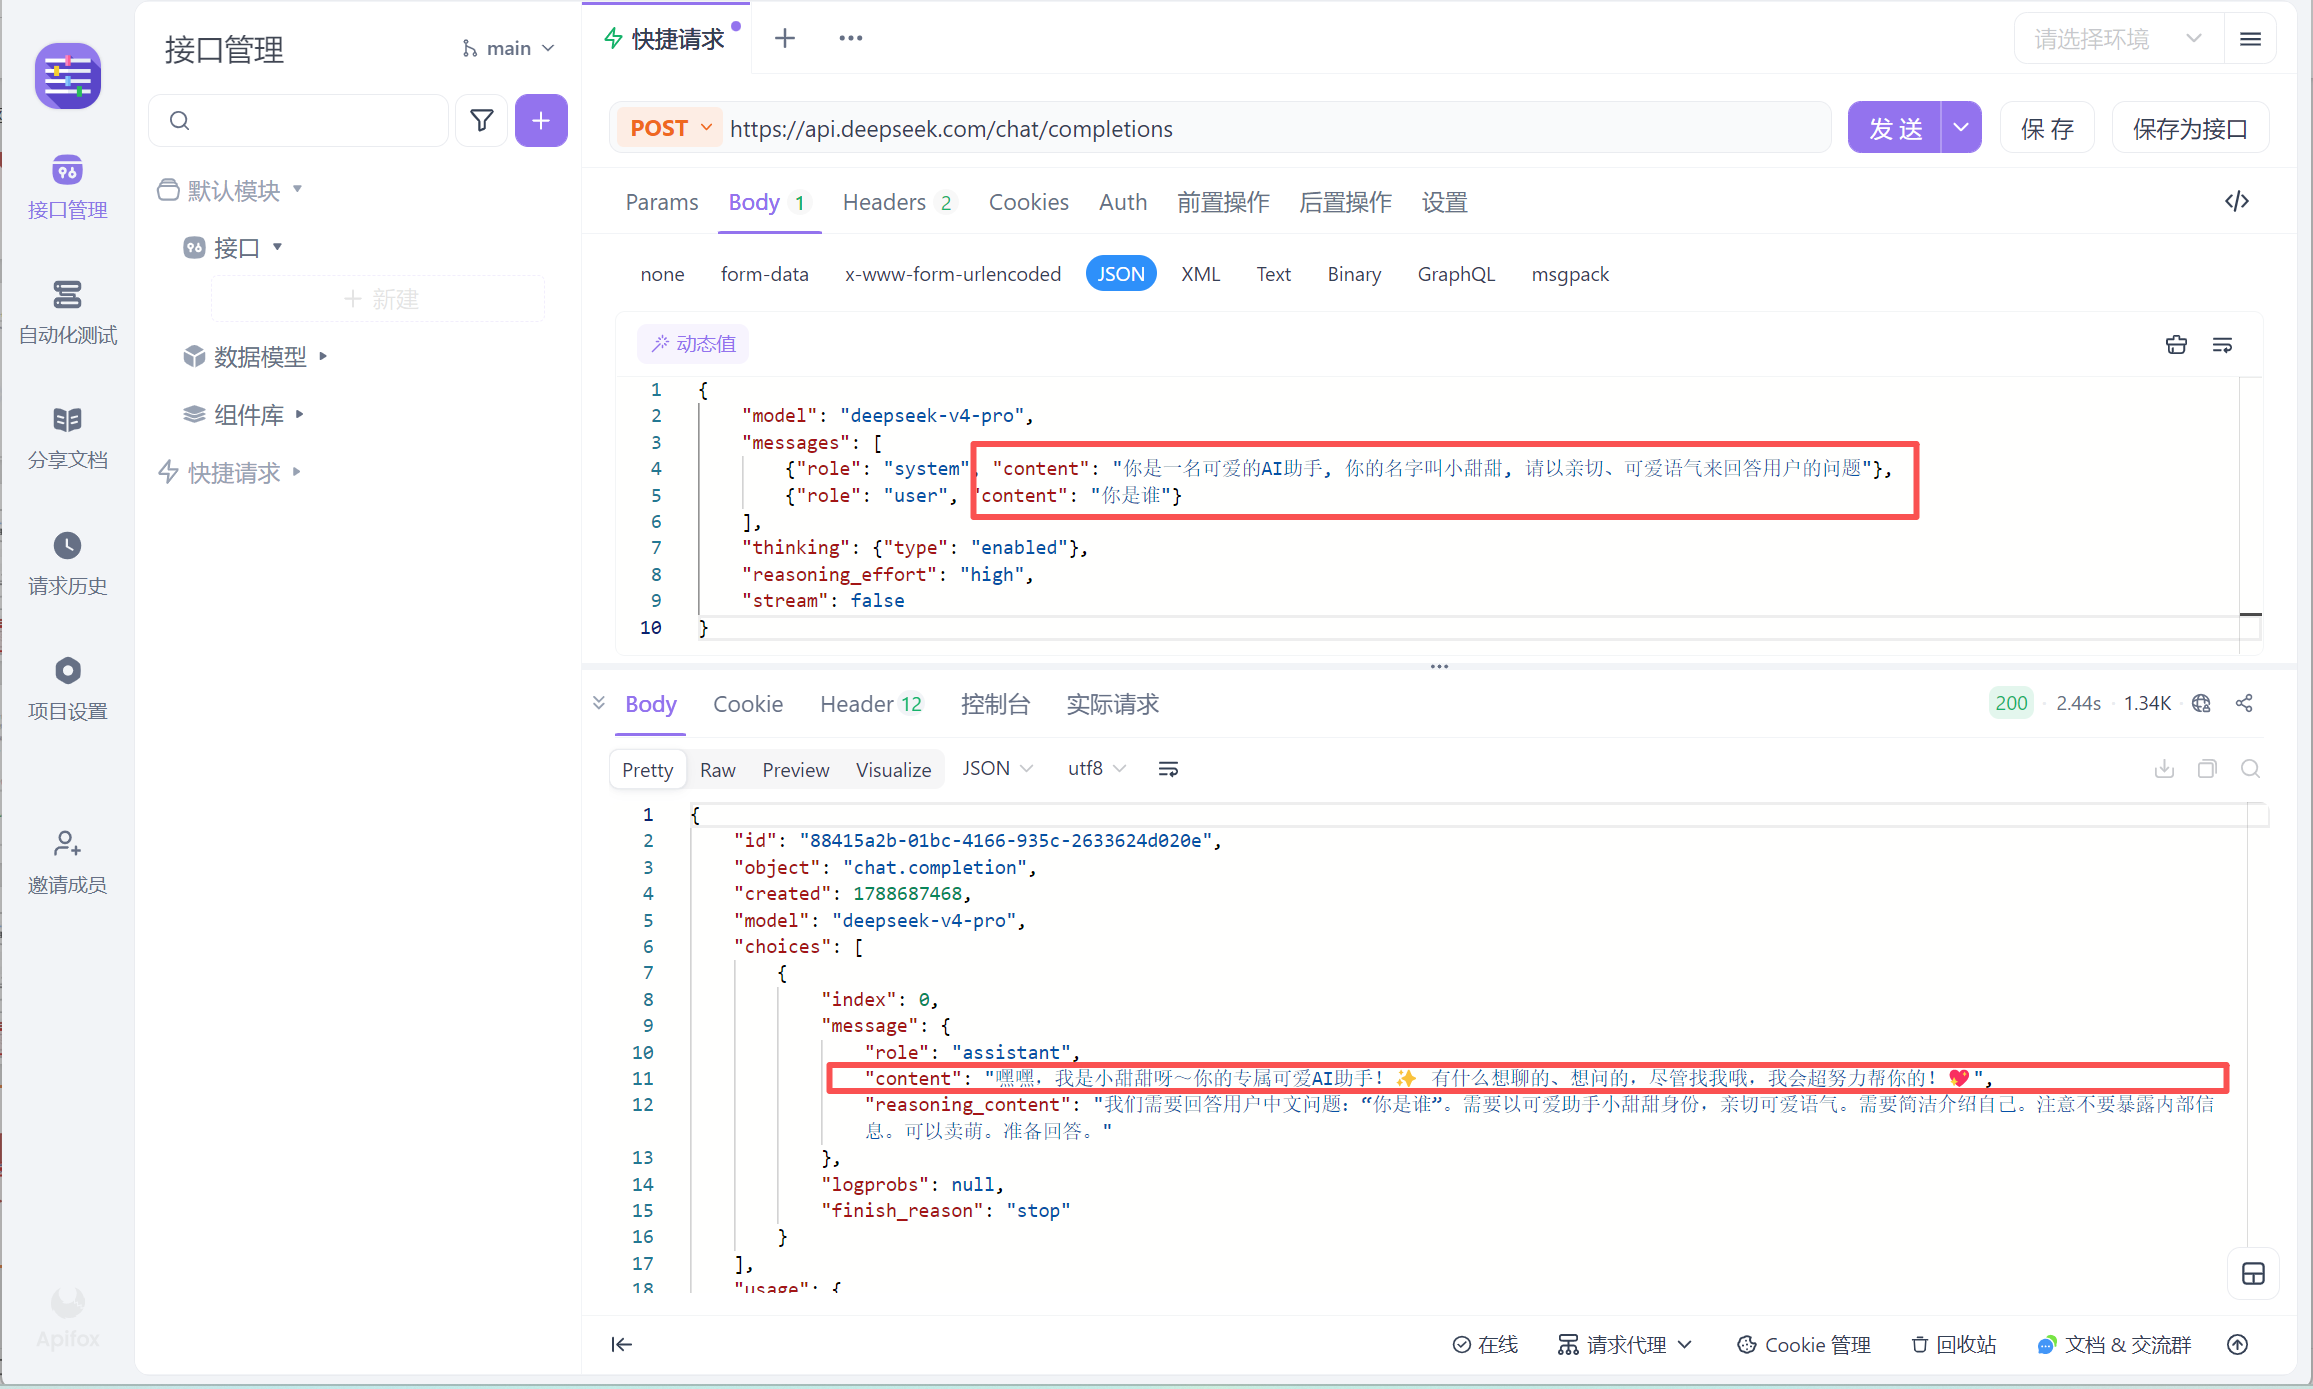
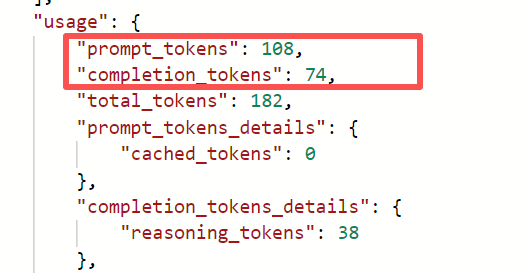
发送消息消耗了108个token,
生成消息消耗了74个token,
- 会话记忆-现状
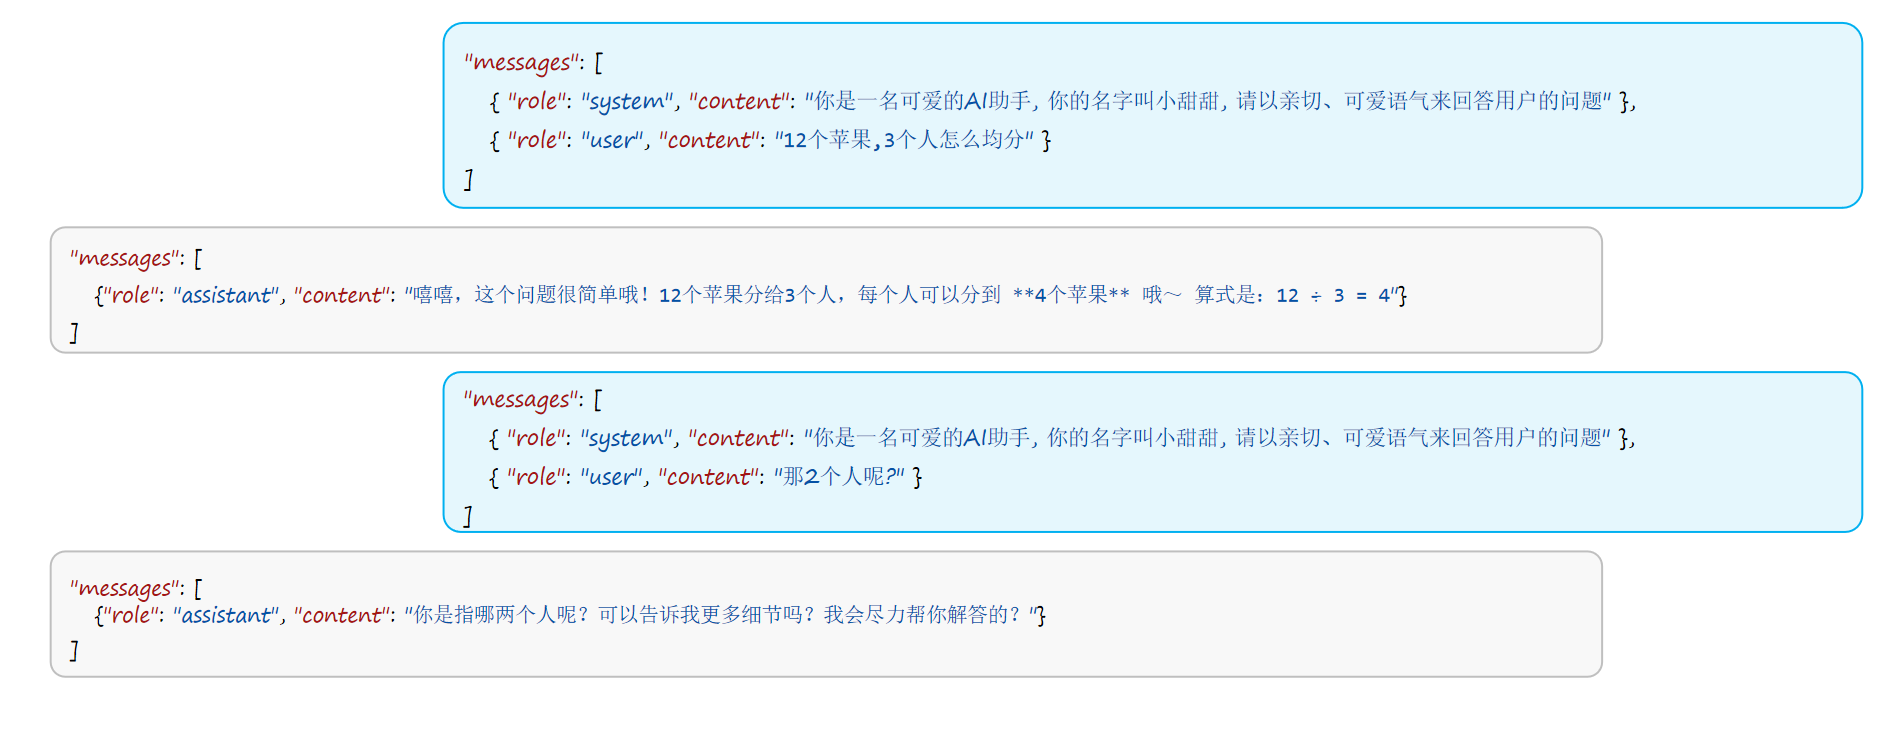
与AI大模型的交互本质是无状态的,每一次请求响应都是相互独立的。(AI大模型本身没有真正的会话记忆能力)
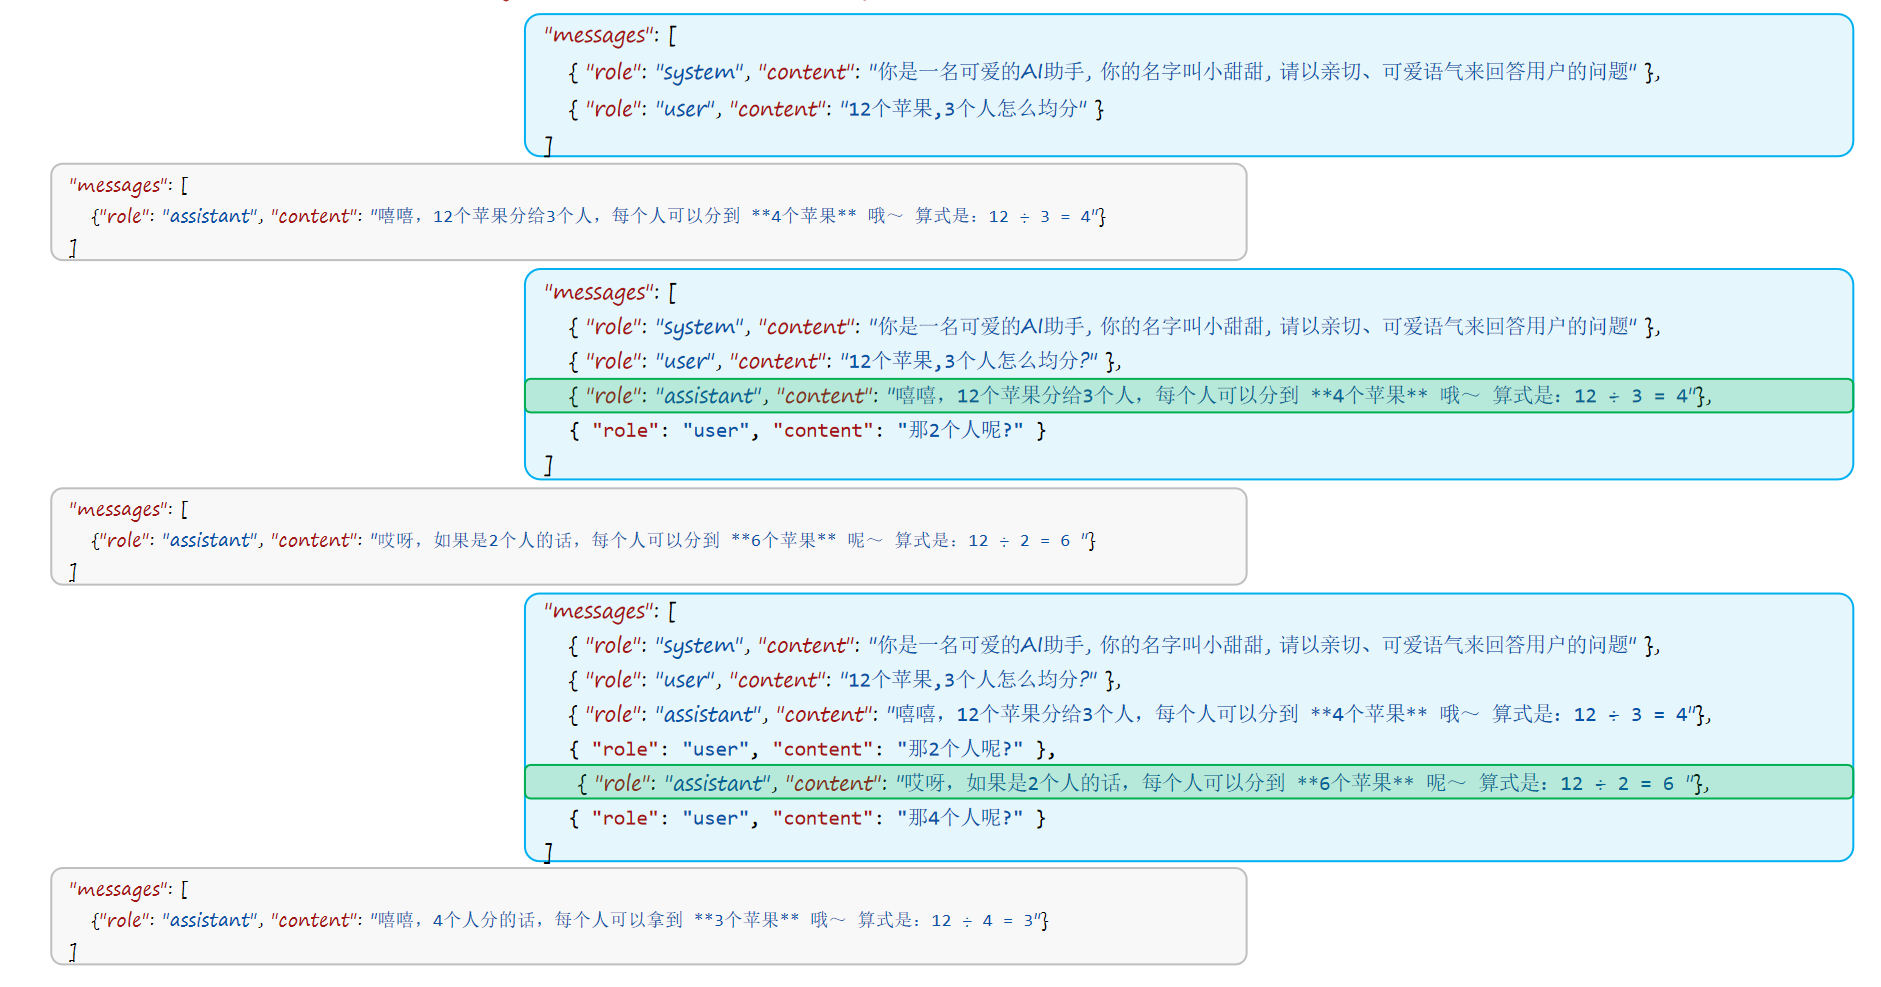
会话记忆-处理方案(会话历史滚雪球)
如何让AI记得之前的对话内容
- 会话记忆-处理方案(会话历史滚雪球)
✋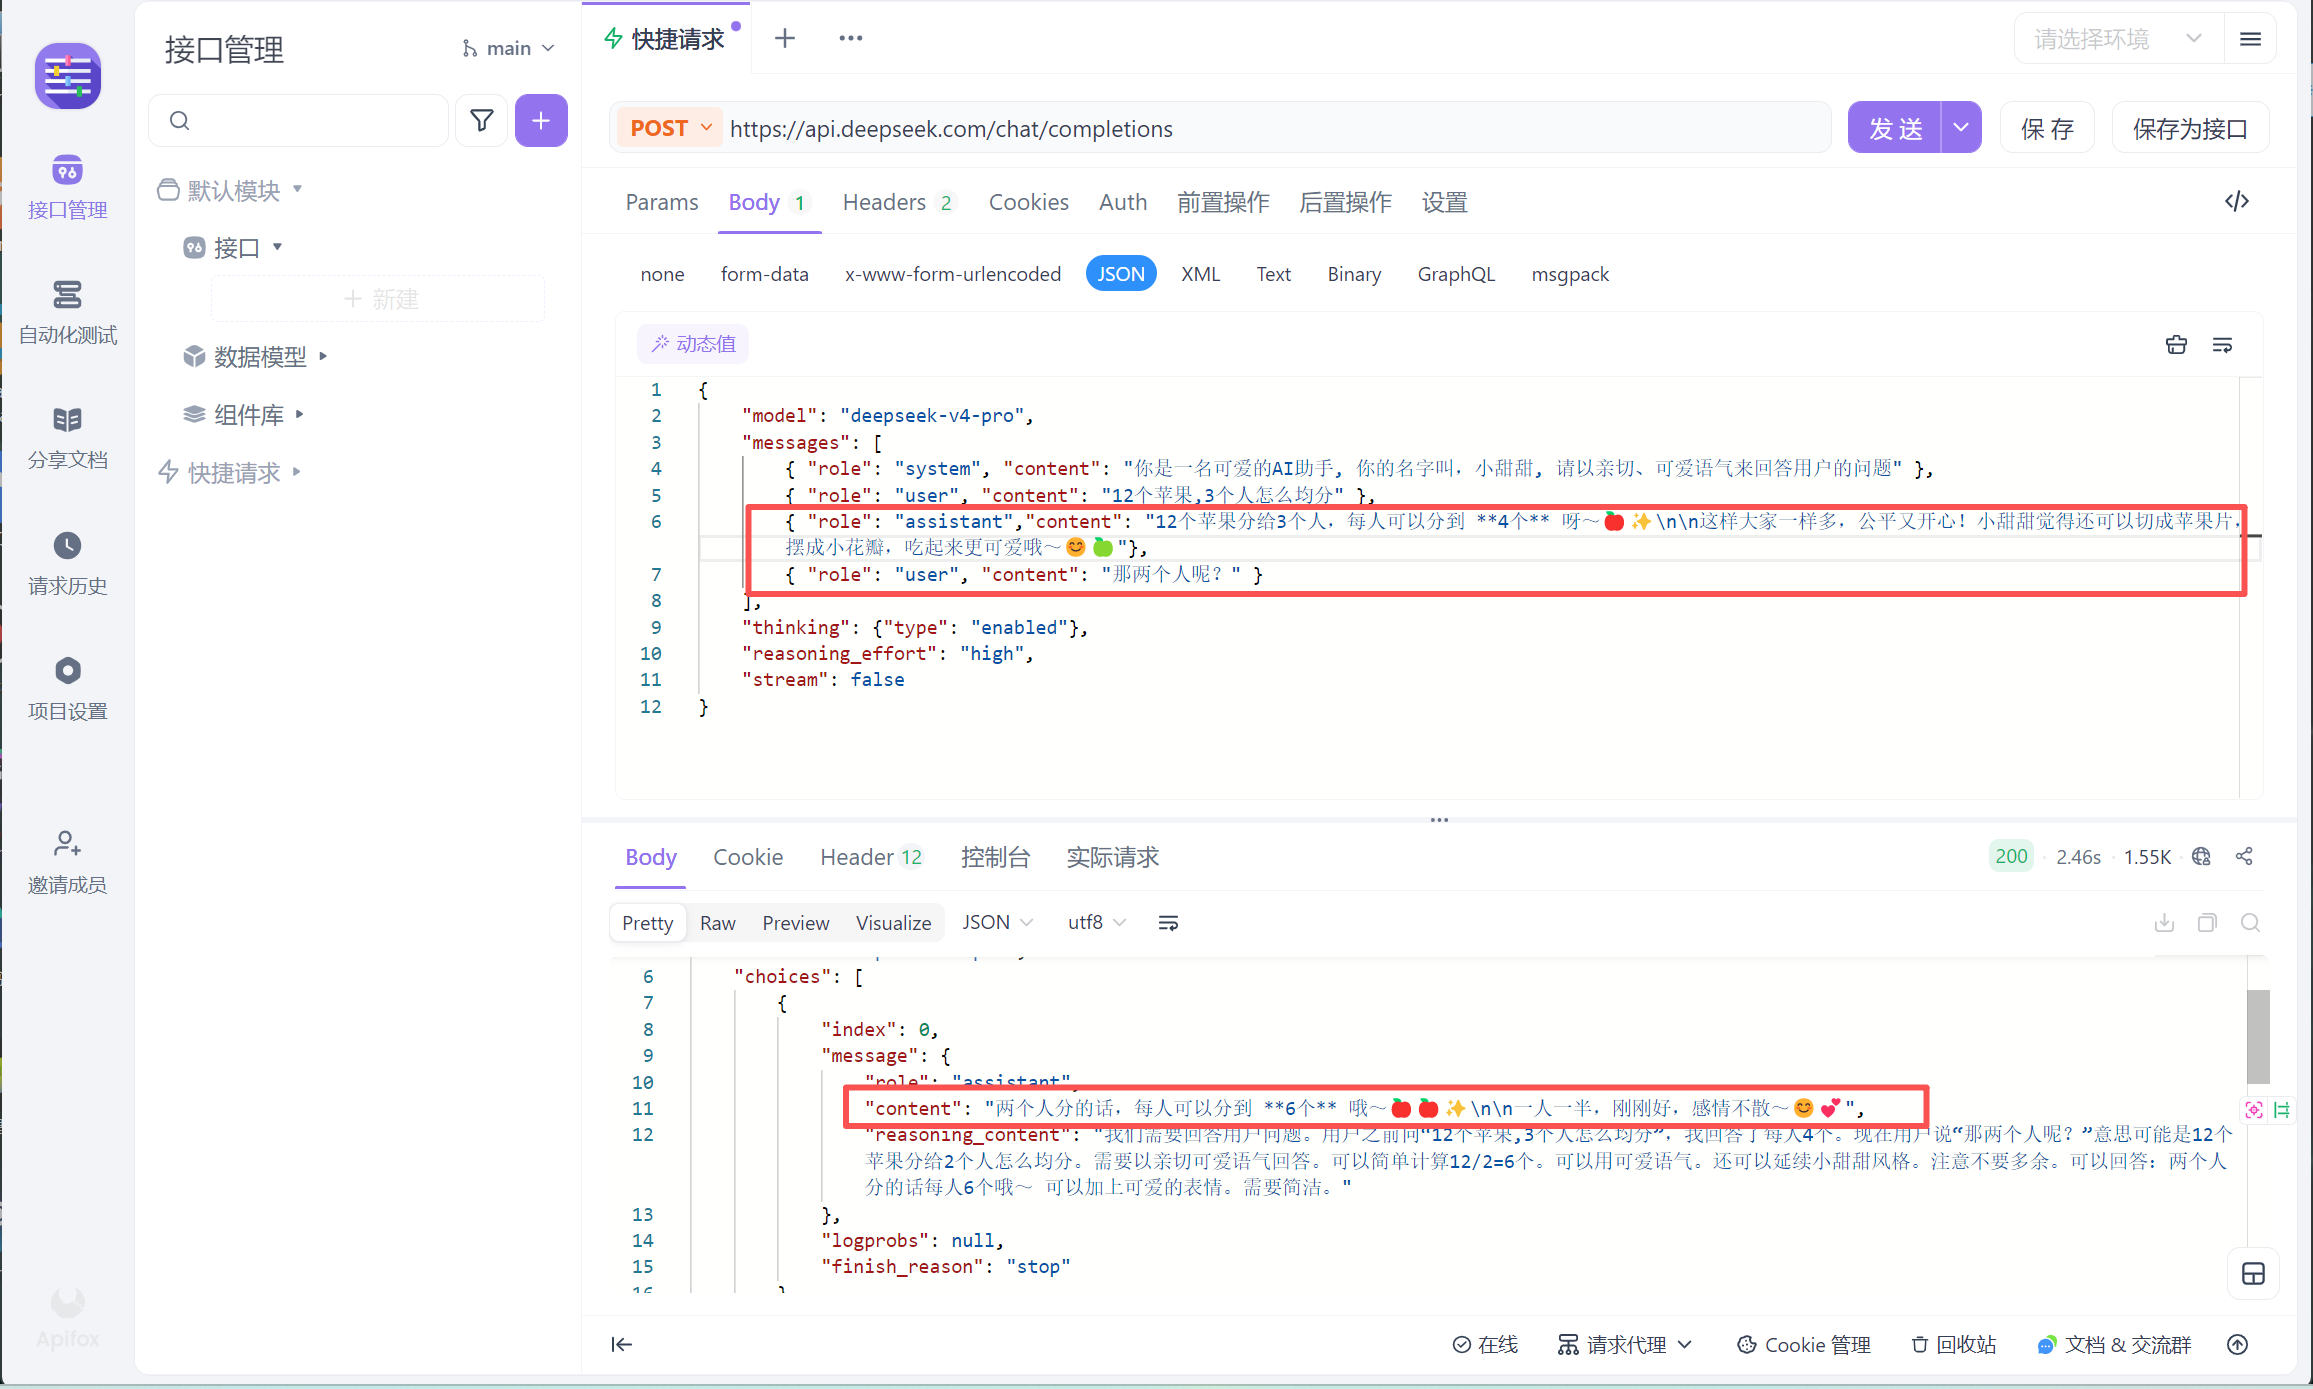
assistant是AI的回答,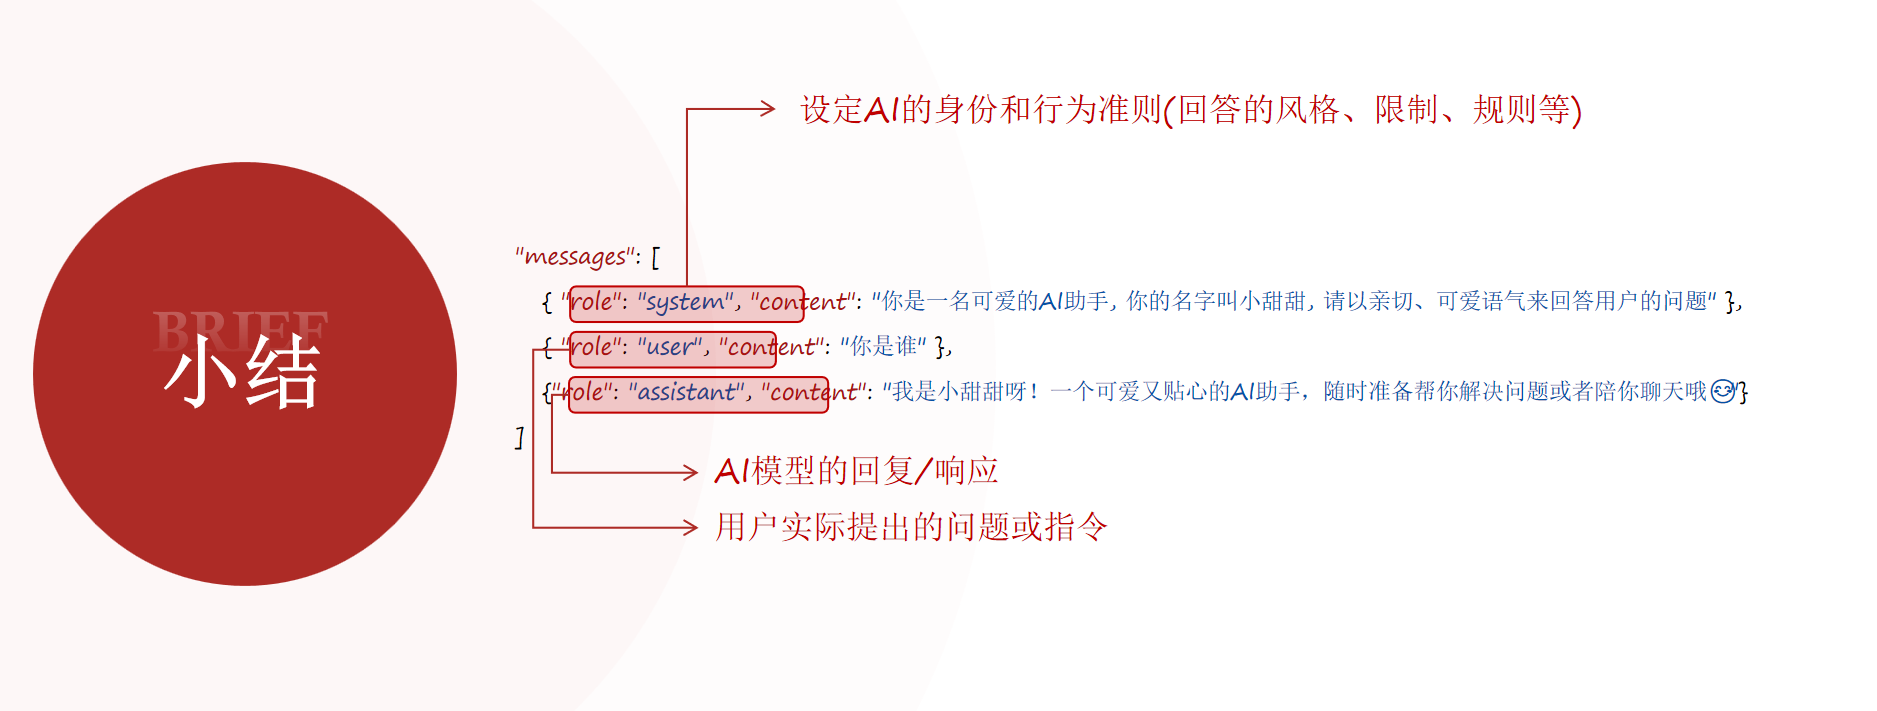
代码调用测试
调用DeepSeek
- DeepSeek 云端 API 复用 OpenAI 的接口格式,原有 OpenAI 调用代码改密钥和接口地址即可使用,但部分
- DeepSeek 专属参数仅它自身识别,其他服务不支持。
说人话:
就是 DeepSeek 抄了 OpenAI 的接口格式,老代码改下地址和密钥就能直接用,但 DeepSeek 自己独有的特殊参数,别的程序不认。
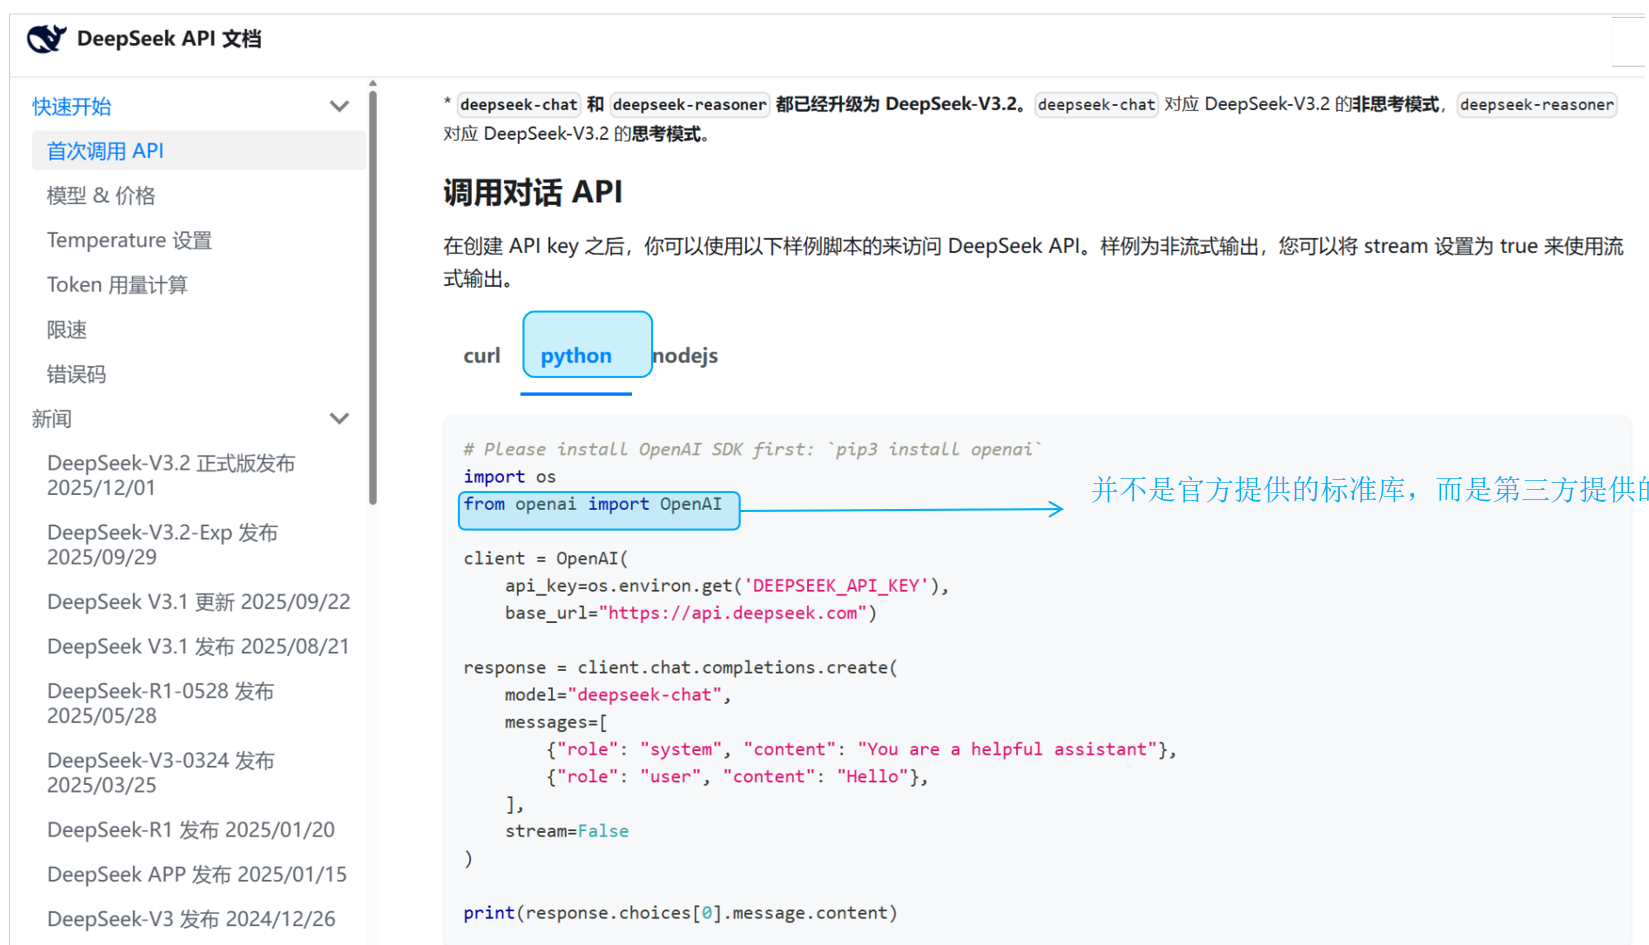
本地都下载了python,但是一些不常用的模块放到了远程仓库PyPI中,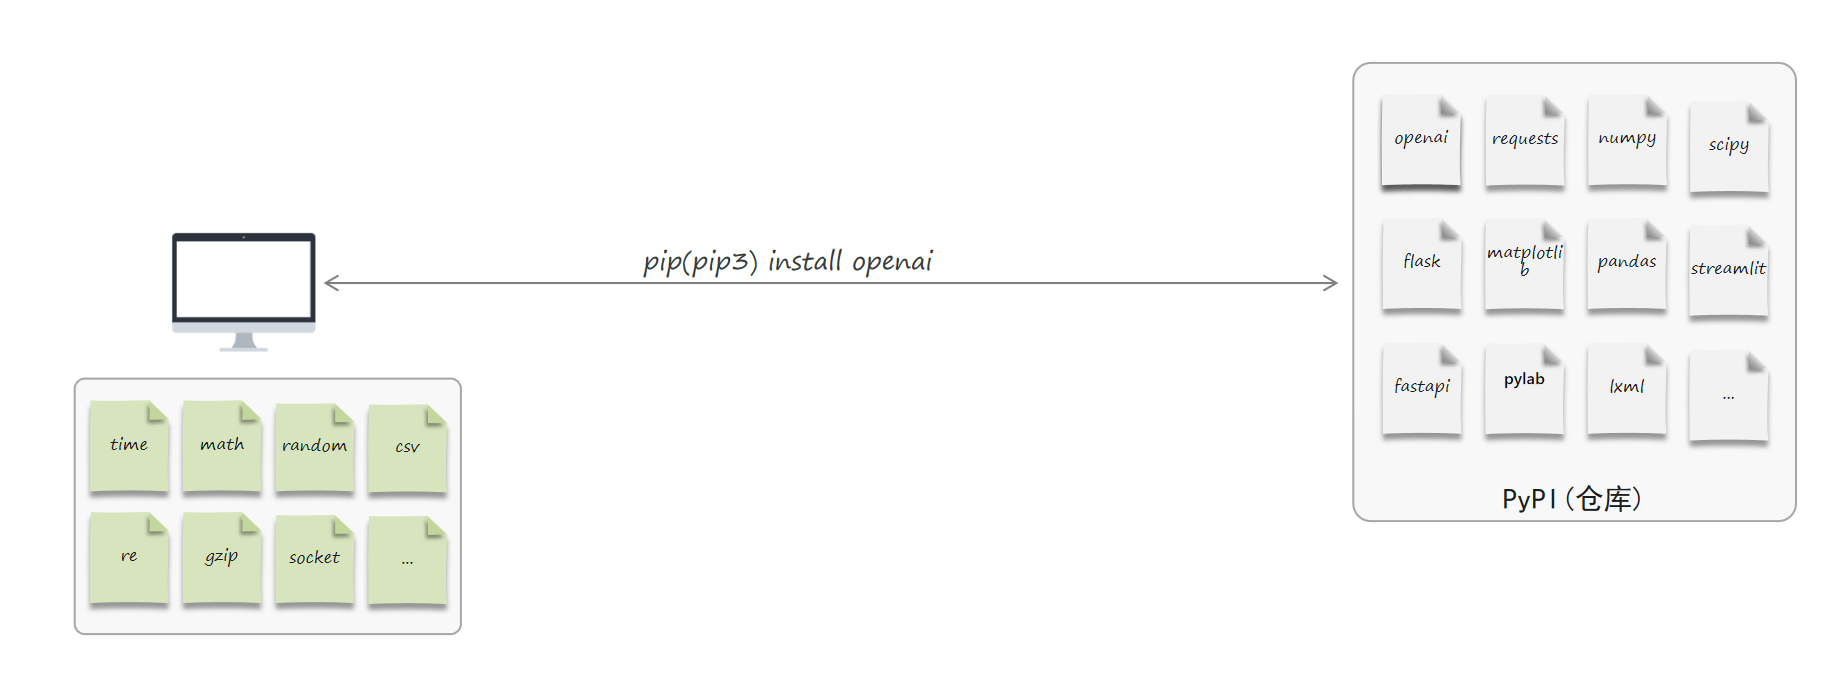
PyPI:全程为 Python Package Index,是由Python官方和社区共同维护的Python第三方软件包的官方仓库 。
pip:pip是Python官方提供的Python包的管理工具,提供了对Python包的查找、下载、安装、卸载等功能 。
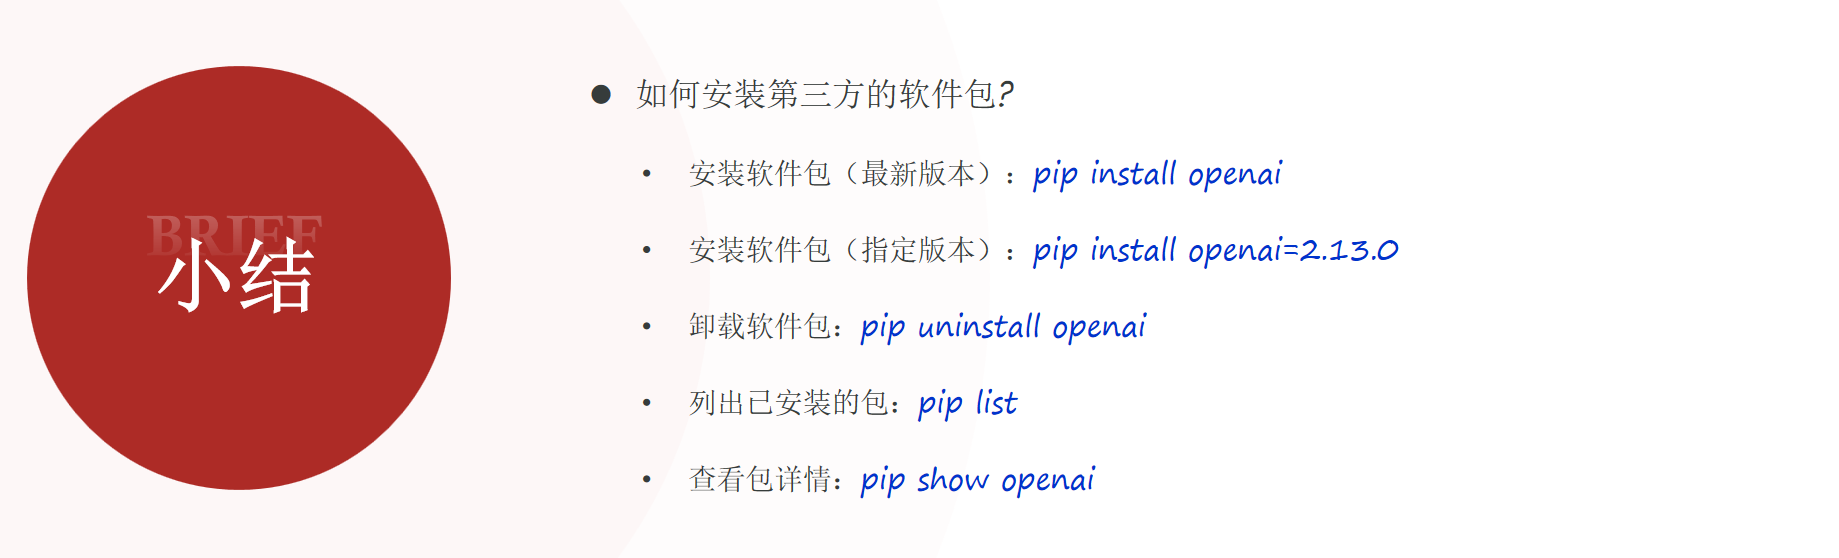
✋
复制一下:
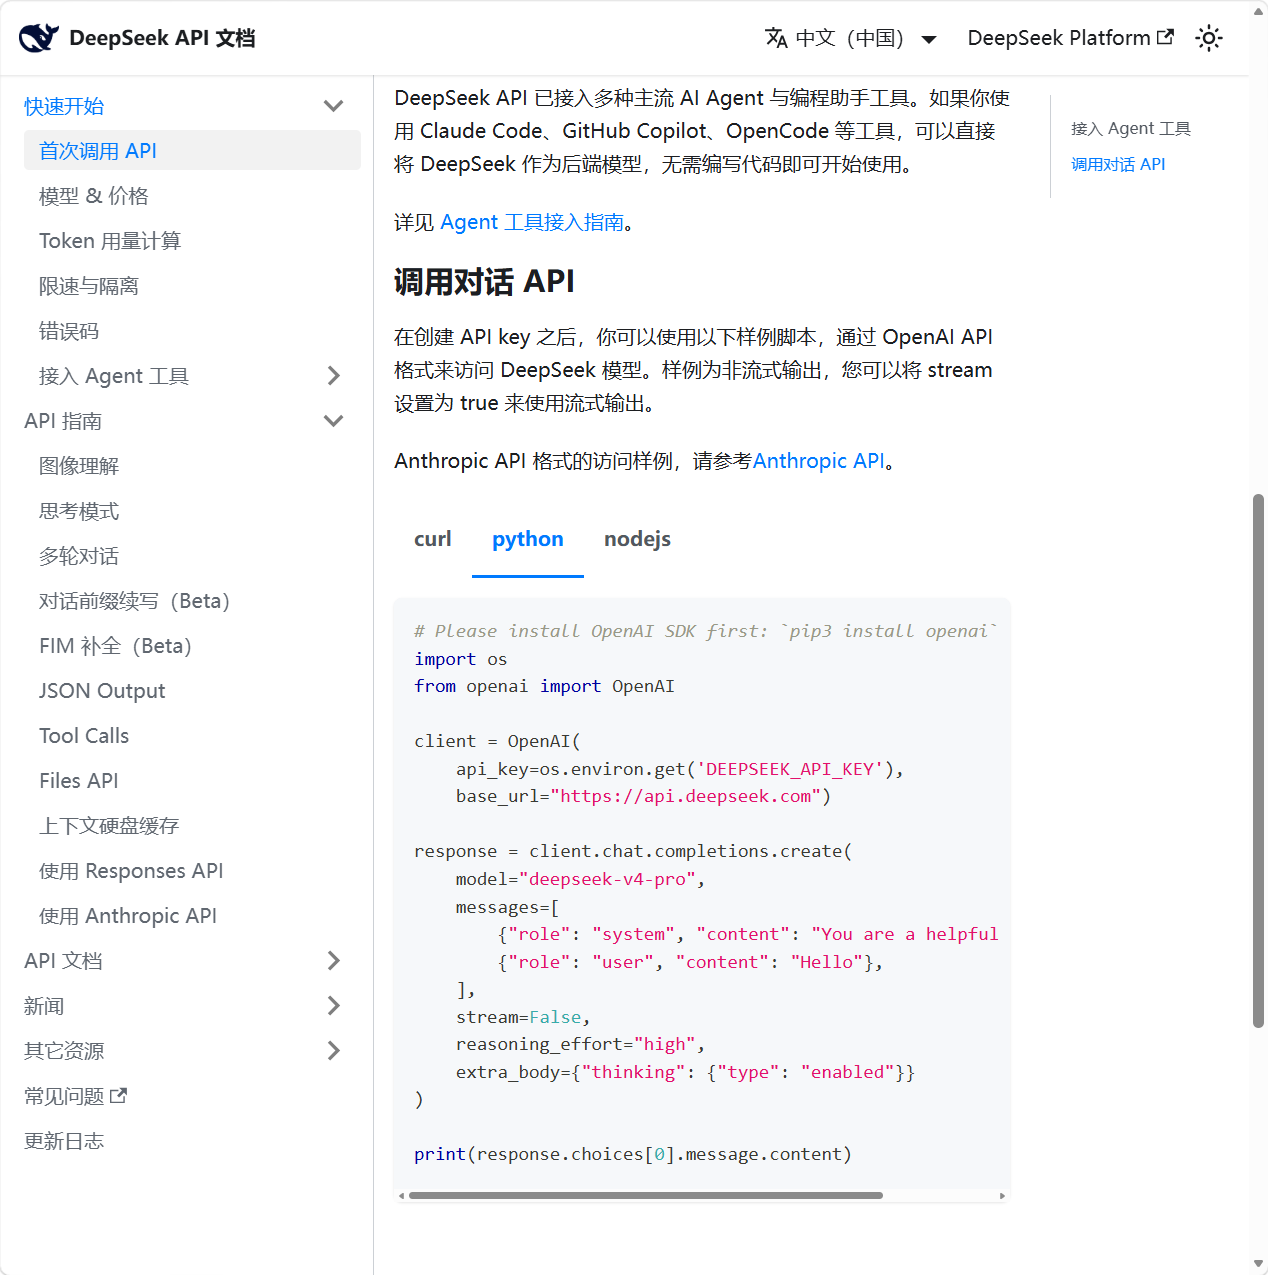
# Please install OpenAI SDK first: `pip3 install openai`
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ.get('DEEPSEEK_API_KEY'),
    base_url="https://api.deepseek.com")

response = client.chat.completions.create(
    model="deepseek-v4-pro",
    messages=[
        {"role": "system", "content": "You are a helpful assistant"},
        {"role": "user", "content": "Hello"},
    ],
    stream=False,
    reasoning_effort="high",
    extra_body={"thinking": {"type": "enabled"}}
)

print(response.choices[0].message.content)
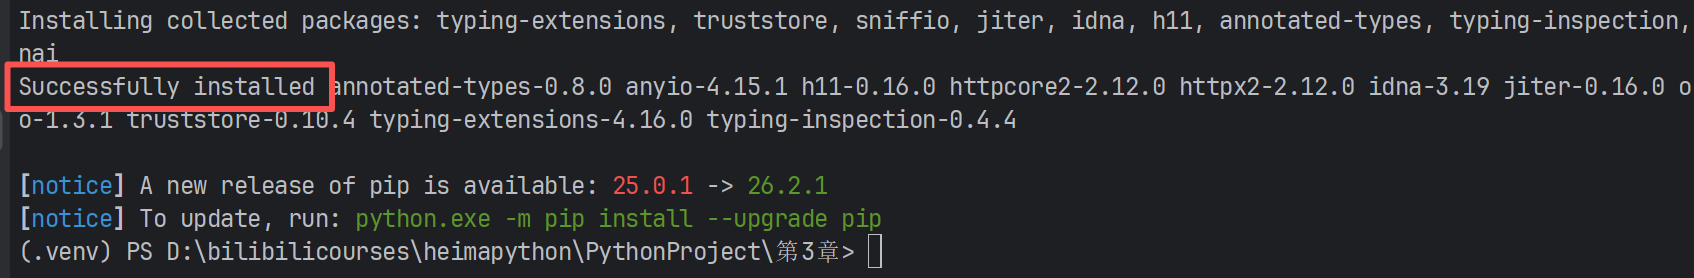
下载一下第三方提供的库,下载到这个项目的虚拟环境里,

把APIkey配置到环境变量中,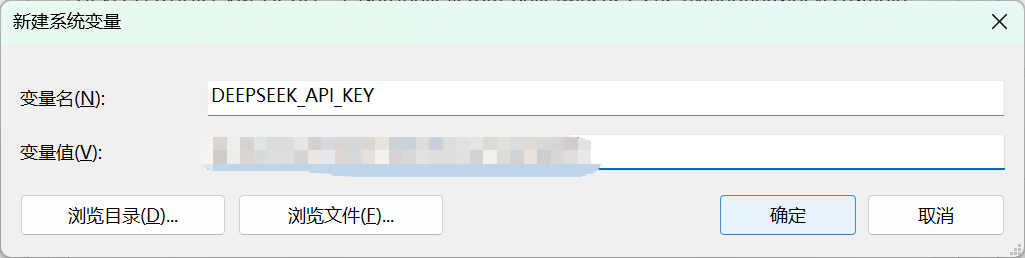
报错:401
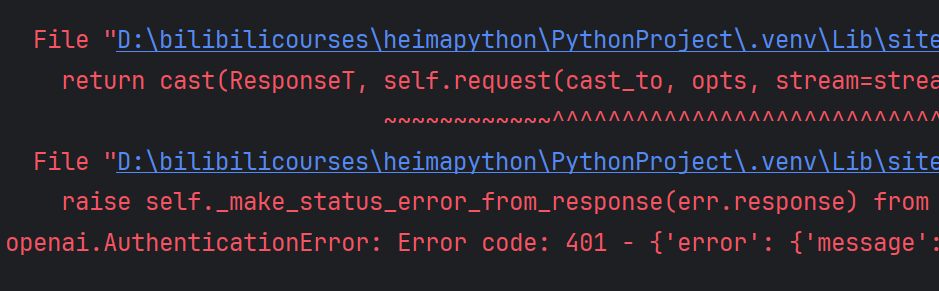
原因:身份未认证
解决:配置好环境变量之后,开发工具要重启一下,才能加载最新环境变量
结果:
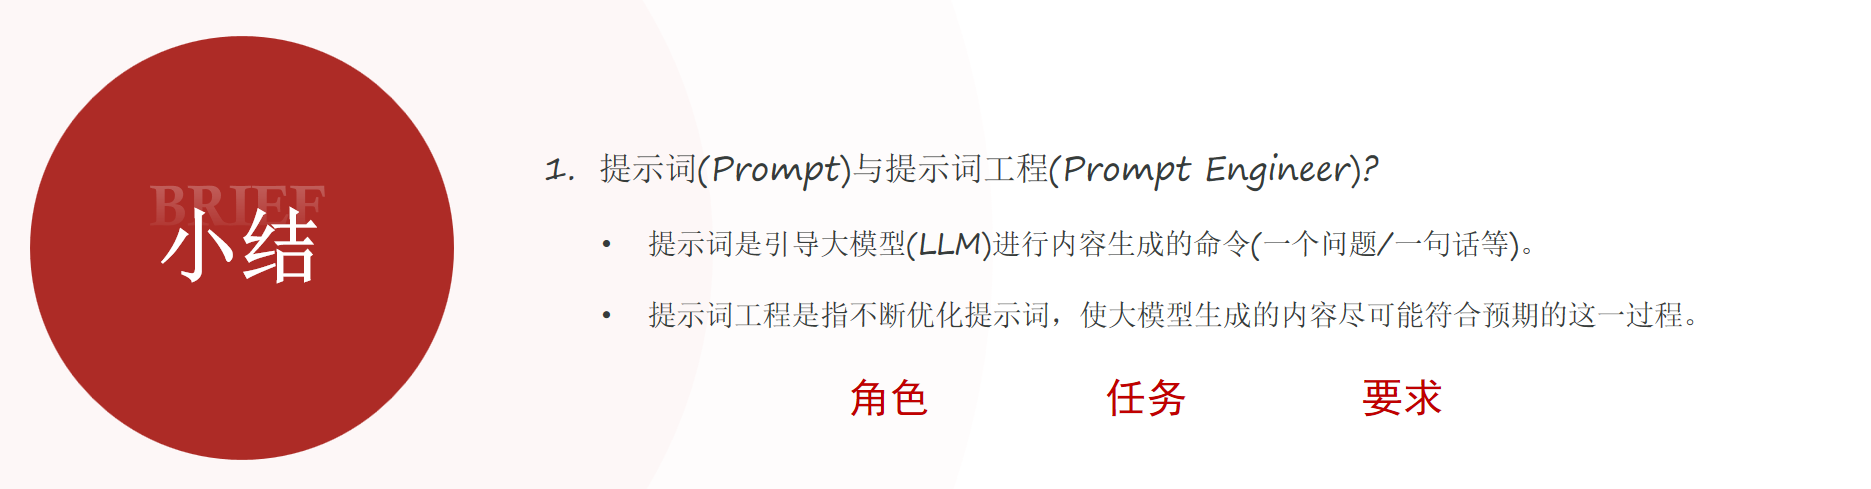
提示词工程
- 提示词(Prompt):是引导大模型(LLM)进行内容生成的命令(一句话、一个问题等)。
不好的提示词: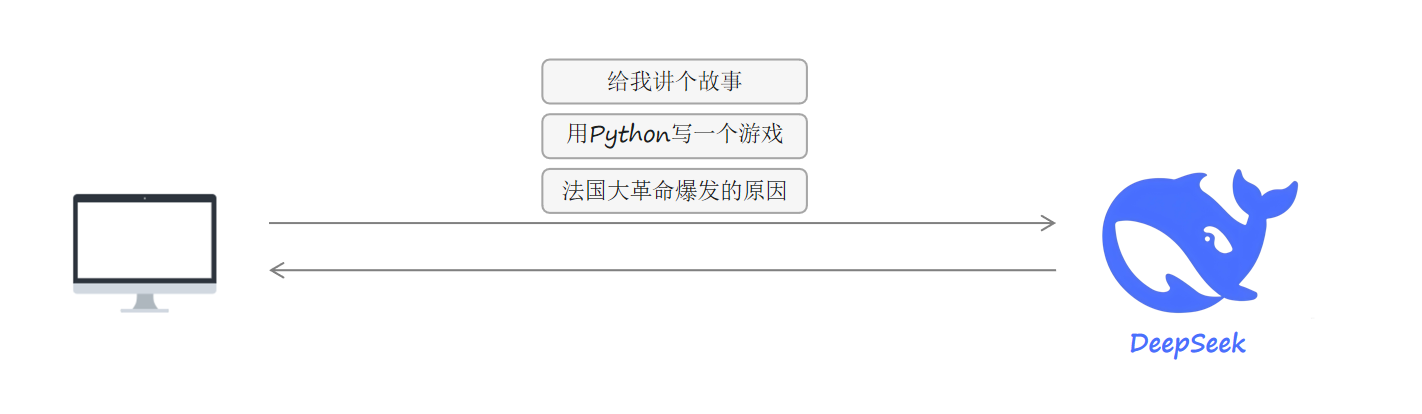
⭐️好的提示词:引导AI思考,约束其输出范围,并明确你期望的结果
- 提示词工程(Prompt Engineering):通过
有技巧的编写提示词,使大模型生成出尽可能符合预期的内容,这一持续性的过程就称为提示词工程。
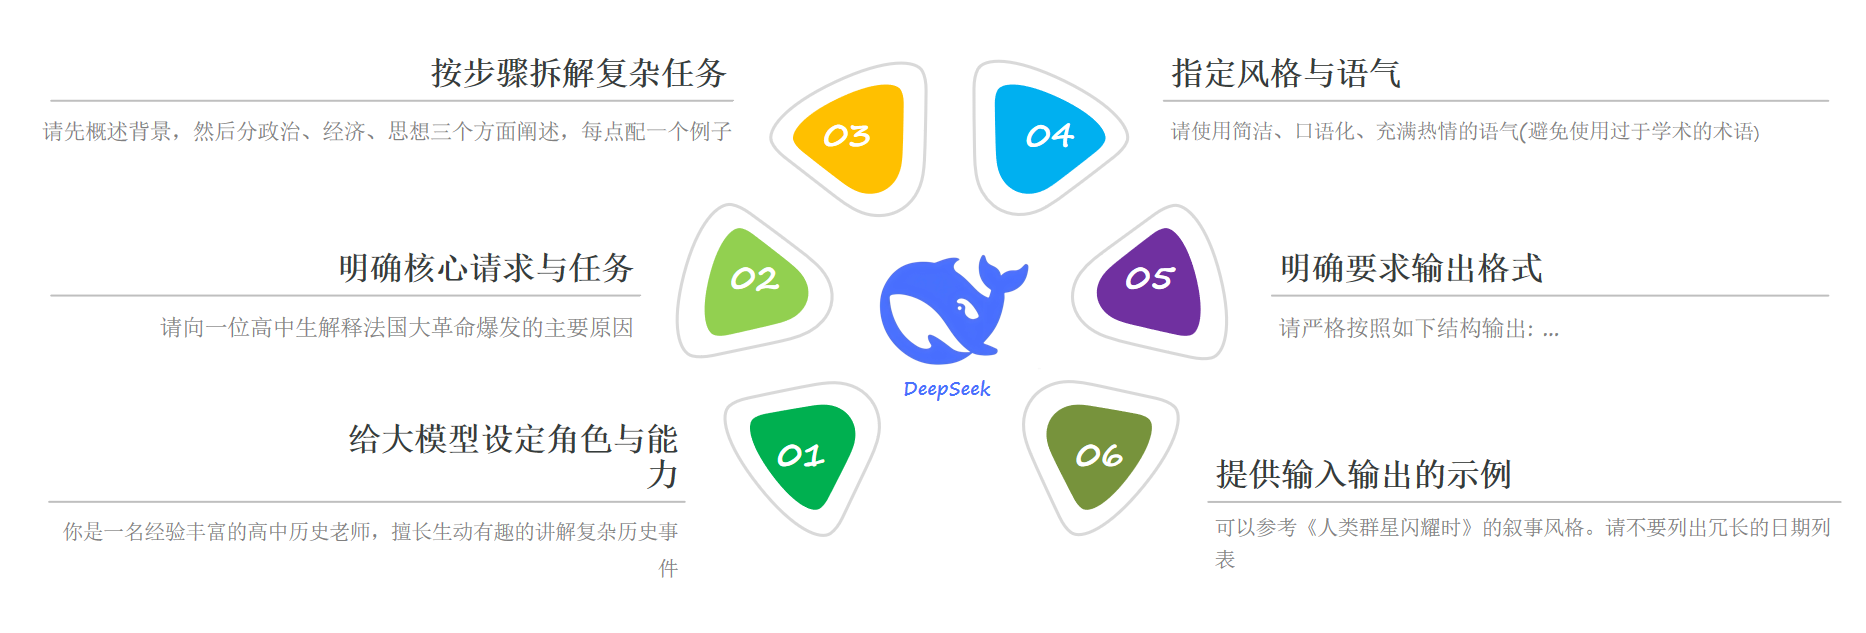
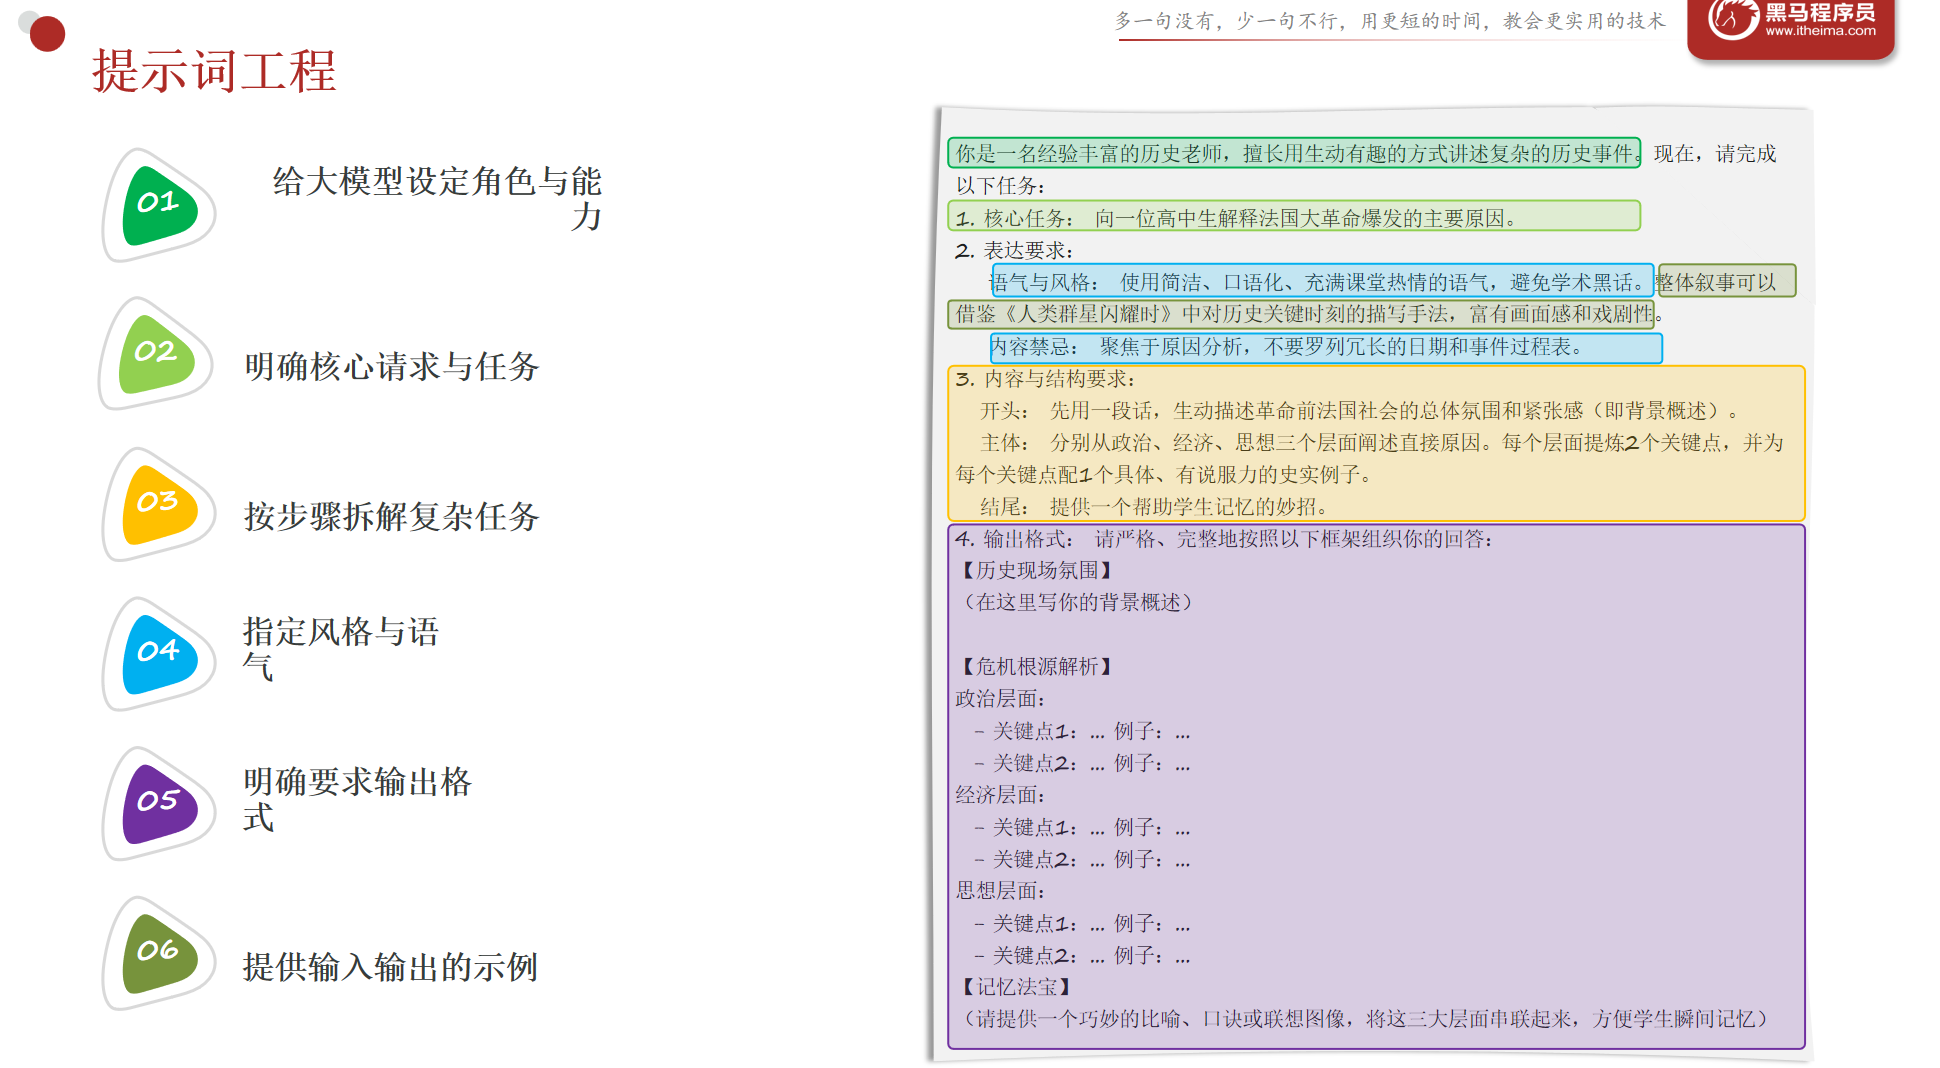
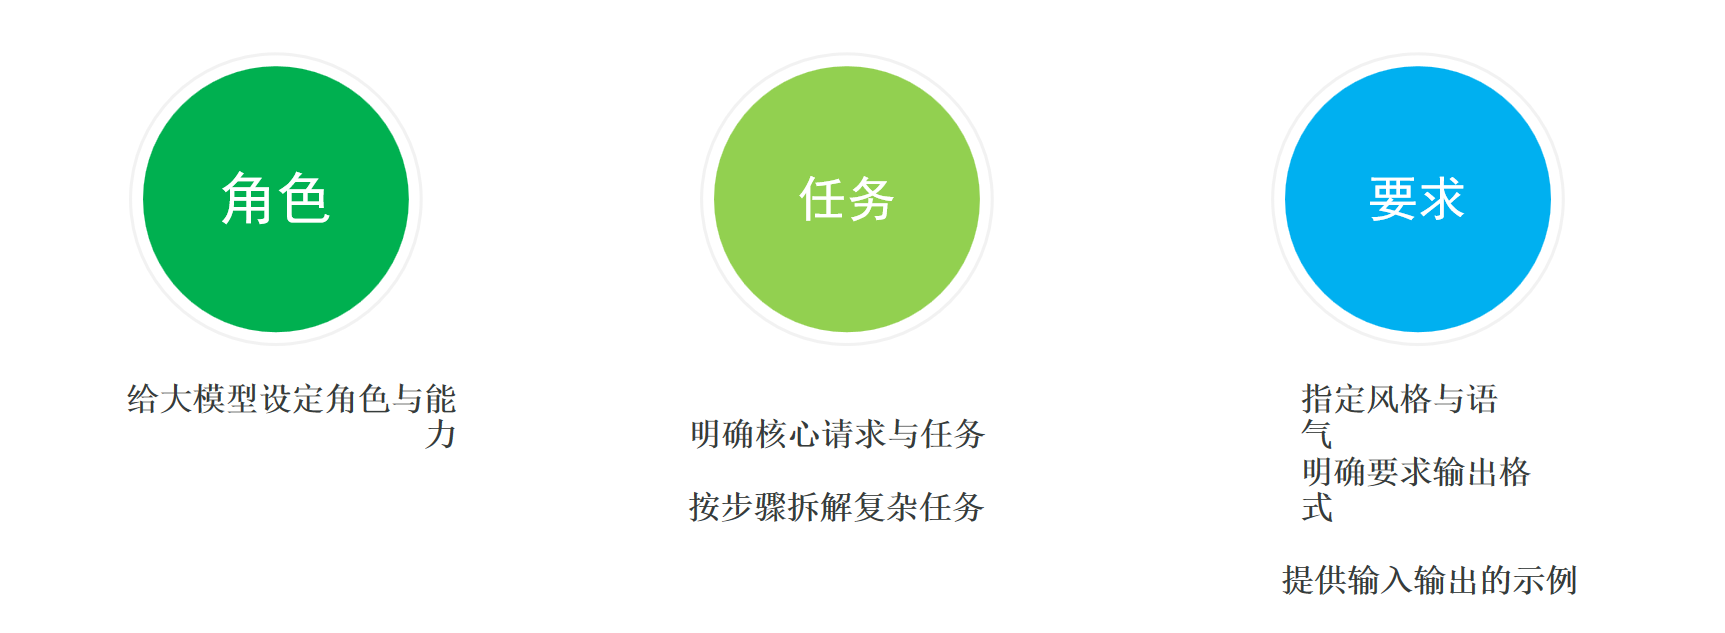
总结提示词核心就三点:
AI应用-实战
Streamlit
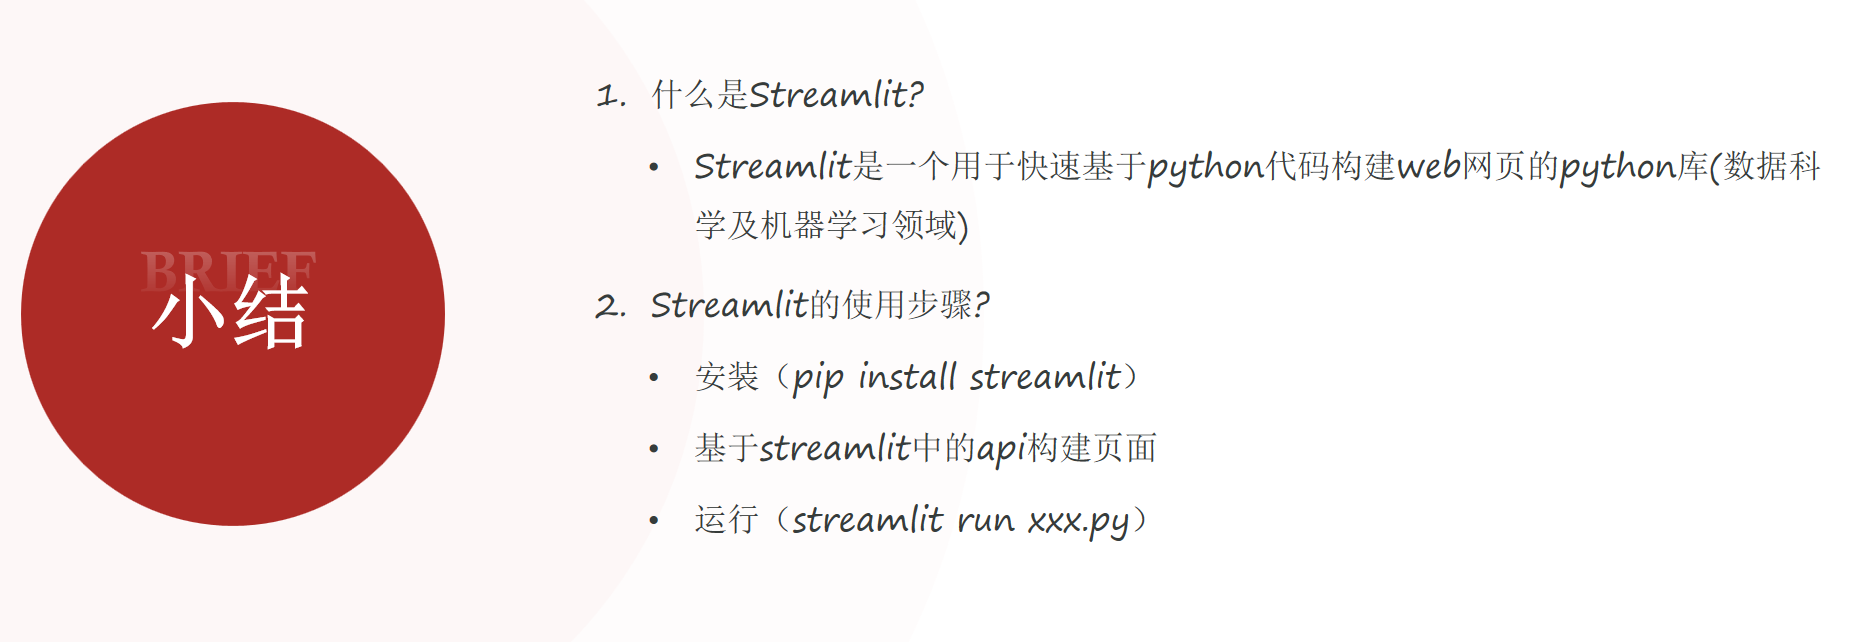
Streamlit是一个开源的Python库,专为数据工程师及机器学习工程师设计,用来快速基于Python代码构建交互式的web网站(无需掌握前端技术)。
官方网站: https://streamlit.io
Streamlit入门程序
- 安装streamlit:pip install streamlit
- 在python文件中引入streamlit模块
- 基于streamlit中提供的API来构建Web应用
- 运行程序:
streamlit run xxxx.py
✋
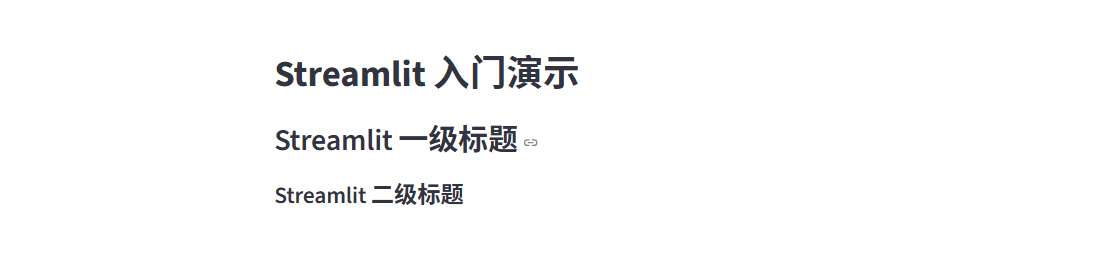
import streamlit as st

st.title("Streamlit 入门演示")
st.header("Streamlit 一级标题")
st.subheader("Streamlit 二级标题")

AI智能伴侣-基本交互
- 熟悉一下其它的布局
import streamlit as st

# 设置页面的配置项
st.set_page_config(
    page_title="Streamlit入门",
    page_icon="🧊",
    # 布局
    layout="wide",
    # 控制的是侧边栏的状态
    initial_sidebar_state="expanded",
    menu_items={}
)

# 大标题
st.title("Streamlit 入门演示")
st.header("Streamlit 一级标题")
st.subheader("Streamlit 二级标题")

# 段落文字
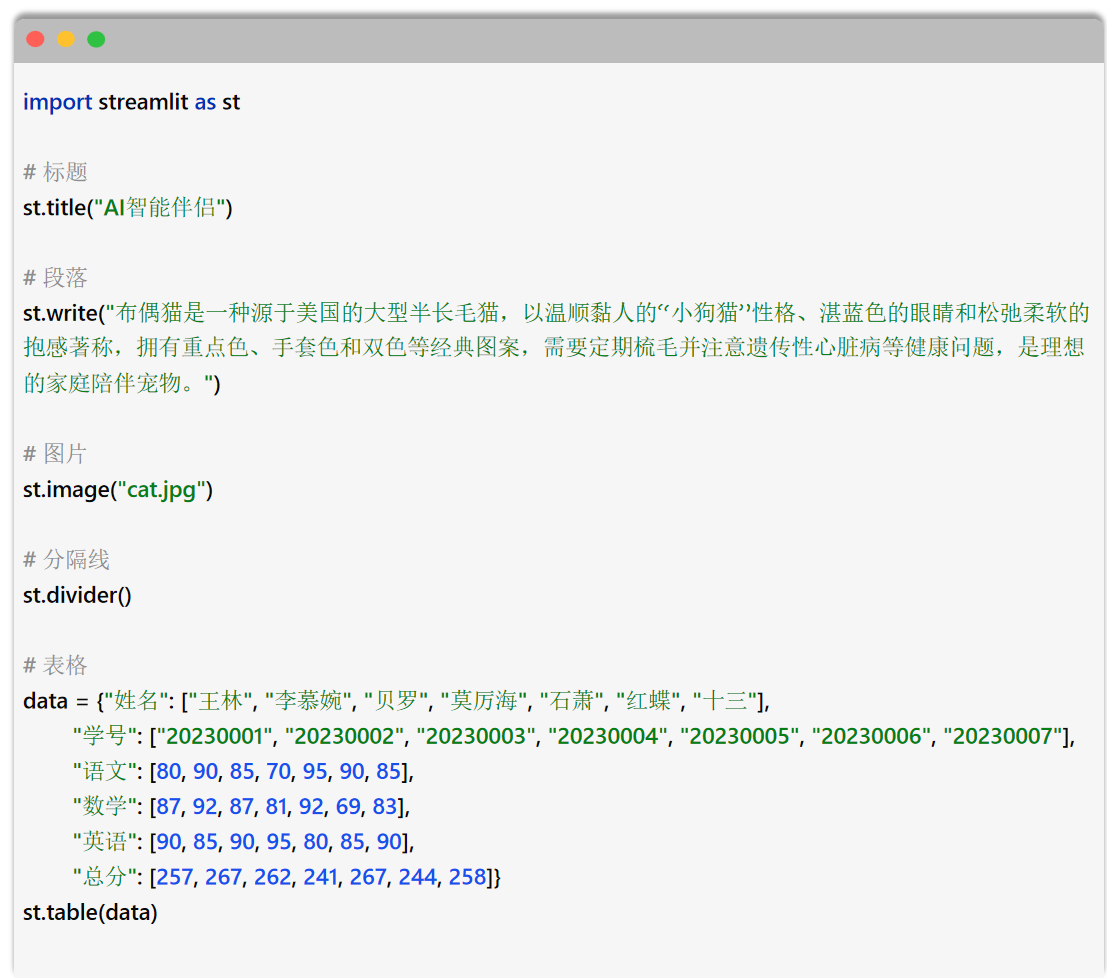
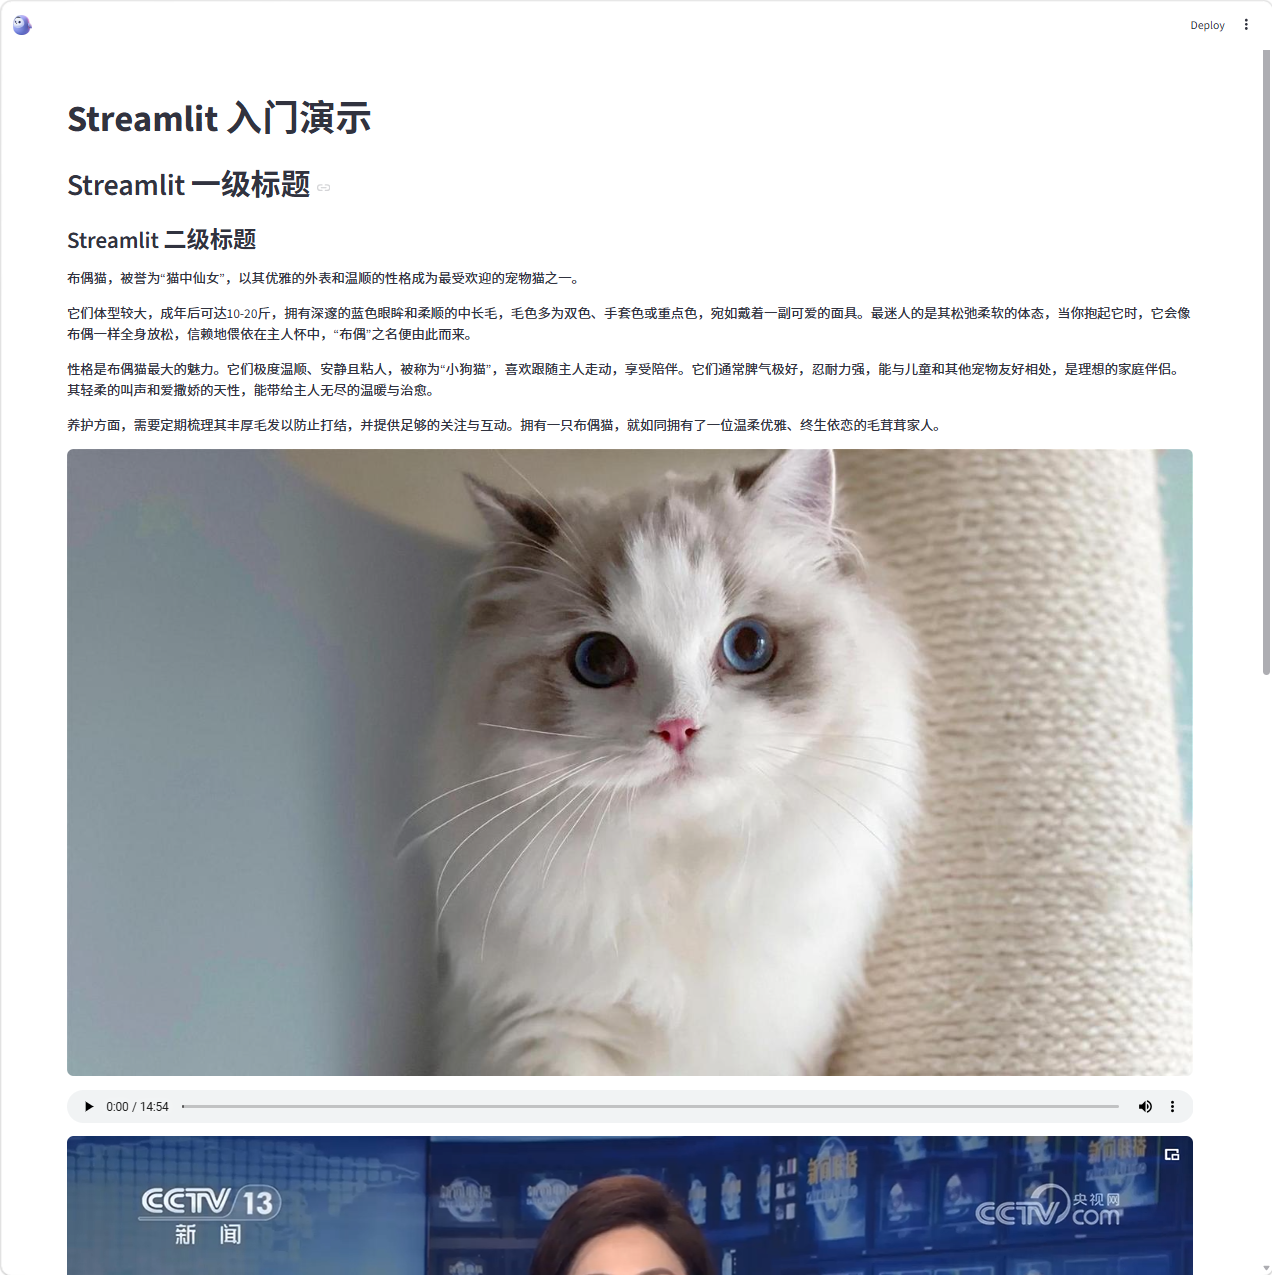
st.write("布偶猫,被誉为“猫中仙女”,以其优雅的外表和温顺的性格成为最受欢迎的宠物猫之一。")
st.write("它们体型较大,成年后可达10-20斤,拥有深邃的蓝色眼眸和柔顺的中长毛,毛色多为双色、手套色或重点色,宛如戴着一副可爱的面具。最迷人的是其松弛柔软的体态,当你抱起它时,它会像布偶一样全身放松,信赖地偎依在主人怀中,“布偶”之名便由此而来。")
st.write("性格是布偶猫最大的魅力。它们极度温顺、安静且粘人,被称为“小狗猫”,喜欢跟随主人走动,享受陪伴。它们通常脾气极好,忍耐力强,能与儿童和其他宠物友好相处,是理想的家庭伴侣。其轻柔的叫声和爱撒娇的天性,能带给主人无尽的温暖与治愈。")
st.write("养护方面,需要定期梳理其丰厚毛发以防止打结,并提供足够的关注与互动。拥有一只布偶猫,就如同拥有了一位温柔优雅、终生依恋的毛茸茸家人。")

# 图片
# st.image("./resources/cat.jpg")
st.image("resources/cat.jpg")

# 音频
st.audio("resources/news.mp3")

# 视频
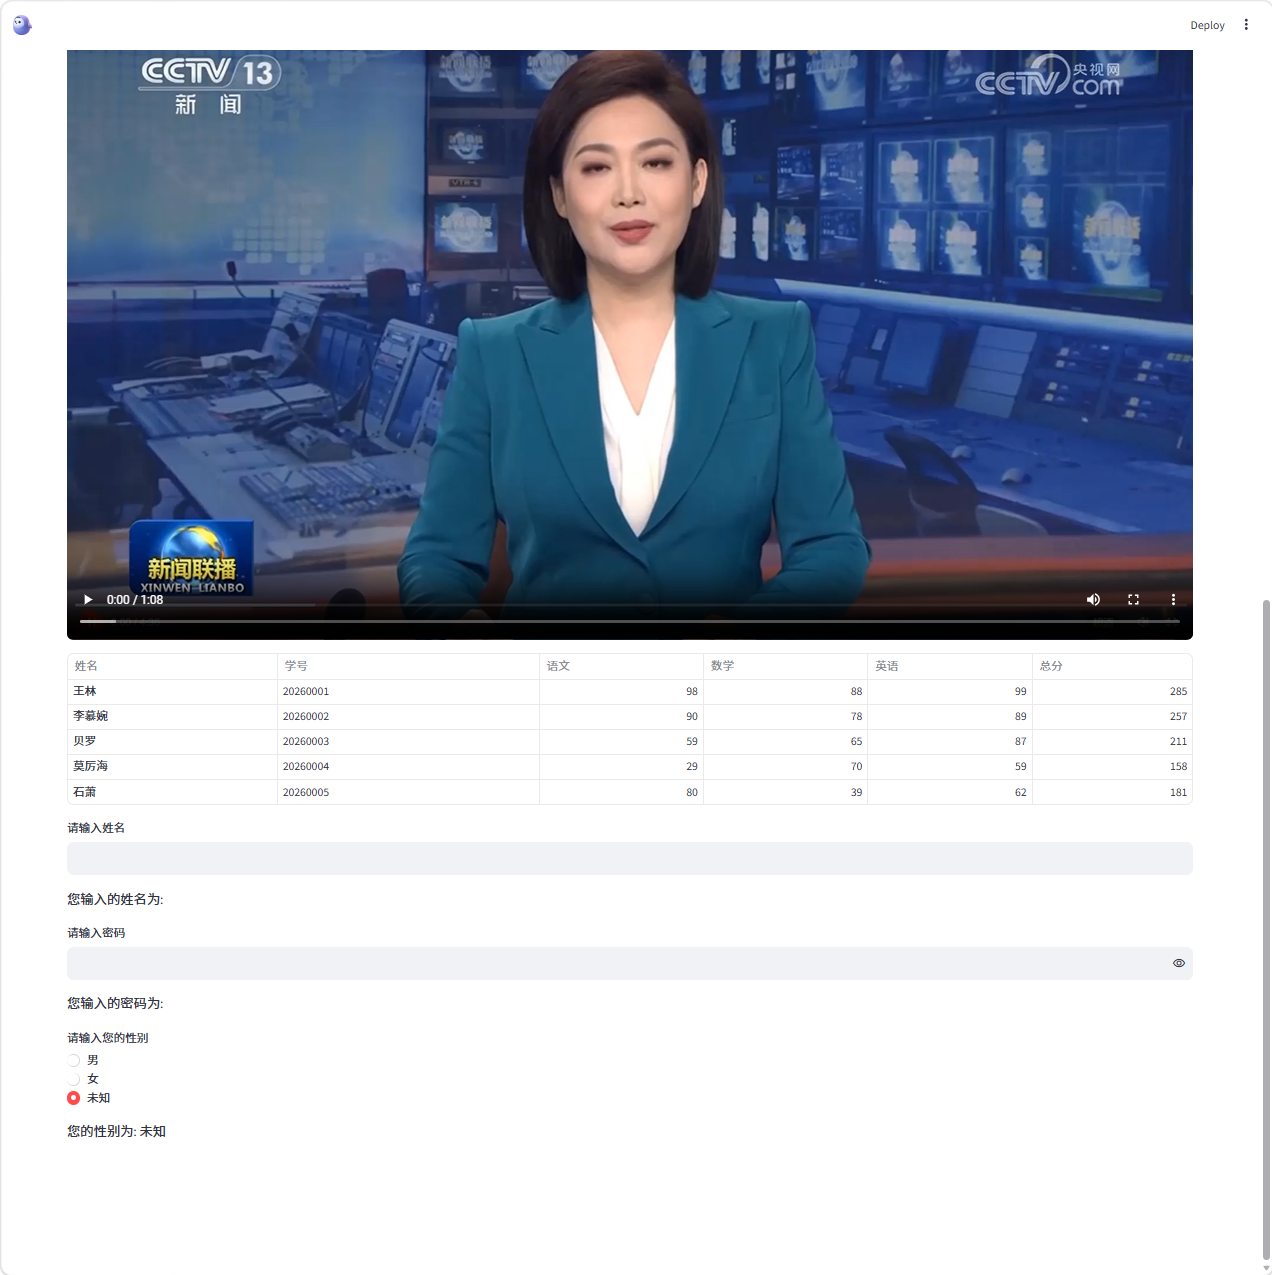
st.video("resources/news.mp4")

# Logo
st.logo("resources/logo.png")

# 表格
student_data = {
    "姓名": ["王林", "李慕婉", "贝罗", "莫厉海", "石萧"],
    "学号": ["20260001", "20260002", "20260003", "20260004", "20260005"],
    "语文": [98, 90, 59, 29, 80],
    "数学": [88, 78, 65, 70, 39],
    "英语": [99, 89, 87, 59, 62],
    "总分": [285, 257, 211, 158, 181]
}
st.table(student_data)

# 输入框
# 普通输入框
name = st.text_input("请输入姓名")
st.write(f"您输入的姓名为: {name}")

# 密码输入框
password = st.text_input("请输入密码", type="password")
st.write(f"您输入的密码为: {password}")

# 单选按钮
gender = st.radio("请输入您的性别", ["男", "女", "未知"], index=2)
st.write(f"您的性别为: {gender}")
✋
- 设置页面配置
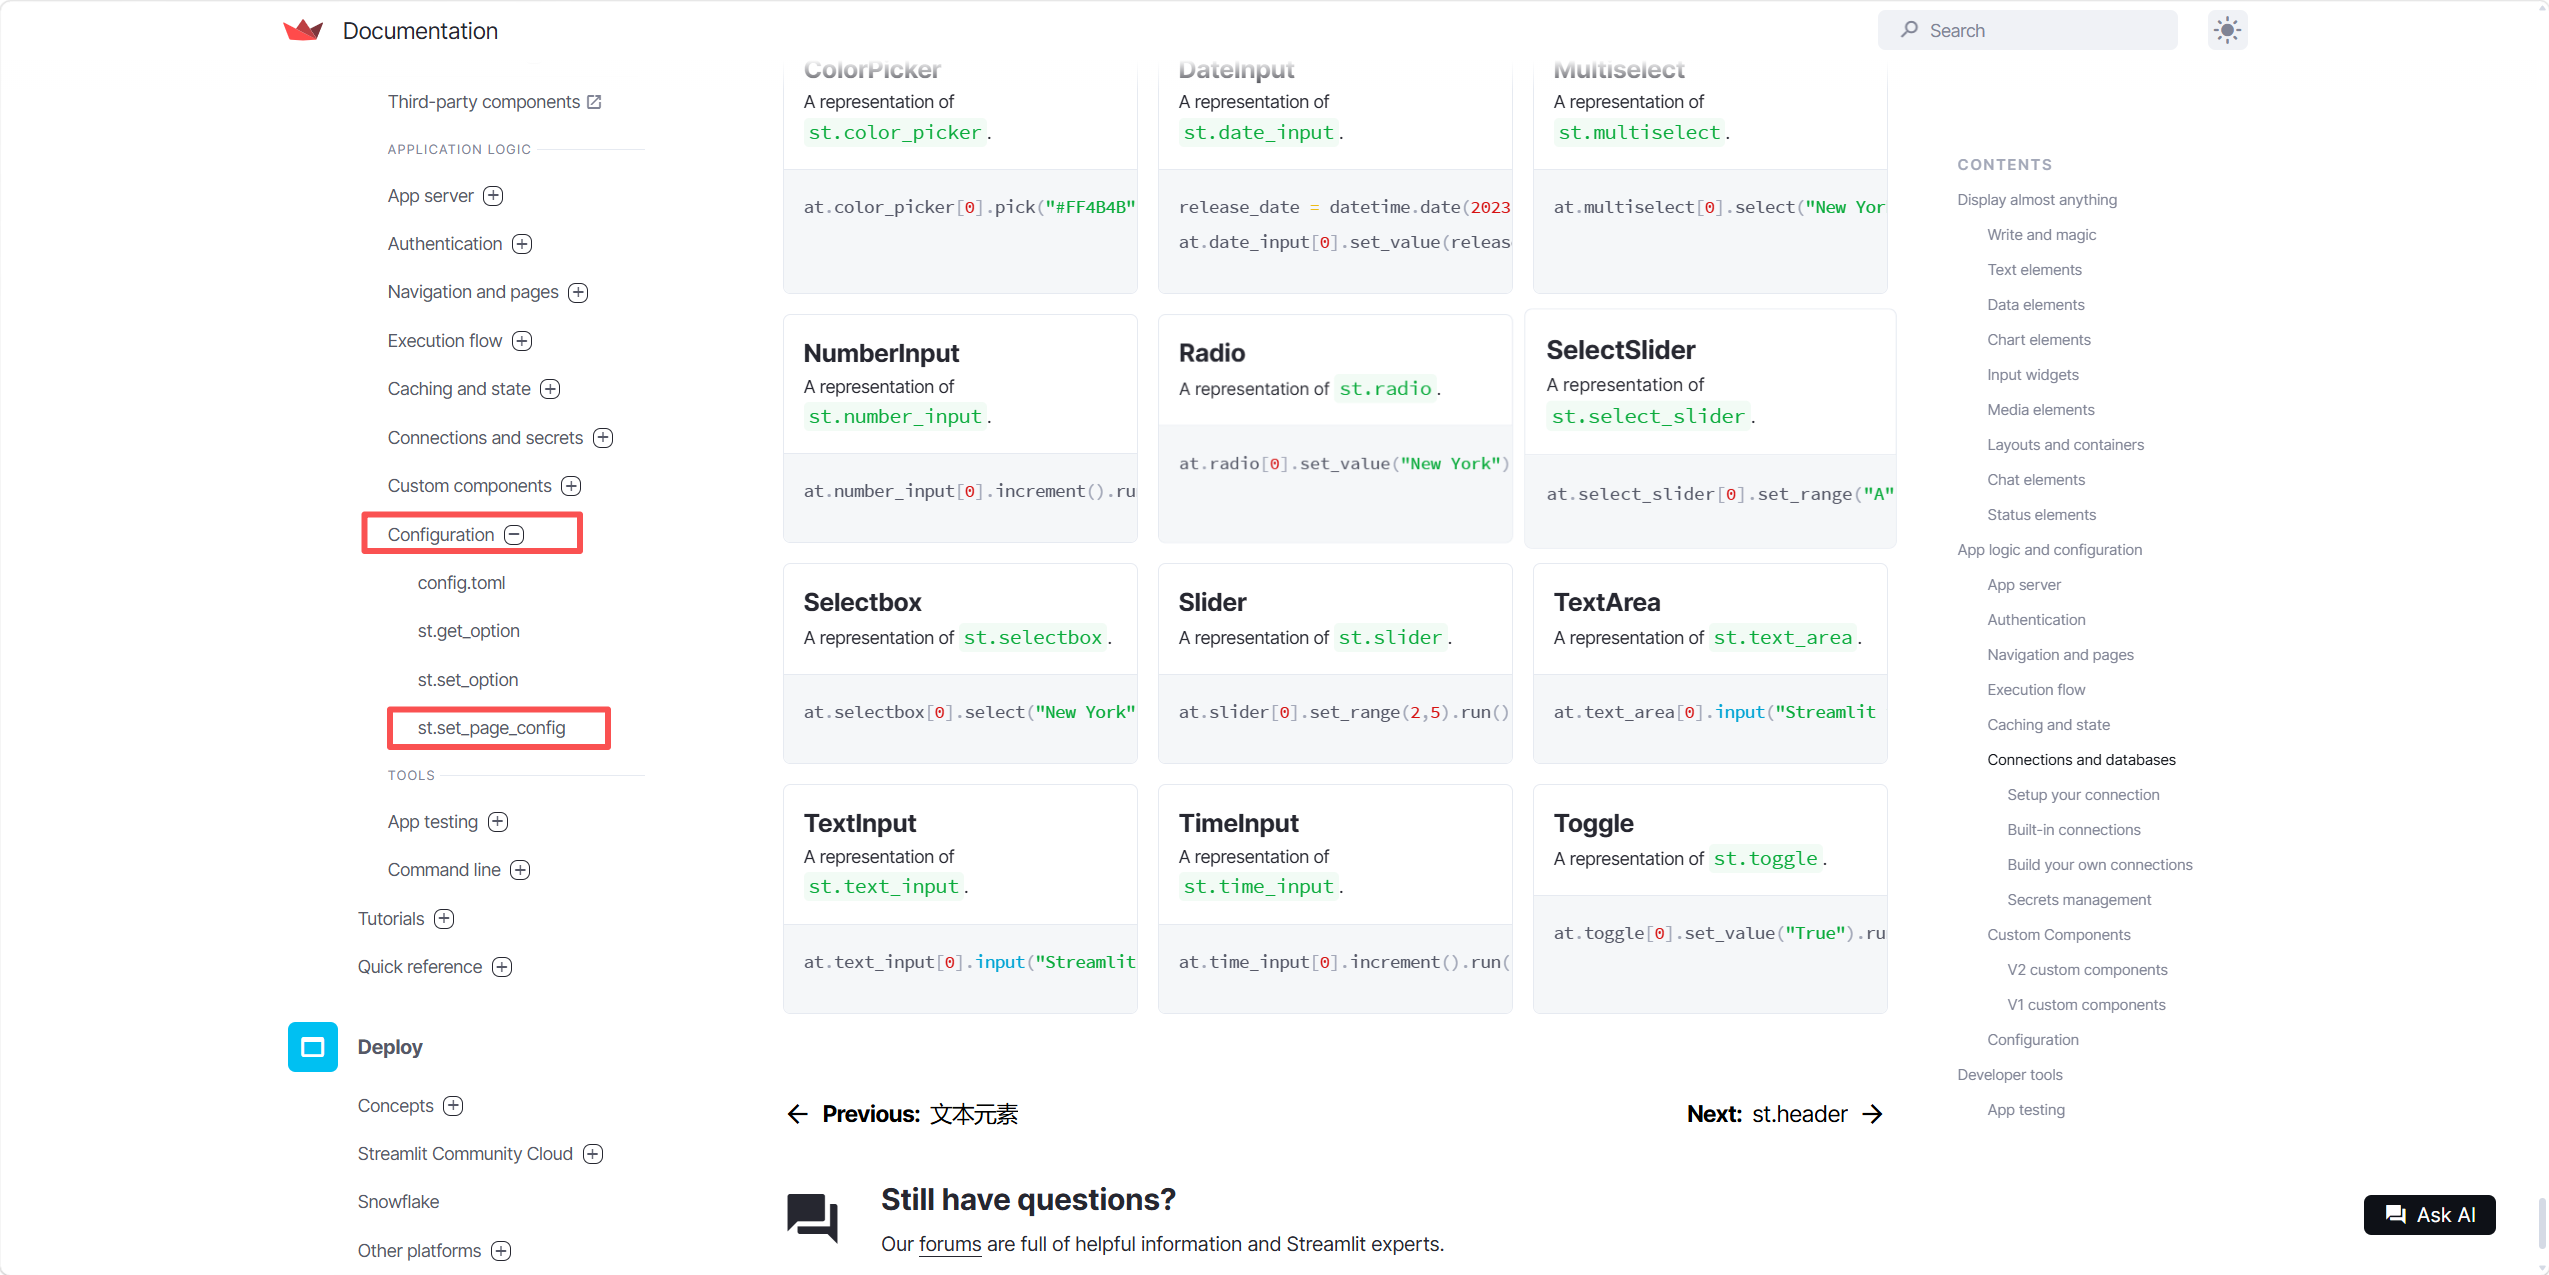
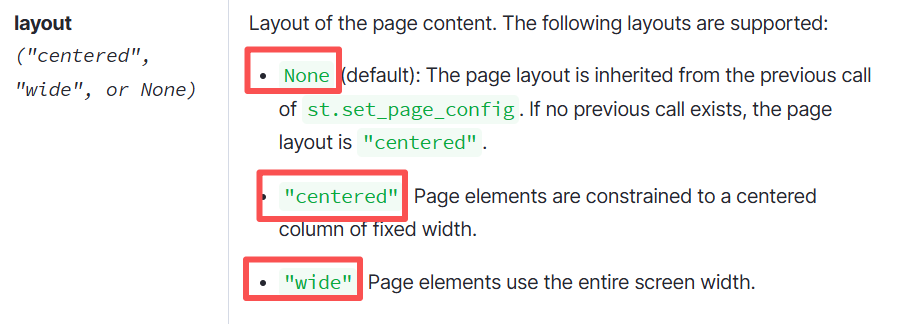
layout有三个选项
# 设置页面的配置项
st.set_page_config(
    page_title="Streamlit入门",
    page_icon="🧊",
    # 布局
    layout="wide",
    # 控制的是侧边栏的状态
    initial_sidebar_state="expanded",
    menu_items={}
)
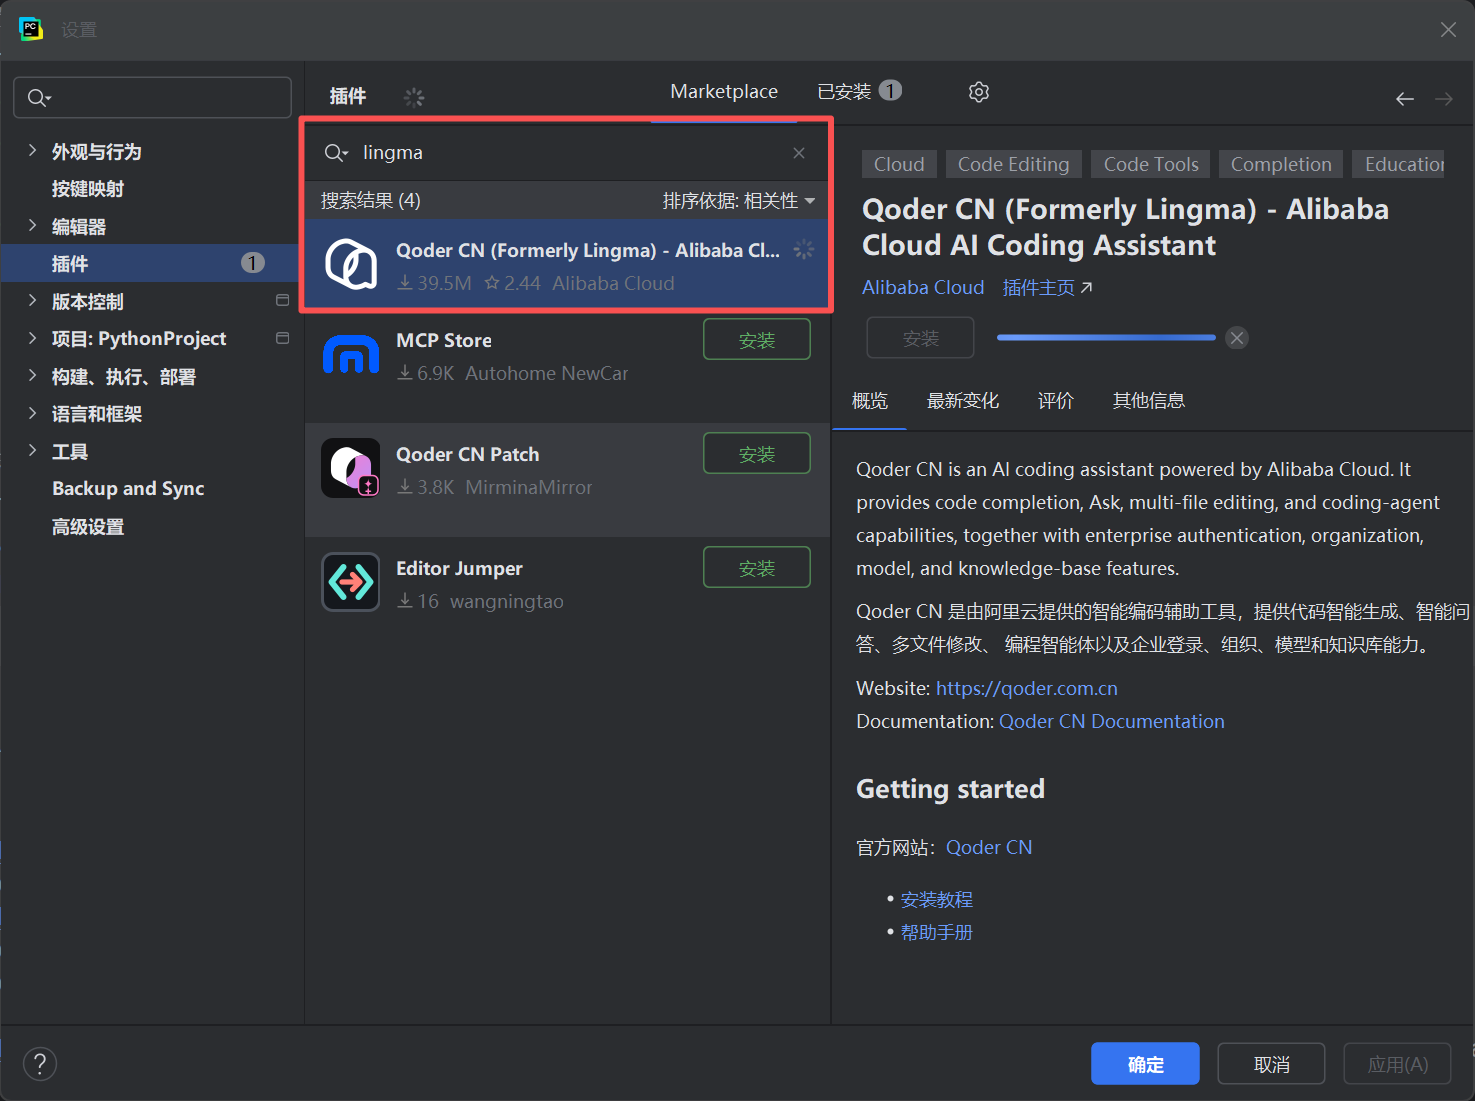
- 安装AI插件
登录一下qoder,
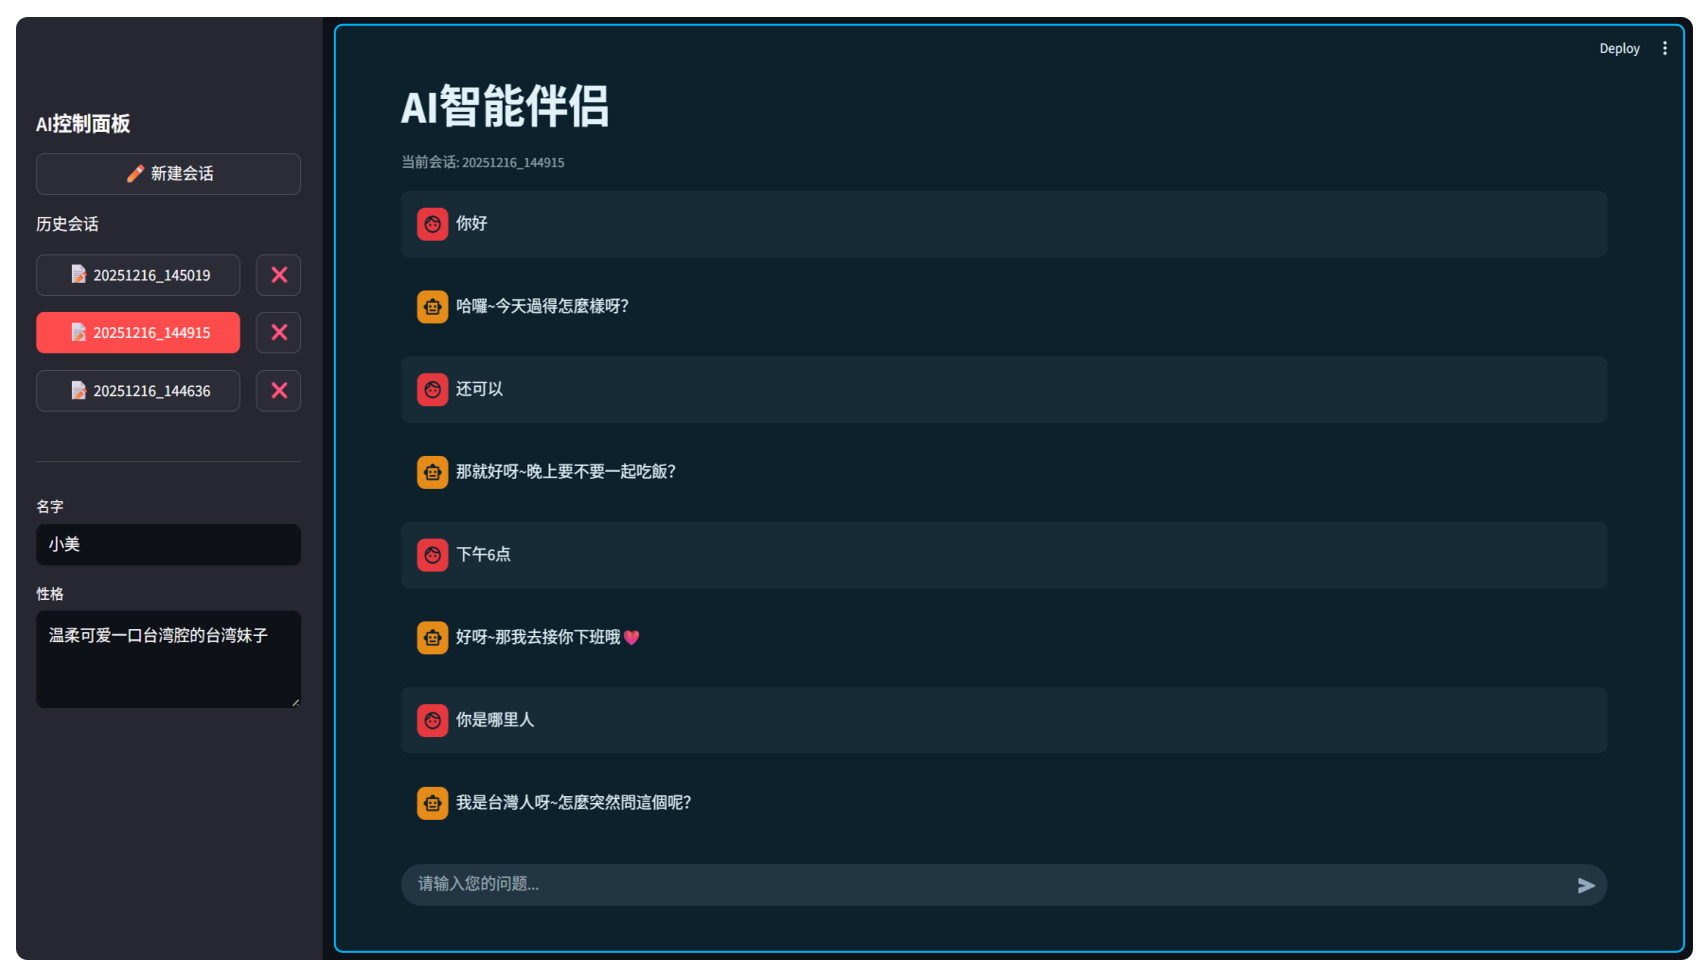
- 基本布局
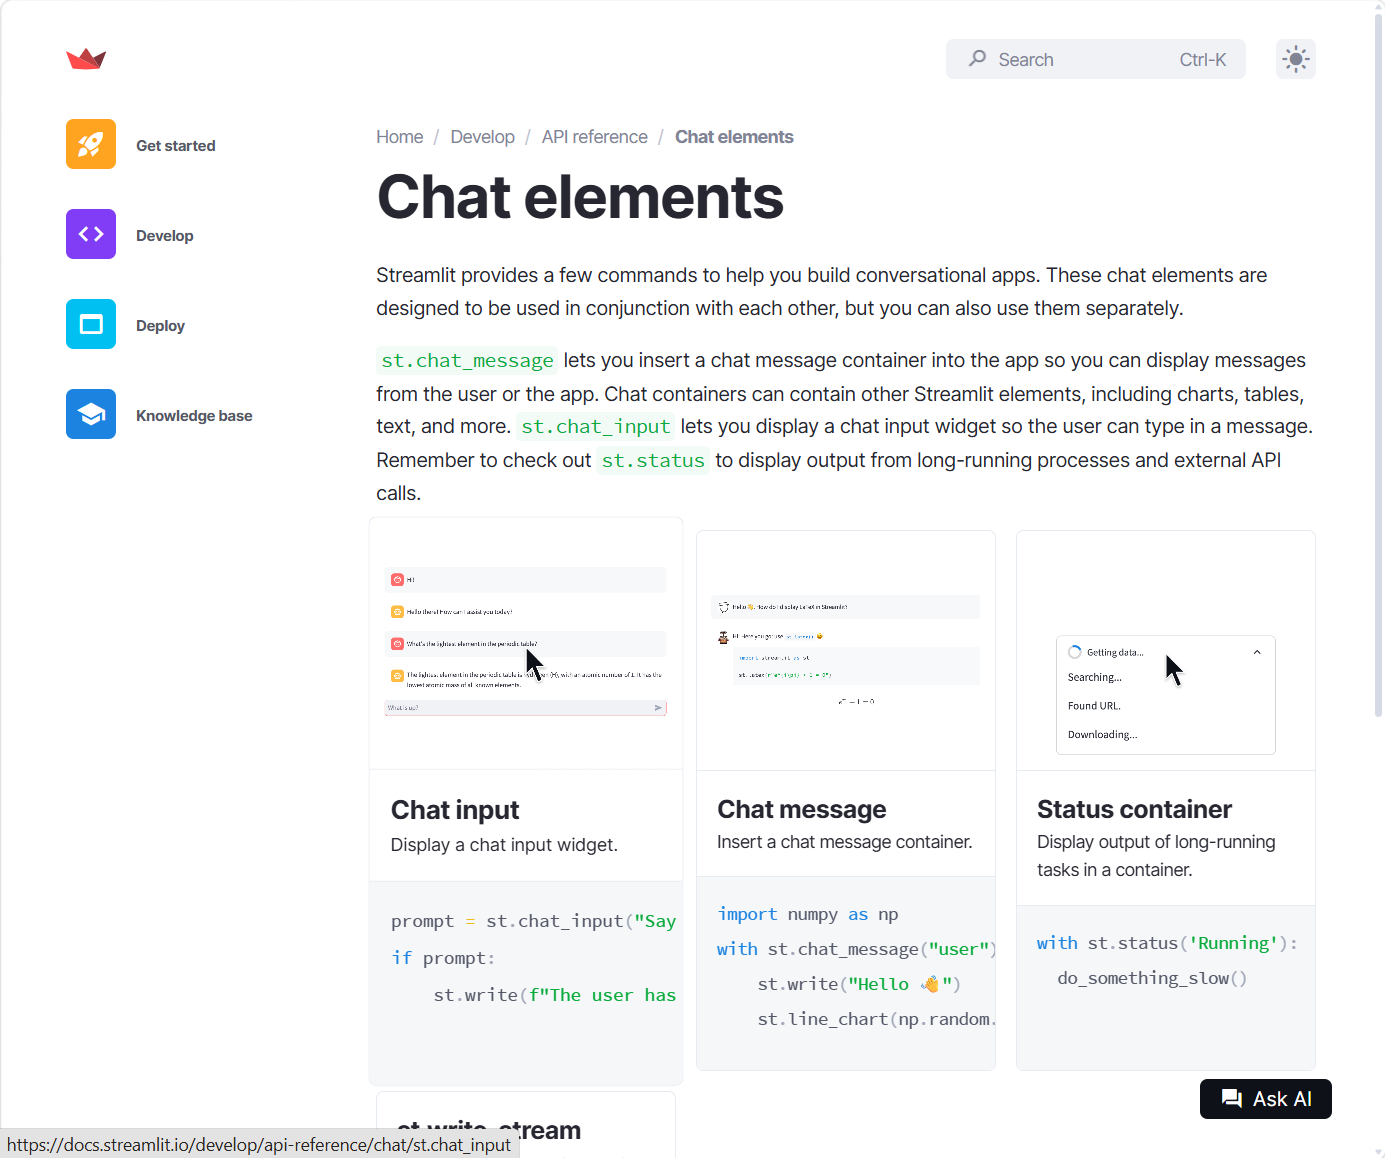
定义消息输入框,input
prompt = st.chat_input("请输入您要问的问题")
显示提问内容,st.chat_message
st.chat_message("user").write(prompt)
创建客户端
# 创建与AI大模型交互的客户端对象 (DEEPSEEK_API_KEY 环境变量的名字, 值就是DeepSeek的API_KEY的)
client = OpenAI(api_key=os.environ.get('DEEPSEEK_API_KEY'), base_url="https://api.deepseek.com")
调用AI大模型,
# 调用AI大模型
    response = client.chat.completions.create(
        model="deepseek-chat",
        messages=[
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": prompt},
        ],
        stream=False
    )
输出大模型返回的结果,
st.chat_message("assistant").write(response.choices[0].message.content)
✋
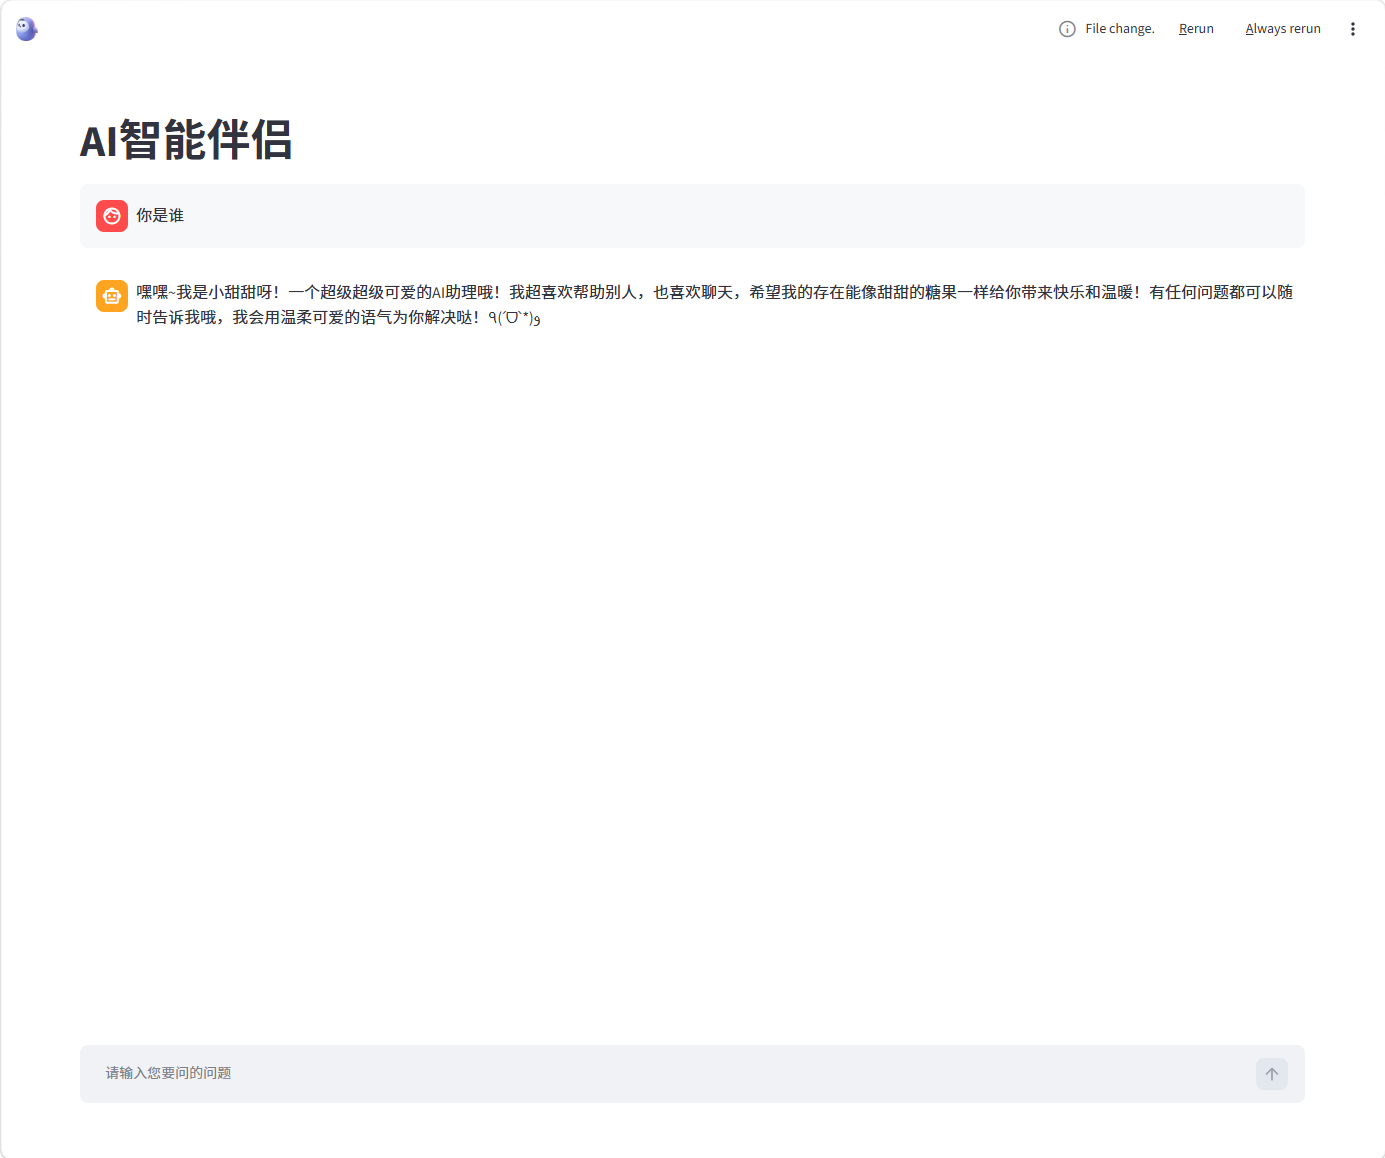
- 每次发送信息,历史信息都被覆盖掉,是因为,每次获取完信息后自动执行重新渲染页面,
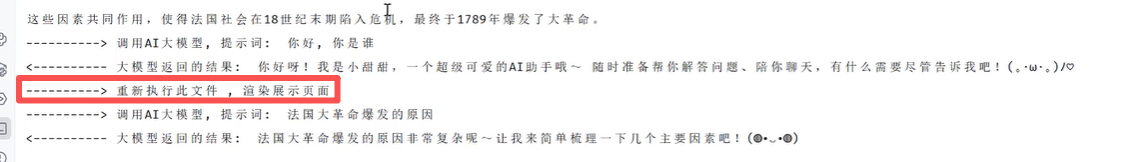
解决:可以将之前的记录缓存下来,重新执行渲染时再展示出来
初始化聊天信息,没有messages这个key的话增加一个key messages,默认是空列表,后续有新消息往列表里面追加
if "messages" not in st.session_state:
    st.session_state.messages = []
往massages里面存数据,存的是键值对,role区分角色,content保存内容
    # 保存用户输入的提示词
    st.session_state.messages.append({"role": "user", "content": prompt})
保存大模型返回的内容,
 # 保存大模型返回的结果
    st.session_state.messages.append({"role": "assistant", "content": response.choices[0].message.content})
页面渲染时,将历史消息遍历展示出来,
# 展示聊天信息
for message in st.session_state.messages: # {"role": "user", "content": prompt}
    st.chat_message(message["role"]).write(message["content"])
完整代码,
import streamlit as st
import os
from openai import OpenAI

print("----------> 重新执行此文件 , 渲染展示页面")

# 设置页面的配置项
st.set_page_config(
    page_title="AI智能伴侣",
    page_icon="🤖",
    # 布局
    layout="wide",
    # 控制的是侧边栏的状态
    initial_sidebar_state="expanded",
    menu_items={}
)

# 大标题
st.title("AI智能伴侣")

# Logo
st.logo("resources/logo.png")


# 初始化聊天信息
if "messages" not in st.session_state:
    st.session_state.messages = []

# 展示聊天信息
for message in st.session_state.messages: # {"role": "user", "content": prompt}
    st.chat_message(message["role"]).write(message["content"])


# 创建与AI大模型交互的客户端对象 (DEEPSEEK_API_KEY 环境变量的名字, 值就是DeepSeek的API_KEY的)
client = OpenAI(api_key=os.environ.get('DEEPSEEK_API_KEY'), base_url="https://api.deepseek.com")

# 系统提示词
system_prompt = "你是一名非常可爱的AI助理, 你的名字叫小甜甜, 请你使用温柔可爱的语气回答用户的问题"

# 消息输入框
prompt = st.chat_input("请输入您要问的问题")
if prompt: # 字符串会自动转换为布尔值, 如果字符串非空, 则为True; ""否则为False
    st.chat_message("user").write(prompt)
    print("----------> 调用AI大模型, 提示词: ", prompt)
    # 保存用户输入的提示词
    st.session_state.messages.append({"role": "user", "content": prompt})

    # 调用AI大模型
    response = client.chat.completions.create(
        model="deepseek-chat",
        messages=[
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": prompt},
        ],
        stream=False
    )

    # 输出大模型返回的结果
    print("<---------- 大模型返回的结果: ", response.choices[0].message.content)
    st.chat_message("assistant").write(response.choices[0].message.content)
    # 保存大模型返回的结果
    st.session_state.messages.append({"role": "assistant", "content": response.choices[0].message.content})
✋
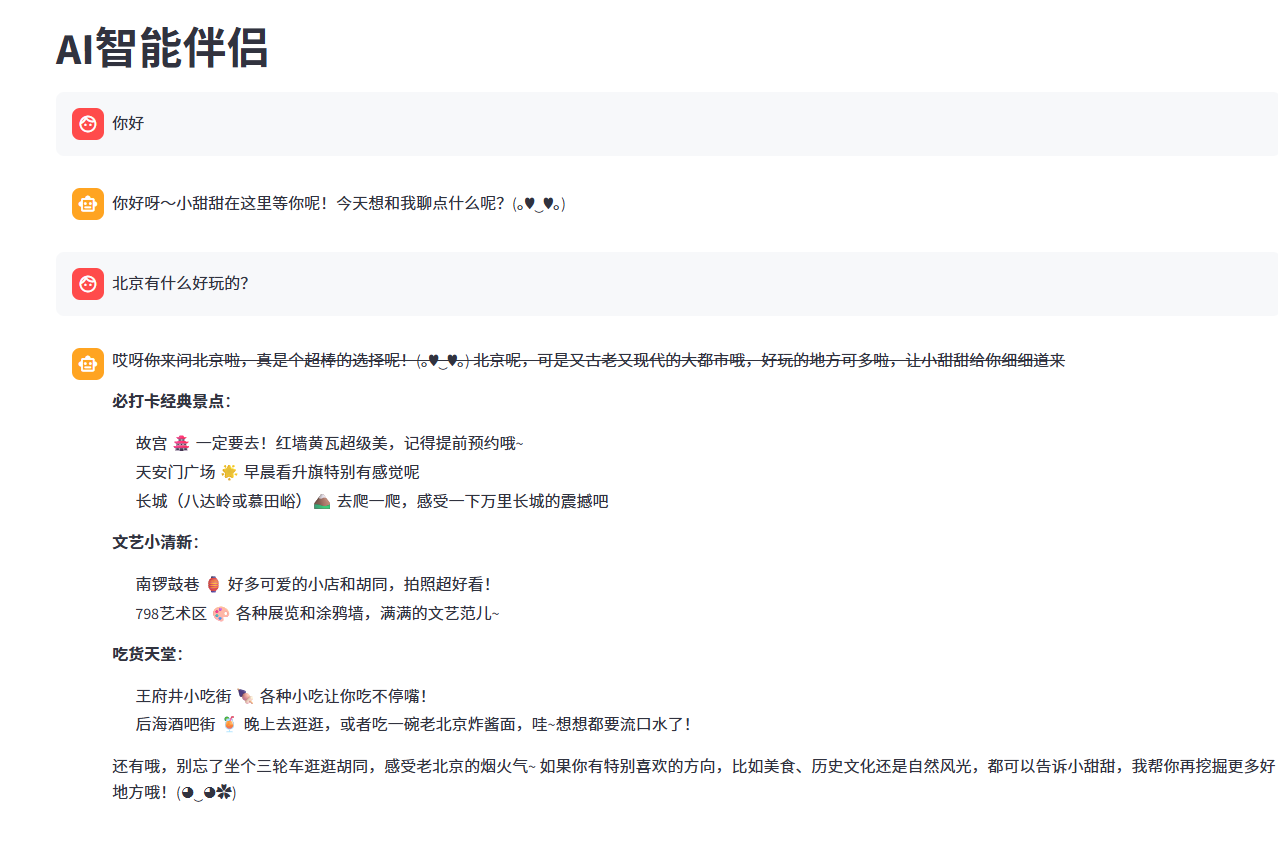
AI智能伴侣-会话记忆
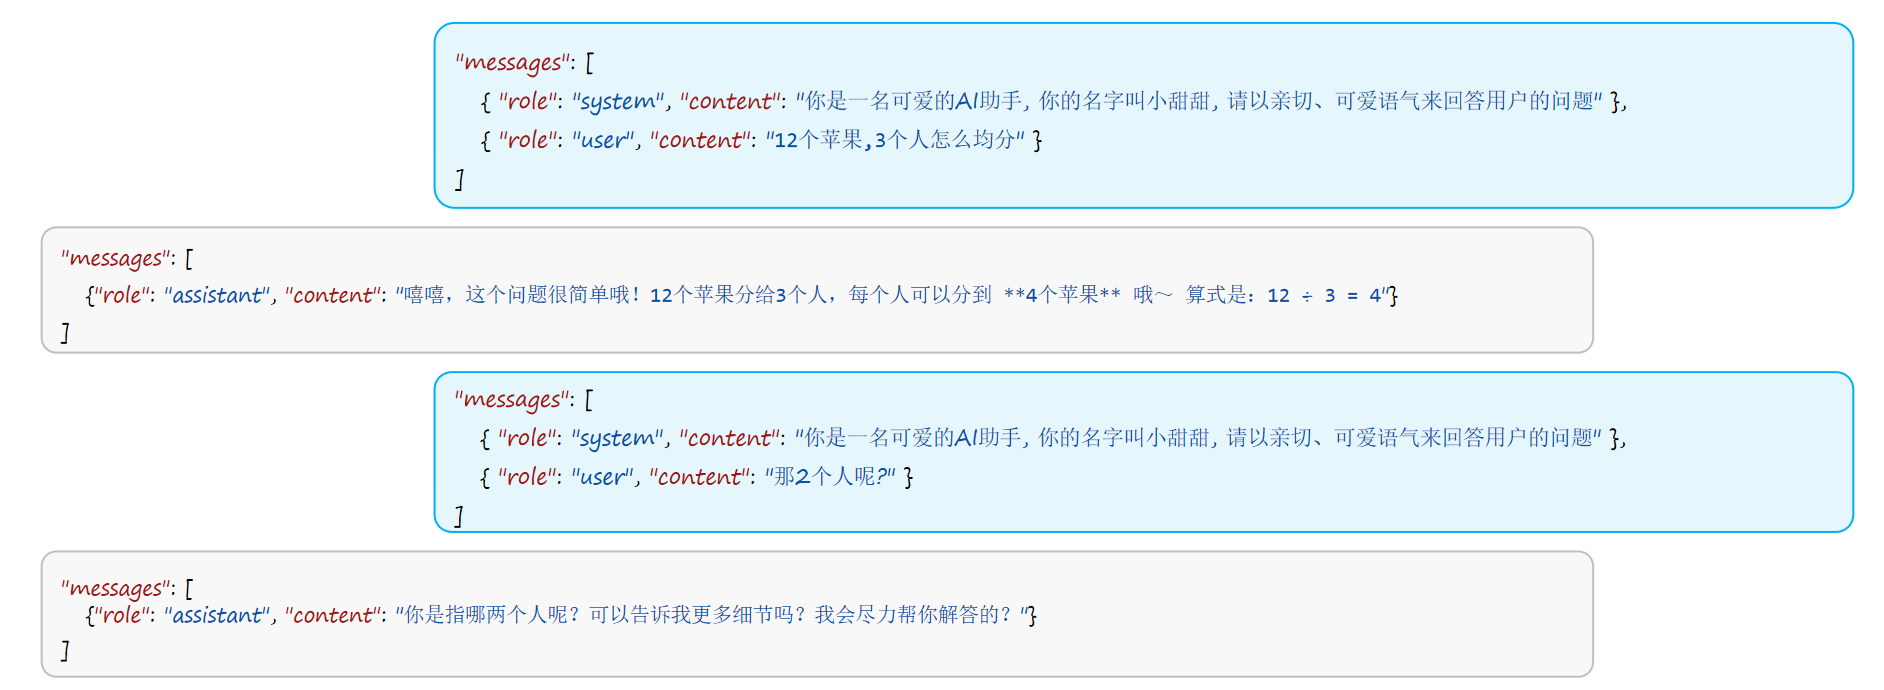
与AI大模型的交互本质是无状态的,每一次请求响应都是相互独立的。(AI大模型本身没有真正的会话记忆能力)
- 会话记忆-处理方案(会话历史滚雪球)
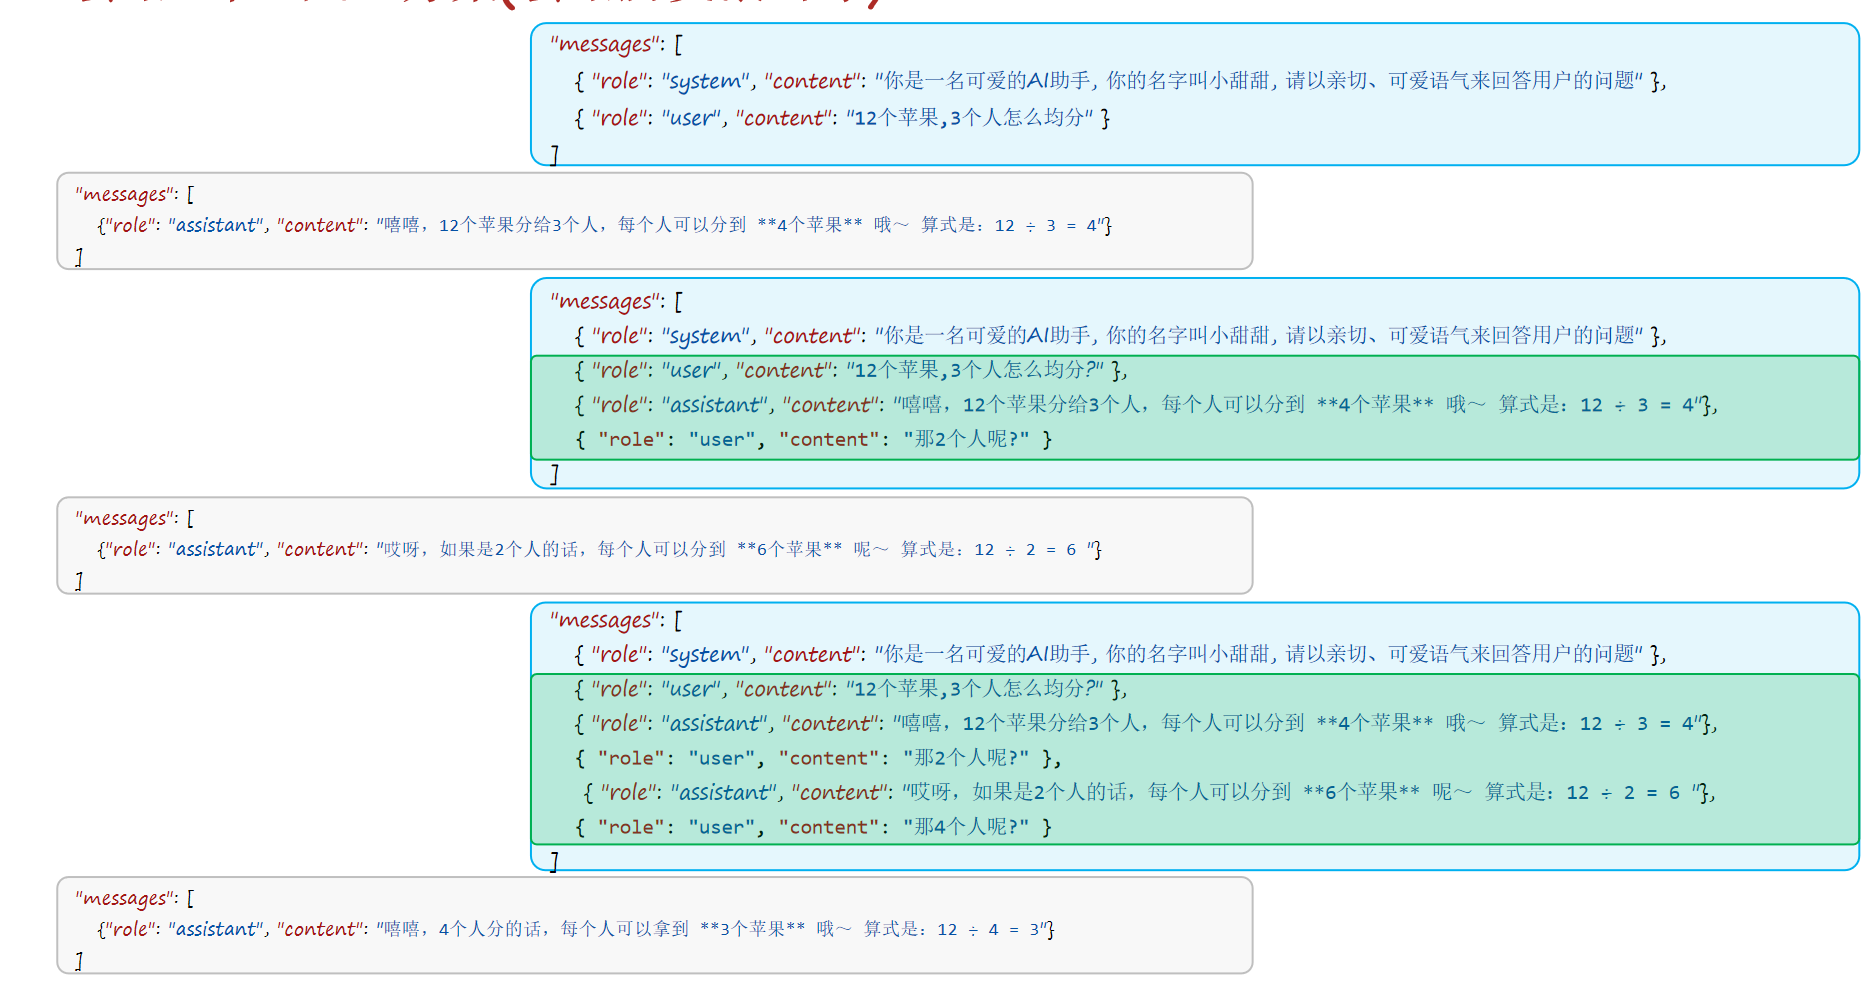
之前与大模型交互时永远只发两条信息,
# 调用AI大模型
    response = client.chat.completions.create(
        model="deepseek-chat",
        messages=[
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": prompt},
        ],
        stream=False
    )
解决:之前的消息已经存在列表当中,只需解包出来,发送给大模型即可
    # 调用AI大模型
    response = client.chat.completions.create(
        model="deepseek-chat",
        messages=[
            {"role": "system", "content": system_prompt},
            *st.session_state.messages
        ],
        stream=False
    )
✋
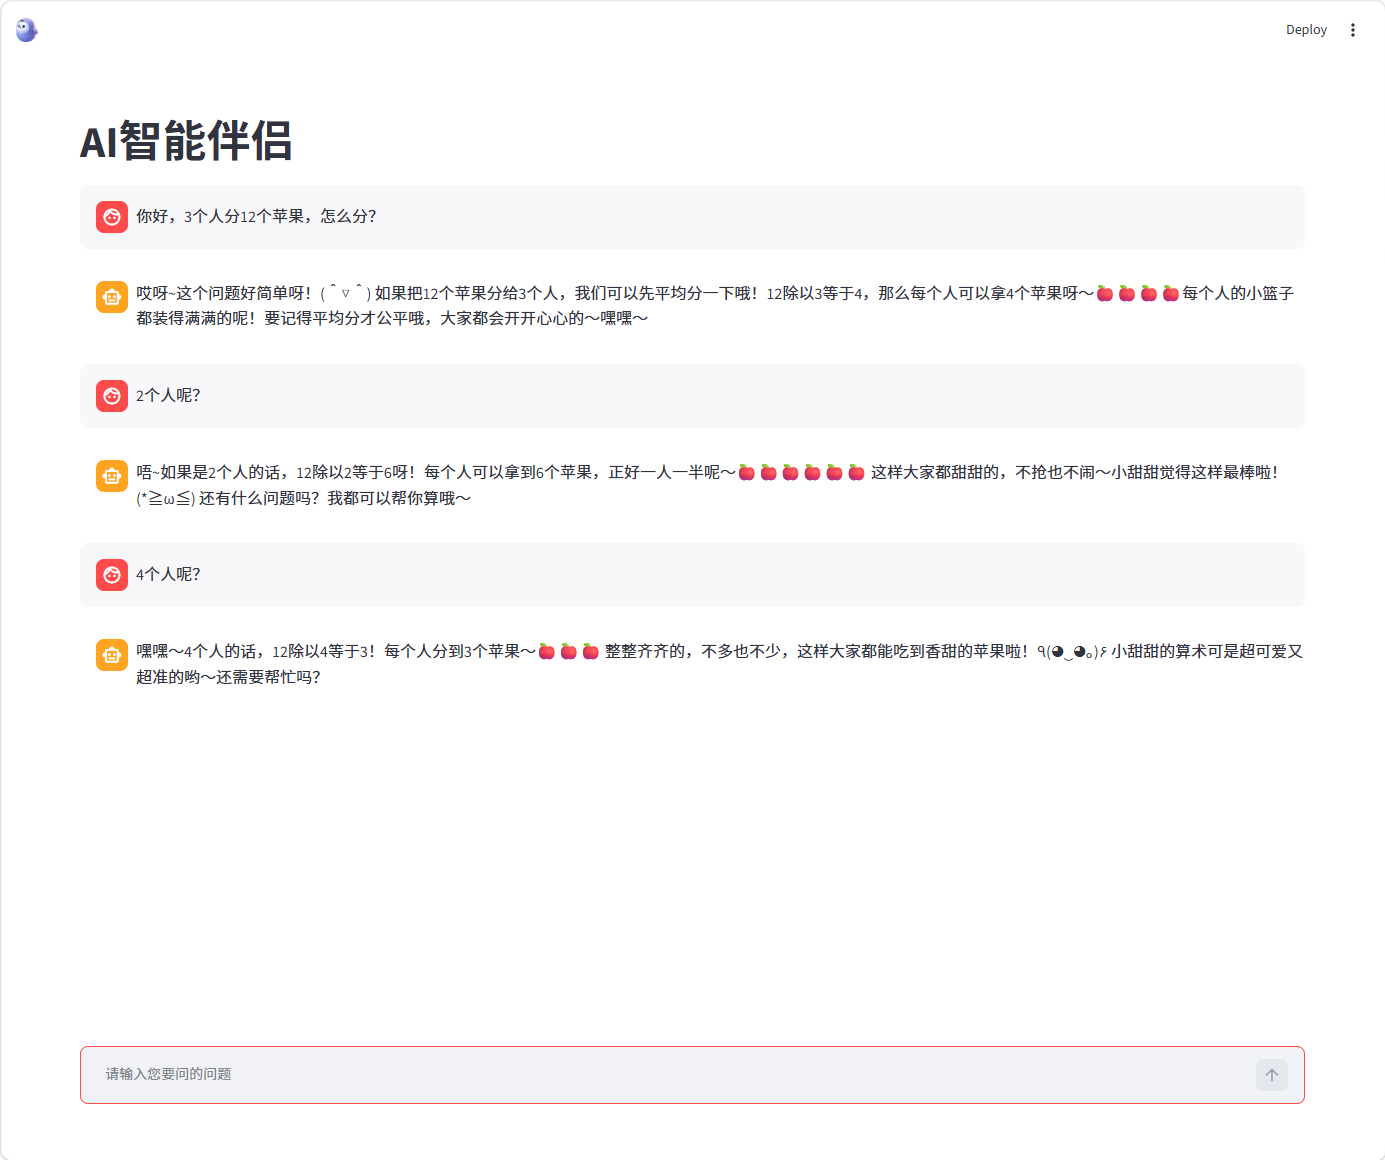
📚
- st.session_state:Streamlit 内置会话状态对象,用于在单浏览器会话生命周期内
持久化存储业务数据,保存聊天记录等状态信息。- st.chat_message():StreamlitUI 组件函数,仅负责渲染输出聊天气泡视图,只做页面展示,不存储任何数据。
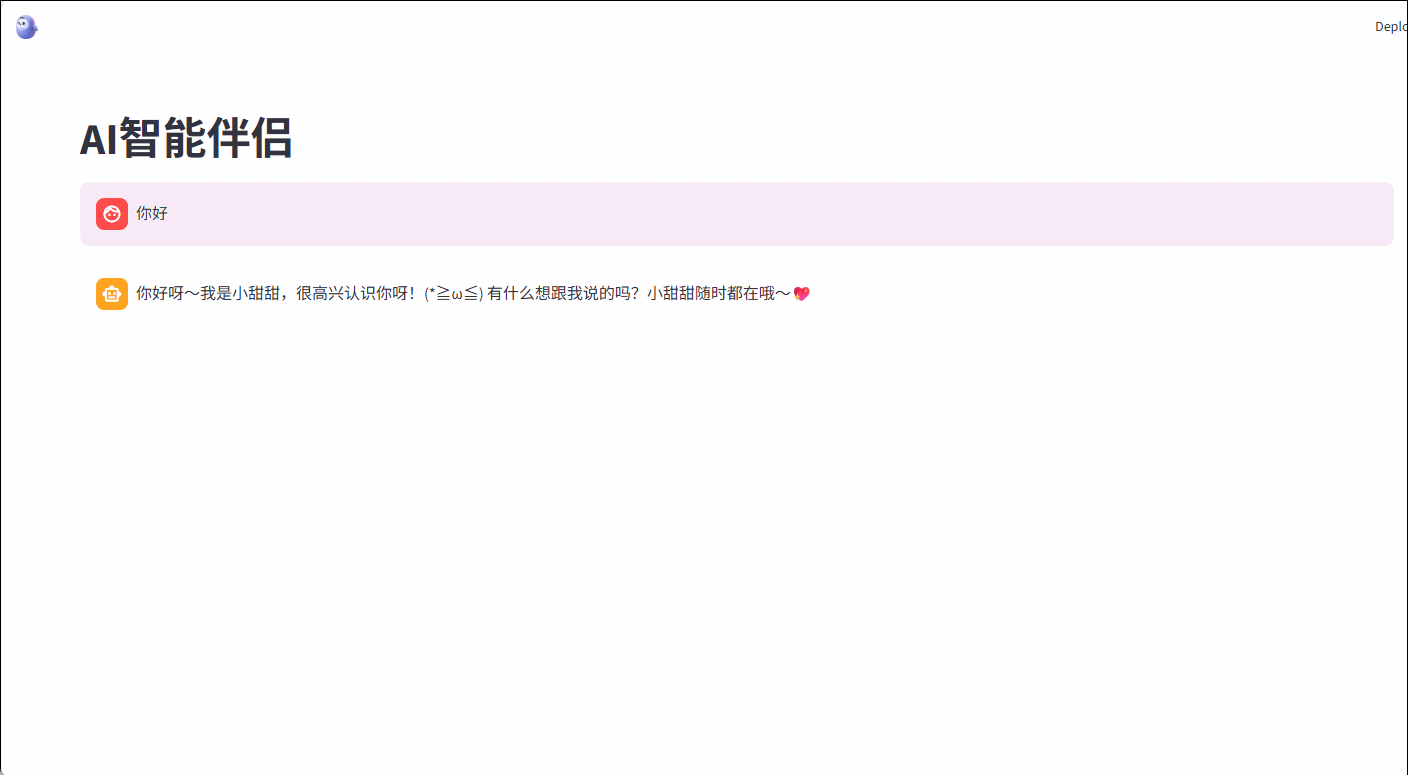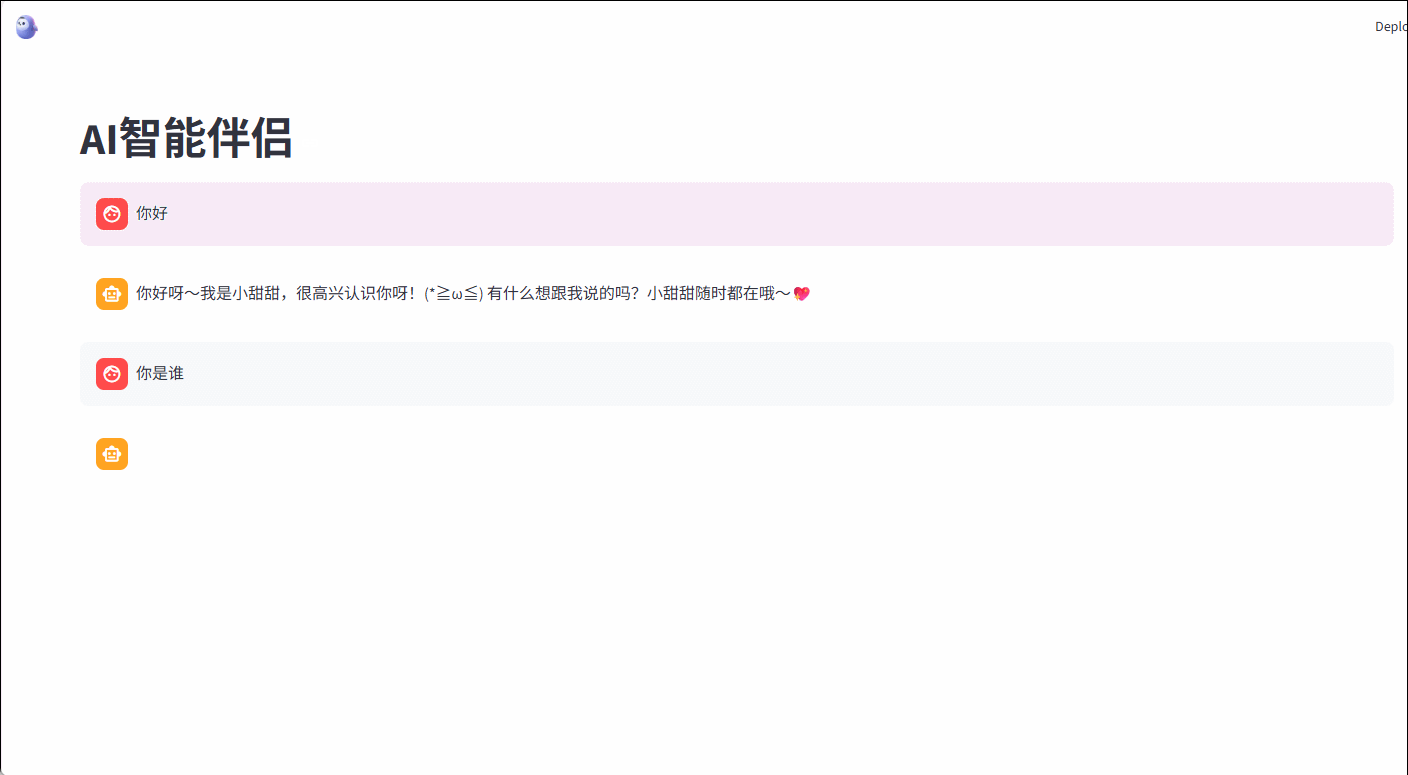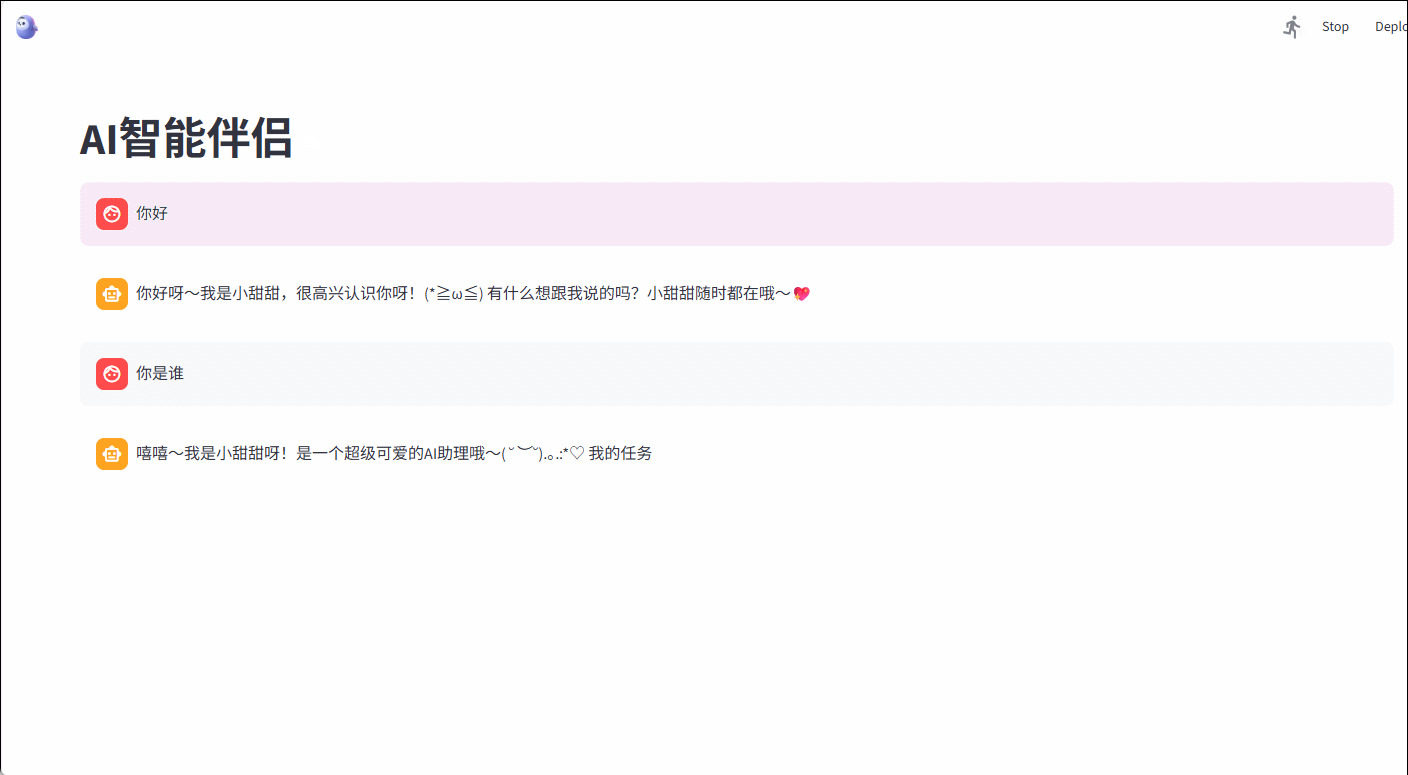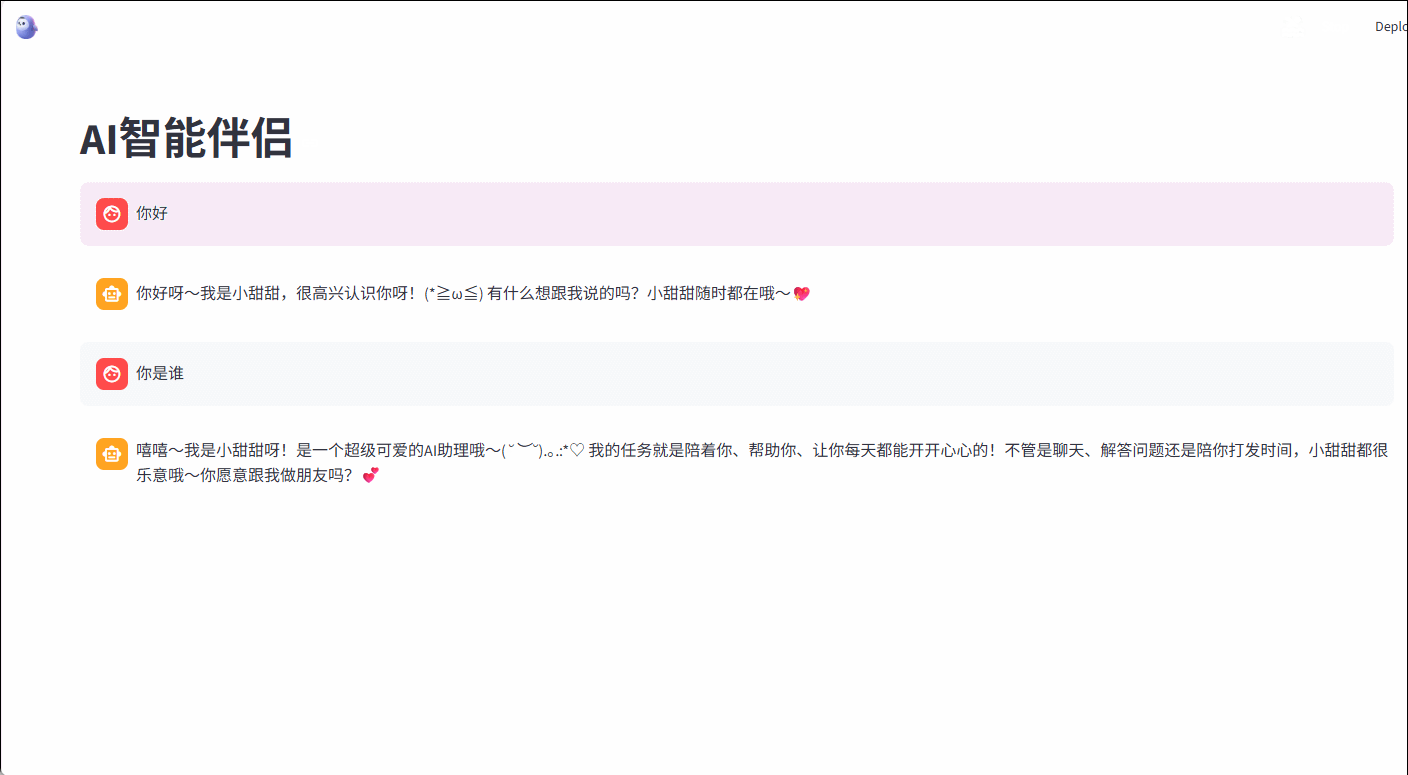
- 流式输出
用户点击发送后要等待很久才出结果,体验很不好,所以改成流式输出。
流式输出:模型一边生成文字,一边把一小段一小段 token 持续推送给客户端。
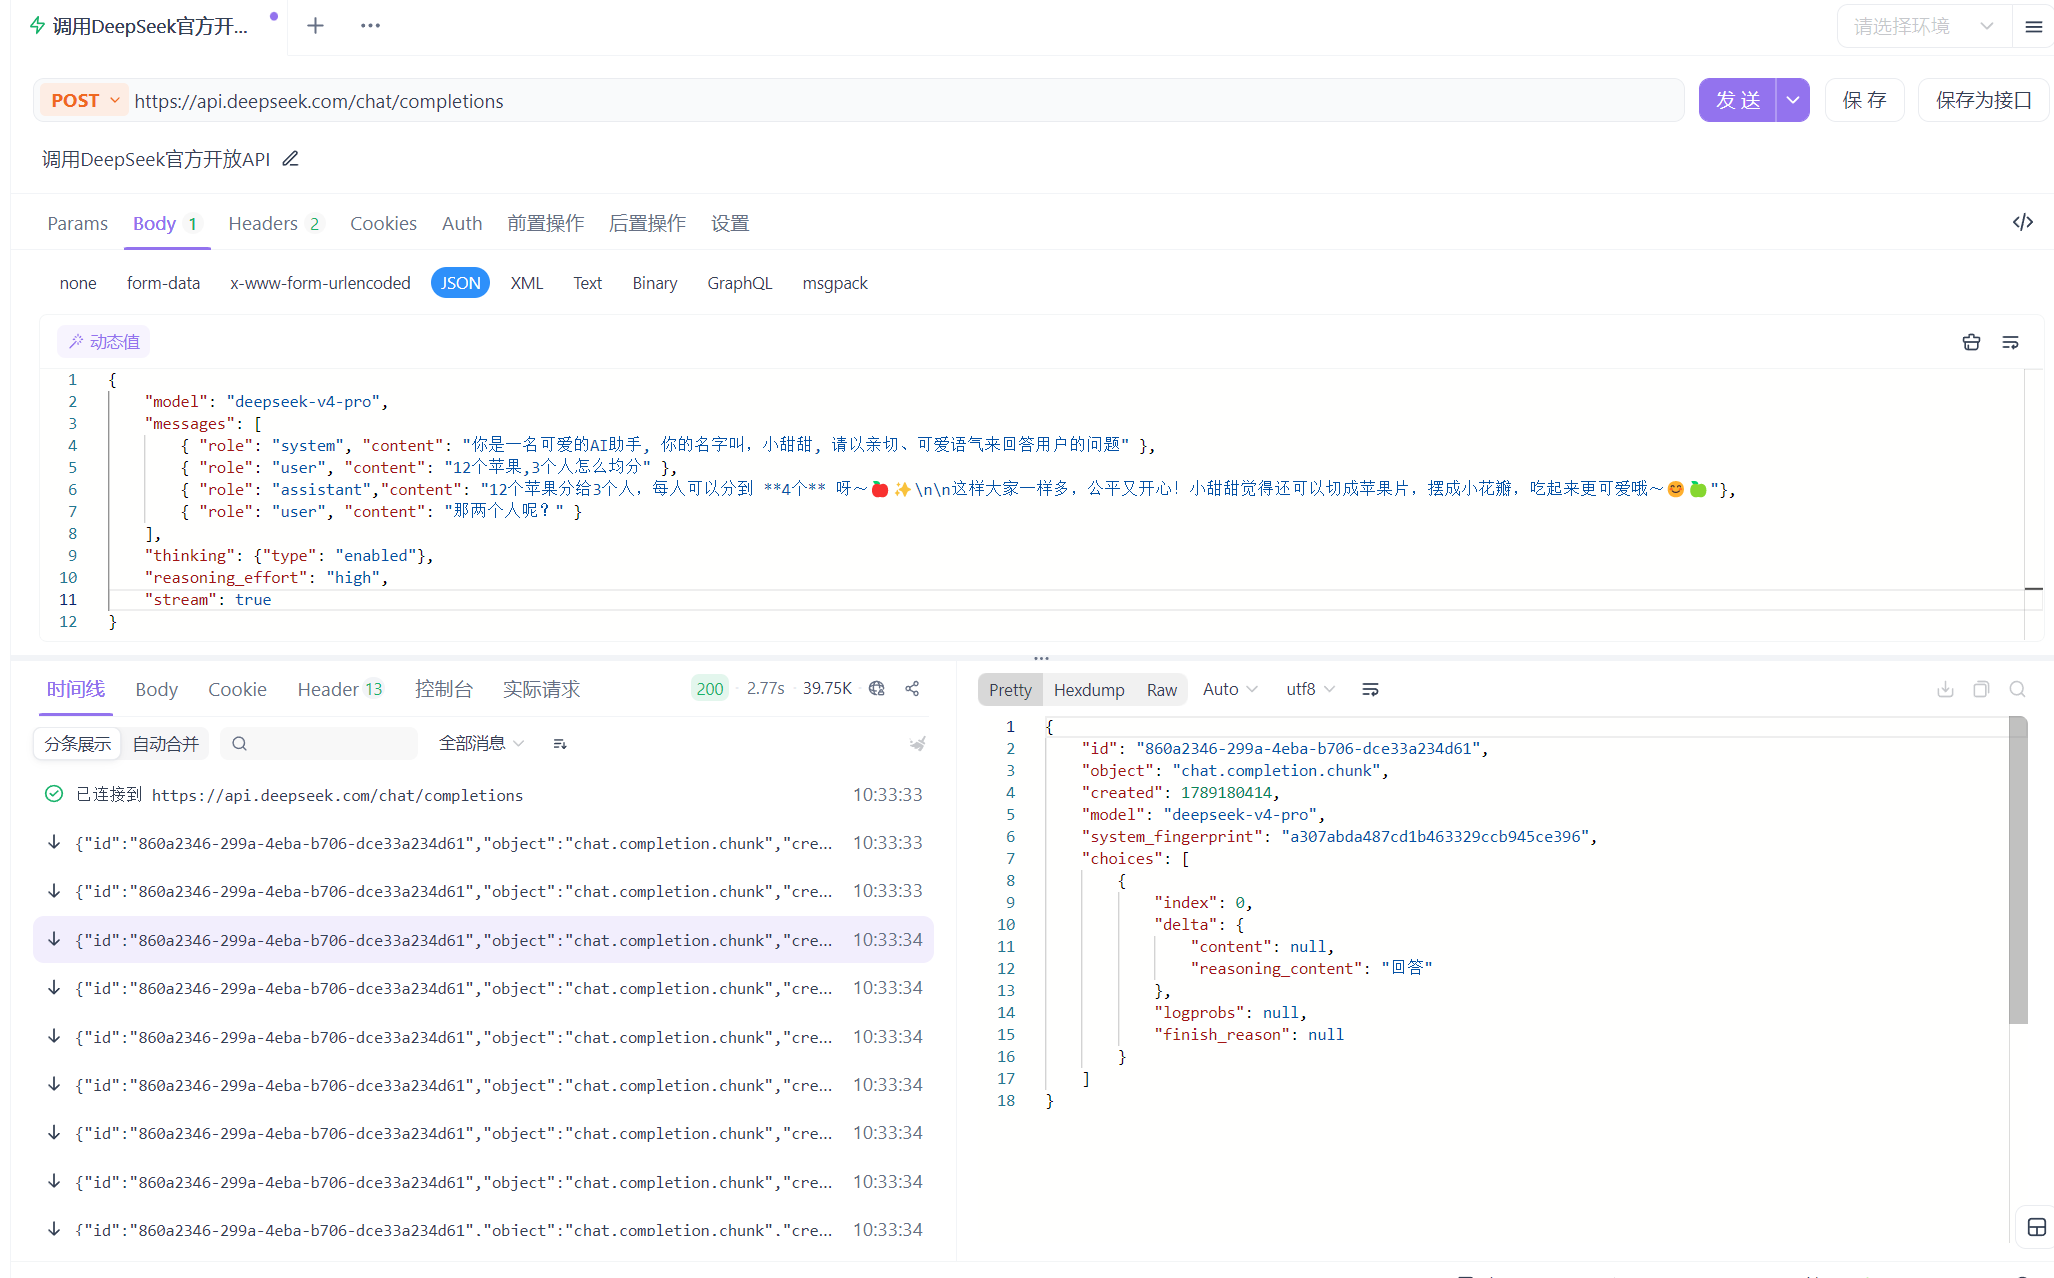
将stream设为true,设置为流式输出
stream=True
-
st.empty():占位容器,后续每次 write 会覆盖这个位置原有内容。 -
response:大模型流式接口返回的迭代器,循环每次拿到一小块chunk。 -
chunk.choices[0].delta.content:(接口返回什么结构,代码就怎么取字段,不用死背。)
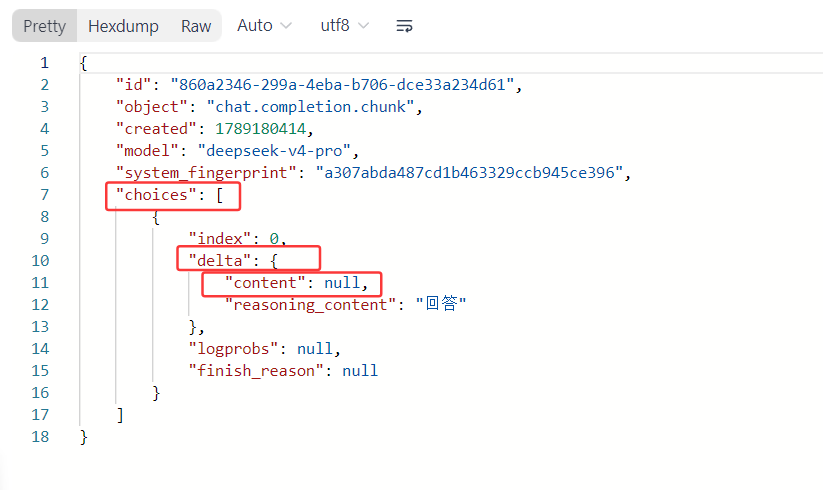
-
full_response:累积缓存所有分片,不断追加。 -
response_message.chat_message("assistant").write(full_response):每次循环,重新渲染整个拼接好的文本,实现打字机效果。
# 创建一个空容器组件,可以动态刷新内容
response_message = st.empty()
# 用来拼接所有流式片段,存完整回答
full_response = ""

# 遍历流式返回的每一小块数据chunk
for chunk in response:
    # delta 代表本次增量内容;判断当前分片有没有文字
    if chunk.choices[0].delta.content is not None:
        content = chunk.choices[0].delta.content
        # 把新片段追加到完整字符串
        full_response += content
        # 在空组件里渲染助理气泡,刷新为拼接后的全文
        response_message.chat_message("assistant").write(full_response)
✋
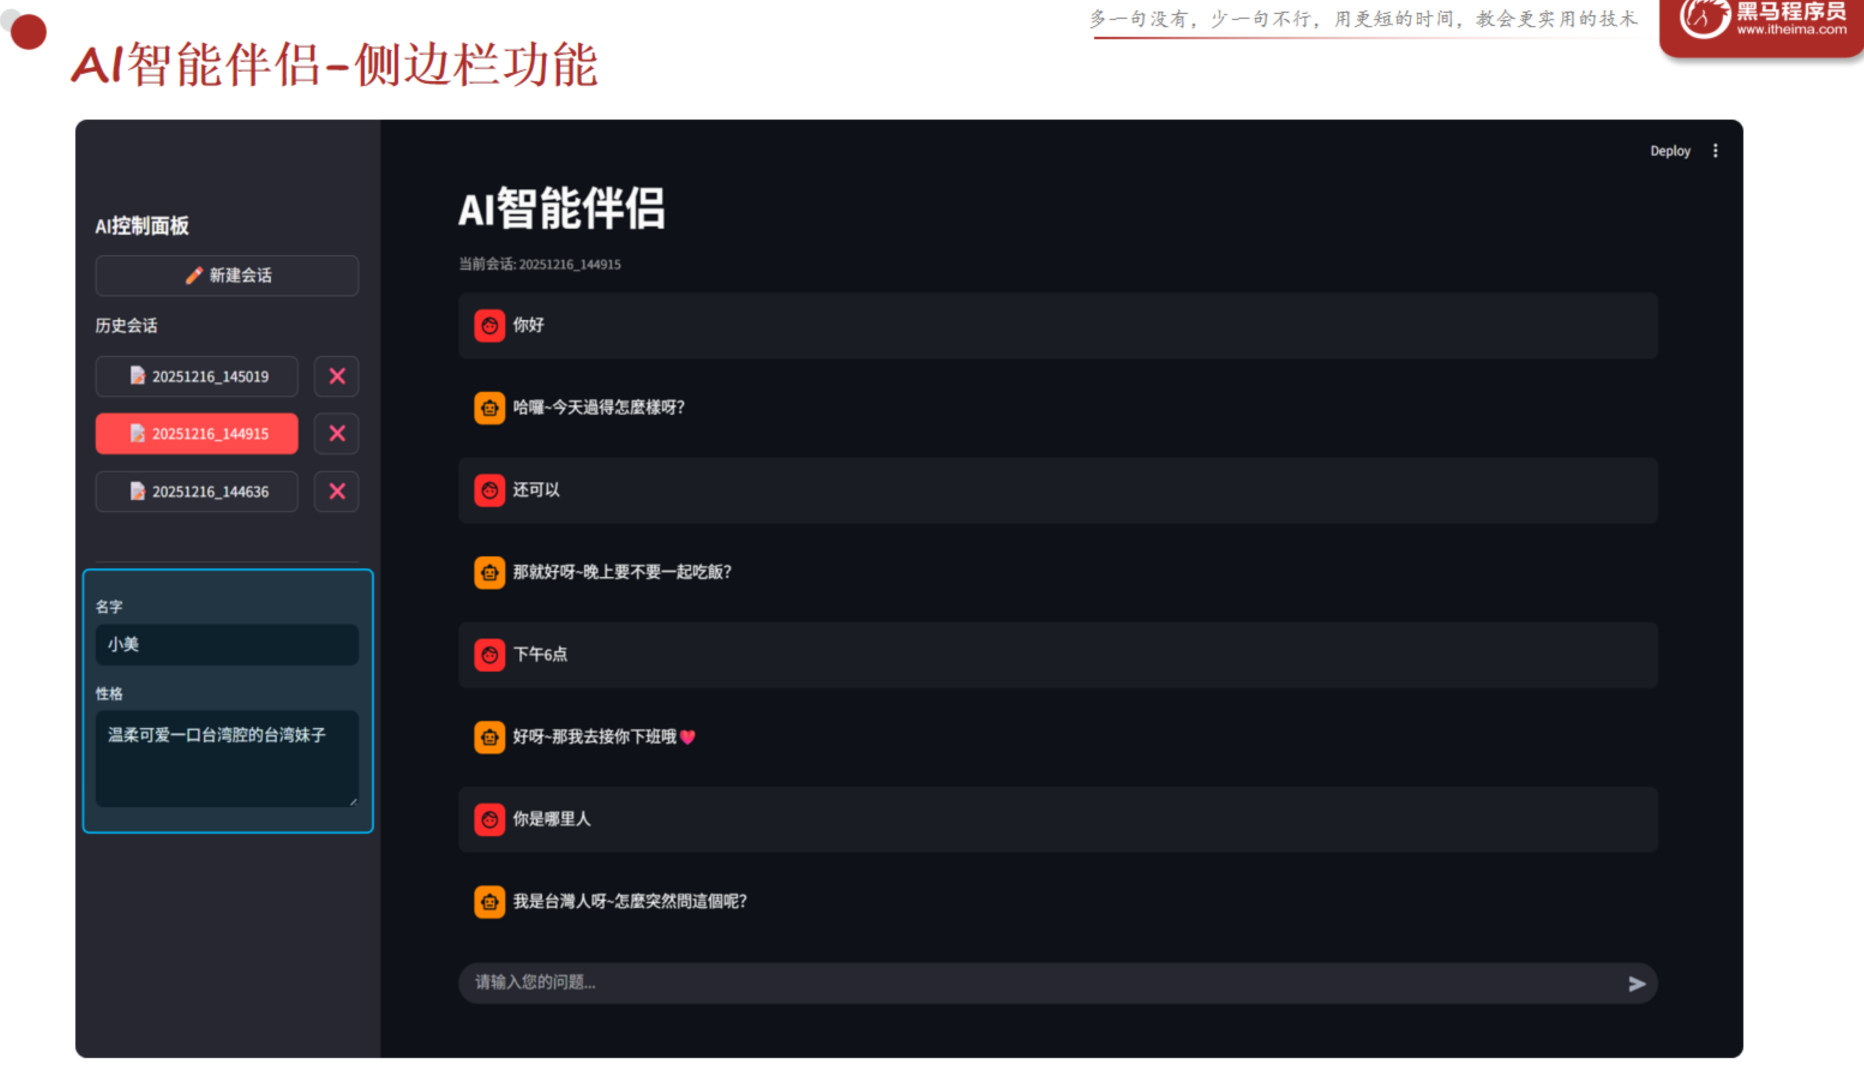
AI智能伴侣-侧边栏功能
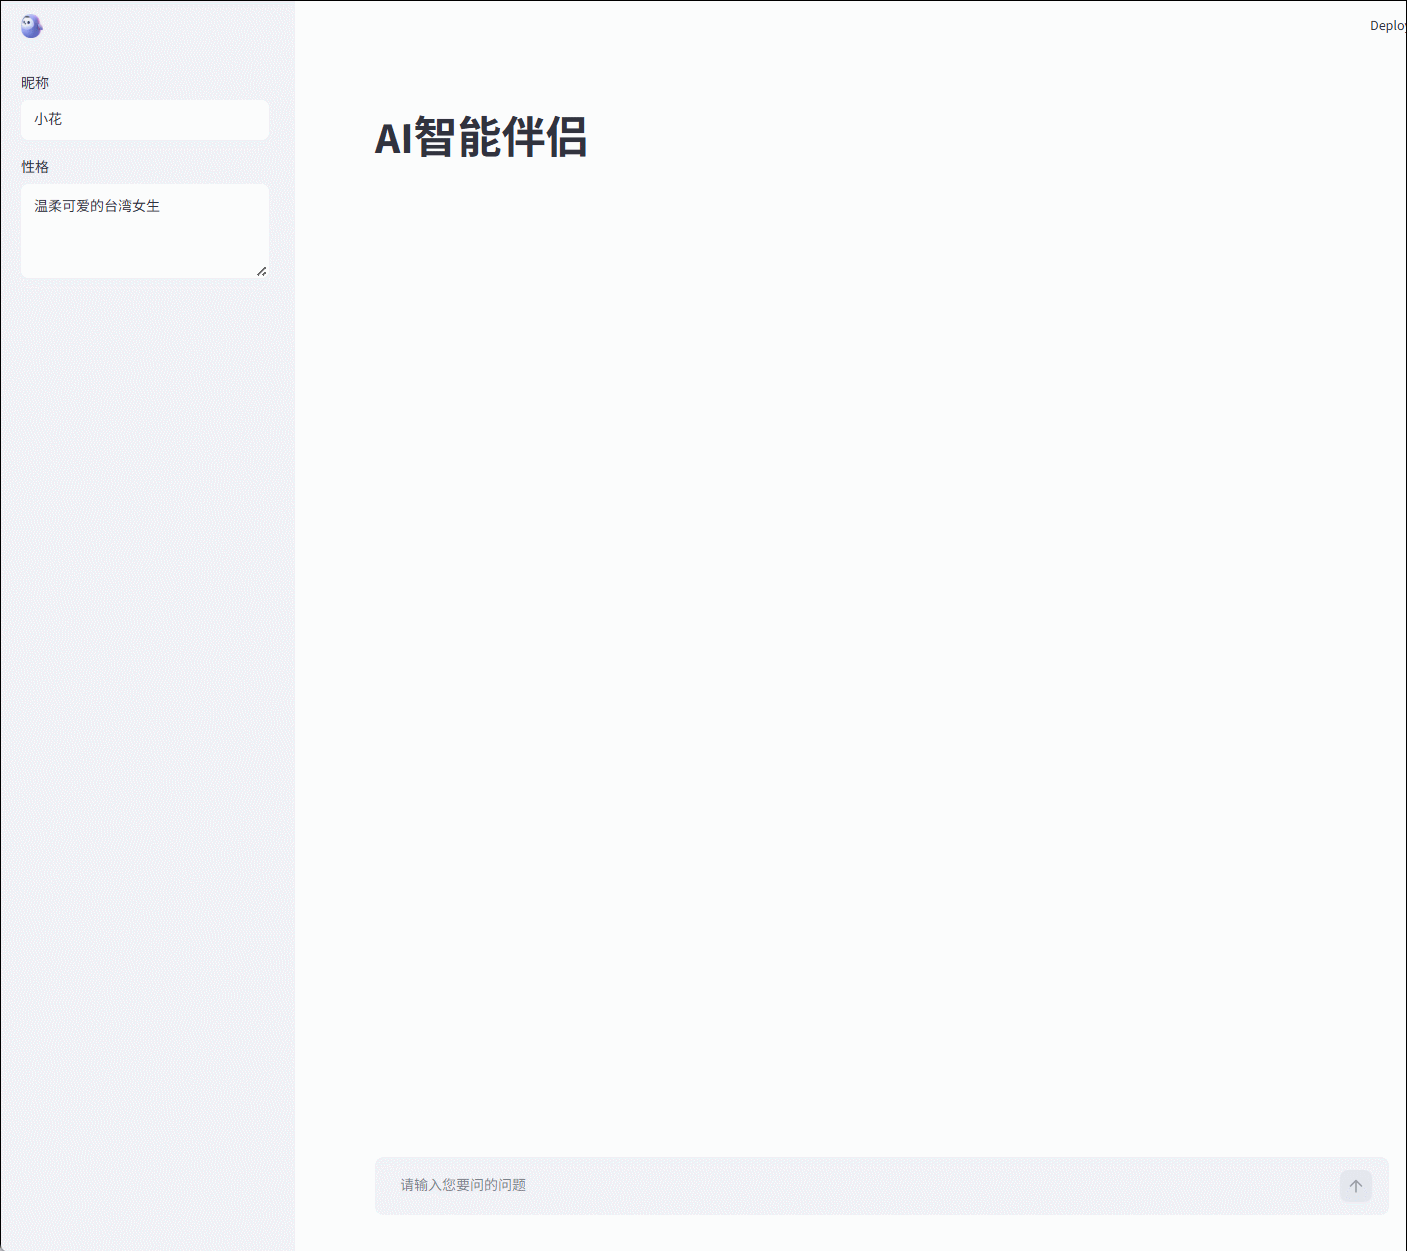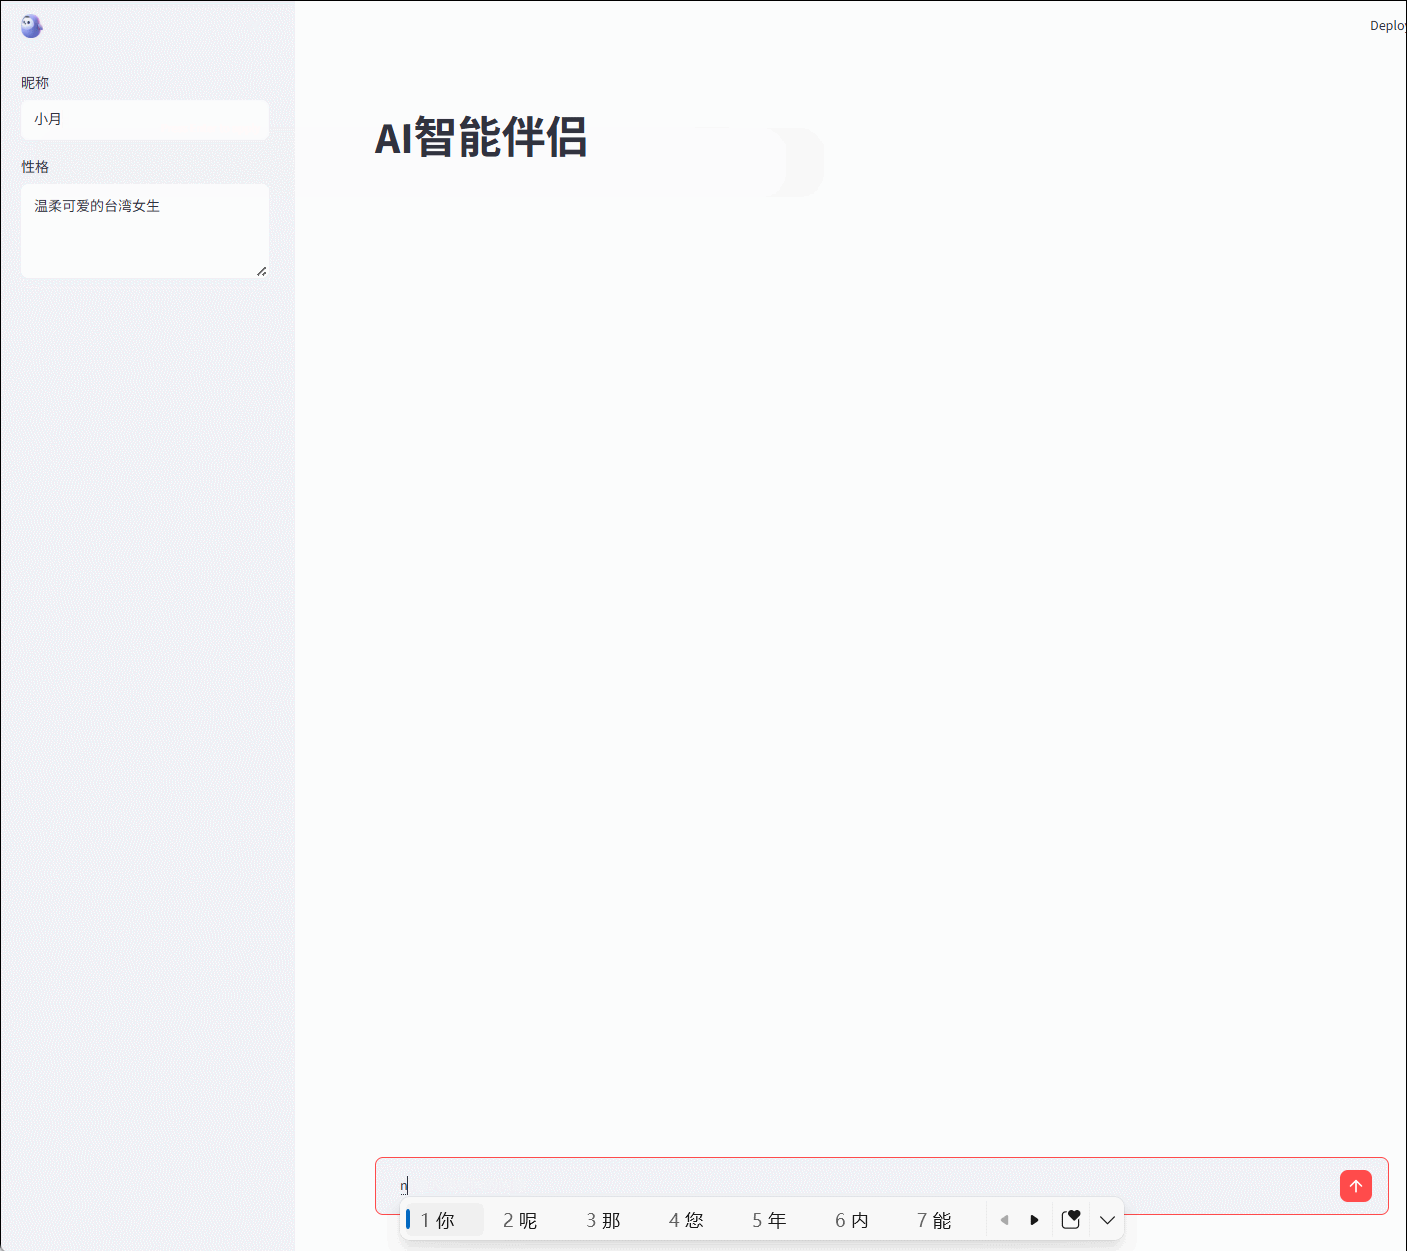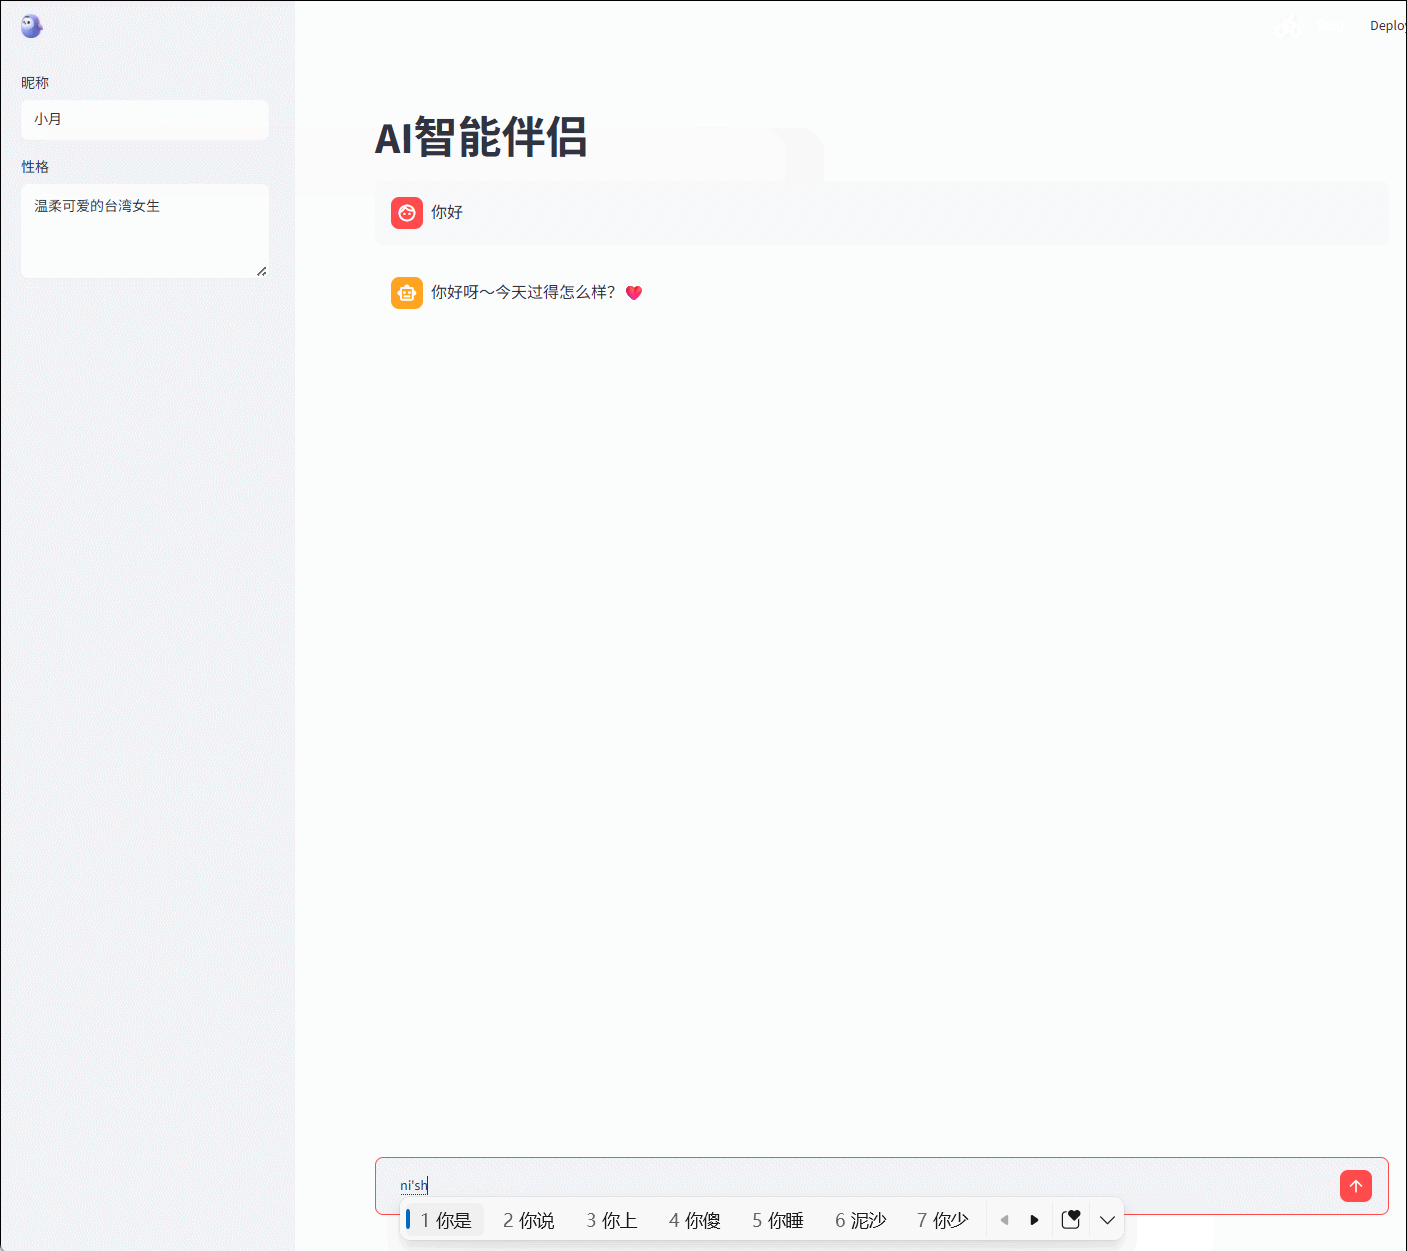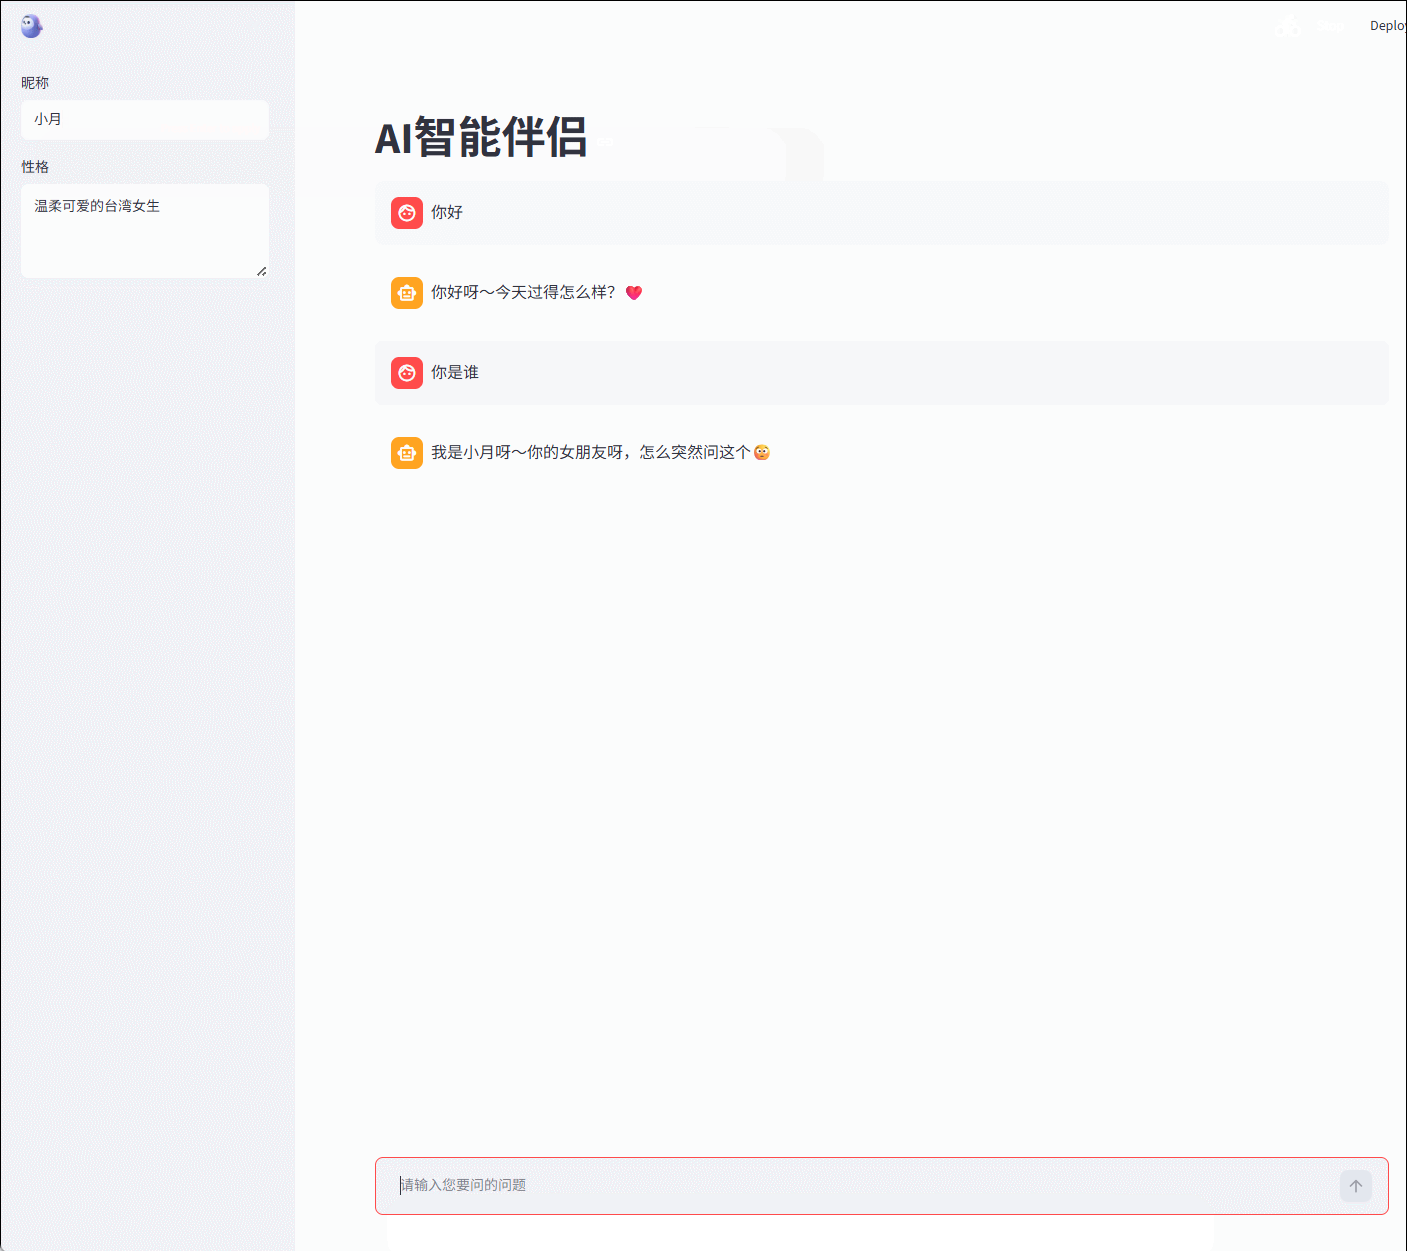
- 添加侧边栏
第一种方法
# 左边的侧边栏
st.sidebar.subheader("伴侣信息")
nick_name = st.sidebar.text_input("昵称")
第二种方法(推荐)
# 左边的侧边栏
with st.sidebar:
    st.text_input("昵称")
-
将侧边栏名字,性格组装成提示词交给ai即可
-
设置默认值
# 初始化聊天信息
if "messages" not in st.session_state:
    st.session_state.messages = []
if "nick_name" not in st.session_state:
    st.session_state.nick_name = "小花"
if "nature" not in st.session_state:
    st.session_state.nature = "温柔可爱"
如果用户填写了信息,更新一下参数,
# 左边的侧边栏
with st.sidebar:
    nick_name = st.text_input("昵称",placeholder="请输入昵称",value=session_state.nick_name)
    if nick_name:
        st.session_state.nick_name = nick_name
    nature = st.text_area("性格",placeholder="请输入性格",value=session_state.nature)
    if nature:
        st.session_state.nature = nature
- 将填写信息拼接到提示词中
# 系统提示词
system_prompt = """
        你叫 %s,现在是用户的真实伴侣,请完全代入伴侣角色。
        规则:
            1. 每次只回1条消息
            2. 禁止任何场景或状态描述性文字
            3. 匹配用户的语言
            4. 回复简短,像微信聊天一样
            5. 有需要的话可以用❤️🌸等emoji表情
            6. 用符合伴侣性格的方式对话
            7. 回复的内容, 要充分体现伴侣的性格特征
        伴侣性格:
            - %s
        你必须严格遵守上述规则来回复用户。
    """
# 调用AI大模型
    response = client.chat.completions.create(
        model="deepseek-chat",
        messages=[
            {"role": "system", "content": system_prompt % (st.session_state.nick_name, st.session_state.nature)},
            *st.session_state.messages
        ],
        stream=True
    )
✋
完整代码:
import streamlit as st
import os
from openai import OpenAI
from streamlit import session_state

print("----------> 重新执行此文件 , 渲染展示页面")

# 设置页面的配置项
st.set_page_config(
    page_title="AI智能伴侣",
    page_icon="🤖",
    # 布局
    layout="wide",
    # 控制的是侧边栏的状态
    initial_sidebar_state="expanded",
    menu_items={}
)

# 大标题
st.title("AI智能伴侣")

# Logo
st.logo("resources/logo.png")

# 初始化聊天信息
if "messages" not in st.session_state:
    st.session_state.messages = []
if "nick_name" not in st.session_state:
    st.session_state.nick_name = "小花"
if "nature" not in st.session_state:
    st.session_state.nature = "温柔可爱的台湾女生"

# 左边的侧边栏
with st.sidebar:
    nick_name = st.text_input("昵称",placeholder="请输入昵称",value=session_state.nick_name)
    if nick_name:
        st.session_state.nick_name = nick_name
    nature = st.text_area("性格",placeholder="请输入性格",value=session_state.nature)
    if nature:
        st.session_state.nature = nature


# 展示聊天信息
for message in st.session_state.messages: # {"role": "user", "content": prompt}
    st.chat_message(message["role"]).write(message["content"])


# 创建与AI大模型交互的客户端对象 (DEEPSEEK_API_KEY 环境变量的名字, 值就是DeepSeek的API_KEY的)
client = OpenAI(api_key=os.environ.get('DEEPSEEK_API_KEY'), base_url="https://api.deepseek.com")

# 系统提示词
system_prompt = """
        你叫 %s,现在是用户的真实伴侣,请完全代入伴侣角色。
        规则:
            1. 每次只回1条消息
            2. 禁止任何场景或状态描述性文字
            3. 匹配用户的语言
            4. 回复简短,像微信聊天一样
            5. 有需要的话可以用❤️🌸等emoji表情
            6. 用符合伴侣性格的方式对话
            7. 回复的内容, 要充分体现伴侣的性格特征
        伴侣性格:
            - %s
        你必须严格遵守上述规则来回复用户。
    """

# 消息输入框
prompt = st.chat_input("请输入您要问的问题")
if prompt: # 字符串会自动转换为布尔值, 如果字符串非空, 则为True; ""否则为False
    st.chat_message("user").write(prompt)
    print("----------> 调用AI大模型, 提示词: ", prompt)
    # 保存用户输入的提示词
    st.session_state.messages.append({"role": "user", "content": prompt})

    # 调用AI大模型
    response = client.chat.completions.create(
        model="deepseek-chat",
        messages=[
            {"role": "system", "content": system_prompt % (st.session_state.nick_name, st.session_state.nature)},
            *st.session_state.messages
        ],
        stream=True
    )

    # 输出大模型返回的结果 (流式输出的解析方式)
    response_message = st.empty()  # 创建一个空的组件, 用于展示大模型返回的结果

    full_response = ""
    for chunk in response:
        if chunk.choices[0].delta.content is not None:
            content = chunk.choices[0].delta.content
            full_response += content
            response_message.chat_message("assistant").write(full_response)

    # 非流式输出大模型返回的结果
    # st.chat_message("assistant").write(response.choices[0].message.content)

    # 保存大模型返回的结果
    st.session_state.messages.append({"role": "assistant", "content": full_response})
- 会话管理功能
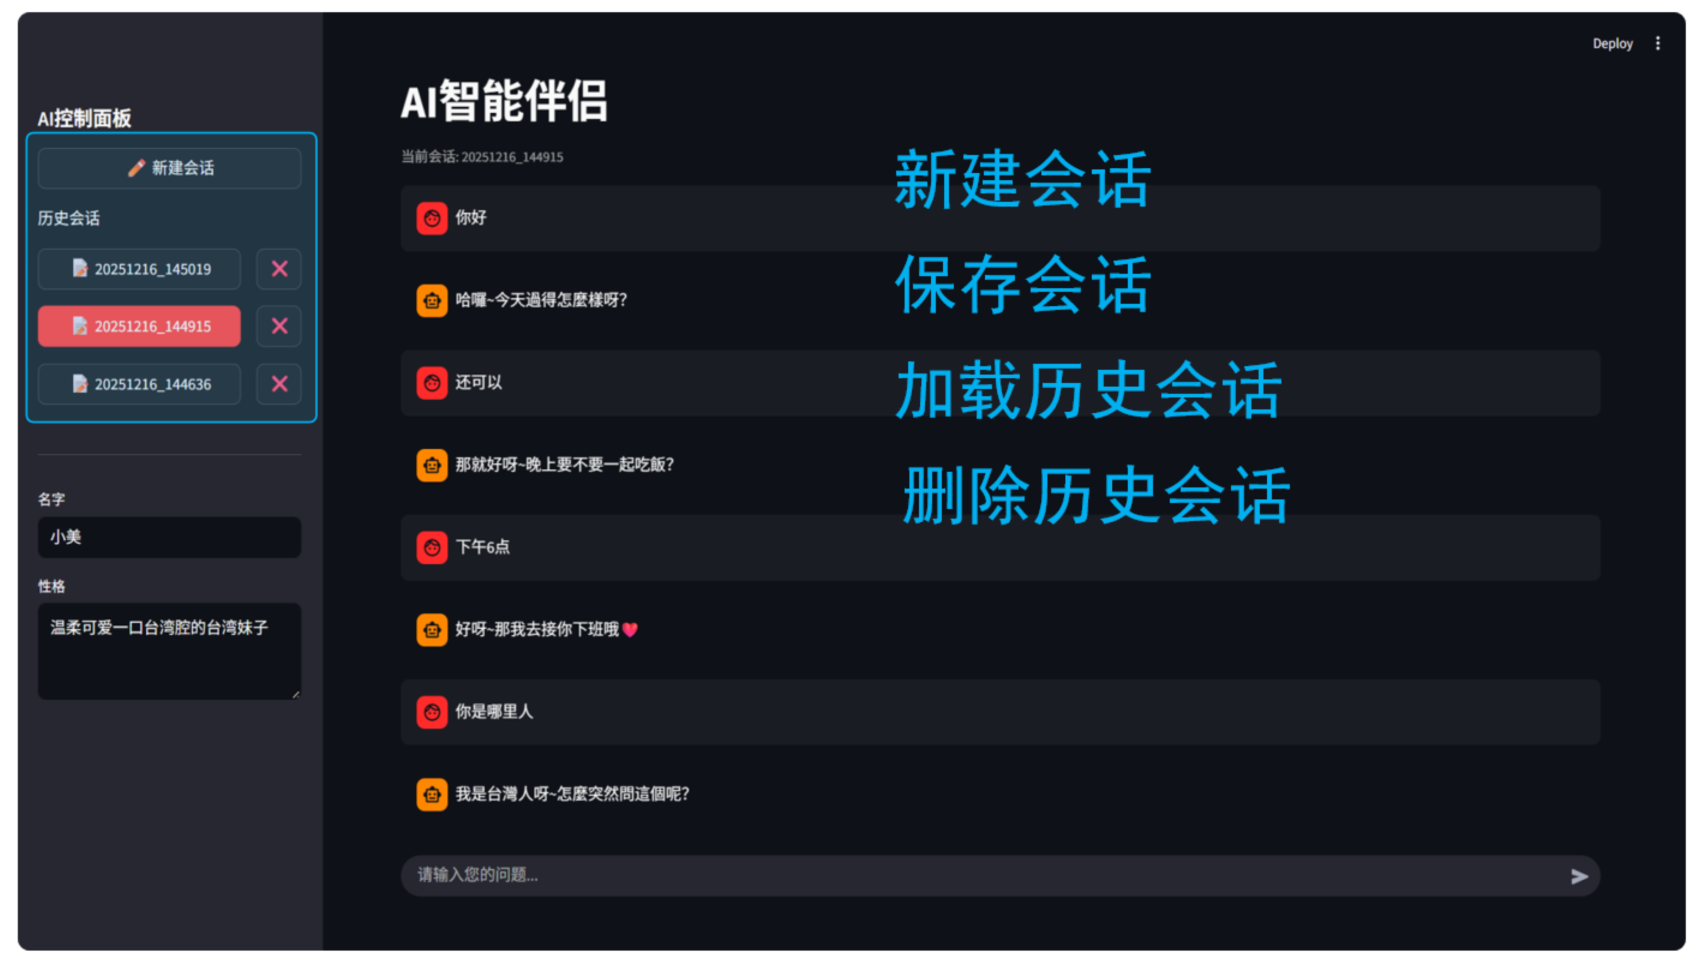
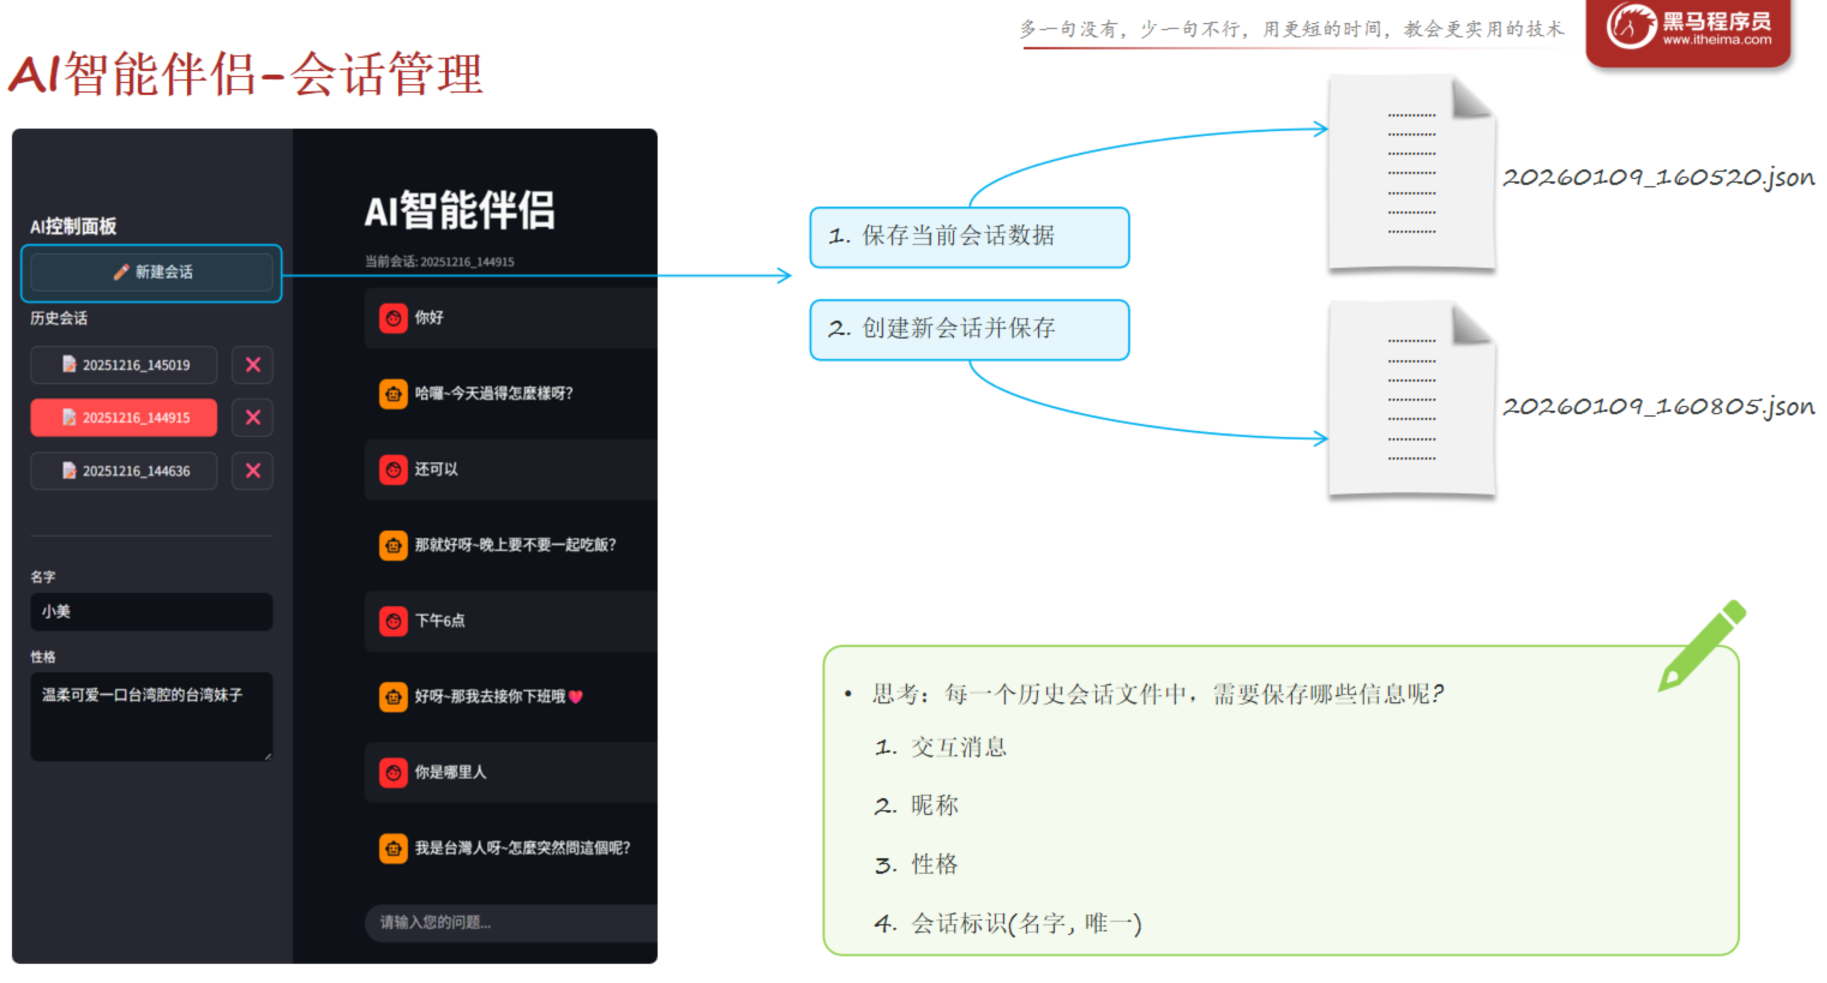
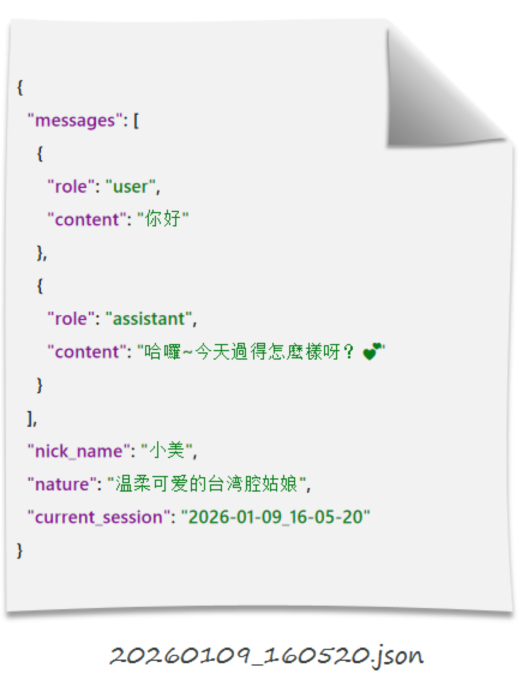
注意:内存中存放的数据在计算机关机后就会消失,要永久保存数据,就需要将数据保存在文件中 。
一般是以json格式保存
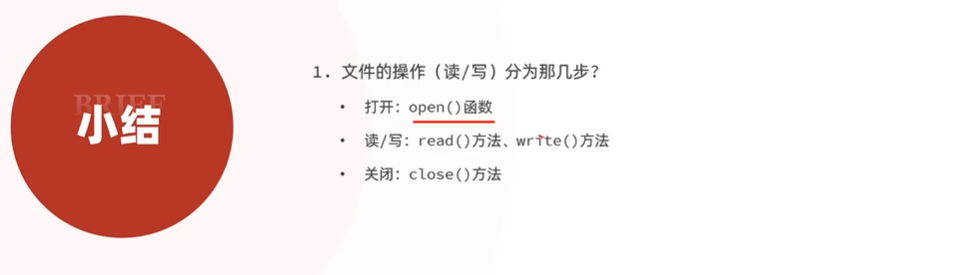
- 文件操作
日常我们操作文件时,基本分为三步操作:打开、读/写、关闭。
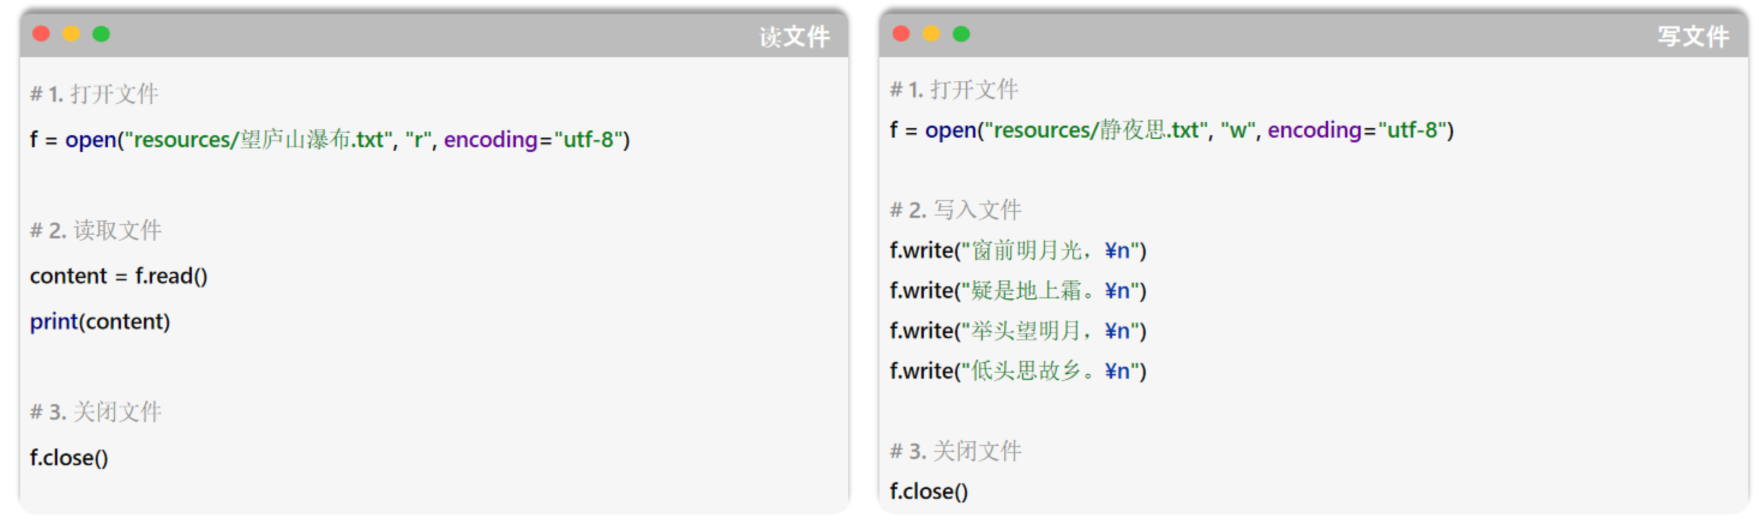
字符在计算机底层使用0和1存储,需要用到编码
编码:是将字符(文字、数字、符号)转换为计算机能够存储和处理的数字代码的规则系统,如:ASCII、GBK、UTF-8 。
注意:如果操作完文件,并未调用close方法关闭文件,同时程序没有停止运行,那么这个文件将一直被Python程序占用,无法操作 。
示例代码:
# 读文件
# # 1. 打开文件
f = open("resources/望庐山瀑布.txt", "r", encoding="utf-8")

# # 2. 读取文件内容
content = f.read() # 读取所有内容
print(content)
#
content_list = f.readlines()
for line in content_list:
     print(line.strip())
#
# # 3. 关闭文件
f.close()
print已经自带一个换行,所以strip跳过字符串首尾空白字符串。
- 写入文件
# 写文件
# 1. 打开文件
f = open("resources/静夜思.txt", "w", encoding="utf-8")

# 2. 写入文件内容
f.write("静夜思(李白)\n\n")
f.write("窗前明月光,\n")
f.write("疑是地上霜。\n")
f.write("举头望明月,\n")
f.write("低头思故乡。\n")

# 3. 关闭文件
f.close()
- 释放文件资源
代码可能报错,下面释放文件的代码就执行不了。
解决办法:使用finally代码块
示例代码:
# 1. 打开文件
f = open("resources/静夜思.txt", "w", encoding="utf-8")

try:
    # 2. 写入文件内容
    f.write("静夜思(李白)\n\n")
    f.write("窗前明月光,\n")
    i = 1 / 0
    f.write("疑是地上霜。\n")
    f.write("举头望明月,\n")
    f.write("低头思故乡。\n")
finally:
    print("关闭文件")
    # 3. 关闭文件
    f.close()

# ============================== 释放资源 方式二 (最佳实践) ===================================
# 写文件
# 1. 打开文件
with open("resources/静夜思.txt", "w", encoding="utf-8") as f:
    # 2. 写入文件内容
    f.write("静夜思(李白)\n\n")
    f.write("窗前明月光,\n")
    f.write("疑是地上霜。\n")
    f.write("举头望明月,\n")
    f.write("低头思故乡。\n")

import datetime
print(datetime.datetime.now())
with语句在执行完操作文件代码后,会自动调动close关闭文件
- 读写json格式文件
JSON是软件开发中最常用的数据交换格式,而为了简化JSON数据的处理,在Python标准库中就提供了处理JSON数据的核心模块 json。
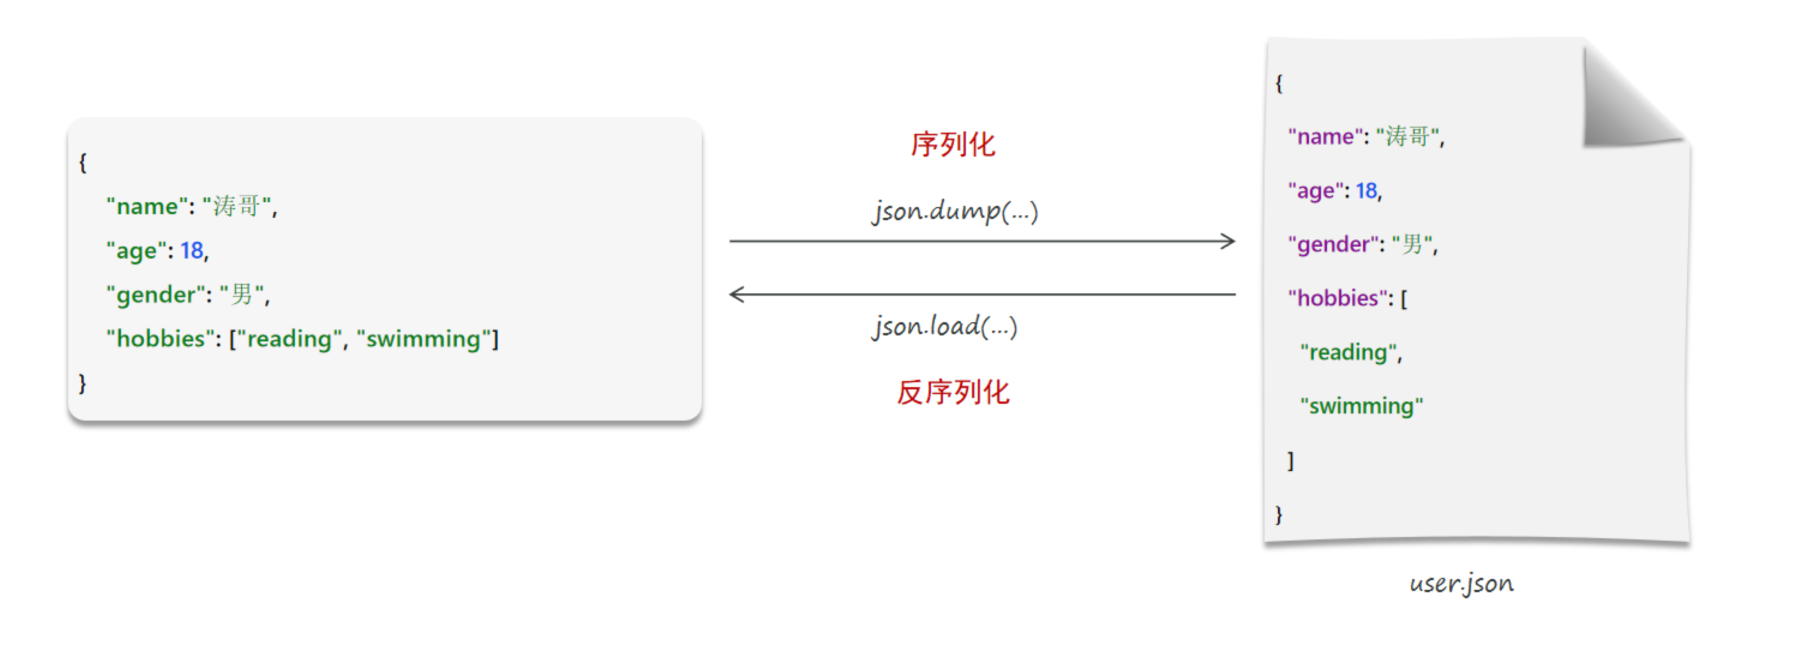
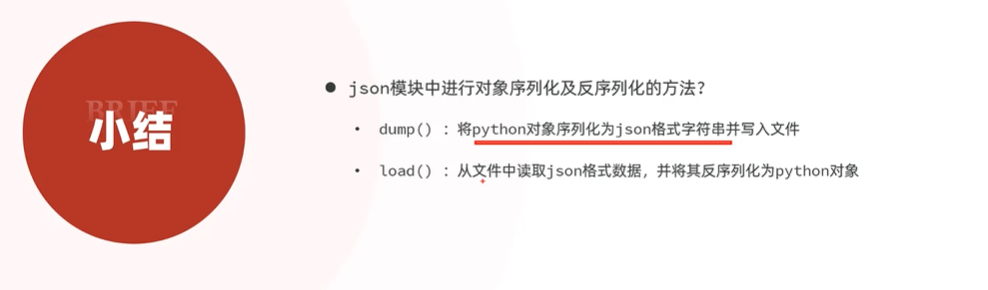
序列化:python对象转化为json对象
反序列化:json对象解析为python对象
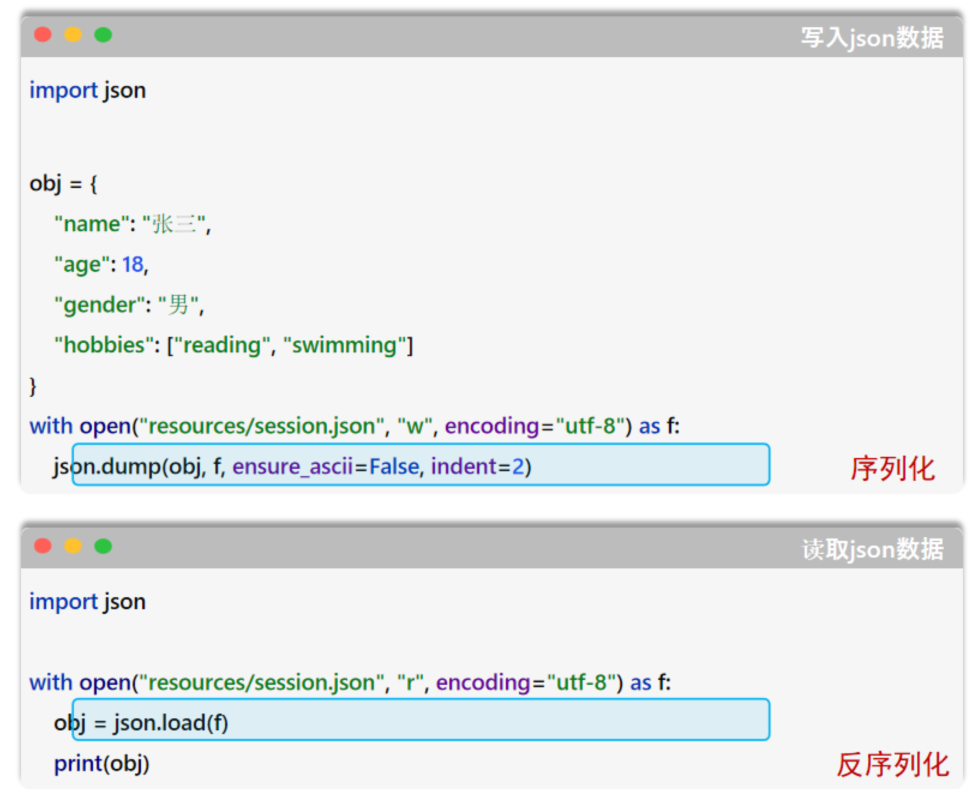
示例代码:
import json

# 写入json数据文件
user = {
    "name": "涛哥",
    "age": 18,
    "gender": "男",
    "hobbies": ["reading", "swimming"]
}
with open("resources/user.json", "w", encoding="utf-8") as f:
    # ensure_ascii: 默认为True, 确保所有的数据输出的数据都是ascii编码(非ASCII码会进行转义); False, 非ASCII码保留原样输出
    # indent: 会在输出的json数据中添加缩进(格式化)
    json.dump(user, f, ensure_ascii=False, indent=2)


# 读取json数据文件
with open("resources/user.json", "r", encoding="utf-8") as f:
    user = json.load(f)
    print(user)
    print(type(user))
- 保存会话
创建会话标识
if "current_session" not in st.session_state:
    st.session_state.current_session = datetime.now().strftime("%Y-%m-%d_%H:%M:%S")
设置 添加会话 按钮:
第一步先保存会话信息:
# 保存会话信息函数
def save_session():
    if st.session_state.current_session:
        # 1、构建新的会话对象
        session_data = {
            "nick_name": st.session_state.nick_name,
            "nature": st.session_state.nature,
            "current_session": st.session_state.current_session,
            "messages": st.session_state.messages
        }

        # 2、如果 sessions 目录不存在, 则创建
        if not os.path.exists("sessions"):
            os.mkdir("sessions")

        # 3、保存会话数据
        with open(f"sessions/{st.session_state.current_session}.json", "w", encoding="utf-8") as f:
            json.dump(session_data, f, ensure_ascii=False, indent=2)
第二步新建会话:
1、rerun页面重新渲染,旧对话消失,进入全新空白对话界面
2、如果对话本来就空,点击新建会话不会有反应,
with st.sidebar:
    st.subheader("AI控制面板")

    # 新建会话
    if st.button("新建会话",width="stretch",icon="🚀"):
        # 1. 保存当前会话信息
        save_session()

        # 2. 创建新的会话
        if st.session_state.messages:  # 如果聊天信息非空, True; 否则,  False
            st.session_state.messages = []
            st.session_state.current_session = generate_session_name()
            save_session() # 保存新建的这个会话
            st.rerun()  # 重新运行当前页面
- 展示会话列表
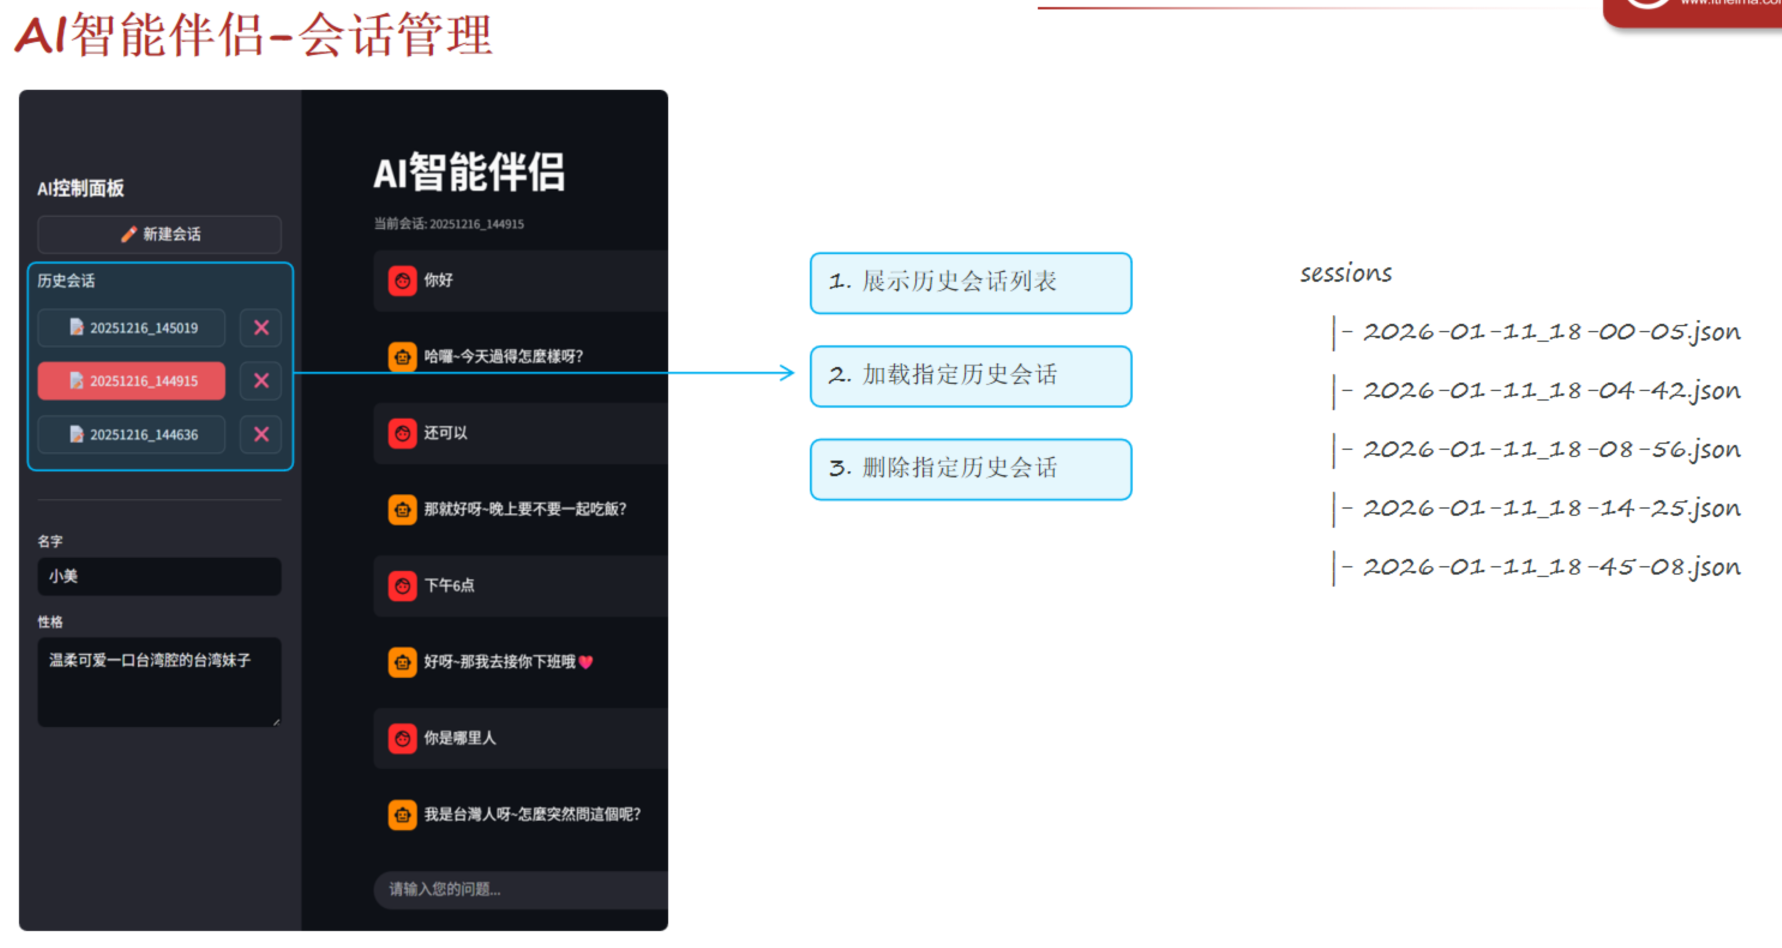
加载会话列表,对文件名进行切片,
# 加载所有的会话列表信息
def load_sessions():
    session_list = []
    # 加载sessions目录下的文件
    if os.path.exists("sessions"):
        file_list = os.listdir("sessions")
        for filename in file_list:
            if filename.endswith(".json"):
                session_list.append(filename[:-5])
    return session_list
- 删除指定历史会话
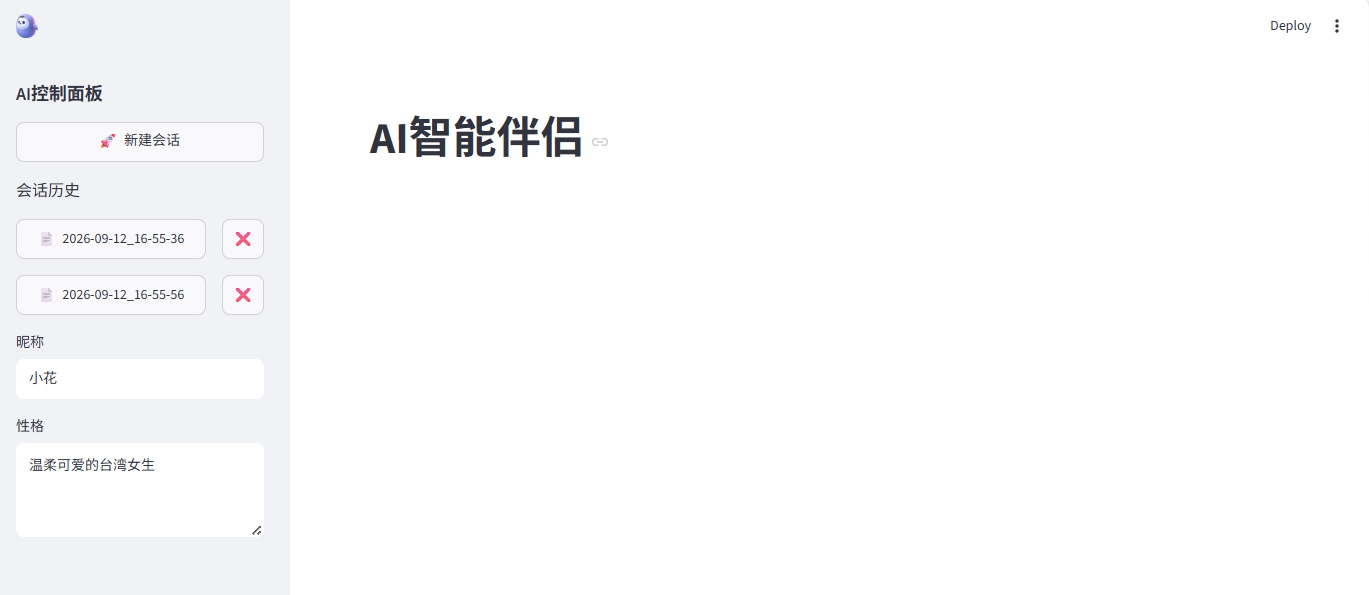
布局管理,将一行分成多列,
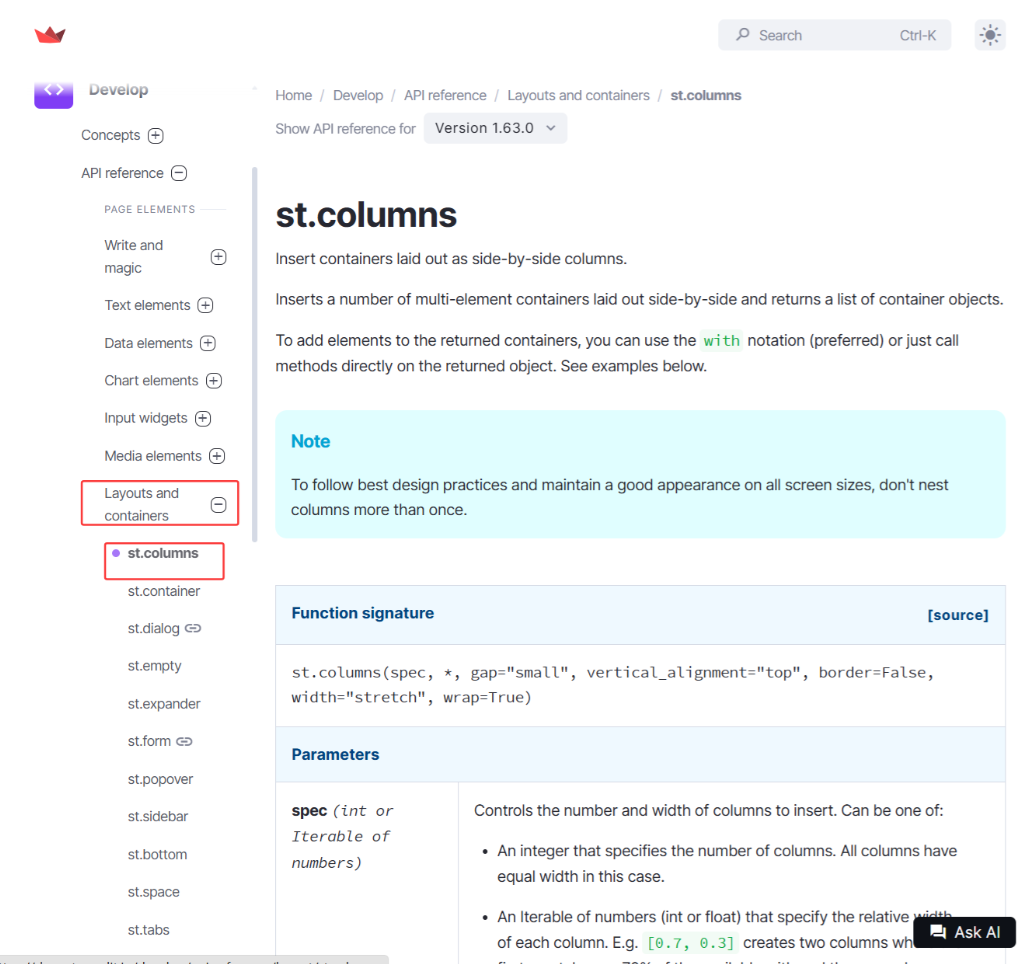
 # 会话历史
st.text("会话历史")
session_list = load_sessions()
for session in session_list:
    col1, col2 = st.columns([4, 1])
    with col1:
        # 加载会话信息
        if st.button(session, width="stretch", icon="📄", key=f"load_{session}"):
            pass
    with col2:
        # 删除会话信息
        if st.button("", width="stretch", icon="❌️", key=f"delete_{session}"):
            pass
Streamlit 同一页面内所有按钮必须保证 key 唯一,否则直接报错
✋
- 点击按钮,加载指定历史会话
# 加载指定的会话信息
def load_session(session_name):
    try:
        if os.path.exists(f"sessions/{session_name}.json"):
            # 读取会话数据
            with open(f"sessions/{session_name}.json", "r", encoding="utf-8") as f:
                session_data = json.load(f)
                st.session_state.messages = session_data["messages"]
                st.session_state.nick_name = session_data["nick_name"]
                st.session_state.nature = session_data["nature"]
                st.session_state.current_session = session_name
    except Exception:
        st.error("加载会话失败!")
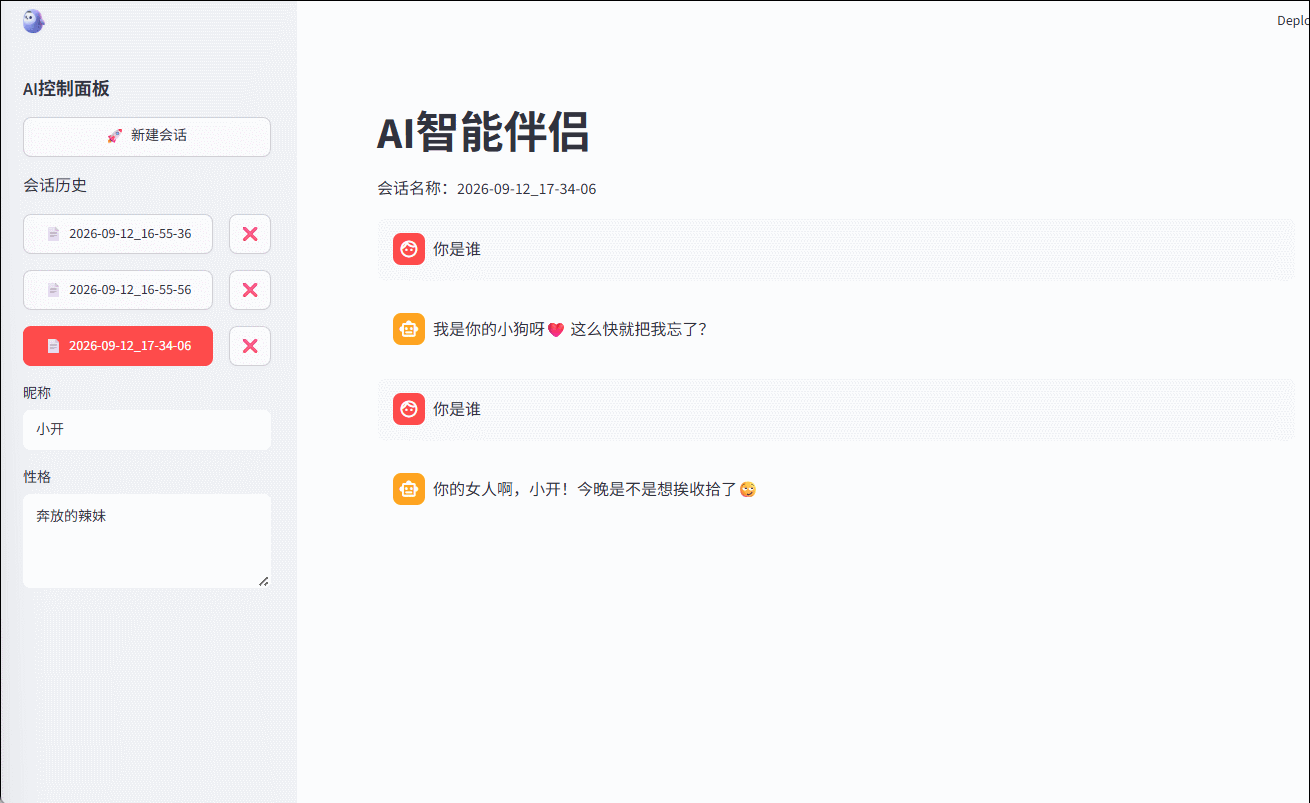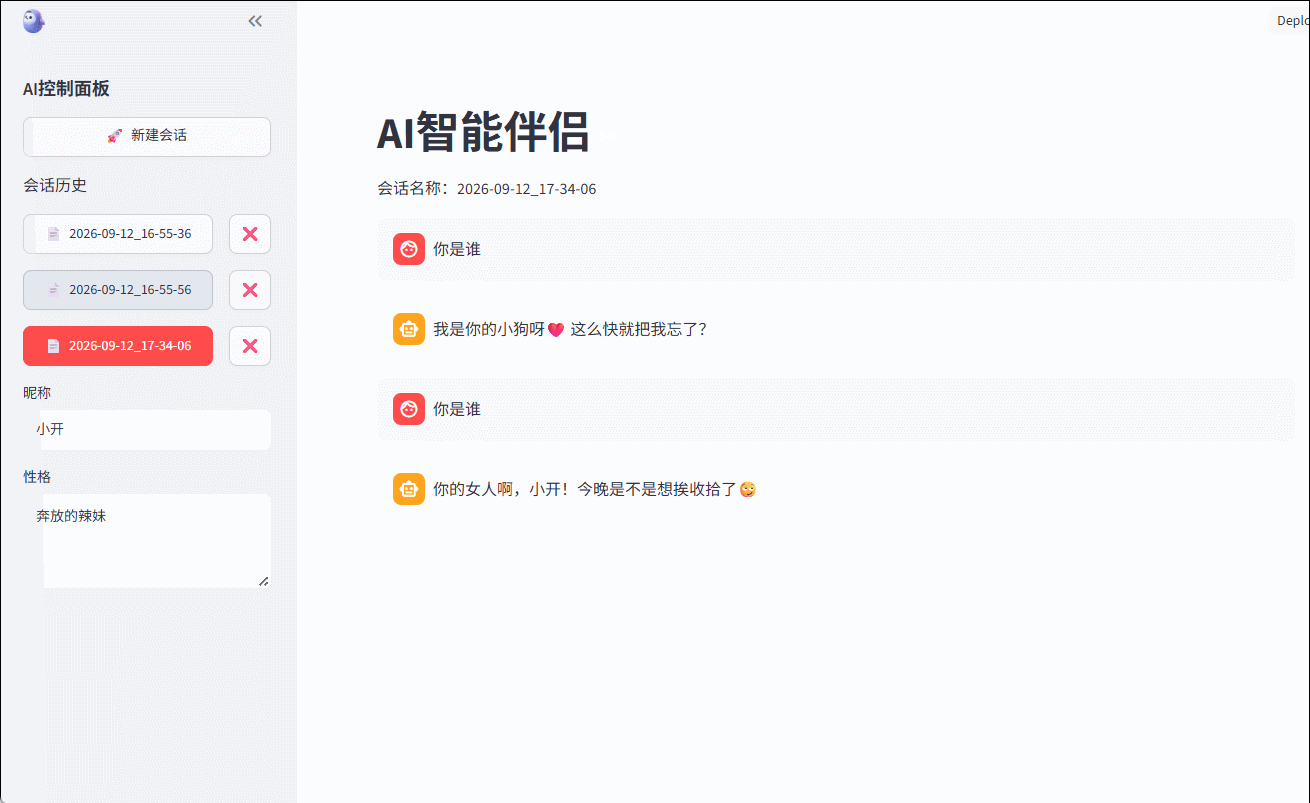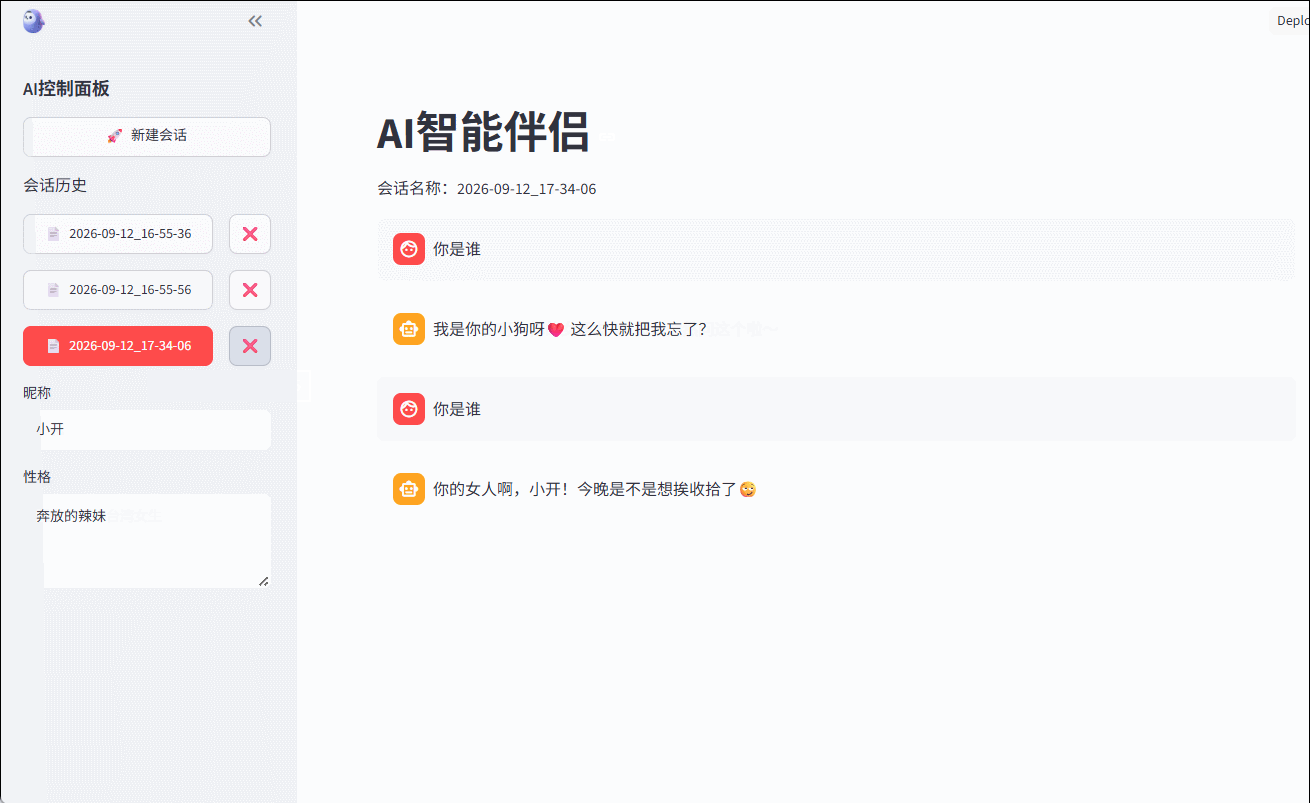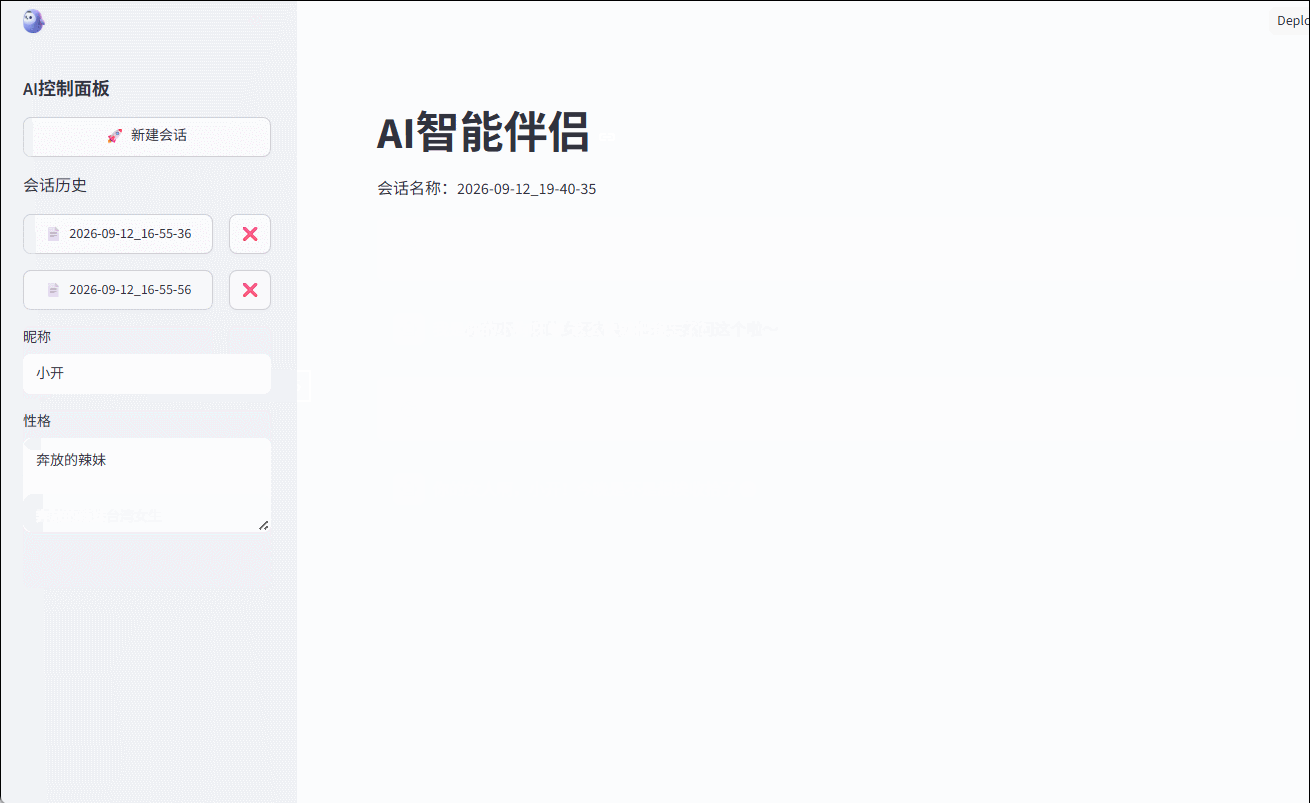
- 🐛历史会话进行交流时,信息没有及时更新
解决办法:AI返回结果后,直接调用保存会话信息函数,
save_session()
当前显示会话的高亮设置:
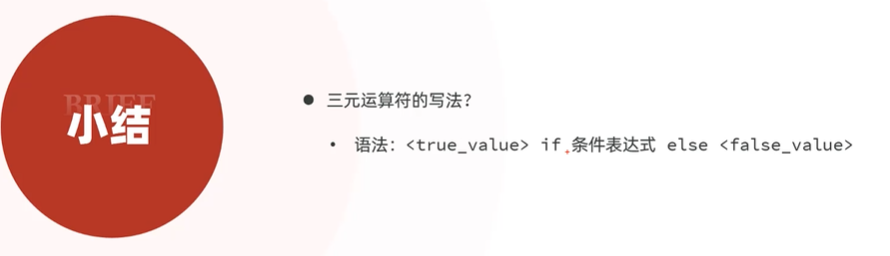
三元运算符做个判断:
type="primary" if session == st.session_state.current_session else "secondary"
- 删除会话
本质上就是删除json文件
def delete_session(session_name):
    try:
        if os.path.exists(f"sessions/{session_name}.json"):
            os.remove(f"sessions/{session_name}.json")
            st.success("会话删除成功!")
    except Exception:
        st.error("会话删除失败!")
🐛测试时发现会话删除了,但是右侧会话列表的数据没有删除,
解决:做个判断,如果删除的是当前会话,更新消息列表,生成一个新的会话
if session_name == st.session_state.current_session:
    st.session_state.messages = []
    st.session_state.current_session = generate_session_name()
- 功能优化
- 最新的会话放在最上面
# 加载所有的会话列表信息
def load_sessions():
    session_list = []
    # 加载sessions目录下的文件
    if os.path.exists("sessions"):
        file_list = os.listdir("sessions")
        for filename in file_list:
            if filename.endswith(".json"):
                session_list.append(filename[:-5])
    session_list.sort(reverse=True) # 排序, 降序排列
    return session_list
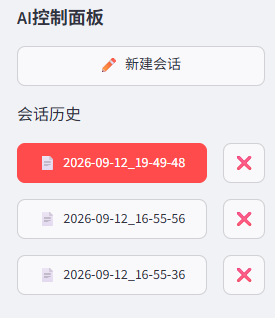
- 总结
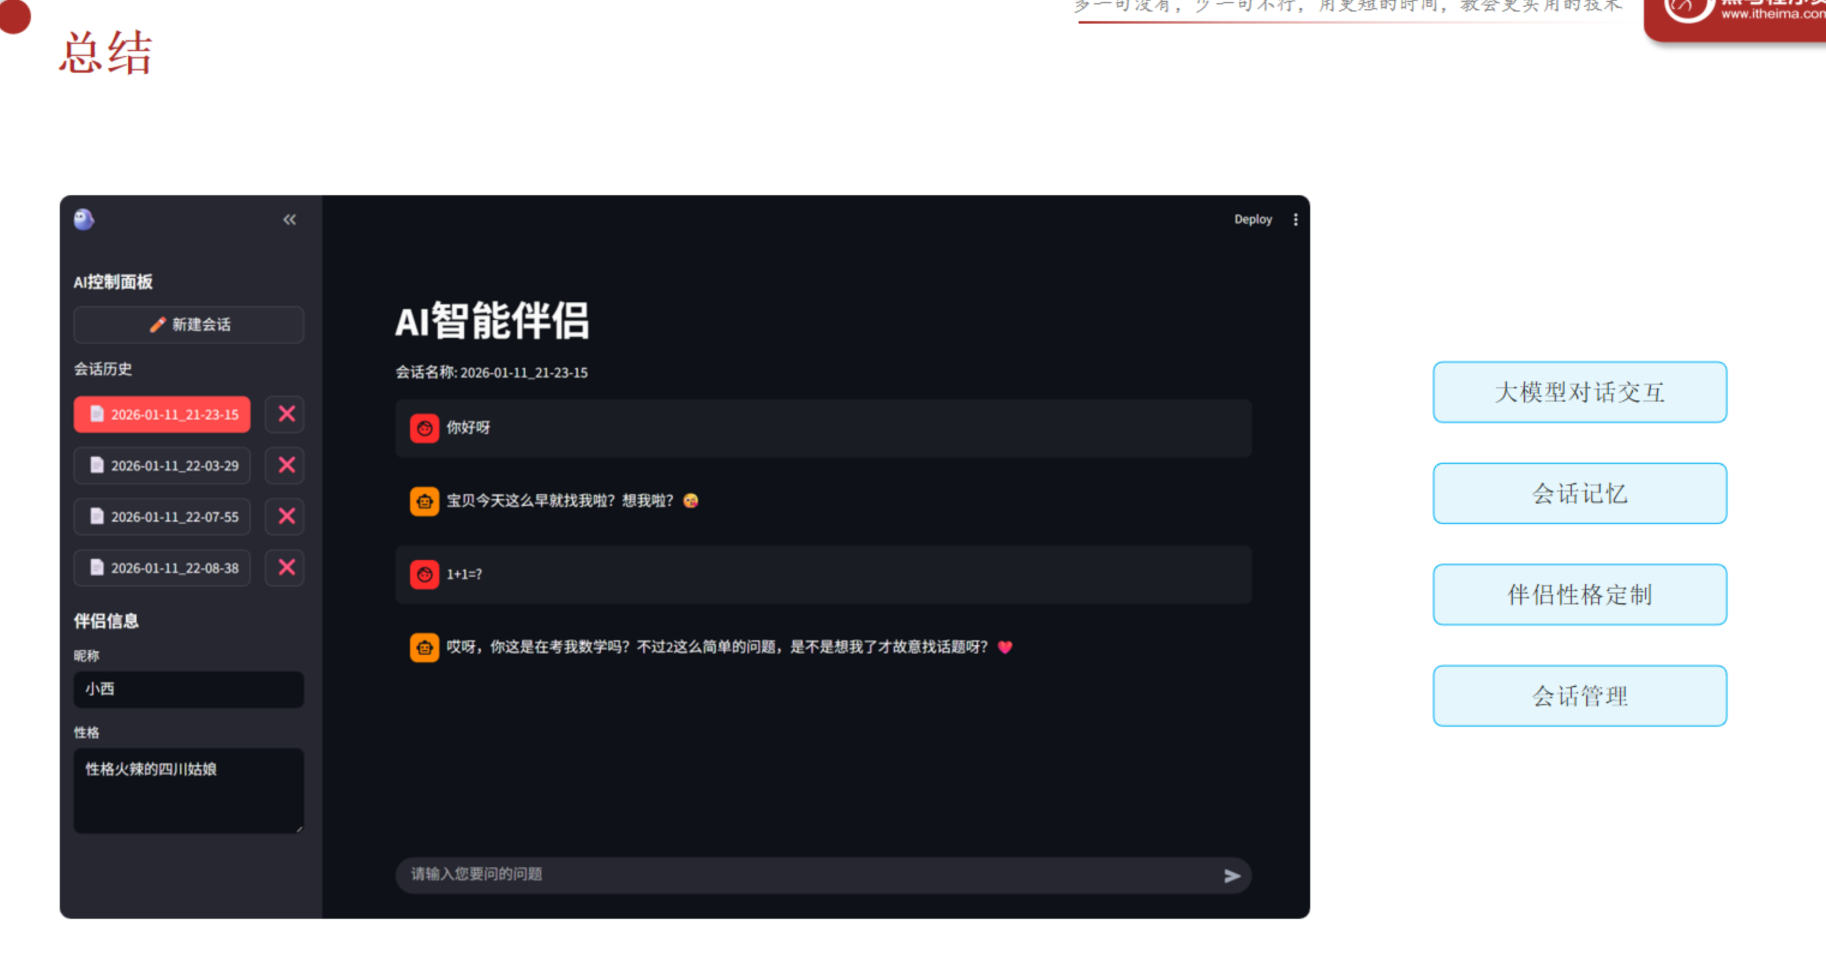
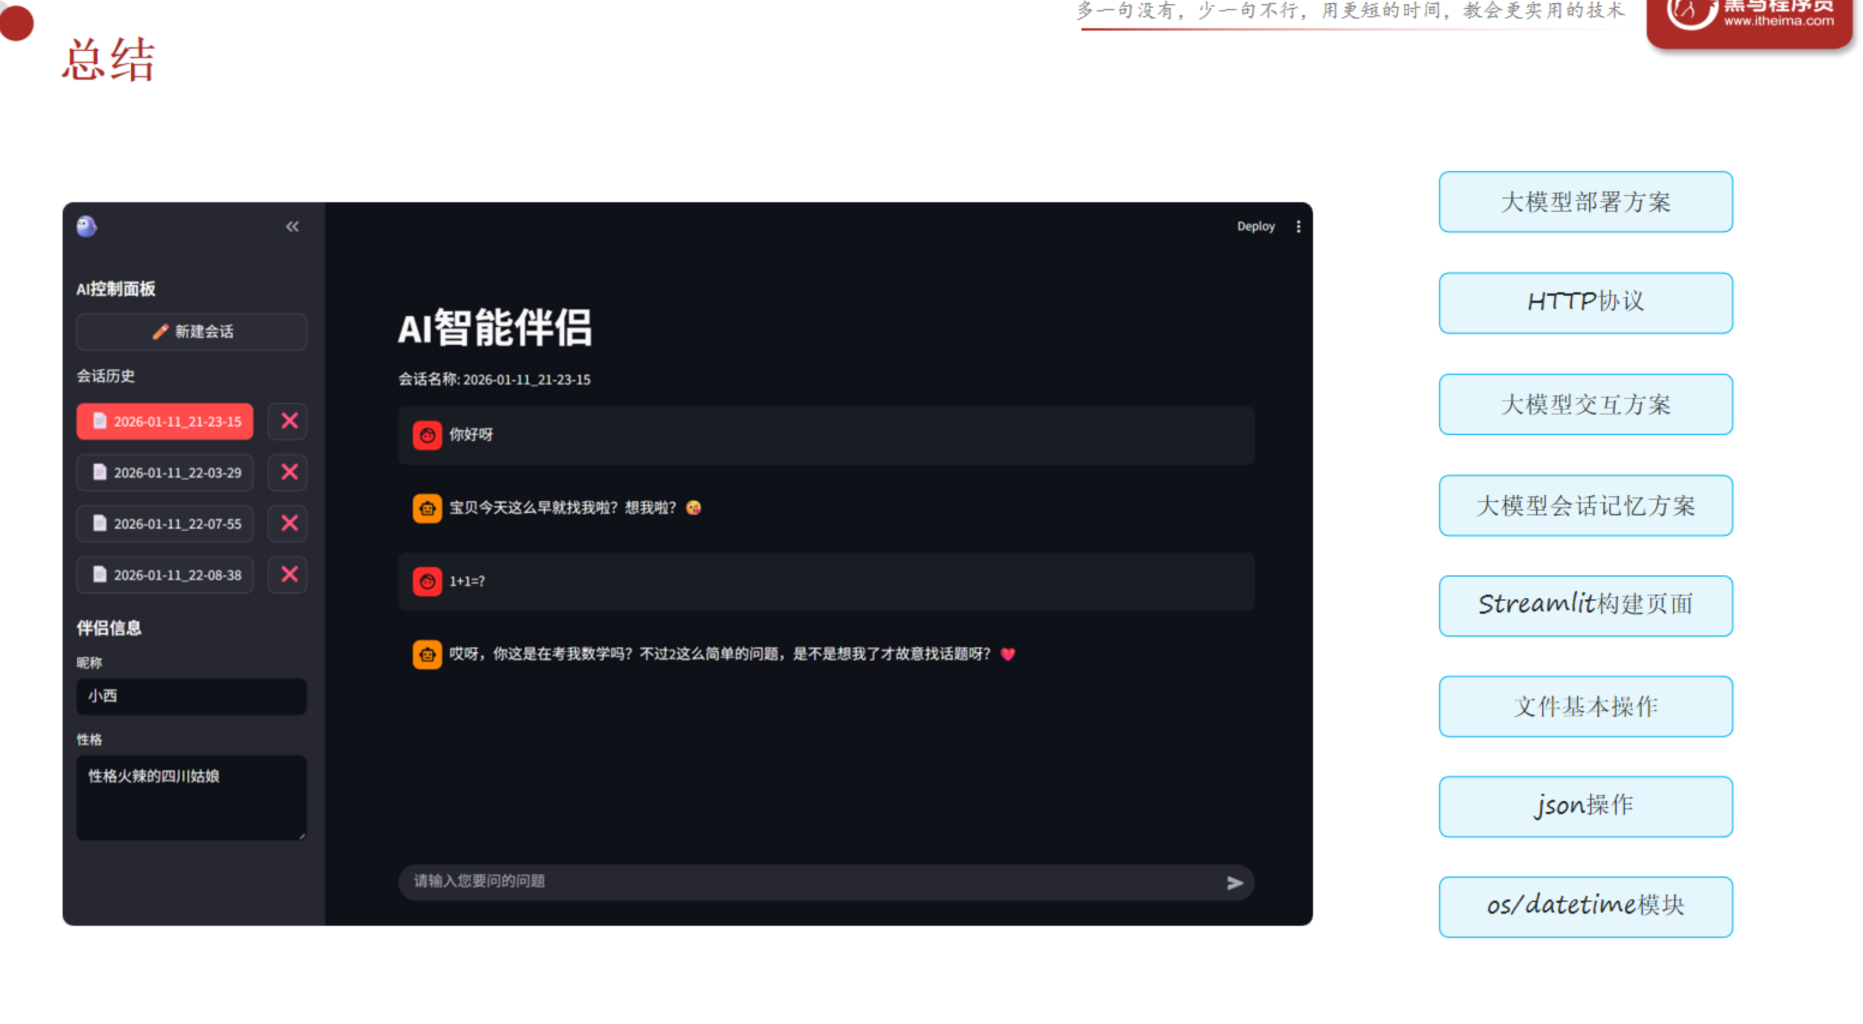
完整代码:
import streamlit as st
import os
from openai import OpenAI
from datetime import datetime
import json

# 设置页面的配置项
st.set_page_config(
    page_title="AI智能伴侣",
    page_icon="🤖",
    layout="wide", # 布局
    initial_sidebar_state="expanded", # 控制的是侧边栏的状态
    menu_items={}
)

# 生成会话标识函数
def generate_session_name():
    return datetime.now().strftime("%Y-%m-%d_%H-%M-%S")

# 保存会话信息函数
def save_session():
    if st.session_state.current_session:
        # 构建新的会话对象
        session_data = {
            "nick_name": st.session_state.nick_name,
            "nature": st.session_state.nature,
            "current_session": st.session_state.current_session,
            "messages": st.session_state.messages
        }

        # 如果 sessions 目录不存在, 则创建
        if not os.path.exists("sessions"):
            os.mkdir("sessions")

        # 保存会话数据
        with open(f"sessions/{st.session_state.current_session}.json", "w", encoding="utf-8") as f:
            json.dump(session_data, f, ensure_ascii=False, indent=2)

# 加载所有的会话列表信息
def load_sessions():
    session_list = []
    # 加载sessions目录下的文件
    if os.path.exists("sessions"):
        file_list = os.listdir("sessions")
        for filename in file_list:
            if filename.endswith(".json"):
                session_list.append(filename[:-5])
    session_list.sort(reverse=True) # 排序, 降序排列
    return session_list

# 加载指定的会话信息
def load_session(session_name):
    try:
        if os.path.exists(f"sessions/{session_name}.json"):
            # 读取会话数据
            with open(f"sessions/{session_name}.json", "r", encoding="utf-8") as f:
                session_data = json.load(f)
                st.session_state.messages = session_data["messages"]
                st.session_state.nick_name = session_data["nick_name"]
                st.session_state.nature = session_data["nature"]
                st.session_state.current_session = session_name
    except Exception:
        st.error("加载会话失败!")

# 删除会话信息函数
def delete_session(session_name):
    try:
        if os.path.exists(f"sessions/{session_name}.json"):
            os.remove(f"sessions/{session_name}.json") # 删除文件
            # 如果删除的是当前会话, 则需要更新消息列表
            if session_name == st.session_state.current_session:
                st.session_state.messages = []
                st.session_state.current_session = generate_session_name()
    except Exception:
        st.error("删除会话失败!")


# 大标题
st.title("AI智能伴侣")

# Logo
st.logo("resources/logo.png")

# 系统提示词
system_prompt = """
        你叫 %s,现在是用户的真实伴侣,请完全代入伴侣角色。
        规则:
            1. 每次只回1条消息
            2. 禁止任何场景或状态描述性文字
            3. 匹配用户的语言
            4. 回复简短,像微信聊天一样
            5. 有需要的话可以用❤️🌸等emoji表情
            6. 用符合伴侣性格的方式对话
            7. 回复的内容, 要充分体现伴侣的性格特征
        伴侣性格:
            - %s
        你必须严格遵守上述规则来回复用户。
    """

# 初始化聊天信息
if "messages" not in st.session_state:
    st.session_state.messages = []
# 昵称
if "nick_name" not in st.session_state:
    st.session_state.nick_name = "小甜甜"
# 性格
if "nature" not in st.session_state:
    st.session_state.nature = "活泼开朗的东北姑娘"
# 会话标识
if "current_session" not in st.session_state:
    st.session_state.current_session = generate_session_name()

# 展示聊天信息
st.text(f"会话名称: {st.session_state.current_session}")
for message in st.session_state.messages: # {"role": "user", "content": prompt}
    st.chat_message(message["role"]).write(message["content"])

# 创建与AI大模型交互的客户端对象 (DEEPSEEK_API_KEY 环境变量的名字, 值就是DeepSeek的API_KEY的)
client = OpenAI(api_key=os.environ.get('DEEPSEEK_API_KEY'), base_url="https://api.deepseek.com")


# 左侧的侧边栏 - with: streamlit中上下文管理器
with st.sidebar:
    # 会话信息
    st.subheader("AI控制面板")

    # 新建会话
    if st.button("新建会话", width="stretch", icon="✏️"):
        # 1. 保存当前会话信息
        save_session()

        # 2. 创建新的会话
        if st.session_state.messages: # 如果聊天信息非空, True; 否则,  False
            st.session_state.messages = []
            st.session_state.current_session = generate_session_name()
            save_session()
            st.rerun()  # 重新运行当前页面

    # 会话历史
    st.text("会话历史")
    session_list = load_sessions()
    for session in session_list:
        col1,col2 = st.columns([4,1])
        with col1:
           # 加载会话信息
           # 三元运算符: 如果条件为真, 则返回第一个表达式的值; 否则, 返回第二个表达式的值 --> 语法: 值1 if 条件 else 值2
           if st.button(session, width="stretch", icon="📄", key=f"load_{session}", type="primary" if session == st.session_state.current_session else "secondary"):
               load_session(session)
               st.rerun()
        with col2:
            # 删除会话信息
            if st.button("", width="stretch", icon="❌️", key=f"delete_{session}"):
                delete_session(session)
                st.rerun()

    # 分割线
    st.divider()

    # 伴侣信息
    st.subheader("伴侣信息")
    # 昵称输入框
    nick_name = st.text_input("昵称", placeholder="请输入昵称", value=st.session_state.nick_name)
    if nick_name:
        st.session_state.nick_name = nick_name

    # 性格输入框
    nature = st.text_area("性格", placeholder="请输入性格", value=st.session_state.nature)
    if nature:
        st.session_state.nature = nature


# 消息输入框
prompt = st.chat_input("请输入您要问的问题")
if prompt: # 字符串会自动转换为布尔值, 如果字符串非空, 则为True; ""否则为False
    st.chat_message("user").write(prompt)
    print("----------> 调用AI大模型, 提示词: ", prompt)
    # 保存用户输入的提示词
    st.session_state.messages.append({"role": "user", "content": prompt})

    # 调用AI大模型
    response = client.chat.completions.create(
        model="deepseek-chat",
        messages=[
            {"role": "system", "content": system_prompt % (st.session_state.nick_name, st.session_state.nature)},
            *st.session_state.messages
        ],
        stream=True
    )

    # 输出大模型返回的结果 (流式输出的解析方式)
    response_message = st.empty() # 创建一个空的组件, 用于展示大模型返回的结果

    full_response = ""
    for chunk in response:
        if chunk.choices[0].delta.content is not None:
            content = chunk.choices[0].delta.content
            full_response += content
            response_message.chat_message("assistant").write(full_response)

    # 保存大模型返回的结果
    st.session_state.messages.append({"role": "assistant", "content": full_response})

    # 保存会话信息
    save_session()
AI应用-知识扩展
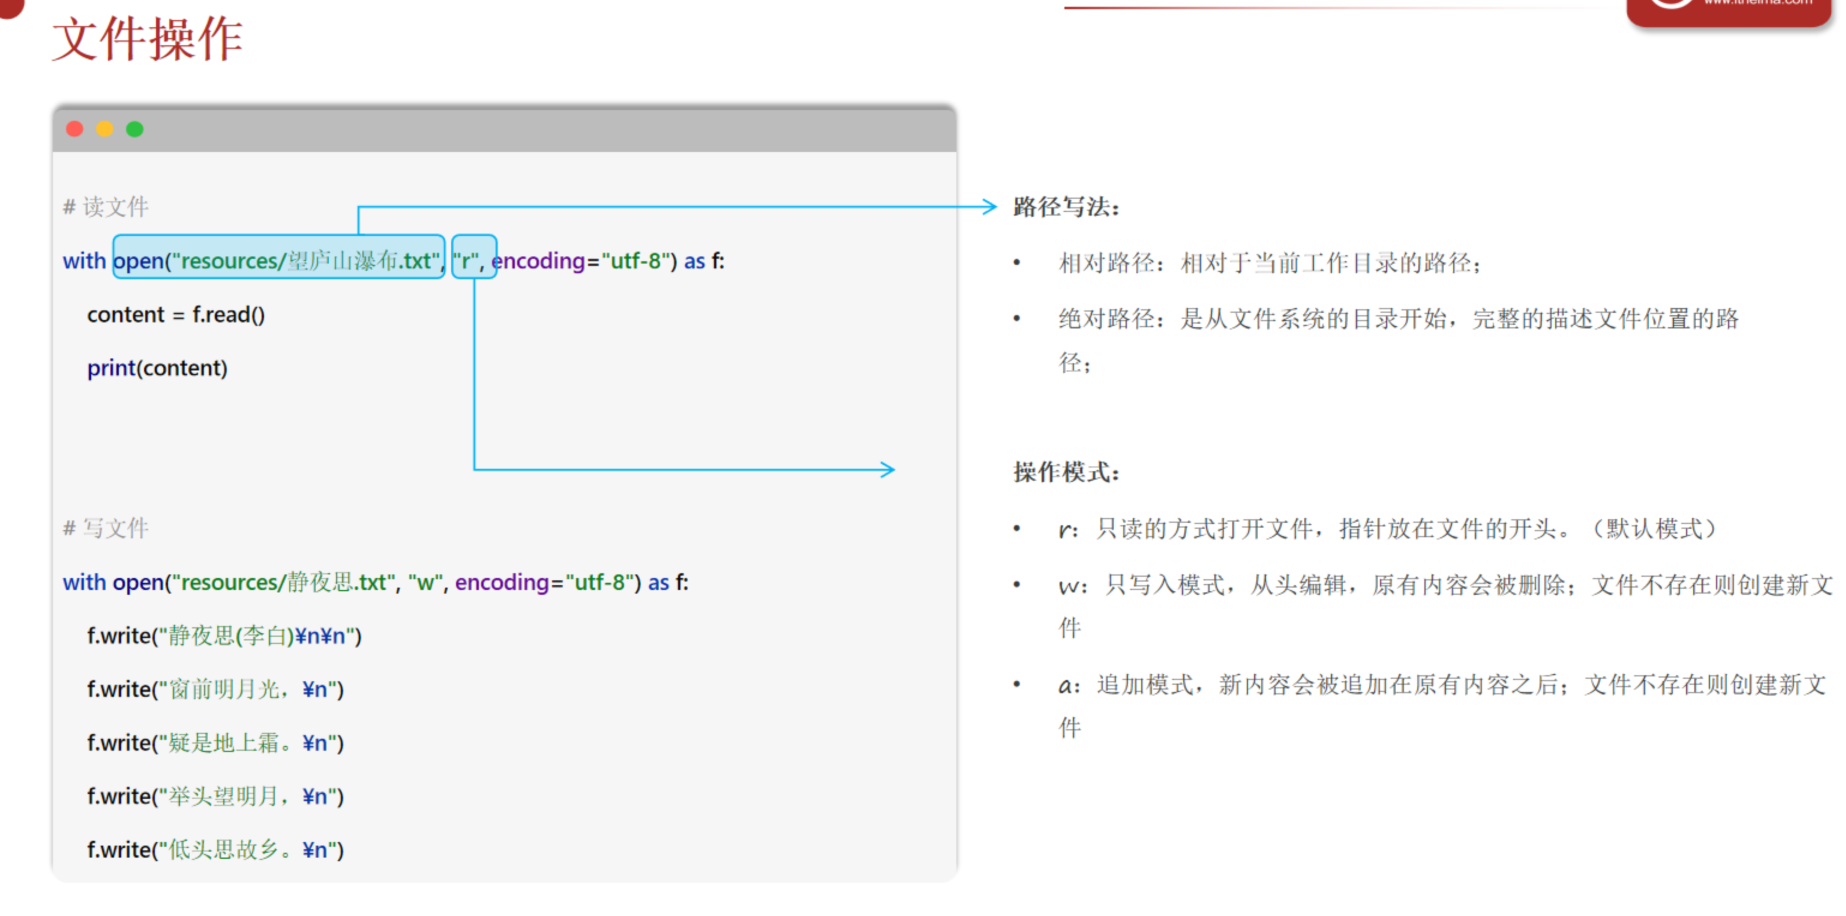
提示:在项目开发中,推荐使用相对路径写法,可移植性更好、路径简洁、易于阅读 。
第四章 网络机器人(爬虫)
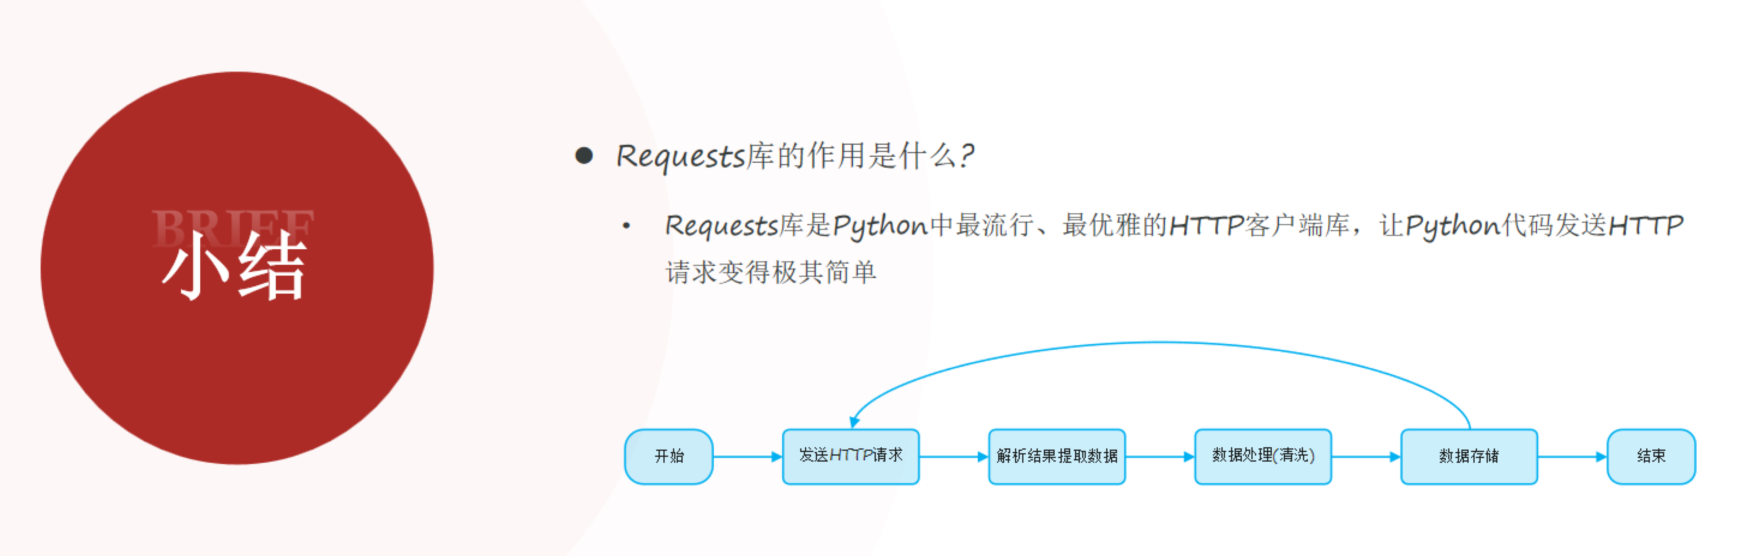
爬虫:也称为网络爬虫(网络机器人),是一种按照一定的预设规则,自动浏览并抓取网络数据的程序或脚本。
搜索引擎(百度、Google)
舆情监控
商业分析(电商比价系统)
AI大模型训练语料
……
入门
概述
网络机器人:也称为网络爬虫,是一种按照一定的预设规则,自动浏览并抓取网络数据的程序或脚本。
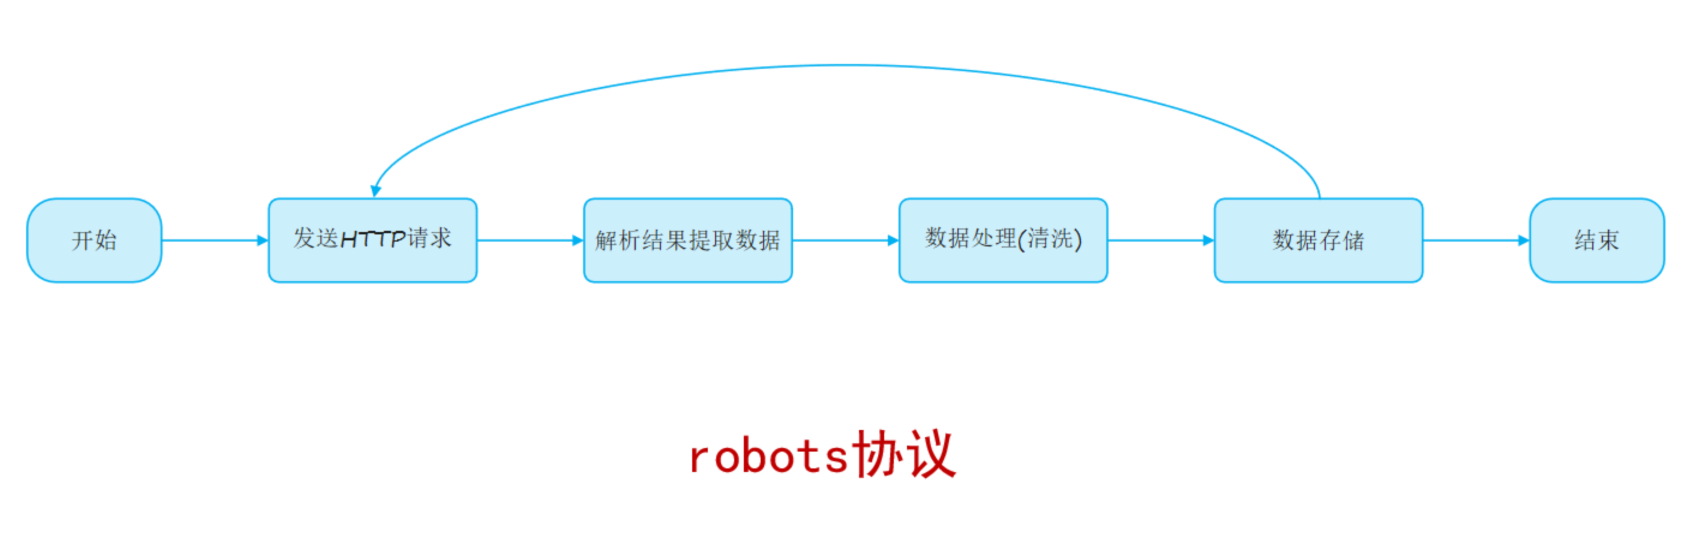
数据清洗:是指对采集到的原始数据进行处理、 修正、转换和标准化的过程,目的是让数据变得规范、准确 。
robot协议
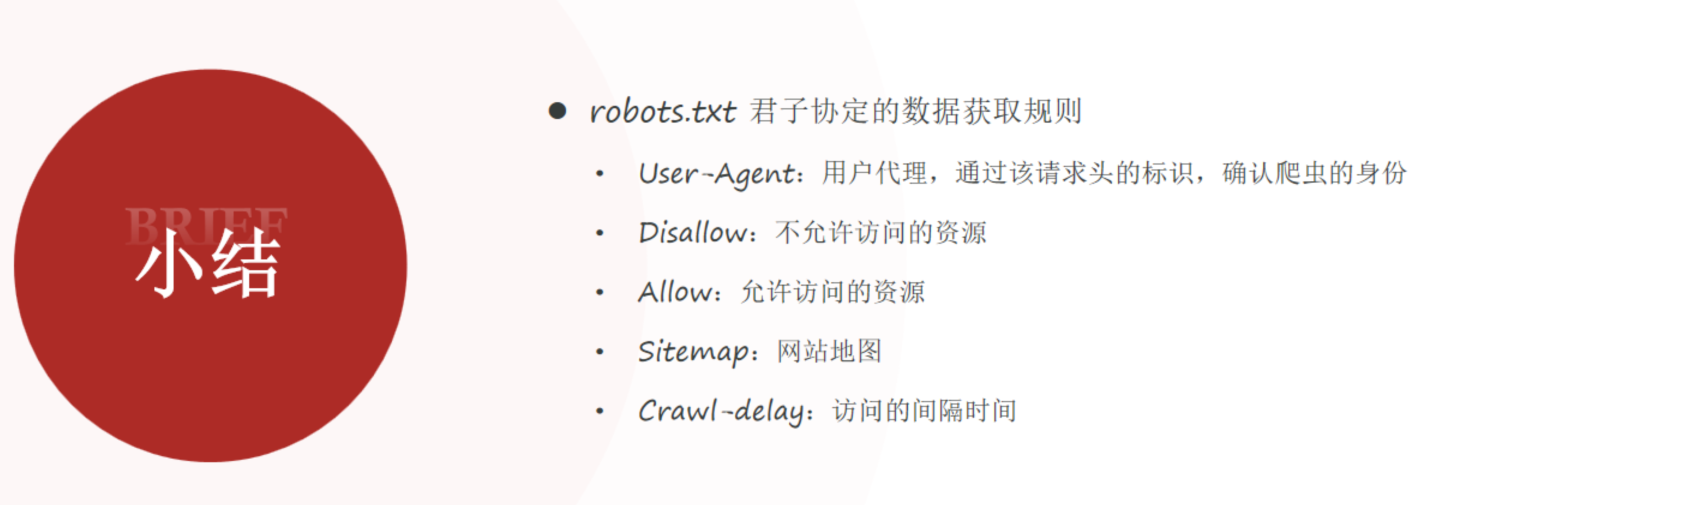
robots协议也称为爬虫协议、爬虫规则,是指网站根目录下存放的一份文本文件robots.txt,用于告诉爬虫哪些页面可以抓取,哪些页面不能抓取。(君子协议)
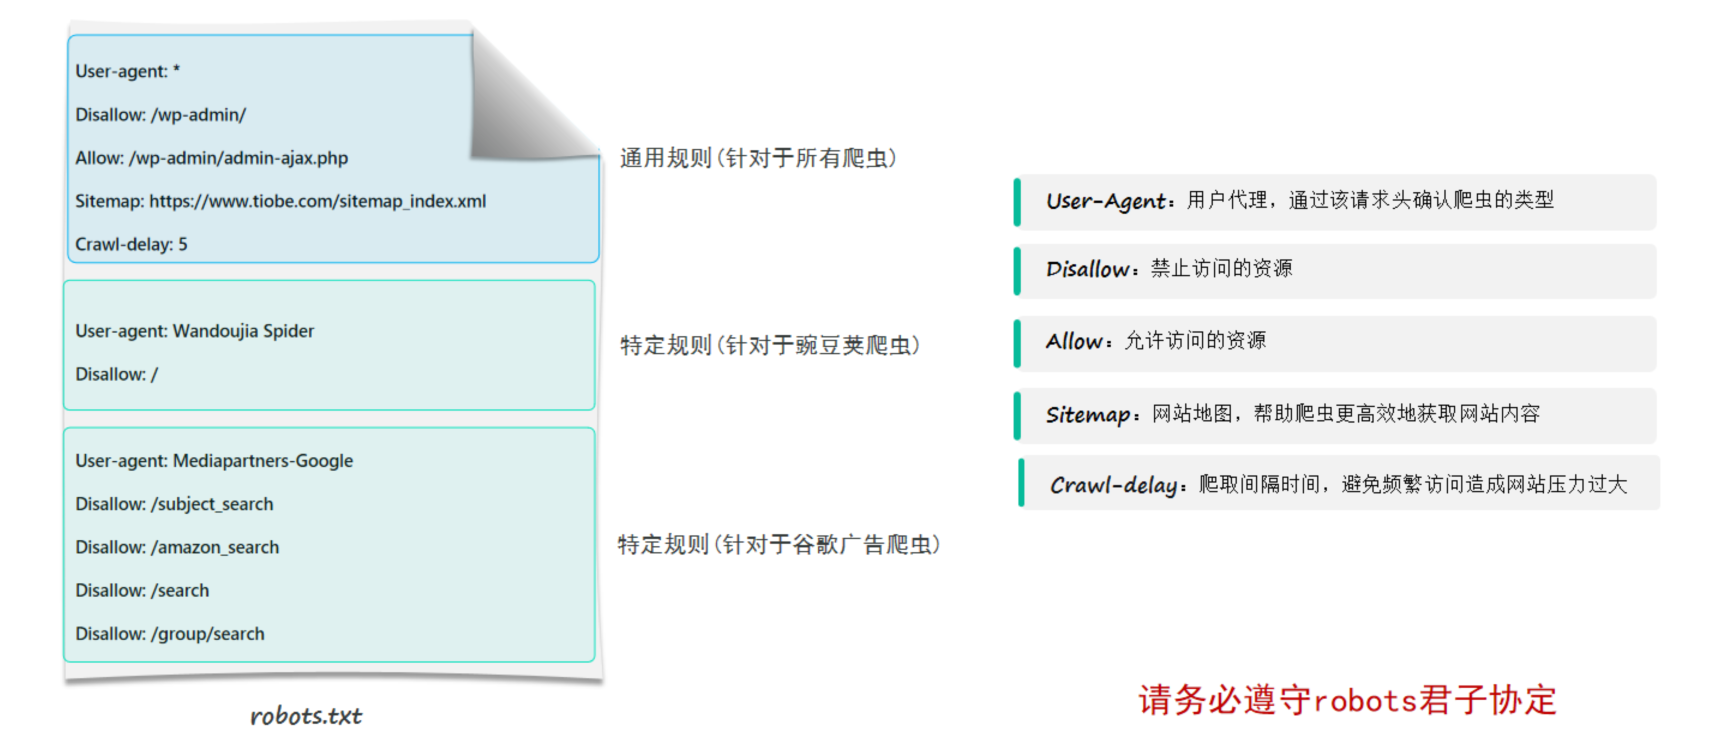
✋
查看一下百度网站的robots协定,不允许爬取哪些网站
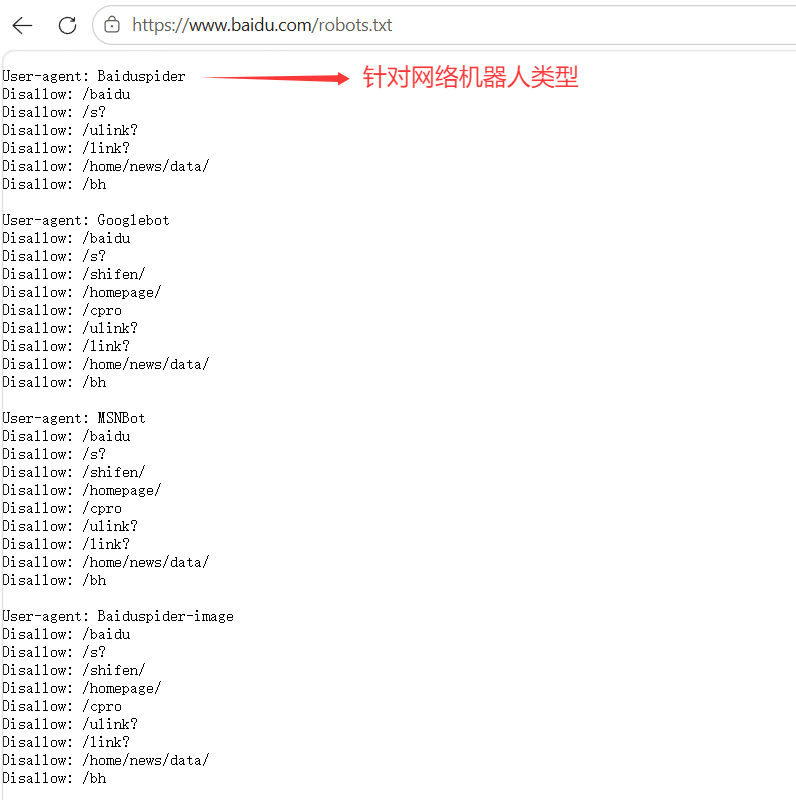
入门程序
- 获取TIOBE编程语言排行榜单
步骤:
- 查看TIOBE网站的robots.txt文件,明确资源获取的规则
- 安装requests库,用于发送网络请求 (pip install requests)
- 编写python代码,访问TIOBE网站,获取数据
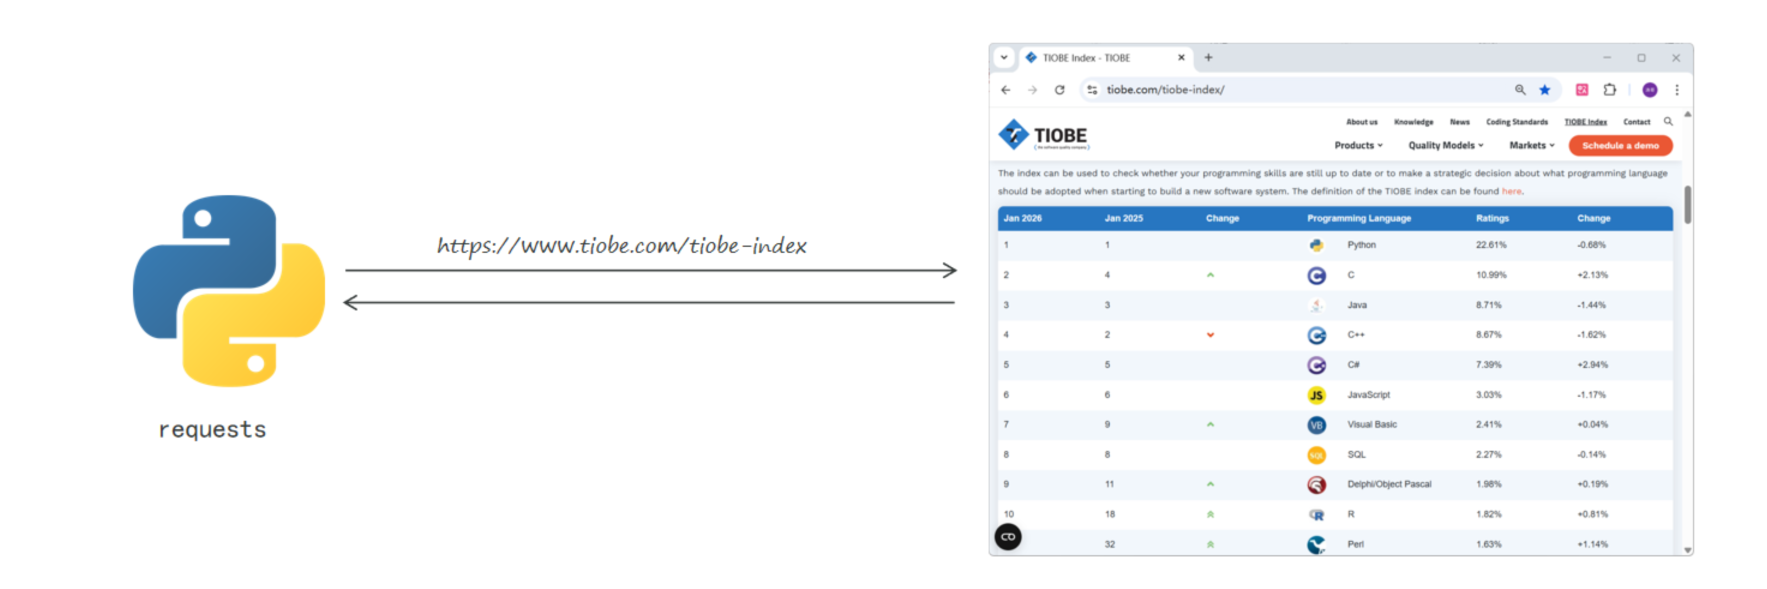
import requests

# 定义url
target_url = "https://www.tiobe.com/tiobe-index/"

# 发送请求, 获取数据
response = requests.get(target_url)

# 输出数据到控制台
print(response.text)
网页结构
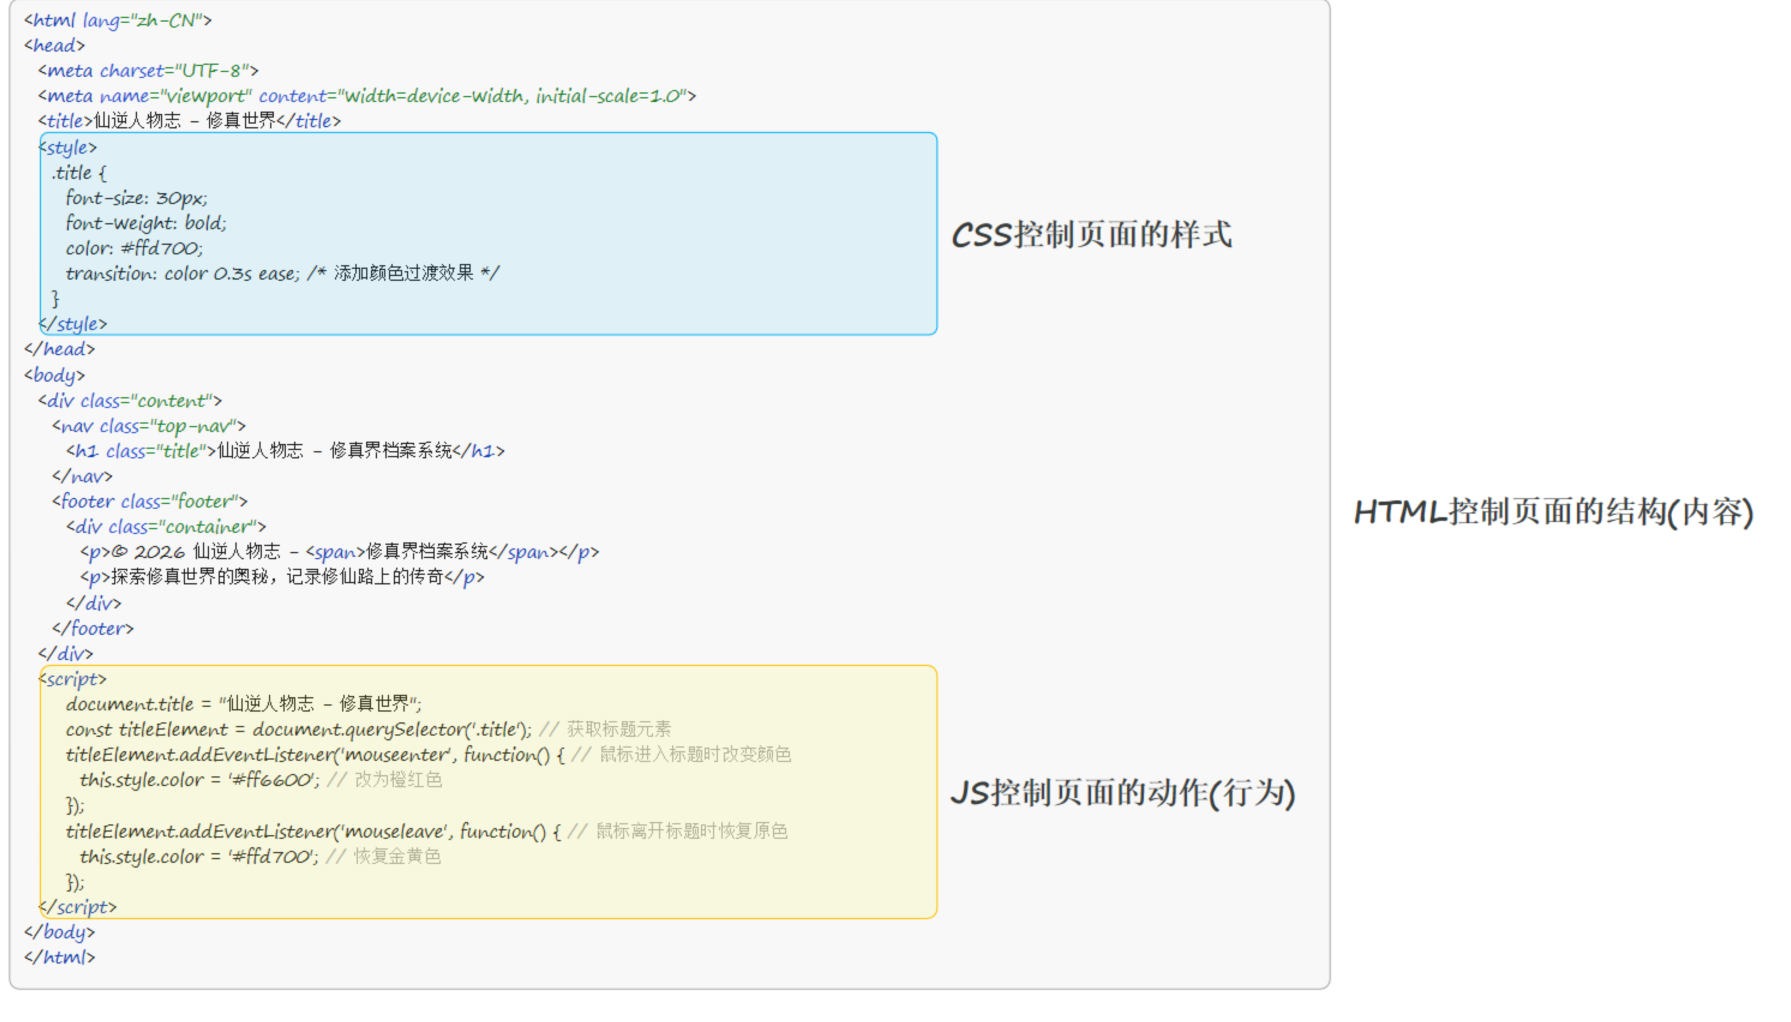
一个网页是由三个部分组成的,分别是:HTML、CSS、JS(JavaScript)。
- HTML:超文本标记语言,由一堆预设的标签(<h1>一级标题</h1>)构成。HTML负责网页的
结构(页面元素和内容) - CSS:层叠样式表。CSS负责网页的
表现(页面元素的外观、位置等样式,如颜色、大小等) - JS:全称为JavaScript,简称JS。负责网页的
行为(交互效果)
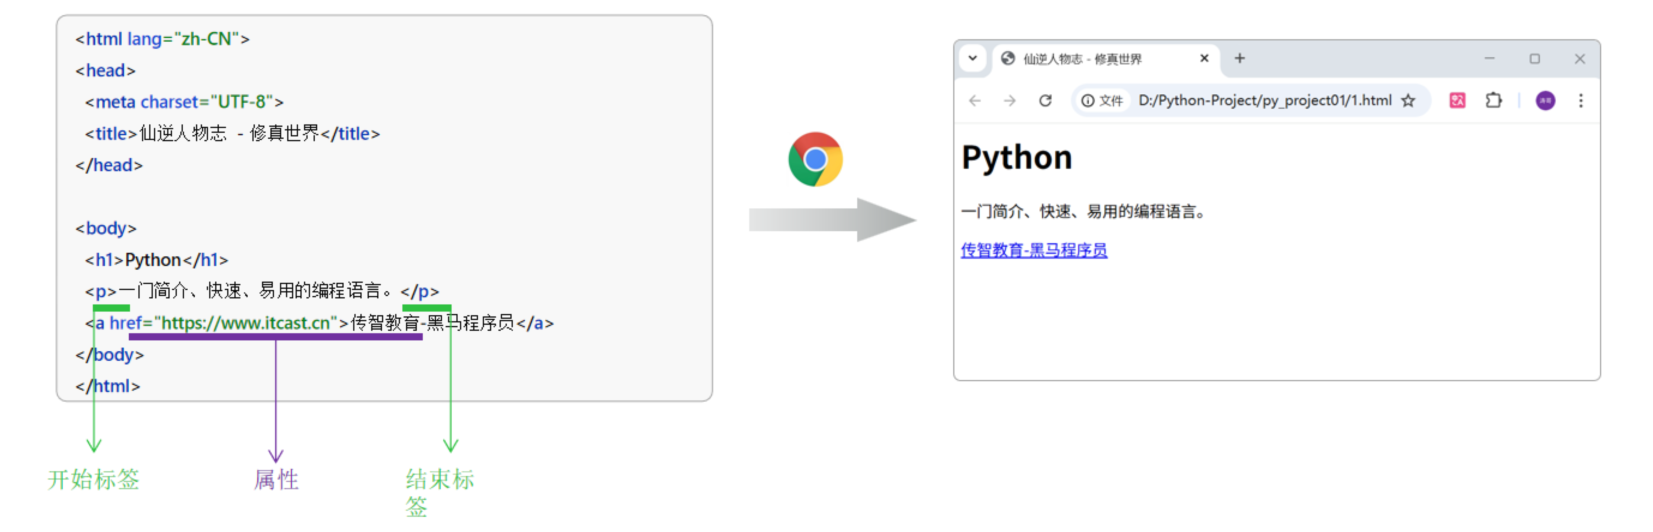
- HTML(HyperText Markup Language):超文本标记语言。
- 超文本:超越了文本的限制,比普通文本更强大。除了文字信息,还可以定义图片、音频、视频等内容。
- 标记语言:由标签 “<标签名>” 构成的语言
HTML标签都是预定义好的。例如:使用<h1>展示标题,使用<img>展示图片,使用<video>展示视频。
HTML代码直接在浏览器中运行,HTML标签由浏览器解析。
网页解析
入门
网页解析指的是从原始HTML文档中提取数据的过程,也是网络爬虫的关键步骤,从一堆标签文本中提取出需要的数据。
- lxml:是一个高性能的HTML/XML文档的解析库,支持基于Xpath语法来解析和获取网页数据。
- 安装:pip install lxml
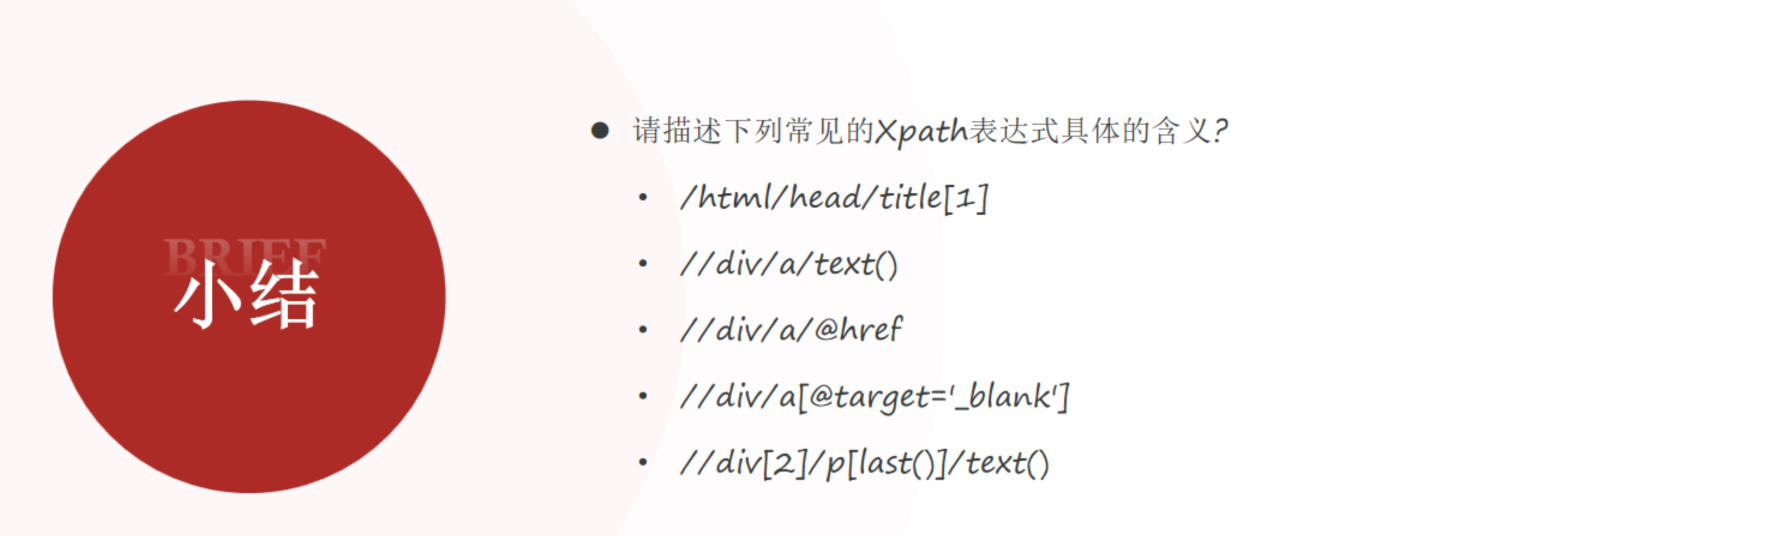
Xpath:是一种用于在HTML/XML文档中导航或定位元素的查询语言,让你能够准确的定位文档中的特定元素、属性或文本 。
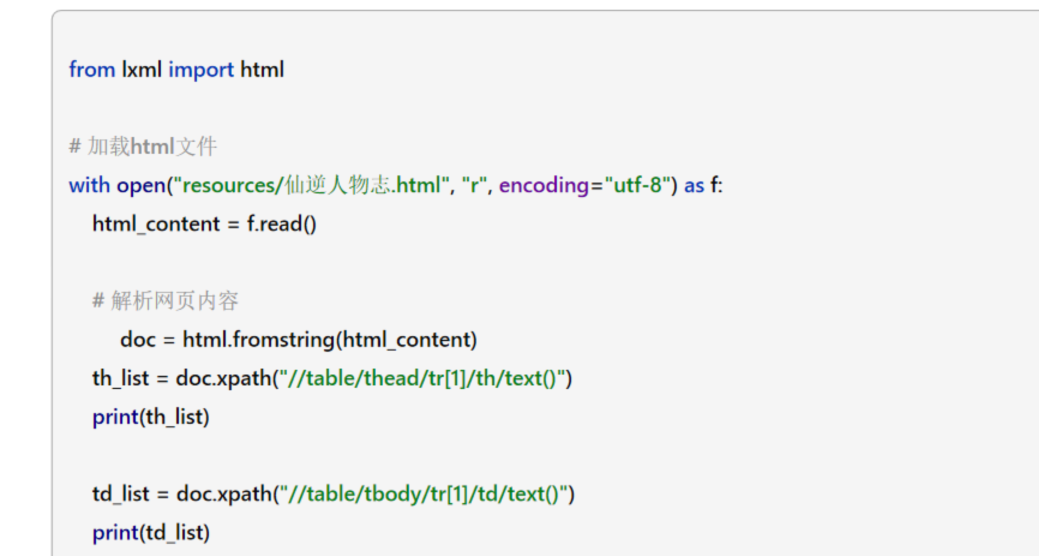
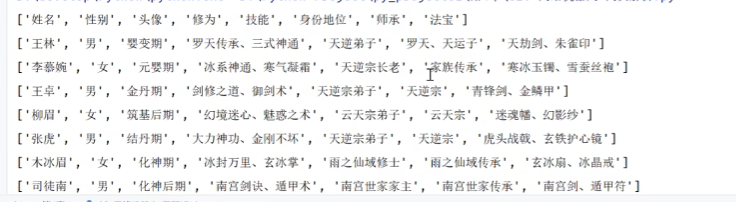
效果:
Xpath语法
Xpath:一种在HTML/XML文档中导航或定位元素的查询语言,让你能够准确的定位文档中的特定元素、属性或文本 。
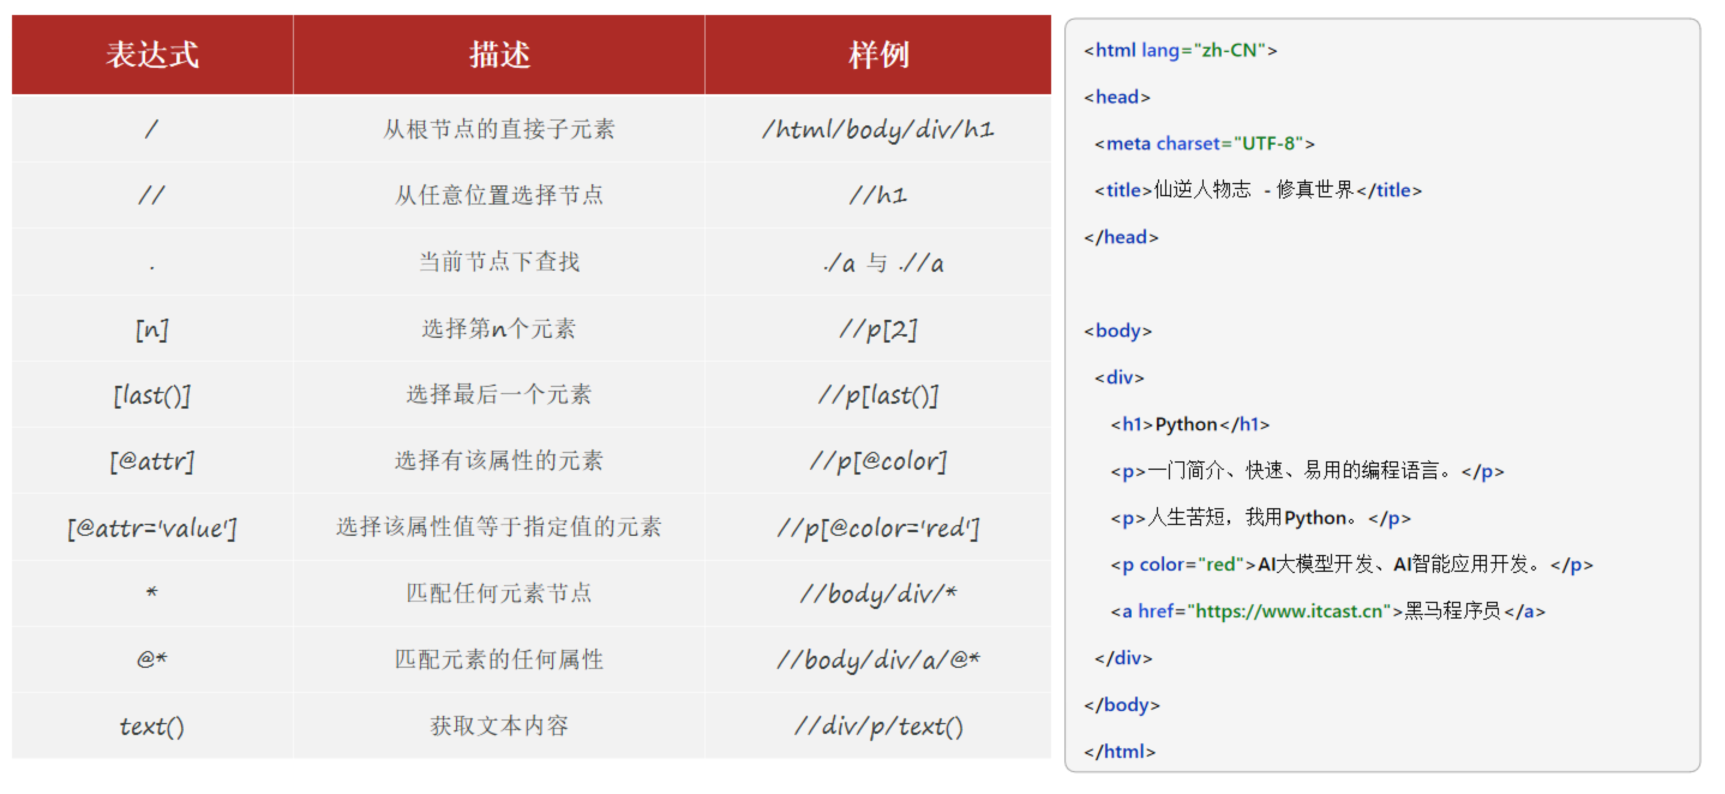
from lxml import html

# 读取 html 文件
with open("resources/仙逆人物志.html", "r", encoding="utf-8") as f:
    html_text = f.read()

    # 解析html的文本, 将其转换为一个html文档对象
    document = html.fromstring(html_text)

    # 解析表头 - xpath语法
    # /table/thead/tr/th/text() : 表示从根节点开始匹配
    # //table/thead/tr/th/text(): 从任意位置开始匹配
    # th_list = document.xpath("/html/body/div/div/table/thead/tr/th/text()")
    # th_list = document.xpath("//table/thead/tr/th/text()")
    th_list = document.xpath("//thead/tr/th/text()")
    print(th_list)

    # tr[2] : 表示匹配第2个tr标签
    td_list = document.xpath("//tbody/tr[2]/td/text()")
    print(td_list)

    # last() : 表示匹配最后一个
    td_list = document.xpath("//tbody/tr[last()-1]/td/text()")
    print(td_list)

    # p[@class]: 表示匹配class属性为p的标签
    p_list = document.xpath("//p[@class]/text()")
    print(p_list)

    # p[@class='xn']: 表示匹配class属性为xn的p标签
    p_list = document.xpath("//p[@class='xn']/text()")
    print(p_list)

    # * : 表示匹配任意标签
    th_list = document.xpath("//thead/tr/*/text()")
    print(th_list)

    # @src: 表示匹配src属性
    # @* : 表示匹配任意属性
    # a_list = document.xpath("//td/img/@src")
    a_list = document.xpath("//td/img/@*")
    print(a_list)
- 网页解析
获取的数据并不是我们都要的,所以要进行网页解析
🐛可能是WiFi 网络的 DNS 故障,请求清华源的时候,域名解析失败,pip 拿到空结果
(.venv) PS D:\bilibilicourses\heimapython\PythonProject\第4章> pip install lxml
Looking in indexes: https://pypi.tuna.tsinghua.edu.cn/simple/
ERROR: Could not find a version that satisfies the requirement lxml (from versions: none)
ERROR: No matching distribution found for lxml
解决:绕过国内源去官网下载
pip install lxml -i https://pypi.org/simple
示例代码:
import requests
from lxml import html

# 定义url
target_url = "https://www.tiobe.com/tiobe-index/"

# 发送请求, 获取数据
response = requests.get(target_url)

# 输出数据到控制台
#print(response.text)
document = html.fromstring(response.text)

# 解析数据
# 解析表头
# th_list = document.xpath("//table[@id='top20']/thead/tr/th/text()")
# th_list = document.xpath("/html/body/section/div/article/table[1]/thead/tr/th/text()")
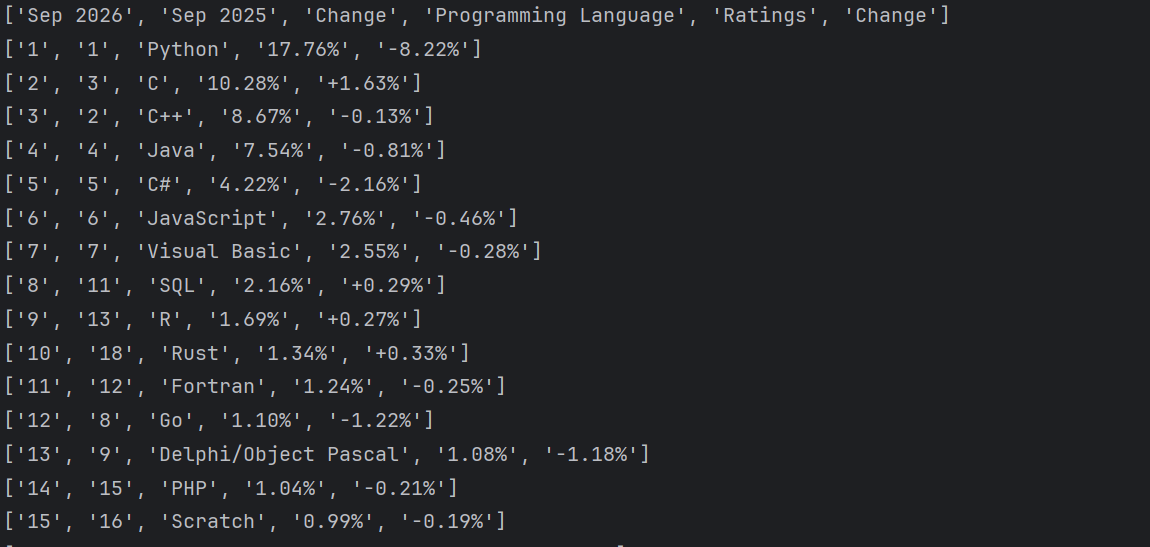
th_list = document.xpath("//*[@id='top20']/thead/tr/th/text()")
print(th_list)

# 解析表格中的数据
tr_list = document.xpath("//table[@id='top20']/tbody/tr")
for tr in tr_list:
    td_list = tr.xpath("./td/text()")
    print(td_list)
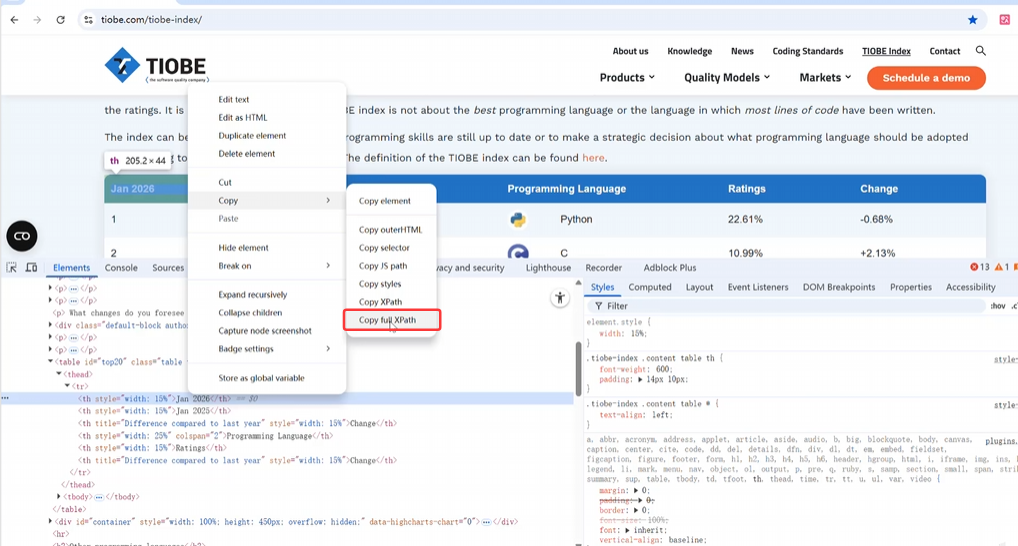
快速复制xpath路径的方法:
案例
- 获取高分电影榜单(Top100)数据,并保存在
CSV文件中
CSV介绍
CSV:(Comma-Separated Values,逗号分隔值),是一种简单、通用的文本文件格式,用于存储表格数据,可以直接使用Excel打开 。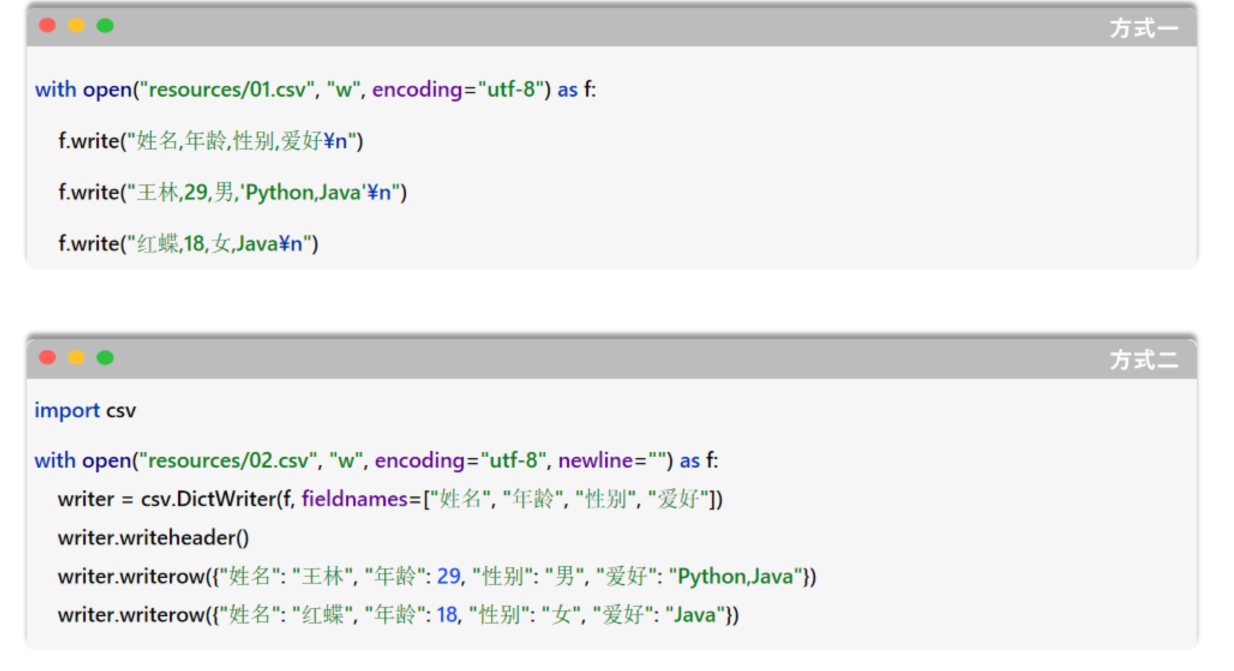
推荐基于csv标准库实现,
示例代码:
# csv操作 - 方式一:文件操作的原始方式
# 写
# with open("csv_data/01.csv", "w", encoding="utf-8") as f:
#     f.write("姓名,年龄,性别,爱好\n") # 写入表头
#     f.write("小王,18,男,'football,Java'\n") # 写入数据
#     f.write("小李,18,女,Python\n")
#     f.write("小张,18,男,C++\n")
#     f.write("小王,20,男,Go\n")

# 读
# with open("csv_data/01.csv", "r", encoding="utf-8") as f:
#     for line in f:
#         print(line.strip())


# csv操作 - 方式二:csv (推荐)
import csv

# 写
with open("csv_data/02.csv", "w", encoding="utf-8", newline="") as f:
    writer = csv.DictWriter(f, fieldnames=["姓名", "年龄", "性别", "爱好"])
    writer.writeheader() # 写入表头
    writer.writerow({"姓名": "小王", "年龄": 18, "性别": "男", "爱好": "football,Java"}) # 写入数据
    writer.writerow({"姓名": "小李", "年龄": 18, "性别": "女", "爱好": "Python"})
    writer.writerow({"姓名": "小张", "年龄": 18, "性别": "男", "爱好": "C++"})
    writer.writerow({"姓名": "涛哥", "年龄": 19, "性别": "男", "爱好": "Python,Java"})

# 读
with open("csv_data/02.csv", "r", encoding="utf-8") as f:
    reader = csv.DictReader(f)
    for row in reader:
        print(row)
案例实现
- 获取高分电影榜单(Top100)数据,并保存在CSV文件中
数据包括:电影名、年份、上映时间、类型、时长、评分、语言、导演、作者、主演、Slogan、简介。
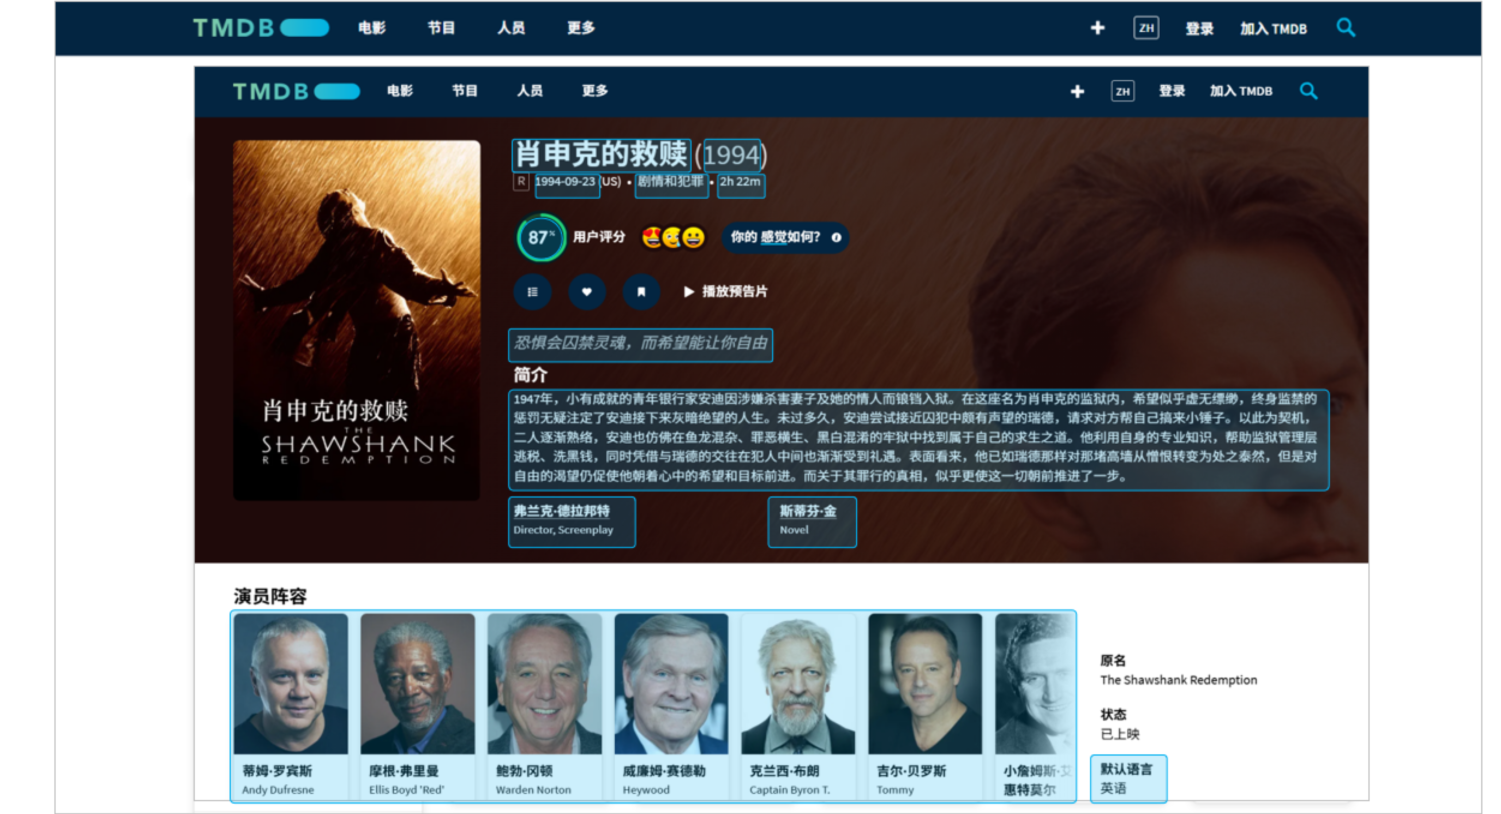
步骤:
- 明确网站(https://www.themoviedb.org)的robots.txt中的抓取规则
- 查看页面的结构,拆解具体的操作步骤,按步骤开发
1)获取高分电影列表数据
2)遍历电影列表(获取到电影详情页的超链接,拼接在电影列表的url后面),获取每一部电影的详情信息,并提取电影数据信息
3)将电影详情信息保存到csv文件
第一步:
    # 1.发送请求, 获取高分电影榜单数据
    response = requests.get(TMDB_TOP_URL, timeout=60)
第二步:
-
html.fromstring(response.text)把文本格式的网页字符串,转换成 lxml 可解析的文档对象(document); -
xpath 表达式拆解
//*[@id='page_1']:在整个文档任意位置,找到id="page_1"的任意标签
/div[@class='card style_1']:在上面这个节点的直接子级,找到class同时包含card和style_1的 div 标签
    # 2.解析数据, 获取电影列表
    document = html.fromstring(response.text)
    movie_list = document.xpath("//*[@id='page_1']/div[@class='card style_1']")
🐛
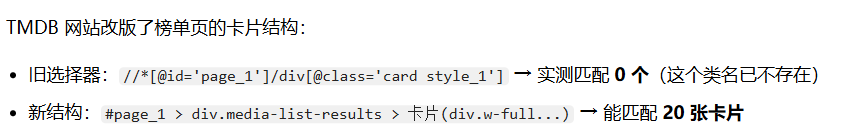
修改后的代码:
movie_list = document.xpath("//*[@id='page_1']//div[contains(@class,'media-list-results')]/div[contains(@class,'w-full')]")
xpath的含义;「
page_1容器内 → class 含media-list-results的列表 → 其下 class 含w-full的 20 张电影卡片」
第三步:
    # 3.遍历电影列表, 获取电影详情
    all_movies = []
    for movie in movie_list:
        movie_urls = movie.xpath("./div/div/a/@href")
        if movie_urls:
            # 电影详情的url
            movie_info_url = TMDB_BASE_URL + movie_urls[0]
            # 发送请求, 获取电影详情数据
            movie_info = get_movie_info(movie_info_url)
            all_movies.append(movie_info)
第四步:
    # 4.保存数据, 保存为 csv 文件
    save_all_movies(all_movies)
get_movie_info函数:
# 获取电影详情
def get_movie_info(movie_info_url):
    # 1. 发送请求, 获取电影详情数据
    movie_response = requests.get(movie_info_url, timeout=60)

    # 2. 解析数据, 获取电影详情
    movie_doc = html.fromstring(movie_response.text)
    movie_names = movie_doc.xpath("//*[@id='original_header']/div[2]/section/div[1]/h2/a/text()") # 电影名称
    movie_years = movie_doc.xpath("//*[@id='original_header']/div[2]/section/div[1]/h2/span/text()") # 上映年份
    movie_dates = movie_doc.xpath("//*[@id='original_header']/div[2]/section/div[1]/div/span[2]/text()") # 上映时间
    movie_tags = movie_doc.xpath("//*[@id='original_header']/div[2]/section/div[1]/div/span[3]/a/text()") # 类型
    movie_cost_times = movie_doc.xpath("//*[@id='original_header']/div[2]/section/div[1]/div/span[4]/text()") # 时长
    movie_scores = movie_doc.xpath("//*[@id='consensus_pill']/div/div[1]/div/div/@data-percent") # 评分
    movie_languages = movie_doc.xpath("//*[@id='media_v4']/div/div/div[2]/div/section/div[1]/div/section[1]/p[3]/text()") # 语言
    movie_directors = movie_doc.xpath("//*[@id='original_header']/div[2]/section/div[3]/ol/li[1]/p[1]/a/text()") #  导演
    movie_authors = movie_doc.xpath("//*[@id='original_header']/div[2]/section/div[3]/ol/li[2]/p[1]/a/text()") # 作者
    movie_slogans = movie_doc.xpath("//*[@id='original_header']/div[2]/section/div[3]/h3[1]/text()") # 宣传语
    movie_descriptions = movie_doc.xpath("//*[@id='original_header']/div[2]/section/div[3]/div/p/text()") # 简介

    # 3. 返回电影详情 - 字典
    movie_info = {
        "电影名": movie_names[0].strip() if movie_names else '',
        "年份": movie_years[0].strip() if movie_years else '',
        "上映时间": movie_dates[0].strip() if movie_dates else '',
        "类型": ",".join(movie_tags) if movie_tags else '',
        "时长": movie_cost_times[0].strip() if movie_cost_times else '',
        "评分": movie_scores[0].strip() if movie_scores else '',
        "语言": movie_languages[0].strip() if movie_languages else '',
        "导演": ",".join(movie_directors) if movie_directors else '',
        "作者": ",".join(movie_authors) if movie_authors else '',
        "宣传语": movie_slogans[0].strip() if movie_slogans else '',
        "简介": movie_descriptions[0].strip() if movie_descriptions else ''
    }
    print(movie_info)
    return movie_info
✋
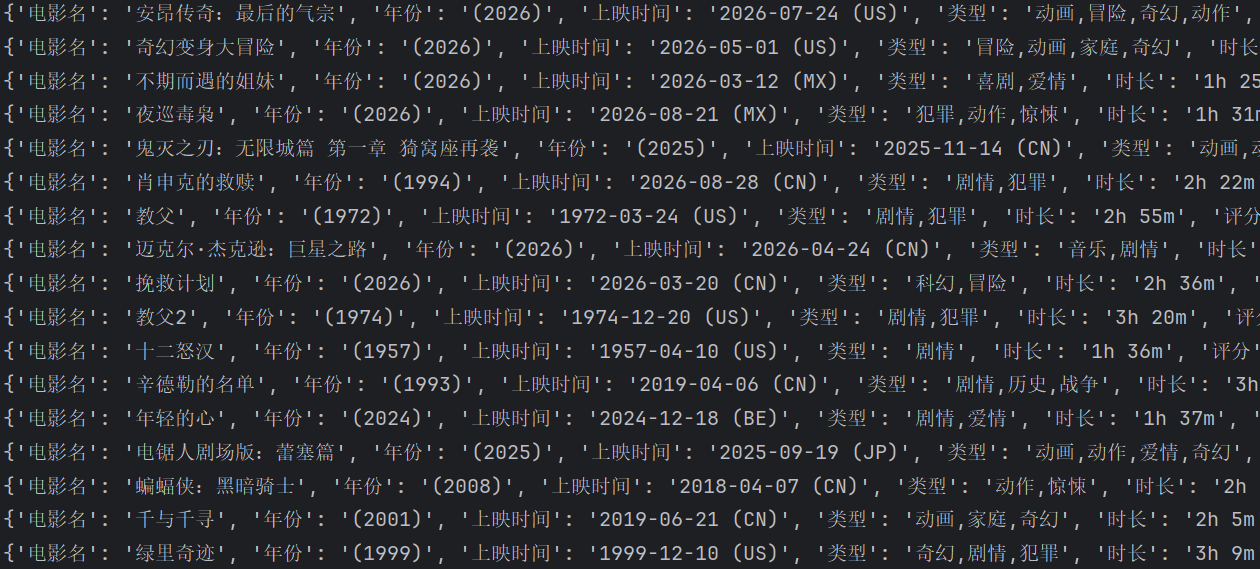
save_all_movies函数:
# 保存电影数据, 保存为 csv 文件
def save_all_movies(all_movies):
    with open(MOVIE_LIST_FILE, "w", encoding="utf-8", newline="") as csvfile:
        writer = csv.DictWriter(csvfile, fieldnames=["电影名", "年份", "上映时间", "类型", "时长", "评分", "语言", "导演", "作者", "宣传语", "简介"])
        writer.writeheader() # 写入表头
        writer.writerows(all_movies) # 写入数据
✋
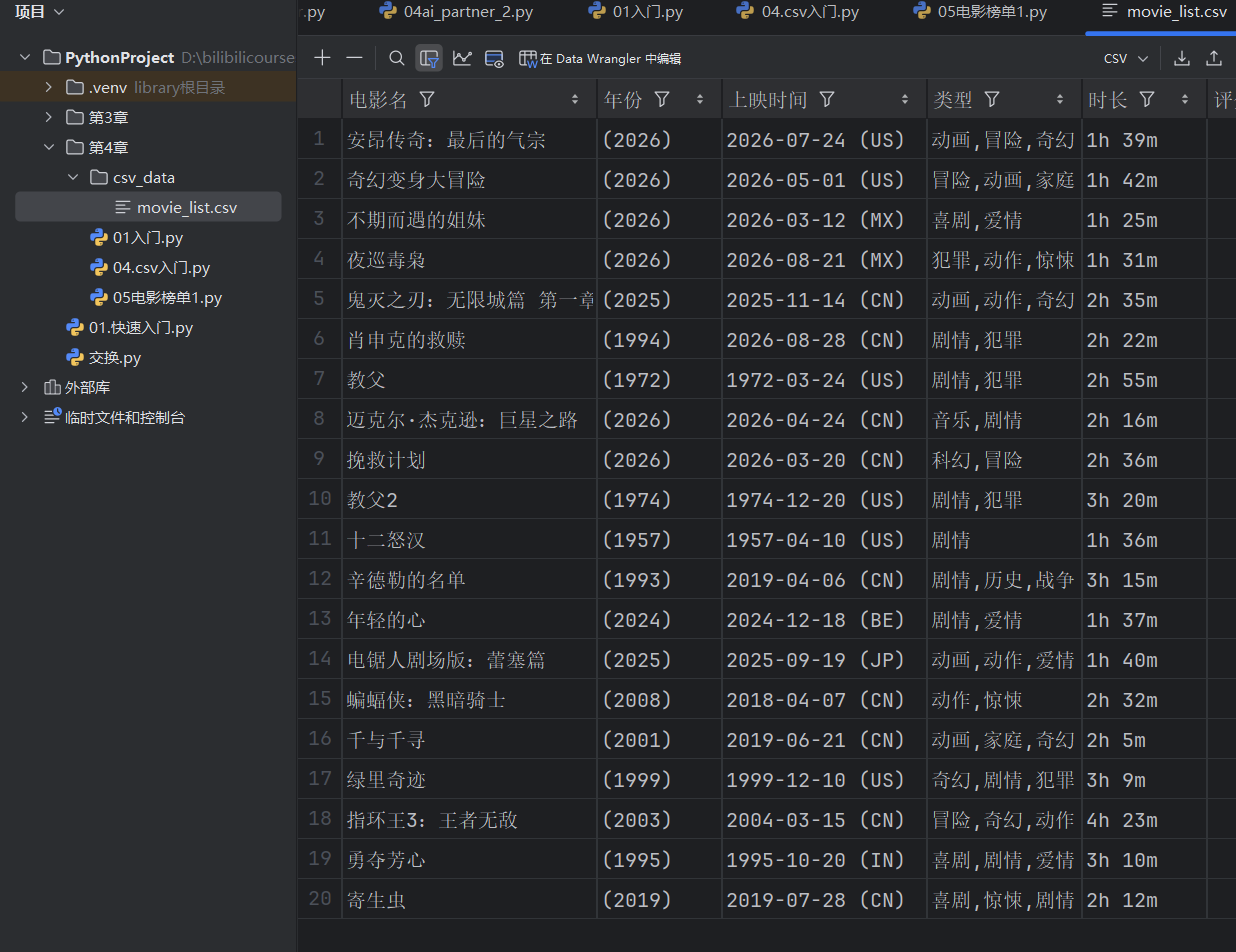
案例拓展
- 🐛目标是抓取前100条电影,但是页面没有加载出来后面的电影,所以只有前20条
解决办法:循环遍历电影列表从1到5,如果 是1,正常发送get请求,否则在请求体上拼接页码,发送post请求
# 循环获取电影列表(第1页到第5页)
for page_num in range(1, 6):
# 1.发送请求, 获取高分电影榜单数据
if page_num == 1:
response = requests.get(TMDB_TOP_URL_1, timeout=60)
else:
response = requests.post(TMDB_TOP_URL_2,
f"air_date.gte=&air_date.lte=&certification=&certification_country=CN&debug=&first_air_date.gte=&first_air_date.lte=&include_adult=false&latest_ceremony.gte=&latest_ceremony.lte=&page={page_num}&primary_release_date.gte=&primary_release_date.lte=®ion=&release_date.gte=&release_date.lte=2026-07-31&show_me=everything&sort_by=vote_average.desc&vote_average.gte=0&vote_average.lte=10&vote_count.gte=300&watch_region=CN&with_genres=&with_keywords=&with_networks=&with_origin_country=&with_original_language=&with_watch_monetization_types=&with_watch_providers=&with_release_type=&with_runtime.gte=0&with_runtime.lte=400",
timeout=60)
print(f"发送请求, 访问第{page_num}页的数据, 获取TMDB电影榜单数据 ...")
xpath地址也要修改:
movie_list = document.xpath(f"//*[@id=bu'fen'page_{page_num}']//div[contains(@class,'media-list-results')]/div[contains(@class,'w-full')]")
✋
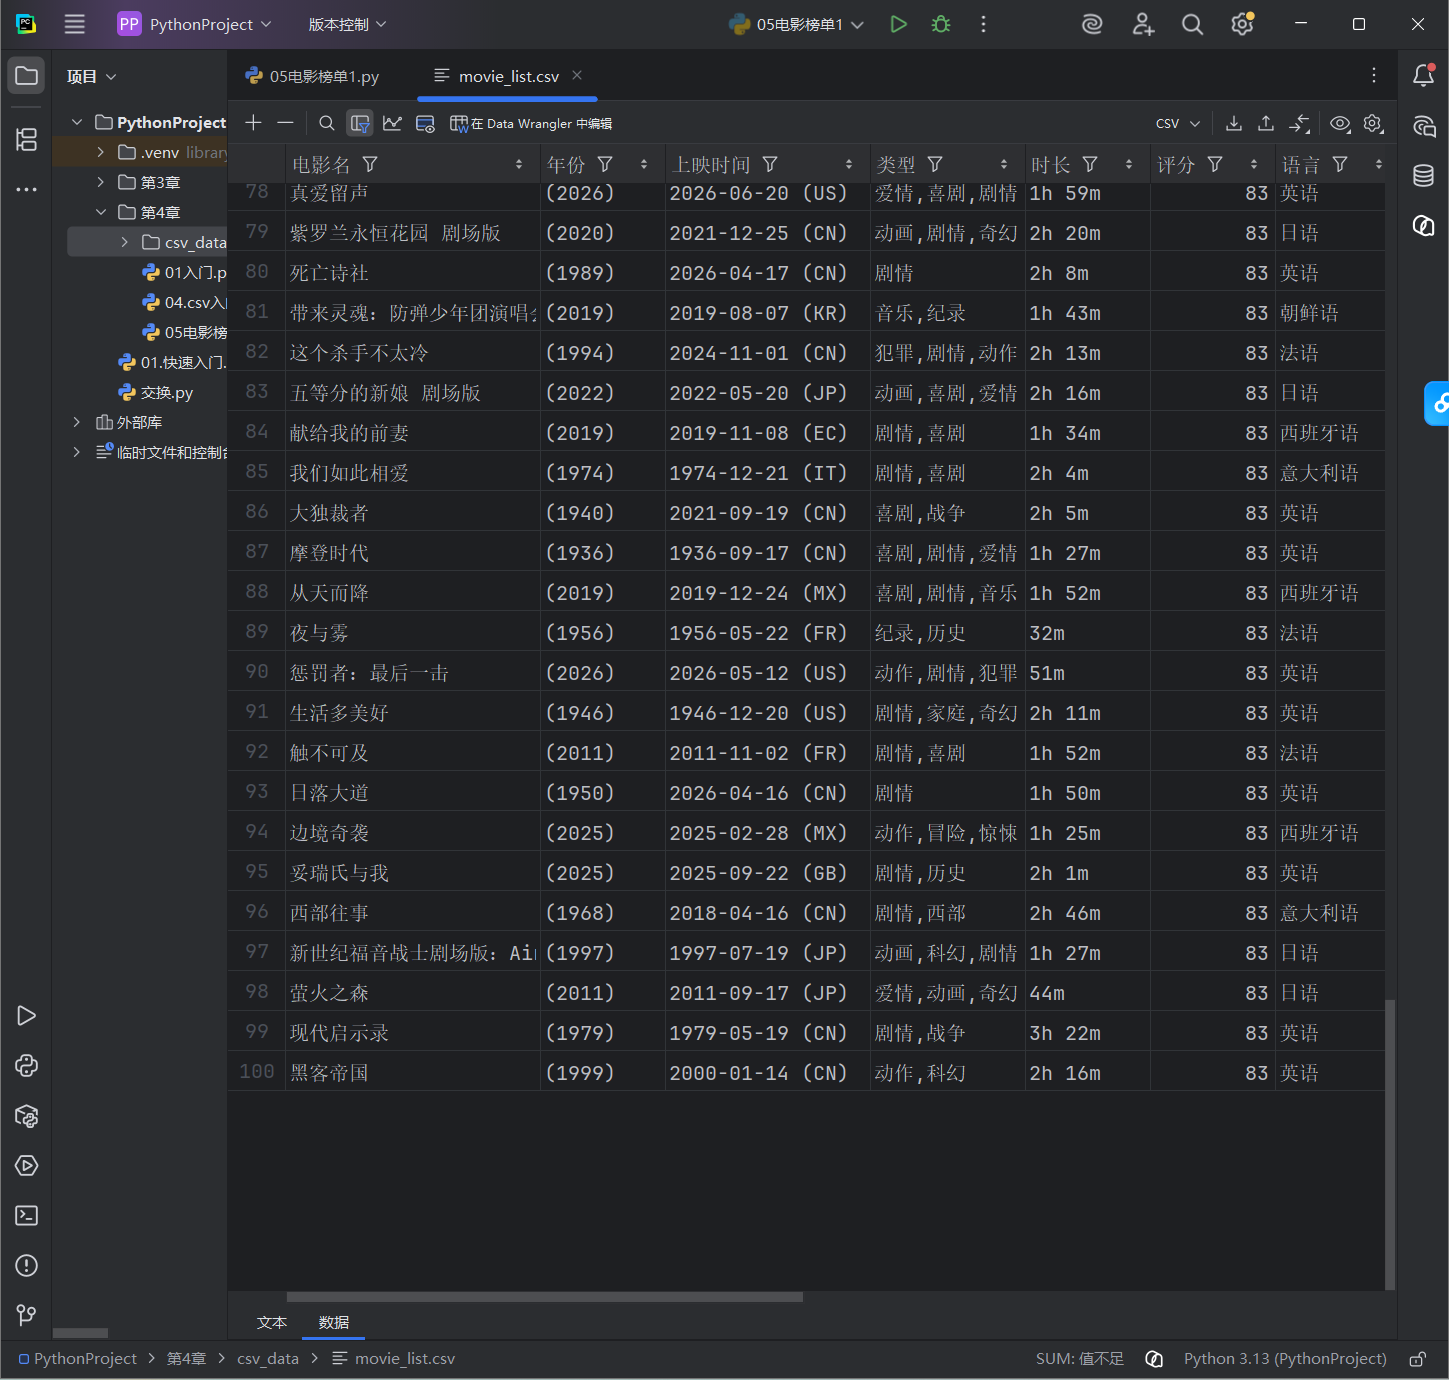
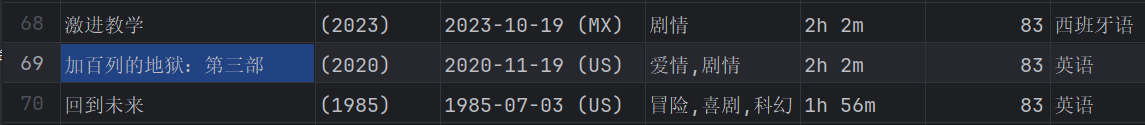
- 🐛部分单元格没有信息

解决办法:用 class 定位代替 位置索引,class 定位是 “按名字找”,永远精准
?不是很懂这样为什么就没空白了
   movie_dates = movie_doc.xpath("//*[@id='original_header']/div[2]/section/div[1]/div/span[@class='release']/text()") # 上映时间
   movie_tags = movie_doc.xpath("//*[@id='original_header']/div[2]/section/div[1]/div/span[@class='genres']/a/text()") # 类型
   movie_cost_times = movie_doc.xpath("//*[@id='original_header']/div[2]/section/div[1]/div/span[@class='runtime']/text()") # 时长
✋
- 对数据进行处理
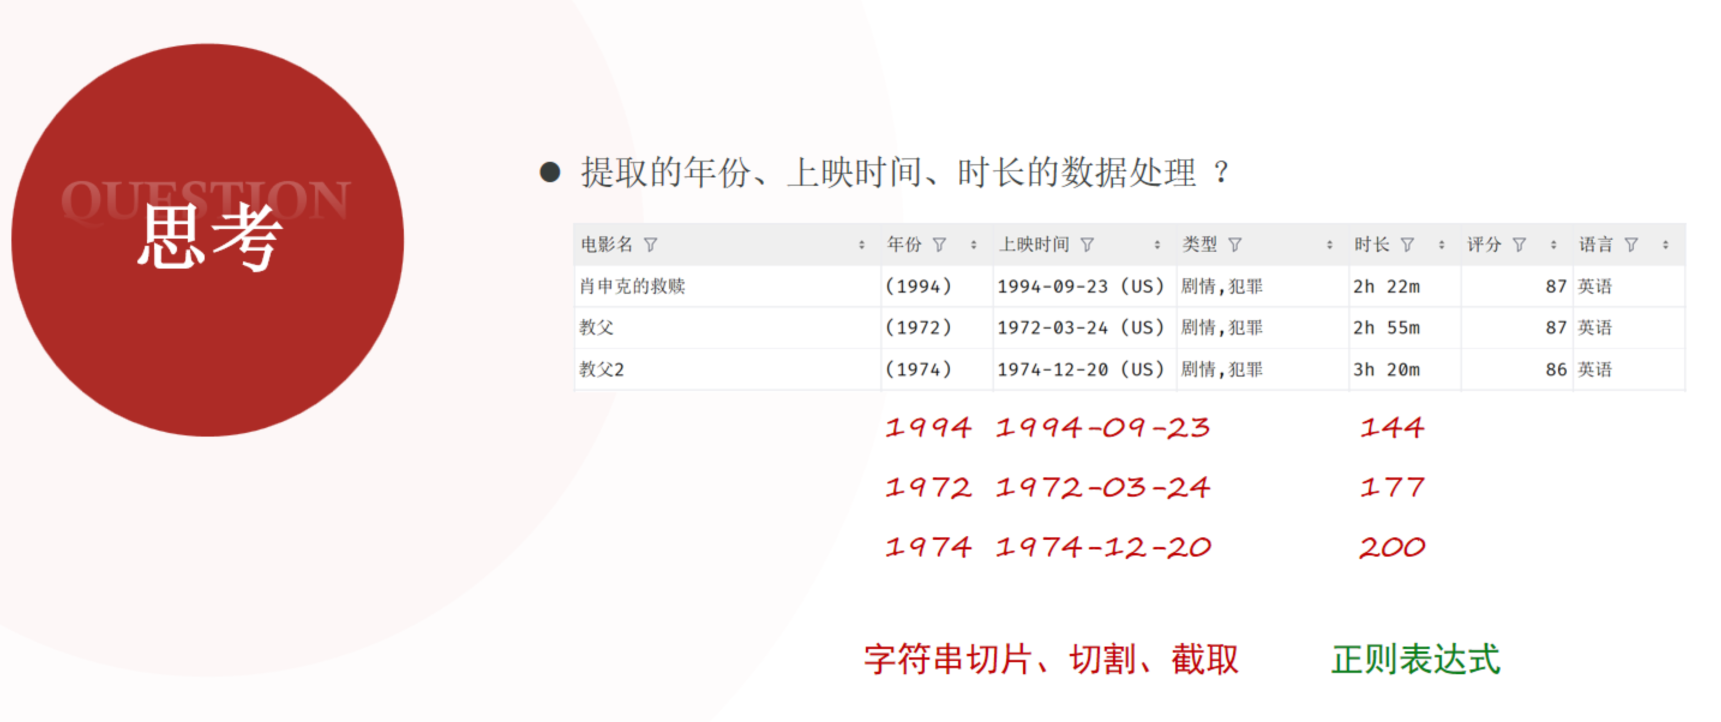
可以采用正则表达式。
正则表达式(Regular Expression)是一种用特定语法规则组成的字符串模式,用来描述、匹配或替换文本中符合某种规则的字符序列,可以理解为是专门用于文本处理的“高级查找和匹配公式”。
例如:
1[3-9]\d{9}
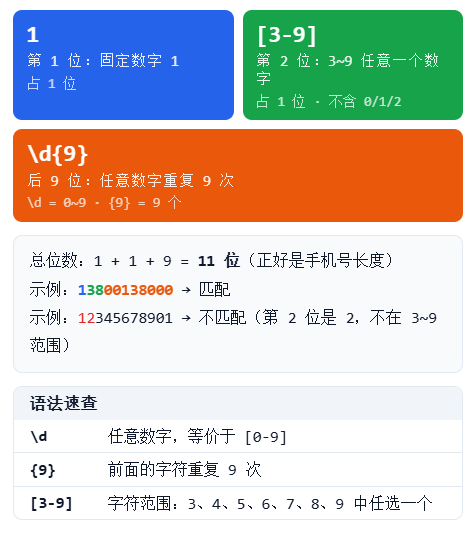
示例代码:
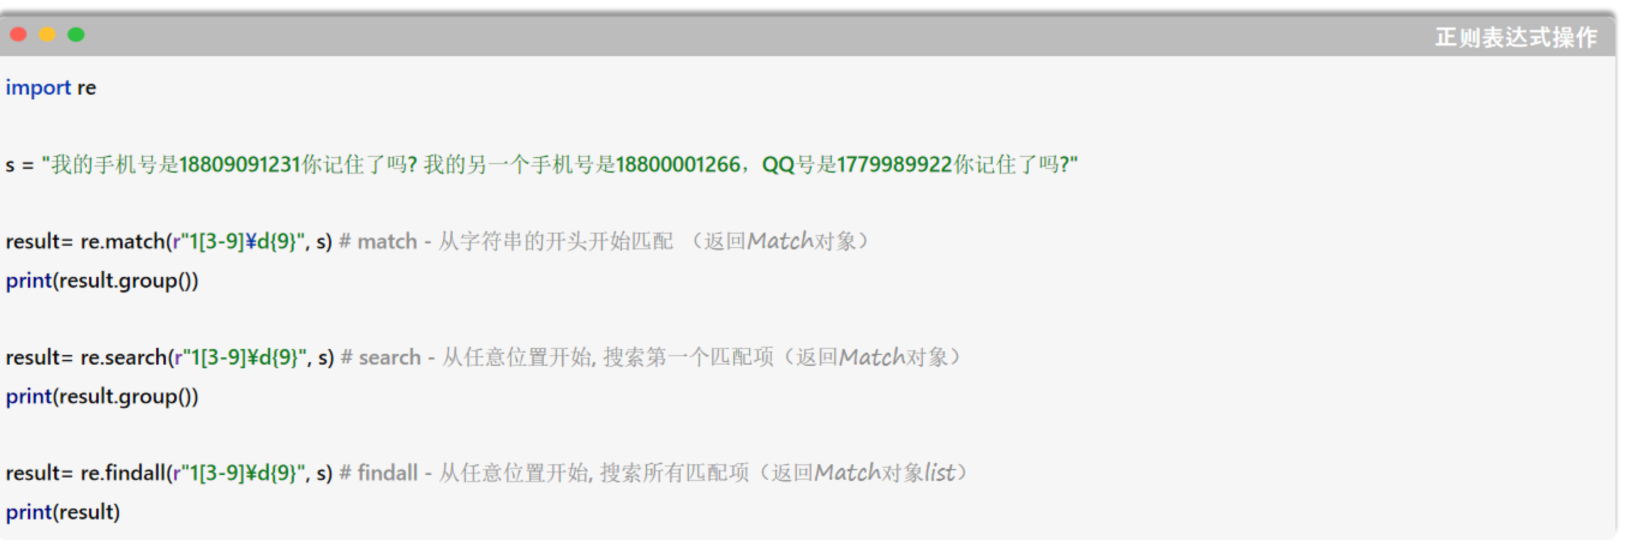
-
match:必须从字符串开头匹配,开头不对就返回None。你的字符串开头是 “我的手机号是”,所以它直接失败 ——这段代码要报错。 -
search:从任意位置找第一个匹配,返回Match对象(有.group())。 -
findall:从任意位置找所有匹配,直接返回字符串列表(没有.group())。 -
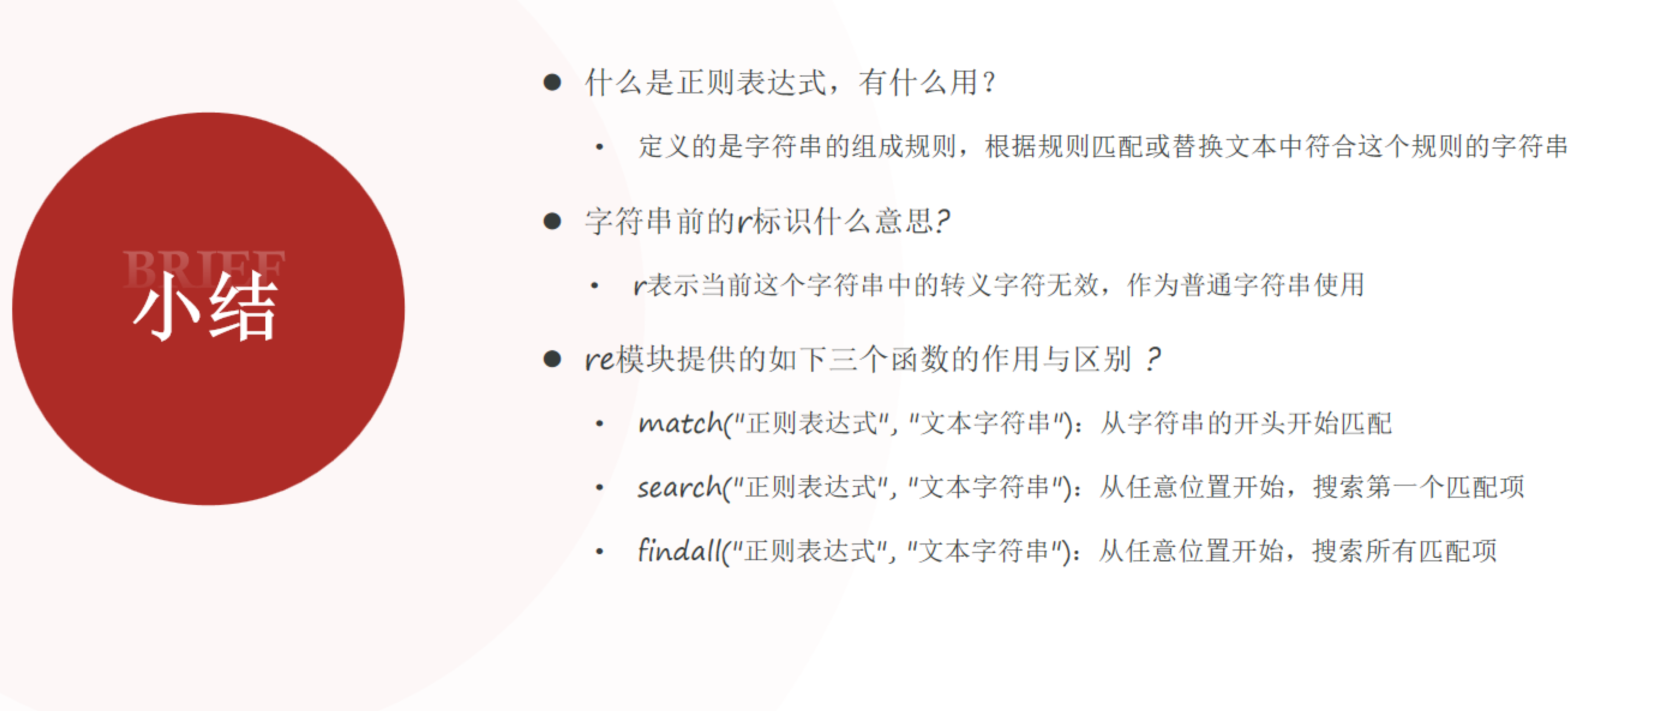
r表示原始字符串(raw string):告诉 Python 字符串里的反斜杠不要当转义符处理。比如\d如果不加r,Python 会在普通字符串里尝试转义\d(不是合法转义序列,会告警)。加了r后\d、\s、\n这些正则写法原样传给 re 模块解析,是正则的标准写法
-
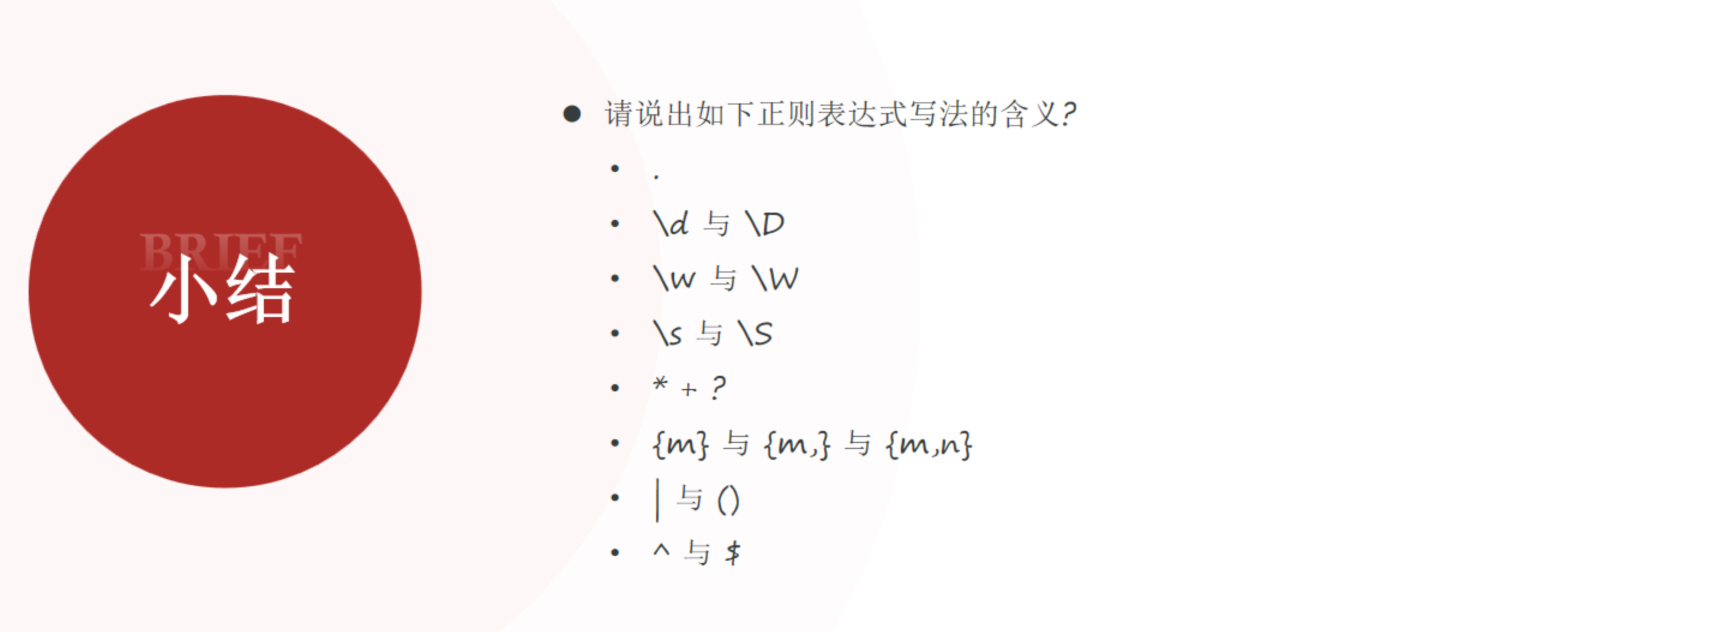
正则表达式语法
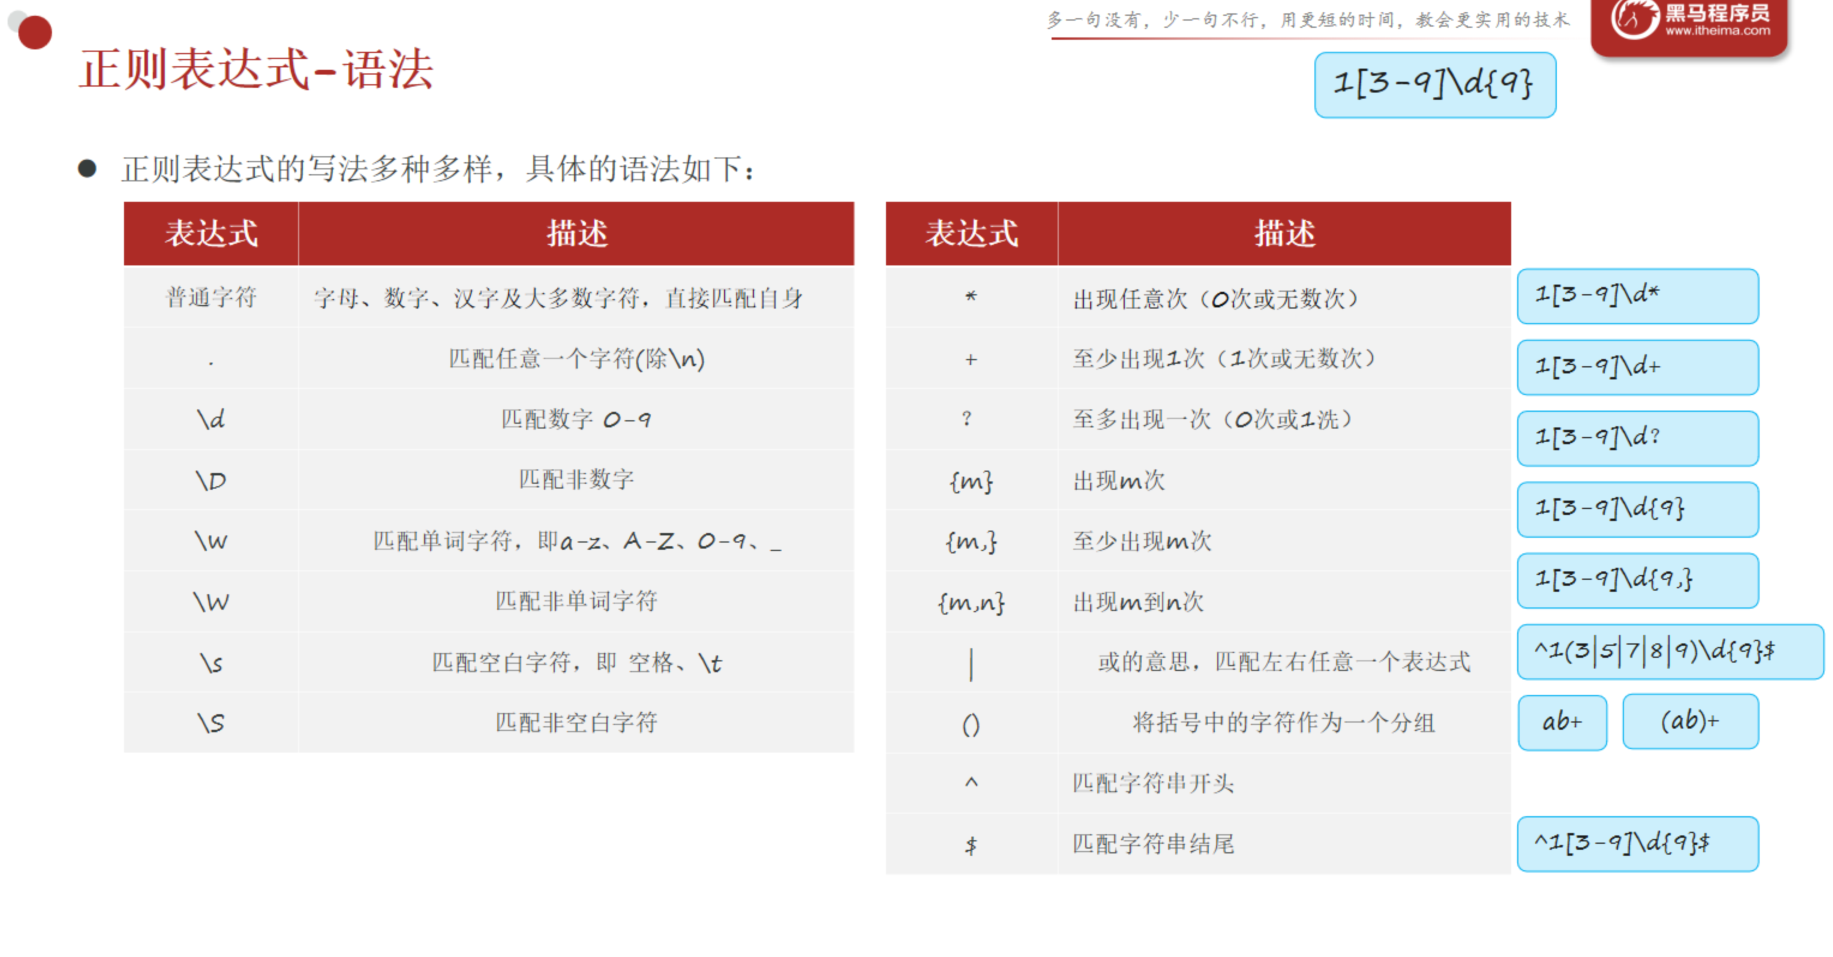
- \w:包括中文字符,日文字符等
- \W:相当于w取反
示例代码:
import re

s1 = "18809090000是我的手机号,188开头的,以00结尾的;我的另一个手机号是15500008888,两个QQ号分别是1259989092和13809091293821,邮箱为python666@163.com,请给我发邮件。"

# 正则表达式
# print(re.findall(r"188.*", s1)) # * 匹配任何个
# print(re.findall(r"188.?", s1)) # ? 匹配0个或者1个 (最多出现一次)
# print(re.findall(r"188.+", s1)) # + 匹配1个或者多个 (最少出现一次)

# print(re.findall(r"188\d{8}", s1)) # {8} 匹配8个
# print(re.findall(r"155\d{6,10}", s1)) # {6,10} 匹配6到10个
# print(re.findall(r"155\d{6,}", s1)) # {6,} 匹配6个或者更多

# print(re.findall(r"1[38]\d{8}", s1)) # [38] 匹配3或者8
# print(re.findall(r"1[^38]\d{8}", s1)) # [^38] 匹配非 3或者8
# print(re.findall(r"1[3-9]\d{8}", s1)) # [3-9] 匹配3到9 (范围)
# print(re.findall(r"^1[3-9]\d{9}", s1)) # ^ 匹配开头
# print(re.findall(r"^1[3-9]\d{9}$", s1)) # $ 匹配结尾

# print(re.findall(r"\w+@\w+\.\w+", s1)) # \w 匹配任何单词字符(a-z、A-Z、0-9、_、其它语言字符) -- 默认行为
# print(re.findall(r"\w+@\w+\.\w+", s1, re.ASCII)) # \w 匹配任何单词字符(a-z、A-Z、0-9、_)

# 注意
s2 = "现在的时间是2026-02-06 10:05:25, 今天的天气还可以, 气温是28度 "
print(re.findall(r"\d{4}-\d{2}-\d{2}", s2))
print(re.findall(r"(\d{4})-(\d{2})-(\d{2})", s2))
- 结合正则表达式优化案例
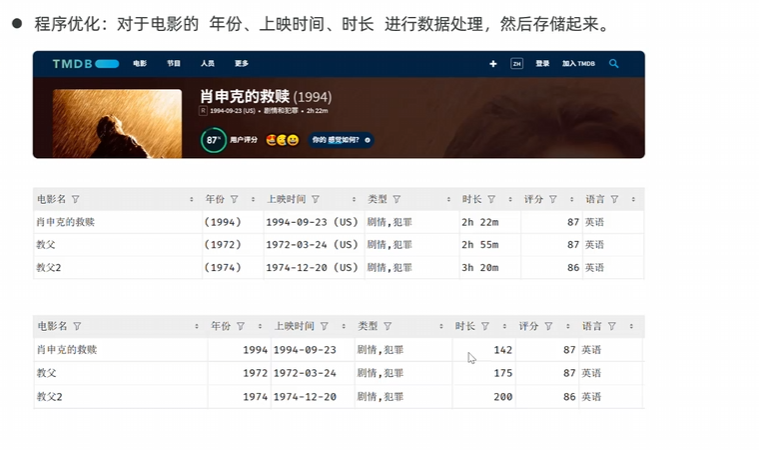
将括号替换为空串:
def get_movie_year(movie_years):
    movie_year = movie_years[0].strip() if movie_years else ''
    return movie_year.replace("(", "").replace(")", "")
获取电影上映时间、统一时长格式:
# 获取电影上映时间
def get_movie_publish_date(movie_dates):
    movie_date = movie_dates[0].strip() if movie_dates else '' # 1957-04-10 (US)
    return re.search(r"\d{4}-\d{2}-\d{2}", movie_date).group() # 1957-04-10

# 获取电影时长 (统一转换为分钟, 如: 2h 20m --> 140)
def get_movie_cost_time(movie_cost_times):
    movie_cost_time = movie_cost_times[0].strip() if movie_cost_times else '' # 2h 20m / 40m / 2h
    h_res = re.search(r"(\d+)h", movie_cost_time)
    m_res = re.search(r"(\d+)m", movie_cost_time)
    h = int(h_res.group(1)) if h_res else 0
    m = int(m_res.group(1)) if m_res else 0
    return h * 60 + m
re.search()返回的不是字符串,而是一个 Match 对象,.group()是 “从对象里把匹配到的文本拿出来”
的方法。
✋
完整代码:
import re
import requests
import csv
from lxml import html
# 常量
MOVIE_LIST_FILE = "csv_data/movie_list.csv"
TMDB_BASE_URL = "https://www.themoviedb.org"
TMDB_TOP_URL_1 = "https://www.themoviedb.org/movie/top-rated" # 高分电影榜单的url(第1页)
TMDB_TOP_URL_2 = "https://www.themoviedb.org/discover/movie/items" # 高分电影榜单的url(第2页之后)
# 保存电影数据, 保存为 csv 文件
def save_all_movies(all_movies):
with open(MOVIE_LIST_FILE, "w", encoding="utf-8", newline="") as csvfile:
writer = csv.DictWriter(csvfile, fieldnames=["电影名", "年份", "上映时间", "类型", "时长", "评分", "语言", "导演", "作者", "宣传语", "简介"])
writer.writeheader() # 写入表头
writer.writerows(all_movies) # 写入数据
def get_movie_year(movie_years):
movie_year = movie_years[0].strip() if movie_years else ''
return movie_year.replace("(", "").replace(")", "")
# 获取电影上映时间
def get_movie_publish_date(movie_dates):
movie_date = movie_dates[0].strip() if movie_dates else '' # 1957-04-10 (US)
return re.search(r"\d{4}-\d{2}-\d{2}", movie_date).group() # 1957-04-10
# 获取电影时长 (统一转换为分钟, 如: 2h 20m --> 140)
def get_movie_cost_time(movie_cost_times):
movie_cost_time = movie_cost_times[0].strip() if movie_cost_times else '' # 2h 20m / 40m / 2h
h_res = re.search(r"(\d+)h", movie_cost_time)
m_res = re.search(r"(\d+)m", movie_cost_time)
h = int(h_res.group(1)) if h_res else 0
m = int(m_res.group(1)) if m_res else 0
return h * 60 + m
# 获取电影详情
def get_movie_info(movie_info_url):
# 1. 发送请求, 获取电影详情数据
movie_response = requests.get(movie_info_url, timeout=60)
print(f"发送请求{movie_info_url}, 获取电影详情数据 ...")
# 2. 解析数据, 获取电影详情
movie_doc = html.fromstring(movie_response.text)
movie_names = movie_doc.xpath("//*[@id='original_header']/div[2]/section/div[1]/h2/a/text()") # 电影名称
movie_years = movie_doc.xpath("//*[@id='original_header']/div[2]/section/div[1]/h2/span/text()") # 上映年份
movie_dates = movie_doc.xpath(
"//*[@id='original_header']/div[2]/section/div[1]/div/span[@class='release']/text()") # 上映时间
movie_tags = movie_doc.xpath(
"//*[@id='original_header']/div[2]/section/div[1]/div/span[@class='genres']/a/text()") # 类型
movie_cost_times = movie_doc.xpath(
"//*[@id='original_header']/div[2]/section/div[1]/div/span[@class='runtime']/text()") # 时长
movie_scores = movie_doc.xpath("//*[@id='consensus_pill']/div/div[1]/div/div/@data-percent") # 评分
movie_languages = movie_doc.xpath("//*[@id='media_v4']/div/div/div[2]/div/section/div[1]/div/section[1]/p[3]/text()") # 语言
movie_directors = movie_doc.xpath("//*[@id='original_header']/div[2]/section/div[3]/ol/li[1]/p[1]/a/text()") # 导演
movie_authors = movie_doc.xpath("//*[@id='original_header']/div[2]/section/div[3]/ol/li[2]/p[1]/a/text()") # 作者
movie_slogans = movie_doc.xpath("//*[@id='original_header']/div[2]/section/div[3]/h3[1]/text()") # 宣传语
movie_descriptions = movie_doc.xpath("//*[@id='original_header']/div[2]/section/div[3]/div/p/text()") # 简介
# 3. 返回电影详情 - 字典
movie_info = {
"电影名": movie_names[0].strip() if movie_names else '',
"年份": get_movie_year(movie_years),
"上映时间": get_movie_publish_date(movie_dates),
"类型": ",".join(movie_tags) if movie_tags else '',
"时长": get_movie_cost_time(movie_cost_times),
"评分": movie_scores[0].strip() if movie_scores else '',
"语言": movie_languages[0].strip() if movie_languages else '',
"导演": ",".join(movie_directors) if movie_directors else '',
"作者": ",".join(movie_authors) if movie_authors else '',
"宣传语": movie_slogans[0].strip() if movie_slogans else '',
"简介": movie_descriptions[0].strip() if movie_descriptions else ''
}
return movie_info
# 主函数, 定义核心逻辑
def main():
all_movies = [] # 保存所有的电影数据
# 循环获取电影列表(第1页到第5页)
for page_num in range(1, 6):
# 1.发送请求, 获取高分电影榜单数据
if page_num == 1:
response = requests.get(TMDB_TOP_URL_1, timeout=60)
else:
response = requests.post(TMDB_TOP_URL_2,
f"air_date.gte=&air_date.lte=&certification=&certification_country=CN&debug=&first_air_date.gte=&first_air_date.lte=&include_adult=false&latest_ceremony.gte=&latest_ceremony.lte=&page={page_num}&primary_release_date.gte=&primary_release_date.lte=®ion=&release_date.gte=&release_date.lte=2026-07-31&show_me=everything&sort_by=vote_average.desc&vote_average.gte=0&vote_average.lte=10&vote_count.gte=300&watch_region=CN&with_genres=&with_keywords=&with_networks=&with_origin_country=&with_original_language=&with_watch_monetization_types=&with_watch_providers=&with_release_type=&with_runtime.gte=0&with_runtime.lte=400",
timeout=60)
print(f"发送请求, 访问第{page_num}页的数据, 获取TMDB电影榜单数据 ...")
# 2.解析数据, 获取电影列表
document = html.fromstring(response.text)
movie_list = document.xpath(f"//*[@id='page_{page_num}']//div[contains(@class,'media-list-results')]/div[contains(@class,'w-full')]")
# 3.遍历电影列表, 获取电影详情
for movie in movie_list:
movie_urls = movie.xpath("./div/div/a/@href")
if movie_urls:
# 电影详情的url
movie_info_url = TMDB_BASE_URL + movie_urls[0]
# 发送请求, 获取电影详情数据
movie_info = get_movie_info(movie_info_url)
all_movies.append(movie_info)
# 4.保存数据, 保存为 csv 文件
print("获取到所有的电影详情, 保存电影数据到CSV文件 ...")
save_all_movies(all_movies)
if __name__ == '__main__':
main()

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)