具身智能工业视觉分析与物联监护应用实训报告
实训报告--具身智能工业视觉分析与物联监护应用演练
拟制__________________________________________________________
摘要:本实训围绕具身智能工业视觉分析与物联监护应用展开,涵盖工业视觉获取与分析、OCR快速编码实现、IoTDA中转空间构建以及CodeArts智慧路灯快速构建与部署等核心环节,最终实现视觉识别与设备物联监护的端到端演练。通过本实训,可掌握工业相机接入、OCR识别、设备注册模拟及云端部署等关键技能。
关键词:具身智能;工业视觉;OCR识别;IoTDA;CodeArts
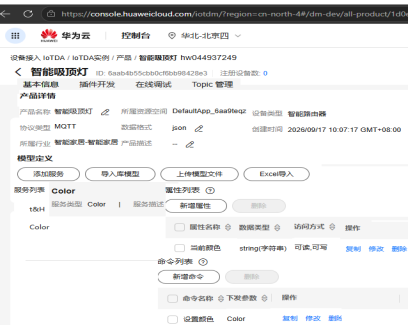
1 工效组合展示
2 具身智能工业视觉获取与分析应用
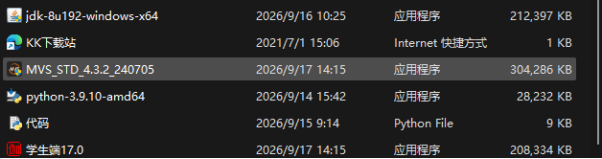
2.1 工具软件安装
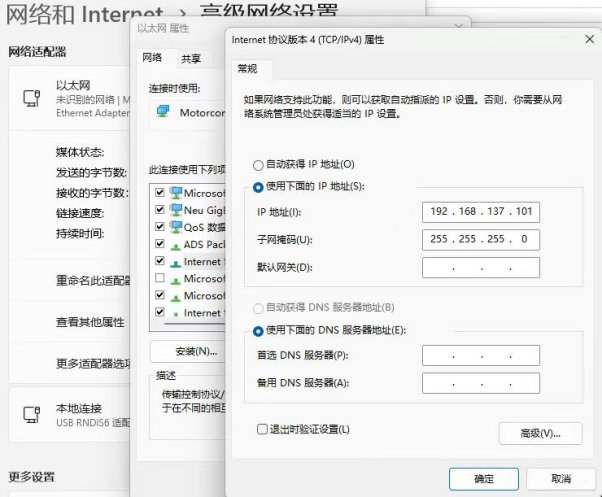
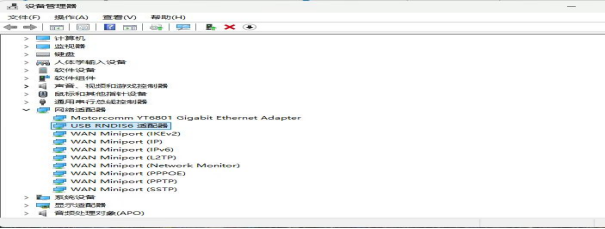
2.2 工业视觉环境构建与应用
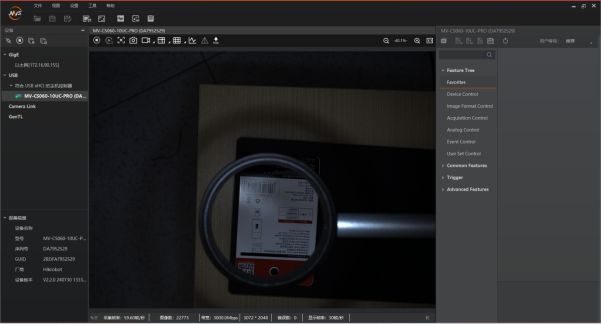
2.3 昇腾工业视觉终端应用展现
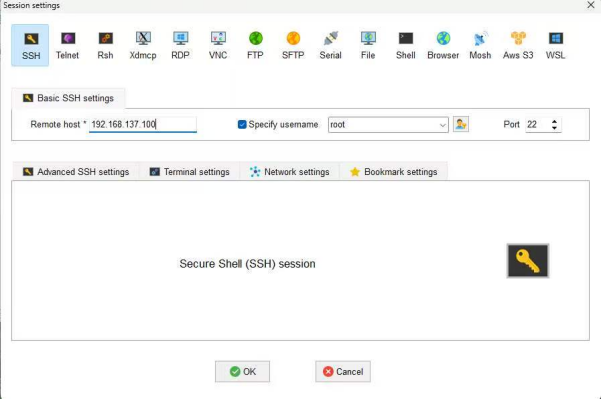
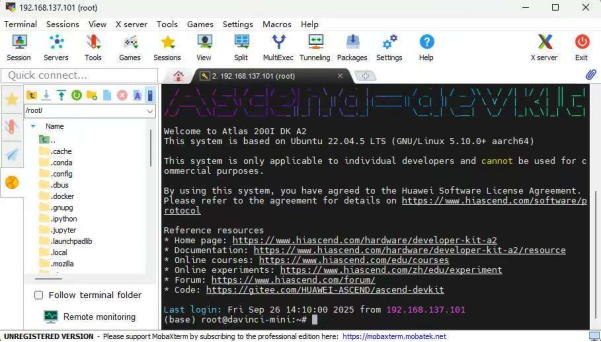
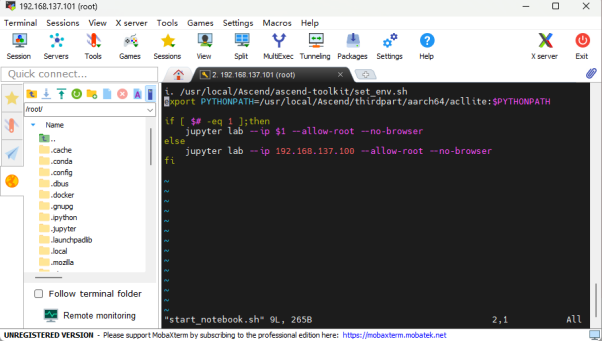
3 具身智能工业视觉识别快速编码实现
3.1 IMA-DS借力
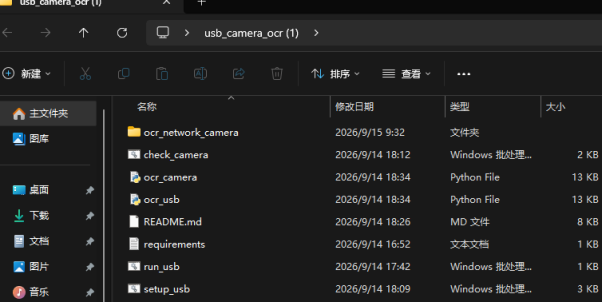
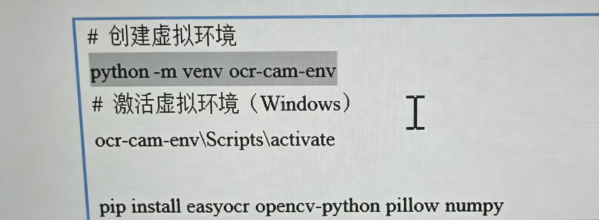
给出Python虚拟环境OCR文字识别编码及其运行过程,包括汉字Windows环境、CPU运行、非CONDA,使用本机USB连接海康工业相机,编码使用一个完整工作夹。
3.2 运行环境构造
3.3 编码实现
import argparse
import os
import sys
import time
# ---------- 解决 Windows 控制台中文输出乱码 ----------
if sys.platform == "win32":
try:
sys.stdout.reconfigure(encoding="utf-8")
sys.stderr.reconfigure(encoding="utf-8")
except Exception:
pass
import cv2
import numpy as np
from PIL import Image, ImageDraw, ImageFont
# =====================================================================
# 配置区(按你的实际情况修改)
# =====================================================================
# 网络摄像机视频流地址。三选一,把用户名/密码/IP/端口替换成你自己的:
#
# 1) 海康威视 RTSP 主码流(清晰、延迟略高):
# rtsp://用户名:密码@IP:554/Streaming/Channels/101
# 2) 大华 RTSP 主码流:
# rtsp://用户名:密码@IP:554/cam/realmonitor?channel=1&subtype=0
# 3) 通用 HTTP MJPEG 码流(很多杂牌摄像头 / 网页预览地址):
# http://用户名:密码@IP:8080/video
# 或 http://IP:8080/?action=stream
#
# 注意:密码里如果含特殊字符(如 @ : / #),需要做 URL 编码,例如 @ -> %40
CAMERA_URL = "rtsp://admin:12345@192.168.1.64:554/Streaming/Channels/101"
# OCR 参数
LANG = "ch" # ch=中英文混合;en=英文;更多见 PaddleOCR 文档
USE_ANGLE_CLS = True # 文本方向分类,可提升旋转文字的识别效果
USE_GPU = False # 是否使用 GPU(True 需安装 paddlepaddle-gpu)
OCR_INTERVAL = 0.5 # 两次 OCR 之间的最小间隔(秒),避免 CPU 满载
OCR_RESIZE = 1280 # OCR 前把画面等比缩小到该宽度(加速检测,0=不缩放)
SHOW_SCORE = True # 是否在画面上显示识别置信度
# 中文字体(Windows 系统自带黑体,用于在画面上写中文;如不存在则回退)
FONT_PATH = r"C:\Windows\Fonts\simhei.ttf"
# 按键说明(运行时)
# q / ESC 退出
# s 保存当前画面和识别结果(保存到 snapshot_*.jpg / *.txt)
# =====================================================================
def draw_chinese_text(img_bgr, text, pos, font_path=FONT_PATH, font_size=18,
color=(0, 255, 0)):
"""在 OpenCV 的 BGR 图像上绘制中文文字。
OpenCV 自带的 cv2.putText 无法显示中文,这里借助 Pillow 完成中文渲染。
"""
img_rgb = cv2.cvtColor(img_bgr, cv2.COLOR_BGR2RGB)
pil_img = Image.fromarray(img_rgb)
draw = ImageDraw.Draw(pil_img)
try:
font = ImageFont.truetype(font_path, font_size)
except Exception:
# 找不到字体时回退为默认字体(此时中文无法显示,仅作为容错)
font = ImageFont.load_default()
# PIL 的颜色是 RGB,需要把 OpenCV 的 BGR 转成 RGB
draw.text(pos, text, font=font, fill=(color[2], color[1], color[0]))
return cv2.cvtColor(np.array(pil_img), cv2.COLOR_RGB2BGR)
class OCREngine:
"""封装 PaddleOCR,兼容 2.x 与 3.x 两种主流版本的 API。"""
def __init__(self, lang=LANG, use_angle_cls=USE_ANGLE_CLS, use_gpu=USE_GPU):
# 延迟导入:PaddleOCR 首次导入较慢,且未安装时给出友好提示
try:
from paddleocr import PaddleOCR
except ImportError as e:
print("[错误] 未安装 PaddleOCR,请先运行:pip install -r requirements.txt")
raise e
self.use_angle_cls = use_angle_cls
# 依次尝试不同版本的初始化参数(PaddleOCR 3.x 与 2.x 参数名不同)
attempts = []
# PaddleOCR 3.x:GPU 用 device 参数;CPU 不传(默认即 CPU)
p3 = dict(lang=lang,
use_textline_orientation=use_angle_cls,
use_doc_orientation_classify=False,
use_doc_unwarping=False,
enable_mkldnn=False) # 修复 PaddlePaddle 3.3.x CPU 推理崩溃
if use_gpu:
p3["device"] = "gpu"
attempts.append(p3)
# PaddleOCR 2.x:用 use_gpu 参数
attempts.append(dict(lang=lang, use_angle_cls=use_angle_cls,
use_gpu=use_gpu, show_log=False))
# 兜底:最小参数
attempts.append(dict(lang=lang))
last_err = None
for params in attempts:
try:
self.engine = PaddleOCR(**params)
break
except (TypeError, ValueError) as e:
last_err = e
else:
raise last_err
# 3.x 用 predict(),2.x 用 ocr()
self.is_v3 = hasattr(self.engine, "predict")
def recognize(self, img_bgr):
"""识别一帧 BGR 图像,返回 [(box, text, score), ...]。
box 为 4 个角点坐标 [[x1,y1],[x2,y2],[x3,y3],[x4,y4]]。
"""
items = []
if self.is_v3:
result = self.engine.predict(img_bgr)
else:
result = self.engine.ocr(img_bgr, cls=self.use_angle_cls)
if result is None:
return items
# 若返回的是单个结果对象而非列表,统一成列表
if isinstance(result, dict):
result = [result]
for page in result:
if page is None:
continue
# ---- PaddleOCR 3.x:OCRResult 支持 dict 访问 ----
try:
texts = page["rec_texts"]
boxes = page["rec_boxes"]
scores = page["rec_scores"]
for box, text, score in zip(boxes, texts, scores):
items.append((box, text, float(score)))
continue
except (KeyError, TypeError):
pass
# ---- PaddleOCR 2.x:[[box, (text, score)], ...] ----
for line in page:
try:
box, (text, score) = line[0], line[1]
items.append((box, text, float(score)))
except Exception:
continue
return items
def draw(self, frame_bgr, items, show_score=SHOW_SCORE):
"""把识别结果绘制到画面(中文标签)。"""
for box, text, score in items:
pts = np.array(box, dtype=np.int32).reshape((-1, 1, 2))
cv2.polylines(frame_bgr, [pts], True, (0, 255, 0), 2)
x = int(pts[0][0][0])
y = int(pts[0][0][1])
label = text
if show_score:
label = f"{text} {score:.2f}"
# 文字放在框上方,若超出顶部则放到框内部
ty = max(0, y - 26)
frame_bgr = draw_chinese_text(frame_bgr, label, (x, ty),
font_size=18, color=(0, 255, 0))
return frame_bgr
def open_capture(url):
"""打开视频流,失败时尝试常见后端。"""
backends = [
(cv2.CAP_FFMPEG, "FFmpeg"),
(cv2.CAP_ANY, "自动"),
]
for backend, name in backends:
cap = cv2.VideoCapture(url, backend)
if cap.isOpened():
print(f"[信息] 视频流打开成功(后端:{name})")
return cap
cap.release()
return None
def run_camera(url, lang=LANG, use_gpu=USE_GPU):
"""主循环:读取网络摄像机并做 OCR。"""
cap = open_capture(url)
if cap is None:
print(f"[错误] 无法打开视频流:{url}")
print(" 请检查:1) 摄像机和电脑在同一局域网 2) 用户名/密码正确")
print(" 3) 先用 VLC/ffplay 验证流地址是否可播放")
return
engine = OCREngine(lang=lang, use_gpu=use_gpu)
last_items = []
last_ocr_time = 0.0
print("[信息] 按 q 或 ESC 退出;按 s 保存当前画面和识别结果。")
while True:
ok, frame = cap.read()
if not ok:
print("[警告] 读取帧失败,正在尝试重连…")
cap.release()
time.sleep(1.0)
cap = open_capture(url)
if cap is None:
print("[错误] 重连失败,退出。")
break
continue
now = time.time()
# 按固定间隔执行 OCR(OCR 较耗 CPU,无需每帧都跑)
if now - last_ocr_time >= OCR_INTERVAL:
last_ocr_time = now
img = frame
if OCR_RESIZE and frame.shape[1] > OCR_RESIZE:
scale = OCR_RESIZE / frame.shape[1]
img = cv2.resize(frame, None, fx=scale, fy=scale,
interpolation=cv2.INTER_AREA)
try:
last_items = engine.recognize(img)
# 打印到控制台
if last_items:
print("-" * 40)
for box, text, score in last_items:
print(f" 识别:{text} (置信度 {score:.2f})")
except Exception as e:
print(f"[错误] OCR 识别失败:{e}")
# 绘制结果
display = engine.draw(frame.copy(), last_items)
# 顶部提示
tip = f"FPS 目标间隔 {OCR_INTERVAL}s | 识别到 {len(last_items)} 段文字 | q 退出 / s 保存"
display = draw_chinese_text(display, tip, (10, 10),
font_size=16, color=(0, 200, 255))
cv2.imshow("Network Camera OCR - 按 q 退出", display)
key = cv2.waitKey(1) & 0xFF
if key in (ord("q"), 27): # q 或 ESC
break
elif key == ord("s"):
stamp = time.strftime("%Y%m%d_%H%M%S")
jpg_path = f"snapshot_{stamp}.jpg"
txt_path = f"snapshot_{stamp}.txt"
cv2.imwrite(jpg_path, display)
with open(txt_path, "w", encoding="utf-8") as f:
f.write("\n".join(f"{text}\t{score:.4f}" for _, text, score in last_items))
print(f"[信息] 已保存画面:{jpg_path} 和识别结果:{txt_path}")
cap.release()
cv2.destroyAllWindows()
def run_image(image_path, lang=LANG, use_gpu=USE_GPU):
"""识别单张图片(用于验证安装)。"""
if not os.path.exists(image_path):
print(f"[错误] 文件不存在:{image_path}")
return
engine = OCREngine(lang=lang, use_gpu=use_gpu)
frame = cv2.imdecode(np.fromfile(image_path, dtype=np.uint8), cv2.IMREAD_COLOR)
if frame is None:
print(f"[错误] 无法读取图片:{image_path}")
return
print("[信息] 正在识别,首次运行会自动下载模型(约 100~300MB),请耐心等待…")
items = engine.recognize(frame)
print("=" * 50)
for box, text, score in items:
print(f" {text}\t置信度 {score:.4f}")
print("=" * 50)
print(f"共识别到 {len(items)} 段文字")
result = engine.draw(frame.copy(), items)
out = "ocr_result.jpg"
cv2.imencode(".jpg", result)[1].tofile(out)
print(f"[信息] 结果图已保存:{out}")
def main():
parser = argparse.ArgumentParser(description="网络摄像机中文 OCR")
parser.add_argument("--url", default=CAMERA_URL,
help="网络摄像机 RTSP/HTTP 流地址")
parser.add_argument("--camera", type=int, default=None,
help="使用本地 USB 摄像头(设备编号,通常为 0)")
parser.add_argument("--image", default=None,
help="识别单张图片(用于测试)")
parser.add_argument("--lang", default=LANG, help="识别语言,如 ch / en")
parser.add_argument("--gpu", action="store_true", help="使用 GPU 加速")
args = parser.parse_args()
if args.image:
run_image(args.image, lang=args.lang, use_gpu=args.gpu)
elif args.camera is not None:
run_camera(args.camera, lang=args.lang, use_gpu=args.gpu)
else:
run_camera(args.url, lang=args.lang, use_gpu=args.gpu)
if __name__ == "__main__":
main()
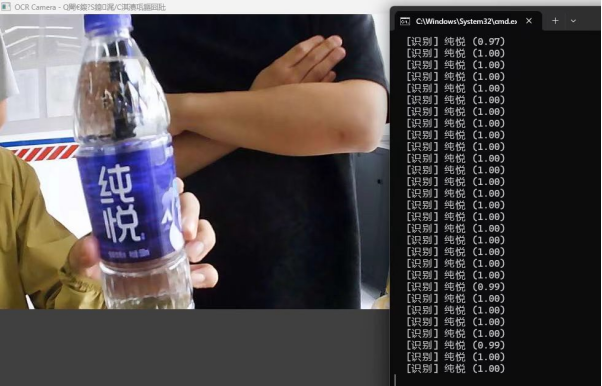
运行上述代码后,程序会打开网络摄像机的实时画面,并在画面中自动框出识别到的文字区域,同时在每个文字框上方以绿色中文标注显示识别出的文本内容及置信度(例如“产品型号 0.98”)。控制台会同步打印识别结果,格式为“识别:产品型号(置信度 0.98)”,便于核对识别是否准确。若画面中无文字,则不会绘制任何标注,顶部提示栏会显示“识别到 0 段文字”。
复现时需重点调整以下两个关键参数:
- CAMERA_URL:网络摄像机视频流地址。默认值为海康威视 RTSP 主码流地址,需将用户名、密码、IP 和端口替换为实际设备信息。若使用大华摄像机,可改为
rtsp://用户名:密码@IP:554/cam/realmonitor?channel=1&subtype=0;若使用普通 USB 摄像头,可在命令行通过--camera 0指定设备编号,无需修改该参数。密码中含特殊字符(如 @、:、/、#)时,需进行 URL 编码,例如 @ 编码为 %40。 - LANG:OCR 识别语言。默认值为
"ch",表示中英文混合识别,适用于包含中文标签的工业场景;若画面中仅有英文,可改为"en"以提升英文识别准确率。修改后需重新运行程序生效。
此外,若识别速度较慢,可适当调大 OCR_INTERVAL(如改为 1.0)降低 CPU 负载;若识别精度不足,可关闭 OCR_RESIZE 缩放(设为 0)以保留原始分辨率。按 s 键可保存当前画面和识别结果,便于后续分析。
3.4 运行测试
4 IoTDA中转空间构建
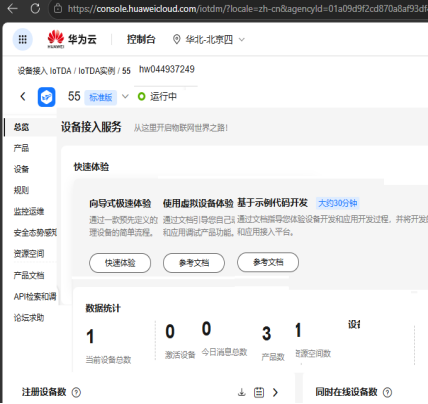
4.0 IoTDA构造
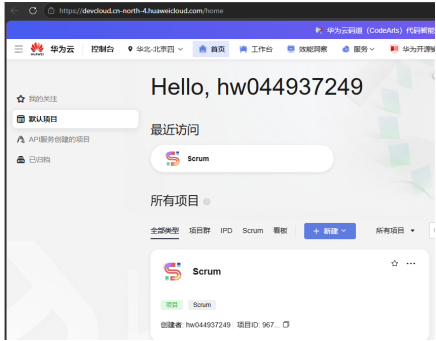
4.1 产品及其模型构建
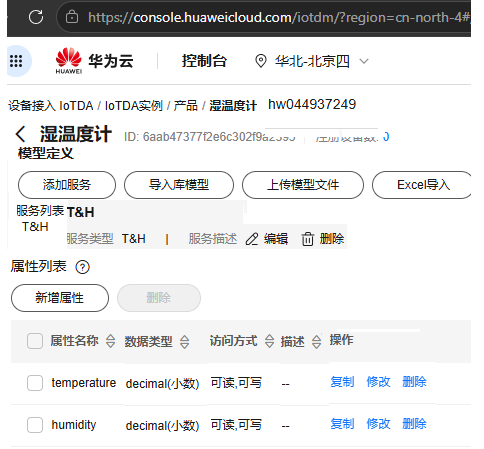
温湿度计产品信息如下:
产品信息:
- 产品名称:温湿度计
- 协议类型:MQTT
- 数据格式:JSON
- 所属行业:智能家居
- 所属子行业:智能家居
服务列表:
- 服务 ID:T&H
- 属性名称:temperature
- 数据类型:decimal
- 访问权限:可读可写
- 取值范围:-100~100
- 属性名称:humidity
- 数据类型:decimal
- 访问权限:可读可写
- 取值范围:0~100
点击“产品 》 创建产品”。
4.1.1 温湿度计
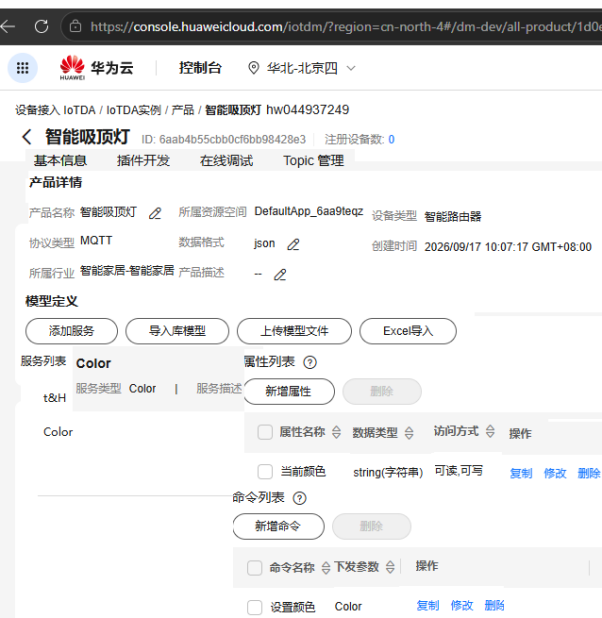
4.1.2 吸顶灯
4.2 设备实例化应用
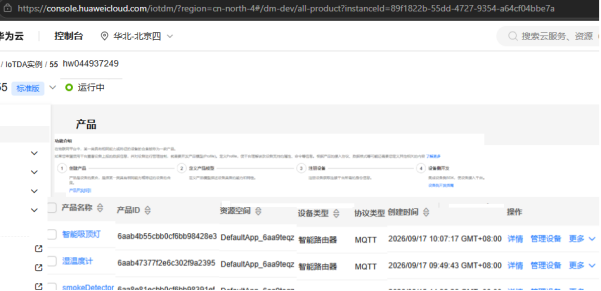
4.2.1 温湿度计设备注册及模拟测试
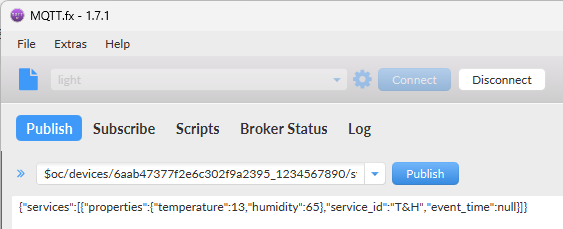
4.2.1 温湿度计设备注册及模拟测试
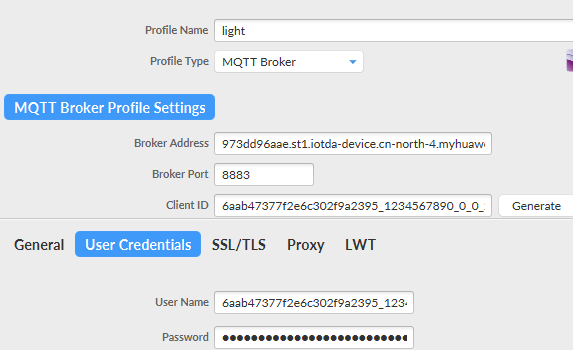
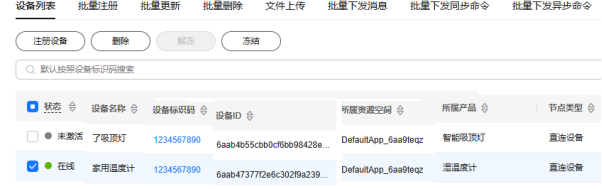
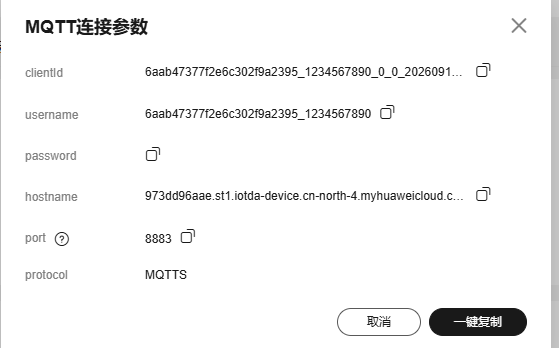
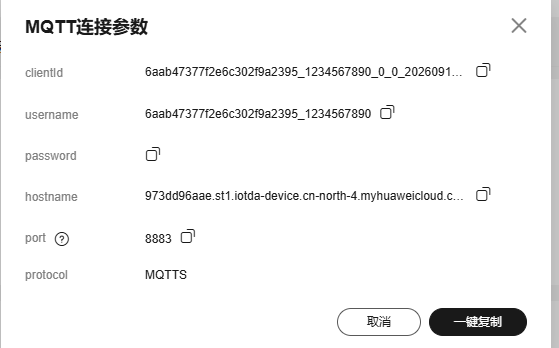
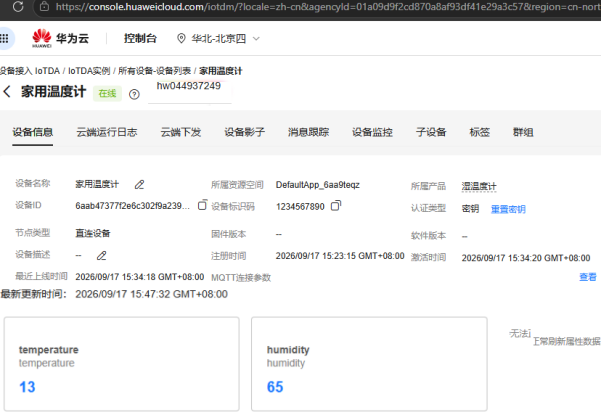
4.2.2 吸顶灯设备注册及模拟测试
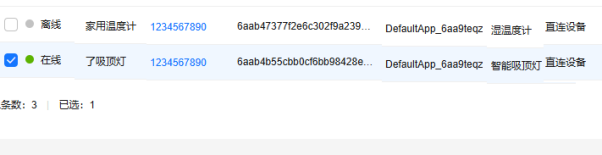
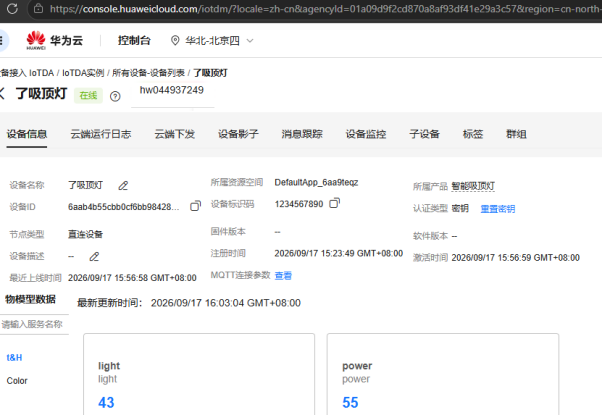
5 CodeArts智慧路灯快速构建与部署
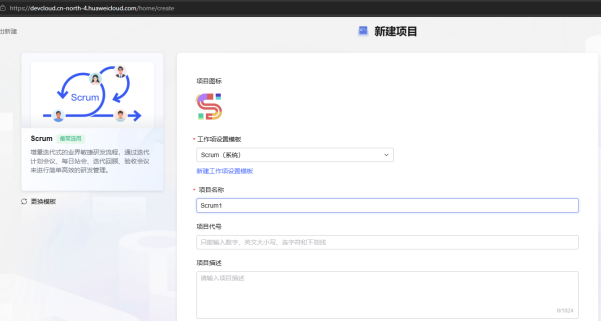
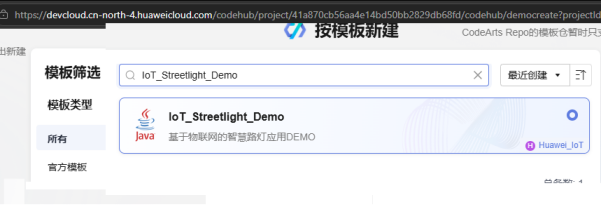
5.1 应用项目创建
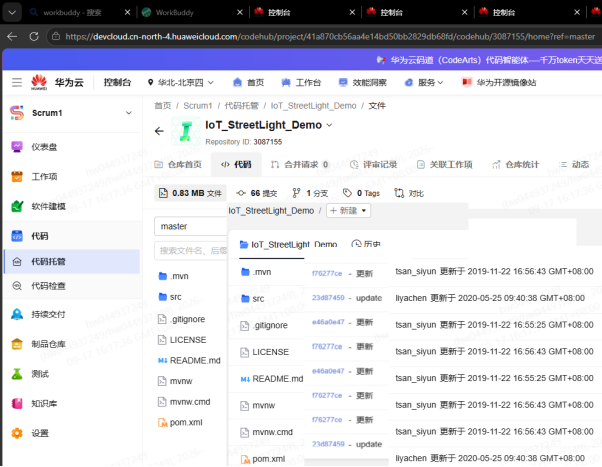
5.2 代码托管操作
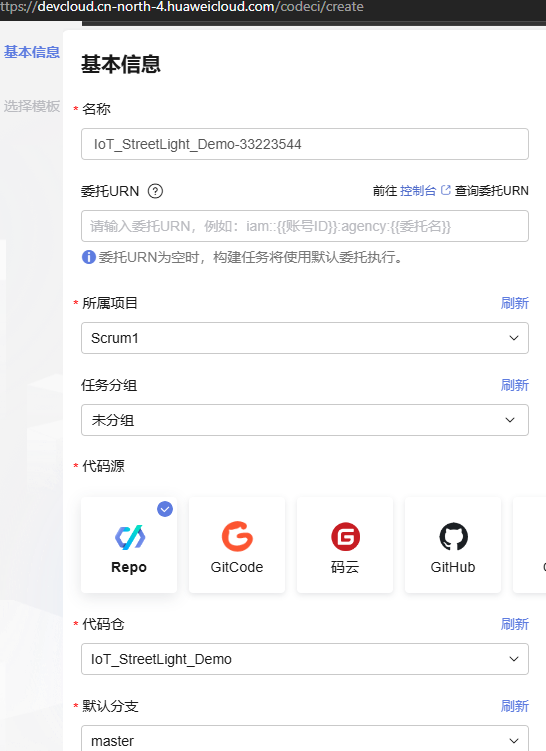
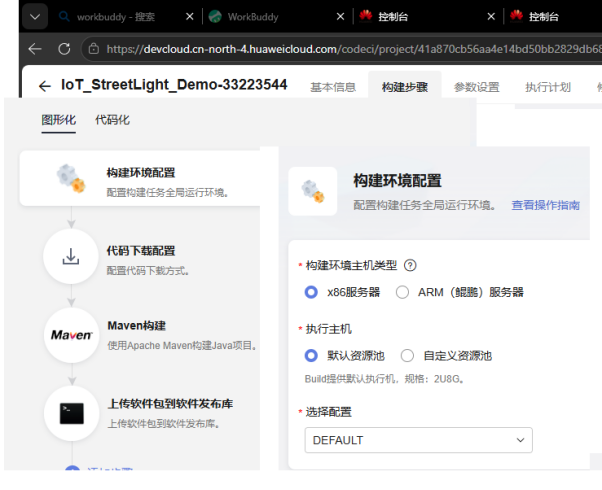
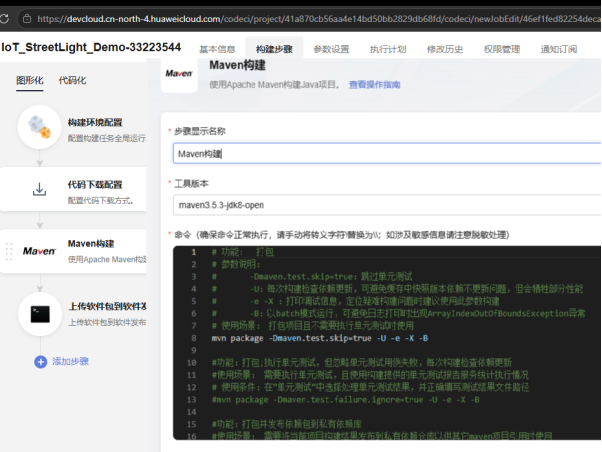
5.3 构建任务设立
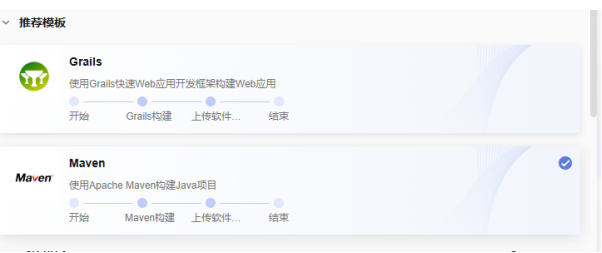
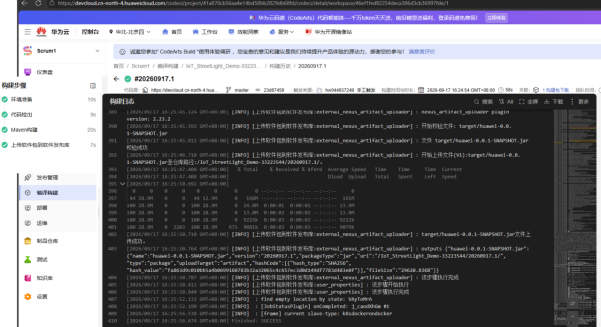
5.4 项目构建实现
5.5 项目部署运行
6 总结与展望
本实训围绕具身智能工业视觉分析与物联监护应用,完整走通了从工业视觉获取与分析、OCR快速编码实现,到IoTDA中转空间构建、CodeArts智慧路灯快速构建与部署的端到端流程。在实训过程中,我们完成了以下关键步骤:一是搭建工业视觉环境,完成工具软件安装与昇腾工业视觉终端应用展现;二是基于Python虚拟环境实现OCR文字识别编码,通过海康工业相机接入实时画面,完成中文标注与识别结果输出;三是在IoTDA平台完成产品模型构建与设备实例化,实现温湿度计、吸顶灯等设备的注册与模拟测试;四是借助CodeArts完成智慧路灯项目的创建、代码托管、构建与部署运行。
在实训过程中也遇到了一些问题,并形成了相应的解决思路。例如,在OCR编码阶段,Windows控制台中文输出出现乱码,通过重配置标准输出编码为UTF-8解决;PaddleOCR不同版本API存在差异,通过兼容2.x与3.x两种初始化参数并做兜底处理解决;CPU环境下推理速度较慢,通过设置OCR_INTERVAL控制识别间隔、OCR_RESIZE等比缩放画面来降低负载。在IoTDA设备注册阶段,需仔细核对产品模型中的服务ID、属性名称与数据类型,确保设备上报数据与模型定义一致,避免数据解析失败。
展望后续工作,可以从以下几个方向继续深化:一是将OCR识别结果与IoTDA设备数据联动,实现视觉识别驱动的物联联动控制;二是引入GPU加速与更轻量的检测模型,提升识别实时性与精度;三是结合CodeArts持续集成能力,完善自动化构建与灰度发布流程;四是探索更多工业场景,如缺陷检测、仪表读数识别等,进一步拓展具身智能工业视觉的应用边界。
7 参考资料
- PaddleOCR 官方文档:Redirecting
- PaddlePaddle 官方文档:飞桨PaddlePaddle-源于产业实践的开源深度学习平台
- OpenCV 官方文档:OpenCV documentation — OpenCV Tutorials
- 海康威视开放平台:海康开放平台
- 华为云 IoTDA 设备接入服务文档:Security Verification
- 华为云 CodeArts 软件开发生产线文档:Security Verification
- Python 官方文档:3.14.7 Documentation

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 2
 0
- 0


 已为社区贡献1条内容

所有评论(0)