Python学习笔记6——爬虫
爬虫,也称为网络爬虫(网络机器人),是一种按照一定的预设规则,自动浏览并抓取网络数据的程序或脚本。
应用场景:搜索引擎、舆情监控、商业分析、大模型语料
基础
执行流程:
开始——→发送HTTP请求——→解析结果提取数据——→数据处理(清洗)——→数据存储——→结束
数据清洗是指对采集到的原始数据进行处理、修正、转换和标准化的过程,目的是让数据变得规范、准确。
网络机器人-合规性(robots协议)
也称为爬虫协议、爬虫规则,是指网站根目录下存放的一份文本文件robots.txt,用于告诉爬虫哪些页面可以抓取,哪些页面不能抓取。
User-Agent:用户代理,通过该请求头确认爬虫的类型
Disallow:禁止访问的资源
Allow:允许访问的资源
Sitemap:网站地图,胖铸爬虫更高效地获取网站内容
Crawl-delay:爬取间隔时间,避免频繁访问造成网站压力过大
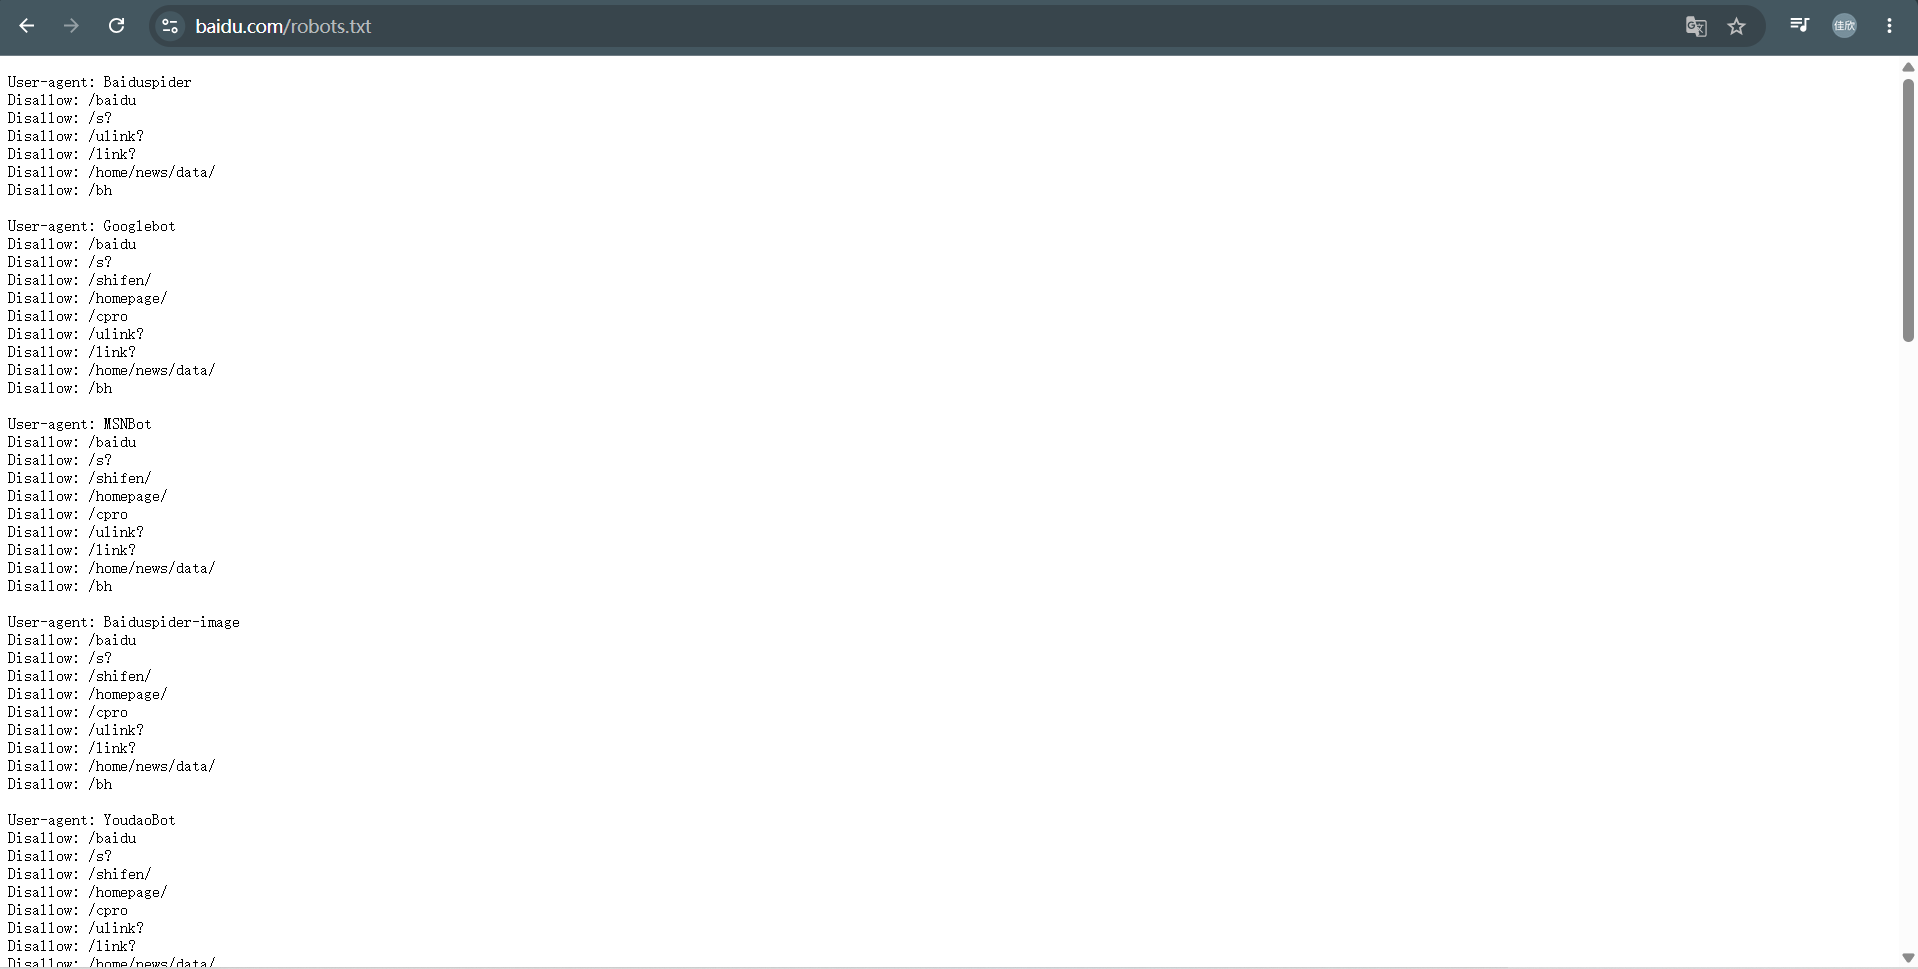
基本步骤
1.查看网站的robots.txt文件,明确资源获取的规则
2.安装requests库,用于发送网络请求(pip install requests)
3.明确页面结构,拆解具体的操作步骤,按照步骤编写Python代码,访问网站,获取数据
import requests

url = "需要爬取的网址"

reponse = requests.get(url)

# 返回的就是页面前端源代码
print(reponse.text)
网页解析
从原始HTML文档中提取数据的过程,也是网络爬虫的关键步骤,从一堆标签文本中提取出需要的数据。
lxml:是一个高性能的HTML/XML文档的解析库,支持基于Xpath语法来解析和获取网页数据。(pip install lxml)
Xpath是一种用于在HTML/XML文档中导航或定位元素的查询语言,能够准确的定位文档中的特定元素、属性或文本。
# 以tiobe网站为例
import requests
from lxml import html

url = "https://www.tiobe.com/tiobe-index/"

reponse = requests.get(url)
# print(reponse.text)

# 解析html文本,将其解析为文档对象
doc = html.fromstring(reponse.text)

# # 解析表头 - Xpath语法
# th_list = doc.xpath("//table/thead/tr/th/text()")
# print(th_list)

# # 解析表格中的数据
# # 获取第一行的数据
# td_list = doc.xpath("//table/tbody/tr[1]/td/text()")
# print(td_list)

# 获取所有行的数据
tr_list = doc.xpath("//table/tbody/tr")
for tr in tr_list:
    td_list = tr.xpath("./td/text()")
    print(td_list)
Xpath语法
| 表达式 | 描述 | 样例 |
| / | 从根节点的直接子元素 | /html/body/div/h1 |
| // | 从任意位置选择节点 | //h1 |
| . | 当前节点下查找 | ./a 与.//a |
| [n] | 选择第n个元素 | //p[2] |
| [last()] | 选择最后一个元素 | //p[last()] |
| [@attr] | 选择有该属性的元素 | //p[@color] |
| [@attr='value] | 选择该属性值等于指定值的元素 | //p[@color='red'] |
| * | 匹配任何元素节点 | //body/div/* |
| @* | 匹配元素的任何属性 | //body/div/a/@* |
| text() | 获取文本内容 | //div/p/text() |
CSV
Comma-Separated Values,逗号分隔值,是一种简单、通用的文本文件格式,用于存储表格数据,可以直接使用Excel打开。
# csv操作 一
# 写
with open("csv_data/01.csv", "w", encoding="utf-8") as f:
    f.write("姓名,年龄,性别,爱好\n")
    f.write("小A,17,女,'C,Java'\n")
    f.write("小B,20,男,Python\n")
    f.write("小C,19,男,football\n")
    f.write("小D,21,女,C++\n")

# 读
with open("csv_data/01.csv", "r", encoding="utf-8") as f:
    for line in f:
        print(line.strip())

# 二 使用csv标准库
import csv

with open("csv_data/02.csv", "w", encoding="utf-8", newline="") as f:
    writer = csv.DictWriter(f, fieldnames=["姓名","年龄", "性别", "爱好"])
    writer.writeheader()    # 写入表头
    writer.writerow({"姓名": "小A", "年龄": 17, "性别": "女", "爱好": "C, Java"})
    writer.writerow({"姓名": "小B", "年龄": 19, "性别": "男", "爱好": "Python"})
    writer.writerow({"姓名": "小C", "年龄": 16, "性别": "男", "爱好": "football"})
    writer.writerow({"姓名": "小D", "年龄": 18, "性别": "女", "爱好": "C++"})

with open("csv_data/02.csv", "r", encoding="utf-8") as f:
    reader = csv.DictReader(f)
    for row in reader:
        print(row)
正则表达式
Regular Expression,RE,是一种由特定语法规则组成的文本模式,用来描述、匹配字符串中符合特定规则的字符序列。就相当于一种模式匹配工具,允许用户通过简洁的语法进行复杂文本的搜索、匹配、提取和替换工作。
import re

s = "我的手机号码是15567278888,我的另一个手机号是17777777777,QQ号是1090000000,记住了吗?"

# match ----- 从字符串的开头开始匹配,返回Match对象
result = re.match(r"1[3-9]\d{9}", s)
print(result)   # None

# search ----- 从任意位置开始匹配,搜索第一个匹配项,返回Match对象
result = re.search(r"1[3-9]\d{9}", s)
print(result.group())   # 15567278888

# findall ----- 从任意位置开始匹配,搜索所有匹配项,返回list
result = re.findall(r"1[3-9]\d{9}", s)
print(result)   # ['15567278888', '17777777777']
| 表达式 | 描述 |
| 普通字符 | 字母、数字、汉字及大多数字符,直接匹配自身 |
| . | 匹配任意一个字符(除\n) |
| \d | 匹配数字0-9 |
| \D | 匹配非数字 |
| \w | 匹配单词字符,即a-z、A-Z、0-9、_、其他语言字符 |
| \W | 匹配非单词字符 |
| [aeiou] | 匹配其中的任何单个字符 |
| [^aeiou] | 求反,匹配不在字符列表中的任何单个字符 |
| [0-5] | 表示范围 |
| * | 出现任意次(0次或无数次) |
| + | 至少出现1次(1次或无数次) |
| ? | 至多出现1次(0次或1次) |
| {m} | 出现m次 |
| {m, } | 至少出现m次 |
| {m, n} | 出现m到n次 |
| | | 或的意思,匹配左右任意一个表达式 |
| () | 分组,将括号里的多个字符视为一个单元 |
| ^ | 匹配字符串开头 |
| $ | 匹配字符串结尾 |

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)