CPU飙高、SQL变慢之后,数据库根因到底该怎么查?
文章目录
数据库监控体系日趋完善,CPU 升高、I/O 波动、会话堆积、慢 SQL 等异常已经能够被快速发现。
但真正的挑战,在于异常出现后的根因定位。
一次性能问题可能同时涉及服务器资源、SQL 执行、锁等待、长事务、索引等多个因素。DBA 往往需要在不同页面间反复切换,再依靠经验将零散线索拼接起来。
为此,KEMCC 构建了覆盖性能、锁、根因、SQL、存储、索引及 SQL 统计的完整诊断框架。
它的核心并不是简单增加更多监控功能,而是将分散的诊断信息关联成一条可以连续下钻的分析链路,让数据库排障从:
“看到异常”走向“找到原因”。
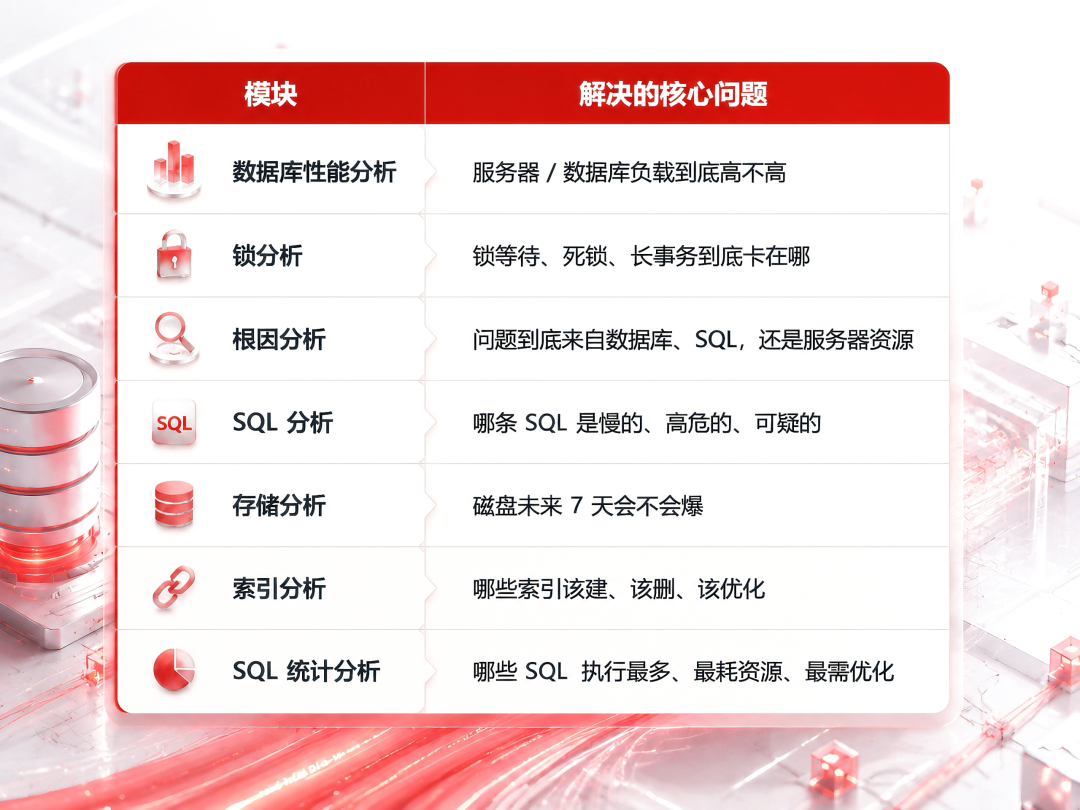
从一个异常时间点开始,把线索串起来
当数据库响应突然变慢时,常规的排查方式通常是先观察:
- CPU
- I/O
- TPS
- QPS
- 会话数
- 数据库负载
这些指标能够帮助 DBA 判断“数据库什么时候出现了异常”,但单独的一条性能曲线并不能回答:
异常究竟因何而起?
KEMCC 性能分析将服务器资源指标与数据库核心指标放在统一时间轴上。
当某一个时间段出现慢 SQL、长事务或其他异常时,可以继续关联查看该时间段数据库正在执行的具体 SQL。
这样,排障就不再停留在:
“这个时间段 CPU 上升了。”
而是可以进一步追问:
“CPU 升高的时候,数据库到底在执行什么?”
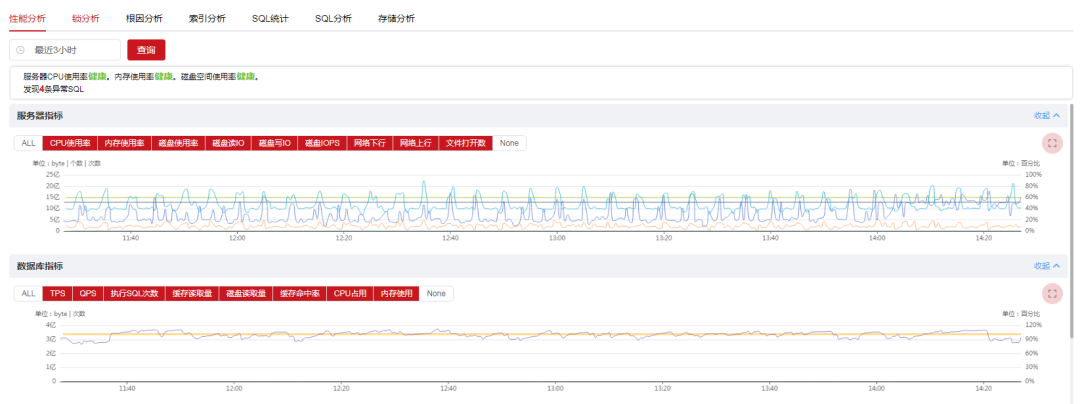
性能分析页面:服务器资源、数据库指标与异常 SQL 联动
SQL 为什么慢?继续看“谁在等谁”
在高并发业务场景中,锁等待是影响数据库响应时间的重要因素之一。
有时候,一条 SQL 本身执行效率并不低,但由于前序事务长时间持有锁,后续大量会话只能持续等待。
如果此时只观察 SQL 执行耗时,很容易被表象误导。
真正的问题可能并不是:
“这条 SQL 执行得太慢。”
而是:
“这条 SQL 一直在等待其他事务释放锁。”
KEMCC 锁分析集中展示:
- 锁等待
- 死锁
- 长事务
- 等锁 SQL
- 加锁 SQL
- 等待时长
从而帮助 DBA 快速建立 SQL 与锁之间的关联关系。
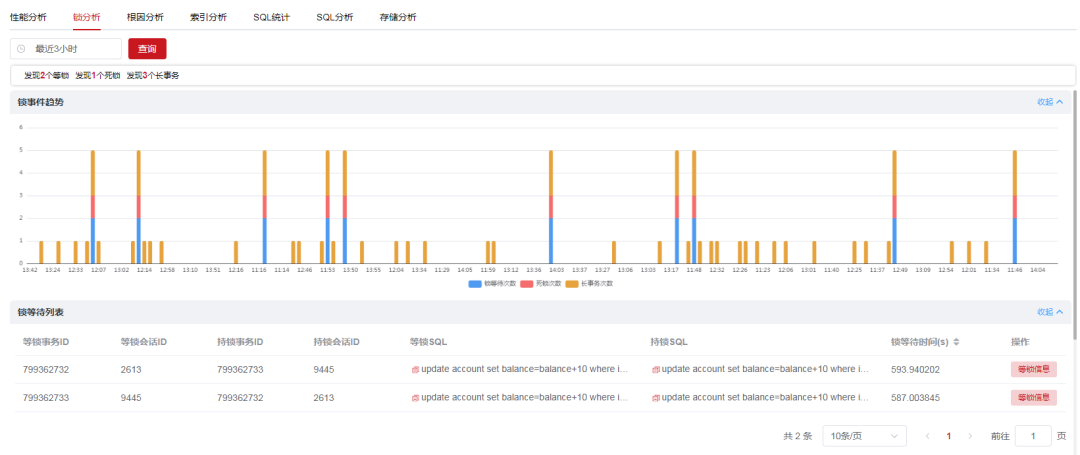
锁次数统计与等锁 SQL 列表
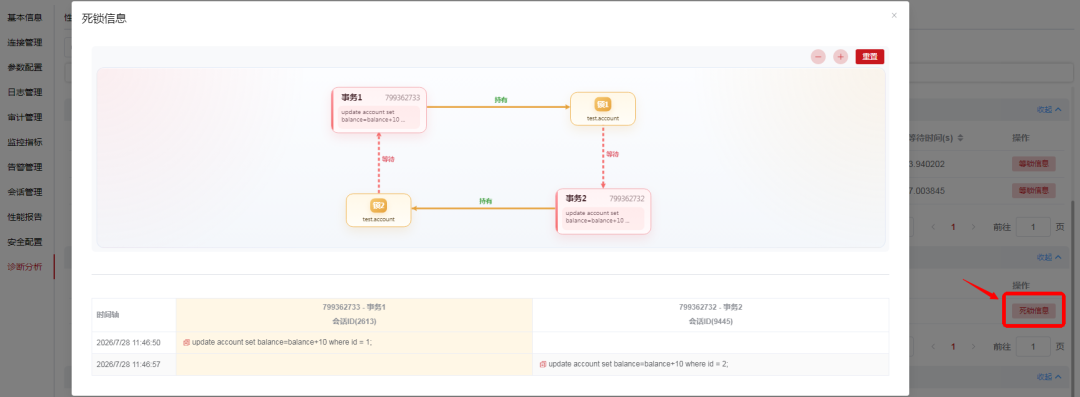
等锁流程图:谁持锁、谁等待,以及等待了多长时间
通过等锁流程图,可以直观还原不同会话之间的持锁与等待关系。
DBA 因此能够快速判断:
一条 SQL 响应缓慢,到底是自身执行效率低,还是被其他事务阻塞。
从性能现象继续追到真正根因
实际生产环境中的数据库性能问题,通常并不是某一个因素单独造成的。
很多时候,它可能是多个问题同时叠加:
- 长事务
- 低效 SQL
- 索引缺失
- 锁等待
- 资源波动
- 高并发请求
如果将这些问题分别查看,每一项可能都只是一个局部异常。
真正困难的是判断:
这些异常之间到底存在什么因果关系?
KEMCC 根因分析会汇总问题 SQL,并结合:
- 影响时长
- 锁详情
- 执行计划
- SQL 执行情况
- 相关诊断信息
进行关联分析,从而辅助判断真正的问题来源。
例如,一条业务 SQL 持续变慢,并且同时伴随着大量锁等待。
继续向上追溯,可能发现:
- 后台存在一个长事务;
- 长事务持续持有相关数据锁;
- SQL 自身执行效率较低;
- 执行时间增加导致持锁时间进一步延长;
- 后续大量业务会话开始排队等待;
- 最终数据库整体响应时间明显上升。
此时:
慢 SQL、长事务、锁等待不再是三个孤立问题,而是形成了一条完整的问题链。
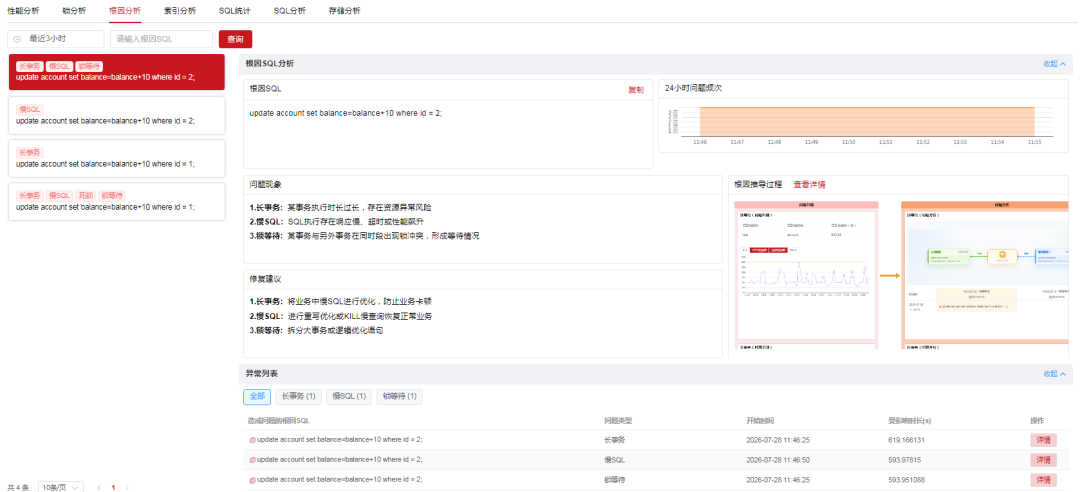
根因分析:根因 SQL、分析结果及优化建议
找到问题之后,再继续判断应该怎么优化
定位根因只是第一步。
如果问题最终指向索引,还需要继续判断:
- 是否存在缺失索引;
- 是否存在无效索引;
- 是否存在低效索引;
- 当前索引是否被执行计划正确使用。
此时可以进一步通过索引分析检查相关索引情况。
如果问题集中在某条 SQL,则可以结合SQL 统计分析继续查看:
- SQL 调用次数
- SQL 总耗时
- SQL 平均耗时
- SQL 执行趋势
- 历史执行计划
通过这些数据,可以进一步判断一条 SQL 到底是:
- 单次执行特别慢;
- 执行次数过多;
- 执行计划发生变化;
- 还是随着业务量增长逐渐成为性能瓶颈。
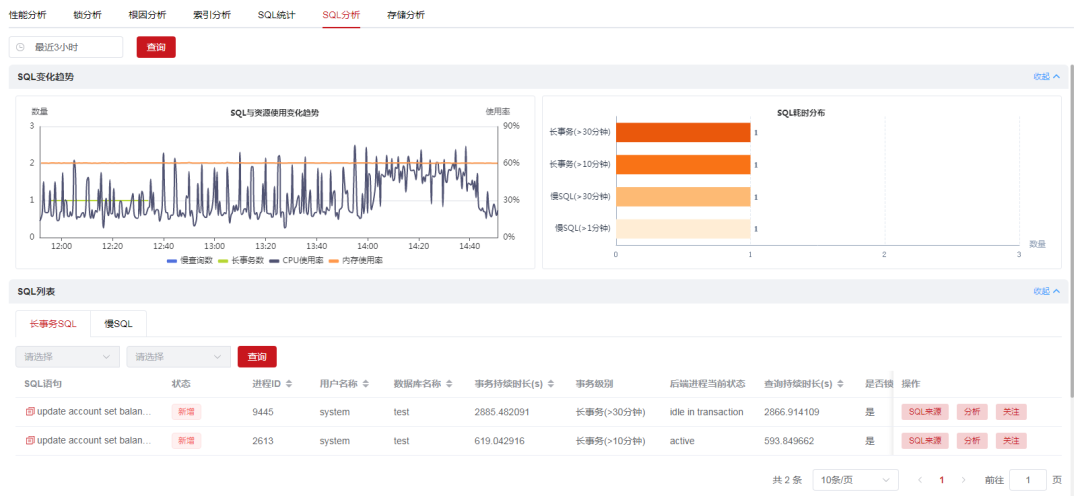
SQL 分析:高危、可疑、慢 SQL、关注 SQL 及执行趋势
一条完整的数据库故障诊断链路
整个数据库性能问题的排查路径可以概括为:
发现异常 → 锁定问题 SQL → 分析等待关系 → 判断问题来源 → 辅助优化
进一步拆解,可以形成这样一条完整的诊断链路:
CPU / I/O / TPS / QPS 等指标出现异常
                ↓
        定位异常发生时间
                ↓
      查看当时执行的异常 SQL
                ↓
       判断 SQL 是否存在等待
                ↓
    分析持锁会话与长事务关系
                ↓
       结合执行计划判断根因
                ↓
      检查索引及 SQL 历史表现
                ↓
          给出优化方向
这样一来,数据库排障不再是不断打开不同监控页面,然后依靠 DBA 个人经验将信息拼接在一起,而是能够沿着统一的诊断链路持续下钻。
少一些反复排查,多一些有依据的判断
KEMCC 的故障诊断框架并不是简单地将多个功能放在一起,而是让七类分析能力协同工作:
| 分析能力 | 主要作用 |
|---|---|
| 性能分析 | 定位异常发生的时间与资源变化 |
| SQL 分析 | 锁定需要重点关注的问题 SQL |
| 锁分析 | 还原会话之间的持锁和等待关系 |
| 根因分析 | 将多个异常线索关联并判断问题来源 |
| 存储分析 | 辅助发现数据库存储层异常 |
| 索引分析 | 判断缺失、无效及低效索引 |
| SQL 统计 | 查看 SQL 调用频率、耗时及执行计划变化 |
过去,DBA 需要在不同页面之间不断寻找这些信息之间的联系。
现在,可以将这些数据纳入统一诊断链路中,让排障过程更加连续。
数据库故障诊断真正需要解决的问题,从来不只是:
“能不能看到异常?”
更重要的是:
“能不能根据现有线索快速找到异常产生的真正原因?”
这也是整个故障与性能诊断体系的核心价值——缩短排查路径,让每一步判断都有依据。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐

 2
 0
- 0


 已为社区贡献4条内容

所有评论(0)