数据分析案例-泰坦尼克号乘客生存预测
1 项目背景与研究目标
泰坦尼克号乘客生存预测是 Kaggle 入门竞赛中最具代表性的二分类案例。任务要求根据乘客登船前已知的信息预测是否生还,适合展示结构化数据清洗、类别特征编码、缺失值处理、特征工程和分类模型评价。
本案例的目标不是单纯追求某一次划分上的最高准确率,而是建立一套可复现、可解释的数据分析流程,并说明每幅图对后续建模决策的影响。
- 识别数据缺失、类别不均衡和潜在信息冗余。
- 分析性别、舱位、年龄、家庭结构和登船港口与生还率的关系。
- 构造能够表达社会身份、同行关系、甲板位置和团体购票的衍生特征。
- 比较四类常用分类模型,并通过交叉验证控制偶然性。
- 使用混淆矩阵、ROC-AUC、阈值曲线和特征系数解释最终模型。
2 数据来源与字段说明
数据来源于 Kaggle 竞赛的训练数据公开镜像,共 891 行、12 列。目标字段 Survived 中,1 表示生还,0 表示未生还。
|
字段 |
含义 |
建模处理 |
|
PassengerId |
乘客编号 |
仅作标识,不进入模型 |
|
Survived |
是否生还 |
目标变量 |
|
Pclass |
舱位等级 |
作为类别变量独热编码 |
|
Name |
姓名 |
提取称谓 Title |
|
Sex |
性别 |
类别变量 |
|
Age |
年龄 |
中位数填补并标准化 |
|
SibSp / Parch |
同行亲属数量 |
构造家庭规模 |
|
Ticket |
票号 |
统计同票号人数 |
|
Fare |
票价 |
标准化并构造人均票价 |
|
Cabin |
舱室号 |
提取甲板首字母,缺失标记为未知 |
|
Embarked |
登船港口 |
众数填补并独热编码 |
数据文件:titanic.csv;Notebook:Titanic_生存预测_完整分析.ipynb。
3 技术路线与评价指标
数据按照 75% 训练集和 25% 测试集划分,并使用 Survived 进行分层抽样,以保持两部分样本中的生还比例一致。模型选择阶段在训练集内部执行五折分层交叉验证。
|
指标 |
含义 |
本案例中的作用 |
|
准确率 |
全部样本中预测正确的比例 |
反映总体判断正确率,但会受到类别比例影响 |
|
精确率 |
预测生还样本中实际生还的比例 |
衡量生还预测的可信度 |
|
召回率 |
实际生还样本中被识别出的比例 |
衡量漏掉生还乘客的程度 |
|
F1 值 |
精确率和召回率的调和平均 |
综合评价生还类别 |
|
ROC-AUC |
不同阈值下的整体排序能力 |
作为调参和模型比较的核心指标 |
3.1 字段缺失率
quality = pd.DataFrame({
    '数据类型': df.dtypes.astype(str),
    '缺失数量': df.isna().sum(),
    '缺失率(%)': (df.isna().mean() * 100).round(2),
    '唯一值数量': df.nunique(dropna=False)
}).sort_values('缺失率(%)', ascending=False)
print(f'完全重复的记录数:{df.duplicated().sum()}')
display(quality)

missing = quality.query('`缺失数量` > 0').sort_values('缺失率(%)')
plt.figure(figsize=(9.0, 4.8))
plt.barh(missing.index, missing['缺失率(%)'], color=PALETTE[0])
plt.xlabel('缺失率(%)')
plt.ylabel('字段')
plt.title('图1 主要字段缺失率')
for i, value in enumerate(missing['缺失率(%)']):
    plt.text(value + 0.8, i, f'{value:.1f}%', va='center')
save_show('01_字段缺失率.png')
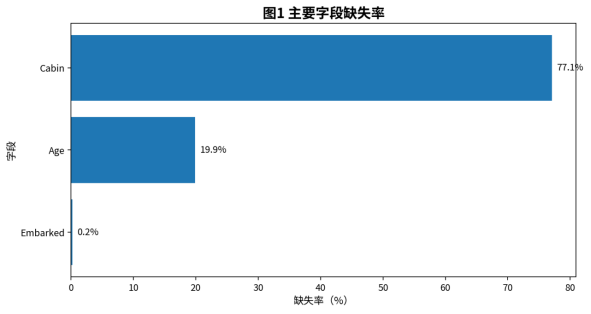 、
Cabin 缺失率约为 77.1%,若直接删除缺失记录会造成大规模样本损失。更合理的方案是保留“是否已知舱室”和甲板首字母信息,并把缺失甲板编码为未知类别。
3.2 生存结果分布
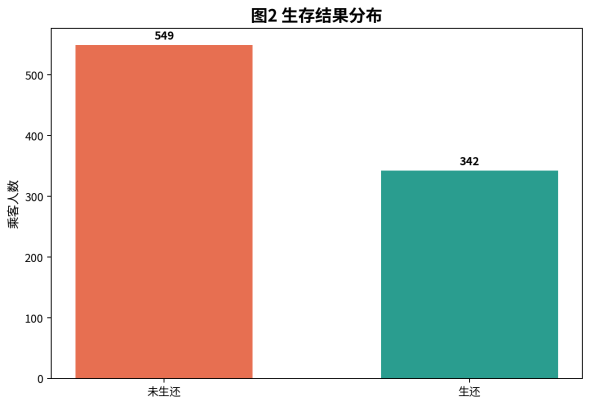
891 名乘客中有 342 人生还、549 人未生还,总体生还率为 38.38%。未生还样本占比约为 61.6%,属于中等程度类别不均衡。
该分布说明准确率不能作为唯一评价标准。假设模型全部预测为未生还,也能获得约 61.6% 的准确率,但完全无法识别生还乘客。因此后续同时报告召回率、F1 值和 ROC-AUC。
3.3 性别与生还率
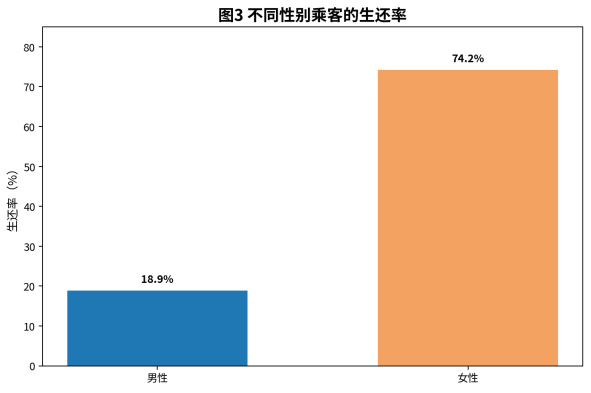
女性乘客生还率约为 74.2%,男性乘客约为 18.9%,差距超过 55 个百分点。性别是数据中最强的单一解释变量之一。
3.4 舱位等级与生还率
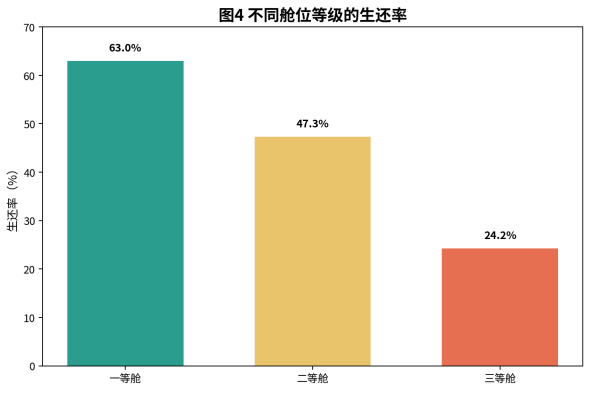
一等舱、二等舱和三等舱的生还率依次下降,约为 63.0%、47.3% 和 24.2%。舱位具有清晰的等级效应。
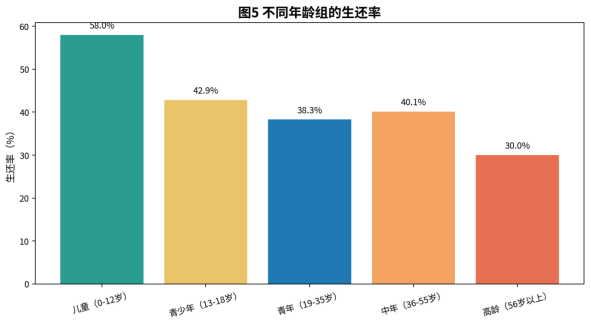
3.5 年龄组与生还率、
3.6 家庭规模与生还率
family_df = df.assign(FamilySize=df['SibSp'] + df['Parch'] + 1)
family_rate = family_df.groupby('FamilySize')['Survived'].agg(['mean', 'count'])
family_plot = family_rate[family_rate['count'] >= 8]
plt.figure(figsize=(9.0, 5.2))
plt.plot(family_plot.index, family_plot['mean'] * 100,
         marker='o', linewidth=2.5, markersize=7, color=PALETTE[0])
plt.fill_between(family_plot.index, family_plot['mean'] * 100, alpha=0.12, color=PALETTE[0])
plt.xlabel('家庭同行人数')
plt.ylabel('生还率(%)')
plt.title('图6 家庭规模与生还率')
save_show('06_家庭规模与生还率.png')
display(family_rate.rename(columns={'mean':'生还率','count':'人数'}))
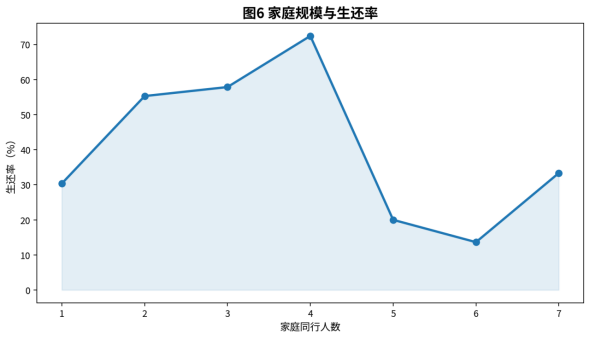
独自出行乘客的生还率偏低,2—4 人小家庭的生还率较高;家庭规模过大后,生还率明显下降。
该关系不是简单线性变化,因此同时保留家庭规模和独行标记。小家庭成员可能更容易互相照应,大型家庭在紧急撤离时则面临更高的协调难度。
3.7 港口与舱位的联合关系
pivot = df.pivot_table(index='Pclass', columns='Embarked', values='Survived', aggfunc='mean')
pivot = pivot.reindex(index=[1,2,3], columns=['C','Q','S'])
plt.figure(figsize=(7.6, 5.2))
img = plt.imshow(pivot.values*100, cmap='YlGnBu', vmin=0, vmax=100, aspect='auto')
plt.xticks(range(3), ['瑟堡 C','皇后镇 Q','南安普顿 S'])
plt.yticks(range(3), ['一等舱','二等舱','三等舱'])
plt.title('图7 登船港口与舱位组合的生还率')
for i in range(pivot.shape[0]):
    for j in range(pivot.shape[1]):
        value = pivot.iloc[i,j]
        if pd.notna(value):
            plt.text(j, i, f'{value*100:.1f}%', ha='center', va='center',
                     color='white' if value>0.55 else 'black', fontweight='bold')
cb = plt.colorbar(img)
cb.set_label('生还率(%)')
save_show('07_港口舱位生还率.png')
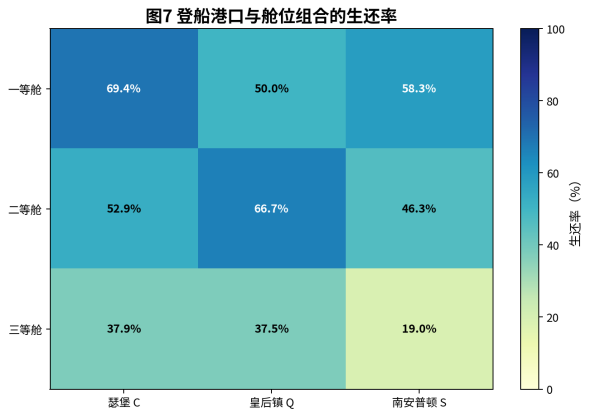
同一港口内部仍存在明显舱位差异,说明舱位效应并非由港口构成完全解释。瑟堡登船者中一等舱比例较高,若只比较港口总体生还率,容易受到乘客结构的混杂影响。
4 特征工程与预处理
原始姓名、票号和舱室号不能直接输入常规模型,因此从中提取可解释的结构化变量。称谓用于表达年龄、性别和社会身份;甲板首字母作为船舱位置的粗略表示;同票号人数用于识别家庭或团体购票;人均票价用于减少共票导致的票价偏差。
|
衍生特征 |
计算方式 |
预期作用 |
|
Title |
从 Name 提取称谓 |
补充年龄、性别和身份信息 |
|
FamilySize |
SibSp + Parch + 1 |
描述同行家庭规模 |
|
IsAlone |
FamilySize 是否等于 1 |
识别独行乘客 |
|
CabinDeck |
Cabin 的首字母,缺失记 U |
近似表示甲板位置 |
|
TicketGroupSize |
同一 Ticket 的出现次数 |
识别团体购票 |
|
FarePerPerson |
Fare / TicketGroupSize |
估计实际人均票价 |
数值变量使用中位数填补和标准化;类别变量使用众数填补和独热编码。预处理与模型封装为同一 Pipeline,保证每一折交叉验证只在训练折拟合填补值、缩放参数和编码类别。
4.1 多模型表现比较
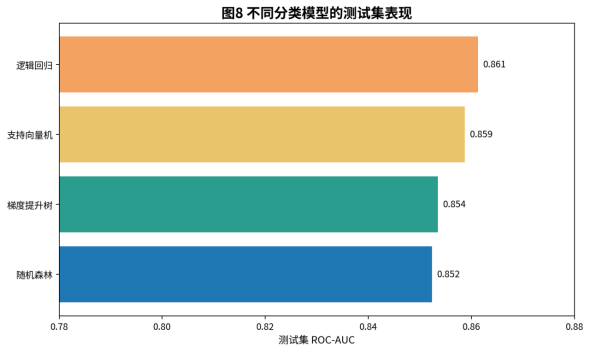
梯度提升树和随机森林在交叉验证 ROC-AUC 上具有一定优势,说明非线性关系确实存在;逻辑回归在固定测试集上的准确率和 F1 值较为稳定,整体差距并不大。
|
模型 |
交叉验证ROC-AUC |
测试集准确率 |
测试集F1 |
测试集ROC-AUC |
|
梯度提升树 |
0.8884 |
0.7982 |
0.7239 |
0.8535 |
|
随机森林 |
0.8794 |
0.7892 |
0.7186 |
0.8524 |
|
支持向量机 |
0.8668 |
0.8027 |
0.7349 |
0.8587 |
|
逻辑回归模型 |
0.8650 |
0.8296 |
0.7765 |
0.8613 |
4.2 参数调优结果
|
指标 |
测试集结果 |
|
准确率 |
0.8117 |
|
精确率 |
0.7683 |
|
召回率 |
0.7326 |
|
F1 值 |
0.7500 |
|
ROC-AUC |
0.8608 |
4.3 混淆矩阵
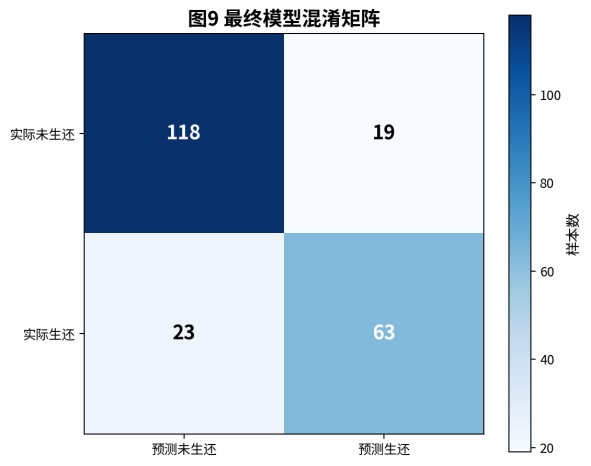
4.4 ROC 曲线
plt.figure(figsize=(8.2,6.0))
for name, model in fitted_models.items():
    prob = model.predict_proba(X_test)[:,1]
    fpr,tpr,_ = roc_curve(y_test,prob)
    auc = roc_auc_score(y_test,prob)
    plt.plot(fpr,tpr,linewidth=2,label=f'{name}(AUC={auc:.3f})')
fpr,tpr,_=roc_curve(y_test,final_prob)
plt.plot(fpr,tpr,linewidth=3,linestyle='--',color='black',label=f'调优逻辑回归(AUC={roc_auc_score(y_test,final_prob):.3f})')
plt.plot([0,1],[0,1],linestyle=':',color='gray',label='随机判断')
plt.xlabel('假阳性率')
plt.ylabel('真阳性率')
plt.title('图10 不同模型的ROC曲线')
plt.legend(frameon=False,loc='lower right')
save_show('10_ROC曲线.png')
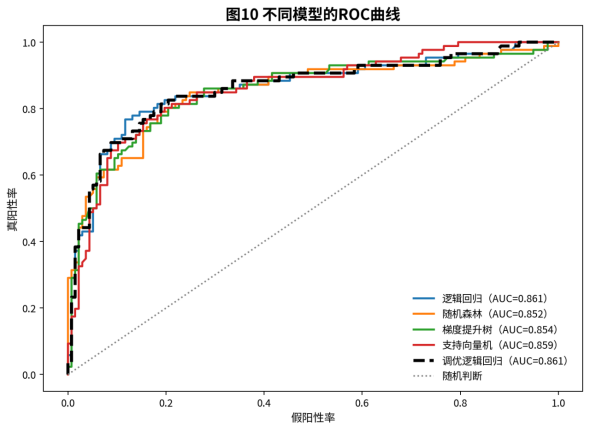
所有模型曲线均明显高于随机判断线,测试集 AUC 位于约 0.85—0.86 区间,具有较好的概率排序能力。
4.5 分类阈值分析
thresholds = np.linspace(0.20,0.80,61)
threshold_rows=[]
for t in thresholds:
    pred_t=(final_prob>=t).astype(int)
    threshold_rows.append({'阈值':t,'精确率':precision_score(y_test,pred_t,zero_division=0),
                           '召回率':recall_score(y_test,pred_t,zero_division=0),
                           'F1值':f1_score(y_test,pred_t,zero_division=0)})
threshold_df=pd.DataFrame(threshold_rows)
best_f1_row=threshold_df.loc[threshold_df['F1值'].idxmax()]
plt.figure(figsize=(9.0,5.5))
plt.plot(threshold_df['阈值'],threshold_df['精确率'],label='精确率',linewidth=2.2,color=PALETTE[0])
plt.plot(threshold_df['阈值'],threshold_df['召回率'],label='召回率',linewidth=2.2,color=PALETTE[4])
plt.plot(threshold_df['阈值'],threshold_df['F1值'],label='F1值',linewidth=2.5,color=PALETTE[1])
plt.axvline(0.5,linestyle='--',color='gray',label='默认阈值0.5')
plt.axvline(best_f1_row['阈值'],linestyle=':',color='black',label=f"最佳F1阈值{best_f1_row['阈值']:.2f}")
plt.xlabel('分类阈值')
plt.ylabel('指标值')
plt.title('图11 分类阈值对模型指标的影响')
plt.legend(frameon=False)
save_show('11_阈值分析.png')
print(best_f1_row)
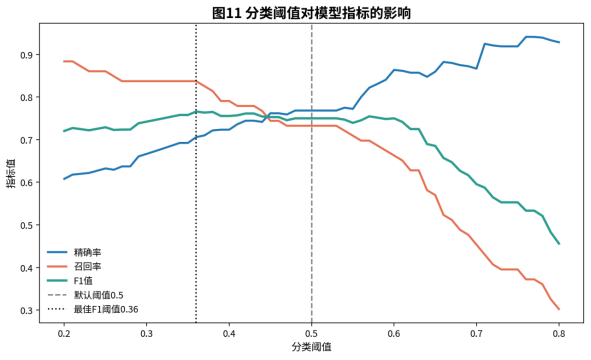
阈值升高时,模型判定生还更谨慎,精确率通常上升而召回率下降;阈值降低则相反。默认 0.5 并不是任何场景下都最优。
4.6 特征系数解释
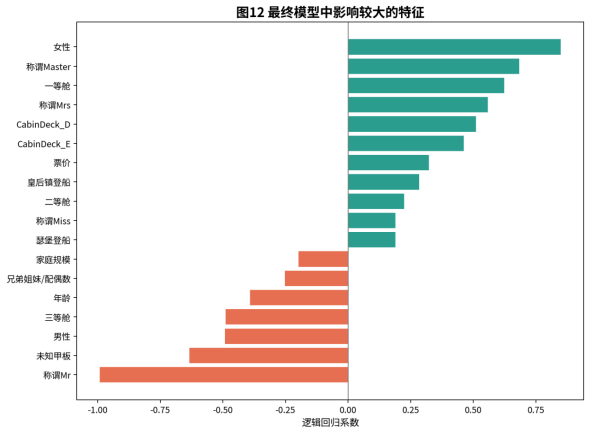
女性、一等舱以及 Mrs、Miss 等称谓通常提高预测生还概率;男性、三等舱和 Mr 称谓通常降低预测生还概率,方向与探索性分析一致。
5 结论、局限性与改进建议
- 性别、舱位等级和称谓是最重要的生还预测因素,家庭规模、甲板和票组信息提供补充解释。
- 最终逻辑回归测试集准确率为 81.17%,ROC-AUC 为 0.8608,性能与可解释性较为均衡。
- 数据量较小,单次测试集指标可能受到划分影响;建议使用重复分层交叉验证报告均值和标准差。
- 同一家庭或同票号乘客可能同时出现在训练集和测试集,后续可尝试基于家庭/票号的分组验证。
- 可进一步尝试 CatBoost、XGBoost、模型融合和概率校准,并使用折外预测确定分类阈值。
具体细节见原文
创造不易,谢谢各位多多点赞收藏!

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐


 2
 0
- 0


 已为社区贡献45条内容

所有评论(0)