SRAM 与 DRAM:计算机内存的技术底层与差异
内存就如同计算机的临时高速数据枢纽,区别于硬盘负责长期存储的特性,它承担着CPU运行程序、处理数据时的临时存取任务,读写速度直接决定了系统响应效率和多任务流畅度。
在内存的核心谱系中,DRAM与SRAM是两大支柱性存在,二者同属随机存取存储器,底层架构、工作机理与性能特质却有着云泥之别,近乎两套完全独立的硬件运行逻辑。
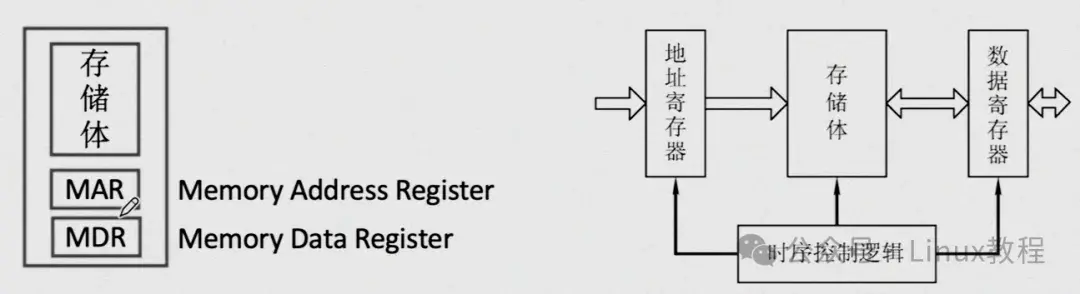
一、认识 RAM
1. RAM 是什么?
RAM,全称Random Access Memory(随机存取存储器),是计算机硬件体系中衔接CPU和外部存储的核心桥梁,属于易失性高速存储器。这里的“随机存取”,指的是可以任意地址、任意顺序读写数据,存取速度与存储位置无关,这也是它和硬盘、U盘等顺序存储设备最核心的区别;而“易失性”,则是指断电后存储的电荷/电路状态会瞬间消失,数据无法保留,这也是为什么电脑突然断电,未保存的文档会全部丢失的原因。
从工作逻辑来看,CPU运算速度可达每秒数十亿乃至上百亿次,而机械硬盘、固态硬盘的读写速度,哪怕是高端NVMe SSD,也远跟不上CPU的运算节奏,两者之间存在巨大的速度鸿沟。RAM的核心作用,就是将硬盘中即将运行的程序、正在处理的数据提前调入,为CPU提供低延迟、高带宽的临时数据存取服务,让CPU不用等待慢速的硬盘传输,始终保持高效运转。简单来说,硬盘是“仓库”,RAM就是“工作台”,工作台越大、速度越快,CPU干活效率就越高。
和RAM对应的是ROM(只读存储器),比如主板BIOS芯片、手机固件芯片,属于非易失性存储器,只能读取、不能随意改写,负责存储设备启动的基础指令,和RAM的临时读写功能完全不同,大家千万不要混淆。
1.2. RAM 在计算机中的位置与作用
从硬件物理位置来看,RAM在不同设备中的形态各不相同:台式机、笔记本中,RAM以DIMM内存条(台式)、SO-DIMM(笔记本)的形态存在,通过主板内存插槽与CPU、芯片组直连;手机、平板、轻薄本等移动设备,为了节省空间,RAM直接封装在SOC芯片内部,和处理器、显存集成在一起,也就是常说的LPDDR内存;服务器、工作站则采用ECC REG内存条,具备纠错功能,稳定性更强。
从计算机存储金字塔结构来看,硬件遵循“速度越快、成本越高、容量越小,越靠近CPU”的规律,从上到下依次是:CPU寄存器→SRAM缓存(L1/L2/L3)→DRAM主内存→SSD→机械硬盘。RAM处于金字塔中上层,其中SRAM靠近塔顶、DRAM位于中间,二者共同承担着“提速”的核心使命。
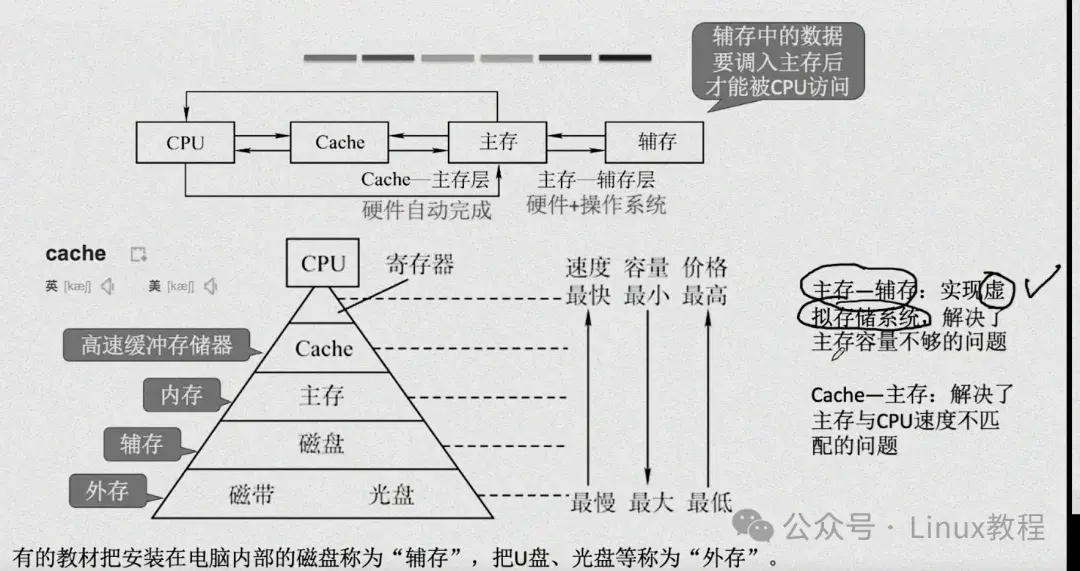
具体作用可以拆解为三点:一是程序运行载体,所有打开的软件、游戏、后台进程,都必须加载到RAM中才能被CPU调用;二是数据缓存枢纽,临时存储CPU运算的中间数据,避免重复读写硬盘;三是多任务支撑,容量越大,能同时加载的程序越多,多任务切换越流畅,不会出现内存不足导致的卡顿、闪退。可以说,没有RAM,再高端的CPU也无法正常工作。
1.3. RAM 的两大分支:DRAM 与 SRAM
RAM并非单一品类,根据存储单元结构、数据保持方式、性能特性,主要分为DRAM(Dynamic Random Access Memory,动态随机存取存储器)和SRAM(Static Random Access Memory,静态随机存取存储器)两大阵营,二者的核心差异从底层存储单元就已经注定,后续的速度、成本、功耗、应用场景也完全分化。
DRAM是动态存储,核心存储单元由1个晶体管+1个电容(1T1C结构)组成,数据依靠电容内的电荷多少来表示(有电为1,无电为0)。但电容存在天然的漏电特性,电荷会随着时间不断流失,因此必须每隔一段时间就进行一次“刷新”,重新给电容充电补充电荷,才能保住数据,这也是“动态”的由来。这种极简结构让DRAM的存储密度极高,单位面积能容纳更多存储单元,成本极低,适合做大容量主内存,也是我们日常说的“内存条”“运行内存”的核心载体。
SRAM是静态存储,核心存储单元采用6管CMOS触发器(6T结构),依靠晶体管组成的双稳态电路来存储数据,只要保持通电,电路状态就会一直稳定,完全不需要刷新,这就是“静态”的核心含义。6管结构让SRAM的读写延迟极低、速度极快,但电路复杂,存储密度极低,单位成本是DRAM的数倍甚至十倍,容量很难做大,因此只能用于对速度要求极致的高速缓存场景。
简单总结:DRAM主打大容量、低成本,是主内存的绝对主力;SRAM主打高速度、低延迟,是CPU缓存的专属选择,二者各司其职、互补配合,才构成了完整的内存运行体系,缺一不可。
二、DRAM 与 SRAM 核心差异
| 对比维度 | DRAM | SRAM |
| 核心存储单元 | 1晶体管+1电容(1T1C),极简结构 | 6管CMOS双稳态触发器(6T),复杂结构 |
| 读写速度 | 较慢,访问延迟约300-500ns,带宽随DDR迭代提升 | 极快,访问延迟仅1-10ns,带宽可达数十TB/s |
| 功耗表现 | 静态功耗极低,刷新操作会产生额外动态功耗 | 静态功耗高,需持续供电维持触发器状态,无刷新功耗 |
| 制造成本 | 极低,存储密度高,适合大规模量产 | 极高,存储密度低,单位容量成本是DRAM的3-10倍 |
| 数据保持方式 | 需要定期刷新(每64ms必须刷新一次) | 无需刷新,通电即可永久保持数据状态 |
| 存储密度 | 极高,单条内存轻松做到16GB/32GB/64GB | 极低,CPU L1缓存仅几十KB,L3缓存最多几十MB |
| 典型应用场景 | 电脑主内存、手机LPDDR运行内存、显卡GDDR显存、服务器内存 | CPU L1/L2/L3缓存、路由器高速缓存、嵌入式实时系统、工业控制 |
这张表格浓缩了DRAM与SRAM的全部核心差异,看似只是参数不同,实则是设计目标完全不同导致的:DRAM的设计初衷是用最低成本实现大容量,牺牲部分速度换取容量和性价比;SRAM的设计初衷是极致速度,不惜成本和功耗,只为满足CPU的超低延迟需求。
从存储单元来看,1T1C的DRAM结构极简,一个芯片内可以集成数十亿个存储单元,所以我们能买到32GB、64GB的平价内存条;而6T结构的SRAM,每个单元需要6个晶体管,占用面积是DRAM的数倍,同样大小的芯片,SRAM容量只有DRAM的几十分之一,成本自然居高不下。
速度差距的核心根源,一是刷新机制,DRAM每次刷新都要占用读写时间,产生额外延迟;二是电路结构,SRAM的触发器电路直接输出稳定电平,无需充放电等待,读写几乎无延时。日常使用中,CPU访问L1 SRAM缓存只需要1-2个时钟周期,访问DRAM主内存则需要100个以上时钟周期,速度差距相差百倍。
功耗方面,DRAM看似需要刷新,但待机时只有电容漏电的微弱功耗,刷新功耗占比极低;SRAM需要持续给6个晶体管供电维持状态,哪怕没有读写操作,也会持续耗电,所以移动设备绝不会用SRAM做运行内存,否则续航会大幅缩水。
三、深挖 DRAM
3.1. 基本存储单元结构:1T1C
DRAM的核心竞争力就是极简的1T1C存储单元,这也是它能实现高存储密度、低成本的关键,每个单元只负责存储1bit(0或1)的数据,结构简单到极致,却暗藏精密的工作逻辑。
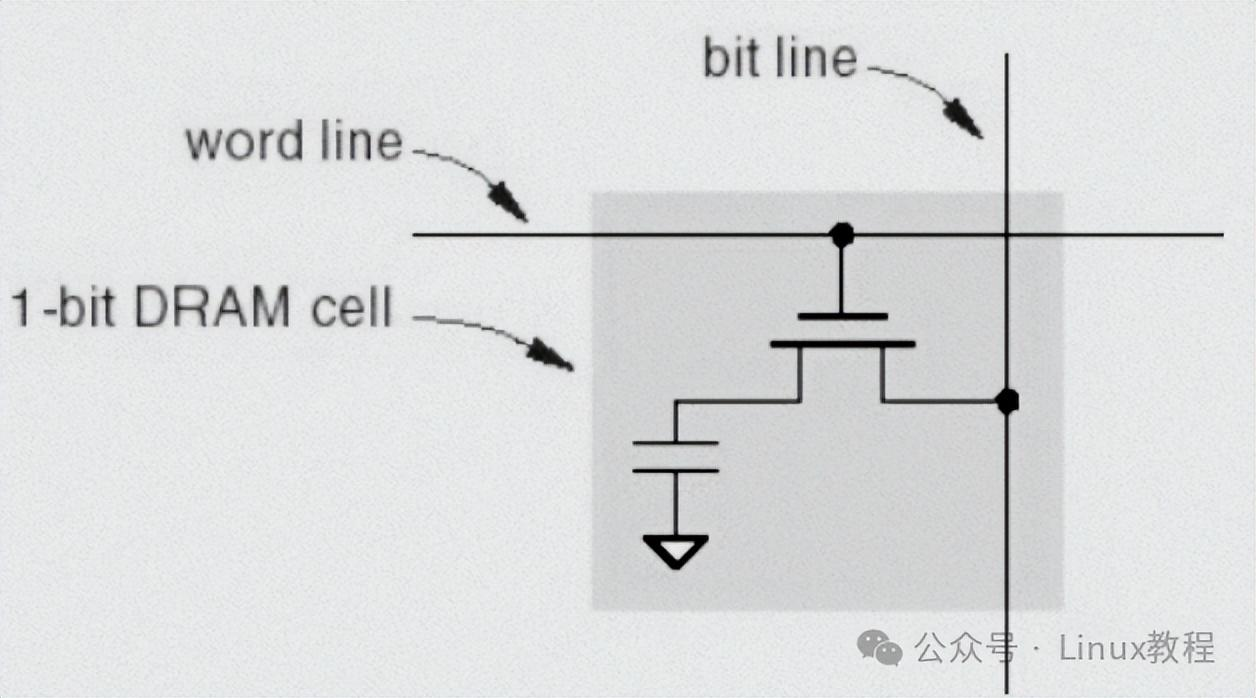
其中,电容(Capacitor)是数据存储核心,依靠内部存储的电荷数量表示数据:当电容充满电荷,电压达到阈值,代表存储数据“1”;当电容释放电荷,电压低于阈值,代表存储数据“0”。而晶体管(Transistor)则充当“电子开关”,负责控制电容的充放电通路:当晶体管导通,电容可以充电或放电,完成读写操作;当晶体管关断,电容进入保持状态,尽量留存电荷。
这里有一个关键技术痛点:电容无法做到绝对绝缘,哪怕晶体管完全关断,电容内的电荷也会通过漏电流慢慢流失,一般几毫秒到几十毫秒就会流失殆尽,数据直接丢失。这就决定了DRAM无法像SRAM那样静态保持数据,必须通过定期刷新,重新给电容充电,恢复电荷水平,才能保住数据,这也是“动态存储器”的核心定义。
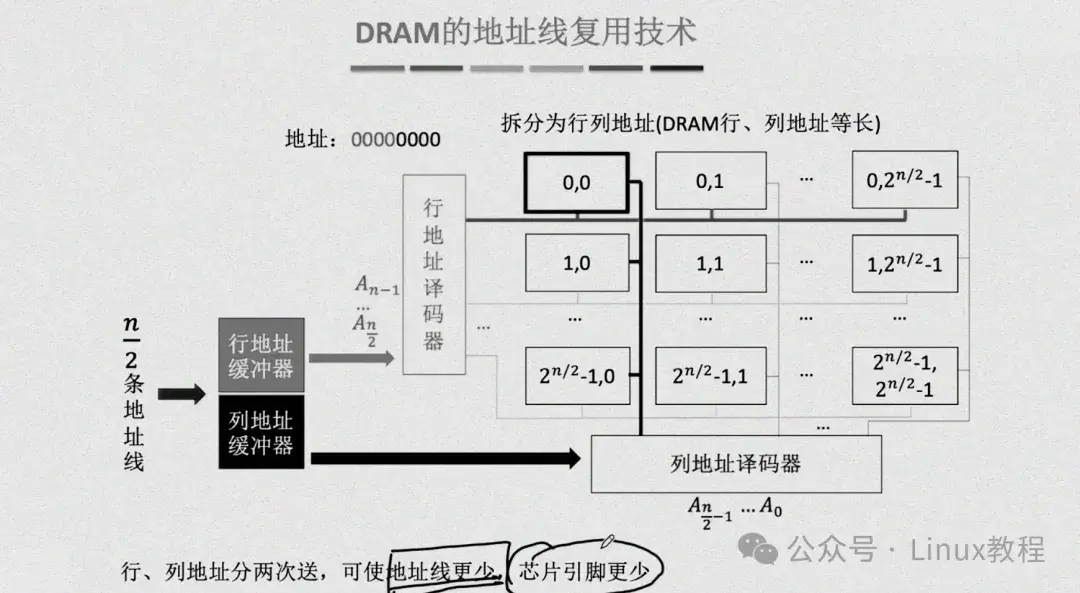
为了提升存储密度,DRAM芯片内部会将数十亿个1T1C单元排列成二维存储矩阵,通过行地址和列地址精准定位每一个存储单元,配合地址线复用技术,实现大容量存储,这也是后续地址线复用技术的基础。
3.2. 刷新机制
DRAM刷新不是盲目充电,而是一套严格遵循行业标准(JEDEC)的精密机制,核心目标是在不影响正常读写的前提下,定期补充电容电荷,避免数据丢失,标准规定:DRAM必须在64ms内,完成对所有存储单元的一次完整刷新,高温环境下刷新周期还要缩短,确保数据稳定。
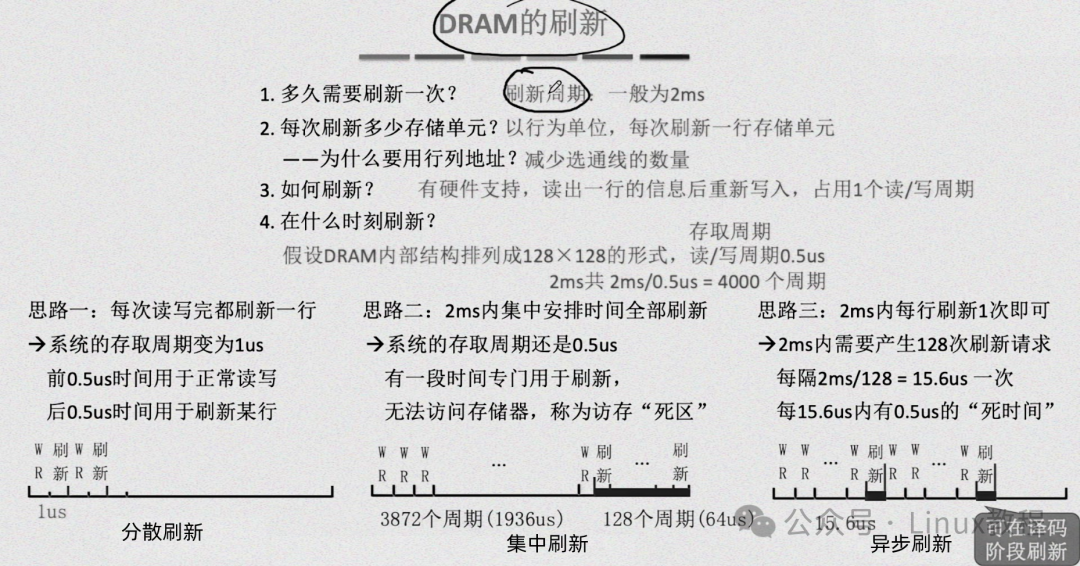
首先要明确:刷新操作的本质是“先读后写”,控制器先读取某一行存储单元的电荷数据,识别出0和1,再按照原有数据重新给电容充电,恢复电荷水平,整个过程不需要CPU参与,由内存控制器自动完成。而且刷新是以行为单位进行的,不是单个单元,效率更高。
目前主流DRAM有三种刷新方式,各有优劣,直接影响内存性能:
① 集中式刷新:将64ms内的所有刷新任务,集中在一个连续时间段内完成,期间内存完全停止读写操作,形成刷新死区。比如一款DRAM有8192行,每行刷新需要10ns,集中刷新总耗时就是81.92μs,这段时间CPU无法访问内存,只能等待,会明显降低系统性能,目前仅用于老式低端DRAM,已基本淘汰。
② 分布式刷新:将刷新操作均匀分散到64ms的每个时间段,把总行数平均分配,每隔一段时间刷新一行,避免出现长时间死区。比如8192行的DRAM,每隔7.8μs刷新一行,每次刷新仅占用10ns,几乎不影响正常读写,性能损耗极小,这也是目前DDR4/DDR5内存的主流刷新方式。
③ 异步刷新:结合前两种方式的优势,不固定刷新时间,内存控制器在内存空闲时自动执行刷新操作,有读写请求时暂停刷新,优先响应CPU指令,灵活性最高,进一步降低刷新对性能的影响,高端服务器DRAM常用这种方式。
刷新机制虽然解决了DRAM的数据保持问题,但也带来了两个弊端:一是产生额外功耗,二是占用少量读写带宽,不过相比于大容量、低成本的优势,这点损耗完全可以接受,也是DDR技术迭代中不断优化的重点。
3.3. 地址线复用技术
如果没有地址线复用技术,DRAM根本无法实现大容量普及,这项技术的核心作用是用最少的芯片引脚,实现最大容量的地址寻址,大幅降低芯片制造成本和硬件设计难度,是DRAM的核心黑科技之一。
正常逻辑下,存储矩阵的行地址和列地址需要独立的地址线传输,容量越大,需要的地址线越多,芯片引脚也就越多,不仅会增加芯片体积,还会大幅提升成本。而地址线复用采用分时传输逻辑,行地址和列地址共用同一组地址线,分两次传输:
第一步,发送行地址信号,同时发出行地址选通信号(RAS),锁定对应行的所有存储单元,将其激活;第二步,发送列地址信号,同时发出列地址选通信号(CAS),从激活的行中精准定位到具体的存储单元,完成读写。
举个通俗的例子:这就像图书馆找书,先通过行地址找到对应的书架排(行),再通过列地址找到书架上的具体位置(列),不用给每本书都配一个独立索引,大幅简化了寻址流程。
这项技术的优势极其明显:同等寻址能力下,地址线数量减少一半,芯片引脚大幅缩减,芯片体积更小、成本更低,同时存储密度进一步提升。目前从DDR1到最新的DDR5、LPDDR5X,全部采用地址线复用技术,也是DRAM能实现单条64GB、128GB大容量的核心技术支撑。
往期精选干货 | C/C++ 开发进阶攻略
👉 搞懂 C++ 就业前景 & 求职避坑:为什么很多人劝退学 C++,但大厂核心岗位还是要 C++?
👉 大厂后端岗系统进阶路线:【大厂标准】Linux C/C++ 后端进阶学习路线
👉 音视频赛道核心学习路径:音视频流媒体高级开发 - 学习路线
👉 Qt 桌面 / 嵌入式开发全闭环攻略:C++ Qt 学习路线一条龙!(桌面开发 & 嵌入式开发)
👉 Linux 内核硬核修炼指南:Linux 内核学习指南,硬核修炼手册
👉 面试冲刺高频八股题库:C/C++ 高频八股文面试题 1000 题(三)
👉 C++ 实操能力硬核提升:手撕线程池:C++ 程序员的能力试金石
四、解密 SRAM
4.1. 基本存储单元结构
SRAM的速度优势,完全来源于6管CMOS双稳态触发器(6T-SRAM)的精密结构,这是目前最成熟、最稳定的SRAM存储单元,每个单元同样存储1bit数据,但工作逻辑和DRAM完全不同,彻底摆脱了电容漏电和刷新的束缚。
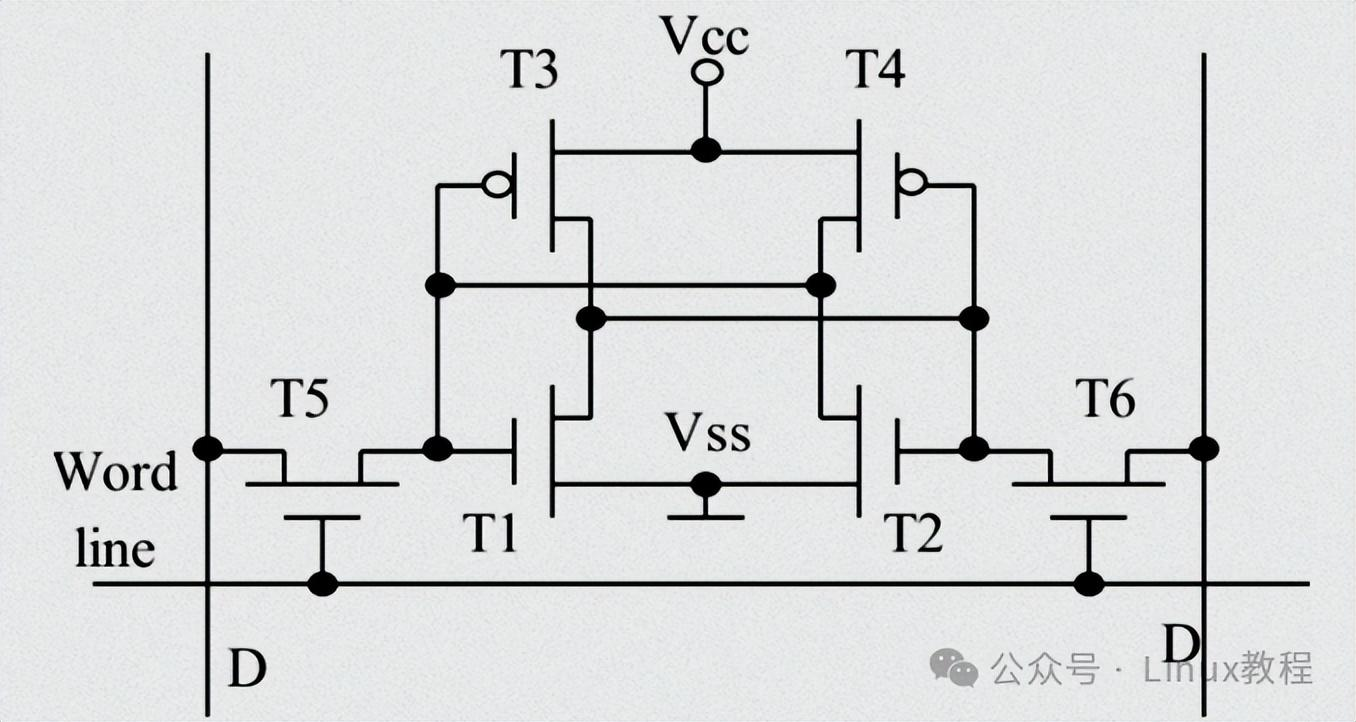
6管单元由6个MOS场效应晶体管组成,分为三部分:4个NMOS/PMOS晶体管组成交叉耦合触发器,构成两个稳定的互补状态,专门用于存储数据;另外2个晶体管作为字线选通开关,控制读写通路,连接位线(数据传输线)。
双稳态触发器的核心特性:只要通电,电路会稳定保持在两种状态之一,不会自行翻转。状态一:左侧晶体管导通、右侧截止,代表数据“1”;状态二:右侧晶体管导通、左侧截止,代表数据“0”。只要不断电,这种状态会永久保持,不需要任何刷新操作,数据不会丢失,这就是SRAM“静态”的核心含义,也是它速度极快的根本原因。
和DRAM的1T1C结构相比,6管SRAM没有电容充放电的等待时间,读写时直接通过晶体管开关状态读取电平信号,几乎零延时,而且抗干扰能力更强,数据稳定性极高,适合对速度和可靠性要求极致的场景。
4.2. SRAM 的结构特点与读写流程
SRAM的整体结构和DRAM差异极大,没有存储矩阵的刷新逻辑,也没有地址线复用的复杂流程,整体架构更简单直接,核心分为地址译码器、存储单元阵列、控制电路、I/O接口四部分,所有设计都围绕“高速”展开。
6管单元核心特点:一是无易失性元件(无电容),通电即稳定,无需刷新;二是读写通路独立,读操作和写操作互不干扰;三是访问速度快,时序简单,不需要等待RAS/CAS信号切换;四是静态功耗高,所有触发器需要持续供电,维持电路状态。
SRAM读写操作流程极简,全程无延时等待:
读操作:地址信号输入地址译码器,快速锁定目标存储单元→字线选通,打开读写开关→触发器的状态信号通过位线直接输出,传输到数据总线→CPU瞬间获取数据,全程仅需1-2个时钟周期。
写操作:地址信号锁定单元→写入数据通过位线传输→改变触发器的导通/截止状态→新数据稳定存储,只要不断电,数据永久保持,无需后续维护。
整个过程没有充放电、没有刷新、没有地址分时传输,信号路径极短,损耗极小,这也是SRAM能实现纳秒级延迟的核心原因,哪怕是高频CPU,也能跟上其运算节奏。
4.3. 为什么 SRAM 速度碾压 DRAM?
很多人疑惑,同样是晶体管组成的存储器,为什么SRAM速度能比DRAM快百倍以上,核心原因有三点,每一点都是底层结构带来的绝对优势:
第一,彻底摆脱刷新机制,无额外延时。DRAM每64ms就要全量刷新,每次刷新占用读写时间,而且电容充放电本身需要延时(电容电压达到阈值需要时间);SRAM没有电容,不需要刷新,读写直接读取晶体管电平,没有任何等待时间,这是最核心的速度差距。
第二,电路结构极简,信号路径极短。SRAM的触发器电路直接连接读写位线,信号传输距离短,电阻、电容损耗小,信号衰减极慢,读写响应速度快;DRAM需要经过晶体管开关、电容充放电、地址复用切换,信号路径长,延时自然更高。
第三,时序逻辑简单,无需同步等待。DRAM需要严格同步RAS、CAS信号,行地址和列地址分时传输,需要等待信号稳定;SRAM地址信号一次性传输,读写时序简单,和CPU时钟周期完美同步,能做到即时响应。
举个实际参数对比:主流DDR5内存的访问延迟约400ns,而CPU内置的SRAM L1缓存延迟仅0.5ns,带宽更是达到惊人的数十TB/s,远超DDR5的100GB/s左右带宽。哪怕是高端显卡的HBM3内存,带宽也远不如片上SRAM,这也是CPU必须搭配SRAM缓存的核心原因——没有SRAM,CPU的性能会被DRAM的延迟彻底限制。
五、应用场景
5.1. DRAM 的主场
DRAM凭借大容量、低成本、低静态功耗的优势,牢牢占据着主内存、显存两大核心场景,覆盖几乎所有电子设备,是日常使用中最常见的内存形态,没有之一。
电脑主内存(DDR/DIMM):台式机、笔记本的DDR4/DDR5内存条,是DRAM最核心的应用,负责存储所有正在运行的程序、系统进程、临时数据。日常办公8GB起步,游戏、设计16GB起步,专业渲染、服务器则需要32GB/64GB甚至更高容量,DRAM的高性价比让大容量内存普及成为可能。
移动设备运行内存(LPDDR):手机、平板、智能手表的LPDDR5/LPDDR5X内存,属于低功耗版DRAM,针对移动设备优化了功耗和体积,集成在SOC内部,负责APP运行、多任务切换,目前旗舰机已经普及12GB/16GB运行内存,都是DRAM的迭代产物。
显卡显存(GDDR/HBM):显卡的GDDR6/GDDR6X、HBM3显存,属于高性能版DRAM,针对图形渲染优化了带宽,负责存储游戏纹理、渲染数据、帧缓存,是显卡性能的核心支撑,高端显卡搭载的16GB/24GB显存,全部是DRAM架构。
服务器/工业内存:服务器ECC DRAM,具备错误校验和纠正功能,稳定性更强,适合7×24小时运行的服务器、工控设备,依靠大容量和高可靠性,支撑云计算、大数据、人工智能等场景。
2. SRAM 的主场
SRAM因为成本高、容量小、功耗高,注定无法用于大容量场景,只专注于超低延迟、高实时性的核心场景,是高端硬件的“速度心脏”,看似不起眼,却决定着硬件的极限性能。
CPU缓存(L1/L2/L3):这是SRAM最核心的应用,CPU内部的一级(L1)、二级(L2)、三级(L3)缓存,全部由SRAM构成。L1缓存容量最小(几十KB)、速度最快,和CPU核心直连;L2缓存容量稍大(几百KB),L3缓存容量最大(几十MB),为所有核心共享,三者形成缓存层级,提前存储CPU高频使用的数据和指令,让CPU不用频繁访问慢速DRAM,大幅提升运算效率。
网络设备高速缓存:高端路由器、交换机、服务器网卡,内部的数据包缓存采用SRAM,负责高速转发网络数据包,降低网络延迟,保障企业网络、数据中心的高速传输。
嵌入式/实时控制系统:汽车电子(自动驾驶ECU)、工业自动化、航空航天设备,对实时性要求极高,需要瞬间响应传感器信号,SRAM的零延迟、高稳定性,完美适配这类场景,不会出现延时卡顿导致的安全风险。
5.3. 为什么不能互相替代?
很多人会问:既然SRAM速度更快,为什么不用它做内存条?
既然DRAM容量更大,为什么CPU缓存不用DRAM?
答案很简单:二者的设计定位和性能特性,决定了它们完全无法互相替代,强行替代只会得不偿失。
成本与容量无法平衡:SRAM单位容量成本是DRAM的3-10倍,存储密度极低,做一条16GB的SRAM内存条,成本高达数万元,体积更是大到无法安装,完全不具备普及性;而DRAM如果做CPU缓存,容量虽然大,但速度太慢,CPU等待延迟的时间,会让整体性能下降70%以上,毫无意义。
功耗与场景不匹配:SRAM静态功耗极高,用于手机、笔记本等移动设备,续航会直接腰斩;DRAM刷新功耗低,但速度太慢,无法满足CPU、实时系统的低延迟需求,功耗优势完全弥补不了速度短板。
存储金字塔的天然分工:计算机存储金字塔的逻辑,就是“速度越快、容量越小、成本越高”,SRAM位于塔顶,负责极致速度;DRAM位于中层,负责大容量高速存储;硬盘位于底层,负责长期存储。三者各司其职,才形成了高效的存储体系,打破这个分工,系统性能和成本都会彻底失衡。
六、常见问题解答
6.1. MRAM/FRAM等新型存储器,会取代SRAM/DRAM吗?
近MRAM(磁阻RAM)、FRAM(铁电RAM)、PCRAM(相变RAM)等新型非易失性存储器热度很高,它们兼具非易失性、高速度、低功耗,看似能替代传统内存,但短期内完全无法取代DRAM和SRAM,长期也只会是互补,而非替代。
MRAM依靠磁性隧道结存储数据,速度接近SRAM,非易失性(断电不丢数据),功耗极低,目前已经用于部分高端CPU缓存、汽车电子;FRAM功耗更低,适合物联网设备;PCRAM存储密度高,接近DRAM。但它们的核心短板很明显:制造成本极高、存储密度不如DRAM、良品率低、生态兼容性差。
目前DRAM和SRAM已经形成完整的产业链、生态体系,制程工艺成熟(DRAM量产至1αnm,SRAM集成在5nm/3nm CPU内),成本可控,性能稳定。新型存储器更多是用于特定场景补位,比如替代部分低容量SRAM、作为存储级内存衔接DRAM和SSD,完全取代DRAM和SRAM,至少未来5-10年不可能实现。
6.2. 内存越大越好吗?怎么选才合理?
内存容量绝对不是越大越好,而是适配使用场景+匹配CPU性能,容量过剩会造成资金浪费,容量不足则会卡顿,合理选型遵循以下标准:
日常办公/网课/追剧:8GB DDR4/DDR5内存足够,系统+办公软件+浏览器,占用内存不超过6GB,8GB完全流畅,没必要上16GB。
主流游戏/轻度设计:16GB内存起步,3A游戏、LOL、原神等大型游戏,加上后台程序,内存占用约10-12GB,16GB刚好够用,兼顾性价比和流畅度。
专业设计/视频剪辑/3A全开:32GB内存起步,PR/AE/C4D、4K视频剪辑、大型3D建模,内存占用轻松超过20GB,32GB才能避免卡顿,专业用户直接上64GB。
服务器/深度学习:64GB/128GB起步,根据负载按需扩容,这类场景内存容量直接影响运算速度。
另外,内存频率和时序也很重要,同容量下,DDR5 6000MHz比DDR5 4800MHz更快,时序越低、延迟越低,游戏和设计场景优先选高频低时序内存。
6.3. 为什么缓存不用 DRAM?
缓存的核心使命是消除CPU与主内存的速度差,要求极致低延迟,而DRAM完全满足不了这个需求:一是DRAM延迟太高,是SRAM的数百倍,CPU访问DRAM缓存,会长期处于等待状态,性能暴跌;二是DRAM需要刷新,刷新期间无法响应CPU指令,会产生大量等待死区;三是DRAM时序复杂,需要地址复用切换,无法和CPU高频时钟同步。
而且缓存容量很小,L1缓存仅几十KB,L3缓存最多几十MB,用SRAM的成本完全可控,没必要为了省成本牺牲性能,所以缓存是SRAM的专属领域,DRAM根本无法胜任。
6.4. DDR4、DDR5 和 DRAM 是什么关系?
DDR4、DDR5本质上都是DRAM的迭代升级版本,属于同步动态随机存取存储器(SDRAM),核心存储单元还是1T1C结构,需要刷新,遵循DRAM的所有工作逻辑,只是在带宽、频率、功耗、通道架构上做了优化升级。
简单来说:DRAM是基础架构,DDR(双倍数据速率)是在DRAM基础上,实现时钟上升沿和下降沿都传输数据,提升带宽,从早期的DDR1,迭代到现在的DDR4、DDR5,下一代还有DDR6。
核心升级点:DDR5相比DDR4,起步频率从2133MHz提升至4800MHz,带宽翻倍,工作电压从1.2V降至1.1V,功耗更低,新增片上ECC纠错,支持双通道拆分,稳定性和性能更强,是目前主流的DRAM技术。
6.5. 未来会有新的存储技术吗?DRAM/SRAM会怎么发展?
存储技术会持续迭代,DRAM和SRAM也会不断进化:DRAM会向3D堆叠、更高频率、更低功耗发展,HBM(高带宽内存)会普及,存储密度和带宽进一步提升;SRAM会随着CPU制程升级(3nm/2nm),集成度更高,容量更大,延迟更低。
新型存储器会持续突破,MRAM、PCRAM会逐步商用,形成SRAM+DRAM+新型非易失性存储器+SSD的多层级存储架构,兼顾速度、容量、功耗、成本,未来存算一体技术也会落地,内存和运算单元融合,进一步提升硬件效率。
6.6. SRAM与DRAM的选型标准
硬件开发或硬件选购中,选型遵循三大原则:
选SRAM的场景:需要超低延迟、高实时性、小容量存储,比如CPU缓存、工控系统、汽车电子、高速数据采集,优先考虑速度和稳定性,不计较成本和容量。
选DRAM的场景:需要大容量、低成本、低静态功耗,比如主内存、运行内存、显存、服务器内存,优先考虑容量和性价比,对延迟要求不极致。
复杂系统选型:采用“SRAM缓存+DRAM主存”的组合,高端系统搭配ECC DRAM+高速SRAM,平衡性能与成本,这也是目前所有电子设备的通用方案。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 6
 0
- 0


 已为社区贡献14条内容

所有评论(0)