(论文速读)Mask-SL RCNN:特征增强的点云三维目标检测网络
论文题目:Mask-SL RCNN: Feature-Enhanced 3D Object Detection Network for Point Clouds(特征增强的点云三维目标检测网络)
期刊:IEEE PHOTONICS JOURNAL
摘要:目前,大多数目标检测器以原始点云为输入,采用Pointnet++基于最远点采样(FPS)提取点云特征。然而,受FPS的影响,特征提取不完整且不稳定。此外,高级语义特征缺乏感兴趣区域(RoI)的内部顶点属性。为了解决上述问题,我们提出了基于特征增强的三维物体检测网络MaskSL RCNN (Mask-Spherical-neighborhood-global-feature-Layer Region-CNN)。它通过点级特征增强来改善最远点的采样。此外,我们提出球面邻域全局特征层(SL)来补充全局特征,提高网络的学习能力。最后,在语义级特征增强的基础上,设计了基于顶点关注的网格池化层,充分挖掘了感兴趣区域的边界特征,提高了对感兴趣区域高级特征的学习能力。我们的网络提高了行人等小物体的检测精度。与PointRCNN相比,该方法在KITTI数据集中的mAPof简单、中等和困难物体检测分别提高了2.66%、1.69%和0.67%。
Mask-SL RCNN: 让自动驾驶"看得更清楚"
引言
想象一下,当自动驾驶汽车在繁忙的街道上行驶时,如何准确识别行人、自行车和其他车辆?这依赖于3D目标检测技术——一项能够从激光雷达点云数据中识别和定位物体的关键技术。今天,我要介绍一篇来自重庆大学团队的最新研究成果,它在小目标检测(特别是行人检测)方面取得了显著突破。
问题的根源:传统方法哪里不够好?
在3D目标检测领域,基于点云的方法因其精确的位置信息而备受青睐。然而,现有方法存在三个核心问题:
1️⃣ 采样不够"智能"
传统的最远点采样(FPS)就像一个只会量距离的机器人——它只关心点与点之间有多远,却忽略了这些点周围的"环境信息"。这就好比你在人群中选人,只看他们站得多分散,却不管他们身边有没有其他人。
2️⃣ 特征提取太"局部"
想象你用望远镜观察一个球形区域,传统方法只记录你看到的点相对于中心的水平距离,却忽略了垂直方向的信息。对于激光雷达来说,这种垂直信息恰恰反映了扫描的密度和物体的完整性。
3️⃣ 边界学习不充分
在精细化阶段,系统需要准确框定物体的边界。但传统方法在学习物体边界特征时力不从心,就像画画时只关注中间部分,边缘却画得很粗糙。
Mask-SL RCNN的三大创新
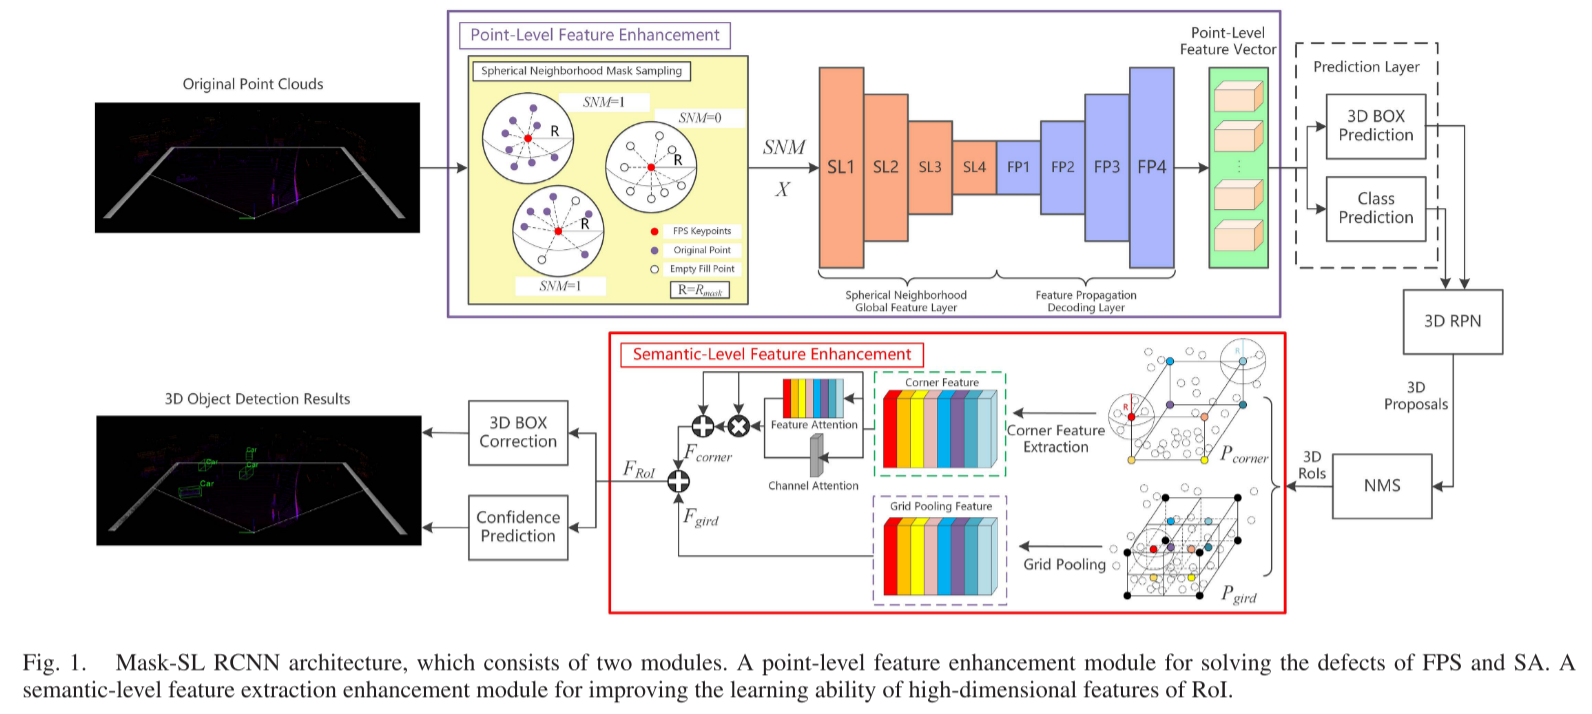
针对上述问题,研究团队提出了Mask-SL RCNN,通过三个巧妙的设计实现了突破:
🎯 创新1: 球形邻域掩码采样(M-FPS)
简单来说:就是给每个点加一个"邻居检测器"。
工作原理:
- 传统FPS:只看点与点的距离
- M-FPS:不仅看距离,还看这个点周围有没有邻居
实际效果:
- 自动过滤掉"孤零零"的点(比如地面上的噪声点)
- 保留更多有意义的前景点(属于车辆、行人等目标的点)
数学表达:
如果某个点周围半径R内只有它自己 → 标记为"空"邻域(SNM=0)
如果周围有其他点 → 标记为"有效"邻域(SNM=1)
🌐 创新2: 球形邻域全局特征层(SL)
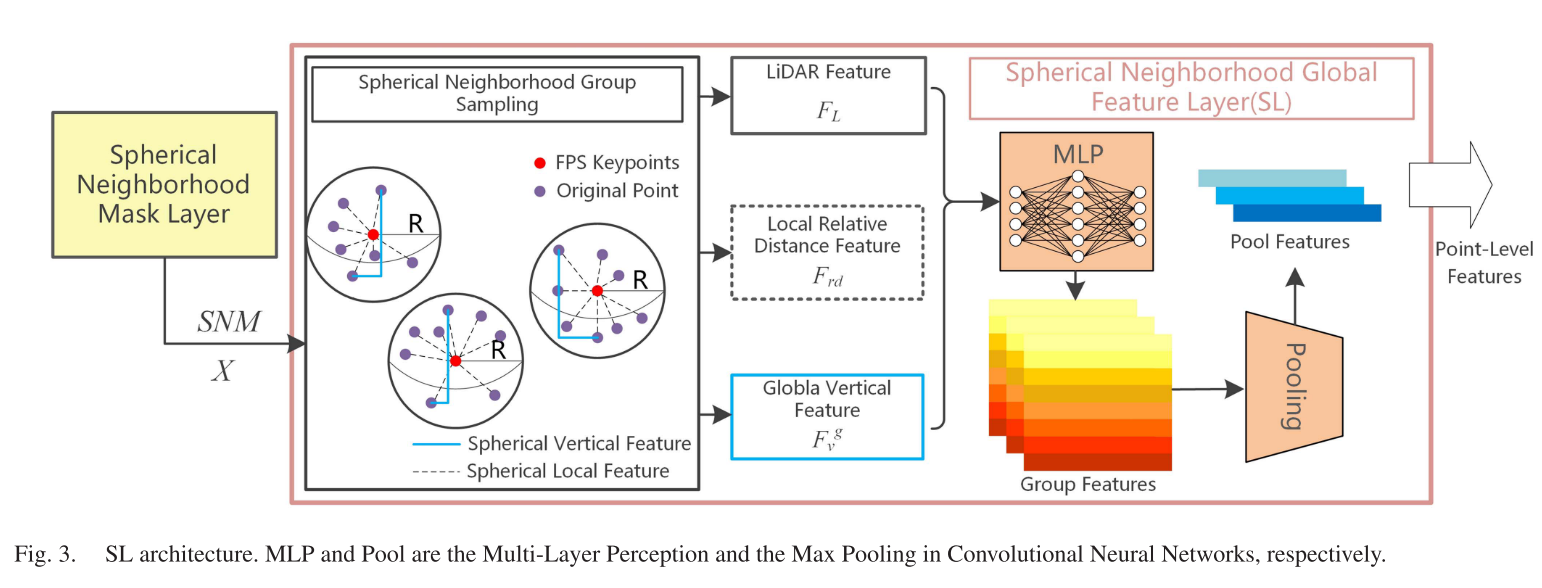
核心思想:给局部特征加上"全局视野"。
传统方法就像只用一把尺子测量,SL则引入了三把不同的"尺子":
- 局部距离尺:测量邻域内点的相对位置
- 激光特征尺:记录激光雷达的原始信息
- 全局垂直尺:测量垂直方向的分布情况
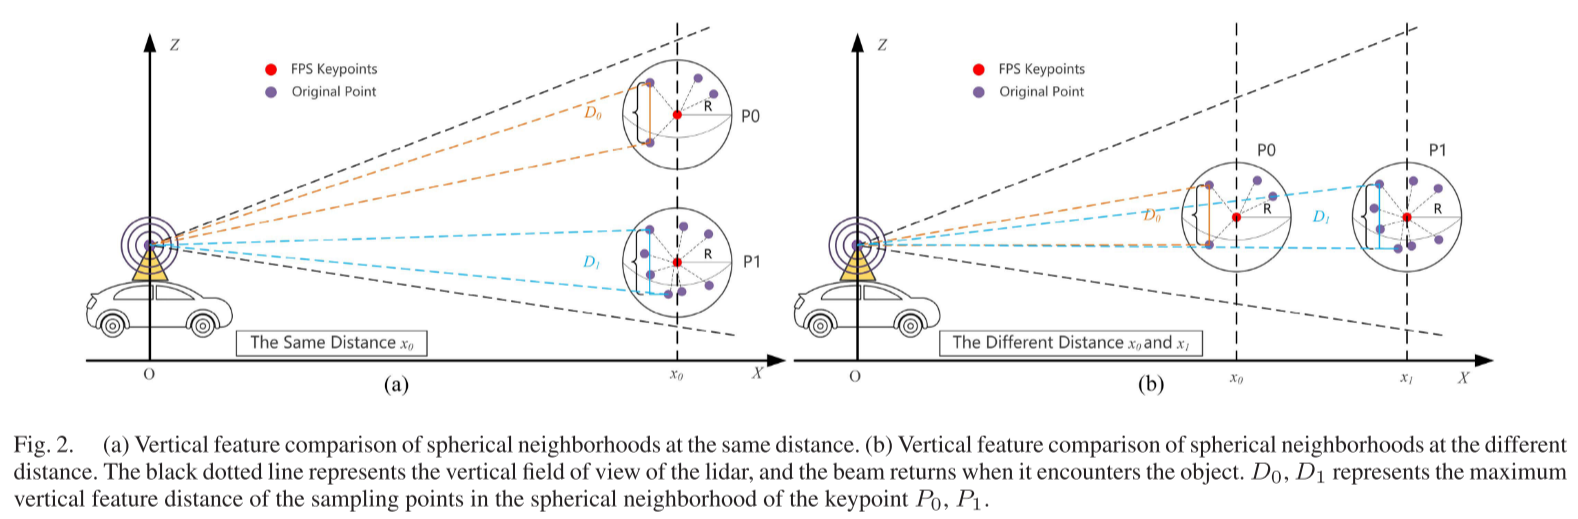
为什么垂直特征重要?
考虑两个场景:
- 场景A:汽车近处的行人 → 激光扫过的垂直范围大 → 点云密集
- 场景B:汽车远处的行人 → 激光扫过的垂直范围小 → 点云稀疏
通过垂直特征与全局距离的比值(Fv/x),系统能够判断:这个区域的点云密度是因为物体本身特征,还是因为距离远近?
📐 创新3: 基于顶点注意力的网格池化
形象比喻:就像给物体画一个精确的"外框"。
两步走策略:
第一步 - 角点特征提取:
- 选取边界框的8个角点
- 在每个角点周围多尺度查询
- 学习物体边缘外侧的特征
第二步 - 网格池化:
- 把边界框内部分成8个小格子
- 每个格子中心向外查询
- 学习物体内部的精细特征
组合优势:外部边界+内部细节=更准确的物体定位
实验结果
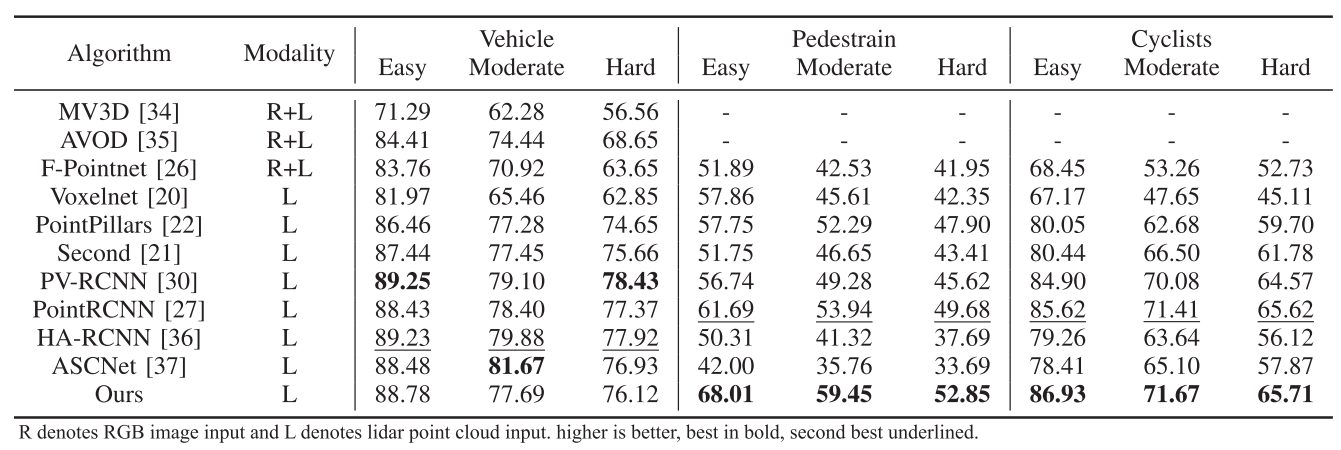
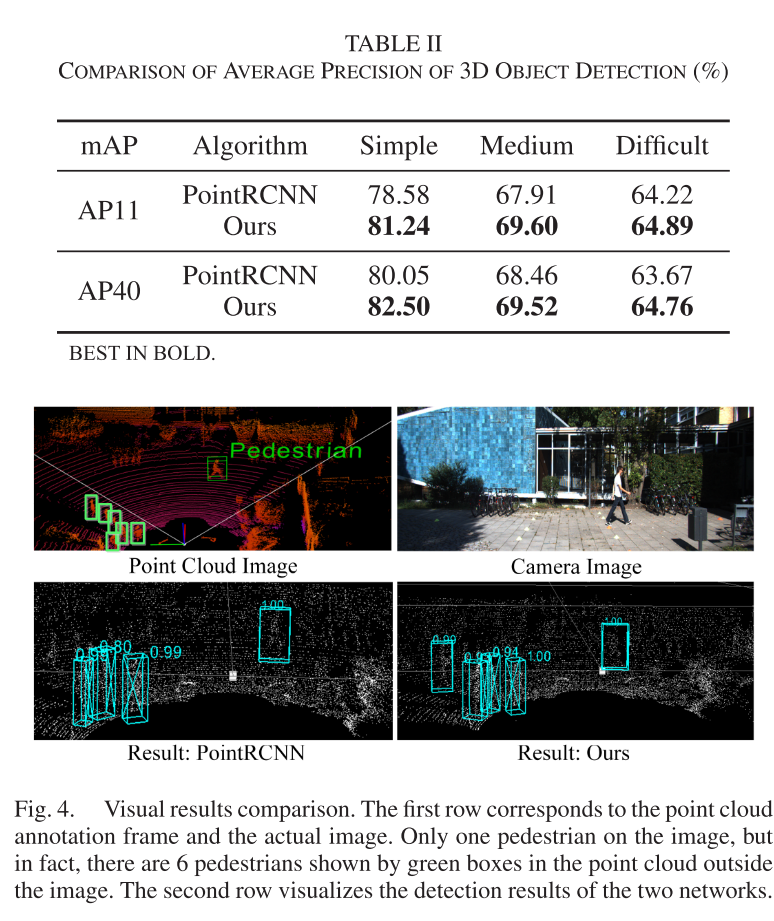
📊 整体性能
在KITTI基准数据集上,Mask-SL RCNN相比基线PointRCNN:
- 简单场景:mAP提升2.66%
- 中等场景:mAP提升1.69%
- 困难场景:mAP提升0.67%
🚶 行人检测大幅提升
这是最令人兴奋的结果:
| 难度级别 | 提升幅度 |
|---|---|
| 简单 | +6.32% (61.69% → 68.01%) |
| 中等 | +5.51% (53.94% → 59.45%) |
| 困难 | +3.17% (49.68% → 52.85%) |
为什么行人检测提升这么大?
- 行人体积小,点云稀疏
- M-FPS有效过滤背景噪声
- SL层补充了稀疏点云的全局信息
- 顶点注意力精确定位小目标边界
🔬 消融实验的启示
研究团队通过系统性实验验证了每个模块的贡献:
- SL层单独作用:行人检测提升2.39%-0.34%
- 加入M-FPS:进一步增强小目标检测
- 参数Rmask优化:
- Rmask=0.5:最适合行人检测
- Rmask=0.75:最适合自行车检测
- Rmask=1.0:更适合大型车辆
这说明不同大小的物体需要不同的"观察尺度"。
方法的局限与展望
⚠️ 当前局限
在车辆检测(尤其是中等和困难级别)上,Mask-SL RCNN略逊于PointRCNN。原因在于:
- 车辆内部存在局部稀疏区域(如车窗)
- M-FPS可能过度过滤这些稀疏但有意义的点
- 对大型物体的内部结构学习不够充分
🔮 未来方向
- **自适应Rmask:**根据物体类型和大小动态调整
- **多尺度融合:**结合不同Rmask的优势
- **稀疏区域建模:**专门处理车辆等大型物体的内部稀疏特征
实际应用价值
自动驾驶场景
- 城市道路:更准确识别行人和自行车,提升安全性
- 复杂环境:在遮挡和密集场景中表现更好
- 实时性:在保持精度的同时维持可接受的速度
工业应用
- 机器人导航:提升小障碍物检测能力
- 安防监控:增强人员识别精度
- 智能交通:改善交通参与者检测
结语
Mask-SL RCNN通过三个精心设计的模块——球形邻域掩码采样、球形邻域全局特征层和基于顶点注意力的网格池化——系统性地解决了传统方法在采样、特征提取和边界学习方面的不足。
特别值得一提的是,该方法在小目标检测(尤其是行人检测)上取得了显著提升,这对于自动驾驶的安全性至关重要。虽然在大型车辆检测上还有改进空间,但其整体设计思路为3D目标检测提供了新的研究方向。
随着自动驾驶技术的不断发展,我们期待看到更多这样既有理论创新又注重实际效果的研究成果,让机器真正"看得更清楚",让自动驾驶更加安全可靠!
如果你对3D目标检测、自动驾驶或点云处理感兴趣,欢迎在评论区讨论交流!

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 26
 0
- 0


 已为社区贡献17条内容

所有评论(0)