【完整源码+数据集+部署教程】【零售和消费品&厨房】厨房食材检测图像分割系统源码&数据集全套:改进yolo11-goldyolo
背景意义
随着智能家居和自动化厨房的迅速发展,厨房食材的智能识别与管理成为了一个重要的研究方向。传统的厨房管理方式往往依赖于人工识别和记录,不仅效率低下,而且容易出现错误。基于深度学习的图像识别技术,尤其是YOLO(You Only Look Once)系列模型,因其高效的实时检测能力而备受关注。YOLOv11作为该系列的最新版本,具备更强的特征提取能力和更快的处理速度,为厨房食材的自动识别提供了新的可能性。
本研究旨在基于改进的YOLOv11模型,构建一个厨房食材检测图像分割系统。该系统将利用包含4500张图像的多样化数据集,涵盖了包括苹果、米饭、黑胡椒、花椰菜等在内的四类食材。这些食材不仅在家庭烹饪中常见,也在健康饮食和营养管理中扮演着重要角色。通过对这些食材的精准识别与分割,系统能够实现对厨房库存的实时监控,帮助用户更好地管理食材,减少浪费,并提升烹饪效率。
此外,随着人们对健康饮食的关注,食材的种类和品质日益受到重视。通过引入深度学习技术,研究将推动厨房智能化的发展,提升用户的烹饪体验。该系统的实现不仅有助于家庭用户的日常生活,还可为餐饮行业提供数据支持,优化食材采购和库存管理,具有广泛的应用前景和市场价值。因此,本研究不仅具有重要的学术意义,也具备良好的实际应用潜力,为未来的智能厨房发展奠定基础。
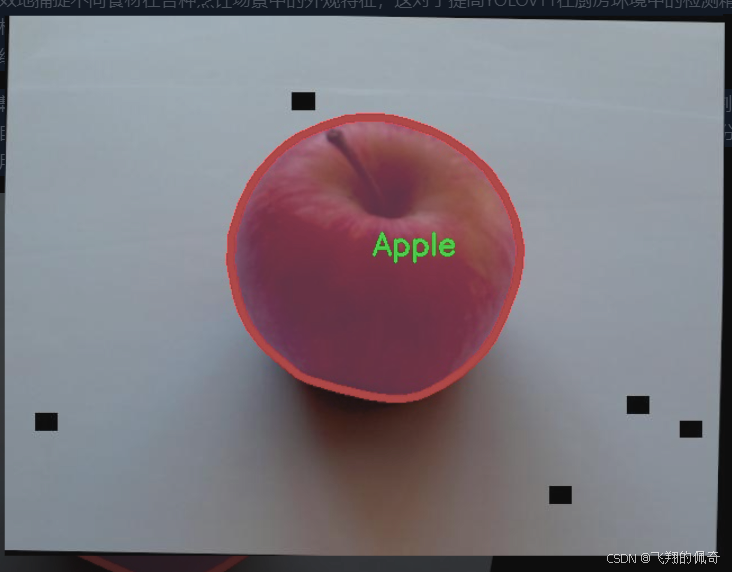
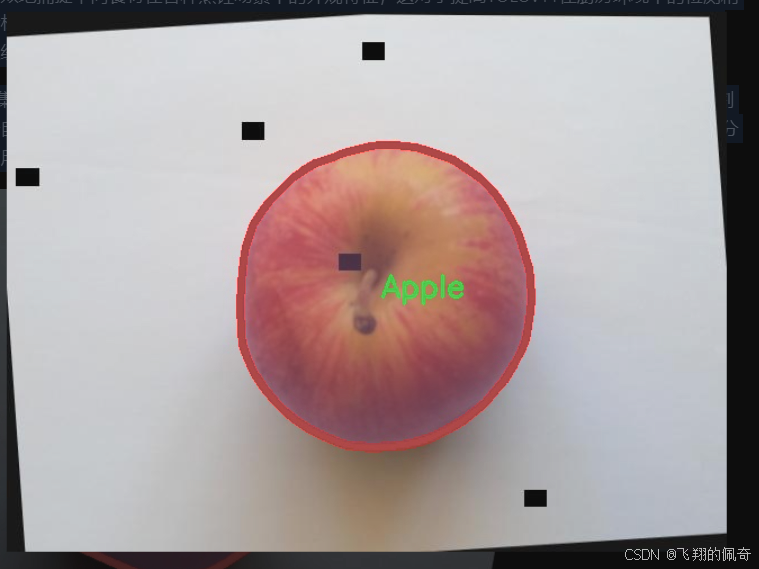
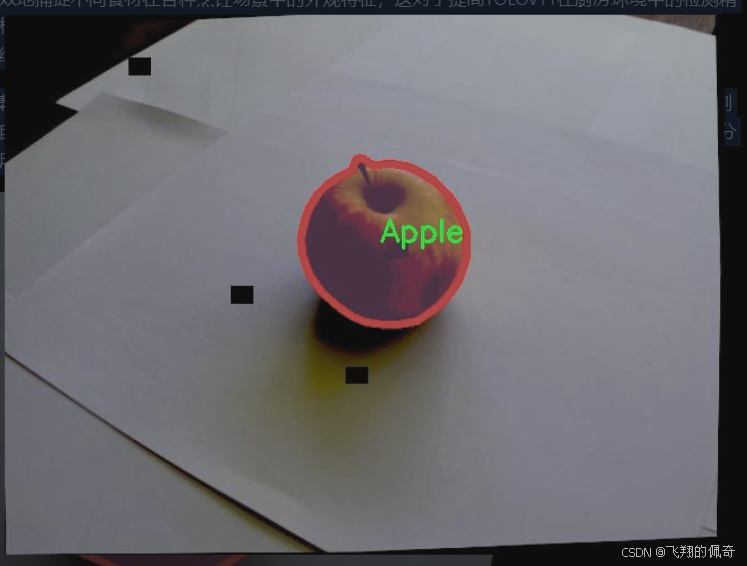
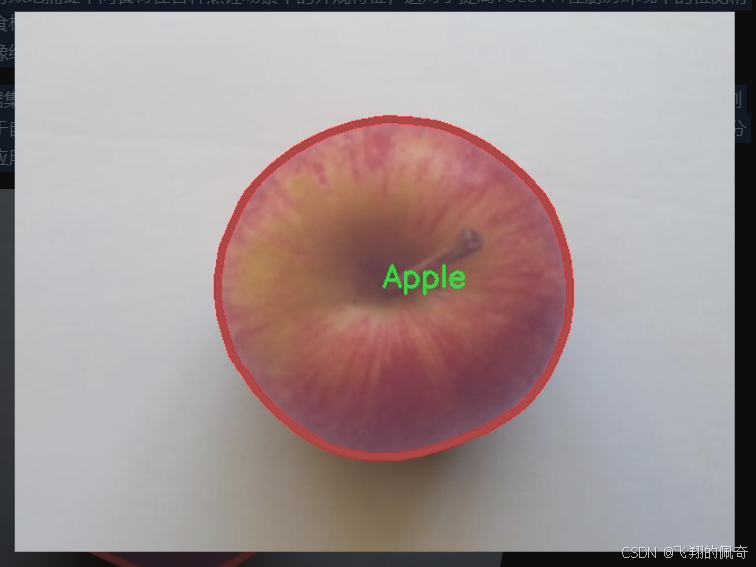
图片效果
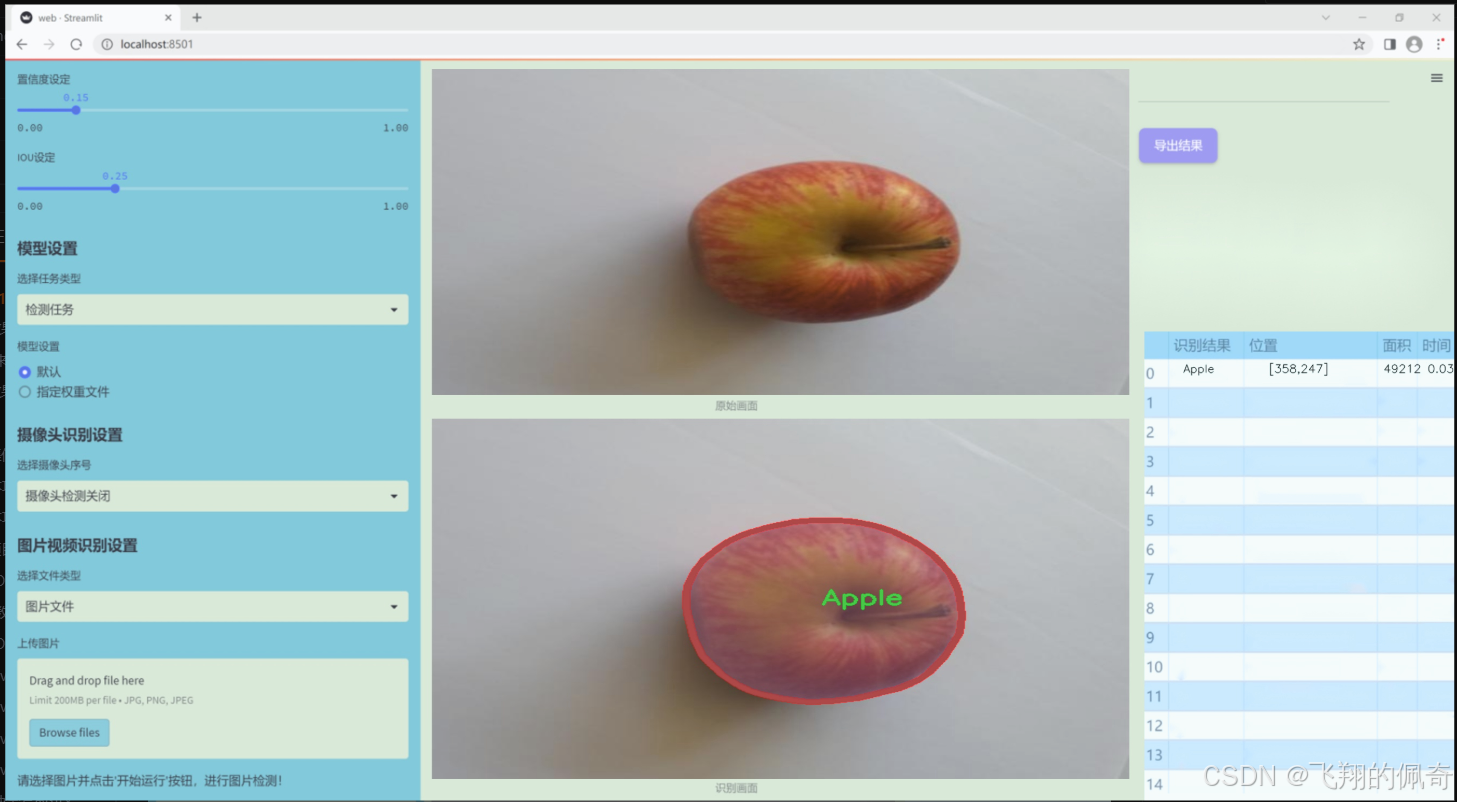
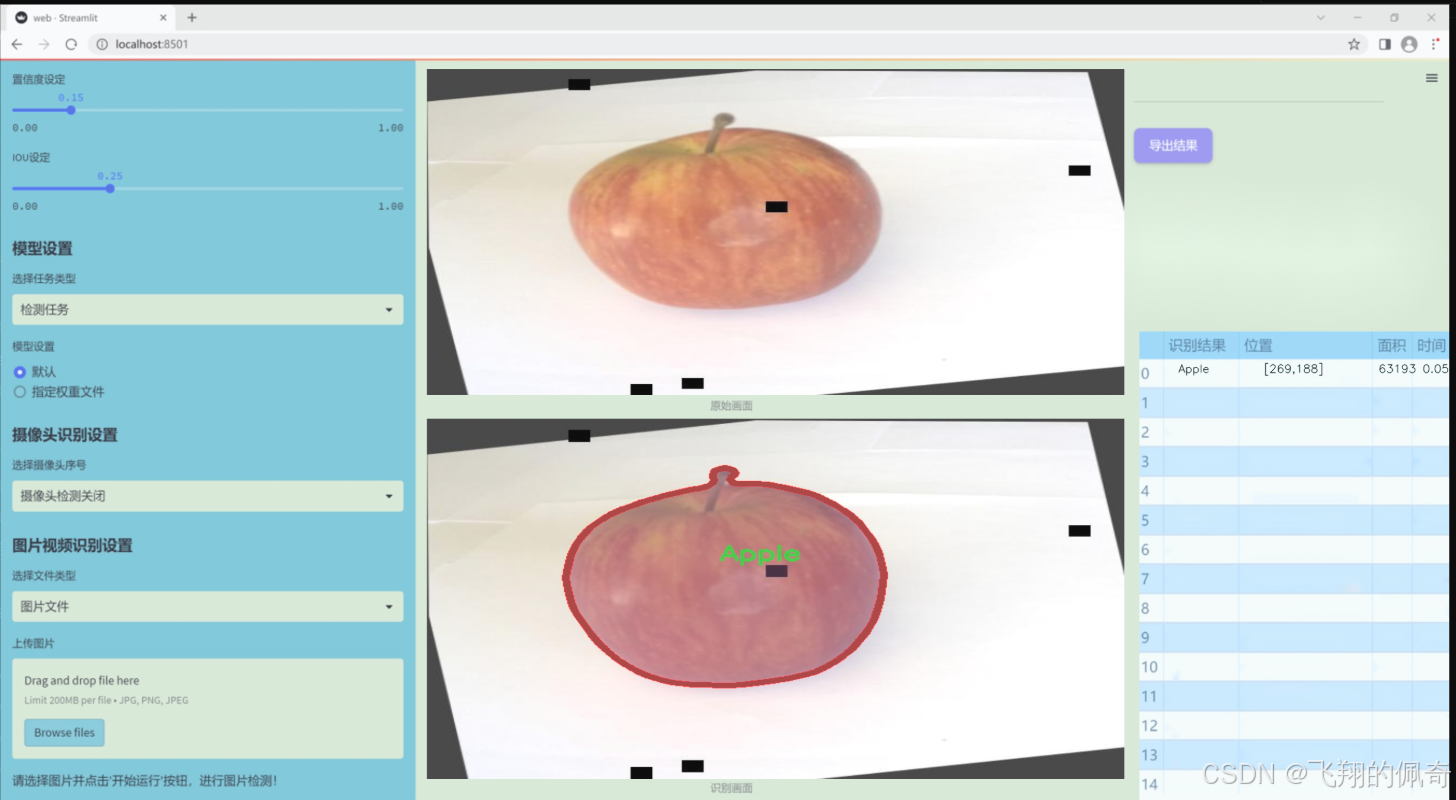
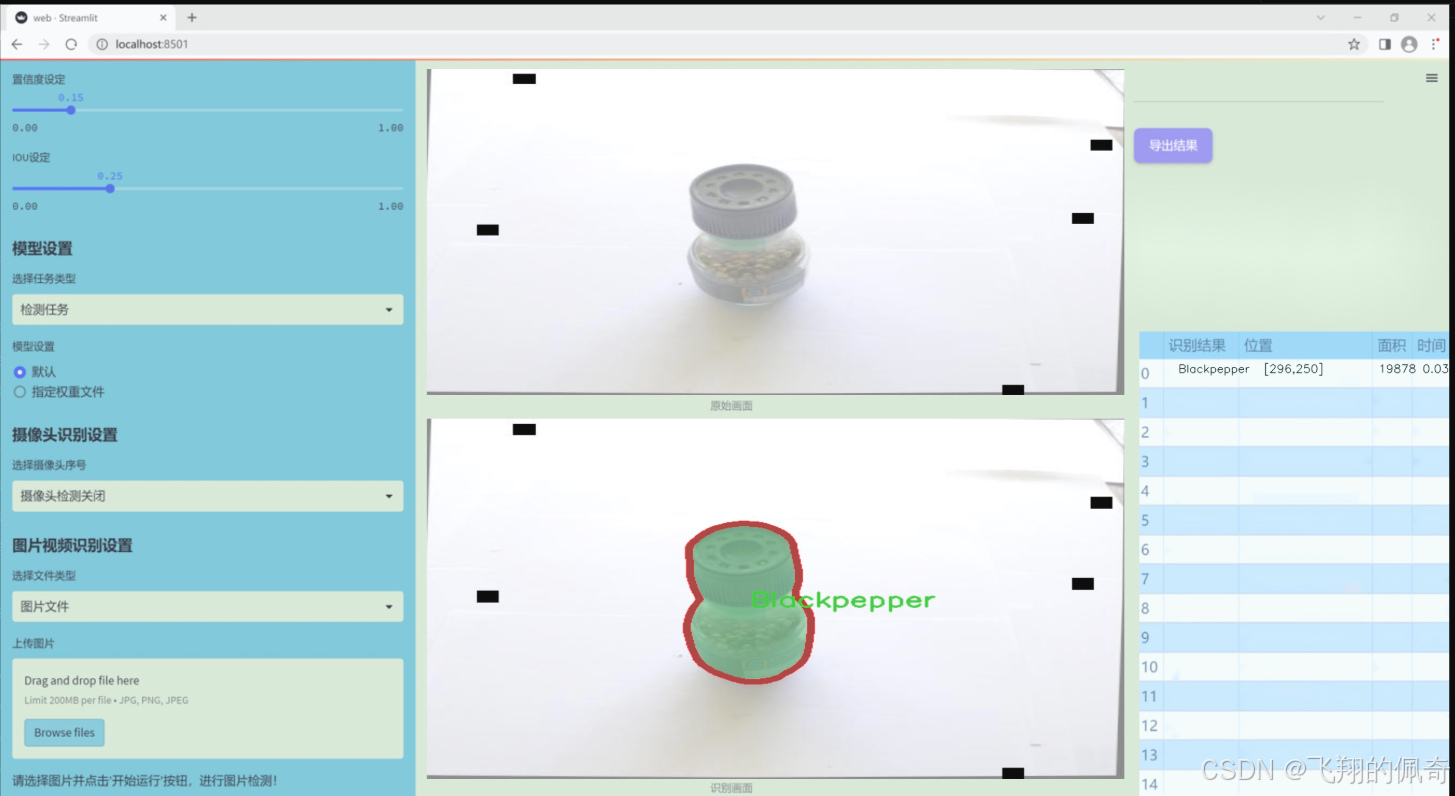
数据集信息
本项目所使用的数据集名为“Ingredients”,其主要目的是为了训练和改进YOLOv11的厨房食材检测图像分割系统。该数据集包含32个类别,涵盖了多种常见的厨房食材,旨在为图像分割任务提供丰富的样本和多样化的特征。这些类别包括了从新鲜水果到调味品、从干货到乳制品的多种食材,具体类别有:苹果、巴斯马蒂米、黑胡椒、西兰花、红糖、黄油、酪乳、按钮蘑菇、腰果、鸡肉高汤、香菜、肉桂、鸡蛋、面粉、大蒜、青椒、柠檬、蛋黄酱、梅德乔尔枣、芥末、洋葱、豌豆、土豆、红豆、红椒、盐、春洋葱、西红柿、植物油、白糖、牛奶和酵母等。
数据集的多样性使其能够有效地捕捉不同食材在各种烹饪场景中的外观特征,这对于提高YOLOv11在厨房环境中的检测精度至关重要。每个类别的食材都经过精心挑选,确保涵盖了家庭烹饪中常见的食材类型,从而增强模型的实用性和适应性。此外,数据集中的图像经过精细标注,确保每个食材的边界清晰,便于进行高质量的图像分割训练。
通过使用“Ingredients”数据集,研究团队期望能够提升YOLOv11在复杂厨房环境中的检测能力,使其能够准确识别和分割出各种食材。这不仅有助于自动化厨房管理,还为智能烹饪助手的开发奠定了基础。整体而言,该数据集的构建为图像分割技术在食品识别领域的应用提供了坚实的支持,推动了相关研究的深入发展。
核心代码
以下是保留的核心代码部分,并附上详细的中文注释:
import torch
import torch.nn as nn
from einops import rearrange
class h_sigmoid(nn.Module):
“”“实现h-sigmoid激活函数”“”
def init(self, inplace=True):
super(h_sigmoid, self).init()
self.relu = nn.ReLU6(inplace=inplace) # 使用ReLU6作为基础
def forward(self, x):
    return self.relu(x + 3) / 6  # 计算h-sigmoid
class h_swish(nn.Module):
“”“实现h-swish激活函数”“”
def init(self, inplace=True):
super(h_swish, self).init()
self.sigmoid = h_sigmoid(inplace=inplace) # 使用h-sigmoid作为基础
def forward(self, x):
    return x * self.sigmoid(x)  # 计算h-swish
class RFAConv(nn.Module):
“”“实现RFA卷积模块”“”
def init(self, in_channel, out_channel, kernel_size, stride=1):
super().init()
self.kernel_size = kernel_size
    # 权重生成模块
    self.get_weight = nn.Sequential(
        nn.AvgPool2d(kernel_size=kernel_size, padding=kernel_size // 2, stride=stride),
        nn.Conv2d(in_channel, in_channel * (kernel_size ** 2), kernel_size=1, groups=in_channel, bias=False)
    )

    # 特征生成模块
    self.generate_feature = nn.Sequential(
        nn.Conv2d(in_channel, in_channel * (kernel_size ** 2), kernel_size=kernel_size, padding=kernel_size // 2, stride=stride, groups=in_channel, bias=False),
        nn.BatchNorm2d(in_channel * (kernel_size ** 2)),
        nn.ReLU()
    )

    # 最终卷积层
    self.conv = nn.Conv2d(in_channel, out_channel, kernel_size=kernel_size, stride=kernel_size)

def forward(self, x):
    b, c = x.shape[0:2]  # 获取输入的批次大小和通道数
    weight = self.get_weight(x)  # 生成权重
    h, w = weight.shape[2:]  # 获取特征图的高和宽

    # 计算加权特征
    weighted = weight.view(b, c, self.kernel_size ** 2, h, w).softmax(2)  # 对权重进行softmax处理
    feature = self.generate_feature(x).view(b, c, self.kernel_size ** 2, h, w)  # 生成特征

    # 计算加权后的特征
    weighted_data = feature * weighted
    conv_data = rearrange(weighted_data, 'b c (n1 n2) h w -> b c (h n1) (w n2)', n1=self.kernel_size, n2=self.kernel_size)  # 重排数据

    return self.conv(conv_data)  # 返回卷积结果
class SE(nn.Module):
“”“实现Squeeze-and-Excitation模块”“”
def init(self, in_channel, ratio=16):
super(SE, self).init()
self.gap = nn.AdaptiveAvgPool2d((1, 1)) # 全局平均池化
self.fc = nn.Sequential(
nn.Linear(in_channel, in_channel // ratio, bias=False), # 从c到c/r
nn.ReLU(),
nn.Linear(in_channel // ratio, in_channel, bias=False), # 从c/r到c
nn.Sigmoid()
)
def forward(self, x):
    b, c = x.shape[0:2]  # 获取输入的批次大小和通道数
    y = self.gap(x).view(b, c)  # 进行全局平均池化并调整形状
    y = self.fc(y).view(b, c, 1, 1)  # 通过全连接层
    return y  # 返回通道注意力
class RFCBAMConv(nn.Module):
“”“实现RFCBAM卷积模块”“”
def init(self, in_channel, out_channel, kernel_size=3, stride=1):
super().init()
self.kernel_size = kernel_size
    # 特征生成模块
    self.generate = nn.Sequential(
        nn.Conv2d(in_channel, in_channel * (kernel_size ** 2), kernel_size, padding=kernel_size // 2, stride=stride, groups=in_channel, bias=False),
        nn.BatchNorm2d(in_channel * (kernel_size ** 2)),
        nn.ReLU()
    )

    # 权重生成模块
    self.get_weight = nn.Sequential(nn.Conv2d(2, 1, kernel_size=3, padding=1, bias=False), nn.Sigmoid())
    self.se = SE(in_channel)  # Squeeze-and-Excitation模块

    # 最终卷积层
    self.conv = nn.Conv2d(in_channel, out_channel, kernel_size=kernel_size, stride=kernel_size)

def forward(self, x):
    b, c = x.shape[0:2]  # 获取输入的批次大小和通道数
    channel_attention = self.se(x)  # 计算通道注意力
    generate_feature = self.generate(x)  # 生成特征

    h, w = generate_feature.shape[2:]  # 获取特征图的高和宽
    generate_feature = generate_feature.view(b, c, self.kernel_size ** 2, h, w)  # 调整形状

    generate_feature = rearrange(generate_feature, 'b c (n1 n2) h w -> b c (h n1) (w n2)', n1=self.kernel_size, n2=self.kernel_size)  # 重排数据

    # 计算加权特征
    unfold_feature = generate_feature * channel_attention
    max_feature, _ = torch.max(generate_feature, dim=1, keepdim=True)  # 计算最大特征
    mean_feature = torch.mean(generate_feature, dim=1, keepdim=True)  # 计算均值特征
    receptive_field_attention = self.get_weight(torch.cat((max_feature, mean_feature), dim=1))  # 计算感受野注意力
    conv_data = unfold_feature * receptive_field_attention  # 加权特征

    return self.conv(conv_data)  # 返回卷积结果
代码说明:
h_sigmoid 和 h_swish:实现了h-sigmoid和h-swish激活函数,常用于轻量级神经网络中。
RFAConv:实现了RFA卷积模块,通过生成特征和权重来增强特征表达能力。
SE:实现了Squeeze-and-Excitation模块,用于通道注意力机制。
RFCBAMConv:实现了RFCBAM卷积模块,结合了特征生成、通道注意力和感受野注意力机制。
这些模块可以用于构建更复杂的神经网络,增强网络的特征提取能力和表达能力。
这个程序文件 RFAConv.py 实现了一些基于卷积神经网络的模块,主要包括 RFAConv、RFCBAMConv 和 RFCAConv。这些模块结合了注意力机制和卷积操作,旨在提升特征提取的能力。
首先,文件中定义了两个激活函数模块:h_sigmoid 和 h_swish。h_sigmoid 是一种改进的 sigmoid 函数,使用了 ReLU6 作为基础,能够在输入范围内进行平滑处理。h_swish 则是将 h_sigmoid 应用于输入,形成了一种新的激活函数。
接下来是 RFAConv 类的定义。这个类的构造函数中定义了几个主要的子模块,包括一个用于生成权重的卷积层和一个用于生成特征的卷积层。forward 方法中,输入数据经过权重生成和特征生成后,利用 softmax 计算权重并与特征相乘,最后通过重排和卷积操作输出结果。
SE 类实现了 Squeeze-and-Excitation (SE) 模块。它通过全局平均池化和全连接层来计算通道注意力,输出的注意力权重用于增强特征图中的重要通道。
RFCBAMConv 类是一个结合了 SE 模块的卷积层。它首先生成特征,然后计算通道注意力,接着利用最大池化和平均池化来生成感受野注意力,最后将这些注意力应用于生成的特征上,输出经过卷积处理的结果。
最后,RFCAConv 类实现了一个结合了空间和通道注意力的卷积模块。它通过生成特征、池化操作和全连接层来计算注意力权重,并将这些权重应用于生成的特征图,最终通过卷积层输出结果。
整体来看,这个文件中的模块通过引入注意力机制,增强了卷积神经网络在特征提取过程中的表现,适用于各种计算机视觉任务。
10.4 UniRepLKNet.py
以下是代码中最核心的部分,并附上详细的中文注释:
import torch
import torch.nn as nn
import torch.nn.functional as F
class GRNwithNHWC(nn.Module):
“”"
GRN (Global Response Normalization) 层
该层在 ConvNeXt V2 中首次提出,旨在提高模型的性能。
输入假设为 (N, H, W, C) 格式。
“”"
def init(self, dim, use_bias=True):
super().init()
self.use_bias = use_bias
# 初始化可学习参数 gamma 和 beta
self.gamma = nn.Parameter(torch.zeros(1, 1, 1, dim))
if self.use_bias:
self.beta = nn.Parameter(torch.zeros(1, 1, 1, dim))
def forward(self, x):
    # 计算输入的 L2 范数
    Gx = torch.norm(x, p=2, dim=(1, 2), keepdim=True)
    # 归一化
    Nx = Gx / (Gx.mean(dim=-1, keepdim=True) + 1e-6)
    # 应用归一化和可学习参数
    if self.use_bias:
        return (self.gamma * Nx + 1) * x + self.beta
    else:
        return (self.gamma * Nx + 1) * x
class SEBlock(nn.Module):
“”"
Squeeze-and-Excitation Block,提出于 SENet 中
输入假设为 (N, C, H, W) 格式。
“”"
def init(self, input_channels, internal_neurons):
super(SEBlock, self).init()
# 下采样卷积
self.down = nn.Conv2d(in_channels=input_channels, out_channels=internal_neurons,
kernel_size=1, stride=1, bias=True)
# 上采样卷积
self.up = nn.Conv2d(in_channels=internal_neurons, out_channels=input_channels,
kernel_size=1, stride=1, bias=True)
self.input_channels = input_channels
self.nonlinear = nn.ReLU(inplace=True)
def forward(self, inputs):
    # 自适应平均池化
    x = F.adaptive_avg_pool2d(inputs, output_size=(1, 1))
    x = self.down(x)  # 下采样
    x = self.nonlinear(x)  # 激活
    x = self.up(x)  # 上采样
    x = F.sigmoid(x)  # Sigmoid 激活
    return inputs * x.view(-1, self.input_channels, 1, 1)  # 逐通道缩放
class UniRepLKNetBlock(nn.Module):
“”"
UniRepLKNet 的基本构建块
包含卷积、归一化、激活等操作。
“”"
def init(self, dim, kernel_size, drop_path=0., deploy=False, use_sync_bn=False):
super().init()
# 深度卷积
self.dwconv = nn.Conv2d(dim, dim, kernel_size=kernel_size, stride=1, padding=kernel_size // 2,
dilation=1, groups=dim, bias=deploy)
# 归一化层
self.norm = nn.BatchNorm2d(dim) if not deploy else nn.Identity()
# Squeeze-and-Excitation 模块
self.se = SEBlock(dim, dim // 4)
# 前馈网络
self.pwconv1 = nn.Linear(dim, dim * 4)
self.act = nn.GELU()
self.pwconv2 = nn.Linear(dim * 4, dim)
    self.drop_path = nn.Identity() if drop_path <= 0. else nn.Dropout(drop_path)

def forward(self, inputs):
    # 逐层前向传播
    x = self.dwconv(inputs)  # 深度卷积
    x = self.norm(x)  # 归一化
    x = self.se(x)  # Squeeze-and-Excitation
    x = self.pwconv1(x)  # 前馈网络
    x = self.act(x)  # 激活
    x = self.pwconv2(x)  # 输出
    return self.drop_path(x) + inputs  # 残差连接
class UniRepLKNet(nn.Module):
“”"
UniRepLKNet 模型的主类
包含多个 UniRepLKNetBlock 以构建深度网络。
“”"
def init(self, in_chans=3, num_classes=1000, depths=(3, 3, 27, 3), dims=(96, 192, 384, 768)):
super().init()
self.stages = nn.ModuleList()
for i in range(len(depths)):
# 每个阶段添加多个 UniRepLKNetBlock
stage = nn.Sequential(*[UniRepLKNetBlock(dim=dims[i], kernel_size=3) for _ in range(depths[i])])
self.stages.append(stage)
def forward(self, x):
    # 前向传播
    for stage in self.stages:
        x = stage(x)  # 逐阶段前向传播
    return x  # 返回最终输出
实例化模型并进行前向传播
if name == ‘main’:
inputs = torch.randn((1, 3, 640, 640)) # 随机输入
model = UniRepLKNet() # 创建模型实例
res = model(inputs) # 前向传播
print(res.shape) # 输出结果的形状
代码核心部分说明:
GRNwithNHWC: 实现了全局响应归一化层,能够自适应地调整输入特征的分布。
SEBlock: 实现了Squeeze-and-Excitation模块,通过学习通道间的关系来增强特征表示。
UniRepLKNetBlock: 该模块是UniRepLKNet的基本构建块,包含深度卷积、归一化、激活和前馈网络,支持残差连接。
UniRepLKNet: 这是整个模型的主类,负责构建多个阶段,每个阶段由多个UniRepLKNetBlock组成,并在前向传播中逐层处理输入。
通过这些核心部分的组合,UniRepLKNet能够有效地处理各种输入数据并进行特征提取。
这个程序文件实现了一个名为UniRepLKNet的深度学习模型,主要用于音频、视频、点云、时间序列和图像识别。该模型基于多个先进的深度学习架构,包括RepLKNet、ConvNeXt、DINO和DeiT等。文件中包含了多个类和函数,下面是对其主要部分的详细说明。
首先,文件导入了必要的PyTorch库和其他模块,包括用于层的定义、功能激活、权重初始化等。接着,定义了一些辅助类,例如GRNwithNHWC、NCHWtoNHWC和NHWCtoNCHW。这些类用于实现特定的操作,如全局响应归一化(GRN)和数据格式转换。
在模型的核心部分,定义了一个名为get_conv2d的函数,用于根据输入参数选择合适的卷积实现,支持原生卷积和高效的iGEMM大核卷积实现。该函数会根据卷积的参数(如通道数、核大小、步幅等)来决定使用哪种实现。
接下来,定义了SEBlock类,它实现了Squeeze-and-Excitation模块,能够增强模型对重要特征的关注。该模块通过自适应平均池化和全连接层来调整特征通道的权重。
DilatedReparamBlock类是UniRepLKNet的一个重要组成部分,它实现了扩张卷积的重参数化,允许在推理时合并多个卷积分支以提高效率。该类根据不同的核大小和扩张率配置多个卷积层,并在前向传播中进行计算。
UniRepLKNetBlock类则是UniRepLKNet的基本构建块,结合了卷积、归一化、激活函数和Squeeze-and-Excitation模块。它还支持在训练和推理模式之间切换,以优化性能。
UniRepLKNet类是整个模型的主类,接受多个参数来配置模型的输入通道数、类别数、深度、特征维度等。它包含了多个下采样层和主阶段,每个阶段由多个UniRepLKNetBlock组成。模型的前向传播方法根据输出模式(特征或分类结果)来处理输入数据。
此外,文件还提供了一些函数用于加载不同配置的UniRepLKNet模型,例如unireplknet_a、unireplknet_f等,这些函数可以根据需要加载预训练权重。
最后,文件的主程序部分创建了一个随机输入,并实例化了一个UniRepLKNet模型,加载了预训练权重,并进行了一次前向传播。然后,模型切换到推理模式,并再次进行前向传播,最后打印了两次输出的差异。
整体来看,这个程序文件实现了一个灵活且高效的深度学习模型,能够处理多种类型的数据,适用于各种计算机视觉和信号处理任务。
源码文件
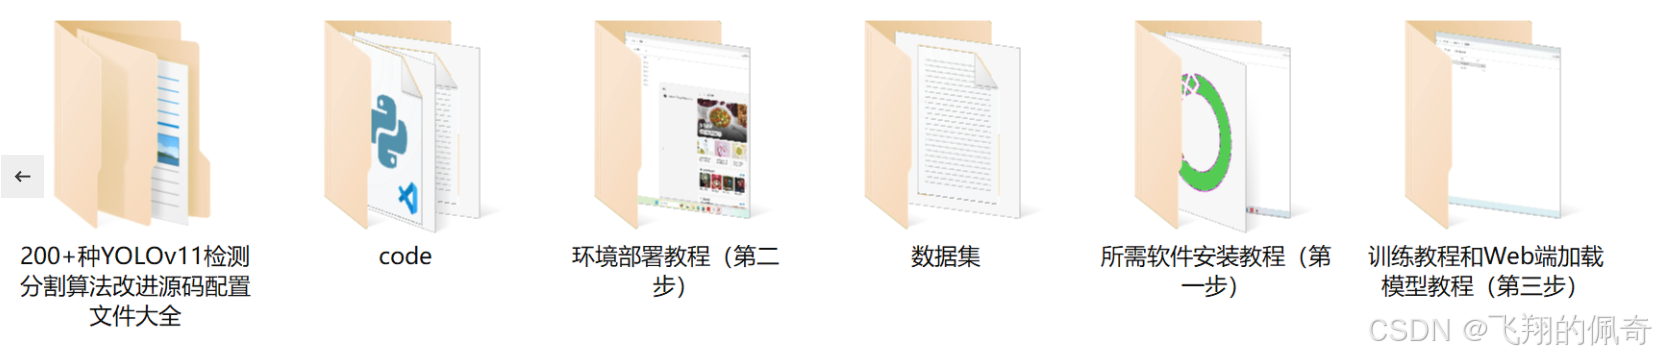
源码获取
欢迎大家点赞、收藏、关注、评论啦 、查看👇🏻获取联系方式👇🏻

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 23
 0
- 0


 已为社区贡献115条内容

所有评论(0)