【完整源码+数据集+部署教程】腐蚀图像分割系统源码&数据集分享 [yolov8-seg-C2f-DySnakeConv&yolov8-seg-LSKNet等50+全套改进创新点发刊_一键训练教程_W
背景意义
随着工业化进程的加快,腐蚀问题已成为制约各类设施安全与耐用性的重要因素。腐蚀不仅影响了设备的使用寿命,还可能导致严重的安全隐患,给经济和社会带来巨大的损失。因此,针对腐蚀的检测与监测显得尤为重要。传统的腐蚀检测方法多依赖人工检查,效率低下且容易受到主观因素的影响。近年来,计算机视觉技术的迅猛发展为腐蚀检测提供了新的解决方案,尤其是深度学习在图像处理领域的应用,极大地提升了图像分析的准确性和效率。
YOLO(You Only Look Once)系列模型因其高效的实时目标检测能力而受到广泛关注。YOLOv8作为该系列的最新版本,进一步提升了模型的精度和速度,适用于多种复杂场景的目标检测与分割任务。然而,针对特定领域如腐蚀图像的分割,现有的YOLOv8模型仍存在一定的局限性,特别是在处理复杂背景和不同腐蚀类型时,模型的表现可能不尽如人意。因此,基于改进YOLOv8的腐蚀图像分割系统的研究具有重要的理论与实际意义。
本研究所使用的数据集“DatasetNew”包含1000幅腐蚀图像,专注于单一类别的腐蚀现象。这一数据集的构建为模型的训练与测试提供了良好的基础,能够有效支持腐蚀图像的实例分割任务。通过对这些图像的深入分析,我们可以提取出腐蚀的特征信息,进而为模型的改进提供数据支持。值得注意的是,数据集的规模虽然相对较小,但其专一性使得模型能够更集中地学习腐蚀特征,从而提升分割精度。
在技术层面,改进YOLOv8的腐蚀图像分割系统不仅能够实现对腐蚀区域的精准识别,还能够在实时监测中发挥重要作用。通过引入先进的图像处理技术和深度学习算法,系统能够自动化地识别和分割腐蚀区域,极大地提高了检测效率和准确性。这一系统的应用前景广泛,涵盖了桥梁、船舶、管道等多个领域,能够为工程维护提供有力支持,降低人工检测的成本和风险。
此外,本研究的意义还在于推动腐蚀检测领域的智能化进程。随着数据驱动技术的不断发展,基于深度学习的图像分割方法将成为未来腐蚀检测的主流趋势。通过对YOLOv8模型的改进与优化,我们不仅可以为腐蚀检测提供新的思路,还能为相关领域的研究提供借鉴和参考。总之,基于改进YOLOv8的腐蚀图像分割系统的研究,既是对现有技术的延续与创新,也是对工业安全与设备维护的重要贡献。
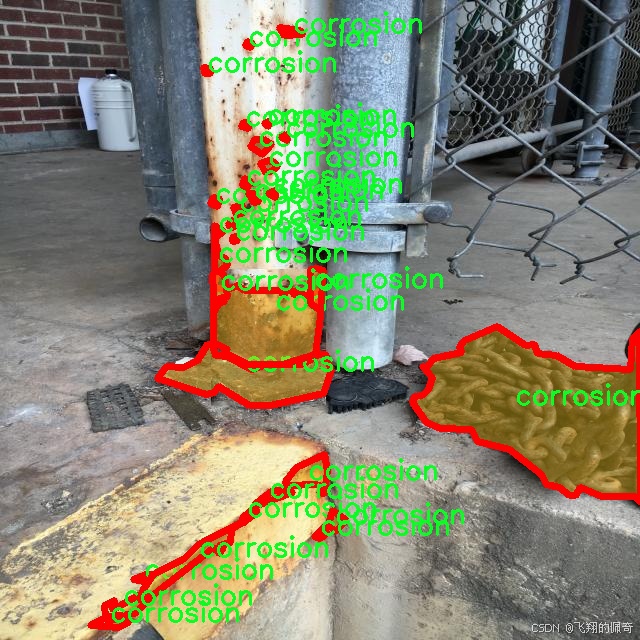
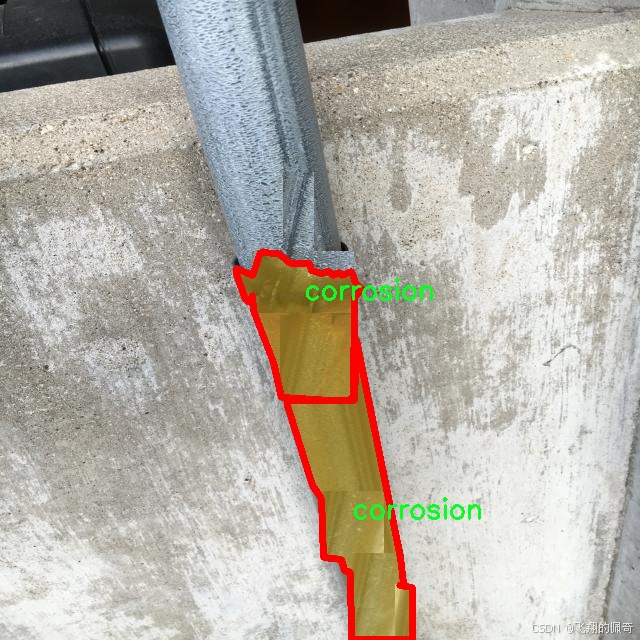
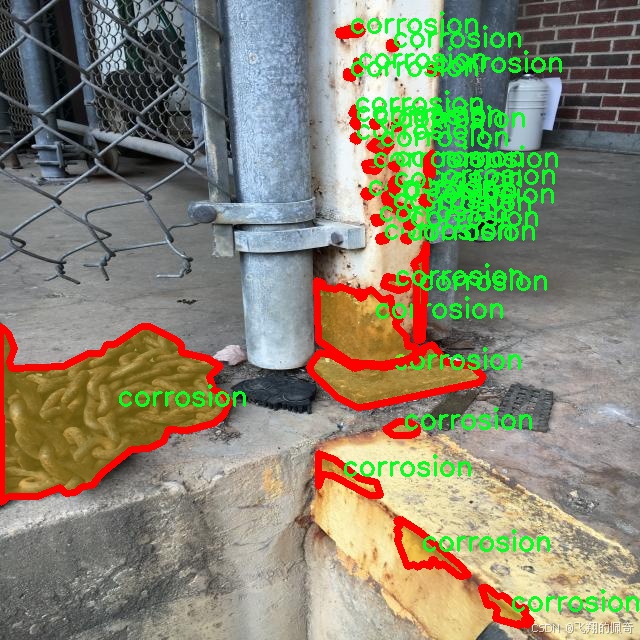
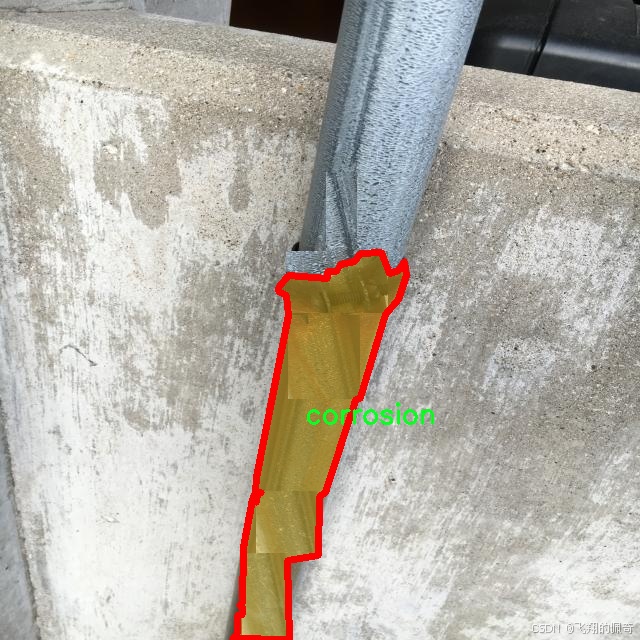
图片效果
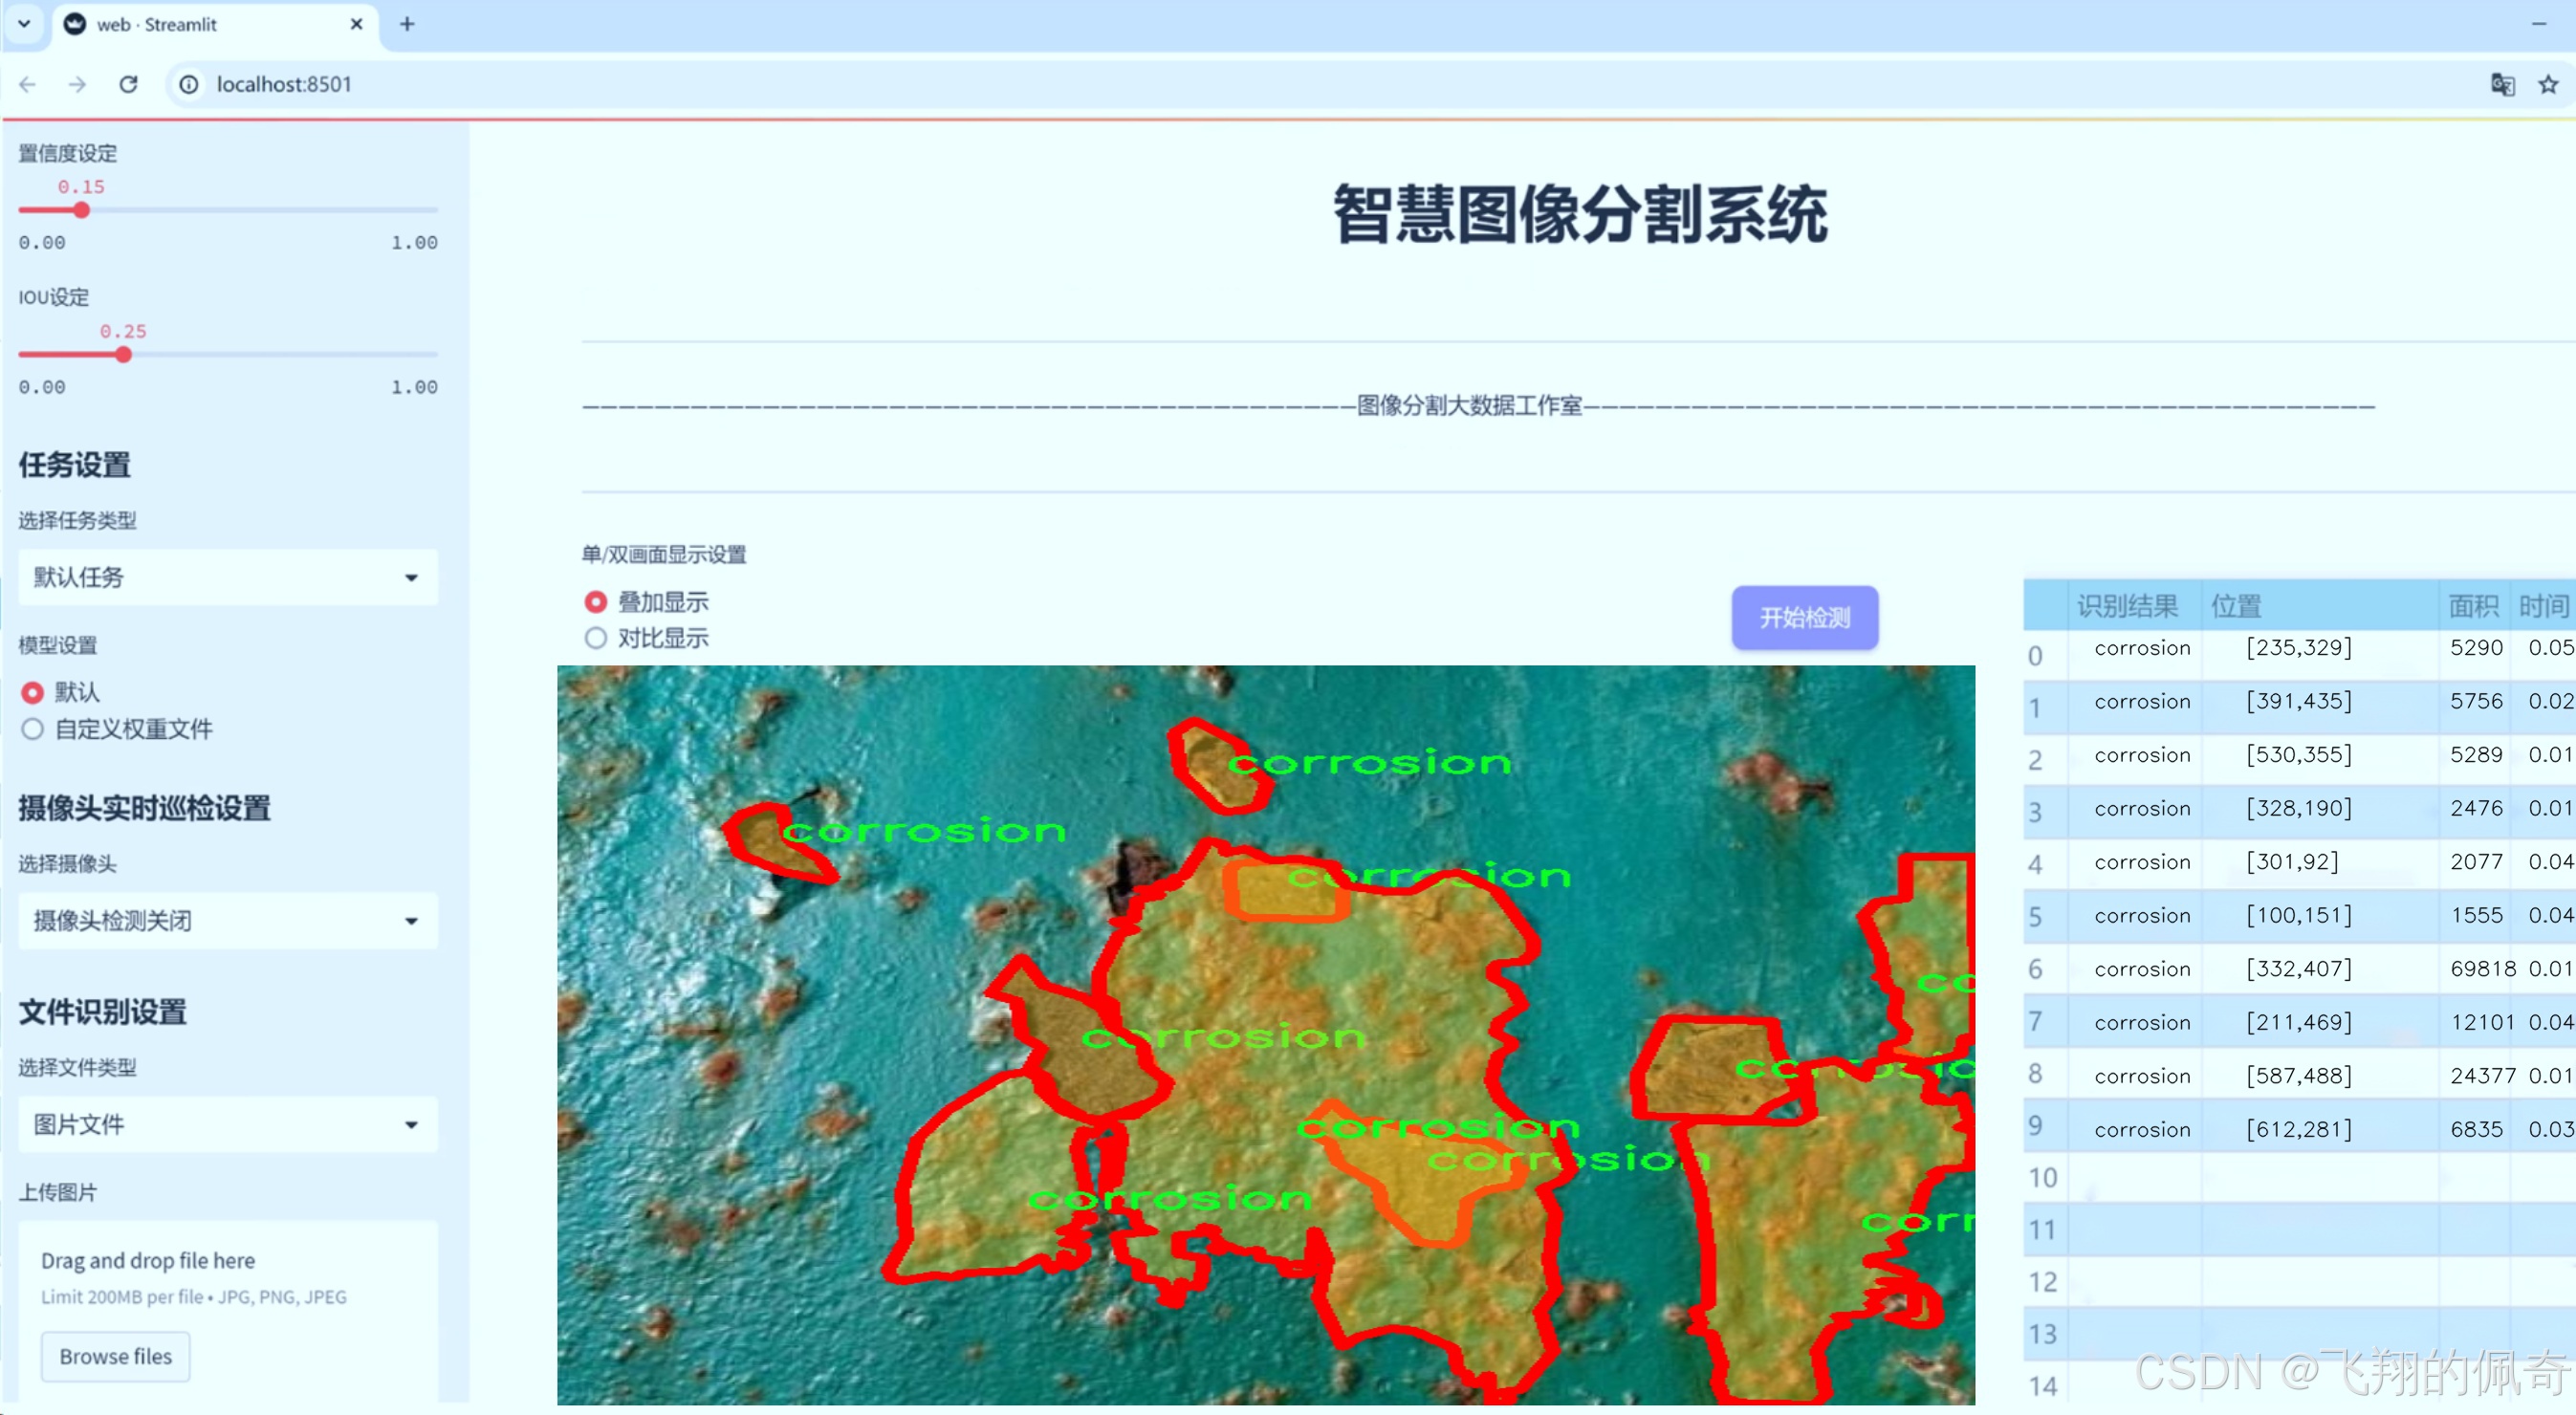
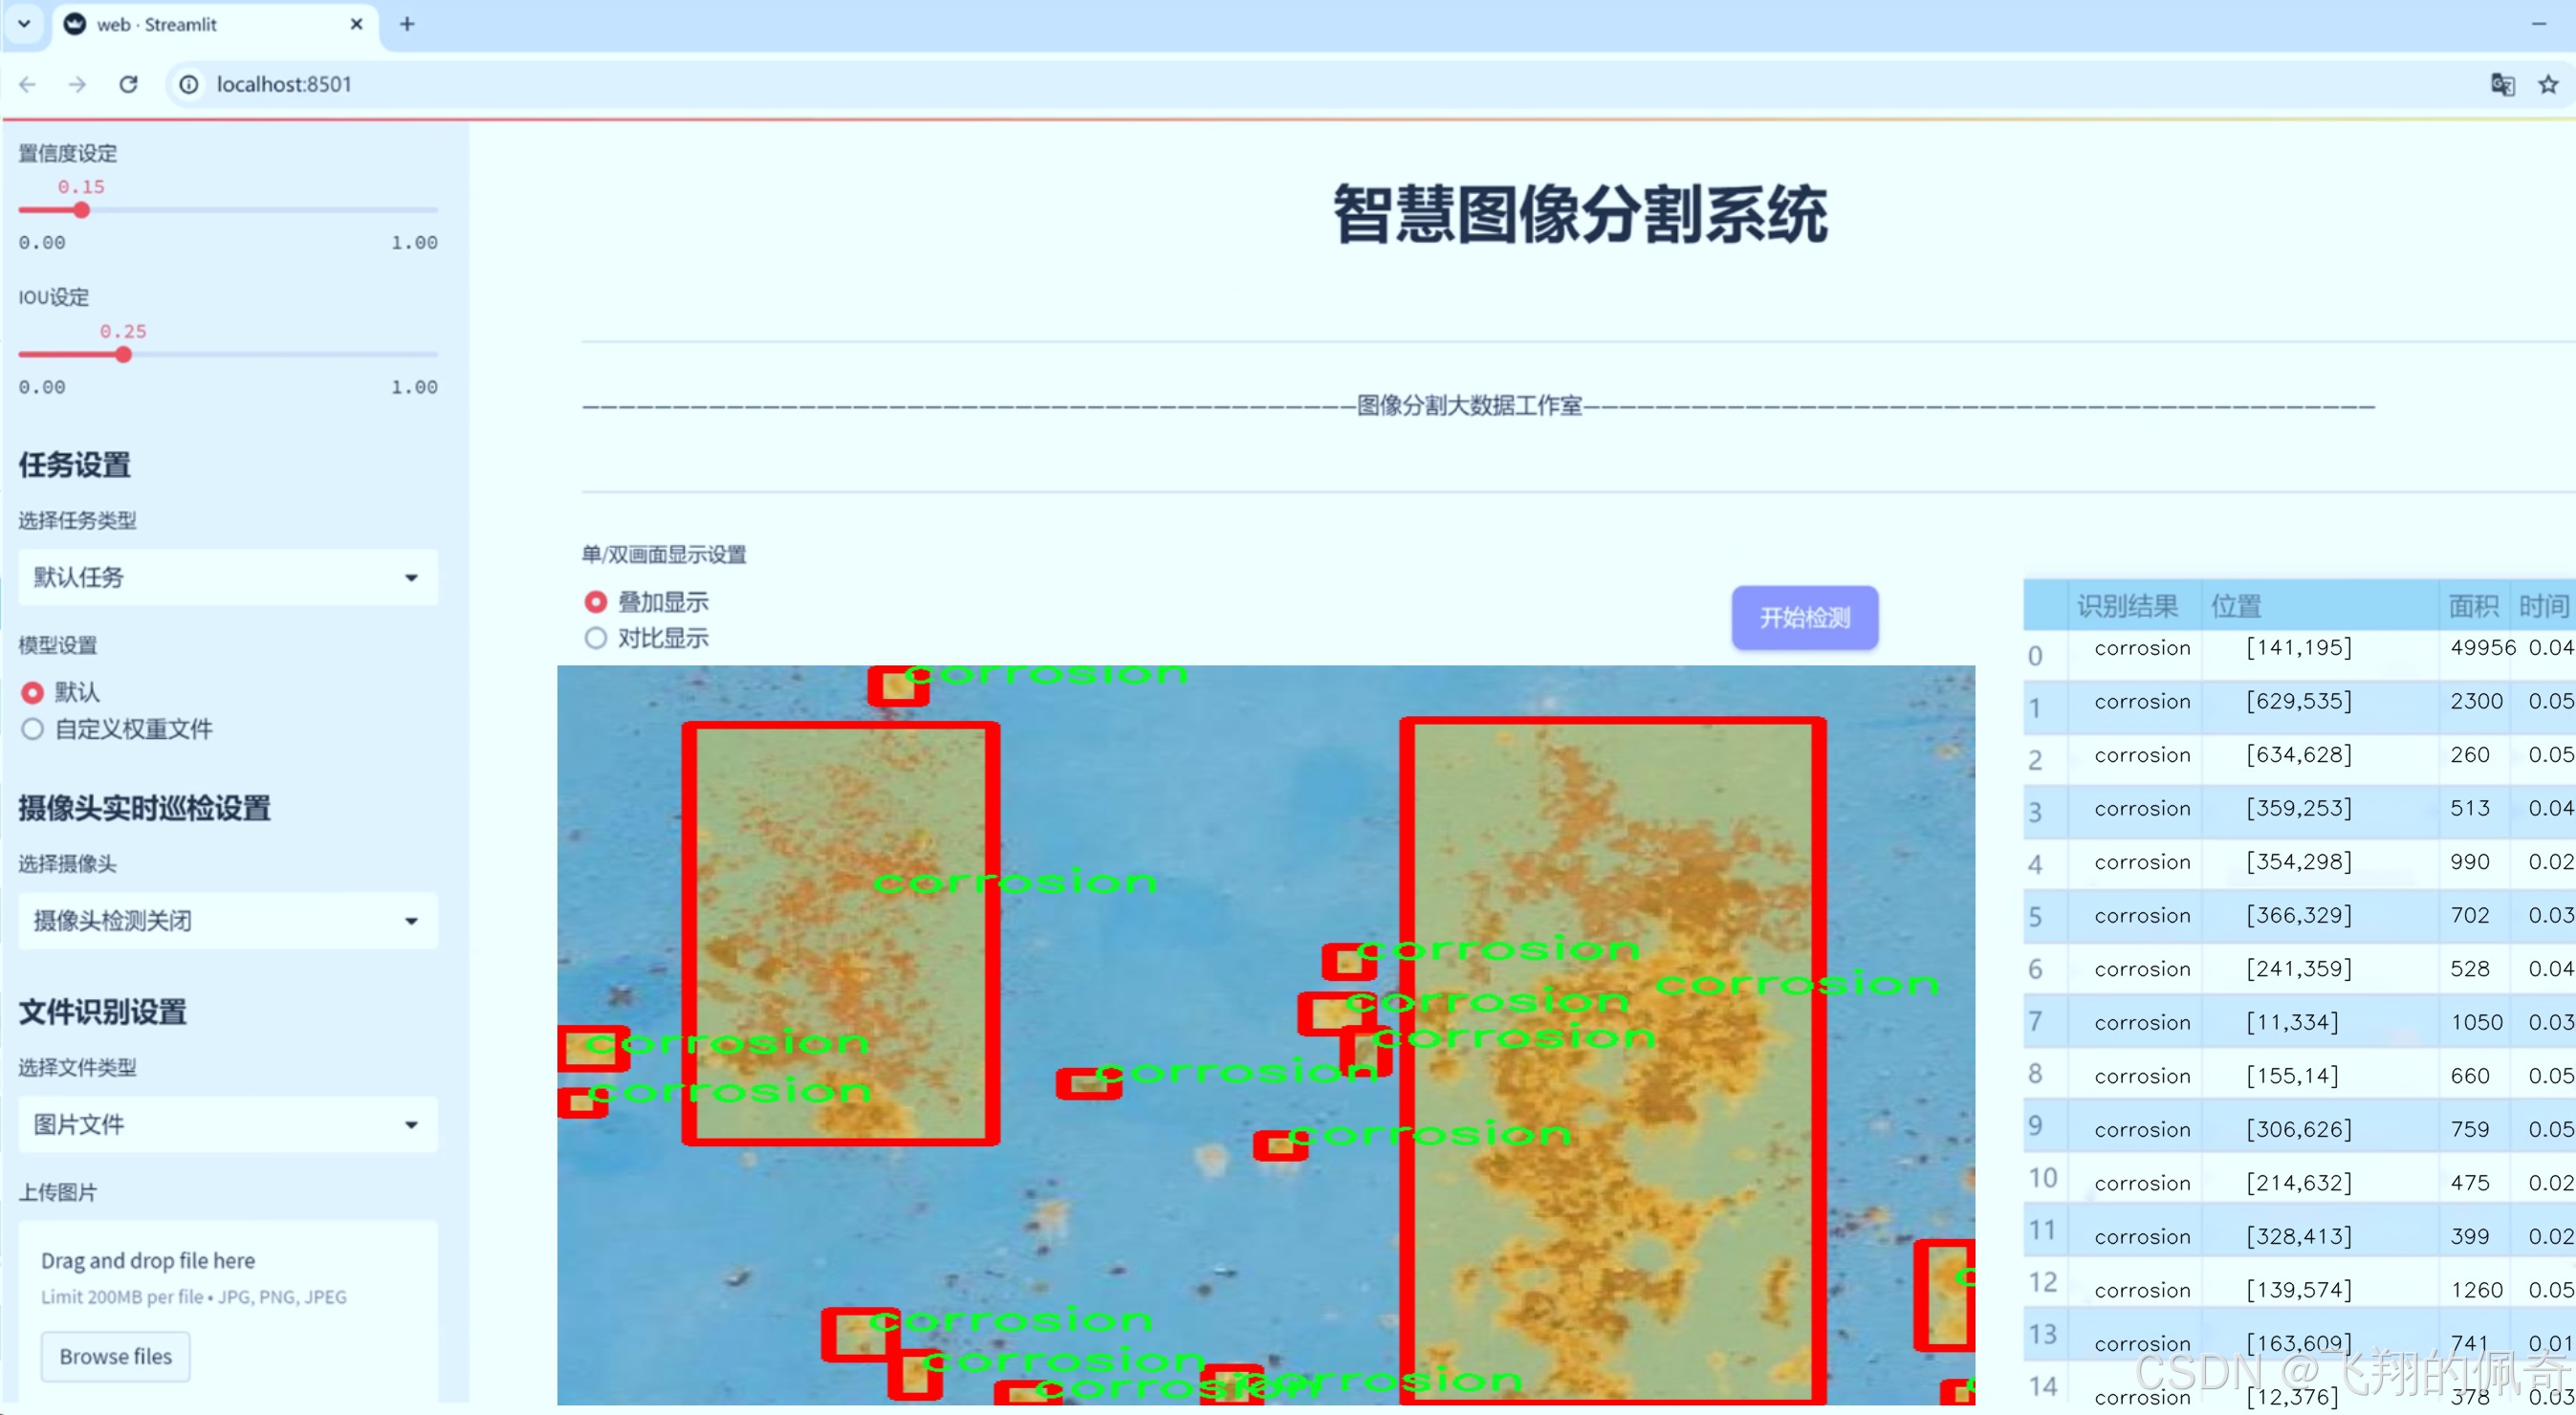
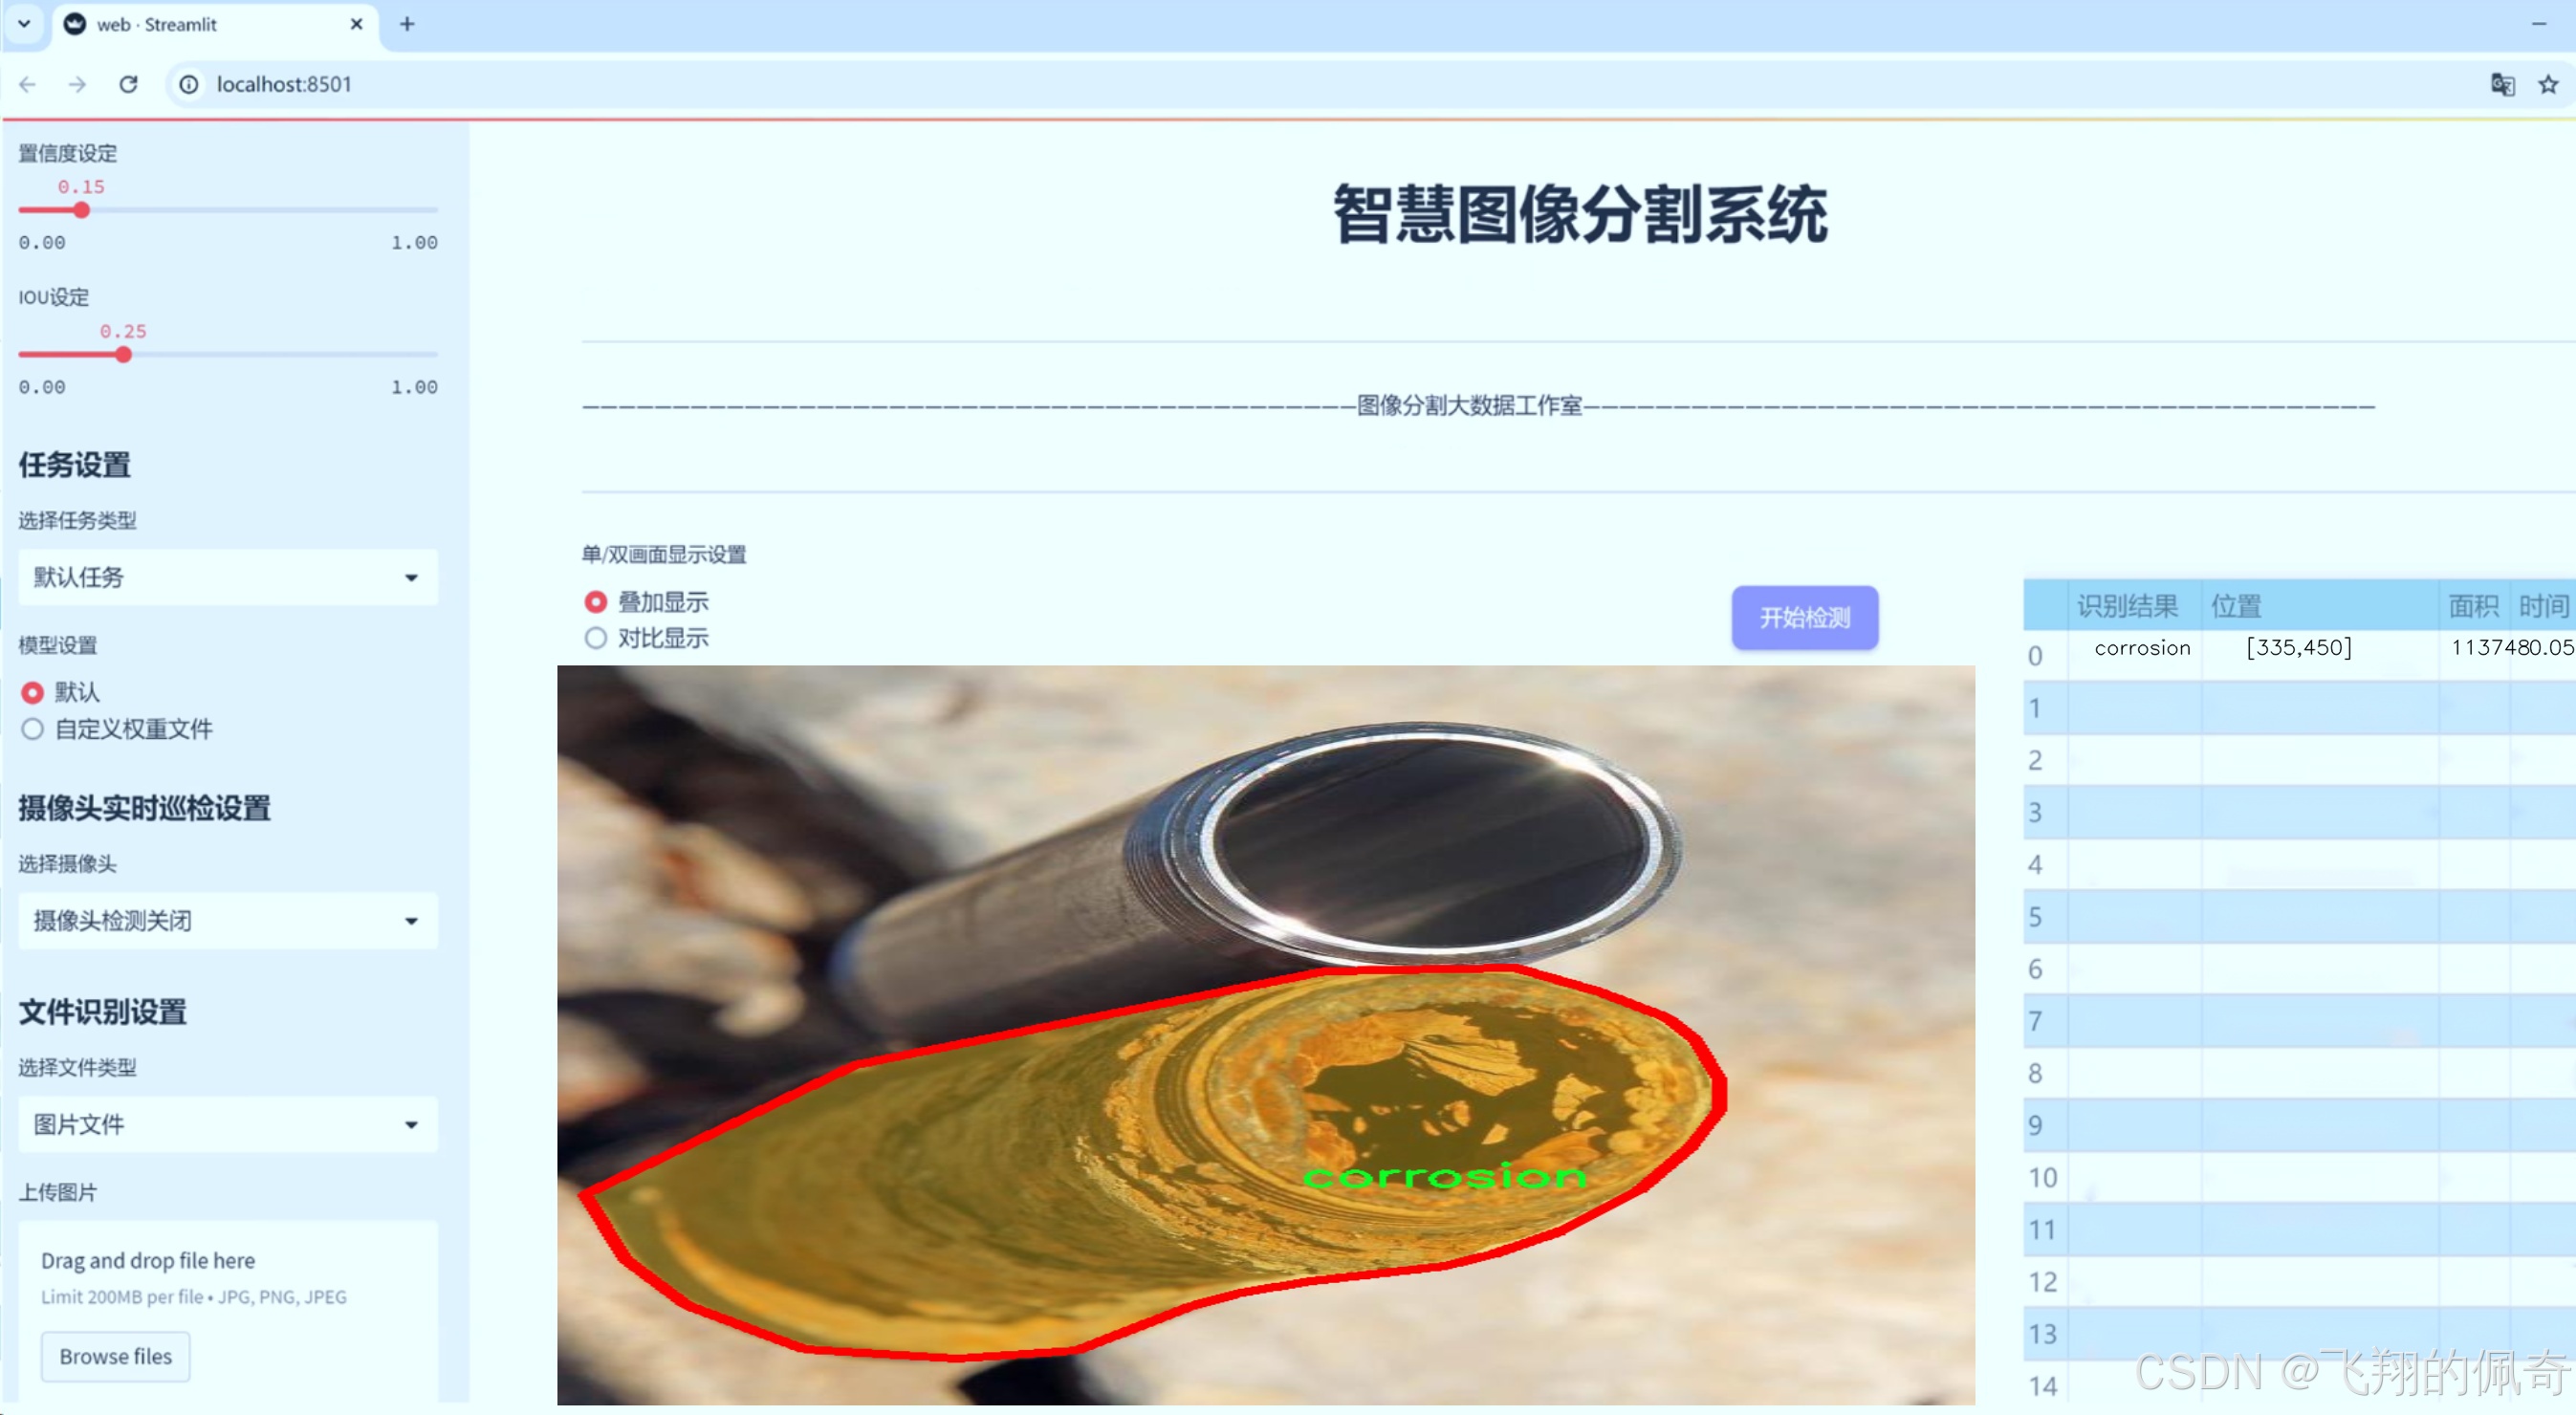
数据集信息
在本研究中,我们采用了名为“DatasetNew”的数据集,以训练和改进YOLOv8-seg模型在腐蚀图像分割任务中的表现。该数据集专门针对腐蚀现象的图像数据进行了精心的收集和标注,旨在为计算机视觉领域的腐蚀检测提供高质量的训练样本。数据集的类别数量为1,唯一的类别名称为“corrosion”,这表明该数据集专注于腐蚀这一特定的图像特征。
“DatasetNew”数据集的构建过程遵循了严格的标准,以确保数据的多样性和代表性。数据集中的图像涵盖了多种不同类型的腐蚀现象,包括但不限于金属表面的锈蚀、混凝土的剥落、涂层的脱落等。这些图像不仅来自于实验室环境的控制拍摄,还包括了实际应用场景中的真实案例,如工业设备、建筑物和基础设施等。这种多样化的图像来源使得模型在训练过程中能够学习到更广泛的腐蚀特征,从而提高其在实际应用中的鲁棒性和准确性。
为了确保数据集的标注质量,所有图像均经过专业人员的仔细审查和标注。每幅图像中腐蚀区域的边界被精确地标记出来,以便于模型能够学习到腐蚀的具体形态和特征。这种精细的标注方式不仅提升了数据集的使用价值,也为后续的模型训练提供了坚实的基础。通过对腐蚀区域的精确分割,YOLOv8-seg模型能够在处理新图像时,快速而准确地识别出腐蚀现象,从而实现高效的图像分割。
在数据集的使用过程中,我们还对图像进行了多种数据增强处理,包括旋转、缩放、翻转和颜色调整等。这些增强技术的应用旨在增加数据集的多样性,帮助模型更好地适应不同的输入条件和环境变化。通过这种方式,我们希望能够提升模型的泛化能力,使其在面对未知数据时依然能够保持较高的分割精度。
“DatasetNew”不仅为YOLOv8-seg模型的训练提供了丰富的图像数据,也为后续的研究和应用奠定了基础。随着腐蚀检测技术的不断发展,该数据集的价值将愈加凸显,成为相关领域研究者和工程师的重要资源。未来,我们期望通过对“DatasetNew”的进一步扩展和优化,能够持续推动腐蚀检测技术的进步,助力于工业安全和基础设施维护的智能化发展。
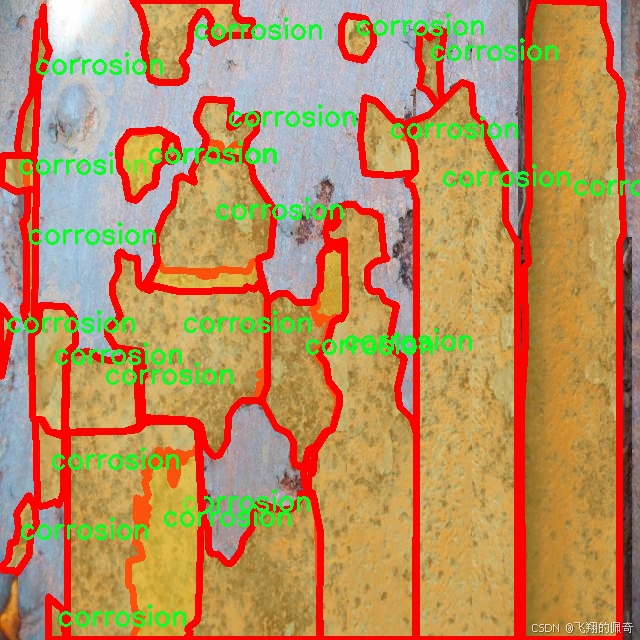
核心代码
```python
import torch
import torch.nn as nn
import torch.nn.functional as F
from timm.layers import weight_init

# 定义激活函数类,继承自ReLU
class Activation(nn.ReLU):
    def __init__(self, dim, act_num=3, deploy=False):
        super(Activation, self).__init__()
        self.deploy = deploy  # 是否为部署模式
        # 初始化权重和偏置
        self.weight = torch.nn.Parameter(torch.randn(dim, 1, act_num * 2 + 1, act_num * 2 + 1))
        self.bias = None
        self.bn = nn.BatchNorm2d(dim, eps=1e-6)  # 批归一化
        self.dim = dim
        self.act_num = act_num
        weight_init.trunc_normal_(self.weight, std=.02)  # 权重初始化

    def forward(self, x):
        # 前向传播
        if self.deploy:
            return F.conv2d(
                super(Activation, self).forward(x),
                self.weight, self.bias, padding=(self.act_num * 2 + 1) // 2, groups=self.dim)
        else:
            return self.bn(F.conv2d(
                super(Activation, self).forward(x),
                self.weight, padding=self.act_num, groups=self.dim))

    def switch_to_deploy(self):
        # 切换到部署模式,融合BN层
        if not self.deploy:
            kernel, bias = self._fuse_bn_tensor(self.weight, self.bn)
            self.weight.data = kernel
            self.bias = torch.nn.Parameter(torch.zeros(self.dim))
            self.bias.data = bias
            self.__delattr__('bn')  # 删除BN层
            self.deploy = True

    def _fuse_bn_tensor(self, weight, bn):
        # 融合卷积层和BN层的权重
        kernel = weight
        running_mean = bn.running_mean
        running_var = bn.running_var
        gamma = bn.weight
        beta = bn.bias
        eps = bn.eps
        std = (running_var + eps).sqrt()
        t = (gamma / std).reshape(-1, 1, 1, 1)
        return kernel * t, beta + (0 - running_mean) * gamma / std

# 定义基本块
class Block(nn.Module):
    def __init__(self, dim, dim_out, act_num=3, stride=2, deploy=False):
        super().__init__()
        self.deploy = deploy
        # 根据是否部署选择不同的卷积层
        if self.deploy:
            self.conv = nn.Conv2d(dim, dim_out, kernel_size=1)
        else:
            self.conv1 = nn.Sequential(
                nn.Conv2d(dim, dim, kernel_size=1),
                nn.BatchNorm2d(dim, eps=1e-6),
            )
            self.conv2 = nn.Sequential(
                nn.Conv2d(dim, dim_out, kernel_size=1),
                nn.BatchNorm2d(dim_out, eps=1e-6)
            )
        # 池化层
        self.pool = nn.MaxPool2d(stride) if stride != 1 else nn.Identity()
        self.act = Activation(dim_out, act_num)  # 激活函数

    def forward(self, x):
        # 前向传播
        if self.deploy:
            x = self.conv(x)
        else:
            x = self.conv1(x)
            x = F.leaky_relu(x, negative_slope=1)  # 使用Leaky ReLU
            x = self.conv2(x)

        x = self.pool(x)  # 池化
        x = self.act(x)   # 激活
        return x

    def switch_to_deploy(self):
        # 切换到部署模式,融合卷积和BN层
        if not self.deploy:
            kernel, bias = self._fuse_bn_tensor(self.conv1[0], self.conv1[1])
            self.conv = self.conv2[0]
            self.conv.weight.data = kernel
            self.conv.bias.data = bias
            self.__delattr__('conv1')
            self.__delattr__('conv2')
            self.act.switch_to_deploy()
            self.deploy = True

# 定义VanillaNet模型
class VanillaNet(nn.Module):
    def __init__(self, in_chans=3, num_classes=1000, dims=[96, 192, 384, 768],
                 drop_rate=0, act_num=3, strides=[2, 2, 2, 1], deploy=False):
        super().__init__()
        self.deploy = deploy
        # 初始化stem部分
        if self.deploy:
            self.stem = nn.Sequential(
                nn.Conv2d(in_chans, dims[0], kernel_size=4, stride=4),
                Activation(dims[0], act_num)
            )
        else:
            self.stem1 = nn.Sequential(
                nn.Conv2d(in_chans, dims[0], kernel_size=4, stride=4),
                nn.BatchNorm2d(dims[0], eps=1e-6),
            )
            self.stem2 = nn.Sequential(
                nn.Conv2d(dims[0], dims[0], kernel_size=1, stride=1),
                nn.BatchNorm2d(dims[0], eps=1e-6),
                Activation(dims[0], act_num)
            )

        self.stages = nn.ModuleList()
        for i in range(len(strides)):
            stage = Block(dim=dims[i], dim_out=dims[i + 1], act_num=act_num, stride=strides[i], deploy=deploy)
            self.stages.append(stage)

    def forward(self, x):
        # 前向传播
        if self.deploy:
            x = self.stem(x)
        else:
            x = self.stem1(x)
            x = F.leaky_relu(x, negative_slope=1)
            x = self.stem2(x)

        for stage in self.stages:
            x = stage(x)  # 通过每个Block
        return x

    def switch_to_deploy(self):
        # 切换到部署模式
        if not self.deploy:
            self.stem2[2].switch_to_deploy()
            self.deploy = True

# 更新模型权重
def update_weight(model_dict, weight_dict):
    idx, temp_dict = 0, {}
    for k, v in weight_dict.items():
        if k in model_dict.keys() and np.shape(model_dict[k]) == np.shape(v):
            temp_dict[k] = v
            idx += 1
    model_dict.update(temp_dict)
    print(f'loading weights... {idx}/{len(model_dict)} items')
    return model_dict

# 创建不同版本的VanillaNet模型
def vanillanet_5(pretrained='', **kwargs):
    model = VanillaNet(dims=[128 * 4, 256 * 4, 512 * 4, 1024 * 4], strides=[2, 2, 2], **kwargs)
    if pretrained:
        weights = torch.load(pretrained)['model_ema']
        model.load_state_dict(update_weight(model.state_dict(), weights))
    return model

# 其他版本的创建函数类似...

if __name__ == '__main__':
    inputs = torch.randn((1, 3, 640, 640))  # 输入数据
    model = vanillanet_10()  # 创建模型
    pred = model(inputs)  # 进行预测
    for i in pred:
        print(i.size())  # 输出每层的尺寸
代码核心部分分析:
- Activation类:自定义的激活函数类,包含了卷积和批归一化的融合逻辑。
- Block类:表示网络中的基本块,包含卷积层、池化层和激活函数的组合。
- VanillaNet类:整个网络的结构,包含stem部分和多个Block的组合。
- 权重更新函数:用于加载预训练模型的权重。
- 模型创建函数:用于创建不同配置的VanillaNet模型。
主要功能:
- 该代码实现了一个卷积神经网络(VanillaNet),支持动态切换到部署模式,优化了推理速度。
- 通过自定义的激活函数和基本块结构,提高了模型的灵活性和可扩展性。```
这个文件是一个深度学习模型的实现,名为VanillaNet,它主要用于图像处理任务,如图像分类。文件中包含了模型的定义、不同版本的模型构建函数以及一些辅助函数。
首先,文件的开头包含版权信息和许可证声明,说明该程序是开源的,可以在MIT许可证下进行修改和分发。
接下来,文件导入了必要的库,包括 PyTorch 及其神经网络模块、功能模块,以及一些用于权重初始化的工具和 NumPy。__all__ 列表定义了该模块中可以被外部访问的对象。
activation 类是一个自定义的激活函数类,继承自 nn.ReLU。它在初始化时创建了一个可学习的权重和偏置,并使用批量归一化来提高模型的稳定性。forward 方法定义了前向传播的过程,支持两种模式:部署模式和训练模式。在部署模式下,激活函数的输出会经过卷积操作,而在训练模式下,则会进行批量归一化。
Block 类是模型的基本构建块,包含两个卷积层和一个激活函数。它的构造函数允许选择是否使用自适应池化。forward 方法定义了输入数据如何通过这个块进行处理。
VanillaNet 类是整个网络的主体,包含多个 Block 组成的阶段。它的构造函数接受输入通道数、类别数、每个阶段的通道数、丢弃率、激活函数数量、步幅等参数。根据这些参数,构建了一个多阶段的网络结构。forward 方法实现了输入数据的前向传播,并在不同的尺度上提取特征。
文件中还定义了一些函数,如 update_weight,用于更新模型的权重。vanillanet_5 到 vanillanet_13_x1_5_ada_pool 函数则是不同版本的 VanillaNet 模型构建函数,可以根据需要创建不同结构的模型,并可选择加载预训练权重。
最后,在文件的主程序部分,创建了一个随机输入并实例化了 vanillanet_10 模型,进行了一次前向传播,输出每个特征图的尺寸。
整体来看,这个文件实现了一个灵活且可扩展的深度学习模型,适用于各种图像处理任务,并且提供了多种模型变体以满足不同的需求。
```python
# 导入必要的模块
from ultralytics.models.yolo.segment import SegmentationValidator
from ultralytics.utils.metrics import SegmentMetrics

class FastSAMValidator(SegmentationValidator):
    """
    自定义验证类,用于在Ultralytics YOLO框架中进行快速SAM(Segment Anything Model)分割。

    该类扩展了SegmentationValidator类,专门定制了快速SAM的验证过程。它将任务设置为'segment',
    并使用SegmentMetrics进行评估。此外,为了避免在验证过程中出现错误,禁用了绘图功能。
    """

    def __init__(self, dataloader=None, save_dir=None, pbar=None, args=None, _callbacks=None):
        """
        初始化FastSAMValidator类,将任务设置为'segment',并将指标设置为SegmentMetrics。

        参数:
            dataloader (torch.utils.data.DataLoader): 用于验证的数据加载器。
            save_dir (Path, optional): 保存结果的目录。
            pbar (tqdm.tqdm): 用于显示进度的进度条。
            args (SimpleNamespace): 验证器的配置。
            _callbacks (dict): 存储各种回调函数的字典。

        注意:
            在此类中禁用了ConfusionMatrix和其他相关指标的绘图,以避免错误。
        """
        # 调用父类的初始化方法
        super().__init__(dataloader, save_dir, pbar, args, _callbacks)

        # 设置任务类型为'segment'
        self.args.task = 'segment'

        # 禁用绘图功能,以避免在验证过程中出现错误
        self.args.plots = False

        # 初始化指标为SegmentMetrics,保存结果的目录为save_dir
        self.metrics = SegmentMetrics(save_dir=self.save_dir, on_plot=self.on_plot)
代码核心部分解释:
- 类定义:
FastSAMValidator类继承自SegmentationValidator,用于快速SAM的分割验证。 - 初始化方法:在初始化时,设置任务类型为分割,并禁用绘图功能以避免错误,同时初始化评估指标为
SegmentMetrics。```
这个程序文件是一个自定义的验证类,名为FastSAMValidator,它继承自SegmentationValidator,主要用于在 Ultralytics YOLO 框架中进行快速分割模型(Segment Anything Model,简称 SAM)的验证。该类的设计目的是针对快速 SAM 的特定需求定制验证过程。
在类的文档字符串中,首先说明了这个类的功能和目的。它将任务设置为“分割”,并使用 SegmentMetrics 进行评估。此外,为了避免在验证过程中出现错误,类中禁用了绘图功能。
类的构造函数 __init__ 接受多个参数,包括数据加载器、结果保存目录、进度条对象、配置参数以及回调函数的字典。构造函数首先调用父类的构造函数来初始化继承的属性,然后将任务类型设置为“segment”,并禁用绘图功能。最后,它还初始化了 SegmentMetrics,用于后续的性能评估。
总体来说,这个类为快速 SAM 模型的验证提供了一个专门的实现,确保在验证过程中能够有效地评估模型性能,同时避免因绘图功能导致的潜在错误。
```python
# 导入模块
from .afpn import *  # 导入自适应特征金字塔网络(AFPN)相关的功能
from .attention import *  # 导入注意力机制相关的功能
from .block import *  # 导入基础网络块的定义
from .head import *  # 导入网络头部的定义,通常用于分类或回归任务
from .rep_block import *  # 导入重复使用的网络块
from .kernel_warehouse import *  # 导入卷积核仓库的相关功能
from .dynamic_snake_conv import *  # 导入动态蛇形卷积的实现
from .orepa import *  # 导入OREPA(可能是某种特定的网络结构或方法)
from .RFAConv import *  # 导入RFA卷积(可能是某种特定的卷积方法)

# 以上代码通过相对导入的方式,将当前包中的多个模块导入到当前命名空间中。
# 这些模块可能包含网络结构、层、操作等,用于构建深度学习模型。
在这个代码片段中,所有的导入语句都是为了引入不同的模块和功能,这些模块可能是构建深度学习模型所需的各种组件。```
这个程序文件 __init__.py 位于 ultralytics\nn\extra_modules 目录下,其主要功能是将该目录下的一些模块导入到包中。通过使用 from .module_name import * 的语法,文件将多个模块的内容暴露给外部,方便用户在使用这个包时可以直接访问这些模块中的类、函数或变量。
具体来说,这个文件导入了以下模块:
afpn:可能是实现了一种特定的特征金字塔网络(FPN)结构,用于增强图像特征的提取。attention:通常与注意力机制相关,可能用于提高模型在处理信息时的重点关注能力。block:可能定义了一些基本的构建块,用于构建更复杂的神经网络结构。head:通常指的是网络的输出部分,可能包含分类或回归的逻辑。rep_block:可能是指重复使用的网络块,通常用于构建深层网络。kernel_warehouse:可能与卷积核的管理或生成有关。dynamic_snake_conv:可能实现了一种动态的卷积操作,可能用于提高卷积神经网络的灵活性。orepa:具体功能不明,可能是某种特定的网络结构或算法。RFAConv:可能与某种特定的卷积操作或结构相关,RFA可能代表某种特定的算法或方法。
通过这个 __init__.py 文件,用户在导入 extra_modules 包时,可以直接使用这些模块中的功能,而无需单独导入每一个模块。这种设计提高了代码的可读性和可维护性,方便用户使用。
```python
import torch

def is_box_near_crop_edge(boxes: torch.Tensor,
                          crop_box: List[int],
                          orig_box: List[int],
                          atol: float = 20.0) -> torch.Tensor:
    """
    判断给定的边界框是否接近裁剪边缘。

    参数:
    - boxes: 需要检查的边界框,格式为 (N, 4),其中 N 是边界框的数量,4 表示 (x1, y1, x2, y2)。
    - crop_box: 当前裁剪框的坐标 [x0, y0, x1, y1]。
    - orig_box: 原始图像的边界框坐标 [x0, y0, x1, y1]。
    - atol: 允许的绝对误差,默认为 20.0。

    返回:
    - 返回一个布尔张量,指示每个边界框是否接近裁剪边缘。
    """
    # 将裁剪框和原始框转换为张量
    crop_box_torch = torch.as_tensor(crop_box, dtype=torch.float, device=boxes.device)
    orig_box_torch = torch.as_tensor(orig_box, dtype=torch.float, device=boxes.device)

    # 将边界框从裁剪坐标系转换回原始坐标系
    boxes = uncrop_boxes_xyxy(boxes, crop_box).float()

    # 检查边界框是否接近裁剪框的边缘
    near_crop_edge = torch.isclose(boxes, crop_box_torch[None, :], atol=atol, rtol=0)
    # 检查边界框是否接近原始图像的边缘
    near_image_edge = torch.isclose(boxes, orig_box_torch[None, :], atol=atol, rtol=0)

    # 只有当边界框接近裁剪边缘且不接近原始图像边缘时,才返回 True
    near_crop_edge = torch.logical_and(near_crop_edge, ~near_image_edge)

    # 返回是否有任何边界框接近裁剪边缘
    return torch.any(near_crop_edge, dim=1)


def uncrop_boxes_xyxy(boxes: torch.Tensor, crop_box: List[int]) -> torch.Tensor:
    """
    将边界框从裁剪坐标系转换回原始坐标系。

    参数:
    - boxes: 需要转换的边界框,格式为 (N, 4)。
    - crop_box: 当前裁剪框的坐标 [x0, y0, x1, y1]。

    返回:
    - 返回转换后的边界框,格式为 (N, 4)。
    """
    x0, y0, _, _ = crop_box
    # 创建偏移量张量
    offset = torch.tensor([[x0, y0, x0, y0]], device=boxes.device)

    # 检查 boxes 是否有通道维度
    if len(boxes.shape) == 3:
        offset = offset.unsqueeze(1)

    # 返回加上偏移量后的边界框
    return boxes + offset


def batched_mask_to_box(masks: torch.Tensor) -> torch.Tensor:
    """
    计算掩膜周围的边界框,格式为 XYXY。

    参数:
    - masks: 输入掩膜,格式为 C1xC2x...xHxW。

    返回:
    - 返回边界框,格式为 C1xC2x...x4。
    """
    # 如果掩膜为空,返回 [0, 0, 0, 0]
    if torch.numel(masks) == 0:
        return torch.zeros(*masks.shape[:-2], 4, device=masks.device)

    # 将掩膜形状规范化为 CxHxW
    shape = masks.shape
    h, w = shape[-2:]
    masks = masks.flatten(0, -3) if len(shape) > 2 else masks.unsqueeze(0)

    # 获取边界框的上下边缘
    in_height, _ = torch.max(masks, dim=-1)
    in_height_coords = in_height * torch.arange(h, device=in_height.device)[None, :]
    bottom_edges, _ = torch.max(in_height_coords, dim=-1)
    in_height_coords = in_height_coords + h * (~in_height)
    top_edges, _ = torch.min(in_height_coords, dim=-1)

    # 获取边界框的左右边缘
    in_width, _ = torch.max(masks, dim=-2)
    in_width_coords = in_width * torch.arange(w, device=in_width.device)[None, :]
    right_edges, _ = torch.max(in_width_coords, dim=-1)
    in_width_coords = in_width_coords + w * (~in_width)
    left_edges, _ = torch.min(in_width_coords, dim=-1)

    # 如果掩膜为空,右边缘会在左边缘的左侧,替换这些边界框为 [0, 0, 0, 0]
    empty_filter = (right_edges < left_edges) | (bottom_edges < top_edges)
    out = torch.stack([left_edges, top_edges, right_edges, bottom_edges], dim=-1)
    out = out * (~empty_filter).unsqueeze(-1)

    # 返回到原始形状
    return out.reshape(*shape[:-2], 4) if len(shape) > 2 else out[0]
代码核心部分说明:
is_box_near_crop_edge: 该函数用于判断给定的边界框是否接近裁剪区域的边缘,返回一个布尔张量,指示哪些边界框接近裁剪边缘。uncrop_boxes_xyxy: 该函数将裁剪坐标系中的边界框转换回原始图像坐标系,适用于后续的处理。batched_mask_to_box: 该函数根据给定的掩膜计算其边界框,返回边界框的坐标,适用于目标检测等任务。```
这个程序文件amg.py是一个与图像处理和计算机视觉相关的模块,主要用于处理与图像分割和边界框(bounding box)相关的操作。以下是对文件中各个部分的详细说明。
首先,文件导入了一些必要的库,包括数学库、迭代工具、类型提示、NumPy 和 PyTorch。PyTorch 是一个流行的深度学习框架,提供了对张量操作的支持。
文件中定义了多个函数,每个函数的功能各不相同:
-
is_box_near_crop_edge:该函数用于判断给定的边界框是否接近裁剪边缘。它接收边界框、裁剪框和原始框的坐标,并通过比较它们的距离来返回一个布尔张量,指示哪些边界框接近裁剪边缘。
-
batch_iterator:这个生成器函数用于从输入参数中生成批次数据。它确保所有输入参数的长度相同,并根据指定的批次大小将数据分成多个批次进行迭代。
-
calculate_stability_score:该函数计算一组掩膜的稳定性得分。稳定性得分是通过对预测掩膜的二值化掩膜进行交并比(IoU)计算得出的,反映了掩膜在不同阈值下的一致性。
-
build_point_grid:生成一个二维网格,网格中的点均匀分布在 [0,1] x [0,1] 的范围内,适用于图像处理中的采样或特征点生成。
-
build_all_layer_point_grids:为所有裁剪层生成点网格,考虑到不同层的缩放比例。
-
generate_crop_boxes:根据输入图像的大小、层数和重叠比例生成不同大小的裁剪框。每一层的裁剪框数量与层数相关,并考虑重叠区域。
-
uncrop_boxes_xyxy:该函数用于将裁剪框的坐标转换为原始图像坐标,通过添加裁剪框的偏移量来实现。
-
uncrop_points:类似于
uncrop_boxes_xyxy,但用于处理点的坐标,将其从裁剪坐标转换为原始图像坐标。 -
uncrop_masks:该函数用于将掩膜从裁剪区域扩展到原始图像大小,通过填充来实现。
-
remove_small_regions:用于去除掩膜中小的、不连通的区域或孔洞。该函数利用 OpenCV 的连通组件分析功能,能够根据给定的面积阈值进行处理。
-
batched_mask_to_box:计算掩膜周围的边界框,返回的格式为 XYXY。该函数处理掩膜为空的情况,并返回相应的边界框。
整个模块的设计旨在为图像分割任务提供支持,尤其是在处理裁剪和掩膜时,能够有效地进行边界框的生成和调整。通过这些函数,用户可以在图像处理过程中进行灵活的操作,以满足不同的需求。
源码文件
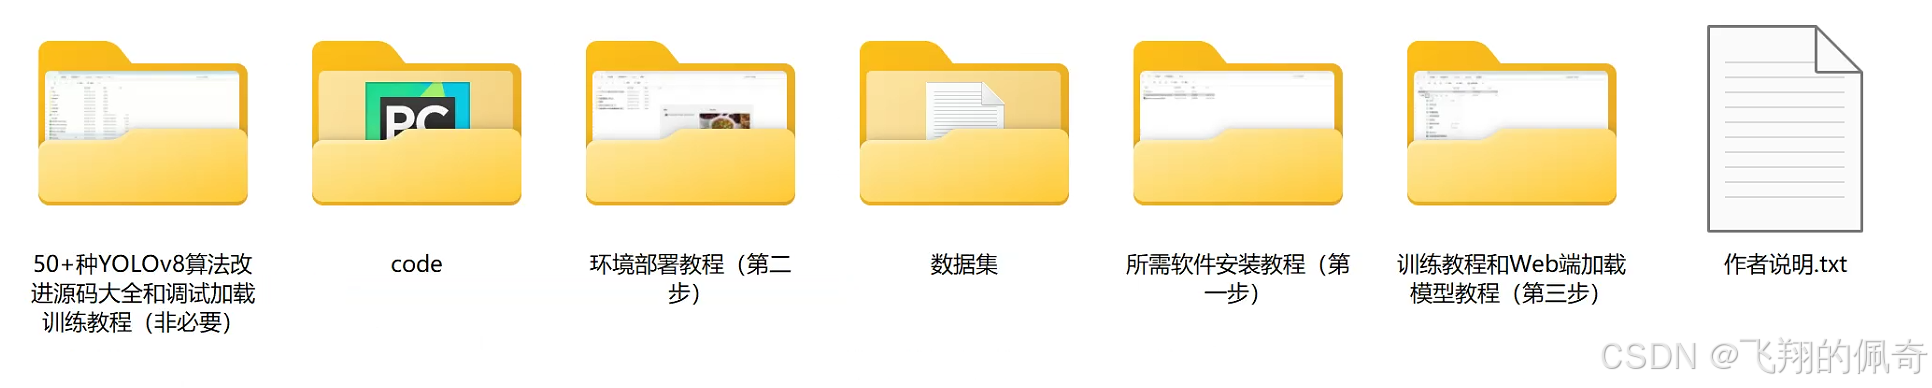
源码获取
欢迎大家点赞、收藏、关注、评论啦 、查看👇🏻获取联系方式👇🏻

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 19
 0
- 0


 已为社区贡献115条内容

所有评论(0)