【完整源码+数据集+部署教程】 日常物品图像分割系统源码&数据集分享 [yolov8-seg-C2f-ContextGuided等50+全套改进创新点发刊_一键训练教程_Web前端展示]
背景意义
随着人工智能技术的迅猛发展,计算机视觉领域在物体检测与图像分割方面取得了显著进展。尤其是深度学习算法的引入,使得图像分割的精度和效率得到了极大的提升。YOLO(You Only Look Once)系列模型作为实时物体检测的代表,凭借其高效性和准确性,在多个应用场景中得到了广泛应用。YOLOv8作为该系列的最新版本,进一步优化了模型结构和算法性能,为日常物品的图像分割提供了新的可能性。
在日常生活中,物品的识别与分割不仅对智能家居、自动驾驶等领域具有重要意义,还在增强现实、机器人视觉等新兴应用中扮演着关键角色。通过对日常物品进行准确的图像分割,系统能够更好地理解环境,从而实现更智能的交互与操作。例如,在智能家居中,能够准确识别和分割出家居物品,进而实现智能控制和管理;在自动驾驶中,实时识别和分割周围物体,有助于提高行车安全性和自动驾驶的可靠性。
本研究旨在基于改进的YOLOv8模型,构建一个高效的日常物品图像分割系统。我们将使用一个包含3200张图像和57个类别的丰富数据集,该数据集涵盖了从水果、家具到电子产品等多种日常物品。这种多样性不仅为模型的训练提供了丰富的样本,也使得模型在实际应用中具备更强的泛化能力。通过对这些物品进行精确的实例分割,系统能够实现对不同物体的独立识别与处理,从而提升整体的智能化水平。
此外,日常物品的图像分割系统还具有重要的社会意义。随着人们生活节奏的加快,智能化的需求日益增长,如何提高生活质量、提升工作效率成为了社会关注的焦点。通过本研究所开发的图像分割系统,可以为用户提供更为便捷的生活体验。例如,在购物场景中,用户可以通过图像识别快速找到所需商品;在家庭环境中,智能助手能够识别出家中的物品并提供相应的服务。这不仅能够提高用户的生活便利性,还能够推动智能家居、智能购物等产业的发展。
综上所述,基于改进YOLOv8的日常物品图像分割系统的研究,不仅在技术上具有重要的创新意义,也在实际应用中展现出广阔的前景。通过深入探讨和解决日常物品图像分割中的关键问题,我们希望能够为计算机视觉领域的发展贡献一份力量,同时为智能化生活的实现提供坚实的技术支持。
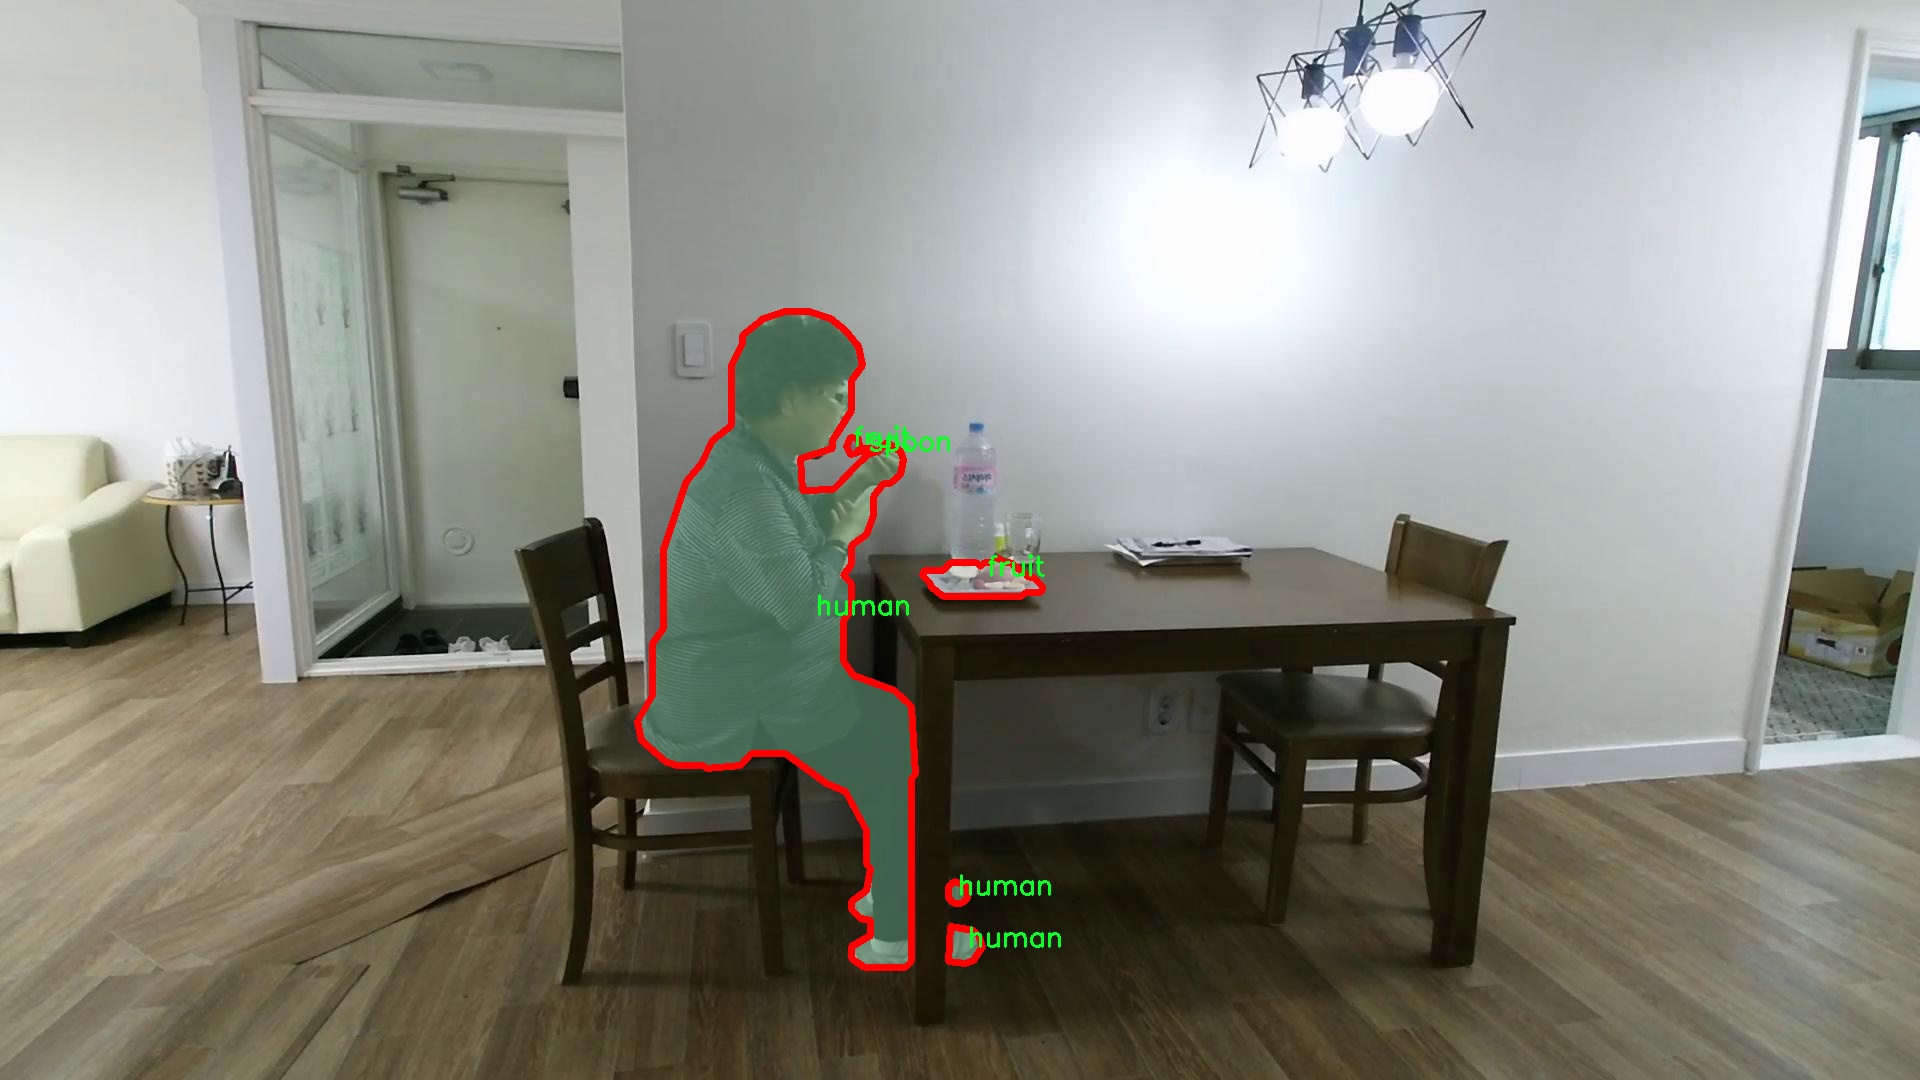
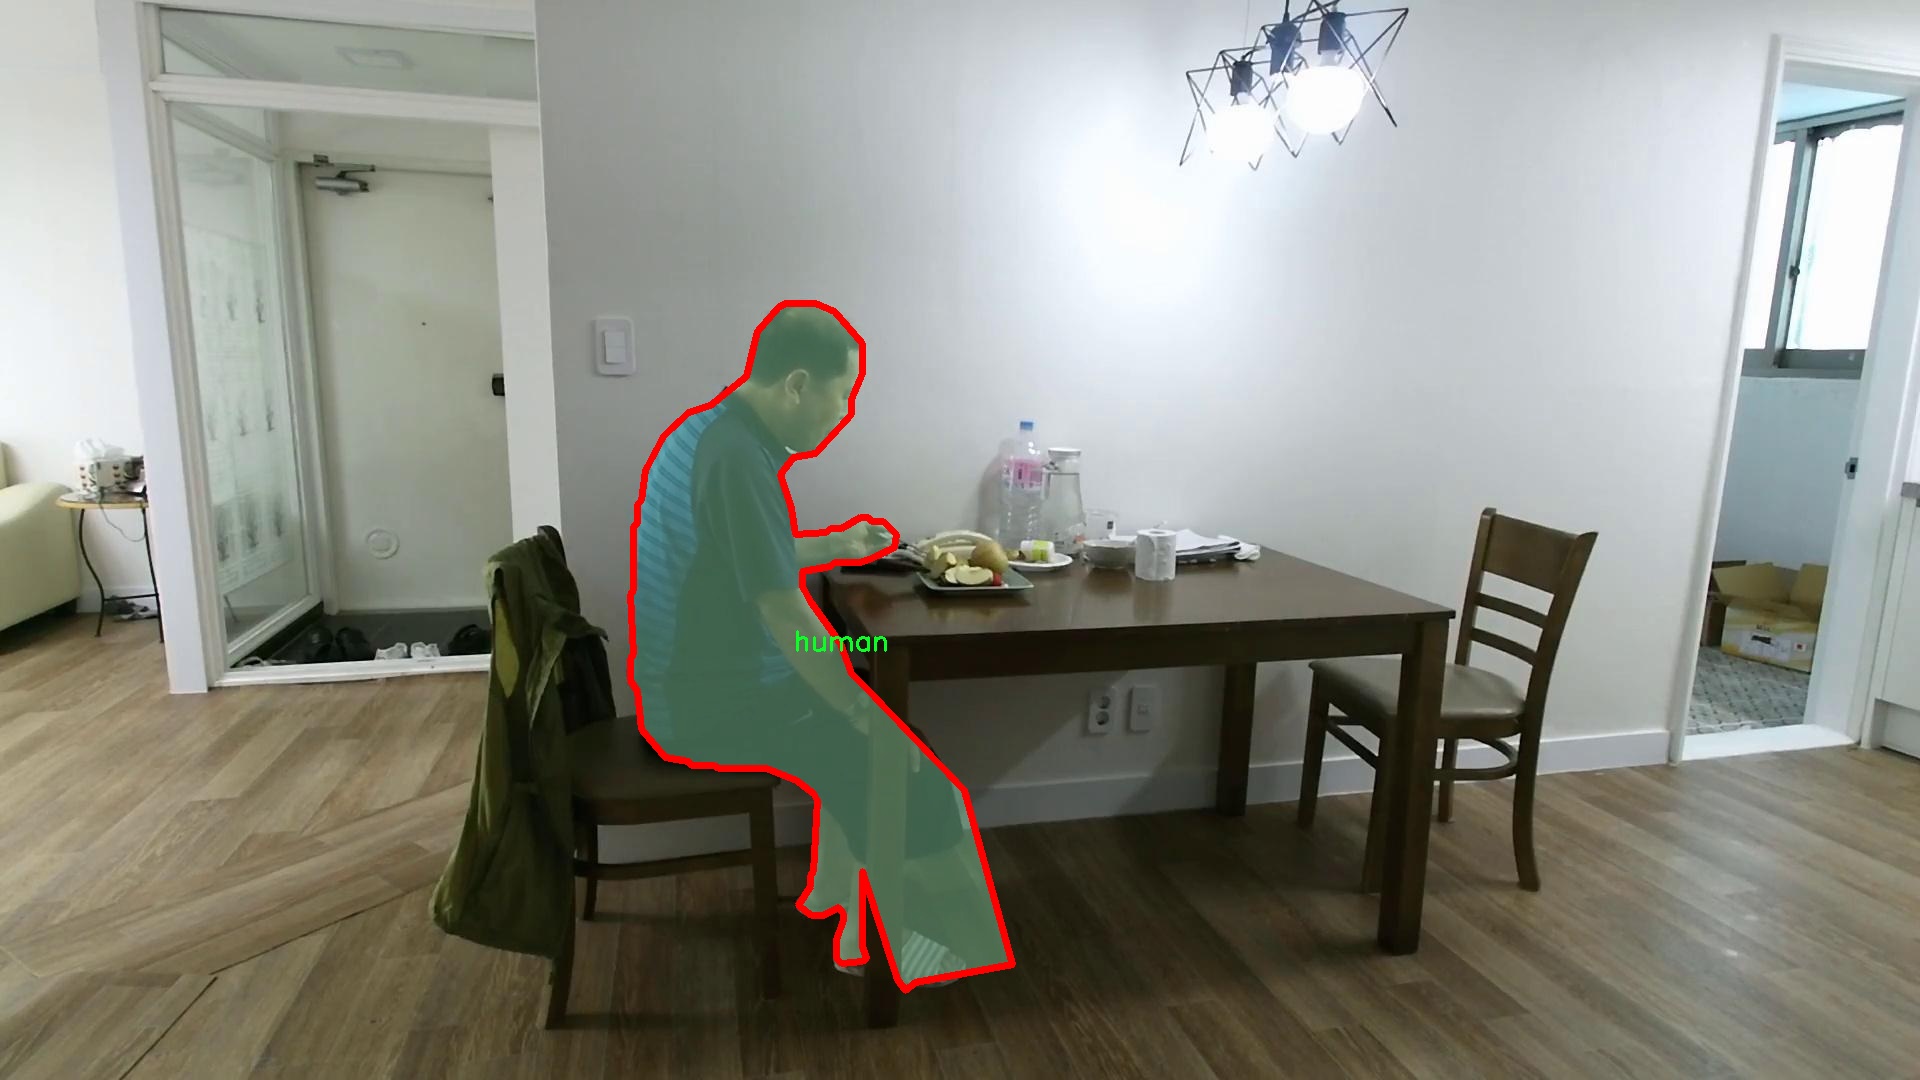
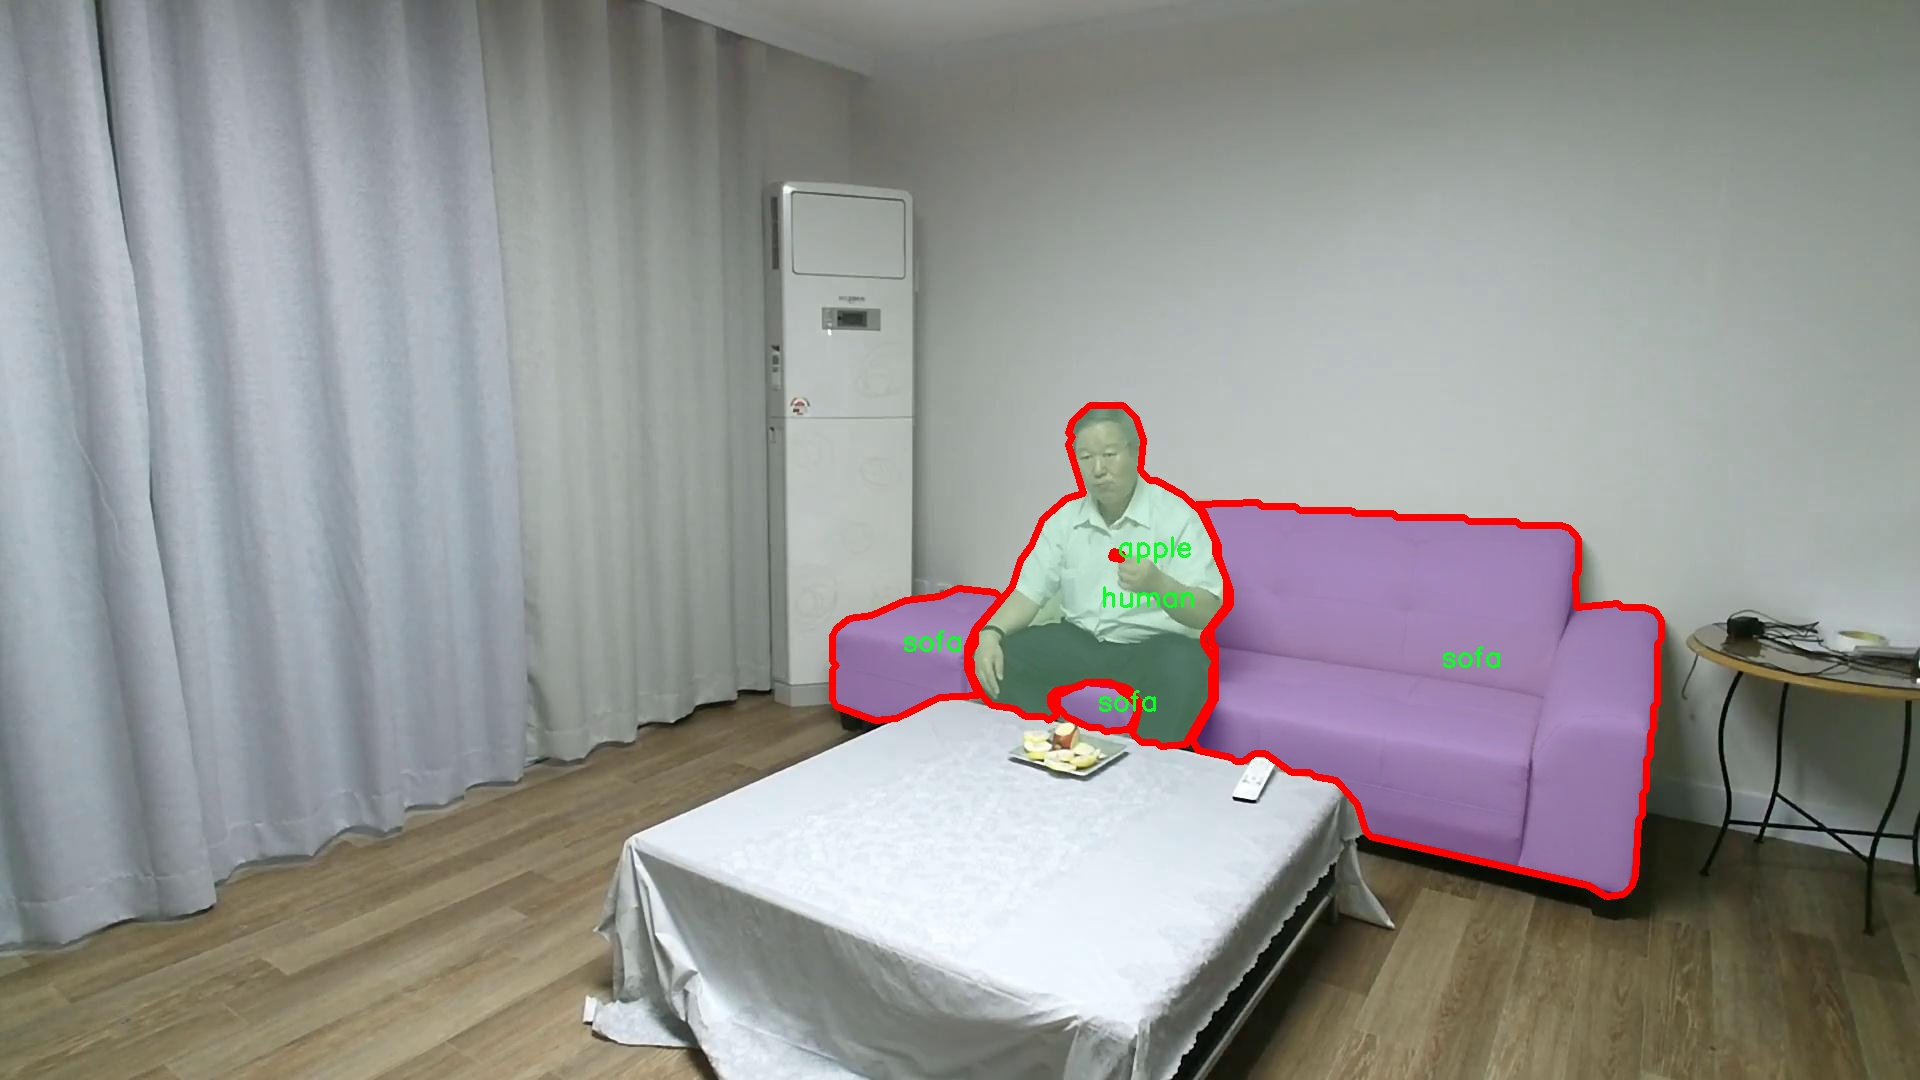
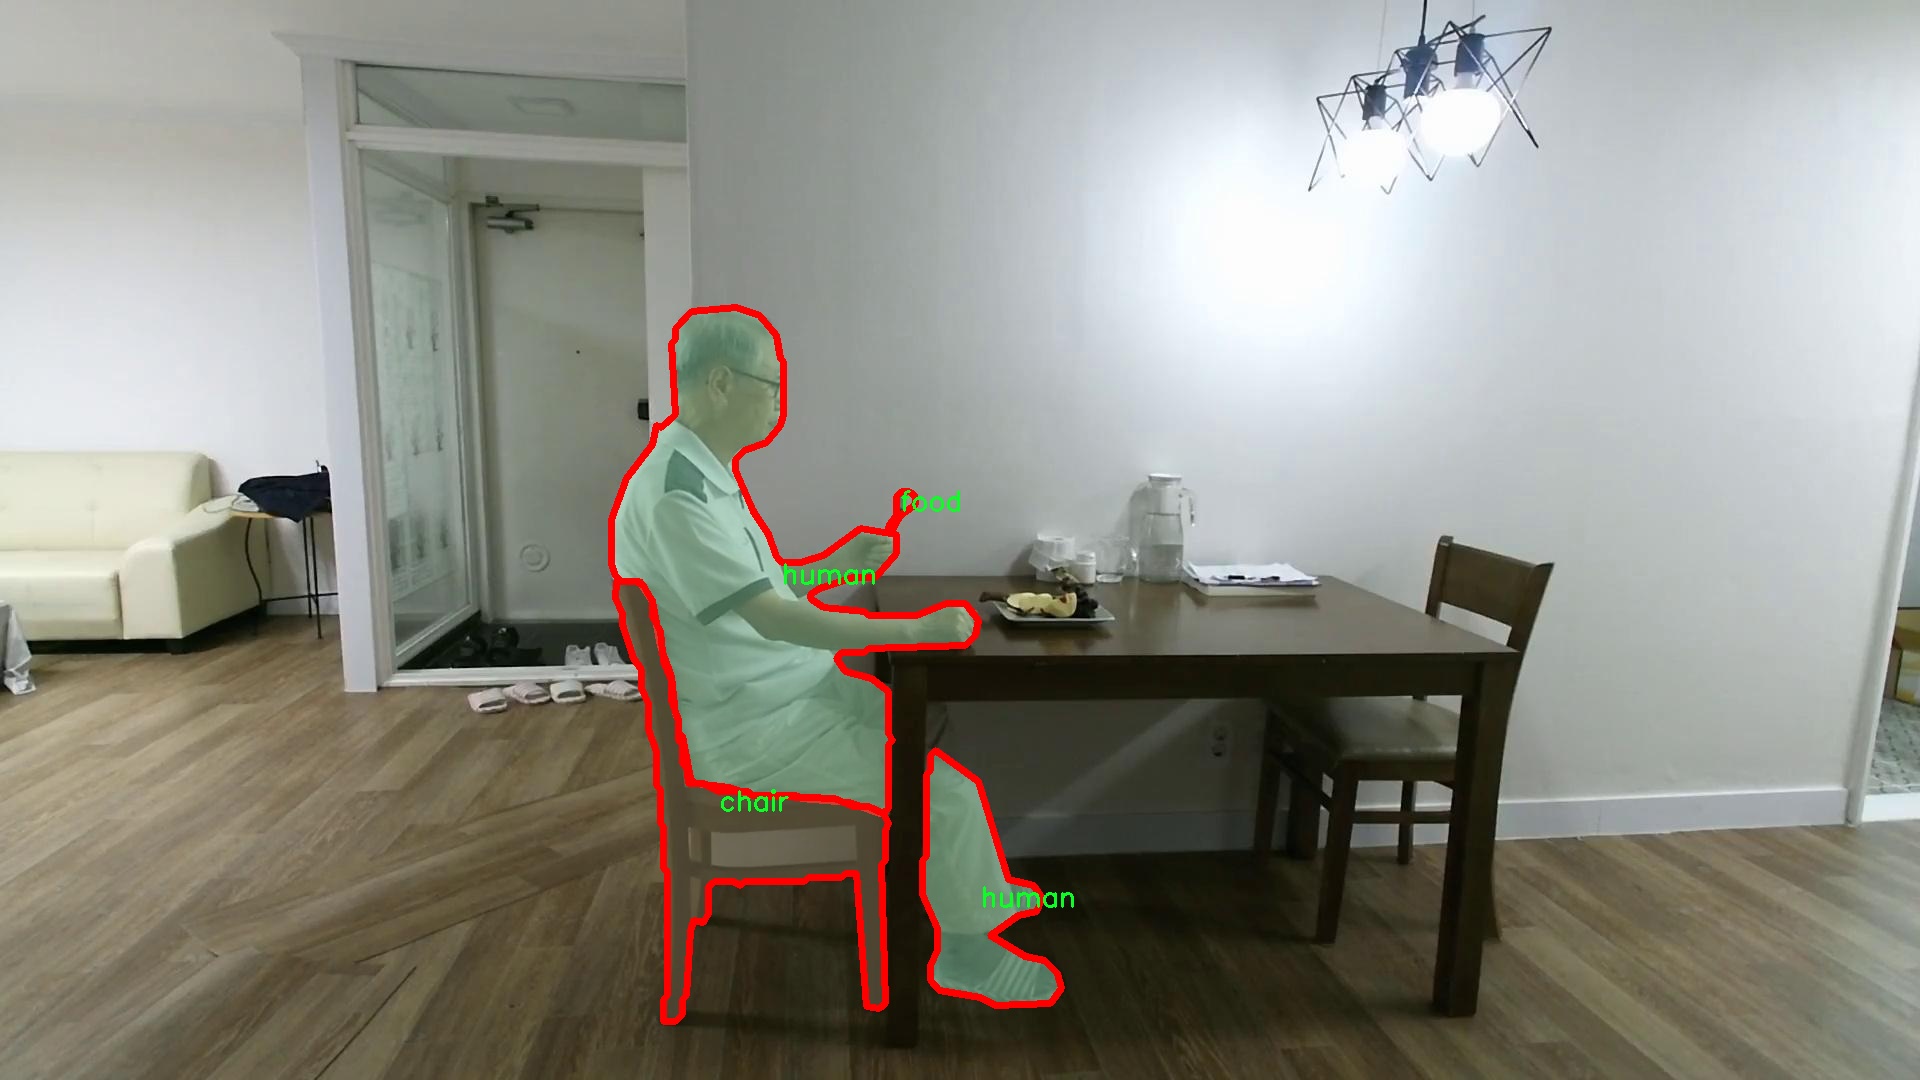
图片效果
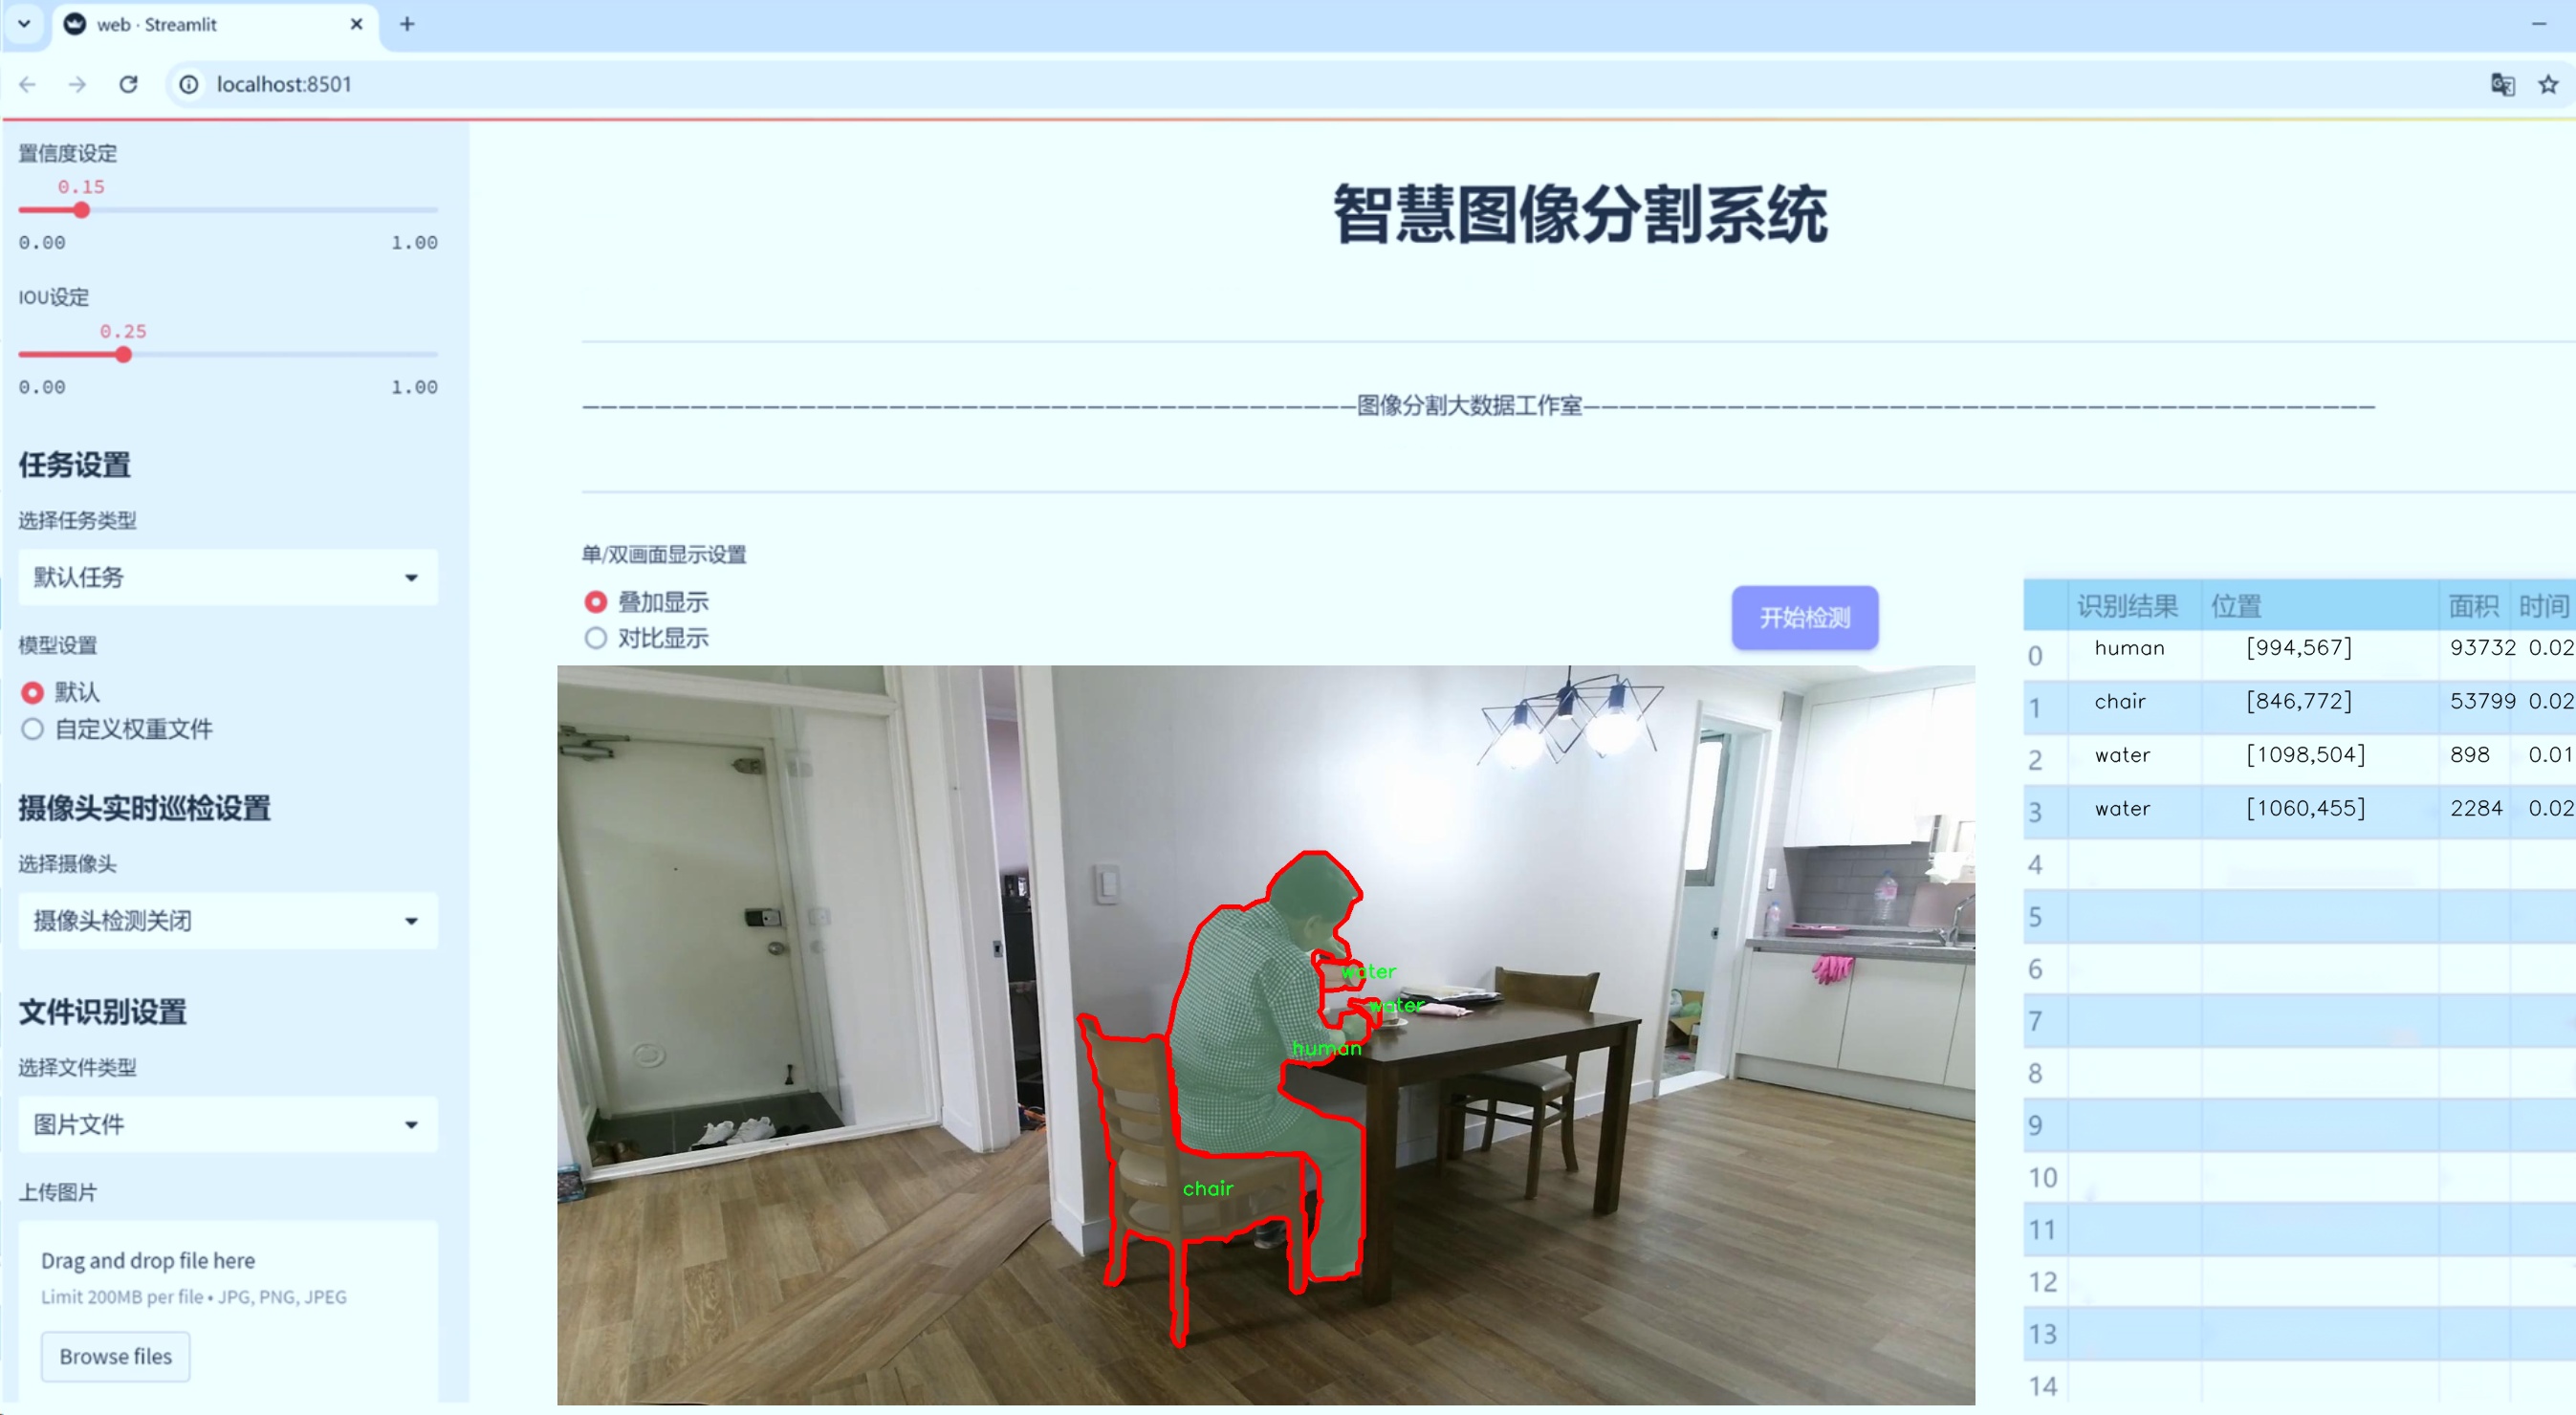
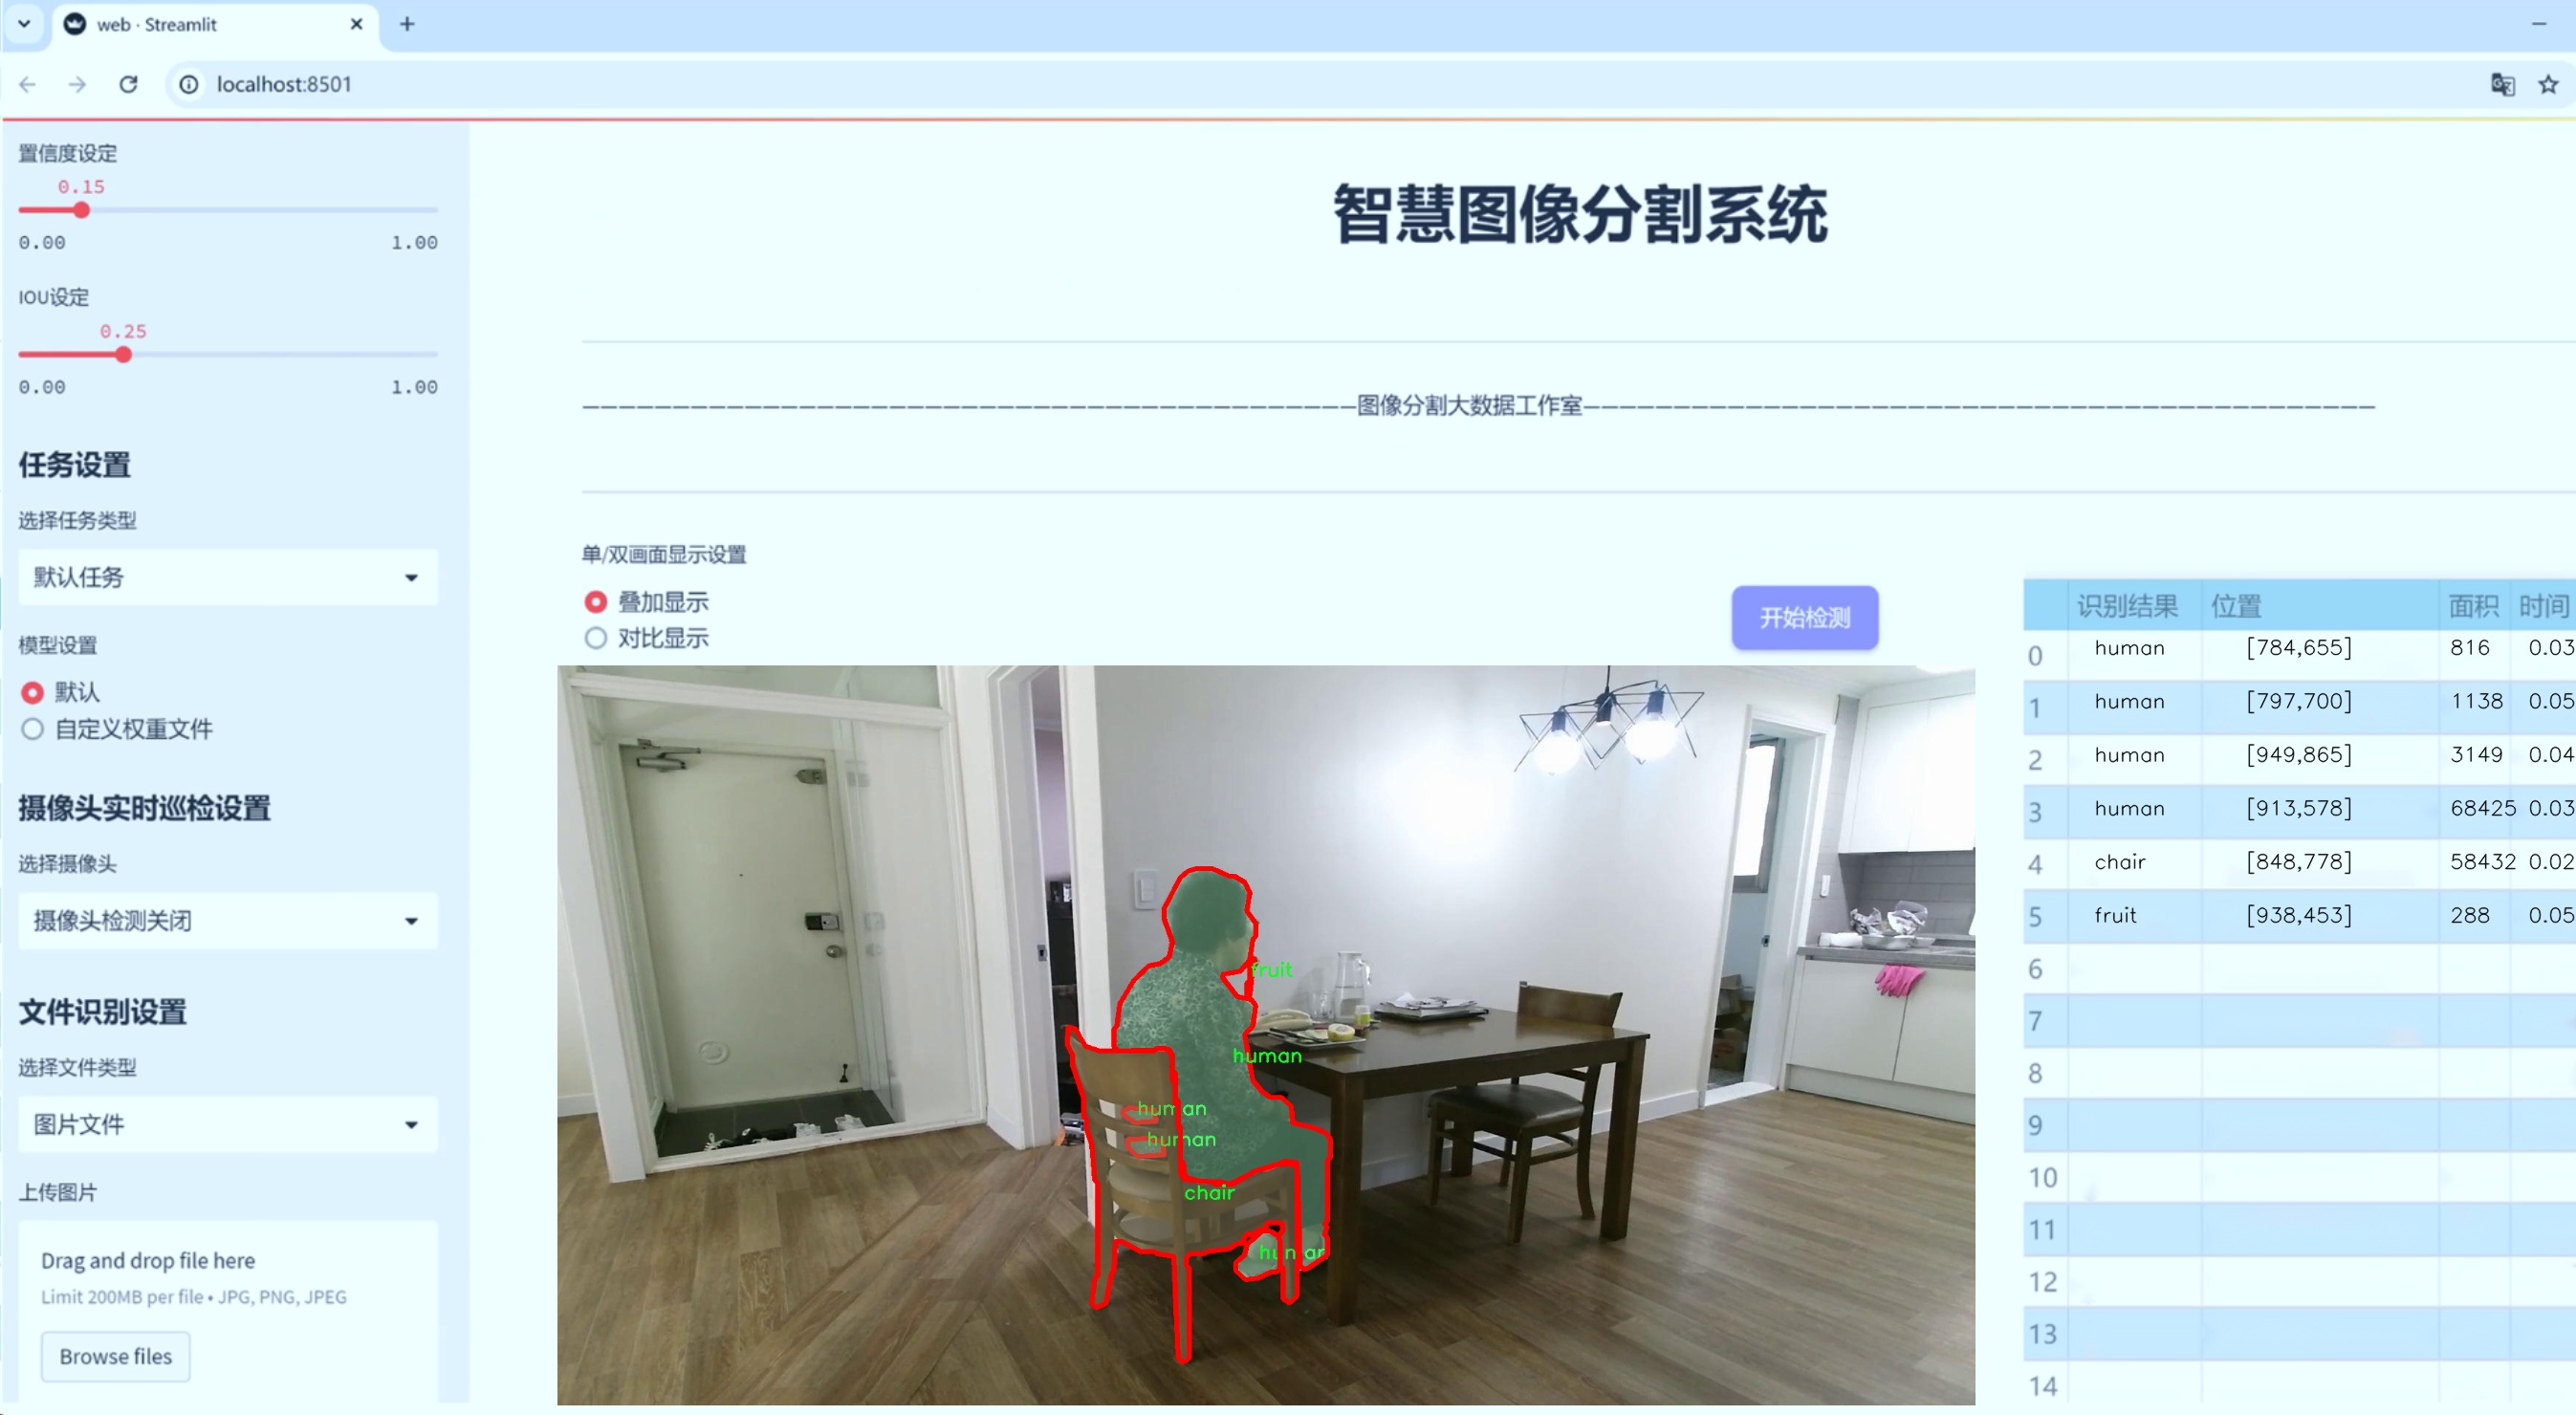
数据集信息
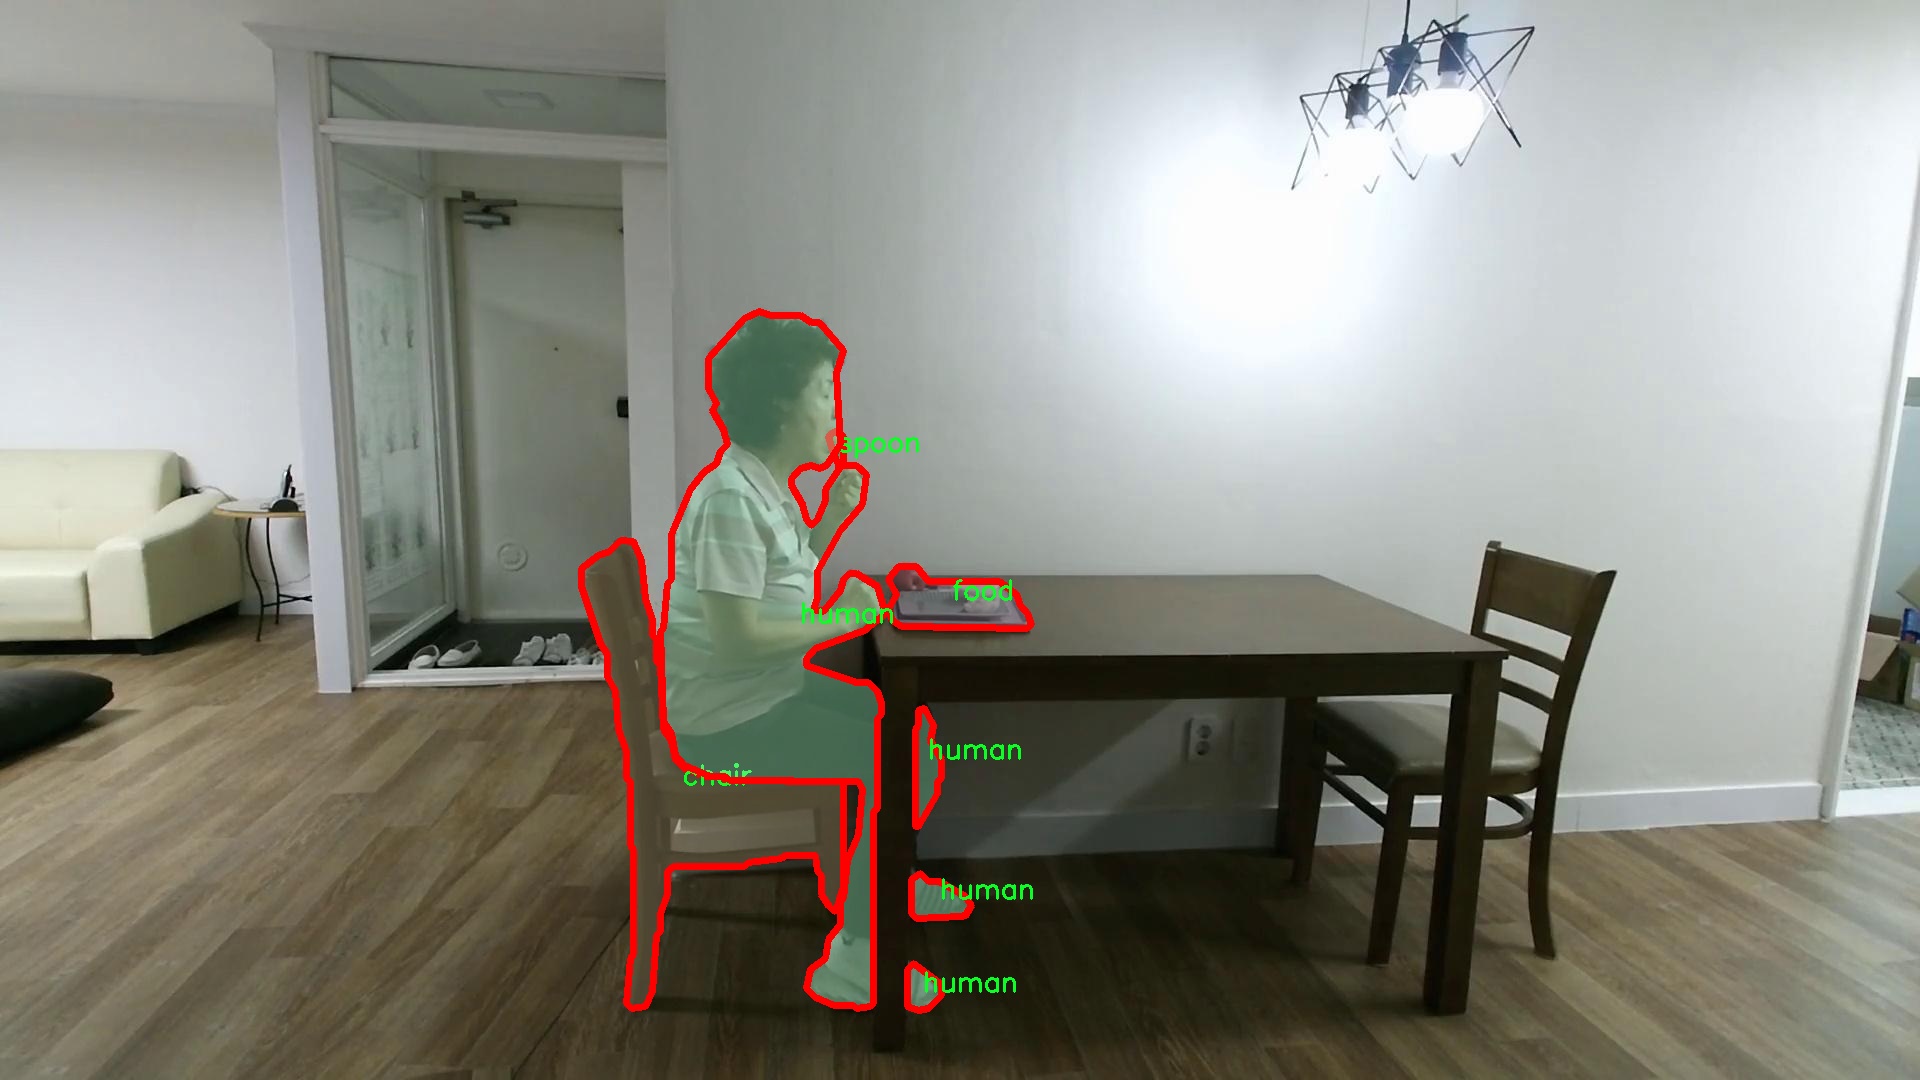
在本研究中,我们使用了名为“human”的数据集,旨在训练和改进YOLOv8-seg模型,以实现对日常物品的高效图像分割。该数据集包含57个类别,涵盖了丰富的日常物品,确保了模型在多样化场景中的适应性和准确性。数据集的类别包括但不限于:苹果、包、床、毛毯、书籍、瓶子、桶、橱柜、椅子、筷子、香烟、布料、梳子、化妆品、杯子、盘子、门、地板、食物、水果、眼镜、吹风机、衣服、罐子、壶、刀、笔记本电脑、口红、药品、镜子、报纸、锅、纸张、笔、不同类型的人(person1和person2)、手机、锅、冰箱、遥控器、鞋子、水槽、智能手机、沙发、勺子、炉子、桌子、电话、纸巾、牙刷、毛巾、电视、吸尘器、蔬菜、水和窗户等。
该数据集的设计旨在模拟真实世界中的各种物品,确保模型在处理复杂场景时能够有效识别和分割出各个物体。通过多样化的物品类别,数据集不仅涵盖了家庭环境中常见的物品,还包括一些特定的工具和设备,这为模型的训练提供了广泛的背景信息。例如,厨房用具(如锅、刀、杯子等)和生活用品(如牙刷、毛巾、电视等)都被纳入其中,使得模型能够在不同的上下文中进行准确的物体识别和分割。
此外,数据集中包含的人类对象(如person1和person2)也为模型提供了对人类行为和互动的理解。这种对人类对象的标注使得模型不仅能够识别静态物体,还能在动态场景中进行有效的分割,从而提升了模型在复杂环境中的应用潜力。
在数据预处理阶段,我们对图像进行了标准化处理,以确保模型在训练过程中能够获得一致的输入。这一过程包括图像的缩放、裁剪和增强等操作,以提高模型的鲁棒性和泛化能力。通过对数据集的精心设计和处理,我们期望YOLOv8-seg模型能够在日常物品的图像分割任务中表现出色。
综上所述,“human”数据集的多样性和丰富性为YOLOv8-seg模型的训练提供了坚实的基础。通过对57个类别的深入学习,模型将能够在实际应用中实现高效、准确的图像分割,进而推动智能视觉系统在家庭、商业和工业等多个领域的广泛应用。随着技术的不断进步,我们期待这一数据集能够为未来的研究和应用提供更多的可能性和灵感。
核心代码
```python
import json
import time
from pathlib import Path
import numpy as np
import torch
from ultralytics.cfg import get_cfg, get_save_dir
from ultralytics.data.utils import check_cls_dataset, check_det_dataset
from ultralytics.nn.autobackend import AutoBackend
from ultralytics.utils import LOGGER, TQDM, callbacks, colorstr, emojis
from ultralytics.utils.checks import check_imgsz
from ultralytics.utils.ops import Profile
from ultralytics.utils.torch_utils import de_parallel, select_device, smart_inference_mode

class BaseValidator:
    """
    BaseValidator 类用于验证模型的准确性。

    属性:
        args (SimpleNamespace): 验证器的配置参数。
        dataloader (DataLoader): 用于验证的数据加载器。
        model (nn.Module): 需要验证的模型。
        device (torch.device): 用于验证的设备。
        speed (dict): 包含预处理、推理、损失和后处理的速度信息。
        save_dir (Path): 保存结果的目录。
    """

    def __init__(self, dataloader=None, save_dir=None, args=None, _callbacks=None):
        """
        初始化 BaseValidator 实例。

        参数:
            dataloader (torch.utils.data.DataLoader): 用于验证的数据加载器。
            save_dir (Path, optional): 保存结果的目录。
            args (SimpleNamespace): 验证器的配置参数。
            _callbacks (dict): 存储各种回调函数的字典。
        """
        self.args = get_cfg(overrides=args)  # 获取配置
        self.dataloader = dataloader  # 数据加载器
        self.model = None  # 模型初始化为 None
        self.device = None  # 设备初始化为 None
        self.save_dir = save_dir or get_save_dir(self.args)  # 设置保存目录
        self.speed = {'preprocess': 0.0, 'inference': 0.0, 'loss': 0.0, 'postprocess': 0.0}  # 初始化速度字典
        self.callbacks = _callbacks or callbacks.get_default_callbacks()  # 初始化回调函数

    @smart_inference_mode()
    def __call__(self, trainer=None, model=None):
        """支持验证预训练模型或正在训练的模型。"""
        self.training = trainer is not None  # 判断是否在训练模式
        if self.training:
            self.device = trainer.device  # 获取训练设备
            model = trainer.ema.ema or trainer.model  # 获取模型
            model.eval()  # 设置模型为评估模式
        else:
            model = AutoBackend(model or self.args.model, device=select_device(self.args.device, self.args.batch))  # 自动选择后端
            self.device = model.device  # 更新设备

        self.dataloader = self.dataloader or self.get_dataloader(self.args.data, self.args.batch)  # 获取数据加载器
        model.eval()  # 设置模型为评估模式

        for batch_i, batch in enumerate(TQDM(self.dataloader, desc='Validating')):
            # 预处理
            batch = self.preprocess(batch)

            # 推理
            preds = model(batch['img'])

            # 更新指标
            self.update_metrics(preds, batch)

        stats = self.get_stats()  # 获取统计信息
        self.print_results()  # 打印结果
        return stats  # 返回统计信息

    def preprocess(self, batch):
        """对输入批次进行预处理。"""
        return batch  # 返回处理后的批次

    def update_metrics(self, preds, batch):
        """根据预测结果和批次更新指标。"""
        pass  # 具体实现由子类定义

    def get_stats(self):
        """返回模型性能的统计信息。"""
        return {}  # 返回空字典,具体实现由子类定义

    def print_results(self):
        """打印模型预测的结果。"""
        pass  # 具体实现由子类定义

    def get_dataloader(self, dataset_path, batch_size):
        """从数据集路径和批次大小获取数据加载器。"""
        raise NotImplementedError('get_dataloader function not implemented for this validator')  # 抛出未实现异常
代码分析与注释
-
导入模块:引入了必要的库和模块,包括
torch、numpy和一些自定义的工具模块。 -
BaseValidator 类:这是一个基类,用于验证模型的准确性。它包含了初始化、数据加载、模型推理等核心功能。
-
初始化方法
__init__:设置了验证器的基本配置,包括数据加载器、保存目录、速度统计和回调函数。 -
调用方法
__call__:该方法支持验证预训练模型或正在训练的模型。它处理模型的设置、数据加载和验证过程。 -
预处理方法
preprocess:对输入的批次进行预处理,目前简单返回原始批次,具体处理逻辑可以在子类中实现。 -
更新指标方法
update_metrics:根据模型的预测结果和输入批次更新性能指标,具体实现由子类定义。 -
获取统计信息方法
get_stats:返回模型性能的统计信息,当前返回空字典,具体实现由子类定义。 -
打印结果方法
print_results:打印模型的预测结果,当前没有实现,具体逻辑可以在子类中定义。 -
获取数据加载器方法
get_dataloader:用于从数据集路径和批次大小获取数据加载器,抛出未实现异常,提示需要在子类中实现。
这个类的设计为后续的具体验证器(如目标检测、分类等)提供了基础框架,子类可以根据具体需求实现相应的方法。```
这个文件是Ultralytics YOLO框架中的一个验证器类(BaseValidator),用于评估模型在测试集或验证集上的准确性。该类的设计目的是为模型的验证过程提供一个基础框架,包含了多种功能和属性,以便于在不同的任务中进行模型评估。
在文件开头,首先提供了使用该验证器的示例命令,说明了如何通过命令行调用YOLO模型进行验证。接着,导入了一些必要的库和模块,包括用于数据处理、模型管理和日志记录的工具。
BaseValidator类的构造函数初始化了一些重要的属性,包括配置参数、数据加载器、模型、设备信息等。构造函数中还会根据提供的参数设置一些默认值,并创建保存结果的目录。
__call__方法是该类的核心,支持对预训练模型或正在训练的模型进行验证。根据传入的参数,方法会设置训练模式或推理模式,并初始化模型和数据加载器。接着,模型会进行热身以提高推理速度。
在验证过程中,使用了一个进度条来显示当前的验证进度。每个批次的数据会经过预处理、推理、损失计算和后处理等步骤,最后更新模型的性能指标。验证完成后,统计结果会被打印出来,并根据需要保存为JSON格式。
该类还提供了一些辅助方法,例如匹配预测结果与真实标签、添加回调函数、获取数据加载器等。这些方法使得验证过程更加灵活和可扩展。
此外,BaseValidator类中定义了一些占位符方法(如get_dataloader、build_dataset等),这些方法需要在子类中实现,以适应具体的验证需求。
总体来说,这个文件提供了一个结构化的框架,用于在YOLO模型中进行验证,涵盖了从数据加载到结果输出的整个过程,具有良好的可扩展性和灵活性。
```python
import os
import re
import shutil
import socket
import sys
import tempfile
from pathlib import Path

def find_free_network_port() -> int:
    """
    查找本地主机上可用的端口。

    在单节点训练时,如果不想连接到真实的主节点,但必须设置
    `MASTER_PORT` 环境变量时,这个函数非常有用。
    """
    with socket.socket(socket.AF_INET, socket.SOCK_STREAM) as s:
        s.bind(('127.0.0.1', 0))  # 绑定到本地地址和随机端口
        return s.getsockname()[1]  # 返回分配的端口号


def generate_ddp_file(trainer):
    """生成 DDP 文件并返回其文件名。"""
    # 获取训练器的模块和类名
    module, name = f'{trainer.__class__.__module__}.{trainer.__class__.__name__}'.rsplit('.', 1)

    # 构建 DDP 文件的内容
    content = f'''overrides = {vars(trainer.args)} \nif __name__ == "__main__":
    from {module} import {name}
    from ultralytics.utils import DEFAULT_CFG_DICT

    cfg = DEFAULT_CFG_DICT.copy()
    cfg.update(save_dir='')   # 处理额外的键 'save_dir'
    trainer = {name}(cfg=cfg, overrides=overrides)
    trainer.train()'''

    # 创建 DDP 目录(如果不存在)
    (USER_CONFIG_DIR / 'DDP').mkdir(exist_ok=True)

    # 创建临时文件并写入内容
    with tempfile.NamedTemporaryFile(prefix='_temp_',
                                     suffix=f'{id(trainer)}.py',
                                     mode='w+',
                                     encoding='utf-8',
                                     dir=USER_CONFIG_DIR / 'DDP',
                                     delete=False) as file:
        file.write(content)  # 写入内容到临时文件
    return file.name  # 返回临时文件的名称


def generate_ddp_command(world_size, trainer):
    """生成并返回用于分布式训练的命令。"""
    import __main__  # 本地导入以避免某些问题
    if not trainer.resume:
        shutil.rmtree(trainer.save_dir)  # 如果不恢复训练,删除保存目录

    file = str(Path(sys.argv[0]).resolve())  # 获取当前脚本的绝对路径
    safe_pattern = re.compile(r'^[a-zA-Z0-9_. /\\-]{1,128}$')  # 允许的字符和最大长度
    # 检查文件名是否合法且存在,并且以 .py 结尾
    if not (safe_pattern.match(file) and Path(file).exists() and file.endswith('.py')):
        file = generate_ddp_file(trainer)  # 生成 DDP 文件

    # 根据 PyTorch 版本选择分布式命令
    dist_cmd = 'torch.distributed.run' if TORCH_1_9 else 'torch.distributed.launch'
    port = find_free_network_port()  # 查找可用端口
    # 构建命令列表
    cmd = [sys.executable, '-m', dist_cmd, '--nproc_per_node', f'{world_size}', '--master_port', f'{port}', file]
    return cmd, file  # 返回命令和文件名


def ddp_cleanup(trainer, file):
    """如果创建了临时文件,则删除它。"""
    if f'{id(trainer)}.py' in file:  # 检查文件名中是否包含临时文件的后缀
        os.remove(file)  # 删除临时文件
代码核心功能概述:
- 查找可用端口:
find_free_network_port函数用于查找本地主机上可用的网络端口,适用于设置分布式训练的环境变量。 - 生成 DDP 文件:
generate_ddp_file函数生成一个用于分布式数据并行(DDP)训练的 Python 文件,并返回该文件的路径。 - 生成训练命令:
generate_ddp_command函数根据训练器的状态和系统环境生成用于启动分布式训练的命令。 - 清理临时文件:
ddp_cleanup函数用于删除在训练过程中生成的临时文件,以保持文件系统的整洁。```
这个程序文件ultralytics/utils/dist.py是用于支持分布式训练的工具模块,主要涉及到一些网络端口的管理、生成分布式训练的命令和清理临时文件等功能。
首先,文件导入了一些必要的库,包括操作系统相关的库、正则表达式库、套接字库、系统库、临时文件库以及路径处理库。它还导入了用户配置目录和一个与 PyTorch 版本相关的常量。
find_free_network_port 函数用于查找本地主机上一个可用的网络端口。这在单节点训练时非常有用,因为我们不想连接到真实的主节点,但需要设置 MASTER_PORT 环境变量。该函数通过创建一个套接字并绑定到一个随机端口来实现,返回该端口号。
generate_ddp_file 函数用于生成一个 DDP(Distributed Data Parallel)文件,并返回其文件名。它从传入的训练器对象中提取类的模块和名称,并构建一个包含训练参数的 Python 脚本内容。接着,它在用户配置目录下创建一个名为 DDP 的文件夹(如果不存在的话),并将生成的内容写入一个临时文件中,最后返回该文件的名称。
generate_ddp_command 函数生成并返回用于分布式训练的命令。它首先检查训练器是否需要恢复,如果不需要,则删除保存目录。接着,它获取当前脚本的路径,并通过正则表达式检查该路径是否安全。如果路径不符合要求,则调用 generate_ddp_file 生成一个临时文件。然后,它确定使用的分布式命令(根据 PyTorch 版本选择 torch.distributed.run 或 torch.distributed.launch),并调用 find_free_network_port 获取一个可用的端口。最后,它构建并返回一个包含执行命令的列表和临时文件名。
ddp_cleanup 函数用于在训练结束后删除临时文件。如果临时文件的后缀与训练器的 ID 匹配,则执行删除操作,以确保清理不再需要的文件。
总体来说,这个模块为 Ultralytics YOLO 提供了分布式训练的支持,简化了分布式训练环境的设置和管理。
```python
import cv2
import numpy as np
from PIL import ImageFont, ImageDraw, Image
from hashlib import md5
from model import Web_Detector
from chinese_name_list import Label_list

def generate_color_based_on_name(name):
    # 使用哈希函数生成稳定的颜色
    hash_object = md5(name.encode())  # 对名字进行MD5哈希
    hex_color = hash_object.hexdigest()[:6]  # 取前6位16进制数
    r, g, b = int(hex_color[0:2], 16), int(hex_color[2:4], 16), int(hex_color[4:6], 16)  # 转换为RGB
    return (b, g, r)  # OpenCV 使用BGR格式

def draw_with_chinese(image, text, position, font_size=20, color=(255, 0, 0)):
    # 在图像上绘制中文文本
    image_pil = Image.fromarray(cv2.cvtColor(image, cv2.COLOR_BGR2RGB))  # 转换为PIL格式
    draw = ImageDraw.Draw(image_pil)  # 创建绘图对象
    font = ImageFont.truetype("simsun.ttc", font_size, encoding="unic")  # 加载中文字体
    draw.text(position, text, font=font, fill=color)  # 绘制文本
    return cv2.cvtColor(np.array(image_pil), cv2.COLOR_RGB2BGR)  # 转换回OpenCV格式

def draw_detections(image, info):
    # 绘制检测结果,包括边框、类别名称等
    name, bbox = info['class_name'], info['bbox']  # 获取类别名称和边界框
    x1, y1, x2, y2 = bbox  # 解包边界框坐标
    cv2.rectangle(image, (x1, y1), (x2, y2), color=(0, 0, 255), thickness=3)  # 绘制边界框
    image = draw_with_chinese(image, name, (x1, y1 - 10), font_size=20)  # 绘制类别名称
    return image

def process_frame(model, image):
    # 处理图像帧,进行目标检测
    pre_img = model.preprocess(image)  # 预处理图像
    pred = model.predict(pre_img)  # 进行预测
    det = pred[0]  # 获取检测结果

    if det is not None and len(det):
        det_info = model.postprocess(pred)  # 后处理,获取检测信息
        for info in det_info:
            image = draw_detections(image, info)  # 绘制检测结果
    return image

if __name__ == "__main__":
    model = Web_Detector()  # 创建模型实例
    model.load_model("./weights/yolov8s-seg.pt")  # 加载模型权重

    # 图片处理
    image_path = './icon/OIP.jpg'  # 指定图片路径
    image = cv2.imread(image_path)  # 读取图片
    if image is not None:
        processed_image = process_frame(model, image)  # 处理图像
        cv2.imshow('Processed Image', processed_image)  # 显示处理后的图像
        cv2.waitKey(0)  # 等待按键
        cv2.destroyAllWindows()  # 关闭窗口
    else:
        print('Image not found.')  # 图片未找到的提示
代码核心部分说明:
- 生成颜色:
generate_color_based_on_name函数使用MD5哈希生成一个稳定的颜色,确保相同的名字总是得到相同的颜色。 - 绘制中文文本:
draw_with_chinese函数在图像上绘制中文文本,使用PIL库处理中文字体。 - 绘制检测结果:
draw_detections函数负责在图像上绘制检测到的目标,包括边界框和类别名称。 - 处理图像帧:
process_frame函数对输入图像进行预处理、预测和后处理,最终返回绘制了检测结果的图像。 - 主程序:在主程序中加载模型并读取图像,调用处理函数进行目标检测并显示结果。```
这个程序文件demo_test_image.py是一个图像处理脚本,主要用于使用深度学习模型进行目标检测和分割,并在图像上绘制检测结果。程序中使用了 OpenCV、NumPy 和 PIL 等库来处理图像和绘制文本。
首先,程序导入了必要的库,包括随机数生成、图像处理、数组操作、字体处理、哈希函数以及自定义的模型和标签列表。接着,定义了几个辅助函数。
generate_color_based_on_name(name) 函数使用 MD5 哈希函数根据输入的名称生成一个稳定的颜色值。这个颜色值用于在图像中标识不同的目标。
calculate_polygon_area(points) 函数计算给定点集(多边形)的面积,使用 OpenCV 的 contourArea 函数。
draw_with_chinese(image, text, position, font_size=20, color=(255, 0, 0)) 函数用于在图像上绘制中文文本。它将 OpenCV 图像转换为 PIL 图像,以便使用指定的字体和颜色绘制文本,然后再转换回 OpenCV 格式。
adjust_parameter(image_size, base_size=1000) 函数根据图像的大小调整参数,以便在绘制时保持一致的比例。
draw_detections(image, info, alpha=0.2) 函数负责在图像上绘制检测到的目标,包括边界框、类别名称和其他信息。如果检测到的目标有掩码,则绘制掩码并计算相关的几何特征(如面积、周长和圆度),并在图像上显示这些信息。
process_frame(model, image) 函数处理输入图像,首先对图像进行预处理,然后使用模型进行预测,最后将检测到的目标绘制到图像上。
在主程序部分,首先加载标签列表和模型,然后读取指定路径的图像。如果图像成功加载,则调用 process_frame 函数处理图像,并使用 OpenCV 显示处理后的图像。如果图像未找到,则输出错误信息。
整体而言,这个程序的目的是通过深度学习模型对图像进行目标检测,并在图像上可视化检测结果,适合用于计算机视觉相关的应用。
源码文件
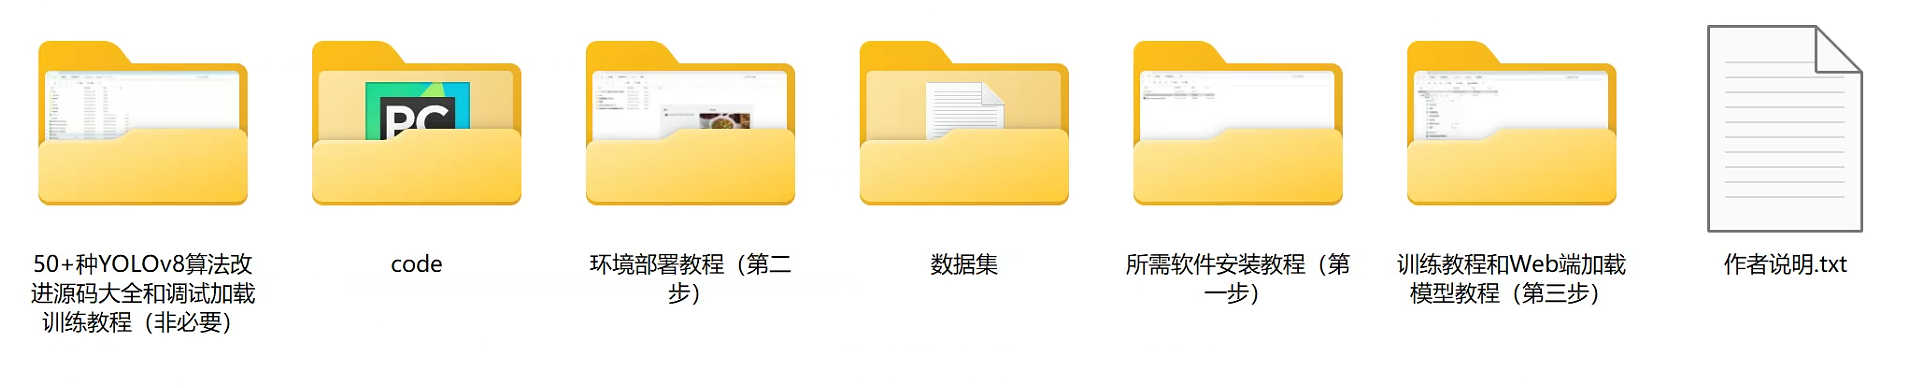
源码获取
欢迎大家点赞、收藏、关注、评论啦 、查看👇🏻获取联系方式

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 24
 0
- 0


 已为社区贡献78条内容

所有评论(0)