SlowFast使用指南(二)——训练ava数据集
写在前面
ava 的数据集非常大,训练起来非常慢,这次我就把ava的数据集缩小到2个视频(1个作为验证集,一个作为训练集),这样做的目的是观察slowfast是如何训练ava数据集的。
训练所需数据文件
新建一个 avademo 目录,目录中包含annotations、frame_lists、frames三个目录
annotations
annotations 需要从官网进行下载。直接从annotations下载地址 下载
然后执行解压命令解压 tar 包
tar -xvf ava_annotations.tar
目录结构如下:
├── ava_annotations
│   ├── ava_action_list_v2.1_for_activitynet_2018.pbtxt
│   ├── ava_action_list_v2.2_for_activitynet_2019.pbtxt
│   ├── ava_action_list_v2.2.pbtxt
│   ├── ava_included_timestamps_v2.2.txt
│   ├── ava_test_excluded_timestamps_v2.1.csv
│   ├── ava_test_excluded_timestamps_v2.2.csv
│   ├── ava_test_v2.2.csv
│   ├── ava_train_excluded_timestamps_v2.1.csv
│   ├── ava_train_excluded_timestamps_v2.2.csv
│   ├── ava_train_v2.1.csv
│   ├── ava_train_v2.2.csv
│   ├── ava_val_excluded_timestamps_v2.1.csv
│   ├── ava_val_excluded_timestamps_v2.2.csv
│   ├── ava_val_v2.1.csv
│   ├── ava_val_v2.2.csv
│   ├── person_box_67091280_iou75
│   │   ├── ava_detection_test_boxes_and_labels.csv
│   │   ├── ava_detection_train_boxes_and_labels_include_negative.csv
│   │   ├── ava_detection_train_boxes_and_labels_include_negative_v2.1.csv
│   │   ├── ava_detection_train_boxes_and_labels_include_negative_v2.2.csv
│   │   ├── ava_detection_val_boxes_and_labels.csv
│   │   ├── ava_detection_val_for_training_boxes_and_labels_include_negative.csv
│   │   └── ava_detection_val_for_training_boxes_and_labels_include_negative_v2.2.csv
│   ├── person_box_67091280_iou90
│   │   ├── ava_action_list_v2.1_for_activitynet_2018.pbtxt
│   │   ├── ava_detection_test_boxes_and_labels.csv
│   │   ├── ava_detection_train_boxes_and_labels_include_negative.csv
│   │   ├── ava_detection_train_boxes_and_labels_include_negative_v2.1.csv
│   │   ├── ava_detection_train_boxes_and_labels_include_negative_v2.2.csv
│   │   ├── ava_detection_val_boxes_and_labels.csv
│   │   ├── ava_detection_val_for_training_boxes_and_labels_include_negative.csv
│   │   ├── ava_detection_val_for_training_boxes_and_labels_include_negative_v2.1.csv
│   │   ├── ava_detection_val_for_training_boxes_and_labels_include_negative_v2.2.csv
│   │   ├── ava_train_predicted_boxes.csv
│   │   ├── ava_train_v2.1.csv
│   │   ├── ava_val_excluded_timestamps_v2.1.csv
│   │   ├── ava_val_predicted_boxes.csv -> ava_detection_val_boxes_and_labels.csv
│   │   ├── ava_val_v2.1.csv
│   │   ├── test.csv
│   │   ├── train.csv
│   │   └── val.csv
│   ├── test.csv
│   ├── train.csv
│   └── val.csv
└── ava_annotations.tar
解压下来的文件并不是都需要,只需要以下内容
ava_annotations
├── ava_action_list_v2.2_for_activitynet_2019.pbtxt
├── ava_train_excluded_timestamps_v2.2.csv
├── ava_train_v2.2.csv
├── ava_val_excluded_timestamps_v2.2.csv
├── ava_val_v2.2.csv
├── person_box_67091280_iou90
│   ├── ava_detection_train_boxes_and_labels_include_negative_v2.2.csv
│   ├── ava_detection_val_boxes_and_labels.csv
将所需要的文件保留下来之后,需要对每一个 .csv 文件进行处理。
/annotations/person_box_67091280_iou90/ava_detection_train_boxes_and_labels_include_negative_v2.2.csv 和 /annotations/ava_train_v2.1.csv, /annotations/ava_train_v2.2csv 只保留第一列名为: -5KQ66BBWC4的所有行。
/annotations/person_box_67091280_iou90/ava_detection_val_boxes_and_labels.csv 和annotations/ava_detection_val_boxes_and_labels.csv
只保留第一列名为:1j20qq1JyX4 的所有行。
frame_lists
在 frame_lists 目录下,这里只存放了两个文件:train.csv、val.csv
train.csv 下载地址:https://dl.fbaipublicfiles.com/video-long-term-feature-banks/data/ava/frame_lists/train.csv
val.csv 下载地址:https://dl.fbaipublicfiles.com/video-long-term-feature-banks/data/ava/frame_lists/val.csv
下载下来的两个 csv 文件同样需要处理。frame_lists/train.csv 只保留第一列名为: -5KQ66BBWC4的所有行;frame_lists/val.csv 只保留第一列名为:1j20qq1JyX4 的所有行。
frames
frames下有两个文件夹:-5KQ66BBWC4,1j20qq1JyX4 此为经过抽帧后的图片。抽帧步骤如下:
参考文档:https://github.com/facebookresearch/SlowFast/blob/master/slowfast/datasets/DATASET.md
第一步,首先下载所需要的两个视频-5KQ66BBWC4,1j20qq1JyX4
-5KQ66BBWC4下载地址:https://s3.amazonaws.com/ava-dataset/trainval/-5KQ66BBWC4.mkv
1j20qq1JyX4下载地址:https://s3.amazonaws.com/ava-dataset/trainval/1j20qq1JyX4.mp4
下载完成后,存放在 avademo 新建的 video 目录。
第二步,创建脚本 cut_video.sh 将两个视频分别裁剪到15分钟,如果视频本身很短则不需要执行此步。
IN_DATA_DIR="./videos"
OUT_DATA_DIR="./videos_15min"

if [[ ! -d "${OUT_DATA_DIR}" ]]; then
  echo "${OUT_DATA_DIR} doesn't exist. Creating it.";
  mkdir -p ${OUT_DATA_DIR}
fi

for video in $(ls -A1 -U ${IN_DATA_DIR}/*)
do
  out_name="${OUT_DATA_DIR}/${video##*/}"
  if [ ! -f "${out_name}" ]; then
    ffmpeg -ss 900 -t 901 -i "${video}" "${out_name}"
  fi
done
然后执行此脚本 sh cut_video.sh。
第三步,创建脚本 frame.sh 将裁剪过的视频进行抽帧处理。
#!/bin/sh
IN_DATA_DIR="./videos_15min"
OUT_DATA_DIR="./frames"

# 检查输出目录是否存在,不存在则创建
if [ ! -d "${OUT_DATA_DIR}" ]; then
  echo "${OUT_DATA_DIR} doesn't exist. Creating it."
  mkdir -p "${OUT_DATA_DIR}"
fi

# 遍历视频文件
for video in "${IN_DATA_DIR}"/*; do
  # 提取文件名(不带路径)
  video_name=$(basename "${video}")

  # 去除扩展名(兼容 .webm 和 .mp4)
  case "${video_name}" in
    *.webm) video_name=$(echo "${video_name}" | sed 's/\.webm$//') ;;
    *)     video_name=$(echo "${video_name}" | sed 's/\.[^.]*$//') ;;
  esac

  # 创建输出目录
  out_video_dir="${OUT_DATA_DIR}/${video_name}"
  mkdir -p "${out_video_dir}"

  # 设置输出文件名格式
  out_name="${out_video_dir}/${video_name}_%06d.jpg"

  # 使用 ffmpeg 提取帧
  ffmpeg -i "${video}" -r 30 -q:v 1 "${out_name}"
done
执行完脚本后,frames目录下会出现-5KQ66BBWC4,1j20qq1JyX4两个目录。
上方内容均执行完成后,此时的 avademo 目录如下图所示

配置文件
在 /SlowFast/configs/AVA/c2 下创建一个新的yaml文件:SLOWFAST_32x2_R101_50_50_train.yaml,如下图
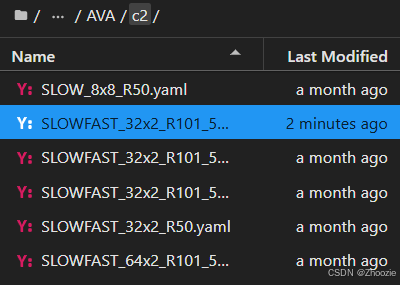
代码如下:
TRAIN:
  ENABLE: True
  DATASET: ava
  BATCH_SIZE: 2
  EVAL_PERIOD: 5
  CHECKPOINT_PERIOD: 1
  AUTO_RESUME: True
  CHECKPOINT_FILE_PATH: "" #path to pretrain model
  CHECKPOINT_TYPE: pytorch
DATA:
  NUM_FRAMES: 32
  SAMPLING_RATE: 2
  TRAIN_JITTER_SCALES: [256, 320]
  TRAIN_CROP_SIZE: 224
  TEST_CROP_SIZE: 256
  INPUT_CHANNEL_NUM: [3, 3]
DETECTION:
  ENABLE: True
  ALIGNED: True
AVA:
  # BGR: False
  FRAME_DIR: "/mnt/workspace/slowfast_project/avademo/frames"
  FRAME_LIST_DIR: "/mnt/workspace/slowfast_project/avademo/frame_lists"
  ANNOTATION_DIR: "/mnt/workspace/slowfast_project/avademo/annotations"
  DETECTION_SCORE_THRESH: 0.8
  TRAIN_PREDICT_BOX_LISTS: [
    "ava_train_v2.2.csv",
    "person_box_67091280_iou90/ava_detection_train_boxes_and_labels_include_negative_v2.2.csv"
  ]
  TEST_PREDICT_BOX_LISTS: ["person_box_67091280_iou90/ava_detection_val_boxes_and_labels.csv"]
SLOWFAST:
  ALPHA: 4
  BETA_INV: 8
  FUSION_CONV_CHANNEL_RATIO: 2
  FUSION_KERNEL_SZ: 5
RESNET:
  ZERO_INIT_FINAL_BN: True
  WIDTH_PER_GROUP: 64
  NUM_GROUPS: 1
  DEPTH: 101
  TRANS_FUNC: bottleneck_transform
  STRIDE_1X1: False
  NUM_BLOCK_TEMP_KERNEL: [[3, 3], [4, 4], [6, 6], [3, 3]]
  SPATIAL_DILATIONS: [[1, 1], [1, 1], [1, 1], [2, 2]]
  SPATIAL_STRIDES: [[1, 1], [2, 2], [2, 2], [1, 1]]
NONLOCAL:
  LOCATION: [[[], []], [[], []], [[6, 13, 20], []], [[], []]]
  GROUP: [[1, 1], [1, 1], [1, 1], [1, 1]]
  INSTANTIATION: dot_product
  POOL: [[[2, 2, 2], [2, 2, 2]], [[2, 2, 2], [2, 2, 2]], [[2, 2, 2], [2, 2, 2]], [[2, 2, 2], [2, 2, 2]]]
BN:
  USE_PRECISE_STATS: False
  NUM_BATCHES_PRECISE: 200
SOLVER:
  BASE_LR: 0.1
  LR_POLICY: steps_with_relative_lrs
  STEPS: [0, 10, 15, 20]
  LRS: [1, 0.1, 0.01, 0.001]
  MAX_EPOCH: 20
  MOMENTUM: 0.9
  WEIGHT_DECAY: 1e-7
  WARMUP_EPOCHS: 5.0
  WARMUP_START_LR: 0.000125
  OPTIMIZING_METHOD: sgd
MODEL:
  NUM_CLASSES: 80
  ARCH: slowfast
  MODEL_NAME: SlowFast
  LOSS_FUNC: bce
  DROPOUT_RATE: 0.5
  HEAD_ACT: sigmoid
TEST:
  ENABLE: False
  DATASET: ava
  BATCH_SIZE: 8
DATA_LOADER:
  NUM_WORKERS: 2
  PIN_MEMORY: True
NUM_GPUS: 1
NUM_SHARDS: 1
RNG_SEED: 0
OUTPUT_DIR: .
其中,需要根据实际情况进行自定义的内容如下:
- TRAIN
- ENABLE: 设置为True,表明启用训练
- CHECKPOINT_FILE_PATH:这里放的是预训练模型的位置
- AVA
- FRAME_DIR
- FRAME_LIST_DIR
- ANNOTATION_DIR
运行
python tools/run_net.py --cfg configs/AVA/c2/SLOWFAST_32x2_R101_50_50_train.yaml

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 22
 0
- 0


 已为社区贡献5条内容

所有评论(0)