SlowFast使用指南(三)——自建数据集
写在前面
在前两个章节初步使用了SlowFast,使用的都是官方给出的数据集。
附上链接:
本文尝试了使用自己的数据集进行训练,整个训练过程十分不易,整个过程最难的便在数据集的准备,下面附上整个过程。
数据集准备
视频准备
首先需要准备了训练使用到的两个视频,和 SlowFast使用指南(二)一样一个视频用于训练,一个视频用于验证。
视频裁剪
准备完成后,如果视频过长,需要对视频进行裁剪。本文使用到的两个视频均只有10秒左右,故没有进行裁剪。
视频抽帧
裁剪完成后,需要再对视频进行抽帧处理,抽帧分为两种方式
-
1秒1帧:用来标注
#切割图片,每秒1帧
IN_DATA_DIR="./videos"
OUT_DATA_DIR="./labels"

if [[ ! -d "${OUT_DATA_DIR}" ]]; then
  echo "${OUT_DATA_DIR} doesn't exist. Creating it.";
  mkdir -p ${OUT_DATA_DIR}
fi

for video in $(ls -A1 -U ${IN_DATA_DIR}/*)
do
  video_name=${video##*/}

  if [[ $video_name = *".webm" ]]; then
    video_name=${video_name::-5}
  else
    video_name=${video_name::-4}
  fi

  out_video_dir=${OUT_DATA_DIR}/${video_name}/
  mkdir -p "${out_video_dir}"

  out_name="${out_video_dir}/${video_name}_%06d.jpg"

  ffmpeg -i "${video}" -r 1 -q:v 1 "${out_name}"
done
抽1帧完成的效果如下
- 1秒30帧:用于训练(因为slowfast在slow流里1秒会采集到15帧,在fast流里1秒会采集到2帧)
#切割图片,每秒30帧
IN_DATA_DIR="./videos"
OUT_DATA_DIR="./frames"

if [[ ! -d "${OUT_DATA_DIR}" ]]; then
  echo "${OUT_DATA_DIR} doesn't exist. Creating it.";
  mkdir -p ${OUT_DATA_DIR}
fi

for video in $(ls -A1 -U ${IN_DATA_DIR}/*)
do
  video_name=${video##*/}

  if [[ $video_name = *".webm" ]]; then
    video_name=${video_name::-5}
  else
    video_name=${video_name::-4}
  fi

  out_video_dir=${OUT_DATA_DIR}/${video_name}/
  mkdir -p "${out_video_dir}"

  out_name="${out_video_dir}/${video_name}_%06d.jpg"

  ffmpeg -i "${video}" -r 30 -q:v 1 "${out_name}"
done
抽30帧完成的效果如下
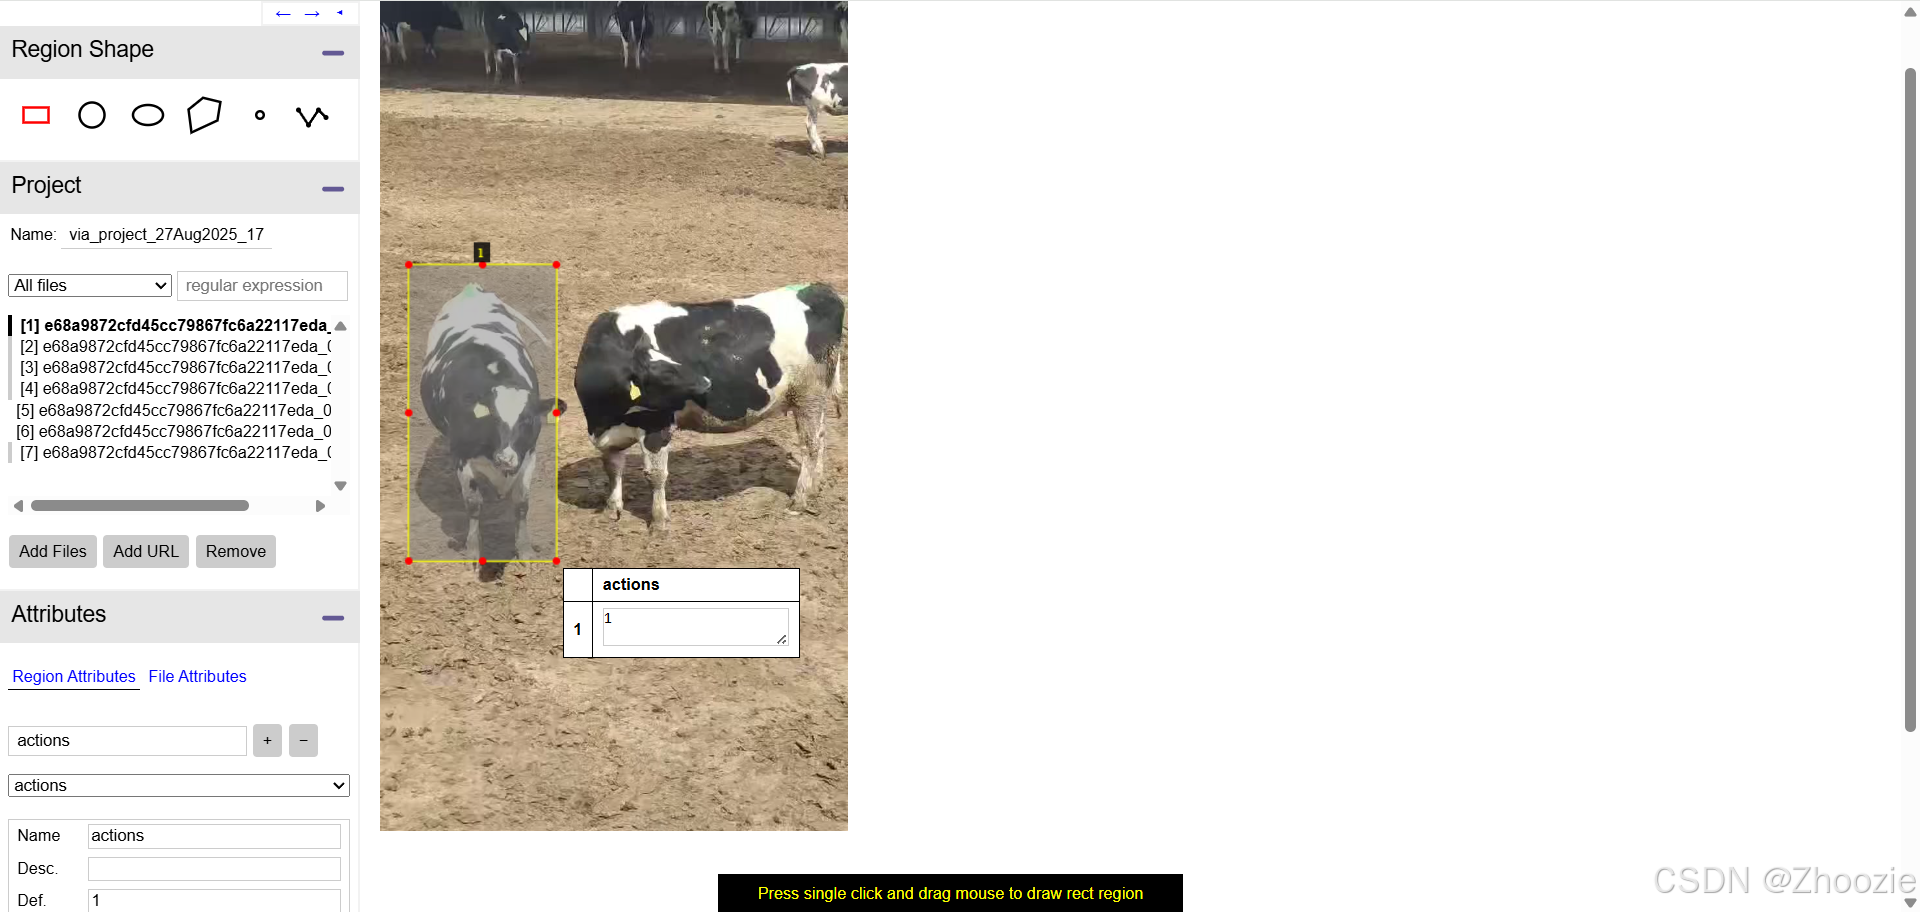
图片标注
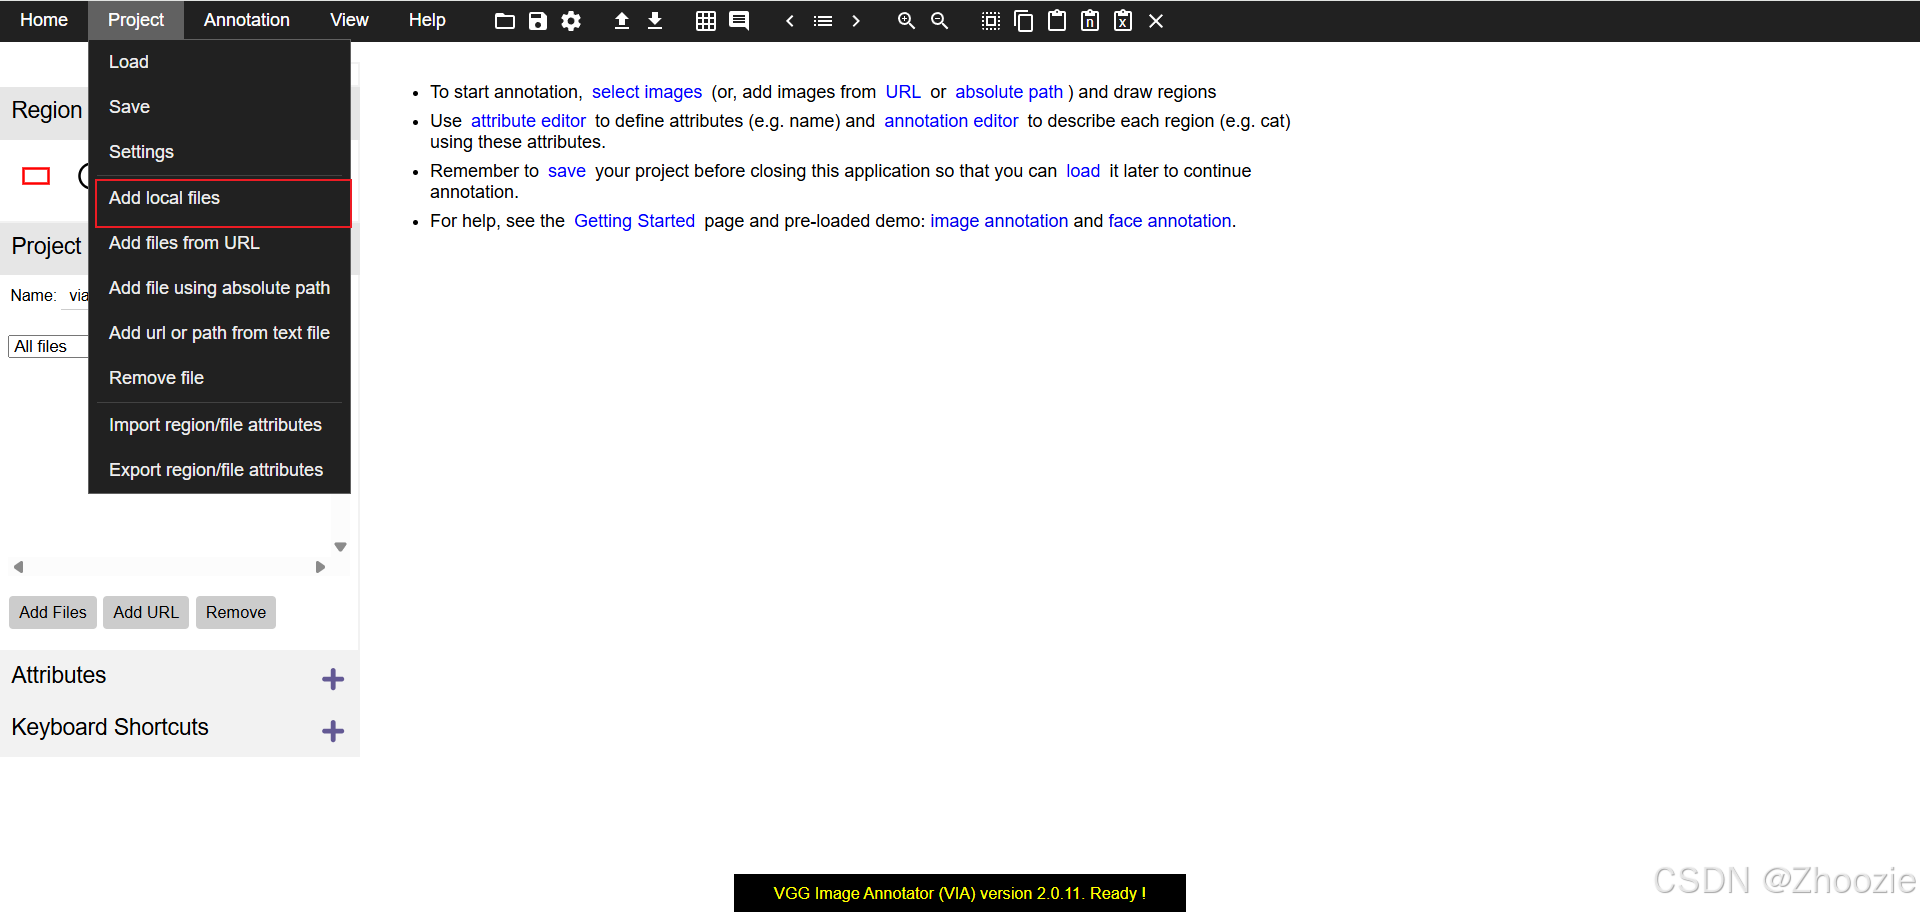
本文采用的是 VGG Image Annotator 进行图片标注的,点击链接进入后。
- 导入图片
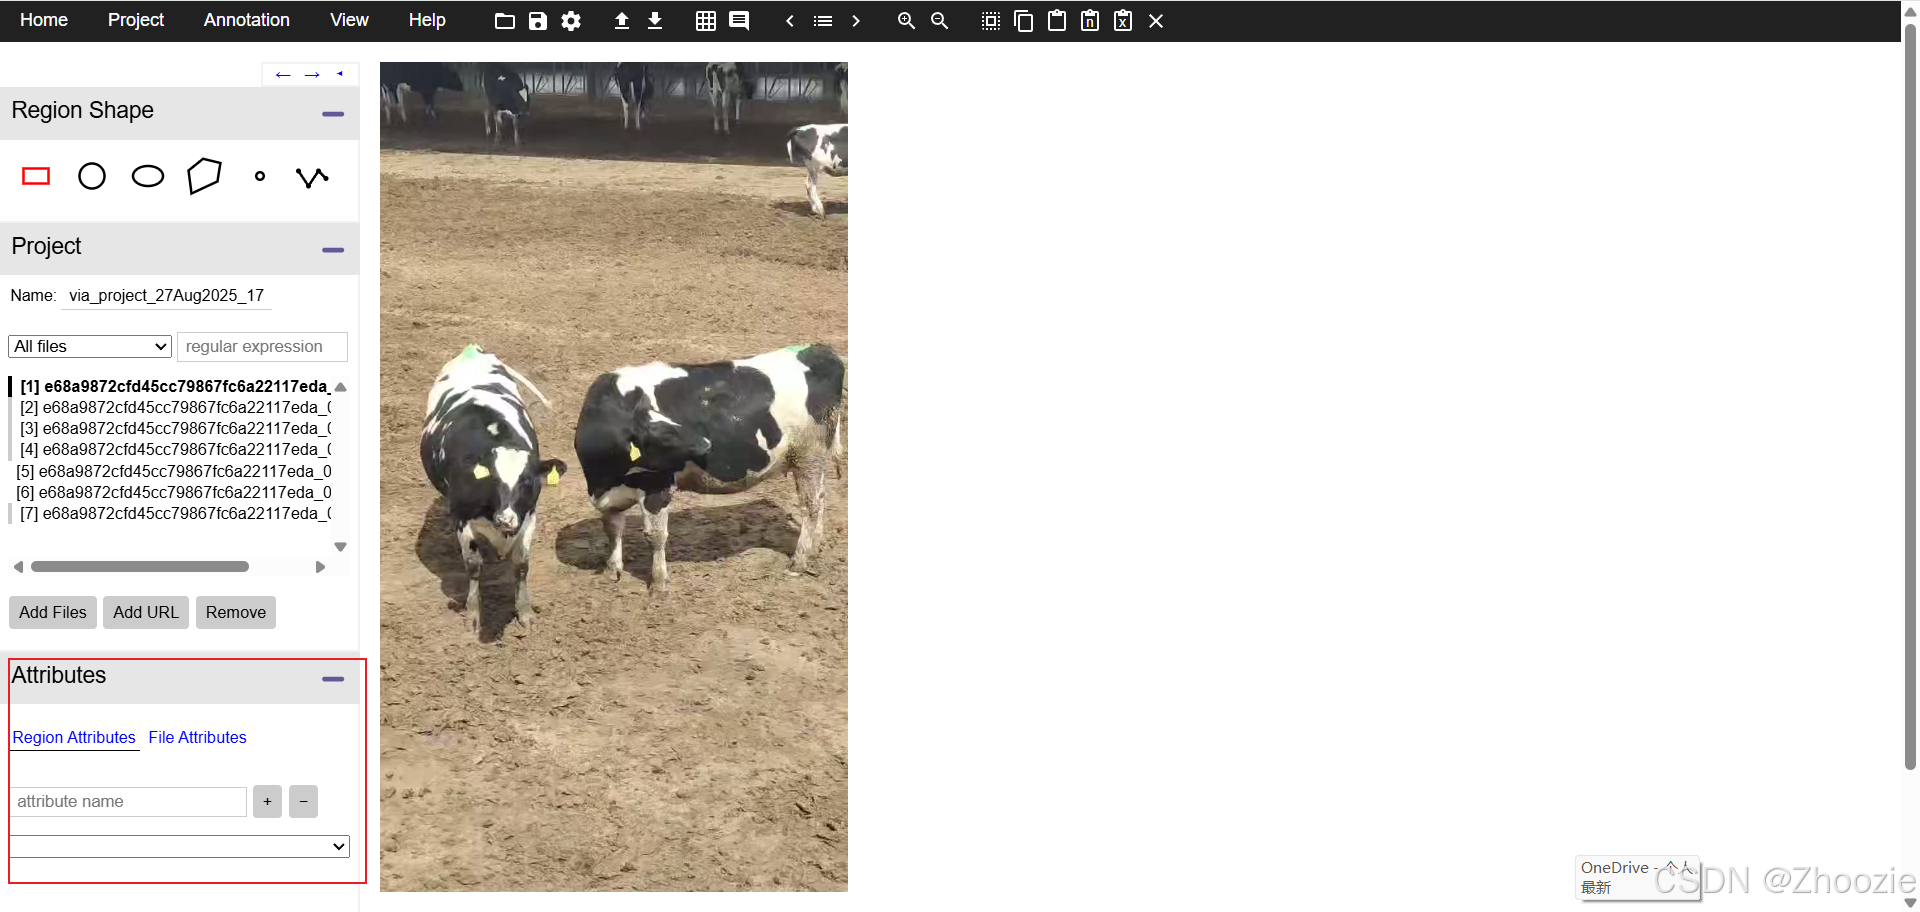
- 创建Attributes
- 画框标注(这里行为的编号,建议从1开始)
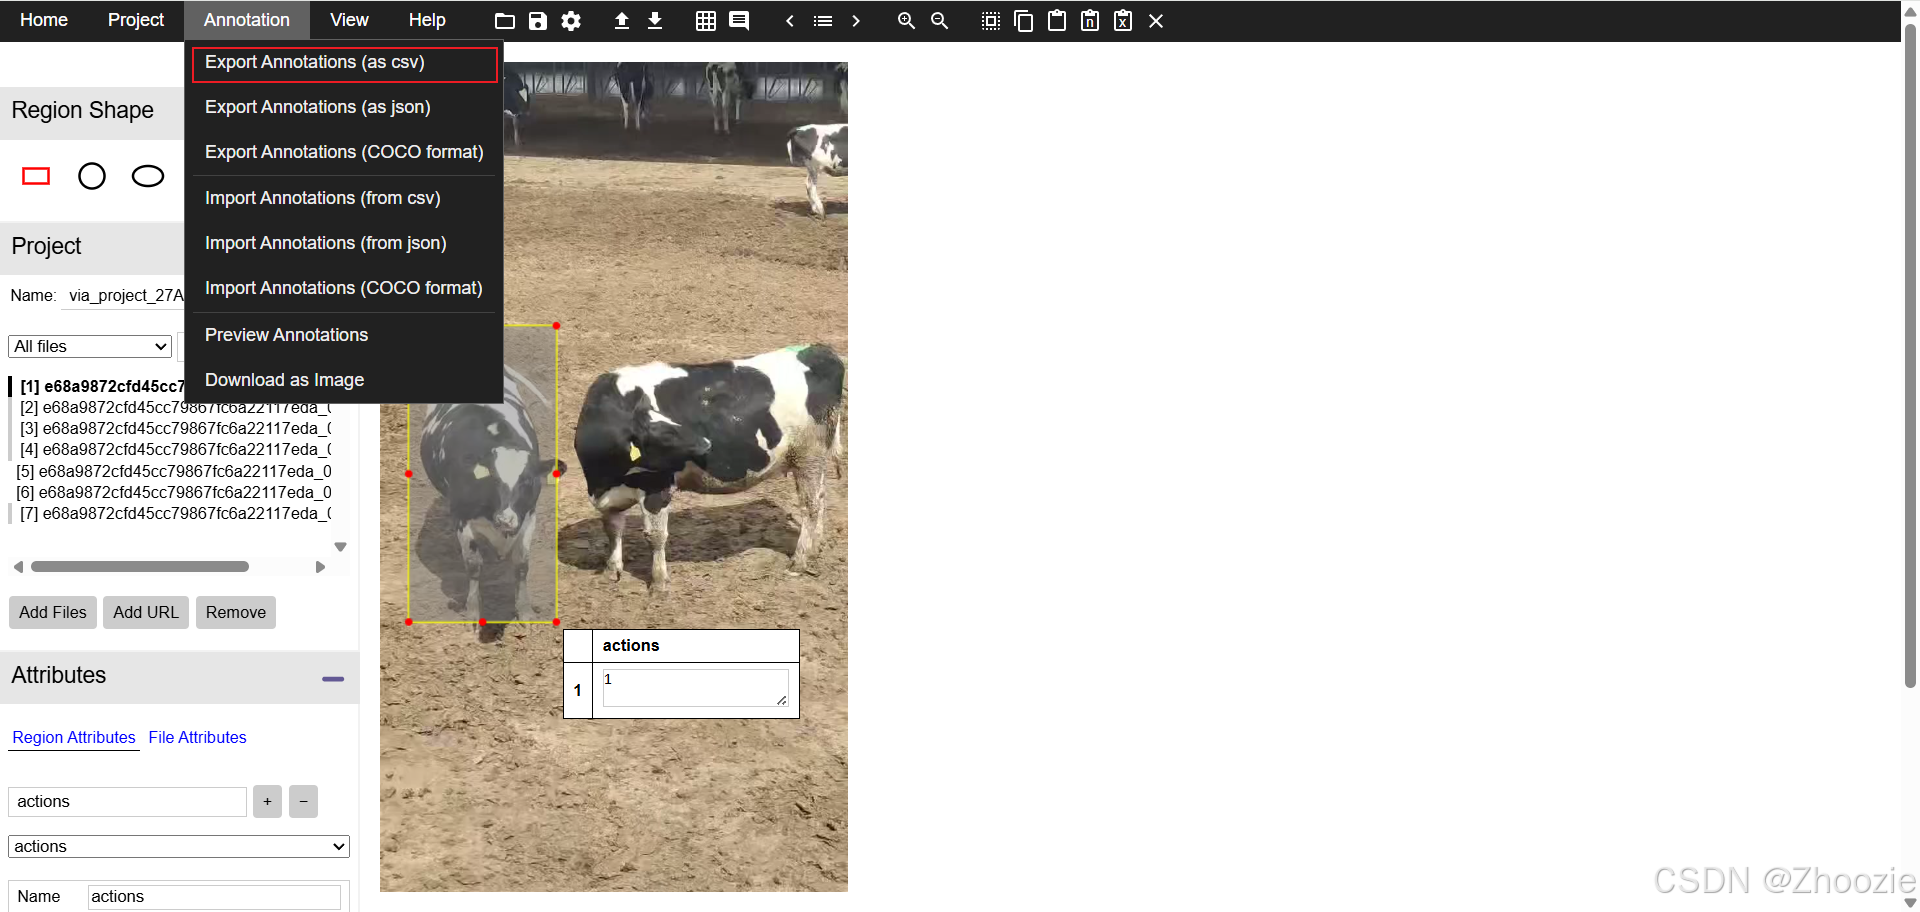
- 导出标注csv文件
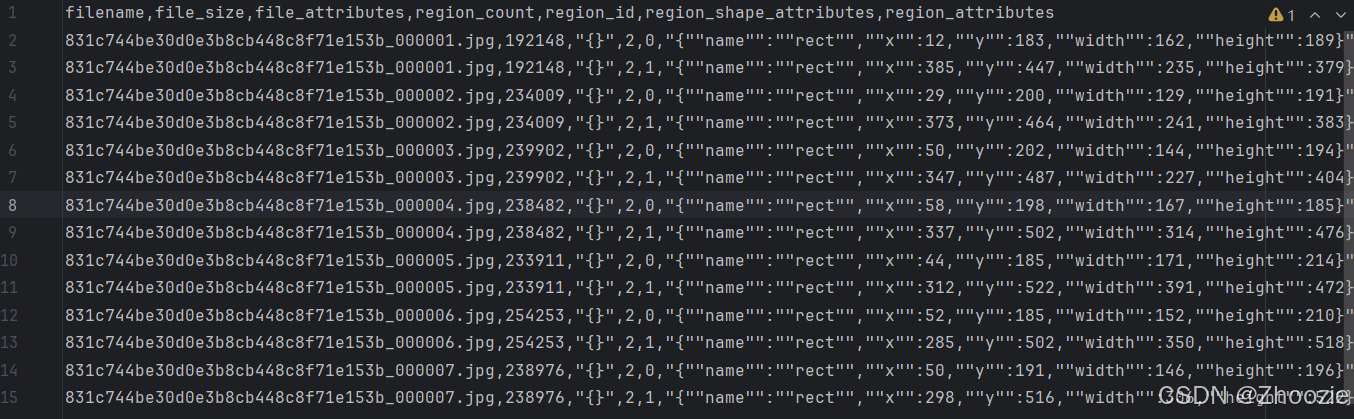
本文由于图片数量较少,采用的是手动标注。如果图片数量较多,建议自动标注。最终得到如下结果。
via转ava
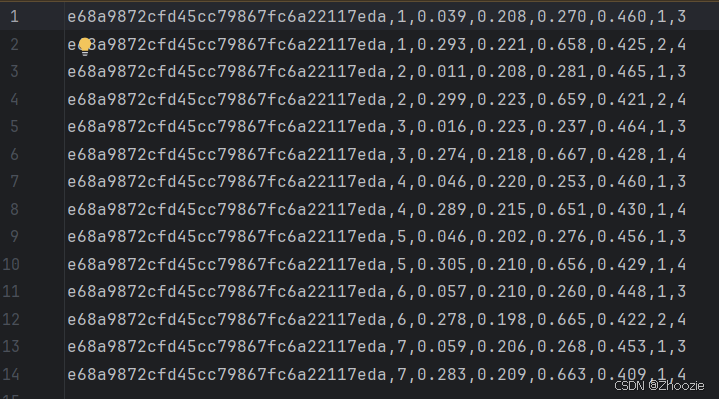
导出的csv格式明显与slowfast所需要的csv格式不相匹配,需要对其进行转换。
import csv

# 输入输出文件
via_csv = "via_project_27Aug2025_14h55m_csv.csv"
ava_csv = "ava_val_v2.2.csv"

# 图像宽高(根据你的实际视频分辨率填写)
IMG_WIDTH = 1080
IMG_HEIGHT = 1920

def via_to_ava(via_csv, ava_csv, img_w=IMG_WIDTH, img_h=IMG_HEIGHT):
    with open(via_csv, newline='') as fin, open(ava_csv, 'w', newline='') as fout:
        reader = csv.DictReader(fin)
        writer = csv.writer(fout)

        for row in reader:
            filename = row['filename']
            video_id = filename.split('_')[0]
            frame_str = filename.split('_')[1].split('.')[0]
            frame_sec = int(frame_str.lstrip('0'))# 每30帧为1秒

            # 解析 region_shape_attributes
            shape = eval(row['region_shape_attributes'])
            x, y, w, h = shape['x'], shape['y'], shape['width'], shape['height']

            # 归一化坐标
            x1 = x / img_w
            y1 = y / img_h
            x2 = (x + w) / img_w
            y2 = (y + h) / img_h

            # 解析 action
            action = eval(row['region_attributes'])['action']
            action_id = int(action)
            person_id = eval(row['region_attributes'])['id']
            person_id = int(person_id)

            # AVA 格式:video_id, frame_sec, x1, y1, x2, y2, action_id, person_id
            writer.writerow([video_id, frame_sec, f"{x1:.3f}", f"{y1:.3f}",
                             f"{x2:.3f}", f"{y2:.3f}", action_id, person_id])

via_to_ava(via_csv, ava_csv)
其中via_csv、ava_csv表示输入路径和输出路径,需要根据实际位置进行修改。IMG_WIDTH 和IMG_HEIGHT 表示图片分辨率,也需要根据实际情况修改。最后得到如下结果。
生成其他配置文件
ava_action_list_v2.2_for_activitynet_2019.pbtxt
item {
  name: "normal"
  id: 1
}
item {
  name: "abnormal"
  id: 2
}
此为你要识别的行为类别,本文识别了两种类别正常和不正常
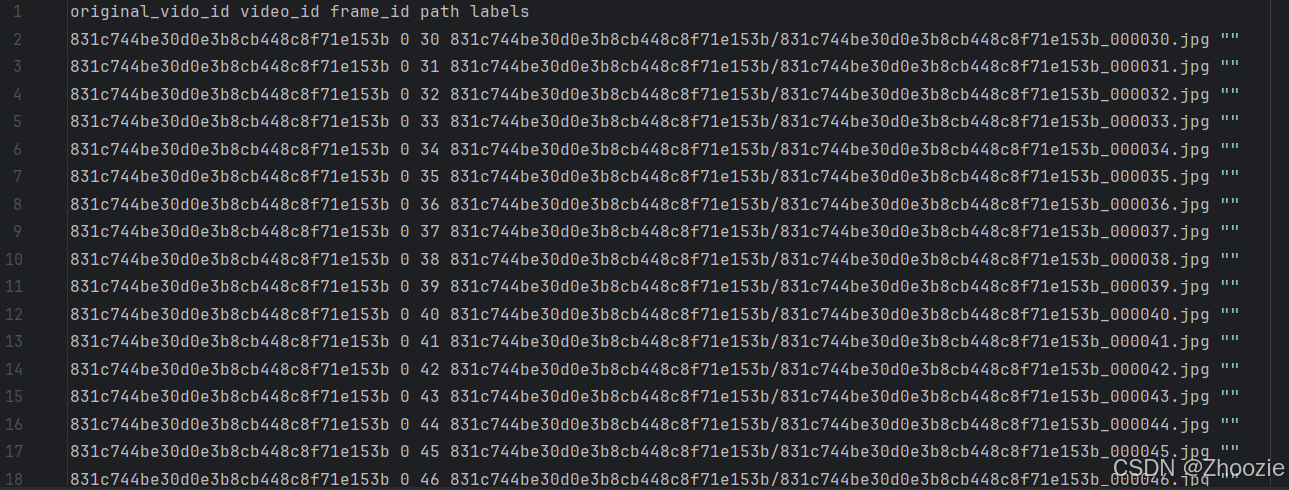
frame_lists
frame_lists下的文件使用1秒抽30帧的图片。
import os
from typing import List, Dict

def build_vid_map(frames_root: str) -> Dict[str, int]:
    """
    返回 目录名 → video_id 的字典序映射
    """
    dirs = sorted([d for d in os.listdir(frames_root)
                   if os.path.isdir(os.path.join(frames_root, d))])
    return {d: idx for idx, d in enumerate(dirs)}

def generate_val_csv(dirs: List[str],
                     frames_root: str = '../frames',
                     out_csv: str = 'frame_lists/val.csv') -> None:
    """
    仅针对给定目录列表生成 val.csv
    :param dirs:        目录名列表,顺序即 video_id
    :param frames_root: 帧根目录
    :param out_csv:     输出文件
    """
    vid_map = build_vid_map(frames_root)
    os.makedirs(os.path.dirname(out_csv), exist_ok=True)
    with open(out_csv, 'w') as f:
        f.write('original_vido_id video_id frame_id path labels\n')
        for orig_vid in dirs:
            vid_id = vid_map[orig_vid]
            vid_dir = os.path.join(frames_root, orig_vid)
            if not os.path.isdir(vid_dir):
                continue
            for fname in sorted(os.listdir(vid_dir)):
                if fname.endswith('.jpg'):
                    frame_id = int(fname.split('_')[-1].split('.')[0])
                    f.write(f'{orig_vid} {vid_id} {frame_id} {orig_vid}/{fname} ""\n')

    print(f'✅ 已生成 {out_csv},目录 {dirs} 已处理')

# ===== 用法 =====
if __name__ == '__main__':
    generate_val_csv(['e68a9872cfd45cc79867fc6a22117eda'])
由于本文是直接指定哪个视频为训练集哪个训练为验证集,故上方代码传递相对应的目录名,即可生成train.csv和val.csv。
最终生成的结果如下
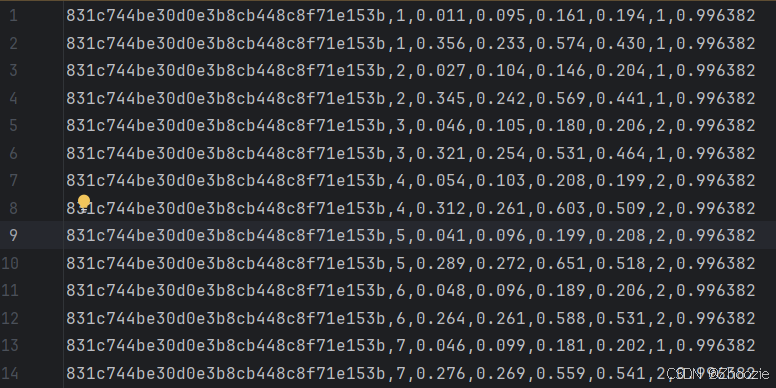
ava_detection_train_boxes_and_labels_include_negative_v2.2.csv
此文件直接对ava_train_v2.2.csv的前七列进行复制,最后一列使用置信度进行填充,置信度设置为0.996382.
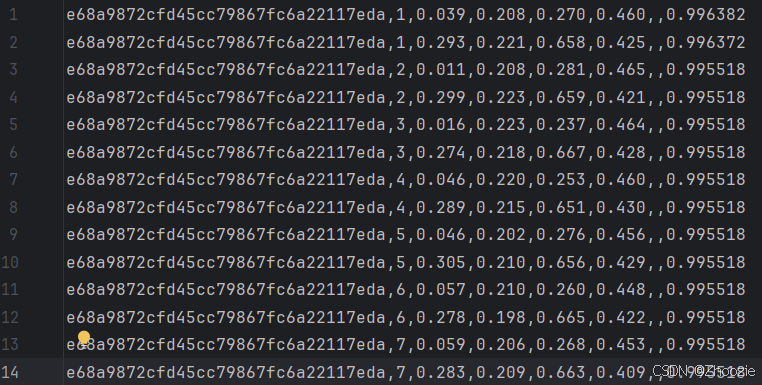
ava_detection_val_boxes_and_labels.csv
此文件对ava_val_v2.2.csv的前六列进行复制,第七列是空值,第八列用置信度填充,然后同样设置置信度。
SLOWFAST_32x2_R50_SHORT5.yaml
在 configs/AVA 目录下创建 SLOWFAST_32x2_R50_SHORT5.yaml 配置文件
TRAIN:
  ENABLE: True
  DATASET: ava
  BATCH_SIZE: 1
  EVAL_PERIOD: 1
  CHECKPOINT_PERIOD: 1
  AUTO_RESUME: True
  CHECKPOINT_FILE_PATH: ''  #path to pretrain model
  CHECKPOINT_TYPE: caffe2
  AUTO_RESUME: True
  CHECKPOINT_EPOCH_RESET: True  # 重置epoch计数
DATA:
  NUM_FRAMES: 32
  SAMPLING_RATE: 2
  TRAIN_JITTER_SCALES: [256, 320]
  TRAIN_CROP_SIZE: 224
  TEST_CROP_SIZE: 224
  INPUT_CHANNEL_NUM: [3, 3]
  PATH_TO_DATA_DIR: '/mnt/workspace/slowfast_project/cowdemo'
DETECTION:
  ENABLE: True
  ALIGNED: True
AVA:
  FULL_TEST_ON_VAL: True
  FRAME_DIR: "/mnt/workspace/slowfast_project/cowdemo/frames"
  FRAME_LIST_DIR: "/mnt/workspace/slowfast_project/cowdemo/frame_lists"
  ANNOTATION_DIR: "/mnt/workspace/slowfast_project/cowdemo/annotations"
  DETECTION_SCORE_THRESH: 0.8
  TRAIN_PREDICT_BOX_LISTS: [
    "ava_train_v2.2.csv",
    "person_box_67091280_iou90/ava_detection_train_boxes_and_labels_include_negative_v2.2.csv",
  ]
  TEST_PREDICT_BOX_LISTS: ["person_box_67091280_iou90/ava_detection_val_boxes_and_labels.csv"]

SLOWFAST:
  ALPHA: 4
  BETA_INV: 8
  FUSION_CONV_CHANNEL_RATIO: 2
  FUSION_KERNEL_SZ: 5
RESNET:
  ZERO_INIT_FINAL_BN: True
  WIDTH_PER_GROUP: 64
  NUM_GROUPS: 1
  DEPTH: 101
  TRANS_FUNC: bottleneck_transform
  STRIDE_1X1: False
  NUM_BLOCK_TEMP_KERNEL: [[3, 3], [4, 4], [6, 6], [3, 3]]
  SPATIAL_DILATIONS: [[1, 1], [1, 1], [1, 1], [2, 2]]
  SPATIAL_STRIDES: [[1, 1], [2, 2], [2, 2], [1, 1]]
NONLOCAL:
  LOCATION: [[[], []], [[], []], [[6, 13, 20], []], [[], []]]
  GROUP: [[1, 1], [1, 1], [1, 1], [1, 1]]
  INSTANTIATION: dot_product
  POOL: [[[2, 2, 2], [2, 2, 2]], [[2, 2, 2], [2, 2, 2]], [[2, 2, 2], [2, 2, 2]], [[2, 2, 2], [2, 2, 2]]]
BN:
  USE_PRECISE_STATS: False
  NUM_BATCHES_PRECISE: 200
SOLVER:
  BASE_LR: 0.1
  LR_POLICY: steps_with_relative_lrs
  STEPS: [0, 10, 15, 20]
  LRS: [1, 0.1, 0.01, 0.001]
  MAX_EPOCH: 20
  MOMENTUM: 0.9
  WEIGHT_DECAY: 1e-7
  WARMUP_EPOCHS: 5.0
  WARMUP_START_LR: 0.000125
  OPTIMIZING_METHOD: sgd
MODEL:
  NUM_CLASSES: 2
  ARCH: slowfast
  MODEL_NAME: SlowFast
  LOSS_FUNC: bce
  DROPOUT_RATE: 0.5
  HEAD_ACT: sigmoid
TEST:
  ENABLE: False
  DATASET: ava
  BATCH_SIZE: 8
DATA_LOADER:
  NUM_WORKERS: 2
  PIN_MEMORY: True
NUM_GPUS: 1
NUM_SHARDS: 1
RNG_SEED: 0
OUTPUT_DIR: .
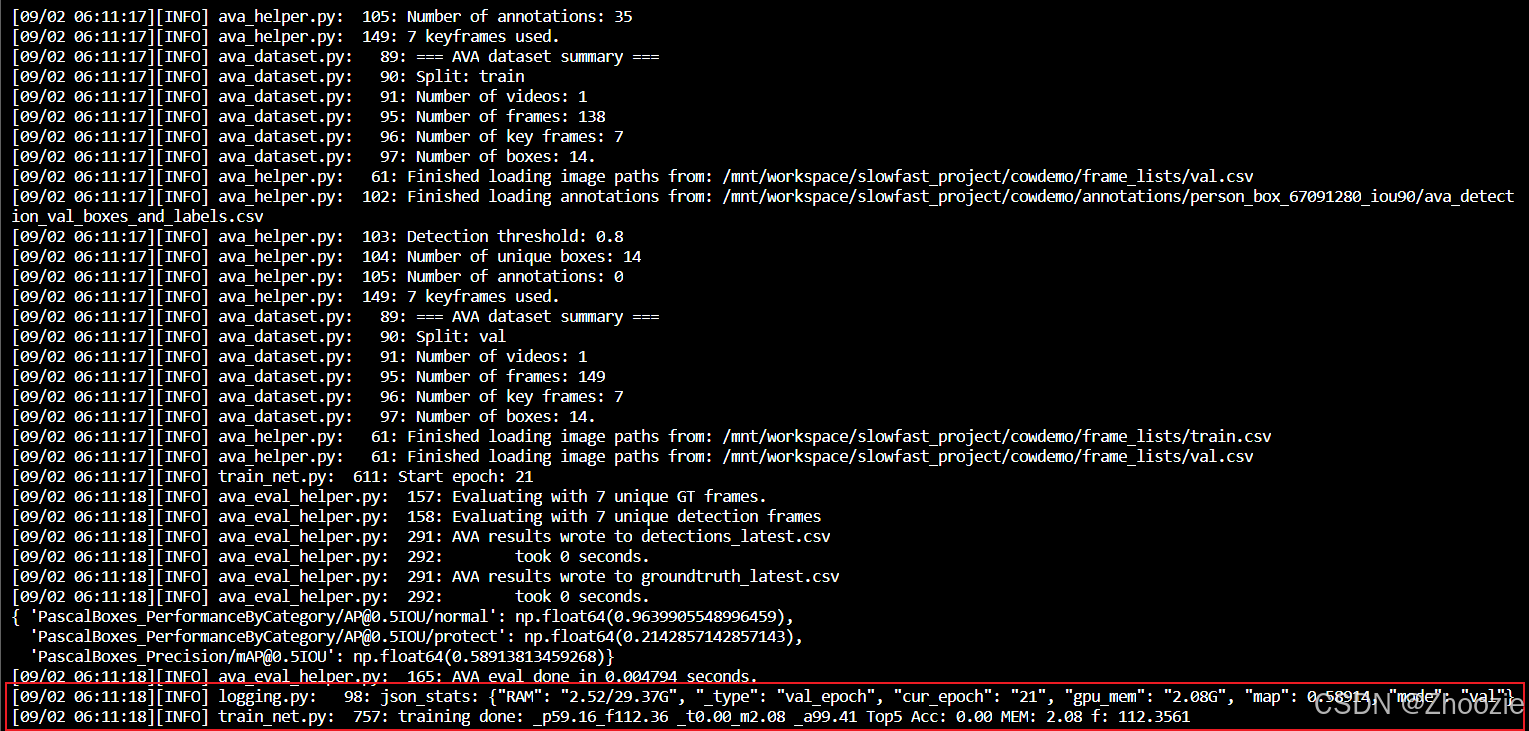
运行
python tools/run_net.py --cfg configs/AVA/SLOWFAST_32x2_R50_SHORT5.yaml最终训练效果如下图所示
问题解决
问题一
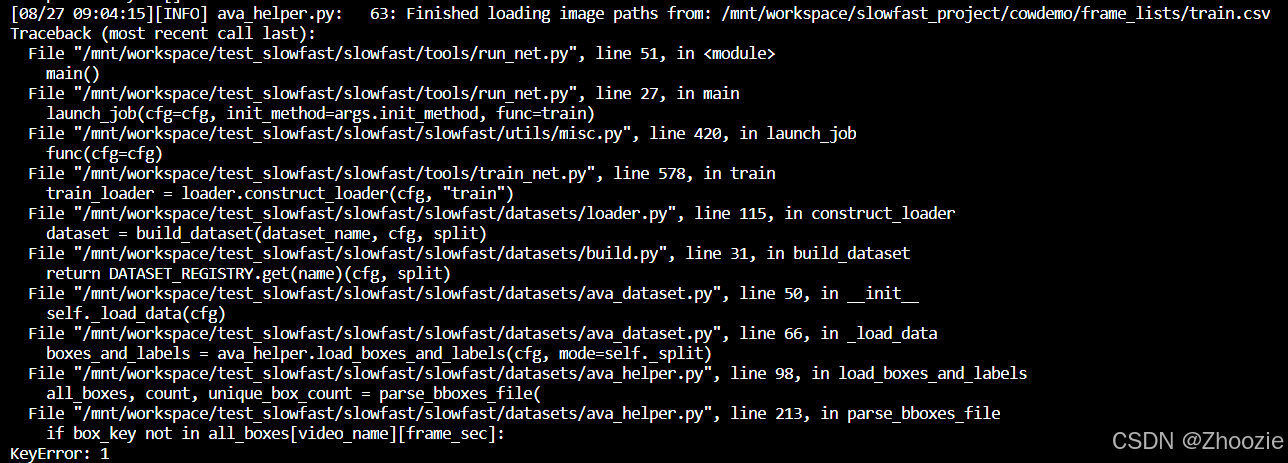
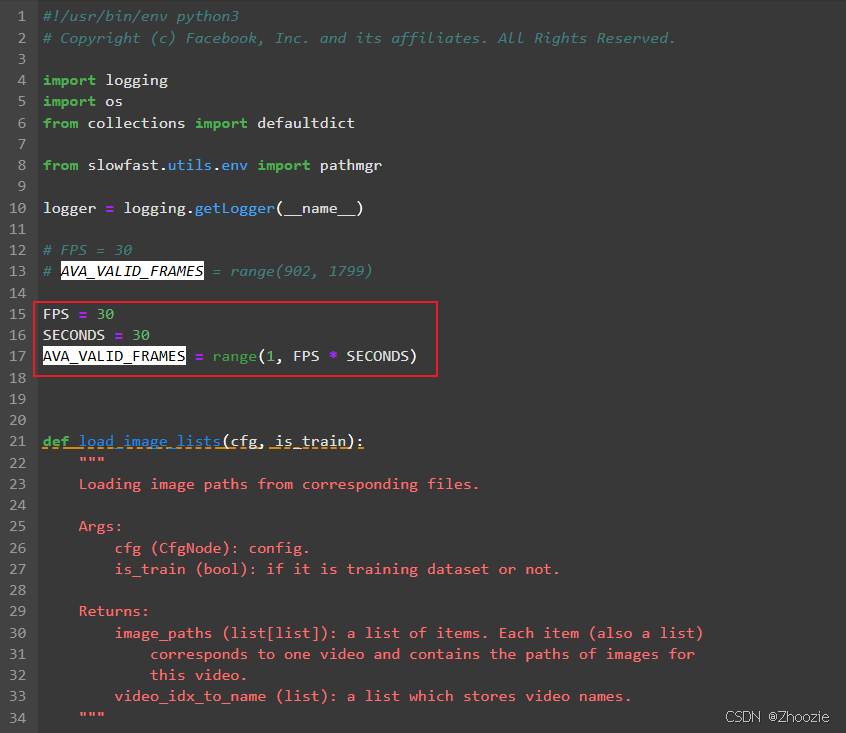
原csv文件是从902秒开始的,但是自己的视频是从第一秒开始的
问题二
使用自制的数据集,使用demo模式测试训练好的模型的效果,得到的输出视频并无检测框。通过查看源代码发现
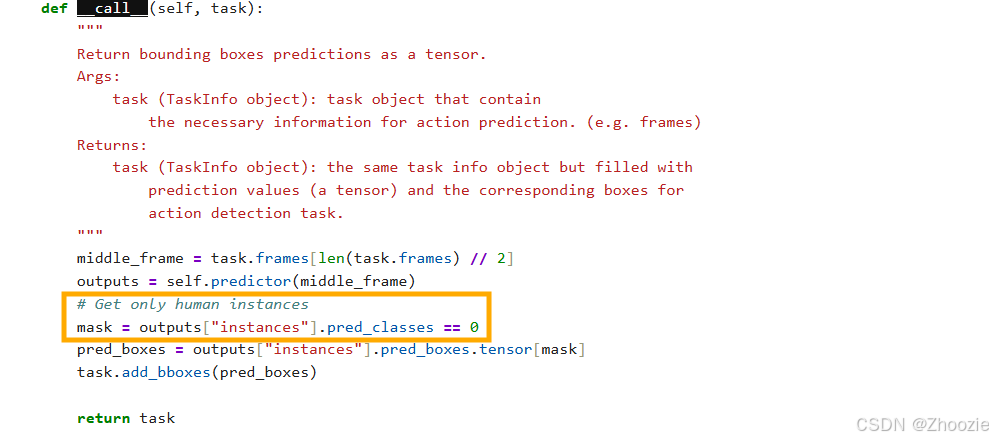
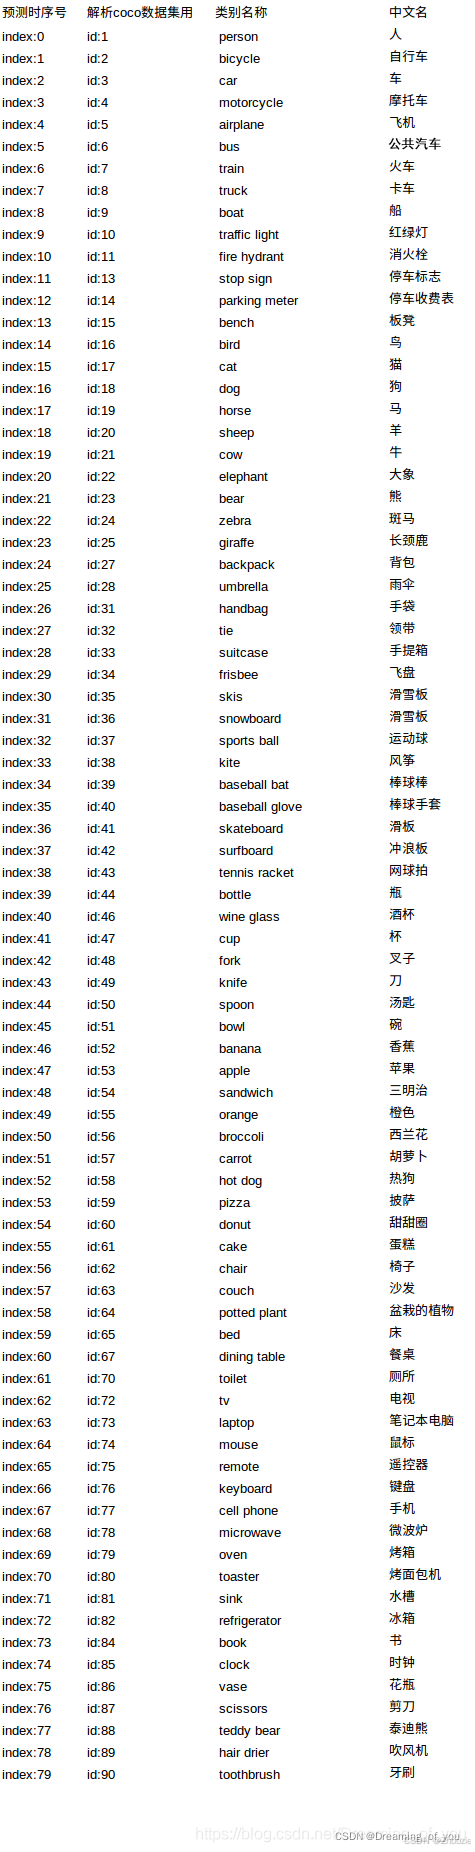
代码只保留类别为 0 的检测框(人类),但我需要识别的行为在COCO数据集中的类别并不为0,所以全部被过滤掉了!将此id修改成需要检测的类别即可(见下图)。
写在后面
当前数据量较少,训练效果不理想。本文仅展示训练自己数据集的过程,后续还需要提升模型效果。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 24
 0
- 0


 已为社区贡献5条内容

所有评论(0)