似然函数-对数似然函数-最大似然估计MLE--计算梯度方向
似然函数(Likelihood Function)
在数理统计学中,似然函数是一种关于统计模型中的参数的函数,表示模型参数中的似然性。
给定输出x时,关于参数θ的似然函数L(θ|x)(在数值上)等于给定参数θ后变量X的概率:
离散:
连续
此处并非条件概率密度函数。
似然函数的主要用法在于比较它相对取值,虽然这个数值本身不具备任何含义
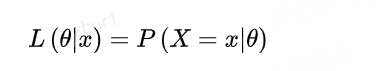
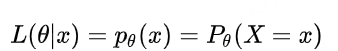
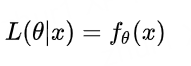
与概率的区别
- 概率:固定参数θ,描述事件x发生的可能性(正向问题)
- 似然:固定观测数据x,评估参数θ的合理性(逆向问题)。
例如,抛硬币实验中,
概率描述“已知硬币对称时出现10次正面的可能性”,
而似然描述“观察到10次正面时硬币对称的可能性”。
似然函数与概率密度函数(Probability Density Function,简称PDF)
两者都是描述数据和参数关系的重要数学工具。
在形式上具有相似性
在解释、用途和计算方面有着明显的不同。
概率密度函数(Probability Density Function, PDF)
- 定义
概率密度函数描述了一个连续随机变量在各个特定值上的“密度”,也就是该值出现的相对可能性。对于离散随机变量,这个概念被称为概率质量函数(Probability Mass Function, PMF)。区别与联系
- 角色互换:
在概率密度函数中,参数是固定的,我们考虑数据的变化。
在似然函数中,数据是已知的,我们考虑参数的变化。- 目的不同:
概率密度函数用于描述数据生成模型
而似然函数用于基于观察到的数据进行参数估计。- 数学性质:
概率密度函数需要满足概率的公理(如非负性,积分(或求和)为1)
而似然函数没有这样的要求。
核心应用
- 最大似然估计(MLE):通过最大化似然函数寻找最优参数,如估计正态分布的均值和方差。
- 似然比检验:比较不同假设下的似然值,用于模型选择或假设检验。
- 贝叶斯推断:作为后验概率计算的组成部分,结合先验分布更新参数估计
- 似然函数与梯度下降:
在机器学习中,尤其是深度学习领域,梯度下降是最常用的优化算法。然而,不同的损失函数(即负对数似然函数)可能导致不同的优化性能和模型泛化能力。理解似然函数如何与梯度下降算法交互,有助于我们更有效地训练模型。- 模型选择与复杂度:
在现实应用中,选择一个“最佳”模型通常涉及到复杂度与准确性之间的权衡。通过似然函数,我们可以更直观地评估模型复杂度与数据拟合度之间的关系,从而进行更合理的模型选择。- 似然函数与不确定性:
在现实世界的很多问题中,数据往往具有噪声和不确定性。似然函数为我们提供了一种量化不确定性的方式,进一步,我们甚至可以通过贝叶斯方法,将先验信息与似然函数相结合,以更全面地理解数据和模型。- 似然函数与生成模型:
在非监督学习和生成模型(如GANs)中,似然函数的概念有时会被重新定义或拓展,以适应更复杂或高维的数据结构。理解这些扩展或变种的数学基础,可以为研究和应用这些先进模型提供有力的支撑。
对数似然函数
涉及到似然函数的许多应用中,更方便的是使用似然函数的自然对数形式,即“对数似然函数”。求解一个函数的极大化往往需要求解该函数的关于未知参数的偏导数。由于对数函数是单调递增的,而且对数似然函数在极大化求解时较为方便,所以对数似然函数常用在最大似然估计及相关领域中。
最大似然估计MLE
估计似然函数的最大值,一般取对数似然
最大似然估计(Maximum Likelihood Estimation, MLE)
最大似然估计是似然函数最初也是最自然的应用。
似然函数取得最大值表示相应的参数能够使得统计模型最为合理。
从这样一个想法出发,最大似然估计的做法是:
首先选取似然函数(一般是概率密度函数或概率质量函数),整理之后求最大值。
实际应用中一般会取似然函数的对数作为求最大值的函数,这样求出的最大值和直接求最大值得到的结果是相同的。
似然函数的最大值不一定唯一,也不一定存在。
与矩法估计比较,最大似然估计的精确度较高,信息损失较少,但计算量较大。
想法:采样结果如何得到fD, 难点在于评估分布参数θ
给定一个概率分布D,
假定其概率密度函数(连续分布)或概率聚集函数(离散分布)为fD,以及一个分布参数θ,
我们可以从这个分布中抽出一个具有n个值的采样X1,X2,…,Xn,通过利用fD,我们就能计算出其概率:
但是,我们可能不知道θ的值,尽管我们知道这些采样数据来自于分布D。那么我们如何才能估计出θ呢?
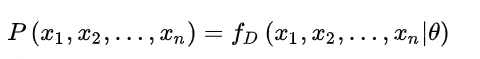
想法:采样数据来估计θ
一个自然的想法是从这个分布中抽出一个具有n个值的采样X1,X2,…,Xn,然后用这些采样数据来估计θ。
一旦我们获得X1,X2,…,Xn,我们就能从中找到一个关于θ的估计。
方法1:θ的非偏估计
非偏估计未必会输出一个最可能的值,而是会输出一个既不高估也不低估的θ值。
方法2:最大似然估计
寻找关于 θ的最可能的值(即,在所有可能的θ取值中,寻找一个值使这个采样的“可能性”最大化)
最大似然估计MLE
要在数学上实现最大似然估计法,我们首先要定义可能性:
并且在θ的所有取值上,使这个函数最大化。这个使可能性最大的值即被称为θ的最大似然估计。
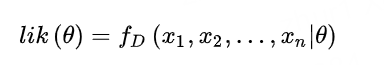
似然比检验
似然比检验是利用似然函数来检测某个假设(或限制)是否有效的一种检验。
检验方法:与不加入时的简单模型对比
一般情况下,要检测某个附加的参数限制是否是正确的,可以将加入附加限制条件的较复杂模型的似然函数最大值与之前的较简单模型的似然函数最大值进行比较。
如果参数限制是正确的,那么加入这样一个参数应当不会造成似然函数最大值的大幅变动。
一般使用两者的比例来进行比较,这个比值是卡方分配。
尼曼-皮尔森引理说明,似然比检验是所有具有同等显著性差异的检验中最有统计效力的检验。
基本思想:
似然比检验是一种寻求检验方法的一般法则。
其基本思想如下:
设由n个观察值X1,X2,…,Xn组成的随机样本来自密度函数为f(X; θ)的总体,其中θ为未知参数。
要检验的无效假设是H0: θ=θ0,
备择假设是H1:θ≠θ0,检验水准为α。
为此,求似然函数在θ=θ0处的值与在θ=θ(极大点)处的值(即极大值)之比,记作λ,可以知道:
- (1) 两似然函数值之比值λ只是样本观察值的函数,不包含任何未知参数。
- (2) 0≤λ≤1,因为似然函数值不会为负,且λ的分母为似然函数的极大值,不会小于分子。
- (3)越接近θ0时,λ越大;反之,与θ0相差愈大,λ愈小。
因此,若能由给定的α求得显著性界值λ0,则可按以下规则进行统计推断:
- 当λ≤λ0,拒绝H0,接受H1;当λ>λ0,不拒绝H0,
- 这里 P(λ≤λ0)=α。(2)对于离散型的随机变量,只需把密度函数置换成概率函数p(X;θ),即这一检验方法还可以推广到有k个参数的情形。
但是,要确定λ的界值λ0,必须知道当H0成立时λ的分布。
当不了解λ的分布或者它的分布太复杂时,就难于确定其界值λ0,
此时可利用下述统计原理:
- 当样本含量n较大时,-2lnλ (本书中用符号G表示)近似x2分布;
- 当自由度大于1,甚至n较小时,这种近似的程度也是相当满意的。
基于上述原理,统计中广泛应用对数似然比检验,通过计算统计量G,可按x2分布处理,不但计算方便,而且只要自由度大于1,就不必考虑理论频数大小的问题。
关于似然比检验的具体应用,详见条目“频数分布的拟合优度”、“两样本率比较”、“多个样本率比较”、“样本构成比的比较”以及“计数资料的相关分析”等。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 15
 0
- 0


 已为社区贡献4条内容

所有评论(0)