【数学建模】美赛20C题全流程+可视化
[目录]
0.行文概述
1.Summary
2.Task One
3.Task Two
4.总结
0. 行文概述
收到许多读者的强烈呼声,本数模小组还是决定将2020美赛C题的全流程与可视化开源。因为这是一道以NLP(自然语言处理)为主的题目,故几个与NLP强相关的小问就不再赘述,请参考:
希望获取源代码与数据的读者,公众号(HORSE RUNNING WILD)后台回复关键词:2020美赛C题。
PS:本次本人并没有承担所有的Coding工作,故不会有全部的源码,仅有NLP部分的源码。在此处让我们赞美我们小组里技艺逐渐精进的两位队员!
Summary
(和背景相关的套话)
针对问题一,我们对数据进行了详尽的数据预处理并且开展了特征工程,调用 nltk \texttt{nltk} nltk库对于评论文本的情感倾向进行评分,随即便对数据集的关键因素开展了相关性分析。为了进一步研究诸如star_rating等因素对于helpfulness_rating的定量影响程度,我们建立了有序Logistic回归模型。以hair_drier为例,结果可见评论的情感倾向与helpful_votes对于helpfulness_rating的影响程度最大。
针对问题2.a,我们的重点在于捕捉用户评论中的关键词,用于确定阳光公司的最佳测量度。为此,我们采用TF-IDF的方法将文本实现序列化,并采用LDA模型来挖掘文本的潜在主题与关键词,并且进行了词云图的可视化。以hair_drier为例,在我们划分划分的三个主题中,主题3的关键词围绕着物流快捷程度和产品灵活性为主,为公司提供了一种产品优化的方向。
针对问题2.b,我们将“声誉”定义为某品牌产品在某日的平均star数,并采用了Theil-Sen和Mann-Kendall两种时间序列趋势分析的方法,用于研究某品牌产品的声誉遂时间的变化
针对问题2.c,为了确定最能表明潜在成功或失败产品的基于文本的度量和基于评级的度量的组合,我们定义了SSCWH,即基于评论质量加权的情感-星级评分准则。
对于分析评论与其它因素相关性的问题2.d与问题2.e,我们首先采用三种相关系数对每个星级的平均评论长度平均情感倾向得分进行了相关性分析,并绘制了各星级的词云图;其后又筛选出评论中具有强情感倾向的词汇,与诸如star_rating在内的变量进行了相关性分析。
Task One
题目
分析提供的三个产品数据集,以数学证据来鉴定,描述和支持有意义的定量和/或定性模式,关系,测度和参数。这些将在星级,评论和帮助等级(KaTeX parse error: Expected 'EOF', got '_' at position 20: …ttt{helpfulness_̲rating})之内和之间进行。
数据准备
我们主要干了这麽几件事:
-
数据预处理
C题是数据题,数据预处理是重点,尤其是本题还是NLP的问题。这一部分应该把Tokenization讲清楚。当然也可以补充一些其它的处理方式,例如使用 nltk \texttt{nltk} nltk库对无关评论的过滤。
-
情感倾向得分计算
这一部分即为3.2.2节中,调用 nltk \texttt{nltk} nltk库计算评论的情感倾向得分,属于NLP中的重头环节。
数据特征可视化
-
描述性可视化
画图也是老生常谈的重点。譬如绘制一些箱型图、概率密度直方图来表征数据的特点。
-
相关性分析
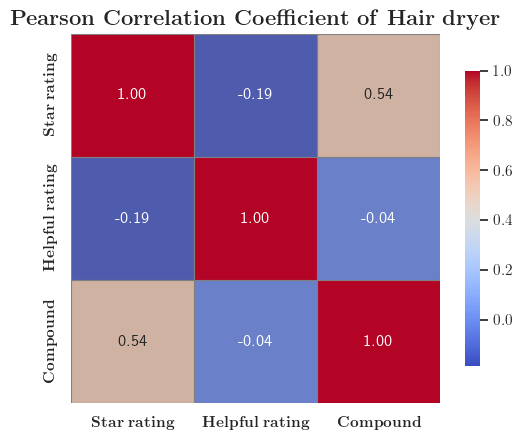
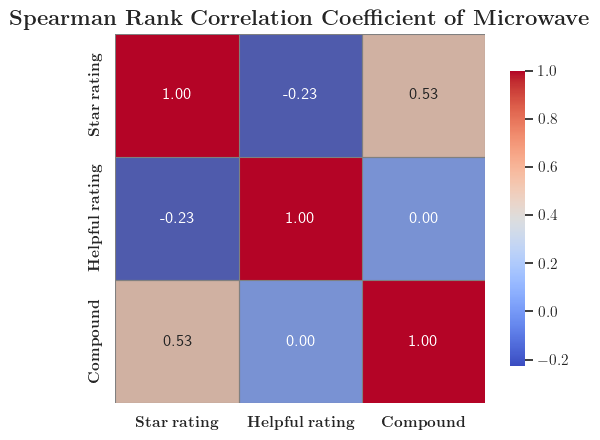
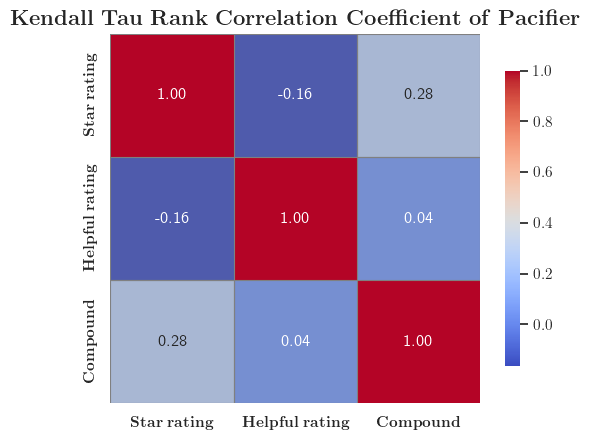
计算星级、评论和帮助等级之间的相关系数。我们计算了Pearson、Spearman以及Kendall三种相关系数,用于定量描述这几个变量之间的相关性。
对于不同相关系数之间的差异,此处应该可以从原理上解释一下
关于此处所谓的“帮助等级(KaTeX parse error: Expected 'EOF', got '_' at position 20: …ttt{helpfulness_̲rating})”在数据集中实际上是并未给出的,所以需要我们自己定义:
H R = { 0 if h v = 0 1 if h v ≤ 3 2 if 3 < h v ≤ 10 3 if 10 < h v ≤ 50 4 if 50 < h v HR = \begin{cases} 0 & \text{if } hv = 0 \\ 1 & \text{if } hv \leq 3\\ 2& \text{if } 3< hv \leq 10\\ 3& \text{if } 10< hv \leq 50\\ 4& \text{if } 50< hv \\ \end{cases} HR=⎩ ⎨ ⎧01234if hv=0if hv≤3if 3<hv≤10if 10<hv≤50if 50<hv
其中 H R HR HR 为 KaTeX parse error: Expected 'EOF', got '_' at position 20: …ttt{helpfulness_̲rating} , h v hv hv 为数据集中给出的helpful_votes。我们分别给出
回归模型分析
多分类Logitic回归模型
相关性分析常常不能满足我们的野心
为了进一步分析诸如star rating的指标对于helpfulness ratings的影响程度,我们最直观的想法便是,将star rating等指标作为自变量,helpfulness ratings作为因变量,建立一个回归模型,通过比较(标准化后的)回归系数,判断各自变量的影响程度。
只不过在此处,因变量是一个分类变量,我们便不再采用线性回归,而是采用机器学习中用于处理分类问题常用的Logistic回归;又因为helpfulness ratings不只是两个类别,而是多个有序的级别,遂采用有序Logitic回归模型。
注意对有序的理解。假如因变量是诸如苹果、梨和香蕉这样不存在什么递进关系的,就是无序的多分类问题。对Logitic回归模型不了解的读者,建议参考【小白学统计】。
在此处就不再赘述模型原理,先强调一下在二元回归中必备的步骤,有序回归中类似:
-
哑变量转换-连续型自变量不必在意,分类变量转化为数字。例如教育水平可以将小学、初中、高中、大学映射为 1 , 2 , 3 , 4 1,2,3,4 1,2,3,4。
-
单因素检验: 使用t检验分析连续型自变量(如家庭收入、负债收入比率、信用卡负债)与因变量的关系,使用卡方检验分析分类变量(如教育水平、雇佣时长)与因变量的关系。一般以检验得到的p值小于0.1或0.05来判定为有相关性。
-
建立模型、模型检验。模型公式不再赘述,检验方法有模型似然比检验、Hosmer-Lemeshow拟合度检验。
-
核心:结果分析。 解释回归系数与OR值。
如果现在我们以回归系数来比较自变量对因变量的影响程度,那可就上套了。因为,在一开始就缺少了最重要的一步——数据标准化。比较两个量纲存在极大差异的数据的回归系数是毫无意义的。
值得注意的是,对于Logitic回归,其数据标准化的方式与一般的线性回归的数据标准化方式并不相同。可以参考如下公式进行变换:
Z
X
i
=
X
i
−
X
ˉ
D
X
,
Z
Y
i
=
Y
i
−
Y
ˉ
D
Y
,
Z_{X_i} = \frac{X_i -\bar{X} }{\sqrt{DX}},Z_{Y_i} = \frac{Y_i -\bar{Y} }{\sqrt{DY}},
ZXi=DXXi−Xˉ,ZYi=DYYi−Yˉ,
D X , D Y DX,DY DX,DY为样本方差。其目标是将每个变量的均值为0,标准差为1的高斯分布,也是概率统计课程的经典结论了。
此处也可以直接调用 sklearn \texttt{sklearn} sklearn库中的 Standardscaler \texttt{Standardscaler} Standardscaler。
结果展示
对单因素进行t-检验时,发现绝大多数自变量都能通过与因变量各个等级的t检验,故正常建立模型。
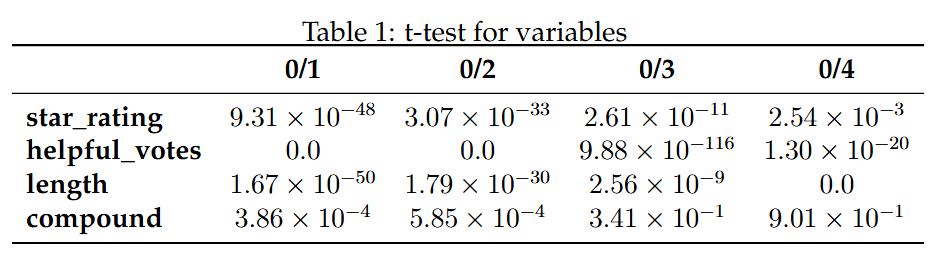
下面我们给出回归模型的结果(以hair_drier为例):
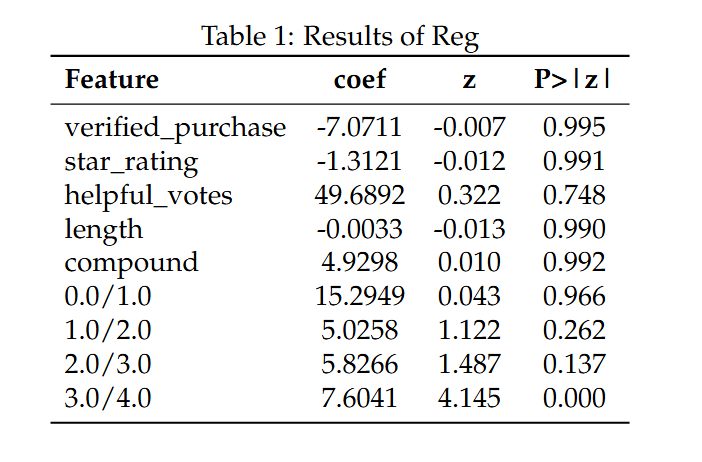
用于建立模型的数据已经经过了标准化,故可以直接通过相关系数的正负与大小来比较各因素对于KaTeX parse error: Expected 'EOF', got '_' at position 20: …ttt{helpfulness_̲rating}的影响。
从结果我们可以发现,自变量对因变量的影响都不显著( P P P值远大于 0.1 0.1 0.1),但在我们只关心系数的正负与相对大小的情况下,我们可以发现,无异KaTeX parse error: Expected 'EOF', got '_' at position 14: \text{helpful_̲votes} 对 KaTeX parse error: Expected 'EOF', got '_' at position 20: …ttt{helpfulness_̲rating} 存在最为显著的影响,这也与我们的定义一致。
Task Two
Task Two a d e
a
确定评级和评论的数据度量,一旦他们的三种产品在线上市场销售,这些数据对阳光公司来说是最有用的信息。
d
具体的星级会引起更多评论吗? 例如,在看到一系列低星评级之后,顾客是否更有可能发表某种类型的评论?
e
文本评论的具体质量描述(如“热情”,“失望”等)与评分水平是否密切相关?
再次给出本人细讲NLP的文章,每一问都可以对应参考:
Task Two b
识别和讨论每个数据集当中基于时间的度量和模式,这些度量和模式可能表明一个产品的声誉在线上市场上正在上升或下降。
我们将声誉定义为某品牌产品在某日的平均Star数。为了进行时间序列趋势分析,我们采用了Theil-Sen和Mann-Kendall两种方法。下面进行简要介绍。
Theil-Sen
Theil-Sen 估计器是一种用于估计数据趋势的非参数方法,特别适用于存在异常值或数据不服从正态分布的情况。以下是 Theil-Sen 估计器的详细介绍:
Theil-Sen 估计器通过计算数据点对的斜率中位数来估计趋势。具体步骤如下:
- 计算斜率:对于每一对数据点 ( x i , y i ) (x_i, y_i) (xi,yi) 和 ( x j , y j ) (x_j, y_j) (xj,yj),计算斜率 m i j = y j − y i x j − x i m_{ij} = \frac{y_j - y_i}{x_j - x_i} mij=xj−xiyj−yi,其中 i < j i < j i<j。
- 斜率中位数:对所有计算出的斜率 m i j m_{ij} mij 进行排序,取中位数作为最终的斜率估计值。
- 截距计算:使用斜率中位数和数据点的中位数计算截距,即 b ^ = median ( y i ) − m ^ ⋅ median ( x i ) \hat{b} = \text{median}(y_i) - \hat{m} \cdot \text{median}(x_i) b^=median(yi)−m^⋅median(xi)。
具体步骤
- 数据准备:假设有一组时间序列数据 ( x 1 , y 1 ) , ( x 2 , y 2 ) , … , ( x n , y n ) (x_1, y_1), (x_2, y_2), \ldots, (x_n, y_n) (x1,y1),(x2,y2),…,(xn,yn)。
- 计算斜率:对于每一对数据点
(
x
i
,
y
i
)
(x_i, y_i)
(xi,yi) 和
(
x
j
,
y
j
)
(x_j, y_j)
(xj,yj),计算斜率:
m i j = y j − y i x j − x i m_{ij} = \frac{y_j - y_i}{x_j - x_i} mij=xj−xiyj−yi
其中 i < j i < j i<j。 - 斜率中位数:对所有计算出的斜率 m i j m_{ij} mij 进行排序,取中位数作为最终的斜率估计值 m ^ \hat{m} m^。
- 截距计算:计算数据点的中位数
median
(
x
i
)
\text{median}(x_i)
median(xi) 和
median
(
y
i
)
\text{median}(y_i)
median(yi),然后计算截距:
b ^ = median ( y i ) − m ^ ⋅ median ( x i ) \hat{b} = \text{median}(y_i) - \hat{m} \cdot \text{median}(x_i) b^=median(yi)−m^⋅median(xi) - 趋势线:最终的趋势线为:
y = m ^ ⋅ x + b ^ y = \hat{m} \cdot x + \hat{b} y=m^⋅x+b^
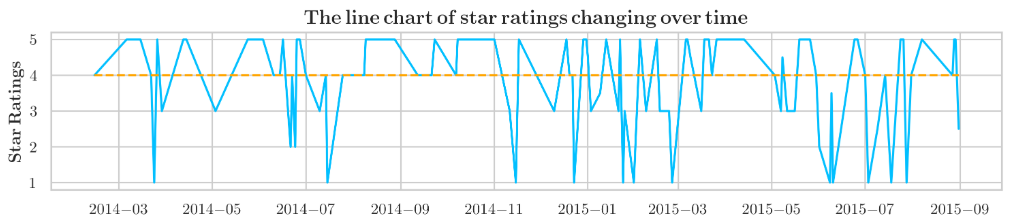
以某品牌产品为例,可视化结果如图,其中黄线为趋势线。
MK test
Mann-Kendall (MK) 检验是一种非参数检验方法,用于检测时间序列数据中的趋势(单调上升或下降)。它不假设数据服从特定分布,且对异常值不敏感,适用于水文、气象、环境等领域的时间序列分析。
- MK 检验的基本思想
MK 检验通过比较数据点之间的相对大小来判断趋势是否存在。其核心是计算统计量 S S S,并通过标准化得到 Z Z Z 值,最终根据 Z Z Z 值的符号和大小判断趋势的显著性。
-
MK 检验的步骤
- 计算统计量
S
S
S :
S = ∑ i = 1 n − 1 ∑ j = i + 1 n sgn ( x j − x i ) S = \sum_{i=1}^{n-1} \sum_{j=i+1}^{n} \text{sgn}(x_j - x_i) S=i=1∑n−1j=i+1∑nsgn(xj−xi)
其中:
- x i x_i xi 和 x j x_j xj 是时间序列中的数据点。
-
sgn
(
⋅
)
\text{sgn}(\cdot)
sgn(⋅) 是符号函数:
sgn ( x j − x i ) = { 1 , if x j > x i 0 , if x j = x i − 1 , if x j < x i \text{sgn}(x_j - x_i) = \begin{cases} 1, & \text{if } x_j > x_i \\ 0, & \text{if } x_j = x_i \\ -1, & \text{if } x_j < x_i \end{cases} sgn(xj−xi)=⎩ ⎨ ⎧1,0,−1,if xj>xiif xj=xiif xj<xi
- 计算方差
Var
(
S
)
\text{Var}(S)
Var(S) :
Var ( S ) = n ( n − 1 ) ( 2 n + 5 ) − ∑ k = 1 m t k ( t k − 1 ) ( 2 t k + 5 ) 18 \text{Var}(S) = \frac{n(n-1)(2n+5) - \sum_{k=1}^{m} t_k(t_k-1)(2t_k+5)}{18} Var(S)=18n(n−1)(2n+5)−∑k=1mtk(tk−1)(2tk+5)
其中:
- n n n 是数据点的数量。
- m m m 是数据中重复值的组数。
- t k t_k tk 是第 k k k 组重复值的数量。
-
计算标准化统计量 Z Z Z :
Z = { S − 1 Var ( S ) , if S > 0 0 , if S = 0 S + 1 Var ( S ) , if S < 0 Z = \begin{cases} \frac{S-1}{\sqrt{\text{Var}(S)}}, & \text{if } S > 0 \\ 0, & \text{if } S = 0 \\ \frac{S+1}{\sqrt{\text{Var}(S)}}, & \text{if } S < 0 \end{cases} Z=⎩ ⎨ ⎧Var(S)S−1,0,Var(S)S+1,if S>0if S=0if S<0 -
趋势判断:
- 如果 Z > 0 Z > 0 Z>0,表明存在上升趋势。
- 如果 Z < 0 Z < 0 Z<0,表明存在下降趋势。
- 通过比较 ∣ Z ∣ |Z| ∣Z∣ 与标准正态分布的临界值(如 Z 1 − α / 2 Z_{1-\alpha/2} Z1−α/2),判断趋势是否显著。
- 计算统计量
S
S
S :
-
结果分析展示
以微波炉 B0052G14E88为例,MK 检验的结果为:-0.00923,p 值为 0.207,Sen 方法计算出的斜率为 0,截距为 4。从检验结果可以看出,该品牌微波炉呈现出略微下降的趋势,但这种趋势并不显著。
Task Two c
确定基于文本的度量和基于评级的度量的组合,来最好地表示潜在成功或失败的产品。
为了准确反映消费者评价中产品的优缺点,我们通过自然语言处理(NLP)获取评论的情感倾向得分和加权星级评分,从而得到某产品在一条消费者评论中的得分 P S oneperson PS_{\text{oneperson}} PSoneperson。然后,根据评论的有用性评分确定该评论的权重。接着,根据权重对所有消费者评论中的产品得分进行加权求和,得到产品的最终得分 P S total PS_{\text{total}} PStotal。
-
计算公式
-
单条评论得分 P S oneperson PS_{\text{oneperson}} PSoneperson :
Compound ⋅ p i + Star rating ⋅ ( 1 − p i ) = P S oneperson \text{Compound} \cdot p_i + \text{Star}_{\text{rating}} \cdot (1 - p_i) = PS_{\text{oneperson}} Compound⋅pi+Starrating⋅(1−pi)=PSoneperson
考虑到评论的情感倾向与星级评分高度相关,设定 p i = 0.5 p_i = 0.5 pi=0.5,即评论的情感倾向得分与星级评分权重相等。 -
产品总得分 P S total PS_{\text{total}} PStotal :
P S total = ∑ i = 1 n P S oneperson ⋅ p i PS_{\text{total}} = \sum_{i=1}^{n} PS_{\text{oneperson}} \cdot p_i PStotal=i=1∑nPSoneperson⋅pi -
评论质量权重 m i m_i mi :
考虑到评论的质量,一般来说,评论包含的字数越多,其质量越高,因此应赋予更高的权重。通过对评论字数的统计,发现 70% 的评论字数少于 60 字。因此,将字数少于 60 字的评论质量权重设为 0,字数大于等于 60 字的评论质量权重设为 1。同时,将有用投票数加 1 作为衡量评论有用性的权重:
KaTeX parse error: Expected 'EOF', got '_' at position 25: …+ \text{helpful_̲votes} + \delta…
其中:
δ = { 0 , 如果评论字数少于 60 字 1 , 如果评论字数大于等于 60 字 \delta = \begin{cases} 0, & \text{如果评论字数少于 60 字} \\ 1, & \text{如果评论字数大于等于 60 字} \end{cases} δ={0,1,如果评论字数少于 60 字如果评论字数大于等于 60 字 -
权重归一化 p i p_i pi :
p i = m i ∑ m i p_i = \frac{m_i}{\sum{m_i}} pi=∑mimi
-
-
总结
通过上述方法,我们可以综合考虑评论的情感倾向、星级评分、评论字数和有用投票数,计算出产品的最终得分 P S total PS_{\text{total}} PStotal,从而更准确地反映消费者对产品的评价。
总结
本题实际上是一道门槛并不高的题目,即使从未接触过NLP的本人也是快速掌握并完成,当然也得益于队友们默契的配合。几日内完成的结果肯定不敢说有多么优秀,但是私认为解题思路是有可取之处的。
其实本题给我最大的一个感觉就是,数模小组的分工一定要非常清楚。
完成本文写作的时间正是2025年美赛放题前的七小时,也是小组努力准备半年的比赛(尤其是在经历亚太忘交论文的惨剧之后)。希望各位读者能从文中受益,取得自己满意的成绩!
也再次重复一遍,希望获取源代码与数据的读者,公众号(HORSE RUNNING WILD)后台回复关键词:2020美赛C题。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 17
 0
- 0


 已为社区贡献1条内容

所有评论(0)