机器学习:欠拟合和过拟合
欠拟合和过拟合是机器学习模型训练中的两个重要概念,它们涉及到模型在拟合数据时的表现。下面是对这两个概念的详细概述。
1. 欠拟合(Underfitting)
定义: 欠拟合发生在模型对训练数据的学习不足,不能捕捉到数据中的潜在模式或特征。模型的复杂度过低,因此无法有效地拟合训练数据和测试数据。
1.1 特征
表现: 在训练数据和测试数据上都表现较差,通常是因为模型过于简单,例如使用线性回归来拟合高度非线性的数据。
示例: 在复杂函数上使用非常简单的线性模型,或在大量特征的情况下使用只有几个参数的模型。
1.2 结果
数据预测的准确度低,模型失去了预测能力,无法完全利用数据中的信息。
1.3 解决方案
增加模型的复杂度,例如选择更复杂的算法或增加特征。
使用更复杂的回归模型(如多项式回归、决策树等)。
进行特征工程以创建更有用的特征。
2. 过拟合(Overfitting)
定义: 过拟合发生在模型对训练数据学习过度,记住了训练数据中的噪声和异常值,而忽略了数据的底层分布关系。模型的复杂度过高,以致于无法泛化到新数据。
2.1 特征
表现: 在训练数据上表现良好(得分高),但在测试数据上表现不佳,显示出较大的误差。
示例: 使用非常复杂的模型(如深度神经网络)时,模型可能把训练集中的噪声当作重要信号进行学习。
2.2 结果
模型对未知数据的预测性能显著下降,无法有效推广到实际应用。
2.3 解决方案
减少模型复杂度,例如使用简单的算法或减少特征数量。
使用正则化技术(如L1或L2正则化)来惩罚过于复杂的模型。
采用交叉验证来选择合适的模型和参数,确保模型的泛化能力。
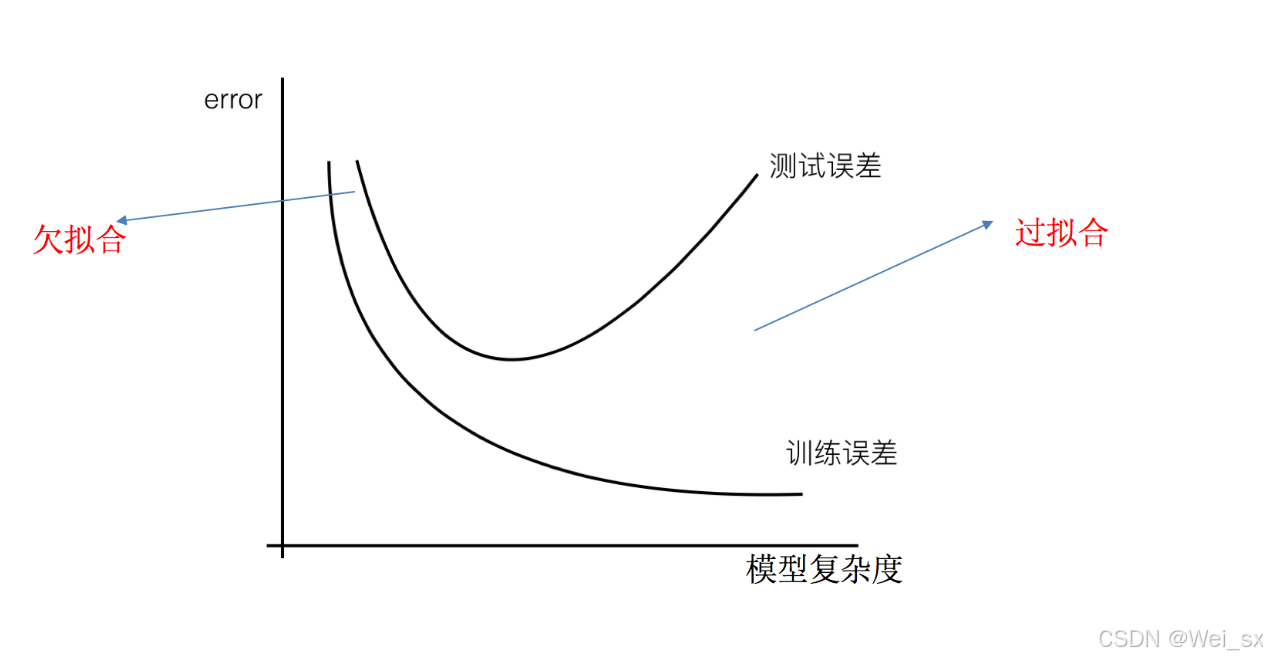
3. 可视化理解
在图表中,通常会看到训练误差和测试误差的变化趋势:
欠拟合: 训练误差和测试误差都高且接近。
过拟合: 训练误差较低而测试误差较高,表现出明显的差距。
4. 模型选择与评估
选择合适的模型:根据数据的复杂性和特征选择合适的模型。可以使用模型评估技术(如交叉验证)来评估模型表现并避免这两种情况。
结合正则化: 使用正则化方法来找到良好的复杂度平衡,确保模型既不过于简单也不过于复杂。
5. 结论
理解欠拟合和过拟合是构建有效机器学习模型的关键。理想的模型应在训练数据上良好拟合,同时在测试数据上也能保持良好的预测性能。因此,在模型开发过程中,需要不断验证和调整,以获得最佳的泛化能力。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐

 3
 0
- 0


 已为社区贡献57条内容

所有评论(0)