【毕设推荐】基于机器学习的车牌识别系统设计与实现【源码+论文】
摘 要
随着智能交通系统的发展,车牌识别的作用越来越重要。基于深度学习的车牌识别方法相较于传统识别方法,具有更高的精准率和更快的处理速度,因此在智能交通系统中有着广阔的应用前景和研究意义。
本设计采用深度学习的方法对车牌进行检测和识别:车牌检测部分使用Yolov7目标检测模型,对检测到的扭曲倾斜车牌图像,采用图像校正算法对其校正,以便后续车牌识别的进行;车牌识别部分采用LPRnet识别模型;采用CycleGAN模型生成真实车牌图像用于扩充数据集,解决了部分省份数据集过少的问题;最后使用PyQt设计可视化界面。系统可以实现对图像、视频文件的车牌检测和识别,并且可以开启本机摄像头或连接网络摄像头作为输入,对车牌进行识别。采用深度学习的方法使得软件对车牌的检测和识别准确率较高。经过测试,Yolov7模型在测试集上对车牌的检测精准率可达99.8%,LPRnet模型在测试集上对车牌识别的准确率达98.2%。但由于数据集的限制,软件只对蓝色车牌和绿色车牌进行识别,为了实现对更多种类的车牌的识别,需要对训练集进行扩充,同时采用更先进的算法。
关键词:深度学习;Yolov7;LPRnet;PyQt;CycleGAN
目 录
5.1.2 基于CycleGAN的车牌图像生成实现... 24
1. 绪论
1.1.课题背景
随着中国经济的不断发展和工业化进程的加速,人们的生活水平和消费水平不断提高,汽车逐渐成为了每个家庭的生活消费品与必需品。国家统计局数据显示在2021年底,中国汽车保有量为2.92亿辆,汽车拥有量达到了每千人口250辆,汽车普及率约为25%。并且随着个人经济水平的提高与交通道路设施的不断完善,中国汽车的普及率将会不断增加。由于汽车数量的不断增加,交通管理系统面临着越来越大的挑战。与此同时,随着现代信息技术发展,智能信息化城市成为未来发展的趋势,此时智能交通系统(Intelligent Transportation System,ITS)就起着很重要的作用。
ITS概念最早在1980年代提出,旨在提高交通安全性、减少交通拥堵和污染、提高出行效率和便捷性,车牌识别是智能交通系统的核心组成部分,现阶段,车牌识别被广泛运用于各种场景,如在交通管理中,根据对车牌号码的识别与记录来计算车流量,并对道路拥堵情况监控和管理。同时也用于车辆收费管理,例如高速公路、停车场等场所的管理,系统识别车牌号码实现车辆进出管理和停车计时收费功能。出行方面,系统通过识别车牌,根据交通流量情况自动调整最佳路线,为司机提供准确高效的导航功能。由此可见,车牌识别为城市交通发展和日常生活提供了有力支持,也是促进经济发展和改善市民生活的重要手段。
2.软件的总体设计
根据需求分析本文车牌识别分为两种情况,对单张车辆图像进行识别,对视频和摄像头捕获的视频进行识别,对视频或摄像头进行车牌识别其原理是对视频文件的每一帧图像进行识别,若存在车牌图像将结果显示在原视频中。所以进行视频检测与单张图像检测流程基本一致,软件的设计流程如图4-1所示,本文将流程分为两块内容进行,一是对深度学习模型的搭建与训练,二是利用训练好的模型对图像进行检测与识别。
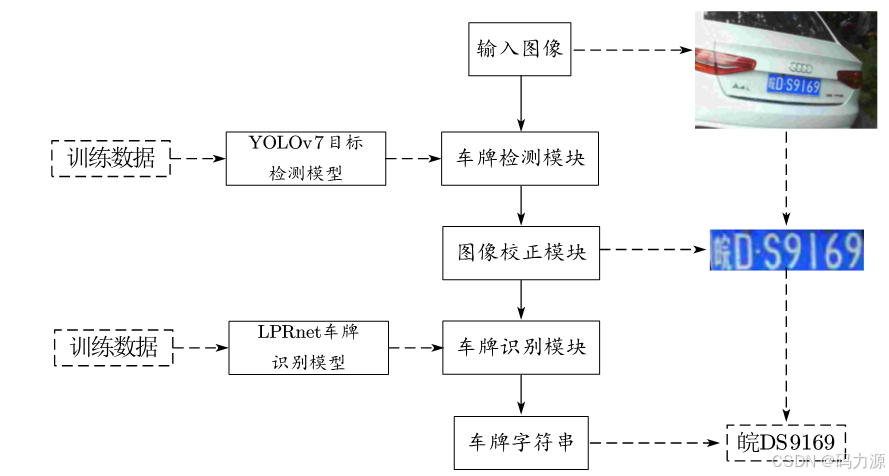
图4-1 软件设计流程图
根据上述内容,按照模块化设计的思路将软件分为以下四模块,图像数据集模块、车牌检测模块、图像校正模块、车牌识别模块。
- 车牌检测
本文使用的Yolov7模型对车牌检测的结果是车牌区域的中心坐标以及宽度和高度,除了车牌区域的信息之外还包括了检测结果的置信度与类别概率。由于本文对蓝牌普通汽车和绿牌新能源汽车进行识别,模型中类别设置为两种,分别对应蓝牌和绿牌,通过这种方式可以在检测车牌图像的同时对车牌颜色进行识别。如图4-2所示,根据得到的信息在原图像上标注出车牌的位置、颜色、置信度等信息。
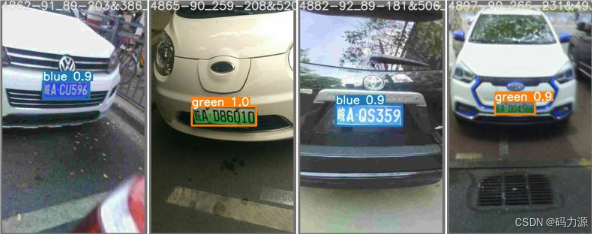
图4-2 车牌位置标注图
- 车牌提取
由上述内容可知,检测模型的结果是车牌区域的位置信息,后续车牌校正和车牌识别需要的是车牌图像。为此需要根据得到的中心坐标与宽度和高度计算车牌区域的左上角坐标与右下角坐标,根据这两个坐标通过裁剪的方式将车牌图像从车辆图像中提取出来。
在上一模块中已经提取出了车牌的具体区域,但在采集车牌图像的过程中,由于拍摄角度和环境等因素的影响,可能会导致提取后的车牌图像出现倾斜、扭曲、形变等现象。如果不对倾斜的车牌图像进行校正处理直接用于车牌识别,会影响车牌识别的准确率,如图4-3所示是部分倾斜的车牌图像。
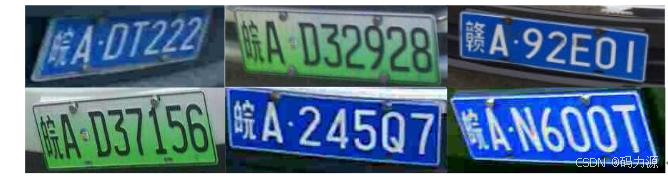
图4-3 部分倾斜车牌图像示意图
为了校正车牌图像,首先对车牌图像倾斜角度进行检测,根据车牌倾斜角度是否超过某个设定的阈值判断是否需要进行校正。若需要进行校正首先对车牌图像的水平方向进行校正,再对垂直方向进行校正,最后消除车牌图像中与车牌不相关的背景图像。
车牌识别模块的功能主要是对输入的校正后的车牌图像进行字符识别,与车牌检测模块开始阶段做的工作相同,在进行推理之前需要对输入图像进行处理。处理后的数据经过模型推理后会得到一个概率矩阵,矩阵中的内容表示对应字符的概率,最后通过解码过程得到推理出的车牌号码。
- . 软件的具体实现
对系统的各个功能模块进行分析后,本章将对这些模块的具体实现进行介绍。由于本文采用深度学习的方式对车牌进行识别,所以软件的实现就是对各个深度学习模型的应用。文中采用了三个深度学习模型分别用于车牌检测、车牌图像生成、车牌识别,据此需要建立三个数据集。车牌检测和车牌识别通过对模型的训练来实现,需要多次训练才能产生较好的检测和识别效果,车牌图像校正模块则需要使用不同的算法和图像处理技术来实现。最后需要设计一个GUI界面,用于用户交互与信息显示
车牌检测模型使用的数据集来自从CCPD数据集中随机挑选的31776张图像,其中训练集22244张图片,验证集3177张图片,测试集6355张图片。训练集涵盖了不同角度、不同大小、不同形状和不同背景的车牌图像,数据集的部分图像如图5-1所示:
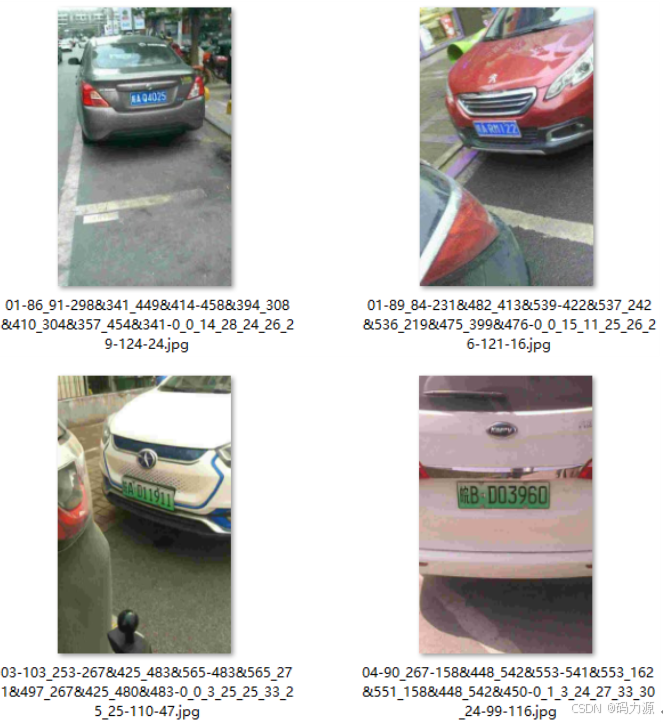
图5-1 数据集部分图像示意图
本文采用基于特征向量的角度估计方法,可以同时检测出车牌的垂直倾斜角度以及水平倾斜角度。首先使用opencv中的cornerEigenValsAndVecs函数计算出图像中所有像素点的特征向量,为了降低计算的复杂度同时保留图像中的关键信息,仅对部分像素点计算角度,在图像上按照某个间距设置网格仅计算网格节点上的角度,可以在较低的计算成本下获得有关图像的倾斜角度信息。
如图5-13(a)所示,是根据图像宽高和间距所定义的网格在图像中的分布图,在计算倾斜角度时循环遍历网格坐标,根据坐标信息获取到该像素点对应的特征向量,最后依据特征向量计算角度,图5-13(b)是每个网格点特征向量的分布情况。
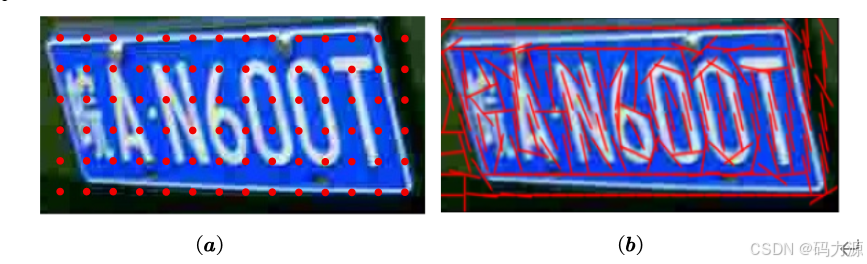
图5-13 车牌特征向量分布示意图
对垂直倾斜的图像进行透视变换得到校正后的图像,校正后的图像左右边界存有较大的无意义背景,这可能会影响后续车牌识别的准确性。为了消除这些左右边界定义一个检测边界的回归模型,通过模型得到车牌图像中的左右边界位置,最后,根据左右边界的起始位置和结束位置剪裁图像得到消除左右边界的结果。
综上所述,车牌图像校正的流程如图5-17所示:
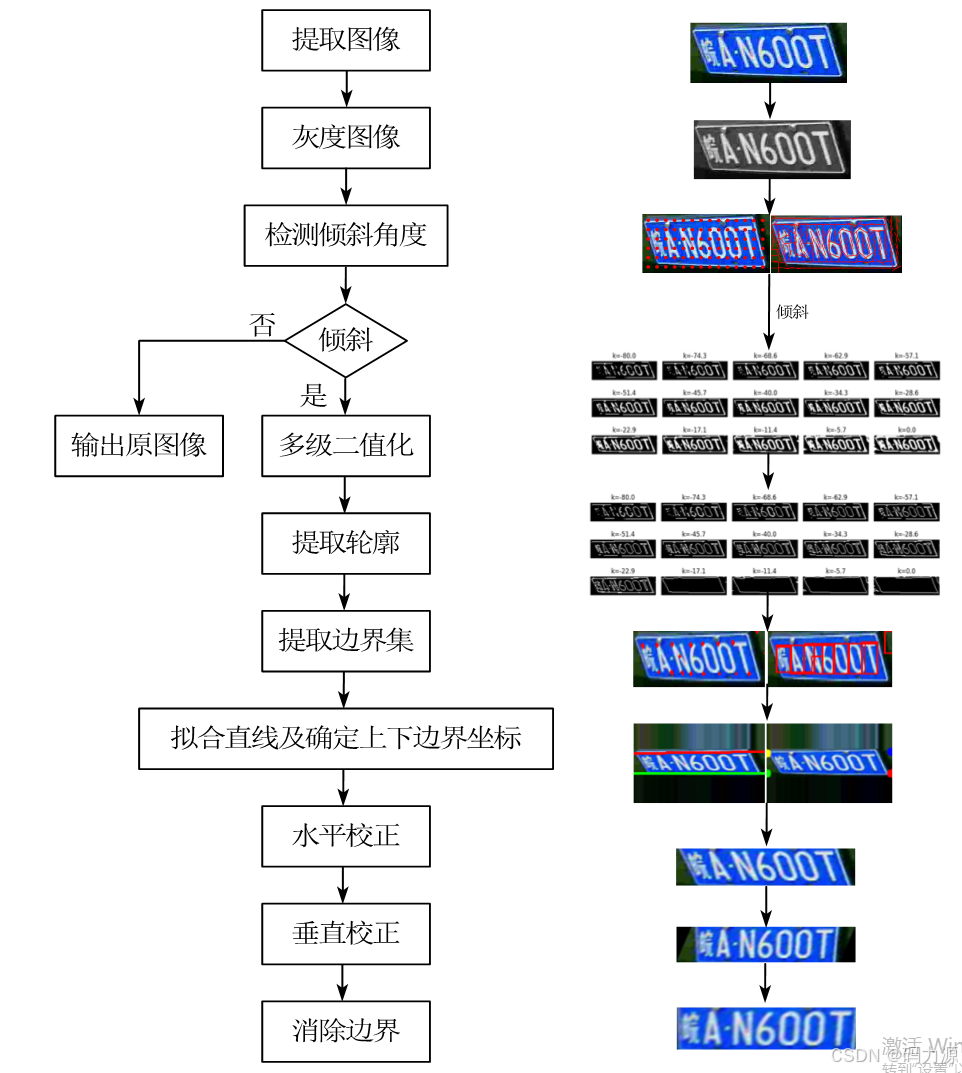
图5-17 车牌校正流程图
目前基于Python语言的常用可视化界面框架为PyQt,PyQt具有大量的GUI控件,包括窗口、按钮、文本框、列表框等,以及各种布局管理器和事件处理器,并且提供了一个可视化界面设计器Qt Designer,可以方便地创建GUI界面,所以采用PyQt对软件界面进行设计。
在设计软件时,首先根据软件要实现的功能对界面进行规划。软件的功能是对图像和视频进行识别,所以将软件界面分为两部分,一部分用于图像的识别另一部分用于对视频的识别,软件界面的具体设计如图5-19所示。界面的左边部分用于车辆图像的识别,设置三个按钮分别为选取文件、开始识别和清除内容。其中选取文件是选择需要识别的车牌图像并将其加载在车辆图像显示框中;开始识别是对选择的车辆图像进行车牌检测和车牌识别,结果包括校正后的车牌图像、车牌颜色和种类、车牌号码以及花费时间,这些结果都会在对应的显示框中显示;清除内容的作用是将显示的结果清空。并设置一个“多个车牌识别”选项,选中后可以识别图像中的多个车牌。
界面右边部分用于对摄像头和视频的识别,设置了打开相机、关闭相机、暂停继续、检测视频、关闭视频五个按钮,对视频和摄像头的检测和识别结果会直接在视频上显示出来。同时增加了用于连接网络摄像头的按钮,可以使用其他设备的摄像头进行检测。此外,由于在车牌检测和识别上尝试了多个深度学习模型,增加选择检测和识别算法按钮,可以自由选择已经训练好的不同种类模型进行车牌检测和识别。
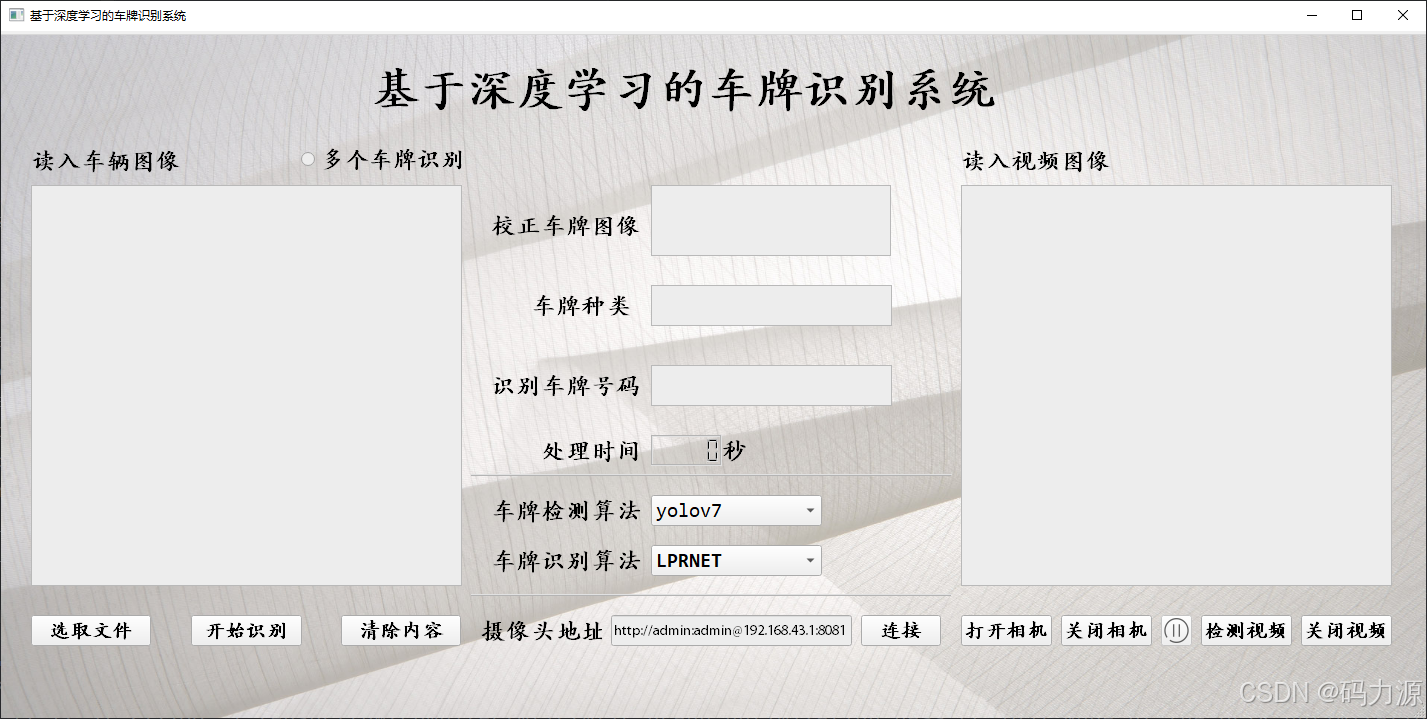
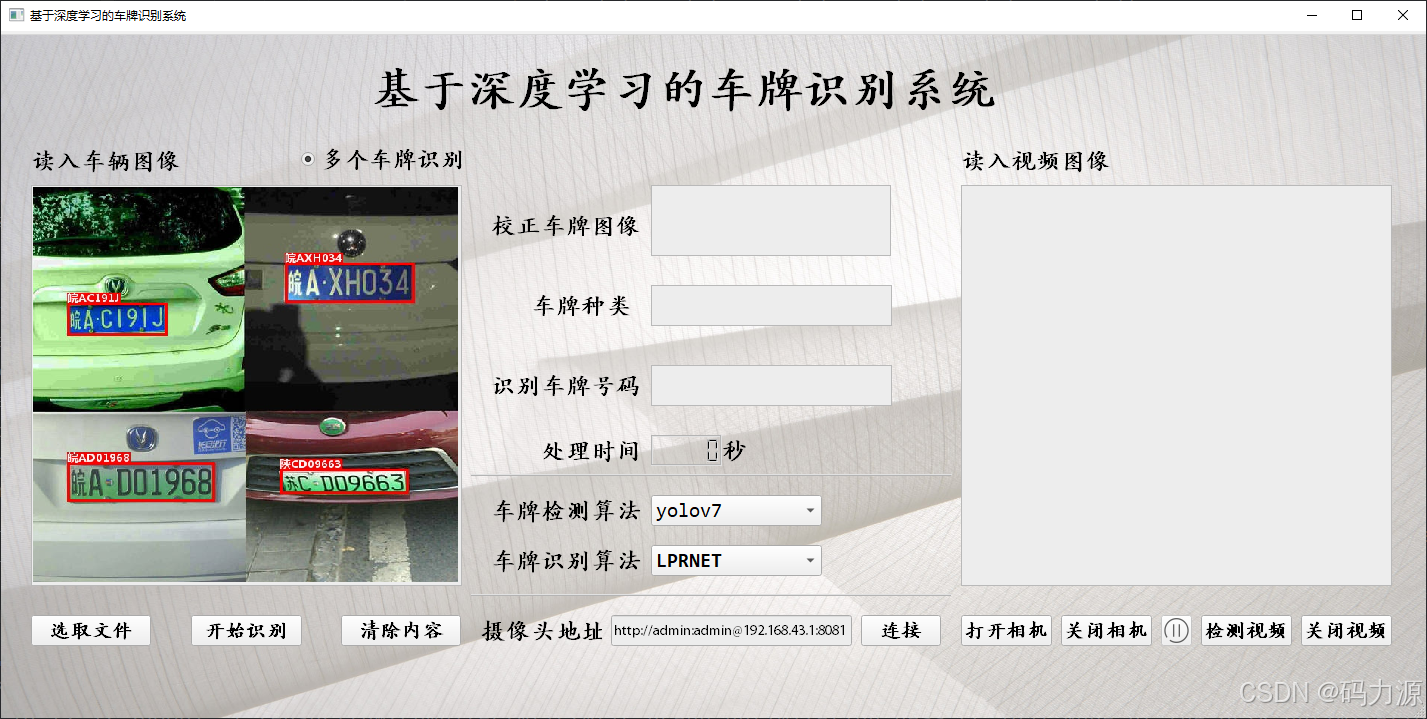
图6-6 车牌识别功能检测示意图
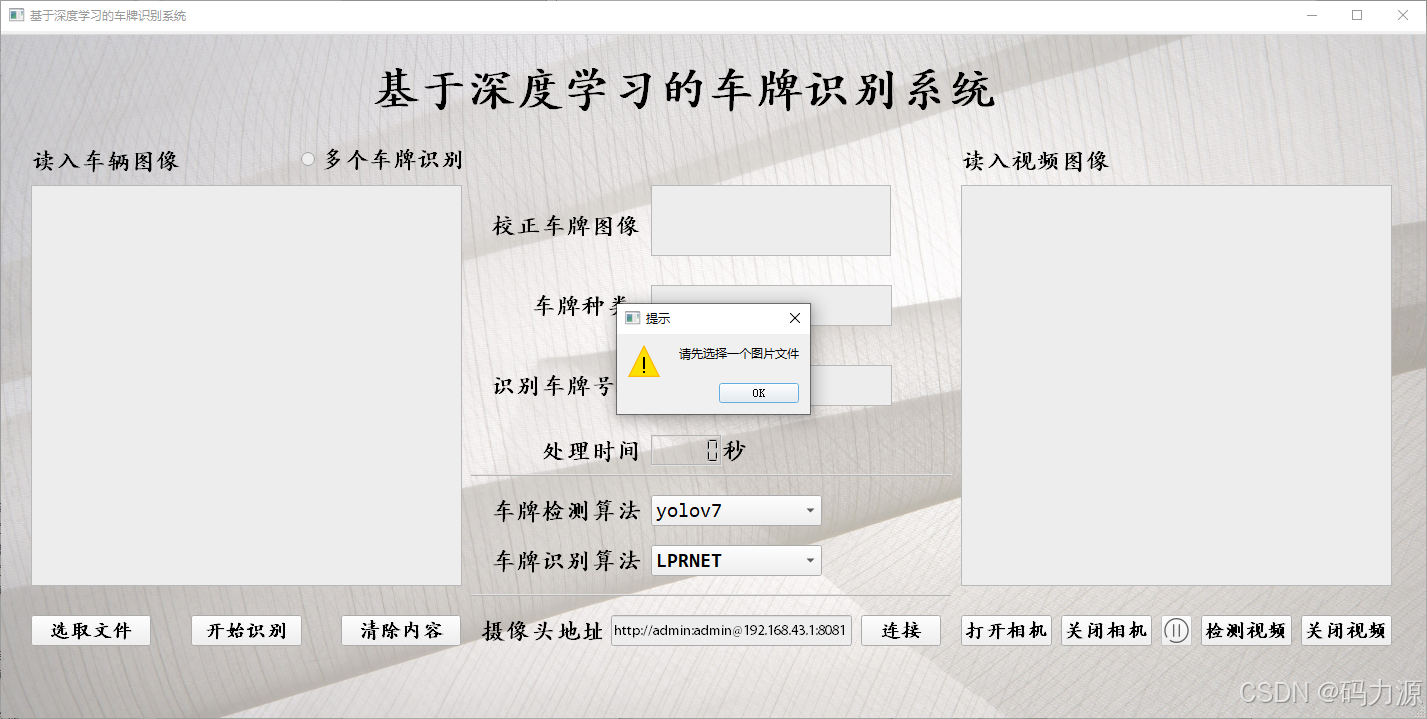
图6-7 多个车牌识别功能检测示意图
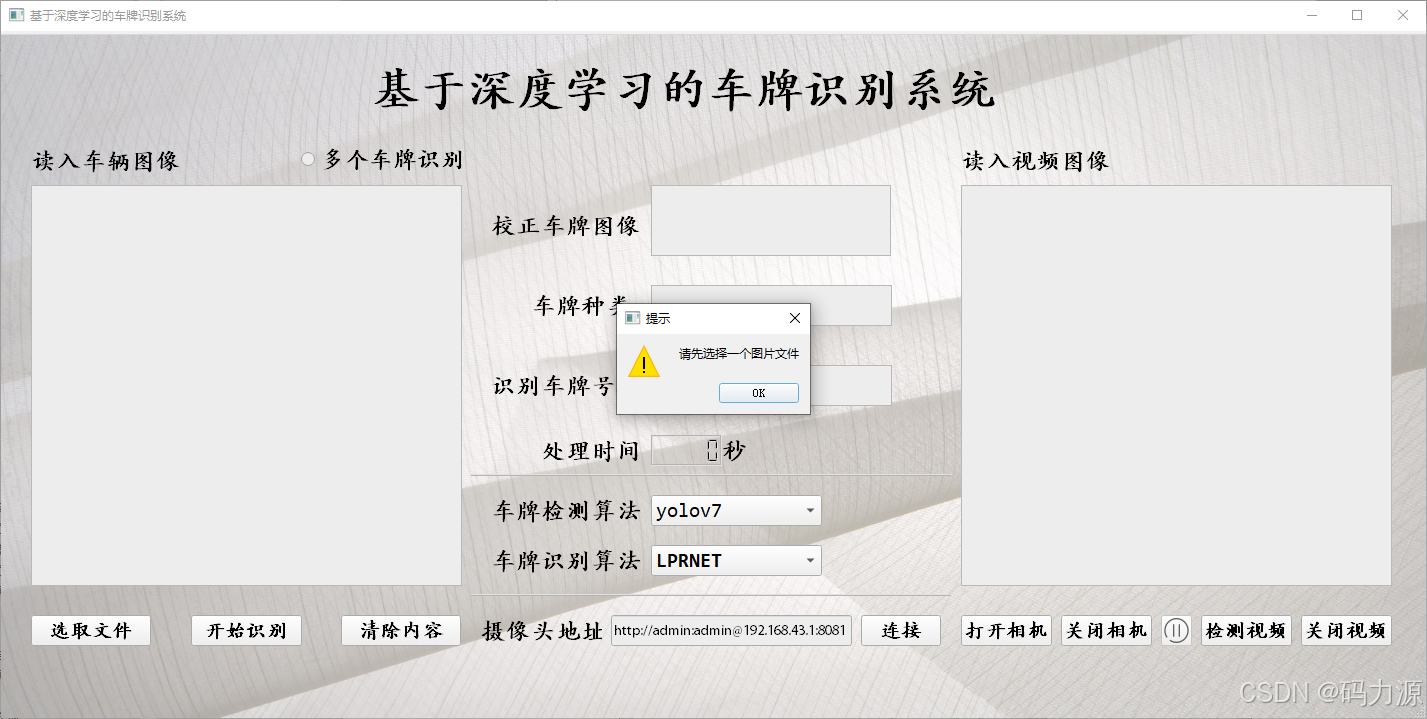
图6-8 弹窗提醒示意图
源码及详细文章获取请添加下方名片

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 26
 0
- 0


 已为社区贡献4条内容

所有评论(0)