Pytorch版deeplabv3+训练自己的数据集
目录
3. 在dataloaders/datasets目录下添加文件
4. 在dataloaders目录下修改__init__.py
开发环境
-
windows11
-
pytorch2.2
-
vscode
-
python3.8
一、准备数据集
1. 数据集文件夹目录

-
ImageSets 文件夹内还有一个文件夹Segmentation,里面存放的是训练集、测试集txt文件
-
JPEGImages 存放原图image
-
SegmentationClass 存放原图对应的mask,要和JPEGImages里的图片一一对应
2. yolo格式转json格式
我使用的标注方式是:Sign in to Roboflow,大大减少了标注时间,推荐!!!
导出yolo格式之后进行转json格式,代码如下:
import json
import os

# 输入TXT标注文件夹路径
txt_folder_path = "E:/VScode project/pytorch-deeplab-xception-master111/Seg552/txt/"
# 输出JSON文件夹路径
json_folder_path = "E:/VScode project/pytorch-deeplab-xception-master111/Seg552/json/"

# 确保输出文件夹存在
os.makedirs(json_folder_path, exist_ok=True)

# 类别ID映射(如有需要可以修改)
label_mapping = {1: "ripe fruits", 0: "branch"}

# 遍历TXT文件夹
for txt_file in os.listdir(txt_folder_path):
    if txt_file.endswith('.txt'):
        txt_file_path = os.path.join(txt_folder_path, txt_file)
        json_file_path = os.path.join(json_folder_path, txt_file.replace('.txt', '.json'))

        # JSON模板
        json_data = {
            "version": "5.2.1",
            "flags": {},
            "shapes": [],
            "imagePath": txt_file.replace('.txt', '.jpg'),  # 假设图像名与TXT文件名相同
            "imageHeight": 1080,
            "imageWidth": 1920
        }

        # 解析TXT文件并构造JSON结构
        with open(txt_file_path, 'r') as file:
            for line in file:
                # 分割类别ID和坐标数据
                parts = line.strip().split()
                class_id = int(parts[0])  # 类别ID
                label = label_mapping.get(class_id, "unknown")  # 类别名称
                coordinates = list(map(float, parts[1:]))  # 坐标数据

                # 将坐标数据转换为(x, y)点对,并按比例转换为实际像素位置
                points = []
                for i in range(0, len(coordinates), 2):
                    x = coordinates[i] * json_data["imageWidth"]
                    y = coordinates[i + 1] * json_data["imageHeight"]
                    points.append([x, y])

                # 添加标注信息到JSON
                shape_data = {
                    "label": label,
                    "points": points,
                    "group_id": None,
                    "description": "",
                    "shape_type": "polygon",
                    "flags": {}
                }
                json_data["shapes"].append(shape_data)

        # 保存为JSON文件
        with open(json_file_path, 'w') as json_file:
            json.dump(json_data, json_file, indent=2)

        print(f"已成功将 {txt_file} 转换为 JSON 文件:{json_file_path}")
3. 文件夹重命名
虽然用网页标注导出来的image和TXT文件的名称是一致的,但为了避免在后续格式转换中出现冲突,现在需要将image图片和txt文件重新命名。相应代码:
import os

# 文件夹路径
folder1 = 'E:/VScode project/pytorch-deeplab-xception-master111/Seg552/txt/'  # 替换为您的文件夹路径
folder2 = 'E:/VScode project/pytorch-deeplab-xception-master111/Seg552/img/'  # 替换为您的文件夹路径

# 获取文件名列表
files1 = os.listdir(folder1)
files2 = os.listdir(folder2)

# 对文件进行排序,确保顺序一致
files1.sort()
files2.sort()

# 确保两个文件夹的文件数相同
if len(files1) != len(files2):
    print("警告:两个文件夹的文件数量不同!")

# 重命名第一个文件夹的文件
for idx, filename in enumerate(files1):
    new_name = f"{idx:03d}{os.path.splitext(filename)[1]}"  # 保留后缀
    os.rename(os.path.join(folder1, filename), os.path.join(folder1, new_name))

# 重命名第二个文件夹的文件
for idx, filename in enumerate(files2):
    new_name = f"{idx:03d}{os.path.splitext(filename)[1]}"
    os.rename(os.path.join(folder2, filename), os.path.join(folder2, new_name))

print("重命名完成。")
4. json格式转mask图片
相应代码:
import argparse
import base64
import json
import os
import os.path as osp
import imgviz
import PIL.Image
from labelme.logger import logger
from labelme import utils
import glob
import yaml

def main():
    logger.warning(
        "This script is aimed to demonstrate how to convert the "
        "JSON file to a single image dataset."
    )
    logger.warning(
        "It will handle multiple JSON files to generate a "
        "real-use dataset."
    )

    parser = argparse.ArgumentParser()
    parser.add_argument("--json_dir", required=True)
    parser.add_argument("-o", "--out", required=True)
    args = parser.parse_args()

    json_dir = args.json_dir
    output_dir = args.out

    if osp.isfile(json_dir):
        json_list = [json_dir] if json_dir.endswith('.json') else []
    else:
        json_list = glob.glob(os.path.join(json_dir, '*.json'))

    for json_file in json_list:
        logger.info(f"Processing file: {json_file}")
        json_name = osp.basename(json_file).split('.')[0]
        out_dir = osp.join(output_dir, json_name)

        if not osp.exists(out_dir):
            os.makedirs(out_dir)

        try:
            data = json.load(open(json_file))
        except Exception as e:
            logger.error(f"Error loading JSON file {json_file}: {e}")
            continue  # Skip to the next file

        imageData = data.get("imageData")

        if not imageData:
            image_filename = osp.basename(data["imagePath"])
            imagePath = osp.join("E:/VScode project/pytorch-deeplab-xception-master111/Seg552/JPEGImages", image_filename)
            try:
                with open(imagePath, "rb") as f:
                    imageData = f.read()
                    imageData = base64.b64encode(imageData).decode("utf-8")
            except FileNotFoundError:
                logger.error(f"File not found: {imagePath}")
                continue  # Skip to the next JSON file
            except Exception as e:
                logger.error(f"Error reading image file {imagePath}: {e}")
                continue

        try:
            img = utils.img_b64_to_arr(imageData)

            label_name_to_value = {"_background_": 0}
            for shape in sorted(data["shapes"], key=lambda x: x["label"]):
                label_name = shape["label"]
                if label_name in label_name_to_value:
                    label_value = label_name_to_value[label_name]
                else:
                    label_value = len(label_name_to_value)
                    label_name_to_value[label_name] = label_value

            lbl, _ = utils.shapes_to_label(img.shape, data["shapes"], label_name_to_value)

            label_names = [None] * (max(label_name_to_value.values()) + 1)
            for name, value in label_name_to_value.items():
                label_names[value] = name

            lbl_viz = imgviz.label2rgb(lbl, imgviz.asgray(img), label_names=label_names, loc="rb")

            # Save files to corresponding subdirectory
            PIL.Image.fromarray(img).save(osp.join(out_dir, "img.png"))
            utils.lblsave(osp.join(out_dir, "label.png"), lbl)
            PIL.Image.fromarray(lbl_viz).save(osp.join(out_dir, "label_viz.png"))

            with open(osp.join(out_dir, "label_names.txt"), "w") as f:
                for lbl_name in label_names:
                    f.write(str(lbl_name if lbl_name is not None else "unknown") + "\n")

            yaml_data = {
                "label_name_to_value": label_name_to_value,
                "label_names": label_names
            }
            with open(osp.join(out_dir, "labels.yaml"), "w") as yaml_file:
                yaml.dump(yaml_data, yaml_file)

            logger.info(f"Saved to: {out_dir}")

        except Exception as e:
            logger.error(f"Error processing file {json_file}: {e}")

if __name__ == "__main__":
    main()
运行指令为:
python My_json_to_dataset.py --json_dir "E:/VScode project/pytorch-deeplab-xception-master111/Seg552/json" -o "E:/VScode project/pytorch-deeplab-xception-master111/Seg552/labelme_json"生成的文件为:
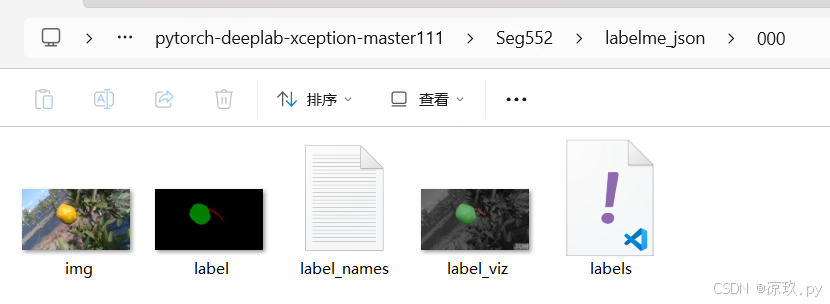
需要将labelme_json文件下的每个文件中的label.png文件重新命名,相应代码:
import os

# 替换为你的json文件夹所在的目录
json_dir = "E:/VScode project/pytorch-deeplab-xception-master111/Seg552/labelme_json"

for root, dirs, files in os.walk(json_dir):
    for dr in dirs:
        file_dir = os.path.join(root, dr)

        # 确认label.png文件存在
        label_file = os.path.join(file_dir, 'label.png')
        if os.path.exists(label_file):
            # 将文件夹名分割,得到原图名
            original_name = dr.split('_')[0] + '.png'
            new_file_name = os.path.join(file_dir, original_name)

            # 执行重命名操作
            os.rename(label_file, new_file_name)
            print(f"Renamed '{label_file}' to '{new_file_name}'")
最后将提取出所有文件夹中的000.png,并放在指定目录中,相应代码:
import os
from shutil import copyfile

for root, dirs, names in os.walk(
        "E:/VScode project/pytorch-deeplab-xception-master111/Seg552/labelme_json"):  # 改成你自己的json文件夹所在的目录
    for dr in dirs:
        file_dir = os.path.join(root, dr)
        print(dr)
        file = os.path.join(file_dir, dr + '.png')
        print(file)
        new_name = dr.split('_')[0] + '.png'
        new_file_name = os.path.join(file_dir, new_name)
        print(new_file_name)

        tar_root = 'E:/VScode project/pytorch-deeplab-xception-master111/Seg552/Segmentationclass'  # 目标路径
        tar_file = os.path.join(tar_root, new_name)
        copyfile(new_file_name, tar_file)
该代码运行得到的文件,就是我们所需要的SegmentationClass
5. 生成txt文件
生成的训练集txt和验证集txt,里面的图片名称(去掉后缀)的分配是随机的。相应代码:
import os
import random

# 设置图像目录和输出目录
image_dir = 'E:/VScode project/pytorch-deeplab-xception-master111/Seg552/JPEGImages'  # 替换为你的图像目录
output_dir = 'E:/VScode project/pytorch-deeplab-xception-master111/Seg552/ImageSets/Segmentation'  # 替换为输出目录

# 获取所有图像文件名(去掉后缀)
image_files = [f.split('.')[0] for f in os.listdir(image_dir) if f.endswith(('.jpg', '.png'))]

# 随机打乱图像文件名
random.shuffle(image_files)

# 分割训练集和验证集
train_files = image_files[:int(len(image_files) * 0.8)]  # 80% 为训练集
val_files = image_files[int(len(image_files) * 0.8):]  # 20% 为验证集

# 写入 train.txt
with open(os.path.join(output_dir, 'train.txt'), 'w') as f:
    for file in train_files:
        f.write(f"{file}\n")

# 写入 val.txt
with open(os.path.join(output_dir, 'val.txt'), 'w') as f:
    for file in val_files:
        f.write(f"{file}\n")

print("train.txt 和 val.txt 已生成。")
二、修改配置
使用的代码是这个deeplab-pytorch
参考博客:Pytorch版deeplabv3+环境配置训练自己的数据集_pytorch deeplabv3+训练自己的数据集自定义init len getitem-CSDN博客
1. 在mypath.py中添加自己的数据集名称与路径
class Path(object):
    @staticmethod
    def db_root_dir(dataset):
        if dataset == 'pascal':
            return '/path/to/datasets/VOCdevkit/VOC2012/'  # folder that contains VOCdevkit/.
        elif dataset == 'sbd':
            return '/path/to/datasets/benchmark_RELEASE/'  # folder that contains dataset/.
        elif dataset == 'cityscapes':
            return '/path/to/datasets/cityscapes/'     # foler that contains leftImg8bit/
        elif dataset == 'coco':
            return '/path/to/datasets/coco/'
        elif dataset == 'Seg552':     #在这里添加自己数据集的名称
            return 'E:/VScode project/pytorch-deeplab-xception-master/Seg552'    #在这里添加自己数据集的路径
        else:
            print('Dataset {} not available.'.format(dataset))
            raise NotImplementedError
2. 在train.py约185行添加自己数据集的名称

3. 在dataloaders/datasets目录下添加文件
复制一份pascal.py,并重命名文件为Seg552
三个修改地方:修改类为Seg552Segmentation,修改类别数、数据集名称
部分代码如下:
from __future__ import print_function, division
import os
from PIL import Image
import numpy as np
from torch.utils.data import Dataset
from mypath import Path
from torchvision import transforms
from dataloaders import custom_transforms as tr

class Seg552Segmentation(Dataset):  #修改类为Seg552Segmentation
    """
    PascalVoc dataset
    """
    NUM_CLASSES = 3    #修改类别数

    def __init__(self,
                 args,
                 base_dir=Path.db_root_dir('Seg552'), #修改数据集名称
                 split='train',
                 ):
4. 在dataloaders目录下修改__init__.py
在第三行导入Seg552Segmentation,复制'pascal.py'数据集描述,三个修改地方:修改
train_set = Seg552Segmentation(args, split='train'),
val_set = Seg552Segmentation(args, split='val'),
修改为自己数据集的名字Seg552
部分代码如下:
from dataloaders.datasets import cityscapes, coco, combine_dbs, pascal, sbd
from torch.utils.data import DataLoader
from dataloaders.datasets.Seg552 import Seg552Segmentation

def make_data_loader(args, **kwargs):

    if args.dataset == 'pascal':
        train_set = pascal.VOCSegmentation(args, split='train')
        val_set = pascal.VOCSegmentation(args, split='val')
        if args.use_sbd:
            sbd_train = sbd.SBDSegmentation(args, split=['train', 'val'])
            train_set = combine_dbs.CombineDBs([train_set, sbd_train], excluded=[val_set])

        num_class = train_set.NUM_CLASSES
        train_loader = DataLoader(train_set, batch_size=args.batch_size, shuffle=True, **kwargs)
        val_loader = DataLoader(val_set, batch_size=args.batch_size, shuffle=False, **kwargs)
        test_loader = None

        return train_loader, val_loader, test_loader, num_class

    elif args.dataset == 'Seg552':    #修改数据名称
        train_set = Seg552Segmentation(args, split='train')  # 自定义数据集类  修改为类:Seg552Segmentation
        val_set = Seg552Segmentation(args, split='val')   #修改为类:Seg552Segmentation
        num_class = train_set.NUM_CLASSES
        train_loader = DataLoader(train_set, batch_size=args.batch_size, shuffle=True, **kwargs)
        val_loader = DataLoader(val_set, batch_size=args.batch_size, shuffle=False, **kwargs)
        test_loader = None
        return train_loader, val_loader, test_loader, num_class
5. 在dateloaders目录下修改utils.py
在74行左右添加代码,设置每一类别的颜色显示;也可以在里面定义颜色映射,即修改原始的decode_segmap,并修改类别数,这段代码根据实际情况改变,具体代码如下:
import matplotlib.pyplot as plt
import numpy as np
import torch

def decode_seg_map_sequence(label_masks, dataset='pascal'):
    rgb_masks = []
    for label_mask in label_masks:
        rgb_mask = decode_segmap(label_mask, dataset)
        rgb_masks.append(rgb_mask)
    rgb_masks = torch.from_numpy(np.array(rgb_masks).transpose([0, 3, 1, 2]))
    return rgb_masks

def decode_segmap(label_mask, dataset):
    # 你需要为 Seg552 定义颜色映射
    # 假设你有 3 类:背景、分支、成熟水果
    label_colors = np.array([(0, 0, 0),    # 背景
                             (0, 255, 0),  # branch
                             (255, 0, 0)]) # ripe fruit
    r = np.zeros_like(label_mask).astype(np.uint8)
    g = np.zeros_like(label_mask).astype(np.uint8)
    b = np.zeros_like(label_mask).astype(np.uint8)

    for ll in range(0, len(label_colors)):
        mask = (label_mask == ll)
        r[mask] = label_colors[ll][0]
        g[mask] = label_colors[ll][1]
        b[mask] = label_colors[ll][2]

    rgb_mask = np.zeros((label_mask.shape[0], label_mask.shape[1], 3))
    rgb_mask[:, :, 0] = r
    rgb_mask[:, :, 1] = g
    rgb_mask[:, :, 2] = b

    return rgb_mask

def encode_segmap(mask):
    """Encode segmentation label images as pascal classes
    Args:
        mask (np.ndarray): raw segmentation label image of dimension
          (M, N, 3), in which the Pascal classes are encoded as colours.
    Returns:
        (np.ndarray): class map with dimensions (M,N), where the value at
        a given location is the integer denoting the class index.
    """
    mask = mask.astype(int)
    label_mask = np.zeros((mask.shape[0], mask.shape[1]), dtype=np.int16)
    for ii, label in enumerate(get_pascal_labels()):
        label_mask[np.where(np.all(mask == label, axis=-1))[:2]] = ii
    label_mask = label_mask.astype(int)
    return label_mask

def get_cityscapes_labels():
    return np.array([
        [128, 64, 128],
        [244, 35, 232],
        [70, 70, 70],
        [102, 102, 156],
        [190, 153, 153],
        [153, 153, 153],
        [250, 170, 30],
        [220, 220, 0],
        [107, 142, 35],
        [152, 251, 152],
        [0, 130, 180],
        [220, 20, 60],
        [255, 0, 0],
        [0, 0, 142],
        [0, 0, 70],
        [0, 60, 100],
        [0, 80, 100],
        [0, 0, 230],
        [119, 11, 32]])

def get_Seg552_labels():
    return np.array([
        [0, 0, 0],
        [128, 0, 0],
        [0, 128, 0]])

def get_pascal_labels():
    """Load the mapping that associates pascal classes with label colors
    Returns:
        np.ndarray with dimensions (21, 3)
    """
    return np.asarray([[0, 0, 0], [128, 0, 0], [0, 128, 0], [128, 128, 0],
                       [0, 0, 128], [128, 0, 128], [0, 128, 128], [128, 128, 128],
                       [64, 0, 0], [192, 0, 0], [64, 128, 0], [192, 128, 0],
                       [64, 0, 128], [192, 0, 128], [64, 128, 128], [192, 128, 128],
                       [0, 64, 0], [128, 64, 0], [0, 192, 0], [128, 192, 0],
                       [0, 64, 128]])
三、训练并测试
1. 开始训练
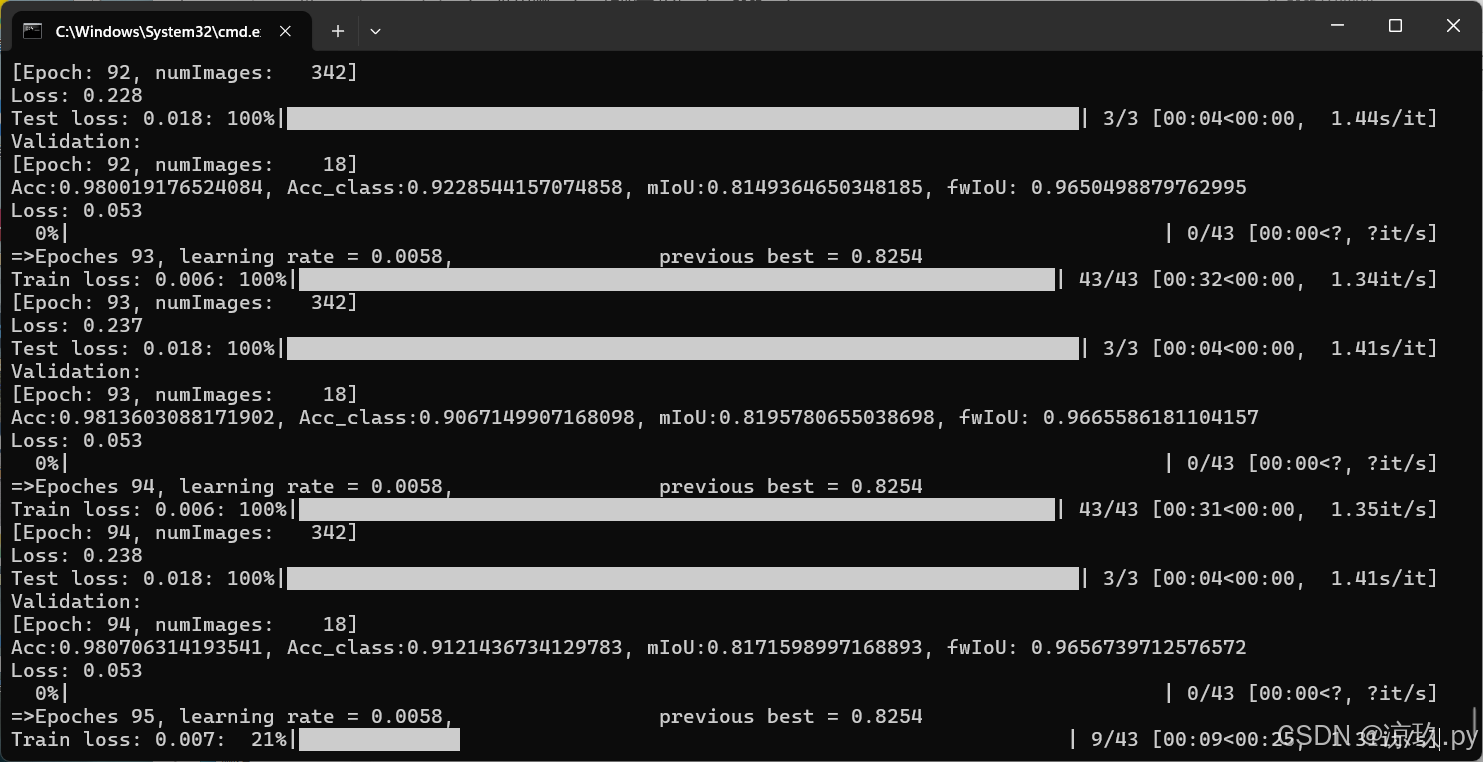
运行指令为:
python train.py --backbone mobilenet --lr 0.007 --workers 1 --epochs 50 --batch-size 8 --gpu-ids 0 --checkname deeplab-mobilenet- –backbone mobilenet 指的是使用mobilenet作为backbone
- –gpu-ids 0 指定gpu
- –checkname deeplab-mobilenet 使用mobilenet预训练模型
2. 模型测试
需要修改代码中输入测试图片的路径,测试代码:
import argparse
import os
import time
from PIL import Image
import torch
from torchvision import transforms
from torchvision.utils import make_grid, save_image
from modeling.deeplab import DeepLab
from dataloaders import custom_transforms as tr
from dataloaders.utils import decode_seg_map_sequence

def main():
    parser = argparse.ArgumentParser(description="PyTorch DeeplabV3Plus Testing")
    parser.add_argument('--in-path', type=str, default='E:/VScode project/pytorch-deeplab-xception-master/Seg552/test', help='input image directory')
    parser.add_argument('--backbone', type=str, default='resnet', choices=['resnet', 'xception', 'drn', 'mobilenet'], help='backbone name (default: resnet)')
    parser.add_argument('--ckpt', type=str, default='E:/test/pytorch-deeplab-xception-masterrun/Seg552/deeplab-mobilenet/experiment_9/checkpoint.pth.tar', help='saved model path')
    parser.add_argument('--out-stride', type=int, default=16, help='network output stride (default: 8)')
    parser.add_argument('--no-cuda', action='store_true', default=False, help='disables CUDA training')
    parser.add_argument('--num_classes', type=int, default=3, help='number of classes')

    args = parser.parse_args()
    args.cuda = not args.no_cuda and torch.cuda.is_available()

    model = DeepLab(num_classes=args.num_classes, backbone=args.backbone, output_stride=args.out_stride)

    try:
        ckpt = torch.load(args.ckpt, map_location='cpu')
        model.load_state_dict(ckpt['state_dict'])
        print("Model loaded successfully.")
    except Exception as e:
        print(f"Error loading model: {e}")
        return

    model = model.cuda() if args.cuda else model

    composed_transforms = transforms.Compose([
        transforms.ToTensor(),
        transforms.Normalize(mean=(0.485, 0.456, 0.406), std=(0.229, 0.224, 0.225))
    ])

    for name in os.listdir(args.in_path):
        try:
            image_path = os.path.join(args.in_path, name)
            image = Image.open(image_path).convert('RGB')

            # 直接将图像转换为张量
            tensor_in = composed_transforms(image).unsqueeze(0)

            model.eval()
            if args.cuda:
                tensor_in = tensor_in.cuda()

            with torch.no_grad():
                output = model(tensor_in)

            decoded_output = decode_seg_map_sequence(torch.max(output[:3], 1)[1].detach().cpu().numpy())
            grid_image = make_grid(decoded_output, 3, normalize=False)
            save_image(grid_image, os.path.join(args.in_path, f"{name[:-4]}_mask.png"))
        except Exception as e:
            print(f"Error processing {name}: {e}")

    print("Processing complete.")

if __name__ == "__main__":
    main()
运行指令为:
python testdemo.py --ckpt run/Seg552/deeplab-mobilenet/experiment/checkpoint.pth.tar --backbone mobilenet修改–in-path为数据集的测试图片,结果保存在–in-path中
参考博客:
【windows10】使用pytorch版本deeplabv3+训练自己数据集_deeplab pytorch-CSDN博客
Pytorch版deeplabv3+环境配置训练自己的数据集_pytorch deeplabv3+训练自己的数据集自定义init len getitem-CSDN博客

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐


 26
 0
- 0


 已为社区贡献1条内容

所有评论(0)