Pytorch入门实战第六周:VGG-16算法-Pytorch实现人脸识别
目录
前言
- 🍨 本文为[🔗365天深度学习训练营](https://mp.weixin.qq.com/s/0dvHCaOoFnW8SCp3JpzKxg) 中的学习记录博客**
- 🍖 原作者:[K同学啊](https://mtyjkh.blog.csdn.net/)
说在前面
本周学习目标:保存训练过程中的最佳模型权重,调用官方的VGG-16网络框架;拔高——使得测试集准确率达到60%(难度稍微有些大),手动搭建VGG-16网络框架
我的环境:Python3.8、Pycharm2020、torch1.12.1+cu113
数据来源:[K同学啊](https://mtyjkh.blog.csdn.net/))
一、前期准备
1.1 导入所需的包并设置GPU
(有GPU优先使用GPU,没有的话就使用CPU)
代码如下:
#一、前期准备
'''
1.1 设置GPU/CPU
'''
import torch
import torch.nn as nn
import torchvision.transforms as transforms
import torchvision
from torchvision import transforms, datasets
import os,PIL,pathlib,warnings
#import torch.nn.functional as F
import matplotlib.pyplot as plt
from PIL import Image
from torchvision.models import vgg16
import copy

warnings.filterwarnings("ignore")        #忽略警告信息--???怎么突然增加一个这个

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print(device)
打印输出:cuda
1.2 导入数据
1.数据下载并设置相应的文件目录以便图片读取,将数据下载放在对应代码目录下新建的data目录
- 数据集介绍:一共是17个人的人脸照片,每个人对应100张人脸图,一共是1700张图片,分别放在17个子文件下,每个子文件夹即为人名

导入数据的步骤:
1)使用函数将字符串类型的文件夹路径转换为pathlib.Path对象
2)使用glob方法获取data_dir路径下的所有文件路径,并以列表的形式存储在data_paths中
3)利用split()函数对data_paths中的每个文件路径执行分割操作,获取各个文件所属的类别名称并储存在classNames中
数据文件导入代码如下:
'''
1.2 导入数据
'''
data_dir = './data/'
data_dir = pathlib.Path(data_dir)           #使用pathlib.Path()函数将字符串类型的文件夹路径转换为pathlib.Path对象
data_paths = list(data_dir.glob('*'))       #使用glob()方法获取data_dir路径下的所有文件路径,并以列表形式存储在data_paths中
classNames = [str(path).split("\\")[1] for path in data_paths]   #使用data_paths中每个文件路径执行分割操作,获得各文件所属的类别名称
print(classNames)
打印结果为:['Angelina Jolie', 'Brad Pitt', 'Denzel Washington', 'Hugh Jackman', 'Jennifer Lawrence', 'Johnny Depp', 'Kate Winslet', 'Leonardo DiCaprio', 'Megan Fox', 'Natalie Portman', 'Nicole Kidman', 'Robert Downey Jr', 'Sandra Bullock', 'Scarlett Johansson', 'Tom Cruise', 'Tom Hanks', 'Will Smith']
2.图片数据处理
torchvision.transforms是pytorch中的图像预处理包。一般用Compose把多个步骤整合到一起
1)Resize:将输入图片resize成统一尺寸
2)ToTensor:将PIL Image或numpy.ndarray转换为tensor,并归一化到[0,1]之间
3)Normalize:标准化处理-->转换为标准正态分布,使模型更容易收敛;其中mean=[0.485,0.456,0.406]与std=[0.229,0.224,0.225] 从数据集中随机抽样计算得到的
ImageFolder类来创建一个数据集对象,total_data将是一个包含所有图像数据的数据集对象,可以用于训练神经网络模型
代码如下:
train_transforms = transforms.Compose([
    transforms.Resize([224, 224]),  # 将输入图片resize成统一尺寸
    # transforms.RandomHorizontalFlip(), # 随机水平翻转
    transforms.ToTensor(),          # 将PIL Image或numpy.ndarray转换为tensor,并归一化到[0,1]之间
    transforms.Normalize(           # 标准化处理-->转换为标准正态分布(高斯分布),使模型更容易收敛
        mean=[0.485, 0.456, 0.406],
        std=[0.229, 0.224, 0.225])  # 其中 mean=[0.485,0.456,0.406]与std=[0.229,0.224,0.225] 从数据集中随机抽样计算得到的。
])
#datasets模块中的ImageFolder类从名为"data"的文件夹中加载图像数据集,并将数据应用train_transforms函数进行预处理
total_data = datasets.ImageFolder("./data/", transform=train_transforms)
print(total_data)
print(total_data.class_to_idx)     #total_data.class_to_idx是一个存储了数据集类别和对于索引的字典
打印如下:
Dataset ImageFolder
Number of datapoints: 1800
Root location: ./data/
StandardTransform
Transform: Compose(
Resize(size=[224, 224], interpolation=bilinear, max_size=None, antialias=warn)
ToTensor()
Normalize(mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])
)
{'Angelina Jolie': 0, 'Brad Pitt': 1, 'Denzel Washington': 2, 'Hugh Jackman': 3, 'Jennifer Lawrence': 4, 'Johnny Depp': 5, 'Kate Winslet': 6, 'Leonardo DiCaprio': 7, 'Megan Fox': 8, 'Natalie Portman': 9, 'Nicole Kidman': 10, 'Robert Downey Jr': 11, 'Sandra Bullock': 12, 'Scarlett Johansson': 13, 'Tom Cruise': 14, 'Tom Hanks': 15, 'Will Smith': 16}
1.3 划分数据集
取全部数据的80%作为训练集、剩下的20%作为测试集,并随机分割数据集为训练集测试集
torch.utils.data.random_split(dataset, lengths, generator=<torch._C.Generator object>)
随机将一个数据集分割成给定长度的不重叠的新数据集。可选择固定生成器以获得可复现的结果(效果同设置随机种子)。
dataset (Dataset) – 要划分的数据集。
lengths (sequence) – 要划分的长度。
generator (Generator) – 用于随机排列的生成器。
代码如下:
'''
1.3 划分数据集
'''
train_size = int(0.8 * len(total_data))     #取全部数据的80%作为训练集
test_size = len(total_data) - train_size    #剩下的20%作为测试集
#将total_data数据集随机分割成训练集和测试集,并以Dataset对象形式返回
train_dataset, test_dataset = torch.utils.data.random_split(total_data, [train_size, test_size])
print(train_dataset, test_dataset)
print(train_size, test_size)
打印如下:
<torch.utils.data.dataset.Subset object at 0x00000282A470A760> <torch.utils.data.dataset.Subset object at 0x00000282A470A700>
1440 360
1.4 查看一个batch_size的数据结构
torch.utils.data.DataLoader():这是Pytorch中用于加载和管理数据的一个实用工具类,它允许以小批次的方式迭代数据集,这对于训练神经网络和其他机器学习任务非常有用。具体参数解释如下:
1)dataset(必需参数):这是你的数据集对象,通常是 torch.utils.data.Dataset 的子类,它包含了你的数据样本。
2)batch_size(可选参数):指定每个小批次中包含的样本数。默认值为 1。
3)shuffle(可选参数):如果设置为 True,则在每个 epoch 开始时对数据进行洗牌,以随机打乱样本的顺序。这对于训练数据的随机性很重要,以避免模型学习到数据的顺序性。默认值为 False。
4)num_workers(可选参数):用于数据加载的子进程数量。通常,将其设置为大于 0 的值可以加快数据加载速度,特别是当数据集很大时。默认值为 0,表示在主进程中加载数据。
5)pin_memory(可选参数):如果设置为 True,则数据加载到 GPU 时会将数据存储在 CUDA 的锁页内存中,这可以加速数据传输到 GPU。默认值为 False。
6)drop_last(可选参数):如果设置为 True,则在最后一个小批次可能包含样本数小于 batch_size 时,丢弃该小批次。这在某些情况下很有用,以确保所有小批次具有相同的大小。默认值为 False。
7)timeout(可选参数):如果设置为正整数,它定义了每个子进程在等待数据加载器传递数据时的超时时间(以秒为单位)。这可以用于避免子进程卡住的情况。默认值为 0,表示没有超时限制。
8)worker_init_fn(可选参数):一个可选的函数,用于初始化每个子进程的状态。这对于设置每个子进程的随机种子或其他初始化操作很有用
代码如下:
batch_size = 32
train_dl = torch.utils.data.DataLoader(train_dataset,
                                       batch_size=batch_size,
                                       shuffle=True,
                                       num_workers=0)
test_dl = torch.utils.data.DataLoader(test_dataset,
                                      batch_size=batch_size,
                                      shuffle=True,
                                      num_workers=0)

for X, y in test_dl:
    print("Shape of X [N, C, H, W]: ", X.shape)
    print("Shape of y: ", y.shape, y.dtype)
    break
打印如下:
Shape of X [N, C, H, W]: torch.Size([32, 3, 224, 224])
Shape of y: torch.Size([32]) torch.int64
二、调用官方的VGG-16模型
2.1 VGG-16的基本介绍
1.简介:
VGG-16(Visual Geometry Group-16)是由牛津大学视觉几何组(Visual Geometry Group)提出的一种深度卷积神经网络架构,用于图像分类和对象识别任务。VGG-16在2014年被提出,是VGG系列中的一种。VGG-16之所以备受关注,是因为它在ImageNet图像识别竞赛中取得了很好的成绩,展示了其在大规模图像识别任务中的有效性
2.主要特点:
- 深度:VGG-16由16个卷积层和3个全连接层组成,因此具有相对较深的网络结构,有助于网络学习到更加抽象和复杂的特征
- 卷积层的设计:VGG-16的卷积层全部采用3×3的卷积核和步长为1的卷积操作,同时在卷积层之后都接有ReLU激活函数,这种设计的好处在于通过堆叠多个较小的 卷积核,可以提高网络的非线性建模能力,同时减少了参数数量,从而降低了过拟合的风险
- 池化层:在卷积层之后,VGG-16使用最大池化层来减少特征图的空间尺寸,帮助提取更加显著的特征并减少计算量
- 全连接层:VGG-16在卷积层之后接有3个全连接层,最后一个全连接层输出与类别数相对应的向量用于进行分类
3.模型结构分析
模型网络结构图如下图所示
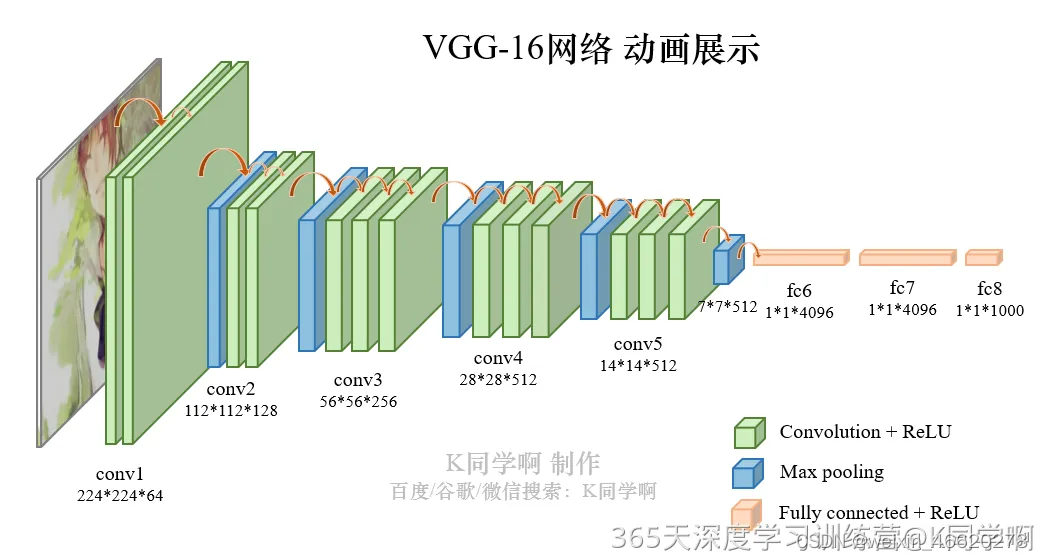
VGG-16一共包含了16个隐藏层(13个卷积层和3个全连接层)
13个卷积层:分别用blockX_convX表示
3个全连接层:用classifier表示
5个池化层
2.2 调用过程
代码如下:
device = "cuda" if torch.cuda.is_available() else "cpu"
print("Using {} device".format(device))

#加载预训练模型,并且对模型进行微调
model = vgg16(pretrained=True).to(device)      #加载预训练的vgg16

for param in model.parameters():
    param.requires_grad = False            #冻结模型的参数,这样在训练的时候只训练最后一层的参数

#修改classfier模块的第六层(即:(6):Linear(in_features=4096, out_features=2, bias=True))
#注意下面打印出来的模型
model.classifier._modules['6'] = nn.Linear(4096,len(classNames))   #修改vgg-16模型最后一层全连接层,输出目标类别个数
model.to(device)
print(model)
模型结构打印如下(可以根据这个打印的官方网络结构后续手动搭建VGG-16网络框架)
Using cuda device
VGG(
(features): Sequential(
(0): Conv2d(3, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(1): ReLU(inplace=True)
(2): Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(3): ReLU(inplace=True)
(4): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
(5): Conv2d(64, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(6): ReLU(inplace=True)
(7): Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(8): ReLU(inplace=True)
(9): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
(10): Conv2d(128, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(11): ReLU(inplace=True)
(12): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(13): ReLU(inplace=True)
(14): Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(15): ReLU(inplace=True)
(16): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
(17): Conv2d(256, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(18): ReLU(inplace=True)
(19): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(20): ReLU(inplace=True)
(21): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(22): ReLU(inplace=True)
(23): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
(24): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(25): ReLU(inplace=True)
(26): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(27): ReLU(inplace=True)
(28): Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1))
(29): ReLU(inplace=True)
(30): MaxPool2d(kernel_size=2, stride=2, padding=0, dilation=1, ceil_mode=False)
)
(avgpool): AdaptiveAvgPool2d(output_size=(7, 7))
(classifier): Sequential(
(0): Linear(in_features=25088, out_features=4096, bias=True)
(1): ReLU(inplace=True)
(2): Dropout(p=0.5, inplace=False)
(3): Linear(in_features=4096, out_features=4096, bias=True)
(4): ReLU(inplace=True)
(5): Dropout(p=0.5, inplace=False)
(6): Linear(in_features=4096, out_features=17, bias=True)
)
)
三、训练模型
3.1 编写训练函数
代码如下:
#三、训练模型s
'''
3.1 编写训练函数
'''
def train(dataloader, model, loss_fn, optimier):
    size = len(dataloader.dataset)    #训练集的大小
    num_batches = len(dataloader)

    train_loss, train_acc =0, 0

    for X, y in dataloader:
        X, y = X.to(device), y.to(device)

        #计算预测误差
        pred = model(X)
        loss = loss_fn(pred, y)
        #反向传播
        optimier.zero_grad()   #grad属性归零
        loss.backward()        #反向传播
        optimier.step()        #每一步自动更新
        #记录acc和loss
        train_acc += (pred.argmax(1) == y).type(torch.float).sum().item()
        train_loss +=loss.item()

    train_acc /= size
    train_loss /= num_batches

    return train_acc, train_loss
3.2 编写测试函数
代码如下:
'''
3.2 编写测试函数
'''
def test(dataloader, model, loss_fn):
    size = len(dataloader.dataset)  # 测试集的大小
    num_batches = len(dataloader)
    test_loss, test_acc = 0, 0

    # 当不进行训练时,停止梯度更新,节省计算内存消耗
    with torch.no_grad():
        for imgs, target in dataloader:
            imgs, target = imgs.to(device), target.to(device)

            # 计算loss
            target_pred = model(imgs)
            loss = loss_fn(target_pred, target)

            test_loss += loss.item()
            test_acc += (target_pred.argmax(1) == target).type(torch.float).sum().item()

    test_acc /= size
    test_loss /= num_batches

    return test_acc, test_loss
3.3 设置动态学习率
torch.optim.lr_scheduler.LambdaLR(optimizer, lr_lambda, last_epoch=-1, verbose=False)
optimizer(Optimizer):是之前定义好的需要优化的优化器的实例名
lr_lambda(function):更新学习率的函数更多的官方动态学习率设置方式可参考:torch.optim — PyTorch 2.2 documentation
代码如下:
'''
3.3 设置动态学习率
这里调用官方动态学习率接口——根据自定义的函数更新学习率lr_scheduler.LambdaLR
optimizer:是之前定义好的需要优化的优化器的实例名
lr_lambda(function):更新学习率的函数
'''
learn_rate = 1e-3    #初始学习率
lambda1 = lambda epoch: 0.92 ** (epoch // 4)
optimizer = torch.optim.Adam(model.parameters(), lr=learn_rate)
scheduler = torch.optim.lr_scheduler.LambdaLR(optimizer, lr_lambda=lambda1)    #选取调整方法
3.4 正式训练
重点关注如何保存最佳模型
先初始化最佳准确率为0,然后在模型训练过程中,当test_acc大于我们设定的最佳准确率之后,将best_acc更新为test_acc,并将对应test_acc的模型保存到best_model,这样整个过程中就会随着不断训练,自动更新best_model
copy.deepcopy():
代码如下:
'''
3.4 正式训练
'''
loss_fn = nn.CrossEntropyLoss()      #创建损失函数
epochs = 40
train_loss = []
train_acc = []
test_loss = []
test_acc = []

best_acc = 0        #先设置一个最佳准确率,作为最佳模型的判别指标

for epoch in range(epochs):
    model.train()
    epoch_train_acc, epoch_train_loss = train(train_dl, model, loss_fn, optimizer)
    scheduler.step()         #更新学习率(调用官方动态学习率接口时使用)

    model.eval()
    epoch_test_acc, epoch_test_loss = test(test_dl, model, loss_fn)

    #保存最佳模型到best_model
    if epoch_test_acc > best_acc:
        best_acc = epoch_test_acc
        best_model = copy.deepcopy(model)

    train_acc.append(epoch_train_acc)
    train_loss.append(epoch_train_loss)
    test_acc.append(epoch_test_acc)
    test_loss.append(epoch_test_loss)

    #获取当前的学习率
    lr = optimizer.state_dict()['param_groups'][0]['lr']

    template = ('Epoch:{:2d}, Train_acc:{:.1f}%, Train_loss:{:.3f}, Test_acc:{:.1f}%,Test_loss:{:.3f}, lr:{:.2E}')
    print(template.format(epoch + 1, epoch_train_acc * 100, epoch_train_loss, epoch_test_acc * 100, epoch_test_loss,lr))
print(best_acc)
#保存最佳模型到文件中
PATH = './best_model4.pth'        #保存的参数文件名
torch.save(best_model.state_dict(), PATH)

print('Done')
训练过程打印如下:
Epoch: 1, Train_acc:8.6%, Train_loss:2.878, Test_acc:10.6%,Test_loss:2.808, lr:1.00E-04
Epoch: 2, Train_acc:10.6%, Train_loss:2.824, Test_acc:13.9%,Test_loss:2.783, lr:1.00E-04
Epoch: 3, Train_acc:9.0%, Train_loss:2.822, Test_acc:14.2%,Test_loss:2.761, lr:1.00E-04
Epoch: 4, Train_acc:12.2%, Train_loss:2.776, Test_acc:15.8%,Test_loss:2.733, lr:1.00E-04
Epoch: 5, Train_acc:11.2%, Train_loss:2.759, Test_acc:16.4%,Test_loss:2.699, lr:1.00E-04
Epoch: 6, Train_acc:12.3%, Train_loss:2.747, Test_acc:16.7%,Test_loss:2.676, lr:1.00E-04
Epoch: 7, Train_acc:12.1%, Train_loss:2.734, Test_acc:17.2%,Test_loss:2.644, lr:1.00E-04
Epoch: 8, Train_acc:13.1%, Train_loss:2.695, Test_acc:18.6%,Test_loss:2.641, lr:1.00E-04
Epoch: 9, Train_acc:14.0%, Train_loss:2.665, Test_acc:19.2%,Test_loss:2.628, lr:1.00E-04
Epoch:10, Train_acc:15.7%, Train_loss:2.671, Test_acc:19.2%,Test_loss:2.593, lr:1.00E-04
Epoch:11, Train_acc:14.8%, Train_loss:2.642, Test_acc:18.9%,Test_loss:2.579, lr:1.00E-04
Epoch:12, Train_acc:15.6%, Train_loss:2.635, Test_acc:18.6%,Test_loss:2.560, lr:1.00E-04
Epoch:13, Train_acc:15.8%, Train_loss:2.610, Test_acc:19.7%,Test_loss:2.548, lr:1.00E-04
Epoch:14, Train_acc:14.5%, Train_loss:2.613, Test_acc:20.3%,Test_loss:2.551, lr:1.00E-04
Epoch:15, Train_acc:16.9%, Train_loss:2.579, Test_acc:20.6%,Test_loss:2.520, lr:1.00E-04
Epoch:16, Train_acc:17.4%, Train_loss:2.570, Test_acc:21.4%,Test_loss:2.515, lr:1.00E-04
Epoch:17, Train_acc:17.3%, Train_loss:2.558, Test_acc:21.1%,Test_loss:2.519, lr:1.00E-04
Epoch:18, Train_acc:17.1%, Train_loss:2.545, Test_acc:21.9%,Test_loss:2.492, lr:1.00E-04
Epoch:19, Train_acc:16.0%, Train_loss:2.555, Test_acc:22.5%,Test_loss:2.490, lr:1.00E-04
Epoch:20, Train_acc:17.4%, Train_loss:2.525, Test_acc:24.4%,Test_loss:2.485, lr:1.00E-04
Epoch:21, Train_acc:17.8%, Train_loss:2.498, Test_acc:24.4%,Test_loss:2.461, lr:1.00E-04
Epoch:22, Train_acc:18.3%, Train_loss:2.498, Test_acc:23.9%,Test_loss:2.433, lr:1.00E-04
Epoch:23, Train_acc:18.8%, Train_loss:2.476, Test_acc:24.2%,Test_loss:2.448, lr:1.00E-04
Epoch:24, Train_acc:18.1%, Train_loss:2.482, Test_acc:24.4%,Test_loss:2.440, lr:1.00E-04
Epoch:25, Train_acc:19.1%, Train_loss:2.466, Test_acc:24.7%,Test_loss:2.426, lr:1.00E-04
Epoch:26, Train_acc:18.7%, Train_loss:2.463, Test_acc:25.3%,Test_loss:2.414, lr:1.00E-04
Epoch:27, Train_acc:20.1%, Train_loss:2.445, Test_acc:25.6%,Test_loss:2.411, lr:1.00E-04
Epoch:28, Train_acc:20.5%, Train_loss:2.433, Test_acc:25.6%,Test_loss:2.394, lr:1.00E-04
Epoch:29, Train_acc:20.7%, Train_loss:2.434, Test_acc:25.6%,Test_loss:2.410, lr:1.00E-04
Epoch:30, Train_acc:21.9%, Train_loss:2.409, Test_acc:26.1%,Test_loss:2.401, lr:1.00E-04
Epoch:31, Train_acc:21.4%, Train_loss:2.412, Test_acc:26.4%,Test_loss:2.385, lr:1.00E-04
Epoch:32, Train_acc:21.2%, Train_loss:2.399, Test_acc:26.7%,Test_loss:2.389, lr:1.00E-04
Epoch:33, Train_acc:20.8%, Train_loss:2.392, Test_acc:26.4%,Test_loss:2.360, lr:1.00E-04
Epoch:34, Train_acc:21.7%, Train_loss:2.392, Test_acc:26.4%,Test_loss:2.366, lr:1.00E-04
Epoch:35, Train_acc:21.4%, Train_loss:2.385, Test_acc:26.1%,Test_loss:2.361, lr:1.00E-04
Epoch:36, Train_acc:21.6%, Train_loss:2.372, Test_acc:26.1%,Test_loss:2.345, lr:1.00E-04
Epoch:37, Train_acc:22.9%, Train_loss:2.377, Test_acc:26.4%,Test_loss:2.343, lr:1.00E-04
Epoch:38, Train_acc:21.2%, Train_loss:2.366, Test_acc:26.7%,Test_loss:2.337, lr:1.00E-04
Epoch:39, Train_acc:23.8%, Train_loss:2.337, Test_acc:26.7%,Test_loss:2.332, lr:1.00E-04
Epoch:40, Train_acc:22.5%, Train_loss:2.337, Test_acc:26.7%,Test_loss:2.328, lr:1.00E-04
Done
四、结果可视化
4.1 Loss与Accuracy图
代码如下:
#四、结果可视化
'''
4.1 Loss和Accuracy图
'''
import warnings
warnings.filterwarnings("ignore")             #忽略警告信息
plt.rcParams['font.sans-serif'] = ['SimHei']  #用来正常显示中文标签
plt.rcParams['axes.unicode_minus'] = False    #用来正常显示负号
plt.rcParams['figure.dpi'] = 100              #分辨率

epochs_range = range(epochs)

plt.figure(figsize=(12, 3))     #figsize 设置图形的大小,a 为图形的宽, b 为图形的高,单位为英寸
plt.subplot(1, 2, 1)   #plt.subplot(nrows, ncols, index),nrows:表示分割画布的行数,ncols:表示分割画布的列数,index:表示子图在画布中的索引,从左往右,从上往下编号

plt.plot(epochs_range, train_acc, label='Training Accuracy')
plt.plot(epochs_range, test_acc, label='Test Accuracy')
plt.legend(loc='lower right')
plt.title('Training and Validation Accuracy')

plt.subplot(1, 2, 2)
plt.plot(epochs_range, train_loss, label='Training Loss')
plt.plot(epochs_range, test_loss, label='Test Loss')
plt.legend(loc='upper right')
plt.title('Training and Validation Loss')
plt.savefig('./data/loss_acc04.png')
plt.show()
可视化结果如下:

4.2 指定图片进行预测
代码如下:
'''
4.2 指定图片进行预测
'''
classes = list(total_data.class_to_idx)

def predict_one_image(image_path, model, transform, classes):
    test_img = Image.open(image_path).convert('RGB')
    plt.imshow(test_img)       #展示预测的图片

    test_img = transform(test_img)
    img = test_img.to(device).unsqueeze(0)

    model.eval()
    output = model(img)

    _,pred = torch.max(output,1)
    pred_class = classes[pred]
    print(f'预测结果是:{pred_class}')

#预测训练集中的某张照片
predict_one_image(image_path='./data/Kate Winslet/003_acb20793.jpg', model=model, transform=train_transforms,classes=classes)
打印输出为:
预测结果是:Megan Fox
4.3 模型评估
best_model.eval()
epoch_test_acc, epoch_test_loss = test(test_dl, best_model, loss_fn)
print(epoch_test_acc, epoch_test_loss)
结果输出:0.26666666666666666 2.3874486088752747
前面我们保存的best_acc=0.26666666666666666
所以两者一致,模型加载没有问题
五、拔高尝试
5.1 手动搭建VGG-16模型
代码如下:
class vgg16_diy(nn.Module):
    def __init__(self):
        super(vgg16_diy, self).__init__()
        #nn.Sequential是一个Sequential容器,模块将按照构造函数中传递的顺序添加到模块中
        #卷积块1:224*224*64
        self.conv = nn.Sequential(
            nn.Conv2d(3, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1)),
            nn.ReLU(),
            nn.Conv2d(64, 64, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1)),
            nn.ReLU(), nn.MaxPool2d(kernel_size=2, stride=2),
            nn.Conv2d(64, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1)),
            nn.ReLU(),
            nn.Conv2d(128, 128, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1)),
            nn.ReLU(), nn.MaxPool2d(kernel_size=2, stride=2),
            nn.Conv2d(128, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1)),
            nn.ReLU(),
            nn.Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1)),
            nn.ReLU(),
            nn.Conv2d(256, 256, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1)),
            nn.ReLU(),
            nn.MaxPool2d(kernel_size=2, stride=2),
            nn.Conv2d(256, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1)),
            nn.ReLU(),
            nn.Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1)),
            nn.ReLU(),
            nn.Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1)),
            nn.ReLU(),
            nn.MaxPool2d(kernel_size=2, stride=2),
            nn.Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1)),
            nn.ReLU(),
            nn.Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1)),
            nn.ReLU(),
            nn.Conv2d(512, 512, kernel_size=(3, 3), stride=(1, 1), padding=(1, 1)),
            nn.ReLU(),
            nn.MaxPool2d(kernel_size=2, stride=2))
        # avgpool
        self.avgpool = nn.AdaptiveAvgPool2d(output_size=(7, 7))
        # 全连接层,用于分类
        self.classifier = nn.Sequential(
            nn.Linear(in_features=512 * 7 * 7, out_features=4096),
            nn.ReLU(),
            nn.Dropout(p=0.5),
            nn.Linear(in_features=4096, out_features=4096, bias=True),
            nn.ReLU(),
            nn.Dropout(p=0.5),
            nn.Linear(in_features=4096, out_features=17)
        )
    #前向传播
    def forward(self, x):
        x = self.conv(x)           #卷积-BN-激活
        x = self.avgpool(x)
        x = torch.flatten(x, start_dim=1)
        x = self.classifier(x)

        return x

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print(device)

#device = 'cuda:0' if torch.cuda.is_available() else 'cpu'
model = vgg16_diy().to(device)

print(model)
模型打印如下:
打印结果与我们调用官方函数打印结果一致的
5.2 提高在测试集上的准确率尝试
1.尝试修改优化器为Adam
初始:优化器——SGD,学习率——0.0001
优化后:优化器——Adam,学习率——0.0001
测试集上的acc最高可达到40.28%,从原来的23.3%上升到40.27%,可见Adam优化器比SGD优化器更适用于本任务
指定图片预测的结果——预测结果是:Kate Winslet(正确)
2.尝试修改为动态学习率
初始:优化器——Adam,学习率——0.0001
优化后:优化器——Adam,初始学习率——0.0001,学习率衰减为0.92倍
测试集上的acc最高可达到44.12%,从原来的40.28%上升到44.12%,可见动态学习率更适合于本任务
指定图片预测的结果——预测结果是:Kate Winslet(正确)
3.尝试修改初始学习率为0.001
优化前:优化器——Adam,初始学习率——0.0001,学习率衰减为0.92倍
优化后:优化器——Adam,初始学习率——0.001,学习率衰减为0.92倍
测试集上的acc最高可达到51.11%,从原来的44.12%上升到51.11%,可见初始学习率得谨慎选取,合适的初始学习率能使得模型性能更优,能够更加接近我们的目标
指定图片预测的结果——预测结果是:Kate Winslet(正确)
4.尝试修改模型结果(暂未完成)
目前使用手动搭建的VGG-16模型,不知道是为什么运行没训练起来,结果如下

一直没变化,所以后面我就Ctrl+C终止了训练过程
总结
- 本周重点学习了VGG-16这个模型结构,同时并根据官方调用的模型网络结构手动搭建了模型框架,但是目前还没找到为什么运行没训练起来的原因
- 同时本周还学习了如何在训练过程中保存最佳模型参数
- 还学习了如何进行模型的评估
- 最后是对测试集准确率提升的尝试,在前几周尝试的方案下还是没能取得需要达到的目标,同时根据输出的loss可以看出,是存在过拟合了,在训练集上的结果是远优于测试集,后续仍需要对模型结构进一步修改以达到更佳的性能

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐


 25
 0
- 0


 已为社区贡献1条内容

所有评论(0)