论文笔记:图像分割——GCN
Laege Kernel Matters—— Improve Semantic Segmentation by Global Convolutional Network
文章目录
论文结构
摘要: 介绍论文的背景、核心观点、方法途径、最终成果
Introduction: 背景概述、本文内容简述
Related Work: 介绍算法思想来源
Approach: 详述算法结构
Experiment: 实验结果分析
Conclusion: 实验结论
References
一、摘要核心
背景概述: 网络架构设计的一个最新趋势是在整个网络中堆叠小卷积核
本文贡献: 当必须同时执行分类和定位任务时,卷积核扮演着重要角色。小卷积核无法同时兼顾,所以要换大的卷积核。我们提出了GCN网络(全局卷积网络)来解决语义分割的分类和定位问题。还基于残差结构保证边界得到进一步的优化,重新定义对象边界。
实验结果: 分别在PASCAL VOC 2012和Cityscapes数据集中获得82.2%和76.9%的MIoU
二、引言及相关工作
① Introduction
-
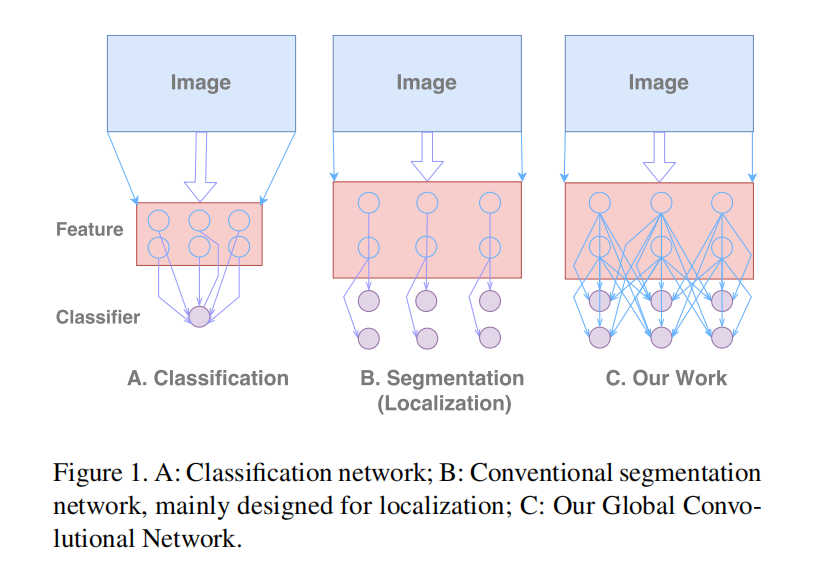
语义分割面临的两个挑战(从过程出发):分类和定位。
语义分割可以看成一个逐像素分类的任务,一个好的语义分割模型应该能同时处理好这两个挑战 -
CNN中的矛盾点:
(1)对于分类任务,模型必须具有不变性的,以适应目标的各种形式,如平移和旋转;
(2)对于定位任务,模型应该对变换敏感,即能够精准定位语义类别的每个像素。 -
本文算法结构简述:
涉及网络的两个原则:
(1)从定位的角度出发,应该采用全卷积的结构,去掉全连接层或全局池化层。因为全连接和全局池化,把二维特征图生成一维向量,会丢失定位信息。
(2)从分类的角度出发,应该采用较大的卷积核,使得像素与特征图的结合更加紧密,让每一个像素和特征图之间都保证密集连接,来增强模型对于处理输入图像不同变化的能力。如果卷积核过小,造成感受野过小,覆盖不了较大的目标,不利于分类。 -
本文贡献
(1)在分类和定位之间找到了平衡点;
(2)缓解了大卷积核参数多的问题;
(3)分别在PASCAL VOC 2012和Cityscapes数据集中获得82.2%和76.9%的MIoU。
② Related Work
Context Embedding 上下文嵌入
(1)Zoom-out 提出了一个手工构建的层次化上下文特性;
(2)ParseNet添加了一个全局池化(不适合定位,适合分类)分支来提取上下文信息;
(3)Dilated-Net在score map后面添加了几个层,以嵌入多尺度上下文;(从头到尾使用不同的采样率的空洞卷积)
(4)DeepLab V2使用ASPP,通过卷积结果的组合,直接从特征映射中组合上下文信息
Resolution Enlarging 分辨率扩大
(1)FCN使用反卷积来提高小尺寸分数图的分辨率(上采样);
(2)DeconvNet 和 SegNet 引入了反池化操作和一个glass-like(“小蛮腰状,堆成的编码-解码结构”)的网络来学习上采样过程
(3)LRR认为上采样特征图要好于上采样分数图
(4)DeepLab 和 Dilated-Net没有学习上采样的过程,而是使用空洞卷积来直接增加小尺寸特征映射的空间大小,从而得到更大尺寸的分数映射
Boundary Alignment 边界对齐
(1)在众多方法中,条件随机场CRF因其良好的数学结构而被广泛采用
(2)DeepLab直接使用denseCRF,作为CNN的一种后处理方法(v1,v2)
(3)CRF As RNN结合,将denseCRF建模为类RNN的结构,并提出了一种端到端的算法,但它在Permutohedral Lattice格点上引入了过多的CPU计算
(4)DPN对denseCRF进行了一个近似,将整个算法流程全部迁移到了GPU上
(5)Adelaide将CRF和CNN深深地结合在一起,CRF中手工设计的势能函数被卷积和非线性层取代。
三、CNN特性
-
平移不变性——用大卷积核使连接变密集
CNN的平移不变性更适用于分类任务,分类结果都不应该随着物体在图中的位置而变化。 -
没有平移同变性——用全卷积来保证
针对定位任务,CNN理论上应该具有同变性,才能保持对目标位置的敏感,然而CNN并不具有这样的特性。 -
CNN弊端
以卷积操作为例,卷积只是记忆物体的形状,并没有考虑不同轮廓的空间位置。
四、算法架构(原文3.Approach)
算法架构
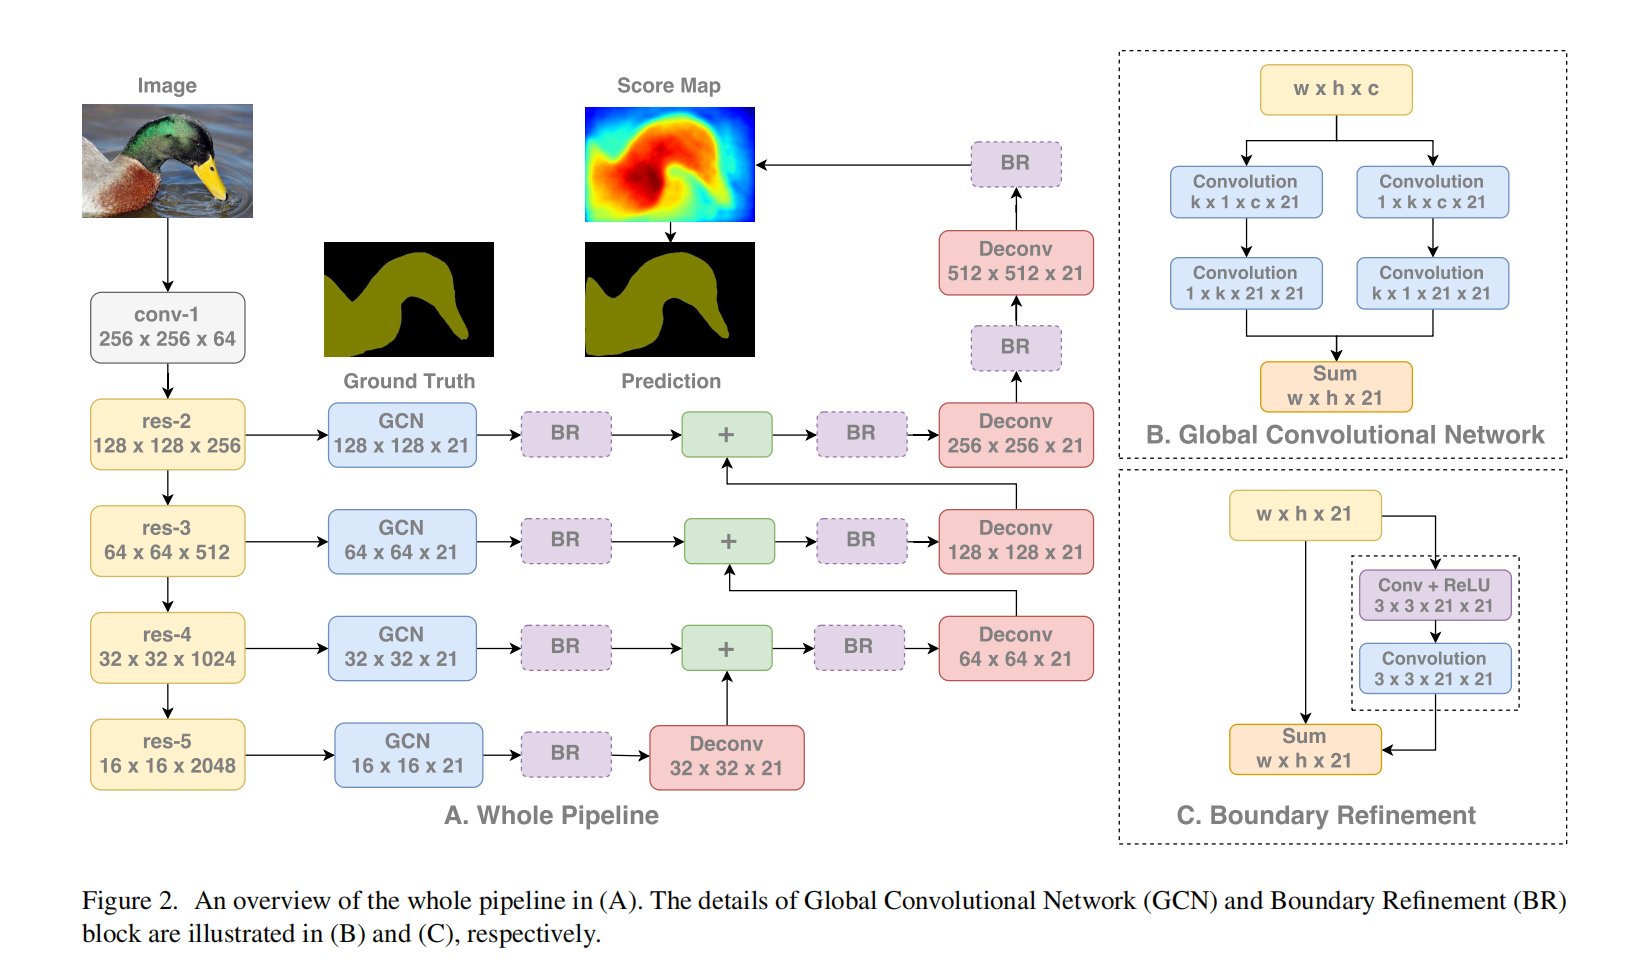
- 基础网络使用ResNet作为特征提取路径,使用FCN作为语义分割架构
- 使用了ResNet中不同stage的特征图,因此是多尺度架构
- GCN模块则用于产生低分辨率的score map,并上采样与更高分辨率的score map相加产生新的score map
- 经过最后的上采样,输出预测结构
重点
GCN的非对称结构+通道数降维;
多尺度架构
多尺度问题的方式
对输入入手:缩放达到多尺度,再特征融合。计算量过大
deeplab系列,用空洞卷积,用并联结合,加ASPP
从过程入手:GCN 在每一个basic 模块之后都输出一组特征图,进行完整的后处理
五、实验
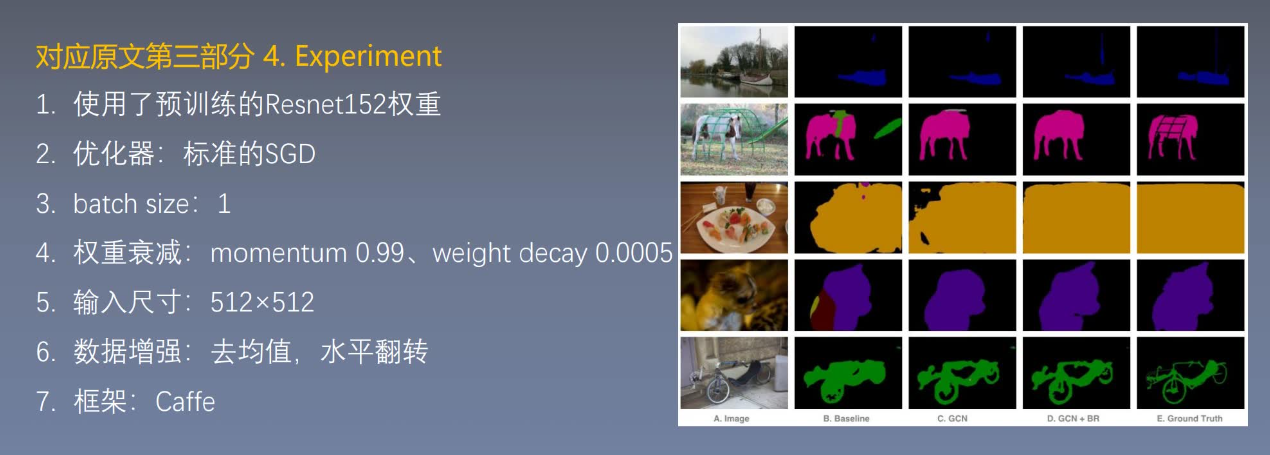
1. 实验设置
2. 实验分析
① GCN的大卷积核的重要性 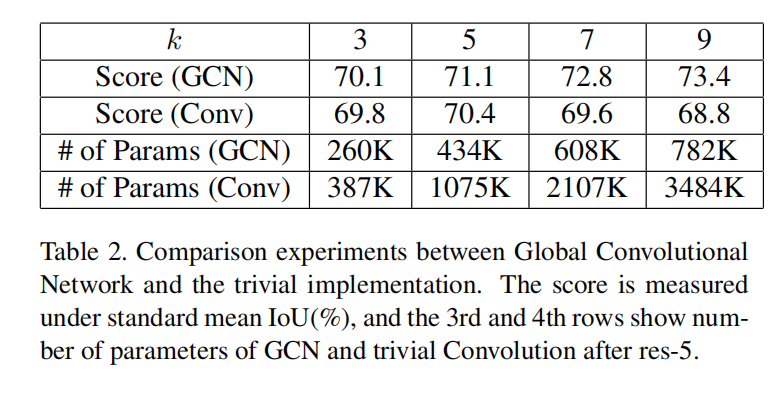
GCN的核心是使用大卷积核,卷积核大小由参数k控制。所以为了验证有效性,使用不同的k值分别测试其性能。
(1)总体网络架构如图A,不使用边界细化模块。
将每个输入图像填充到512×512中,这样最上面的特征图是16×16。
(2)为了更好的对比,使用1×1卷积baseline替换了GCN,如图B。
(3)考虑到模型性能提升可能是因为参数增加,所以我们将GCN与传统的k×k卷积核进行对比,如图C。
(4)除了GCN,还可以用小卷积核堆叠达到类似的感受野,不同于VGG,为了与GCN结构一致,我们在堆叠小卷积核时没有插入非线性层ReLU,如图D。
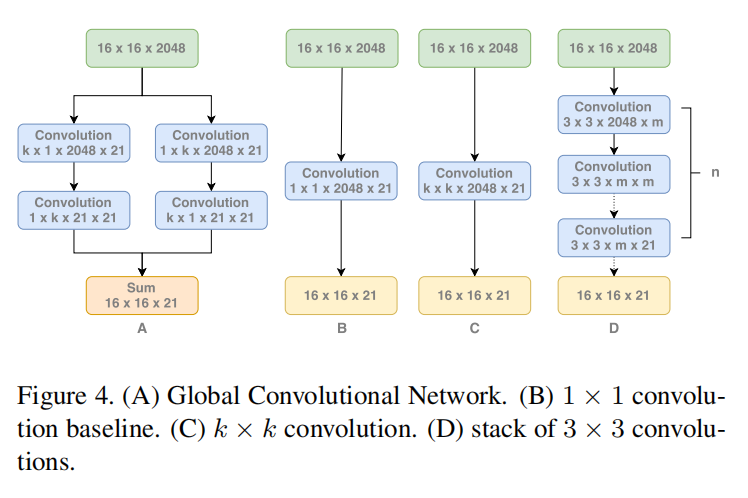
A和B比
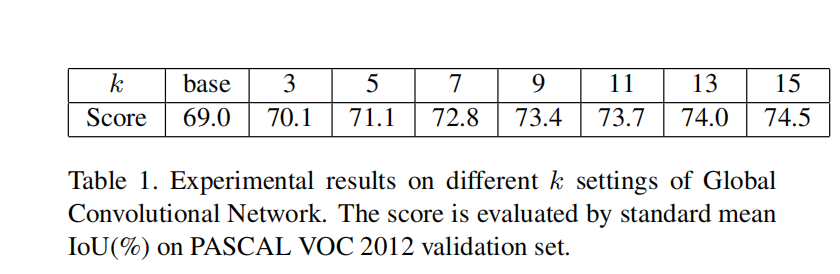
- 使用3到15不同的k值验证,在k=15时,感受野已经接近16×16,GCN结构真正达到了“全局卷积”
- 从实验结果来看,网络性能随着内核大小k增加而增加
- 特别是“全局卷积”k=15时,性能比k最小时高了5.5%
- 结果表明,大卷积核在GCN结构中带来了很大的提升,这与3.1节的分析是一致的。
A和C比
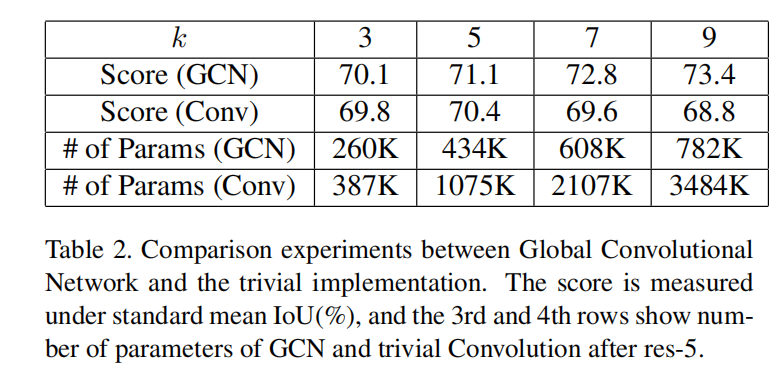
- 从结果来看,传统k×k卷积核参数更多
- GCN结构的效果一直比传统卷积核好
- 随着k增加,k×k卷积核效果先是提升,然后反而下降了,可能是因为过拟合,阻碍了传统卷积核的效果
- 在训练过程中,因为参数多,k×k卷积核的网络难以收敛
- 实际的原因还有待研究
A和D比
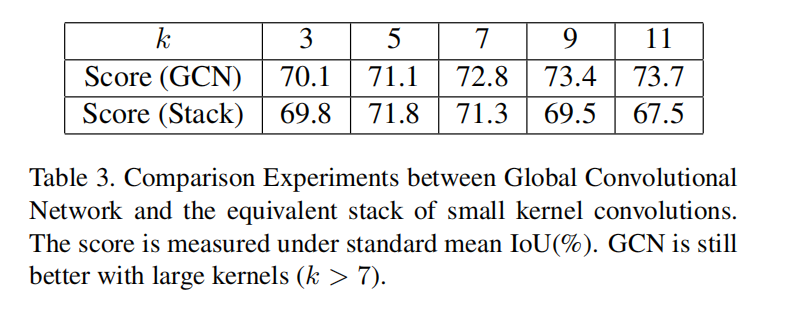
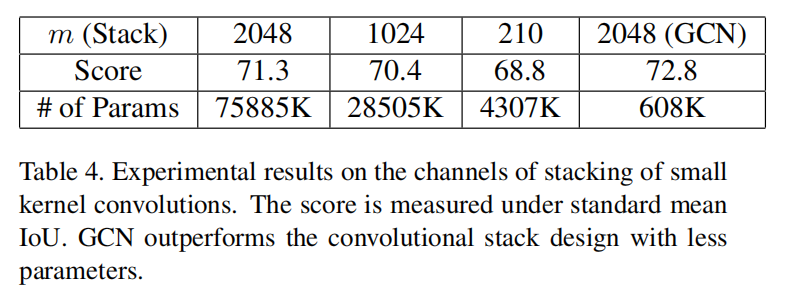
结果表明,GCN仍优于堆叠小卷积核,对于较大的核,例如k=7,堆叠3×3卷积会带来比GCN更多的参数,可能会对结果产生副作用。因此我们视图减少堆叠卷积核的中间特征映射的数量,并进一步的进行比较。
对边界像素的讨论
GCN在特征映射中引入了密集连接,有助于应对大量的变换,从而提高了分割模型的分类能力,在此基础上,可以推断:
(1)位于大目标中心的像素,任务非常接近于纯粹的分类问题
(2)然而对于对象的边界像素,其性能主要受定位能力的影响
为了验证我们的推理,把分割特征图分成两部分,在这两部分都进行评估(k=15的GCN)
(a)边界区域,这些像素接近对象的边界(距离<=7)
(b)内部区域,其他的像素
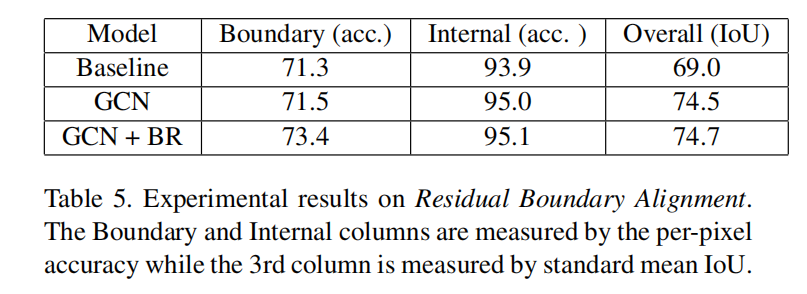
实验结果表示,GCN模型主要是提高了内部区域的精度,对边界区域精度的影响较小。与GCN结构相反,BF模块主要提高了边界区域的精度,这也证实了其有效性。
② 预训练模型的GCN(改进BR)
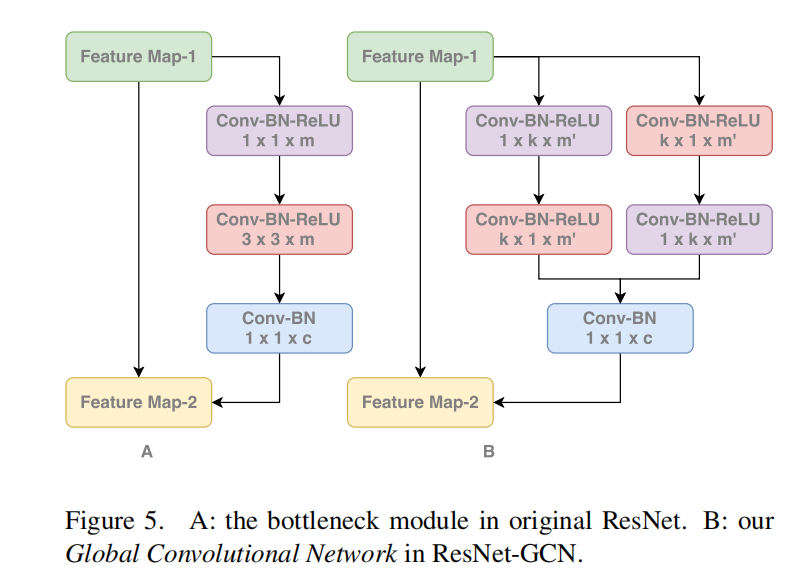
考虑到大卷积核的优点,我们很自然的把GCN的思想应用到ResNet152上,提出了一个ResNet-GCN结构。
删除了ResNet中bottleneck分支的前两层,并将其替换为GCN模块,在每个卷积层之后使用批标准化。
首先在ImageNet 2015上对ResNet-GCN进行预训练,并在Pascal VOC 2012数据集上进行fine tune。考虑到ResNet152计算成本太高,选择ResNet50来比较。
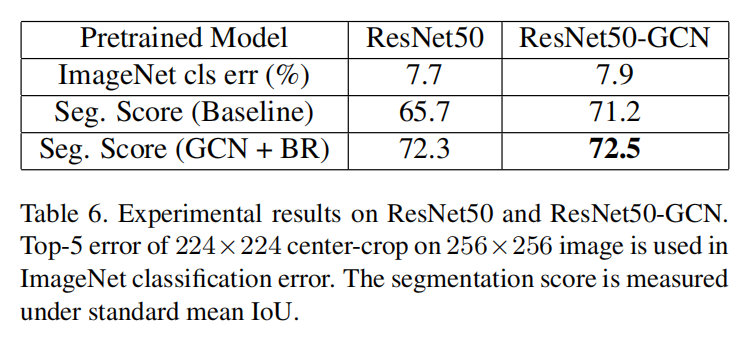
- 对ImageNet数据及分类,基于ResNet-GCN比原始ResNet稍差一些
- 在分割数据集上微调后,ResNet-GCN模型的性能显著优于原始ResNet,提高了5.5%
- 应用GCN和BR模块后,对基于GCN的与训练模型的提升变小,但模型仍然占优势
结论:无论是在预训练的模型还是针对分割的结构中,GCN主要提升分割性能。
六、结论
大卷积核对于缓解分类和定位之间的矛盾至关重要。
遵循大卷积核的原则,提出了全局卷积网络GCN。
(1)GCN改进内部的区域,有效感受野和参数量达到了很好的平衡 ,同时取得了良好的性能。
(2)为了进一步细化对象的边界,我们提出了一种新的边界细化块BR,提高了边界附近的性能。
七、卷积方式汇总
① 用小卷积核替代大卷积核(计算量变大了)
大卷积核:
优点:感受野范围大,可以看到比较全的上下文信息,也可以产生密集连接(对应下一层包含的信息更丰富)。
AlexNet、LeNet等网络都使用了比较大的卷积核,如5×5、11×11
缺点:参数量多;计算量大
小卷积核:
优点:参数量少、计算量小;整合三个非线性激活层代替单一非线性激活层,增加模型判别能力。
VGG之后
缺点:感受野不足(空洞卷积来解决);深度堆叠卷积容易出现不可控的因素(ResNet 堆叠到一定程度网络退化了,出现了残差结构)
参数计算:
输入图片和输出图片 通道数必须一致时,堆叠使用小卷积核的参数量要少一些,
如果输入是3通道,输出64通道,
用大卷积核的参数量更少:5×5×3×64 = 4800
堆叠2个小卷积核:3×3×3×64 + 3×3×64×64 =28592
所以很多网络的第一层使用的都是7×7的大卷积核接收输入图片。
② 让固定大小的卷积核看到更大范围的区域
空洞卷积 可以实现。
当rate=2时,就能把感受域从3×3变成5×5.
pooling下采样操作导致信息丢失是不可逆的,不利于像素级任务,用空洞卷积代替pooling(成倍的增加感受野)更适用于语义分割。
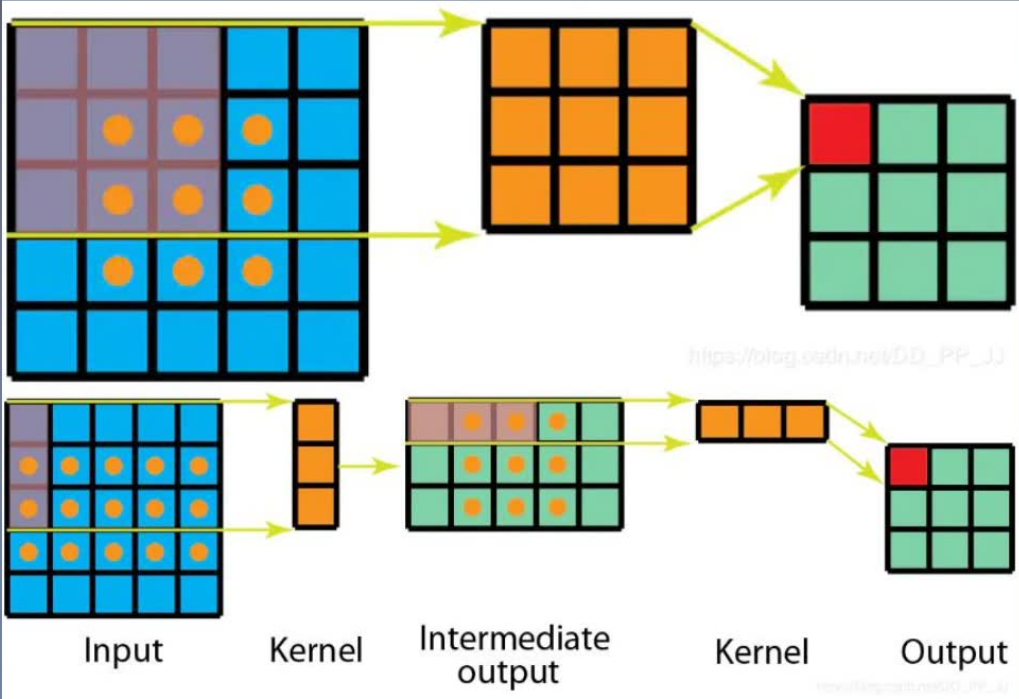
③ 非对称卷积(减少计算量)
将标准3×3卷积拆分为一个1×3卷积和一个3×1卷积,在不改变感受野的情况下,减少了计算量
标准对称卷积:9×9=81 一共滑动了9次,每次要做9次乘法
非对称卷积:3×15+3×9=72次乘法
④ 组卷积 & 深度可分离卷积
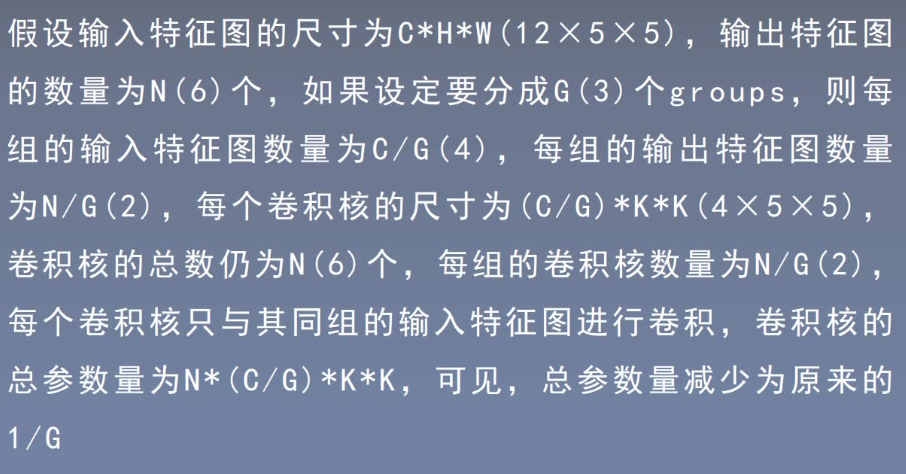
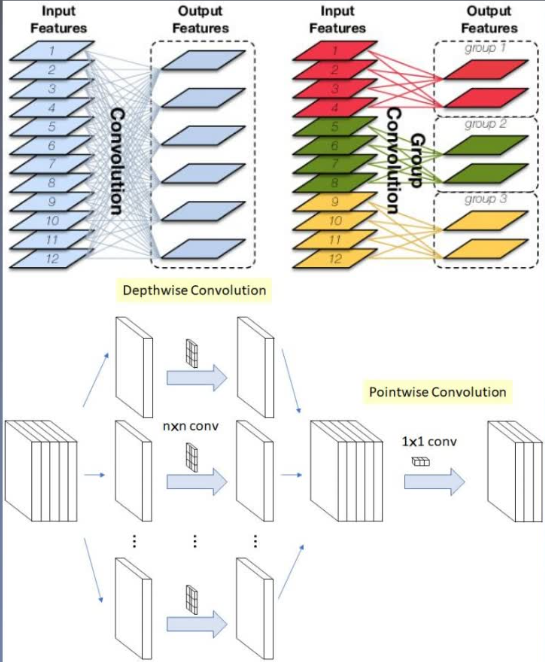
组卷积:对输入特征图进行分组,每组分别进行卷积。
深度可分离卷积(deeplab v3+):按照通道数来分组,是特殊的组卷积
⑤分组卷积对通道进行统一分组
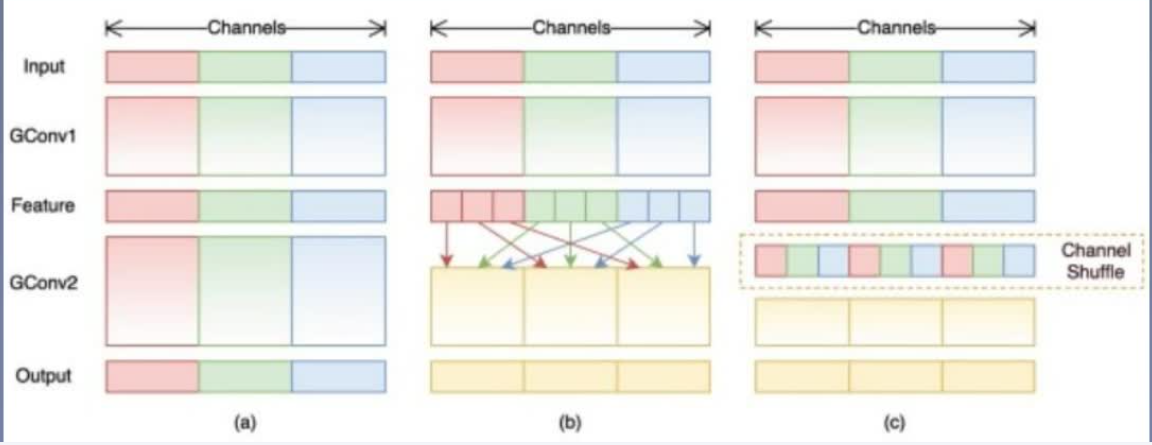
(ShffleNet 解决组间不能通信的问题)
为了达到特征之间的相互通信,
除了采用深度可分离卷积(dense pointwise convolution)(上图下面的图,会经过一个逐点卷积来使特征图更加密集,有实现特征之间相互通信的过程),
还可以使用channel shuffle(重组),对group convolution之后的特征图进行重组,这样可以保证下面的卷积其输入来自不同的组,因此信息可以在不同组之间流转。
⑥ 每层卷积可以用不同尺寸的卷积核
传统的层叠式网络,基本上都是一个个卷积层堆叠,每层只用一个尺寸的卷积核,例如VGG结构中是用来大量的3×3卷积层。
事实上,同一层的特征图可以分别使用多个不同尺寸的卷积核,以获得不同尺度的特征,再把这些特征结合起来,得到的特征往往比使用单一卷积核的要好。
为了尽可能的减少参数,一般先用1×1的卷积将特征图映射到隐空间,再在隐空间做卷积。(减少通道数)
⑦ 通道间的特征不平等(SENet)
给每层信息加权,分配不同的权重。
通过学习获取每个特征通道的重要程度,然后按照计算出来的重要程度去提升有用的特征,并抑制对当前任务用处不大的特征。
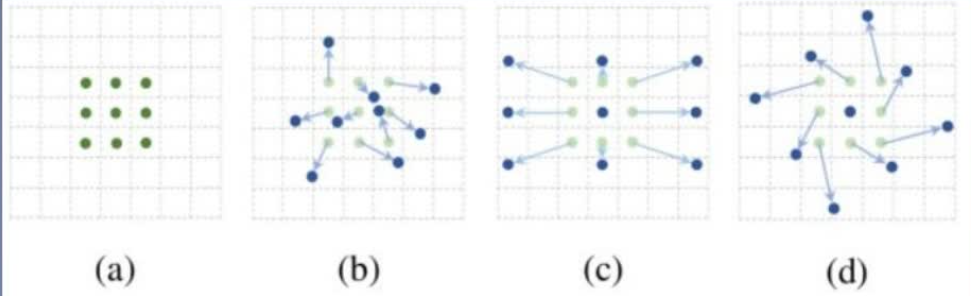
⑧ 卷积核形状不一定是矩形
规则形状的卷积核可能会限制特征的提取,
如果赋予卷积核形变的特性,让网络根据label反传下来的误差自动的调整卷积核的形状,适应网络重点关注的感兴趣的区域,就可以提取更好的特征。
例如,网络会根据原位置a,学习一个offset偏移量,得到新的卷积核b,c,d,那么一些特殊情况就会成为这个更泛化的模型的特例,例如c表示从不同尺度物体的识别,图d表示旋转物体的识别。
⑨ 汇总
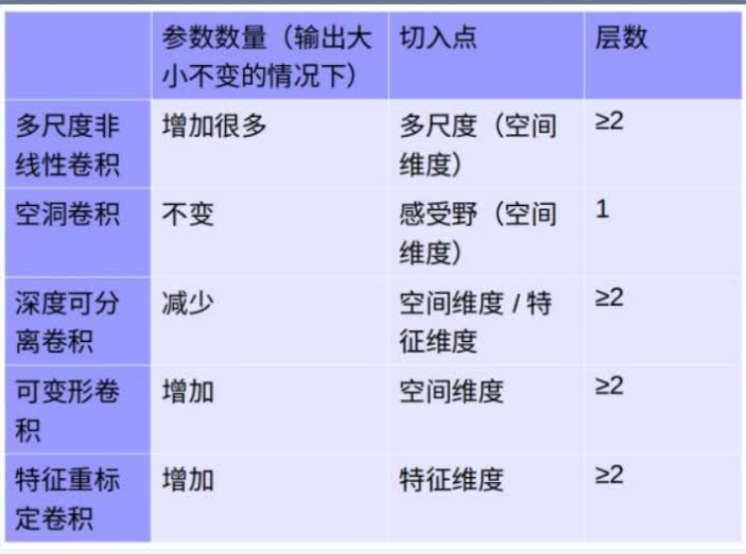
卷积核方面
- 大卷积核用多个小卷积核代替
- 单一尺寸卷积核用多尺寸卷积核代替
- 固定形状卷积核趋于使用可变形卷积核
- 使用1×1卷积核缩减通道数(bottleneck结构)
卷积层通道方面
- 标准卷积用深度可分离卷积替代
- 使用分组卷积
- 分组卷积前使用channel shuffle
- 通道加权计算
卷积层连接方面
- 使用跳跃连接,让模型更深,阻止网络退化
- 密集连接,每一层都融合其它层的特征输出(DenseNet)

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)