统计学习方法 CHAPTER5 决策树
开始入门机器学习有关知识,在这里发文的目的一是来记录主要的知识点,二是熟悉一下CSDN的发文操作,方便后续的更新。
信息增益:
熵(entropy):是表示随机变量不确定性的度量。设X是一个取有限个值的离散随机变量,其概率分布为:
则随机变量X的熵定义为:
熵越大,随机变量的不确定性越大。
条件熵H(Y|X)表示在已知随机变量X的条件下随机变量Y的不确定性。随机变量X给定的条件下随机变量Y的条件熵(conditional entropy),定义为X给定条件下Y的条件概率分布的熵对X的数学期望
H(Y|X=xi)表示Y对于X等于特定的数值的情况下取熵。
当熵和条件熵中的概率由数据估计得到是,所对应的熵与条件熵分别称为经验熵(empirical entrop)和条件经验熵(empirical conditional entropy)。此时,如果有概率0,令0log0=0.
信息增益(information gain)表示得知特征X的信息而使得类Y的信息的不确定性减少的程度。
特征A对训练数据集D的信息增益g(D,A),定义为集合D的经验熵H(D) 与特征A给定条件下D的经验条件熵H(D|A)之差,即:
一般地,熵与条件熵的差称为互信息(mutual information)。决策树学习中的信息增益等价于训练数据集中类与特征的互信息。
信息增益依赖于特征,不同的特征往往具有不同的信息增益,信息增益大的特征具有更强的分类能力。根据信息增益准则选取特征的方法是:对训练数据集D,计算其每个特征的信息增益,并且比较他们的大小,选择信息增益最大的特征。
信息增益的算法:
输入:训练数据集D和特征A;
输出:特征A对训练数据集D的信息增益g(D,A)。
信息增益比(information gain ratio):
特征A对训练数据集D的信息增益比定义为其信息增益与训练数据集D关于特征A的值的熵之比,即:
其中
n是特征A取值的个数。
ID3算法:
ID3算法的核心是在决策树各个结点上应用信息增益准则选择特征,递归地构建决策树。具体方法是:从根节点(root node)开始,对节点计算所有可能的特征的信息增益,选择信息增益最大的特征作为结点的特征,由该特征的不同取值建立子结点;再对子结点递归地调用以上方法,构建决策树。但是ID3算法仅有树地生成,所以该算法生成的树容易产生过拟合。
输入:训练数据集D,特征值A阈值;
输出:决策树T。
C4.5算法:
C4.5算法跟ID3算法类似,其对ID3算法进行了改进。C4.5算法在树的生成过程中,用信息增益比来选择特征。
输入:训练数据集D,特征值A阈值;
输出:决策树T。
决策树的剪枝:
决策树的剪枝往往通过极小化决策树整体的损失函数(loss function)或代价函数(cost function)来实现。设树的叶结点个数为|T|,t是树T的叶结点,该叶结点有Nt个样本点,其中k类的样本点有Ntk个,k=1,2,...,K,Ht(T)为叶结点的经验熵,α≥0为参数,则决策树学习的损失函数定义为:
其中经验熵为:
在损失函数中,将其第一项记作:
这时有:
C(T)表示模型对训练数据的预测误差,即模型与训练数据的拟合程度,|T|表示模型的复杂度,参数α≥0控制两者之间的影响。较大的α促使选择较简单的模型,较小的α促使选择较复杂的模型。α=0意味着只考虑模型与训练数据的拟合程度,不考虑模型的复杂程度。
树的剪枝算法:
输入:生成算法产生的整个树T,参数α;
输出:修剪后的子树T‘。
若树回缩到父结点时的损失函数小于原树的损失函数,则选择回缩到父结点。
CART算法:
分类与回归树(classification and regression tree,CART)由特征选择、树的生成及剪枝组成,既可用于分类也可用于回归。
CART假设决策树是二叉树,内部结点特征的取值为是和否,左分支是取值为是的分支,右分支是取值为否的分支。其主要由两步组成:决策树生成和决策树剪枝。CART算法由两部分组成,分别是决策树生成和决策树剪枝。
CART生成:
决策树的生成就是递归地构建二叉决策树的过程。对回归树使用平方误差最小化准则,对分类树使用基尼指数(Gini index)最小化准则,进行特征选择,生成二叉树。
在平方误差最小化准则中,需要遍历来选择最有切分变量j与切分点s来使得平方误差最小。
基尼指数(Gini index):
分类问题中,假设有K个类,样本点属于第k类的概率为pk,则概率分布的基尼指数定义为:
对于二分类问题,若样本点属于第一类的概率是p,则概率分布的基尼指数为:
对于给定的样本集合D,其基尼指数为:
这里,Ck是D中属于第k类的样本子集,K是类的个数。
如果样本集合D根据特征A是否取某一可能值a被分割成D1和D2两部分,则在特征A的条件下,集合D的基尼指数定义为:
基尼指数表示集合D的不确定性,基尼指数Gini(D,A)表示经A=a分割后集合D的不确定性。基尼指数越大,样本集合的不确定性也就越大,这一点与熵相似。
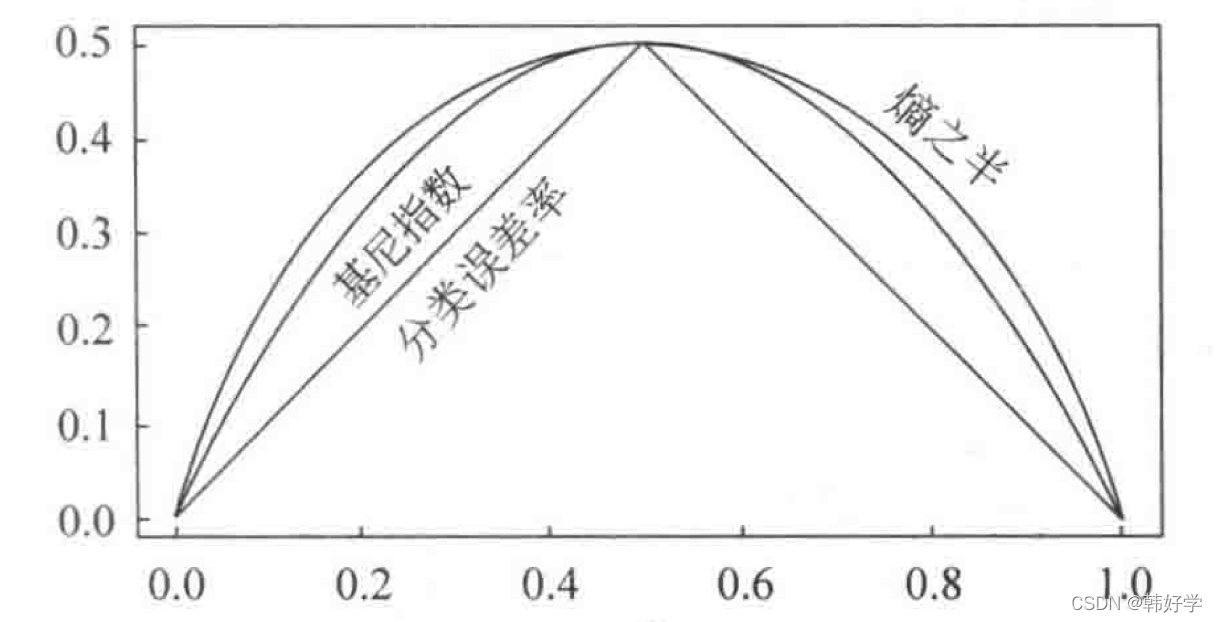
在二分类问题中基尼指数、熵之半和分类误差的关系如下,可以看出基尼指数和熵之半的曲线很接近,都可近似的代表分类误差率。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)