机器学习笔记--约束优化
机器学习笔记–约束优化
学习笔记
优化问题
我们称在xxx的某些集合SSS中找f(x)f(x)f(x)的最大值和最小值为约束优化问题。集合SSS内的点成为可行点。
约束优化问题的通用形式如下:
{minf(x)s.t.gi(x)≤0,i=1,2,...,qhj(x)=0,j=q+1,...,mx∈D
\left\{\begin{aligned}
\min \quad&f(x) \\
s.t. \quad&g_i(x) \le0, \qquad i=1, 2,...,q \\
&h_j(x) = 0, \qquad j=q+1,...,m\\
&x\in D
\end{aligned}\right.⎩⎪⎪⎪⎪⎨⎪⎪⎪⎪⎧mins.t.f(x)gi(x)≤0,i=1,2,...,qhj(x)=0,j=q+1,...,mx∈D
其中f(x)f(x)f(x)是优化的目标函数,gi(x)≤0g_i(x)\le0gi(x)≤0是不等式约束,hj(x)=0h_j(x)=0hj(x)=0是等式约束,D={x∈Rn∣li≤xi≤ui,li,ui∈R,i=1,2,...,n}D=\{x\in R^n|l_i\le x_i \le u_i, l_i, u_i \in R, i=1, 2,..., n\}D={x∈Rn∣li≤xi≤ui,li,ui∈R,i=1,2,...,n}是搜索空间, DDD中所有满足约束条件的解构成可行域SSS,即S={x∣x∈D,gi(x)≤0,i=1,2,...,q,hj(x)=0,j=q+1,...,m}S=\{x| x\in D, g_i(x)\le 0, i=1,2,...,q,h_j(x)=0,j=q+1,...,m\}S={x∣x∈D,gi(x)≤0,i=1,2,...,q,hj(x)=0,j=q+1,...,m}。
若在x∗∈Dx^*\in Dx∗∈D的邻域内的所有点xxx满足:f(x∗)<f(x)f(x*)<f(x)f(x∗)<f(x),则称x∗x^*x∗为局部最优解;若对∀x∈D\forall x\in D∀x∈D,有f(x∗)<f(x)f(x^*)<f(x)f(x∗)<f(x),则称其为全局最优解。考虑到算力问题,目前的最优解多为局部最优解。
对于上述优化问题,传统的解决方法是从约束问题形式出发,通过变形,将原本复杂的问题转变为相对简单的问题。传统方法存在以下问题:
- 传统的基于梯度的优化方法无法获得全局最优解,容易陷入局部最优。并且在实际问题中往往伴随更新过快或过慢的问题。牛顿法在一定程度上解决了更新过慢的问题,添加梯度更新学习率可以防止更新过快而错过最优解。
- 对于实际问题,往往维数较高,因此在优化曲面中存在多个极小点,因此使得部分基于梯度的优化算法失效。另一方面,梯度优化方法要求目标函数在可行域内连续,并不是每次都能得到满足。
- 梯度方法无法在非凸或不连通优化问题中奏效。
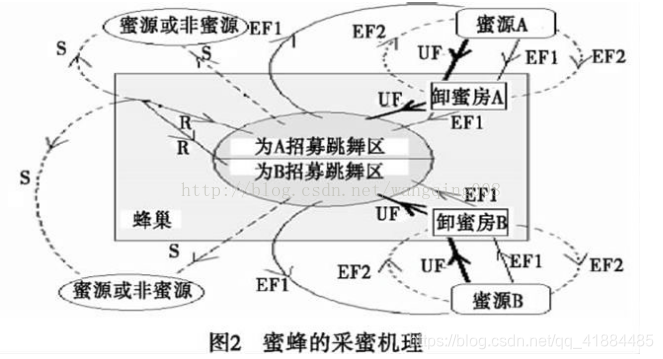
进化算法是求解优化问题的全局优化方法,其灵感来自于大自然的生物进化,是一种成熟的具有高鲁棒性和广泛适用性的优化算法。目前接触到的有遗传算法、粒子群优化算法、人工蜂群算法。只是接触,并未深入了解。此处留一坑,下图是人工蜂群算法思路图(很大自然)。
拉格朗日乘子法(KKT方法)
KKT方法是针对约束优化问题的一个通用方法。引入新的变量λi\lambda_iλi和αi\alpha_iαi,引入的变量被称为KKT乘子。通过新的变量,我i们的目标函数可以更改为:L(x,λ,α)=f(x)+∑iλigi(x)+∑jαjhj(x)L(x,\lambda, \alpha) = f(x)+\sum_i\lambda_ig^i(x)+\sum_j\alpha_jh^j(x)L(x,λ,α)=f(x)+i∑λigi(x)+j∑αjhj(x)
该式被称为广义Largrangian函数。
我们的优化问题可以转化为:
minxmaxλmaxα,α>0L(x,λ,α)\min_x \max_\lambda \max_{\alpha, \alpha>0}L(x,\lambda,\alpha)xminλmaxα,α>0maxL(x,λ,α)
可以这么修改的原因在于,对于可行域SSS之外的点,该约束都有maxλmaxα,α>0L(x,λ,α)=∞\max_\lambda \max_{\alpha,\alpha>0}L(x,\lambda,\alpha)=\inftyλmaxα,α>0maxL(x,λ,α)=∞
这些性质确保了不可行点不会只最优解,而可行域范围内的最优点不变。
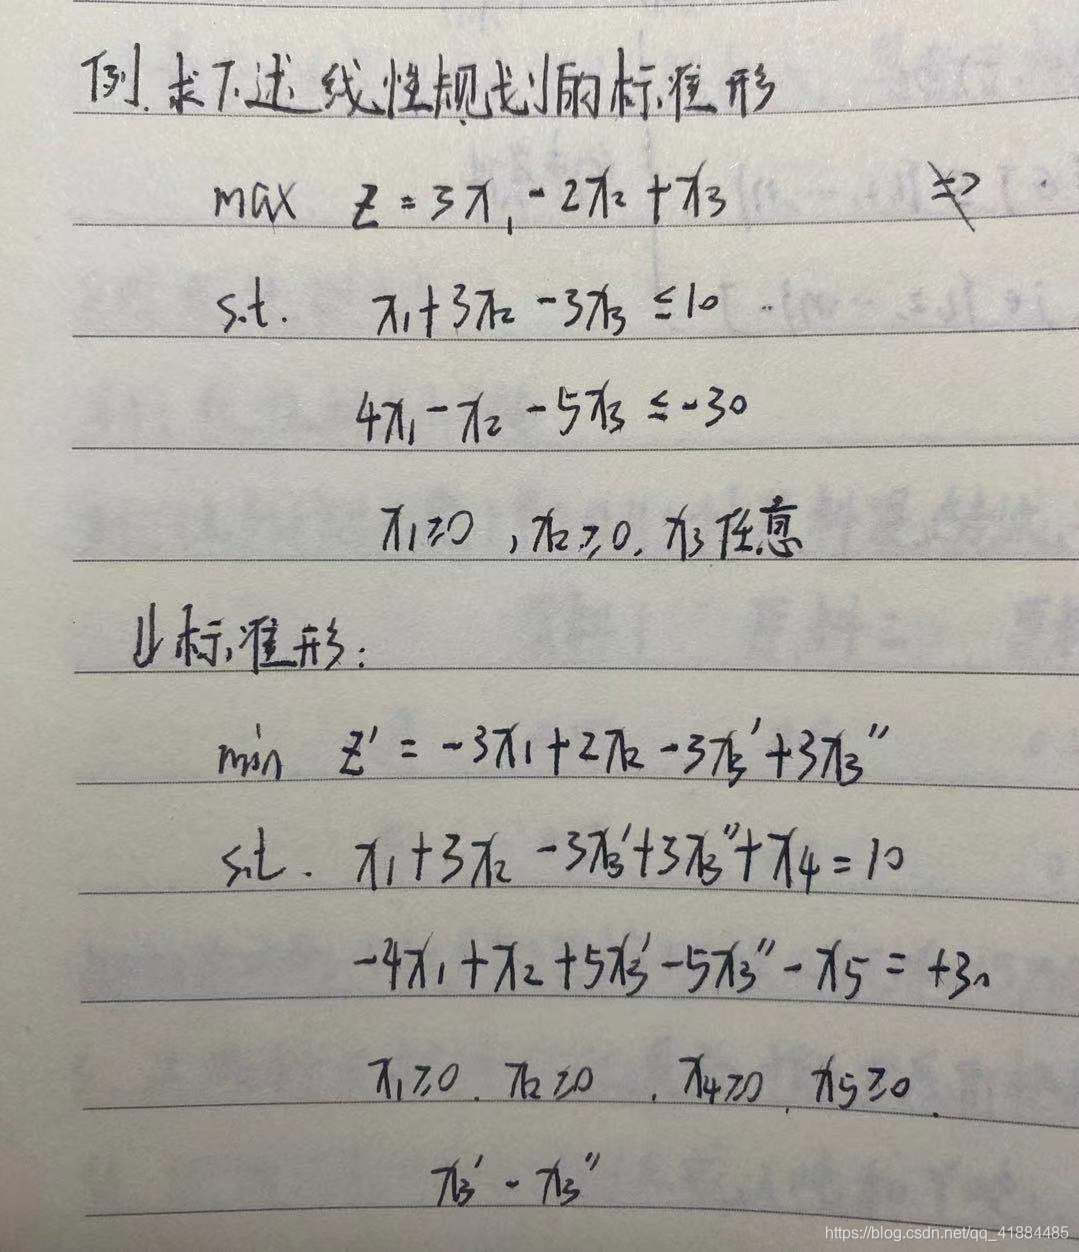
上述的KKT方法是基于优化问题的标准形式的,对于非标准形可通过以下方法进行转化:
- 对于maxiZ\max_i ZmaxiZ,通过变换mini−Z\min_i -Zmini−Z
- 对于∑j=1naijxj≤bi\sum_{j=1}^n a_{ij}x_j\le b_i∑j=1naijxj≤bi, 加入松弛变量yiy_iyi,使∑j=1naijxj+yi=bi,yi≥0\sum_{j=1}^n a_{ij}x_j + y_i = b_i, y_i\ge0∑j=1naijxj+yi=bi,yi≥0
- 对于∑j=1naijxj≥bi\sum_{j=1}^na_{ij}x_j\ge b_i∑j=1naijxj≥bi,加入剩余变量yiy_iyi, 使∑j=1naijxj−yi=bi,yi≥0\sum_{j=1}^na_{ij}x_j-y_i = b_i, y_i\ge0∑j=1naijxj−yi=bi,yi≥0
- 对于bi<0b_i < 0bi<0,考虑−∑j=1naijxj=−bi-\sum_{j=1}^n a_{ij}x_j = -b_i−∑j=1naijxj=−bi
- 对于xj<0x_j < 0xj<0,考虑−xj≥0-x_j \ge 0−xj≥0,若xjx_jxj任意,则考虑xj′−xj′′,xj′≥0,xj′′≥0x_j^{'}-x_j^{''}, x_j^{'}\ge 0,x_j^{''} \ge 0xj′−xj′′,xj′≥0,xj′′≥0
我们可以使用一组简单的性质来描述约束优化问题的最优点。这些性质称为Karush−Kuhn−TuckerKarush-Kuhn-TuckerKarush−Kuhn−Tucker(KKT)条件。这些是确定一个点是最优点的必要条件,但不一定是充分条件。这些条件是:
- 广义Lagrangian的梯度为0
- 所有关于xxx和KKT乘子的约束都满足
- 不等式约束显示的“互补松弛性”:α⊙h(x)=0\alpha \odot h(x) = 0α⊙h(x)=0 。(⊙\odot⊙表示同或,当两者符号不同时为0)
对偶问题
对优化问题:
minw,b12∣∣w∣∣2s.t.yi(wTxi+b)≥1,i=1,2,...,m.
\begin{aligned}
\min_{w,b} \quad &\frac{1}{2}||w||^2 \\
s.t. \quad & y_i(w^Tx_i + b) \ge 1, \quad i=1,2,...,m.
\end{aligned}
w,bmins.t.21∣∣w∣∣2yi(wTxi+b)≥1,i=1,2,...,m.
可以使用拉格朗日乘子法得到其“对偶问题”。对上式篾条约束添加拉格朗日乘子αi≥0\alpha_i\ge0αi≥0,则该问题的拉格朗日函数可写为:
L(w,b,α)=12∣∣w∣∣2+∑i=1mαi(1−yi(wTxi+b))L(w, b, \alpha) = \frac{1}{2}||w||^2+\sum_{i=1}^m\alpha_i(1-y_i(w^Tx_i+b))L(w,b,α)=21∣∣w∣∣2+i=1∑mαi(1−yi(wTxi+b))
其中α=(α1,α2,...,αm)\alpha=(\alpha_1,\alpha_2,...,\alpha_m)α=(α1,α2,...,αm).令L(w,b,α)L(w,b,\alpha)L(w,b,α)对www和bbb的偏导为0(KKT条件的第一个条件)可得:
w=∑i=1mαiyixiw = \sum_{i=1}^m \alpha_iy_ix_iw=i=1∑mαiyixi 0=∑i=1mαiyi0 = \sum_{i=1}^m\alpha_iy_i0=i=1∑mαiyi
带入原式即可消去www和bbb, 并化简可得:
maxα∑i=1mαi−12∑i=1m∑j=1mαiαjyiyjxiTxjs.t.∑i=1mαiyi=0,ai≥0,i=1,2,...,m
\begin{aligned}
\max_\alpha\quad&\sum_{i=1}^m \alpha_i - \frac{1}{2}\sum_{i=1}^m \sum_{j=1}^m \alpha_i \alpha_jy_iy_jx_i^Tx_j \\
s.t. &\sum_{i=1}^m \alpha_iy_i = 0, \\
&a_i \ge 0, \qquad i=1,2,...,m
\end{aligned}
αmaxs.t.i=1∑mαi−21i=1∑mj=1∑mαiαjyiyjxiTxji=1∑mαiyi=0,ai≥0,i=1,2,...,m
上述过程满足的KKT条件为:
{αi≥0;yif(xi)−1≥0(约束);αi(yif(xi)−1)=0(互补松弛性).
\left\{\begin{aligned}
&\alpha_i \ge 0; \\
&y_if(x_i)-1 \ge 0(约束);\\
&\alpha_i(y_if(x_i)-1) = 0(互补松弛性).
\end{aligned}\right.
⎩⎪⎨⎪⎧αi≥0;yif(xi)−1≥0(约束);αi(yif(xi)−1)=0(互补松弛性).
对任意训练样本(xi,yi)(x_i, y_i)(xi,yi),总有αi=0\alpha_i = 0αi=0或yif(xi)=1y_if(x_i) = 1yif(xi)=1。若αi=0\alpha_i = 0αi=0, 则该样本将不会在求和中出现,也就不会对f(x)f(x)f(x)有任何影响。若αi>0\alpha_i > 0αi>0,则必有yif(xi)=1y_if(x_i) = 1yif(xi)=1, 所对应的样本点位于最大间隔边界上,是一个支持向量。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)