Python-数据分析-常用检验-1-正态分布检验
·
一直对各种检验稀里糊涂的,借着Python把一些常用的数据分析或者论文建模使用的检验方法总结一哈。
文章目录
正态分布 Normal distribution
我导师说得好,大家都喜欢的男孩子叫正太,大家都喜欢的图像也叫正态。
首先导入:
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats
import pandas as pd
正态分布相关数据构造
生成正态分布随机数 np.random.normal(loc=0.0, scale=1.0, size=None)
- loc为生成正态分布的均值
- scale为生成正态分布的标准差
- size为生成正态分布随机数的数量
Norm = np.random.normal(size=10)
print(Norm)

# [ 0.79297992  0.11486076  0.59150981 -0.48018112 -0.49646006  0.30028252
#  -0.44232973  0.92398375 -0.21909139  3.15716074]
生成正态分布随机数的密度值 pdf()
norm_pdf = stats.norm.pdf(Norm)
print(norm_pdf)
# [0.39507864 0.39891275 0.34705588 0.34324403 0.30508555 0.34804571
#  0.35405806 0.36189068 0.20743041 0.1305287 ]
生成正态分布随机数的累计密度值 cdf()
norm_cdf = stats.norm.cdf(Norm)
print(norm_cdf)
# [0.55547757 0.49514605 0.29878981 0.29170626 0.23195405 0.30067458
#  0.31256909 0.32941451 0.12637477 0.93251756]
获取累计密度值为0.05的分位数 ppf(0.05, 均值,标准差)
(正态分布应用——VaR)
q = stats.norm.ppf(0.05, Norm.mean(), Norm.var() ** 0.5)
print(q)
# -1.3951102225418839  即95%的概率损失不会超过-1.3951102225418839
正态分布相关图像绘制
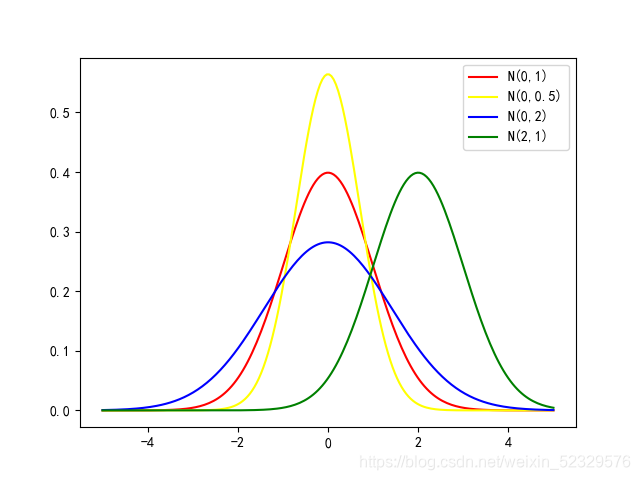
正态分布概率密度函数图像绘制
norm_bins = np.linspace(-5, 5, num=200)
plt.plot(norm_bins, stats.norm.pdf(norm_bins, 0, 1), label='N(0,1)', color='r')
plt.plot(norm_bins, stats.norm.pdf(norm_bins, 0, 0.5 ** 0.5), label='N(0,0.5)', color='yellow')
plt.plot(norm_bins, stats.norm.pdf(norm_bins, 0, 2 ** 0.5), label='N(0,2)', color='blue')
plt.plot(norm_bins, stats.norm.pdf(norm_bins, 2, 1), label='N(2,1)', color='green')
plt.legend()
plt.show()
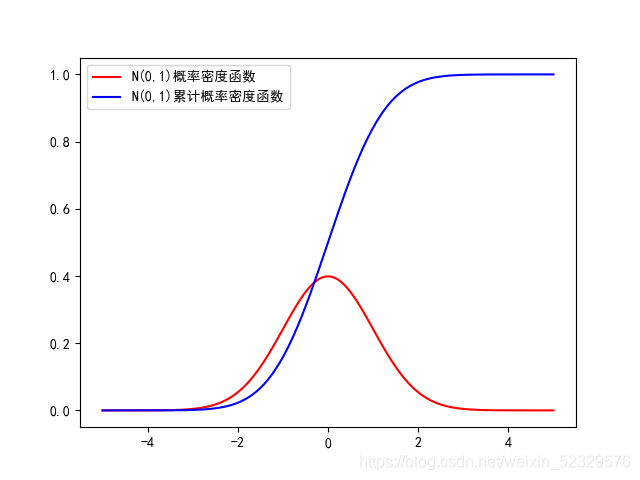
正态分布累计概率密度函数图像绘制
norm_bins = np.linspace(-5, 5, num=200)
plt.plot(norm_bins, stats.norm.pdf(norm_bins, 0, 1), label='N(0,1)概率密度函数', color='r')
plt.plot(norm_bins, stats.norm.cdf(norm_bins, 0, 1), label='N(0,1)累计概率密度函数', color='b')
plt.legend()
plt.show()
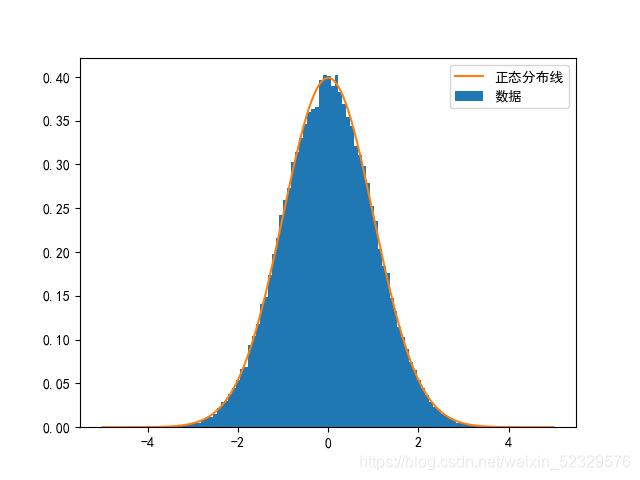
正态分布检验
直方图初略判断
x = np.arange(-5, 5, 0.01)


def normal_distirbution(x):
    return (np.e) ** (-x ** 2 / 2) / (2 * np.pi) ** 0.5


samples = np.random.normal(size=100000)

plt.hist(samples, bins=100, density=True, label='数据')
plt.plot(x, normal_distirbution(x), label='正态分布线')
plt.legend()
plt.show()
Shapiro-Wilk test检验
适用于样本量<50的样本数据。
testData = np.random.normal(2, 1, 30)
contrastData = np.random.random(30)

# 利用Shapiro-Wilk test检验其是否服从正态分布

testDataSW = stats.shapiro(testData)
contrastDataSW = stats.shapiro(contrastData)
print('testData的结果为{},contrastData的结果为{}'.format(testDataSW, contrastDataSW))
# testData的结果为ShapiroResult(statistic=0.9613666534423828, pvalue=0.33556127548217773),
# contrastData的结果为ShapiroResult(statistic=0.9475071430206299, pvalue=0.14491666853427887)

# 统计量越接近1就越表明数据和正态分布拟合得越好,如果P值>显著性水平,接受原假设,则判断样本的总体服从正态分布
kstest 检验
testData = np.random.randn(50)
print('testData的结果为{}'.format(stats.kstest(testData, 'norm')))
# testData的结果为KstestResult(statistic=0.05008991574251498, pvalue=0.9989955175362586)

# 统计量越接近0就越表明数据和标准正态分布拟合的越好,如果P值>显著性水平,接受原假设,则判断样本的总体服从正态分布
normaltest 检验
testData = np.random.randn(50)
print('testData的结果为{}'.format(stats.normaltest(testData)))
# testData的结果为NormaltestResult(statistic=3.3668911251714606, pvalue=0.185732917877838)

# 如果P值>显著性水平,接受原假设,则判断样本的总体服从正态分布
Anderson-Darling 检验
该检验可以应用于不同分布的检验:‘norm’, ‘expon’, ‘gumbel’, ‘extreme1’ , ‘logistic’
testData = np.random.randn(50)
print('testData的结果为{}'.format(stats.anderson(testData)))
# testData的结果为AndersonResult(statistic=0.1963449673478479,
#                            critical_values=array([0.538, 0.613, 0.736, 0.858, 1.021]),
#                            significance_level=array([15., 10., 5., 2.5, 1.]))


# 如果输出的统计量值statistic < critical_values,则表示在相应的显著性水平下,接受原假设,即认为样本数据符合正态分布(给定的其他分布)。
对数正态分布
我理解的对数正态分布就是正态分布的一种变型啦。
X~Lognormnal(μ, σ2) [即Y=lnX 服从正态分布]
log_bins = np.linspace(0, 10, num=200)
plt.plot(log_bins, stats.lognorm.pdf(log_bins, 1, 0, 1))
plt.show()

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 3
 0
- 0


 已为社区贡献2条内容

所有评论(0)